论文:Qwen-Audio-3.0-ASR Technical Report
一、先说结论:这不是只追求 Benchmark 的 ASR
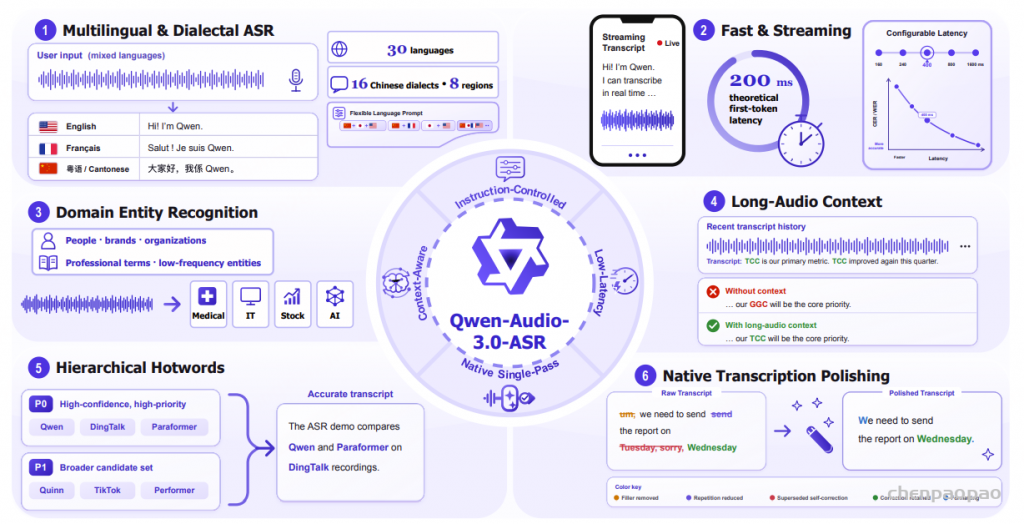
Qwen-Audio-3.0-ASR 的核心目标,是把“听清楚”扩展成“在真实产品里持续可用”。论文把问题归纳为四类:多语言和地区方言、动态人名/品牌/专业术语、长语音跨句上下文,以及停顿、重复、口误和自我纠正等自然口语现象。
模型采用 Qwen Mixture-of-Experts(MoE)语言模型作为解码器,训练数据达到数千万小时量级,统一支持 30 种语言和 16 种中文方言变体。更重要的是,它把语言指定、历史文本、P0/P1 分层热词和文本润色都设计成输入指令,而不是为每种任务维护一套独立模型。
- 30 种语言,覆盖东亚、东南亚、南亚、阿拉伯语区和欧洲多种语言。
- 16 种中文方言/方言变体,覆盖 8 个主要方言区,既支持方言转写,也支持方言到普通话的语音翻译。
- 行业实体识别、分层热词、长音频上下文和原生单次解码润色。
- 独立的 Qwen-Audio-3.0-ASR-Streaming 流式版本,以及面向语音输入、会议、采访和客服的 Message ASR 部署形态。
二、研究背景:数据、模型和 LLM 三条路线正在汇合
论文把近年的 ASR 演进概括为三个互补方向:
- Data Scaling:Whisper 系列从约 3,000 小时扩大到 68 万小时以上后,WER 下降超过 20 个点;领先系统的训练规模已经进入数千万小时。
- Model Scaling:Whisper 参数量从约 38M 增加到 1.5B,多语言 WER 继续显著改善。
- LLM Integration:Seed-ASR、FireRedAudio 等模型利用语言知识、世界知识和上下文推理能力,处理同音词、实体歧义和语义不完整等纯声学模型难以解决的问题。
但 Benchmark 的低 CER/WER 并不自动等价于产品体验。传统系统往往需要按语言或市场部署多个 checkpoint,热词更新要依赖外部 biasing 模块,口语润色又要额外串联一个 LLM。Qwen-Audio-3.0-ASR 的设计取舍是:把这些控制信号放进同一个 instruction-following ASR 解码过程里。
三、模型设计:四个模块加一个统一指令接口
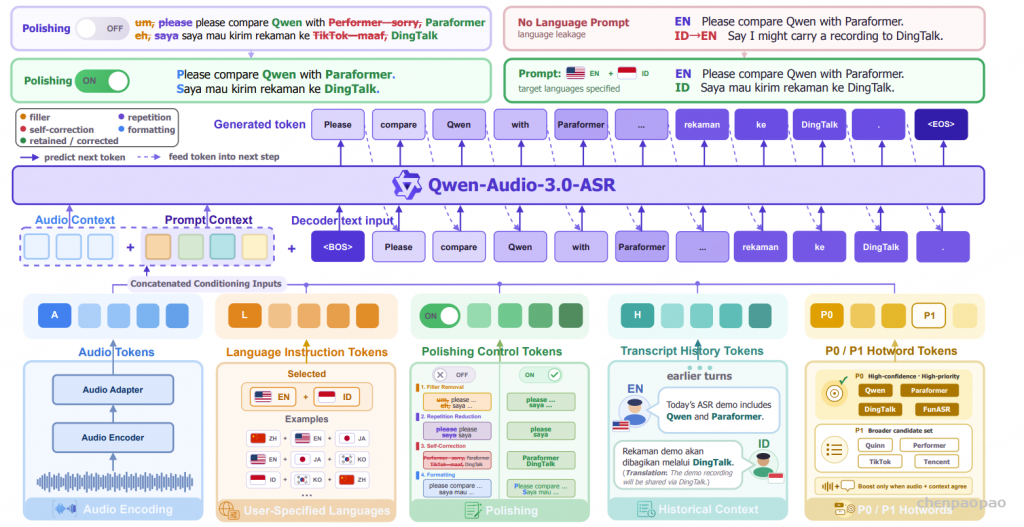
Qwen-Audio-3.0-ASR 延续上一代 Fun-ASR 的整体拓扑,但把原来的 7B Dense LLM Decoder 换成 Qwen MoE Backbone。一次请求除了音频,还可以携带目标语言列表、是否润色、历史转写,以及 P0/P1 热词。
- Audio Encoder:多层 Transformer Encoder,使用 SenseVoice 音频编码器,把波形转换为声学表示。
- Audio Adapter:两层 Transformer Encoder,将声学表示映射到 LLM 可消费的表示空间。
- CTC Decoder:挂在 Audio Encoder 上方,生成粗粒度识别假设。它不负责最终输出,而是为热词定制和长音频上下文注入提供候选与对齐信号。
- LLM Decoder:Qwen MoE 解码器,综合 Audio Representation、CTC Hypothesis、Instruction 和 Context,自回归生成最终文本。
最终输出可以抽象为:
\(P(y_{1:T}\mid x,c)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x,c)\)其中 \(x\) 是音频, \(c\) 是语言、历史上下文、热词和润色等条件。关键变化不在音频前端,而在解码器:MoE 通过稀疏专家路由维持较大的总语言容量,同时只激活部分专家,降低每个 token 的实际计算成本。
四、训练方案:五阶段逐步对齐声学、语言和产品目标
训练顺序为:Audio Encoder Pretraining -> Audio LLM Pretraining -> LLM Cooldown Adaptation -> Supervised Fine-tuning(SFT)-> Reinforcement Learning(RL)。这条链路的含义是,先获得稳健声学表示,再对齐 Qwen 的语言空间,随后用高质量数据收敛,最后直接优化生产指标。
4.1 Audio Encoder:BEST-RQ 自监督 + AED 有监督
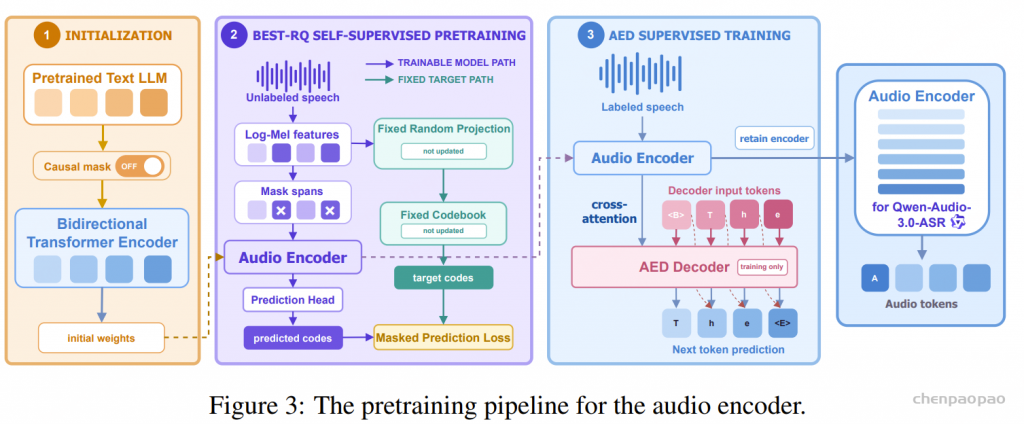
第一阶段使用 BEST-RQ 在海量无标注语音上训练。随机遮蔽声学帧,目标是预测由固定随机投影和冻结 codebook 生成的离散目标。部分 Transformer 层从预训练 Qwen3 初始化,但将语言模型中的 causal attention 改为双向 attention,以适应语音编码。数据覆盖 AI、生物科技、电商、教育、娱乐、金融、出行等真实场景,两阶段合计达到数千万小时。
第二阶段把编码器放进 attention-based encoder-decoder(AED)模型,用中文和英文为主的带标注或伪标注数据继续训练。数据流程包含 VAD、多 ASR 模型伪标签(Paraformer-V2、Whisper、SenseVoice)和 ITN。训练结束后,AED Decoder 被丢弃,只保留训练好的 Audio Encoder 作为后续初始化。
4.2 Audio LLM Pretraining:约 2,000 万小时做音频-文本对齐
Audio Encoder 在这一阶段冻结,Audio Adapter 和 Qwen MoE Decoder 联合训练。数据约 2,000 万小时,主要由 ASR 数据和交错 text-audio 数据组成,目标是文本 token 的交叉熵:
\(\mathcal{L}_{CE}=-\sum_{t=1}^{T}\log P_{\theta}(y_t\mid y_{<t},x,c)\)这一阶段把声学表示对齐到 LLM 的文本表示空间,形成多语言知识、世界知识、同音词和实体消歧能力,以及后续指令跟随能力。
4.3 LLM Cooldown:减少数量,增加质量与平衡
Cooldown 使用约 100 万小时的更高质量数据,并重新平衡语言和方言分布,同时加入 Audio Understanding、Speaker Diarization 和 SpeechQA。ASR 数据经 VibeVoice 重识别,错误率大于 0.3 的样本被过滤。Audio Encoder 继续冻结,只更新 Adapter 和 Decoder。它的作用不是继续堆数据,而是把大规模预训练模型“收敛”到更可靠、更均衡的音频语言任务。
4.4 SFT:统一指令格式覆盖 30 语言、16 方言和多种业务条件
SFT 使用数千万小时语音,包含人工标注、高置信伪标签、噪声增强、TTS、流式模拟、远场/房间模拟、code-switch、多语言/方言和业务场景数据。Audio Encoder 与 Adapter 更新,Base LLM 冻结并通过 LoRA 适配 Decoder,训练序列最多 8,192 tokens。
- 指定语言转写:单语场景只输出指定语言;多语混说保留各语言原始书写形式,减少 language leakage。
- 行业实体增强:从 AI、金融、医疗、IT 等领域挖掘实体,经过“实体 -> 事实检索 -> LLM 造句 -> CosyVoice3 合成 -> 当前 ASR 重识别过滤 -> SFT”流程,强化长尾词。
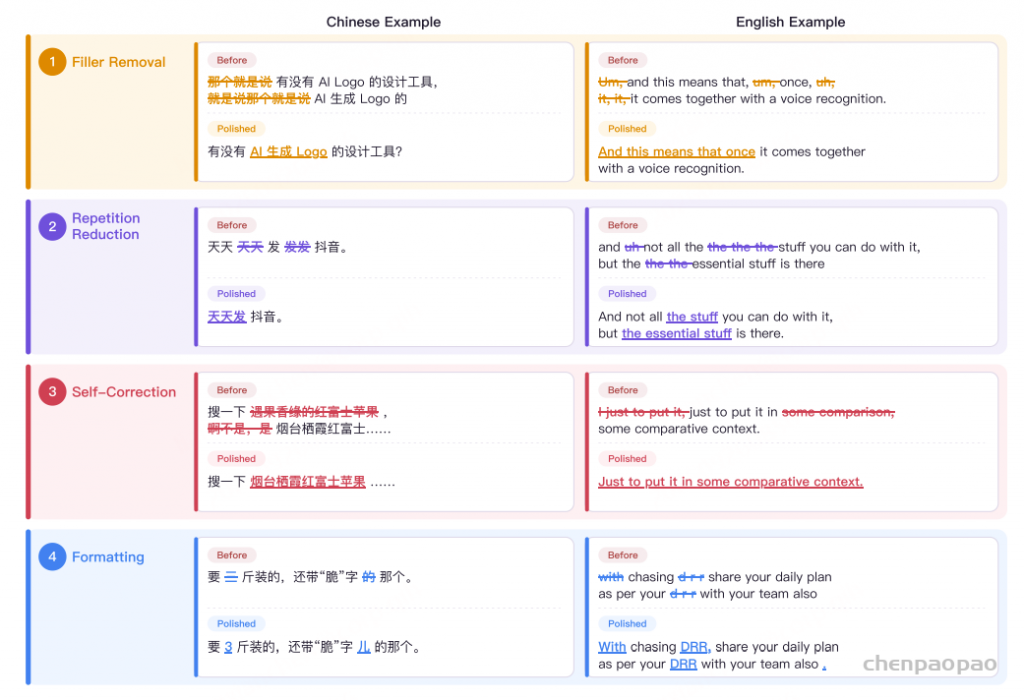
- 原生润色:用二值指令控制 verbatim 或 polished 输出,学习删除 filler、消除重复、处理 self-correction、补标点和规范格式。
- 历史上下文:将同一 session 的前序转写作为 context,同时训练正确、冲突、噪声和空 context,明确告诉模型音频始终是主要证据。
- 分层热词:P0 是高置信、高优先级词;P1 是更宽的候选池。LLM 根据 reference transcript 做语义匹配,P0 bias 更强但仍需得到声学和语义证据支持。
分层热词可以形式化为:对 P0 候选使用更高的条件权重,对 P1 使用较弱权重;目标不是把候选词硬塞进结果,而是在召回长尾词和抑制错误插入之间取得平衡。
4.5 RL:FunVerl-ASR + GRPO,直接优化 ASR 产品指标
RL 数据集强调 compact、high-quality、hard cases:模型与 Whisper/FireRed-ASR/SenseVoice 不一致的样本、超过 20 秒的长语音、幻觉样本、关键词/热词样本,以及用于防止灾难性遗忘的普通 ASR 数据。
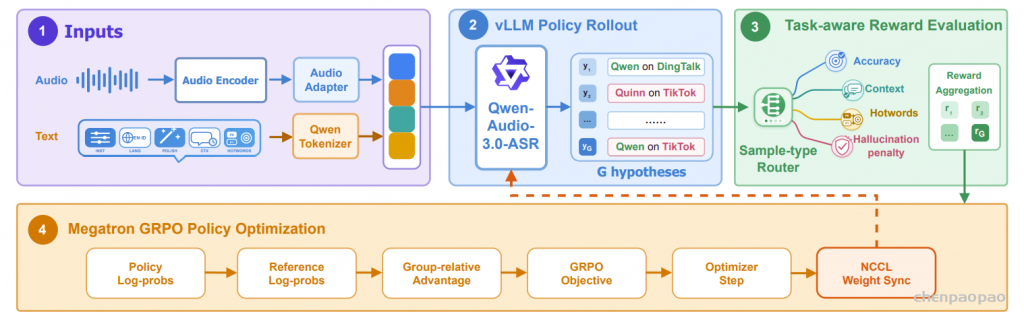
FunVerl-ASR 为音频大模型扩展了普通文本 RL 框架,包含四个并行模块:
- Audio Processor:波形转 Mel 特征,指令文本转 token。
- vLLM Rollout Engine:冻结 Audio Encoder/Adapter 生成音频 embedding,与文本 embedding 合并后由 MoE 生成多个候选。
- Reward Module:支持 CER、关键词召回、热词命中、上下文实体匹配、幻觉检测、语言一致性和 LLM Judge。
- Megatron Policy Trainer:使用 tensor/pipeline/expert parallel,更新后通过 NCCL 将 Decoder 权重同步回 rollout worker。
其工程创新是 fully asynchronous loop:rollout 持续生成轨迹并放入消息队列,trainer 独立消费并更新策略;当轨迹对应的旧策略过于陈旧时直接丢弃。默认每个 prompt 生成 8 个 hypothesis,每次 actor update 使用 32 个 prompt,在 32 张 A100(rollout 和训练各 16 张)上,一天内完成完整 RL。
GRPO 不需要单独训练 value network。组内 advantage 为:
\(\hat{A}_{i,t}=\frac{R_i-\operatorname{mean}(\{R_j\}_{j=1}^{G})}{\operatorname{std}(\{R_j\}_{j=1}^{G})}\)策略目标使用 clipped objective 和 KL 惩罚:
\(\mathcal{L}_{GRPO}(\theta)=\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_t\min\left(r_{i,t}(\theta)\hat{A}_{i,t},\operatorname{clip}(r_{i,t}(\theta),1-\epsilon,1+\epsilon)\hat{A}_{i,t}\right)-\beta D_{KL}(\pi_{\theta}\parallel\pi_{ref})\)当 reward 只有 WER 时,GRPO 与 ASR 中的 MWER 训练接近;论文进一步使用组合 reward:
- \(R_1=1-WER\):总体识别准确率。
- 关键词准确率与召回率:既奖励命中,也惩罚错误插入。
- 热词 reward:分别评价 P0/P1,并使用不对称正负权重。
- 上下文 reward:奖励命中历史实体,惩罚错误复制。
- 幻觉抑制:按幻觉 span 长度惩罚。
五、部署形态:一个模型,三种产品能力
5.1 多语言与方言:从多 checkpoint 变成运行时指令
上一代 Fun-ASR 需要中文英文主模型和独立的 Fun-ASR-ML 多语言 checkpoint。Qwen-Audio-3.0-ASR 改成一个模型加 runtime language instruction,例如 Chinese+English+Japanese、Chinese+French、English+Indonesian。支持语言包括中文、日语、韩语、越南语、泰语、印尼语、马来语、菲律宾语、印地语、阿拉伯语,以及英语、法语、德语、西班牙语、葡萄牙语、俄语、意大利语、荷兰语、瑞典语、丹麦语、芬兰语、希腊语、波兰语、捷克语、匈牙利语、罗马尼亚语、保加利亚语、克罗地亚语、斯洛伐克语和挪威语。
5.2 Streaming:先快后准的混合式解码
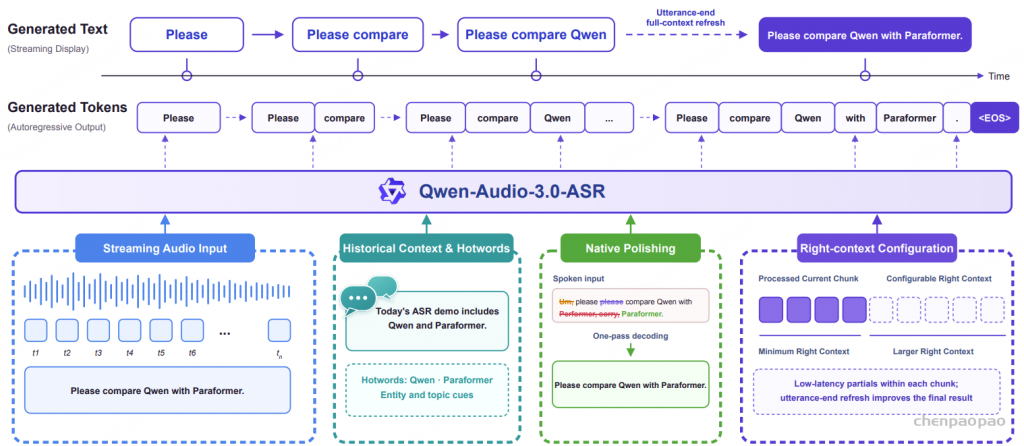
流式模型先用短 chunk 和有限 right context 连续输出临时文本;端点检测后,再用完整上下文大模型重算并刷新最终文本。chunk size 与 right context 可以独立调整:上下文越短,响应越快;上下文越长,准确率越高。论文在 H100 上测量 first-token latency 和 text-display latency,低延迟配置下前者低于 200 ms,后者低于 300 ms。
5.3 Message ASR:面向会议、采访和客服的组合式接口
Message ASR 不是另一个模型,而是把 streaming audio、历史上下文、P0/P1 热词、native polishing 和 right context 组合成一个部署 profile。它在说话过程中提供 partial result,结束后用完整 utterance 刷新结果;上下文帮助维持主题和实体一致性,热词帮助识别人名、产品和技术术语,但音频证据始终优先于 context 和 hotword。
六、公开基准:在统一评测下,中文、英文和多语言都具竞争力
论文同时使用公开数据集和内部工业测试集。公开集包括 AISHELL-1、AISHELL-2、FLEURS、LibriSpeech、WeNetSpeech、GigaSpeechBench 和 Common Voice 15。中文使用 CER,英文使用 WER;数值越低越好。
作者将中文英文结果分为两组:Panel A 是各模型官方报告结果,Panel B 是所有系统通过同一个 API 评测流程得到的结果。Panel A 可能存在预处理、参考文本和打分约定差异,因此真正适合横向比较的是 Panel B。
| 测试集 | 指标 | GPT-4o Transcribe | Azure | Doubao-ASR | Fun-ASR-Flash | Tencent Hy-ASR-3.0-preview | Qwen-Audio-3.0-ASR |
|---|---|---|---|---|---|---|---|
| AISHELL-1 | CER | 3.34 | 1.60 | 1.54 | 0.76 | 0.78 | 1.03 |
| AISHELL-2 | CER | 4.47 | 3.24 | 2.66 | 1.93 | 2.15 | 2.02 |
| FLEURS-zh | CER | 6.14 | 5.51 | 8.18 | 5.52 | 2.38 | 2.08 |
| FLEURS-en | WER | 5.79 | 5.47 | 6.50 | 4.95 | 5.45 | 4.17 |
| LibriSpeech-clean | WER | 1.58 | 1.90 | 3.36 | 1.35 | 1.60 | 1.19 |
| LibriSpeech-other | WER | 3.87 | 3.54 | 4.46 | 2.51 | 2.68 | 2.24 |
| WeNetSpeech-net | CER | 12.27 | 4.58 | 4.81 | 3.83 | 4.16 | 4.31 |
在 Panel B 中,Qwen-Audio-3.0-ASR 在 7 个测试集中的 4 个取得最低错误率:FLEURS-zh 2.08%、FLEURS-en 4.17%、LibriSpeech-clean 1.19%、LibriSpeech-other 2.24%。相对同一 pipeline 下最强竞争系统,分别降低 0.30、0.78、0.16 和 0.27 个百分点;AISHELL-2 也只落后最佳结果 0.09 个百分点。
6.1 多语言结果:GigaSpeechBench 与 Common Voice 15 的宏平均领先
| 数据集 | Qwen-Audio-3.0-ASR 宏平均 | 对比结论 |
|---|---|---|
| GigaSpeechBench | 22.50% | 在完整覆盖的系统中最低;7 种语言中 5 种最低 |
| Common Voice 15 | 4.57% | 宏平均最低;7 种语言中 6 种最低 |
| FLEURS | 4.94% | 9 种语言中 4 种最低,整体具有竞争力 |
这组结果体现了论文的主要平衡:模型不是在每一种语言、每一个测试集上都绝对第一,但在跨语言覆盖面和宏平均稳定性上表现很强,尤其适合一个模型服务多个市场的场景。
七、内部工业评测:论文真正想证明的四项能力
7.1 16 种中文方言:CER 与任务一致性同时评估
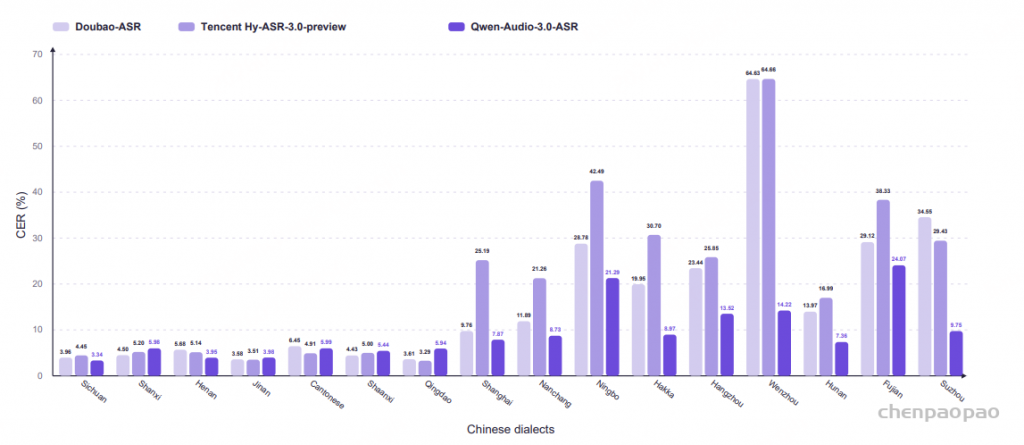
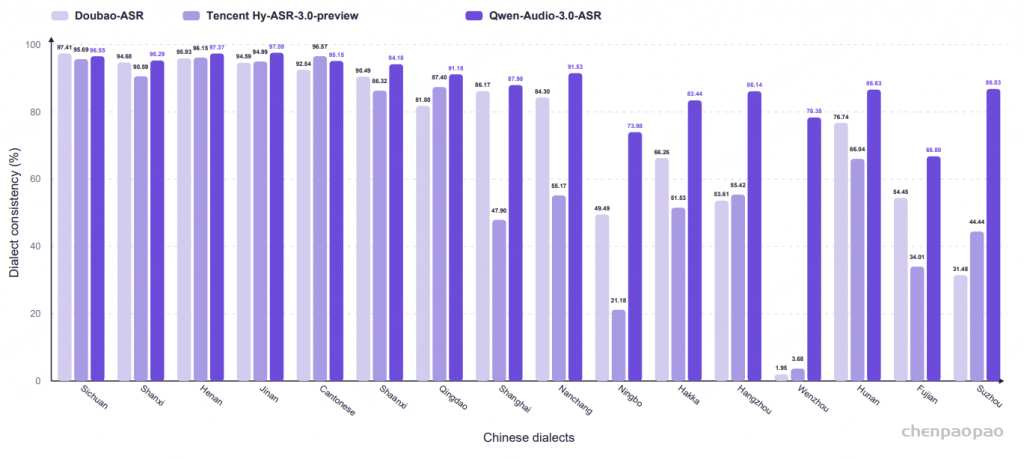
方言测试覆盖 16 种方言。四川、山西、河南、济南、粤语、陕西、青岛采用 ASR 设置,要求保留目标方言;上海、南昌、宁波、客家、杭州、温州、湖南、福建、苏州采用 AST 设置,要求翻译为自然普通话。
一致性由 Qwen3.7-Max 按 0-10 分评价,分数至少为 6 才算一致。计算公式为:
\(Consistency=\frac{100}{N}\sum_{i=1}^{N}\mathbf{1}[s_i\ge 6]\)Qwen-Audio-3.0-ASR 在 16 个方言子集中的 11 个取得最低 CER,宏平均 CER 为 9.40%,对比 Doubao-ASR 的 16.77% 和 Tencent Hy-ASR-3.0-preview 的 20.40%。在温州话上,模型 CER 为 14.22%,而两个对比系统分别为 64.63% 和 64.66%,差距尤其明显。
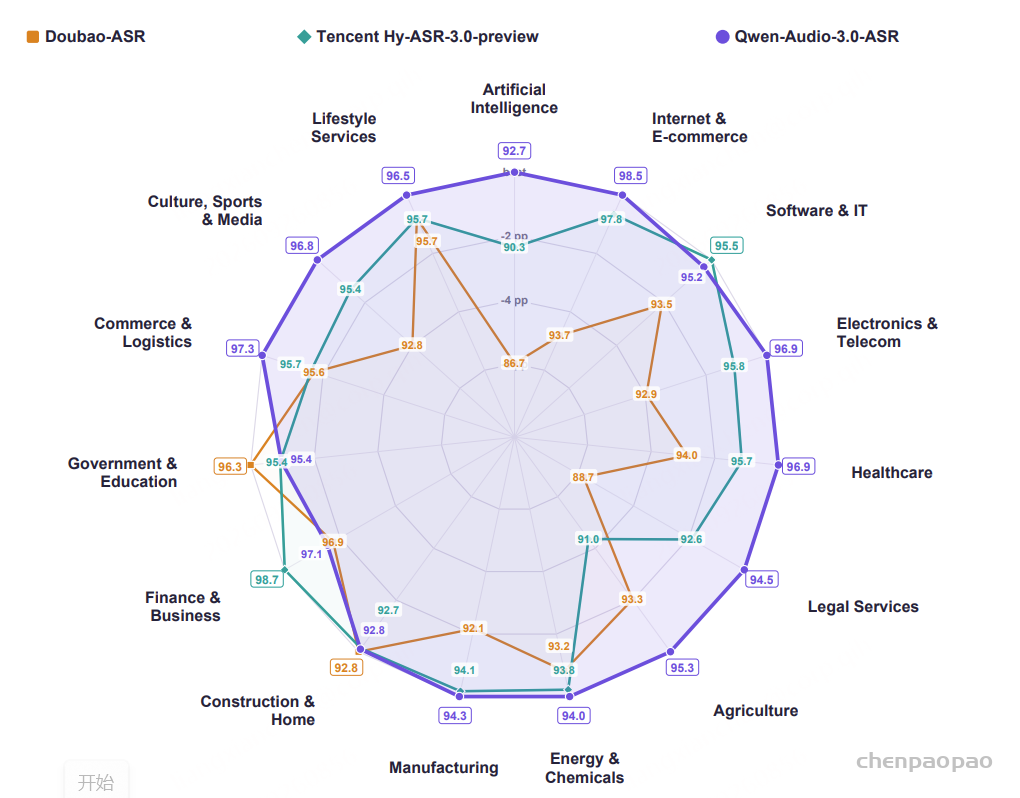
7.2 行业实体:15 个领域全部取得最高召回
内部行业测试覆盖 15 个领域,包括 AI、医疗、农业、制造、文化体育媒体、软件与 IT 等。Qwen-Audio-3.0-ASR 在所有领域的 entity recall 都高于 Doubao-ASR 和 Tencent Hy-ASR-3.0-preview,软件与 IT 的提升最明显,因为其中包含大量低频、快速变化的软件库、框架和 API 名称。
这里需要保持严谨:论文认为实体挖掘和数据合成 pipeline 很可能是主要贡献之一,但不能据此证明所有提升都由该模块单独带来,因为 MoE 解码器、更多数据和 RL 也可能共同贡献。
7.3 分层热词:P0 召回接近 99%,P1 有意保持更弱 bias
| 类别 | Qwen 无热词 | Qwen + 热词 | 说明 |
|---|---|---|---|
| Person names P0 | 62.12% | 99.43% | 提升 37.31 个百分点 |
| Subject terms P0 | 69.36% | 99.42% | 高优先级词强增强 |
| Trending buzzwords P0 | 63.08% | 99.46% | 动态热词效果明显 |
| AI entities P0 | 88.22% | 99.39% | 接近饱和召回 |
| Brand names P0 | 83.83% | 97.95% | 实体类别稳定提升 |
| Product entities P0 | 72.87% | 99.07% | 长尾产品名受益明显 |
| Subject terms P1 | 88.46% | 95.31% | 较弱 bias,避免误插词 |
| Trending buzzwords P1 | 74.00% | 88.34% | 保守增强 |
7.4 长音频上下文:把前文变成 running context cache
很多错误不是当前片段的声学信息不足,而是同音实体、文件名、技术缩写或人名需要跨句记忆。模型把同一 session 中已经识别的前序文本作为上下文,不要求人工维护完整热词表。例如前文已经确认“style.xsl”、TCC、unigram、softmax、debug 或某个人名,后续再次出现时可以抑制声学上相近但错误的替代词。
| 前文线索 | 参考 | 无长上下文 | 有长上下文 |
|---|---|---|---|
| xsltproc style.xsl input.xml | style.xsl data.xml > out.html | xsl data.xml > out.html | style.xsl data.xml > out.html |
| “这叫法条竞合” | 法条竞合 | 划掉即可 | 法条竞合 |
| unigram 已出现两次 | 我们称之为 unigram | unique | unigram |
| TCC 已被反复确认 | our TCC will be… | our GGC will be… | our TCC will be… |
| softmax 已出现 | softmax 形式 | softmap 形式 | softmax 形式 |
7.5 原生单次润色:可读性接近两阶段级联
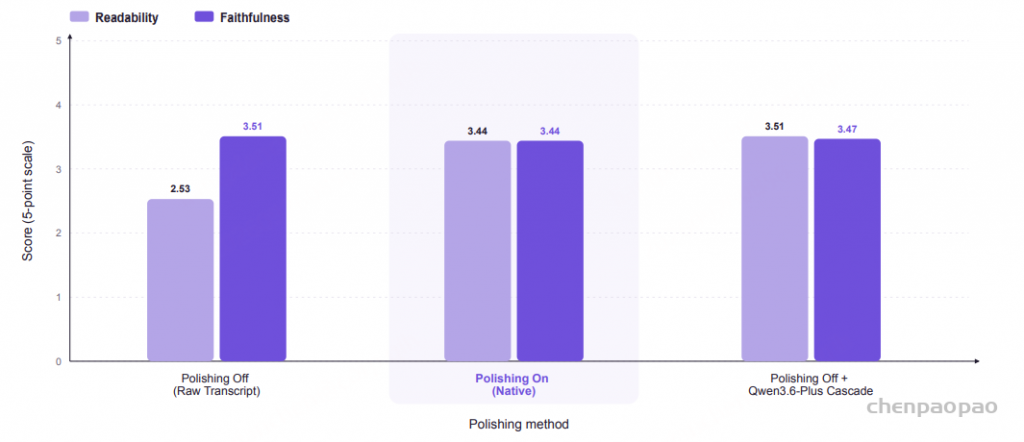
传统做法是 ASR 先输出原始转写,再调用一个 LLM 清理 filler、重复和自我纠正。Qwen-Audio-3.0-ASR 用一个 polishing flag 在同一次自回归解码中选择 verbatim 或 polished 输出。
内部 5 分制评测中,原始输出可读性为 2.53,原生润色提升到 3.44;忠实度为 3.44,与两次调用的 ASR + Qwen3.6-Plus 级联方案 3.47 接近,但只需要一次推理。代表性行为包括删除 um/uh、消除 the the the、解析 false start、补充标点并规范缩写。
7.6 流式延迟-准确率:400 ms 是一个可用折中点
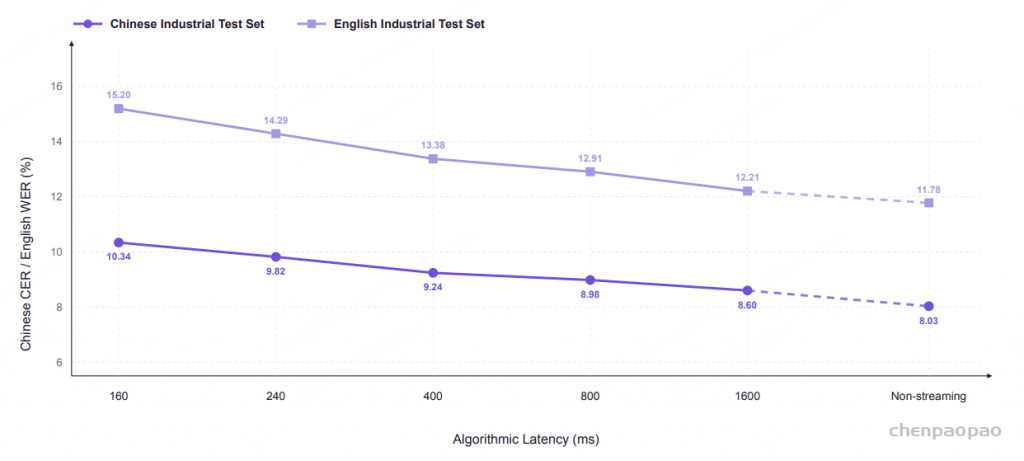
随着 algorithmic latency 增加,中文 CER 和英文 WER 持续下降;非流式模式准确率最低。论文给出 400 ms 延迟点的结果:中文 CER 9.24%、英文 WER 13.38%;非流式分别为 8.03% 和 11.78%,相对错误率增加约 15.1% 和 13.6%。这说明系统可以按产品需求在响应速度和准确率之间选 operating point。
八、创新点总结:真正有价值的不是单个模块,而是组合方式
- MoE LLM-ASR:以 Qwen MoE 替换 Dense Decoder,在增加语言/世界知识容量的同时控制 token 级计算。
- 统一 instruction-controlled ASR:语言、历史上下文、热词和润色不是外挂,而是同一解码接口中的条件。
- 分层 P0/P1 热词:用优先级和证据约束同时优化长尾召回和错误插入。
- 原生单次润色:把“识别 + 可读化”放到一次生成中,减少后处理延迟。
- 上下文缓存式长音频建模:利用此前已确认的文本维持跨句实体一致性,不依赖人工热词维护。
- FunVerl-ASR 异步 RL:针对音频大模型补齐 rollout、奖励和训练的异步系统,并用复合 reward 优化真实业务目标。
- 流式与全上下文结合:实时给反馈,结束后再用完整音频刷新最终文本。
九、如何理解论文的实验优势
从公开 Benchmark 看,Qwen-Audio-3.0-ASR 的优势是整体均衡:中文和英文各有多个测试集领先,多语言宏平均在 GigaSpeechBench 和 Common Voice 15 上领先。从工业集看,最明显的提升集中在通用 CER/WER 难以表达的部分:方言一致性、行业实体、热词、跨句上下文和可读性。
更准确地说,论文证明的不是“每个数据集都第一”,而是“一个统一模型可以同时覆盖多种生产约束”。这对会议记录、客服质检、跨境语音输入和企业知识场景,比只看单一测试集的 SOTA 排名更有意义。
十、局限性
- Panel A 不完全可比:官方结果可能使用不同预处理、参考文本和评分协议。作者也建议优先参考统一 API 的 Panel B。
- 大量工业测试集未公开:15 行业实体、16 方言、润色和流式延迟的内部数据有较强应用价值,但外部研究者难以完整复现。
- MoE 规模信息有限:论文强调稀疏激活带来的效率,但没有在报告中完整披露总参数、激活参数、专家数量和详细吞吐。
- LLM Judge 可能引入评测偏差:方言一致性使用 Qwen3.7-Max,部分 reward 也支持 LLM Judge;这适合产品质量评估,但需要独立人工标注或跨模型验证。
- 上下文和热词不是无条件增益:论文反复强调音频是第一证据,错误、过时或冲突的 context/hotword 不应被模型机械复制。
- 低延迟仍有代价:低于 200 ms 的 first-token latency 与非流式准确率并非同时达到,实际部署必须根据业务选择 operating point。
十一、结语
Qwen-Audio-3.0-ASR 的核心贡献,可以概括为一句话:它把 ASR 从“音频到文字”的单一任务,升级成“音频 + 指令 + 上下文 + 业务词表 -> 可直接使用文本”的统一生成系统。
其工程路线也很清晰:用数千万小时数据建立规模基础,用 Qwen MoE 提供语言和世界知识,用 SFT 把产品控制信号统一进解码,用异步 GRPO 直接优化 CER、热词、上下文和幻觉指标,再通过 streaming/full-context 和 Message ASR 落到低延迟业务。公开基准证明了竞争力,工业测试则说明它的真正卖点在长尾实体、方言、上下文和可读性。
如果把这篇报告放到 ASR 的发展脉络里看,它的重要性不只是“又一个更大的模型”,而是尝试回答一个更实际的问题:在多语言、长音频、动态热词和低延迟约束同时存在时,能否用一个可控的音频大模型替代多套串联系统。Qwen-Audio-3.0-ASR 给出的答案是肯定的,但其内部数据、模型规模和评测可复现性仍值得后续公开与验证。
参考资料:
1. Qwen-Audio-3.0-ASR Technical Report, arXiv:2609.07549v2, https://arxiv.org/abs/2609.07549
2. Nova Speech,《最新工业SOTA转写模型:Qwen-Audio-3.0-ASR》,https://mp.weixin.qq.com/s/_jWVjU0XslOw31WPAjhEdg