- https://github.com/NVIDIA-NeMo/Speech
- https://huggingface.co/blog/nvidia/nemotron-transcribe-granary
- https://github.com/NVIDIA-NeMo/Curator/tree/main/tutorials/audio/granary_v2
一、核心结论
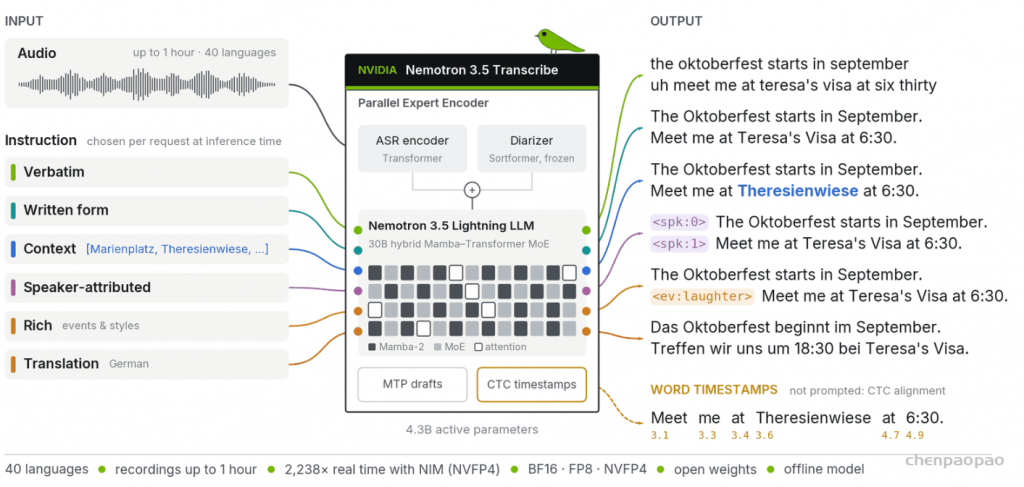
- Nemotron 3.5 ASR Streaming 是约 0.6B 参数的多语言流式 ASR。
- 核心架构是 24 层 Cache-Aware FastConformer 编码器、RNN-T 解码器和语言 ID Prompt Conditioning。
- 声学表示维度为 1024,语言向量为 128 维;一个 checkpoint 支持 40 个 language locale。
- 运行时支持 80 ms、160 ms、320 ms、560 ms、1.12 s 五个 chunk 配置。
- FLEURS 上,Transcription-ready 19 个 locale 的平均 LangID WER 从 80 ms 的 10.38% 降到 1.12 s 的 8.84%;Auto-detect 从 11.14% 降到 9.21%。
- 单张 H100 上,80 ms 时约支持 240 路并发流,Parakeet RNNT 1.1B buffered streaming 约 14 路;1.12 s 时约为 2,400 路对 400 路。
设计目标不是只追求离线 WER,而是在准确率、端到端延迟、显存和并发之间提供可调的 Pareto 点。
二、模型架构
2.1 Cache-Aware FastConformer
FastConformer 结合卷积对局部声学模式的建模能力和注意力对长程依赖的建模能力。Nemotron 3.5 使用 24 层 Cache-Aware FastConformer。缓存同时覆盖 self-attention 和 convolution 状态,因此当前 chunk 可以复用上一 chunk 的隐藏状态。
设第 k 个音频块为 x_k,上一步缓存为 C_(k-1):
\((H_k, C_k) = Encoder(x_k, C_(k-1))\)传统 buffered streaming 会把上一段上下文与当前音频重新拼接,导致重叠帧重复计算;Cache-Aware 方案只计算新到达的帧,缓存负责保留上下文。
2.2 语言 ID Prompt Conditioning
编码器输出 H_a 的形状是 (1024,T)。语言 ID 被编码为 128 维向量 e_lang,沿时间轴广播为 H_l,二者拼接后经过投影层送入 RNNT:
\(H_a = FastConformer(x_1:T), H_a in R^(1024 x T)\) \(H_l = Broadcast(e_lang,T), e_lang in R^128\) \(H_f = Proj([H_a;H_l]), [H_a;H_l] in R^(1152 x T)\)已知语言时可以输入 en-US、de-DE、zh-CN 等 locale;未知语言时使用 auto 模式。语言向量是每个时间帧都可见的条件信号,而不是附加在最终文本后的标签。
2.3 RNN-T
RNN-T 用 prediction network 建模已输出的 token 历史,用 joint network 融合声学状态与标签状态:
\(z_(t,u) = f_joint(h_t,g_u), P(y_(t,u)|x,y_<u) = softmax(z_(t,u))\)它能在音频流持续到达时逐步发射 token,比必须等待整段音频的离线 encoder-decoder 更适合实时语音代理。
三、创新点
- 缓存级流式计算,减少 buffered streaming 的重叠重算。
- 语言提示让一个共享 checkpoint 覆盖多语言 locale。
- chunk size 可在推理时切换,不需要重新训练。
- 原生支持 punctuation 和 capitalization。
- 0.6B 参数配合缓存式推理,在 H100 上获得高并发。
四、训练数据:规模、来源与标签
官方模型卡给出的训练数据范围是 10,000 到 1,000,000 小时,覆盖 40 个 language locale。来源包括 NVIDIA Riva multilingual ASR training set(专有)、NVIDIA Granary、Multilingual LibriSpeech、Mozilla Common Voice、FLEURS、VoxPopuli 和 Europarl-ASR。
训练标签包括人工标签和合成标签。合成 ASR 标签来自 Canary、Parakeet Multilingual 1.1B RNNT、Parakeet CTC 1.1B、Whisper large-v3 与 FunASR 的模型集成;标点和大小写由 Qwen3-32B 生成:
\(y_hat_i = Consensus(Canary(x_i), Parakeet(x_i), Whisper(x_i), FunASR(x_i))\) \(y_PnC_i = Qwen3-32B(y_hat_i, language_i)\)Consensus 不能被擅自解释为简单多数投票,因为官方没有披露集成规则。工程上还应结合语言一致性、字符速率、重复检测、空输出和长度比过滤。
4.1 Granary 数量级
Granary 覆盖 25 种欧洲语言,聚合规模约 1M 小时;ASR 侧约 643,238 小时,AST 侧约 351,000 小时。
| 来源 | 语言数 | 过滤后小时数 | 格式 |
|---|---|---|---|
| YODAS-Granary | 23 | 192,172 | 16 kHz WAV |
| VoxPopuli | 24 | 206,116 | FLAC |
| YouTube-Commons | 24 | 122,475 | WAV |
| LibriLight | 英语 | 约 23,500 | FLAC |
| ASR 合计 | 25 | 643,238 | 混合格式 |
Granary 主要提供 NeMo JSONL manifest 和元数据,部分来源需要另行下载音频。典型字段包括 audio_filepath、text、source_lang、target_lang、original_source_id 和 dataset_source。
五、训练阶段
- 阶段 A:收集和统一 manifest。保留路径、时长、采样率、语言、来源、许可证和原始 ID。
- 阶段 B:切分、VAD、说话人和语言质检。检查时长、静音比例、字符速率、语言一致性、空文本和异常重复。
- 阶段 C:多模型伪标注与 PnC。生成候选、做一致性筛选,再用 Qwen3-32B 统一标点和大小写。
- 阶段 D:流式多语言 ASR 训练。使用 Cache-Aware FastConformer-RNNT、语言 ID 条件和混合多语言数据。
- 阶段 E:多延迟点评测。以 80 ms 为基本帧,测试 80 ms、160 ms、320 ms、560 ms、1.12 s。
六、Granary v2 流水线
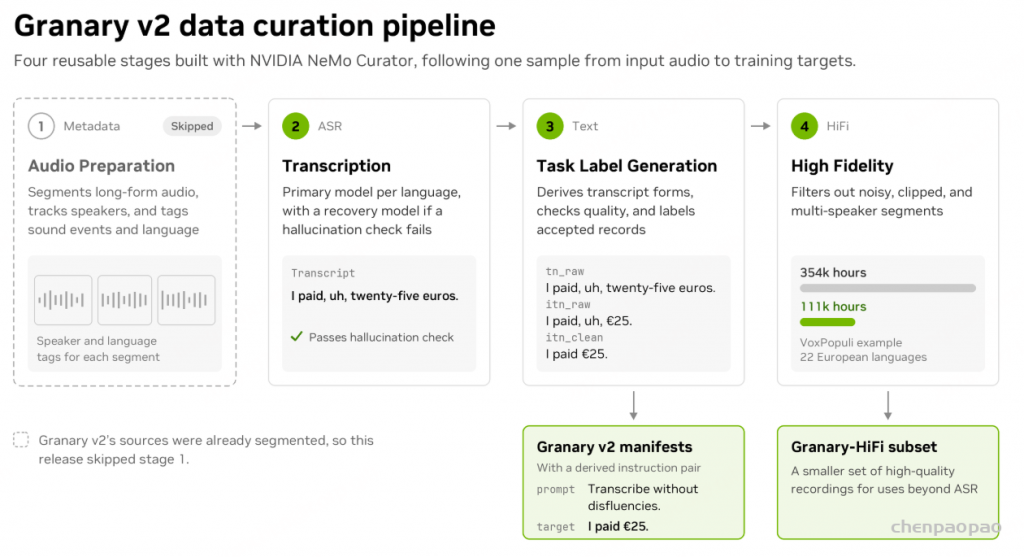
Granary v2 把原始录音加工成带元数据、可追溯、可继续处理的训练数据。官方教程包括 Metadata extraction、Indic ASR、Qwen Omni ASR 和 Text pipeline。
6.1 Metadata extraction
- 读取 recording manifest,重采样到单声道 16 kHz WAV。
- Sortformer 做说话人分离并输出 RTTM。
- Silero TensorRT VAD 切分语音段。
- CNN14 TensorRT 预测声音事件。
- SpeechBrain、Indic Canary、Whisper 做多级语言识别。
- 根据一致性选择 source_lang,保留拒绝原因。
- 片段编码为 Opus,并写出 JSONL metadata。
没有语音的录音保留 vad_empty 审计行;语言意见不一致时保留 skip 标记和预测结果,避免把“无语音”和“文件缺失”混为一谈。
6.2 Indic ASR
Hindi 示例有 11 个阶段:读取 manifest;准备单声道 16 kHz 音频;Canary 主转写;主结果 hallucination 检查;Parakeet 恢复候选;恢复结果检查;选择最佳预测;正则清洗;缩写合并;计算 WER;写回 JSONL。两个 ASR 模型会对每个有效片段都运行。
示例限制 0.5 到 40 秒;最终字段包括 primary_model_prediction、fallback_model_prediction、best_prediction、cleaned_text、abbreviated_text 和 wer_pct。
6.3 Qwen Omni ASR 与 Text pipeline
Qwen3-Omni 生成主转写,已有 transcript 只作为回退文本,不发送给 Qwen。随后执行规则型 hallucination 检查、最佳预测选择、标点和空白清理、缩写合并。Text pipeline 不读取音频,负责实体恢复、PnC、语言识别与验证、逆文本规范化、captioning、code switching 和 speech QA。
6.4 Xenna 与 Ray Data 吞吐
| 管道 | 基准数据 | Xenna | Ray Data |
|---|---|---|---|
| Metadata | 30,631 录音 / 107.76357 小时 | 472.309 audio-hours/hour | 166.251 |
| Indic ASR | 216,164 Hindi 片段 / 531.75763 小时 | 3,604.471 | 387.649 |
| Qwen Omni ASR | 22,710 英语片段 / 80.61259 小时 | 406.615 | 228.424 |
| Text pipeline | 14,290 行 transcript | 30.283 rows/s | 12.217 rows/s |
官方对比使用 8 张 H100 80 GB GPU、相同 cohort、镜像、模型和 stage 设置。音频管道吞吐包含模型启动时间;Text pipeline 复用了已启动的模型服务器。
七、实验对比:FLEURS 与流式延迟
| 分组 | 模式 | 80 ms | 160 ms | 320 ms | 560 ms | 1.12 s |
|---|---|---|---|---|---|---|
| Transcription-ready 19 locales | LangID 平均 WER | 10.38 | 10.00 | 9.49 | 9.12 | 8.84 |
| Transcription-ready 19 locales | Auto-detect 平均 WER | 11.14 | 10.67 | 10.05 | 9.63 | 9.21 |
| Broad-coverage 13 locales | LangID 平均 WER | 25.86 | 25.14 | 24.11 | 23.09 | 22.13 |
| Broad-coverage 13 locales | Auto-detect 平均 WER | 27.62 | 26.65 | 25.41 | 24.44 | 23.09 |
在 1.12 s、LangID 条件下,官方表中英语 WER 为 7.91%,西班牙语 4.11%,意大利语 4.25%,葡萄牙语 5.48%,Hindi 6.81%,德语 8.31%,法语 9.03%,俄语 9.17%,乌克兰语 13.07%。Hindi 在 80 ms 下 LangID 为 8.13%,Auto-detect 为 11.47%;1.12 s 下分别为 6.81% 和 8.23%。日语、韩语和普通话使用 CER。
chunk 增大通常带来更多右侧上下文,平均 WER 下降但等待时间上升:
\(WER(c_1) >= WER(c_2), c_1 < c_2\)八、吞吐对比与系统意义
| 配置 | Nemotron 3.5 ASR | Parakeet RNNT 1.1B | 优势 |
|---|---|---|---|
| 80 ms | 约 240 路 | 约 14 路 | 约 17 倍 |
| 1.12 s | 约 2,400 路 | 约 400 路 | 约 6 倍 |
优势来自参数规模、缓存复用、chunk 粒度和 H100 推理实现的共同作用,而不是单纯参数更小:
\(Cost_per_stream proportional to GPU_hourly_cost / sustainable_concurrent_streams\)