YODAS v3 论文拆解:110 万小时高带宽立体声多语言语料,如何从检索到训练落地

一、论文到底贡献了什么

YODAS v3 的核心贡献不是提出一个新的 ASR 网络,而是提出一套面向大规模、多语言、宽带和立体声语音的数据构建方法,并用两个基线任务验证数据是否可用。论文将开源语音数据的瓶颈概括为三点:大量语料仍是 16 kHz 或 24 kHz 单声道;中低资源语言在通用网页检索中容易被高资源语言挤压;仅有音频时长而没有字幕、翻译和时间戳,难以直接用于监督训练。

二、和已有开源语音语料相比,YODAS v3 的位置

论文 Table 1 使用论文撰写时的统一口径比较规模、采样率、立体声、标注与许可证。下面完整保留该表的关键数字;“Stereo”表示数据集是否以立体声或多声道为主要发布形态,而不是说每一个文件都一定有两个互不相同的声道。

数据集语言数规模(小时)采样率立体声有标注许可证
Common Voice13733k48 kHz否是CC0
MLS851k16 kHz否是CC BY 4
FLEURS1021k16 kHz否是CC BY 2.5
VoxLingua1071077k16 kHz否是CC BY 4
LibriLight160k16 kHz否否CC BY 4
VoxPopuli23400k16 kHz否否CC0
Emilia6100k24 kHz否是CC BY-NC 4
Unsupervised People’s Speech89740k48 kHz是否CC BY-SA 4
YODAS v2140550k24 kHz否是CC BY 3
YODAS v31471100k48 kHz是弱标注CC BY 3
表 1:论文中的开源大规模语音数据集比较。

这里的“147 languages”需要谨慎理解。论文分析章节按 YouTube 上传者提供的 locale 统计,locale 是语言分布的代理字段,不是对每段音频进行人工或模型语音识别后的金标准语言标签。当前 Hugging Face 数据卡又提供了 transcript_lang 目录,因此会出现 103 个目录(102 个语言码加 unk)与论文 147 个 locale 代码并存的情况;二者是不同字段、不同统计问题,并不矛盾。

从 Table 1 看,v3 相比 v2 的名义时长约翻倍,并保留更高采样率与多声道;相比 Unsupervised People’s Speech,则额外提供可用于监督训练的字幕。但表中的“有标注”只表示存在标注机制,不能解释为全部音频都有人工标注。

三、数据采集流水线:从 Wikipedia 关键词到 Creative Commons 视频

3.1 关键词生成:解决“用英文搜全世界”的偏置

YODAS v2 复用共享的多语言 Wiki 关键词列表,容易出现两类错误:低资源语言没有足够查询词,以及查询词实际上是英语或其他语言。v3 改成“每种语言单独生成关键词”。作者下载每种语言的 Wikipedia dump,先按规则过滤候选词:不能只有数字或标点;首字符不能是数字或标点;长度限制为 3 至 30 个字符;排除文件名、DOI、Wikipedia Template 和 Request 页面。

接着,作者在每种语言的候选词上训练 unigram subword tokenizer。词表有预设大小;如果候选语料太小,便逐步减半词表直到 tokenizer 能够训练。对候选关键词分词后,用 unigram 语言模型概率排序,保留似然较高且不太罕见的词。论文没有公开固定的词表大小、最终 top-K 数量或每种语言的搜索预算,因此复现时应把这几个量视为需要自行设定的工程超参数。

\(\log P(w)=\sum_{i=1}^{m}\log p(s_i),\quad w=(s_1,s_2,\ldots,s_m)\)

上式是对论文步骤的工程化表达:将关键词 w 切成若干 subword 后累加 unigram 对数概率。它帮助筛掉模板词、极罕见实体和无法代表自然语言内容的条目,但不是论文单独编号的理论创新公式。

3.2 视频搜索:按语言分治,并使用两轮检索
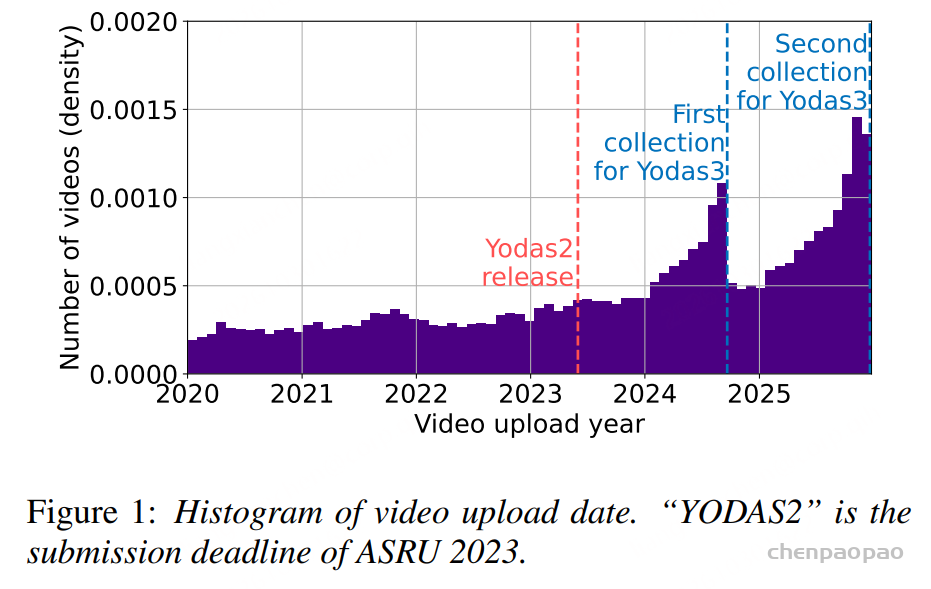
3.3 下载与弱标注

下载时优先使用视频原始语言的人工字幕;没有人工字幕时使用 YouTube 自动字幕。如果存在非英语字幕,还保存英文字幕。每个字幕条目保留开始时间和持续时间,并与音频文件建立 ID 级关联。视频 description 也被保存,论文把它视为未来检索、摘要和多模态任务的潜在信号,而没有在本文实验中单独证明其收益。

v3 中人工字幕占比约 3.7%,低于 v2 的约 20%。作者推测 YouTube 自动字幕质量提升,降低了上传者制作人工字幕的必要性;论文没有提供人工转写对照集、字幕字符错误率或显著性检验,因此不能把“自动字幕质量提升”写成已验证的定量结论。

“3.7%”的分母在论文中没有进一步细分为视频数、句子数还是小时数,因此本文保留原文的占比表述,不据此推算人工字幕小时数。另外,原始视频音轨可以包含音乐、背景噪声和多个声源,110 万小时是抓取音轨时长,并非经过 VAD 验证后的纯语音时长。

阶段输入主要操作输出
关键词各语言 Wikipedia dump规则过滤、unigram tokenizer、似然排序每种语言的查询词
检索语言查询词、YouTubeCreative Commons、两轮搜索、优先新上传、去除 v2 ID候选视频 ID
字幕人工字幕或自动字幕优先原语言,补充英文字幕,保存时间戳弱监督 transcript/translation
音频最高质量视频流下载 48 kHz 多声道 Opus/WebM原始宽带音频
分析音频和字幕元数据语言、时长、带宽、声道、质量过滤数据卡和实验子集
YODAS v3 采集流程的工程化摘要。
论文 Table 2 元数据示例或含义
Channels / Effective channels容器声道数与去除重复后的有效声道数,例:2 / 2
Sampling rate / Max bandwidth解码采样率与最高有效频率,例:48 kHz / 20 kHz
Views / Language观看次数、语言代理标签,例:67 / French
Transcript / Translation原语言字幕与英文翻译
Description视频描述,可为检索或摘要提供上下文
表 2:论文给出的元数据示例。其字段集合不等于当前 Parquet 的完整 schema。

四、数据组成与 Hugging Face 发布结构

数据卡中的 id 是 32 位十六进制字符串,shard 是四位编号。音频文件、JSON 和 Parquet 行应通过同一 id 与 shard 关联,不要假设 tar 内文件顺序与 Parquet 行号一致。transcript 字段通常是 JSON 字符串或 null;解析后可得到 segment 的 start/duration,以及相对于 segment 起点的 word 时间偏移。音频 length 以秒计,字幕时间戳以毫秒记录。

当前默认 preview 配置只是预览集,不代表完整的一百多万小时。完整数据应按语言和 shard 流式处理。论文的下载流水线与 Hugging Face 的打包流水线也不是一回事:前者解释数据如何被发现和筛选,后者解释已经发布的文件如何组织。

data/
  <lang>/
    audio/0000.tar
    audio/0001.tar
    metadata/0000.parquet
    metadata/0001.parquet
  unk/  # 没有字幕语言可用于分组的音频
当前数据卡字段单位 / 解释使用注意
id、shard样本标识、四位分片号以 ID 关联音频与元数据
transcriptJSON 字符串或 nullsegment 时间为毫秒,words.t 是相对 segment.start 的偏移
translation_en英文翻译 JSON 或 null只有句级时间戳;卡片报告约 107 万个视频有该字段
transcript_lang、locale_lang字幕轨语言、上传者 locale文件级字段不代表每一句都使用同一种语言
length秒卡片范围 1–153284,均值约 952;长视频宜分段解码
audio_bitratekbit/s容器码率约 3.6–569,中位数约 122;1461 个视频缺失
max_freq_hzHz,约 35–24000约 28.3 万条缺失,不能直接当作低带宽
estimated_bandwidth_hz等效采样率分档8000、16000、22050、24000、32000、44100 或 null
channels容器声道数1、2、4、6;约 99.8% 为 2
n_distinct_channels实测有效声道数1–5 或 null;581 条分析失败,不能当作单声道
当前 Hugging Face 数据卡的发布字段与统计,不是论文 Table 2 的逐列复制。

75%、60%、95% 分别针对是否有字幕、非英语数据是否有翻译、已有字幕是否包含词时间戳,条件集合不同。尤其不要将“60% 非英语数据有翻译”直接换算为“总量的 60% 都是可训练翻译对”。没有字幕的 unk 数据仍可用于无监督音频建模;带字幕的数据也需要检查原语言与翻译是否覆盖同一时间段。

五、规模与音频属性分析

5.1 语言分布:更均衡,但不是严格均衡

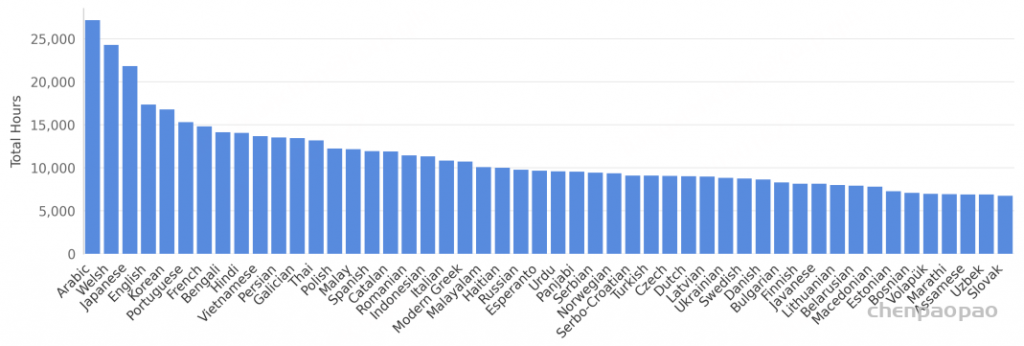
论文统计中,阿拉伯语和威尔士语约 2.5 万小时,日本语约 2.1 万小时,英语约 1.7 万小时且低于总量的 2%;共有 22 种语言超过 1 万小时、73 种语言超过 5000 小时。平均数约 7400 小时而中位数约 5180 小时,说明分布仍然长尾,只是比单纯依靠全球热门查询词更平衡。
5.2 视频时长与有效样本量
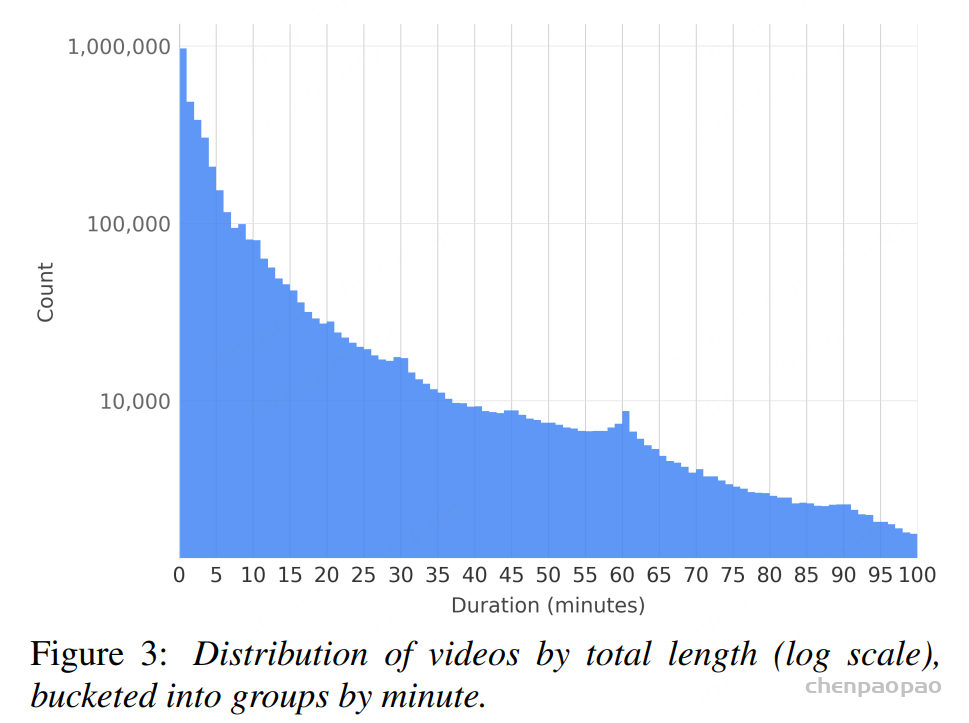
约 400 万个视频中,超过 24% 的视频短于 1 分钟,作者将其与 Shorts 生态联系起来。约 170 万个视频长于 5 分钟,总时长约 100 万小时;约 120 万个视频长于 10 分钟,总时长约 95 万小时。后两个集合是嵌套关系,不能相加。同时数据呈明显长尾分布。约有 400 万个视频(占 24%)少于 1 分钟,作者认为这可能和 YouTube Shorts 的流行有关。论文还指出存在大量超过 60 分钟的直播类视频,但没有给出一个可直接复核的精确小时数。

这组统计提醒我们:总小时数很大,并不意味着每个训练样本都长、都干净或都包含完整对话。做 ASR 时需要按 utterance 切片;做编解码器或空间音频任务时,可能需要重新设计长音频采样和直播片段去重策略。

5.3 48 kHz 不等于每个文件都包含完整 24 kHz 频谱

Opus 解码后可以得到 48 kHz PCM,但上传者的麦克风、混音和编码模式可能只保留较窄频带。论文用 8192 点 Hann 窗、50% 重叠的 STFT 估计最高有效频率:跳过 RMS 不超过 10^-6 的静音帧,找出幅度超过该帧最大幅度 0.5% 的最高频率,再在短视频全程或长视频随机抽取的五个 60 秒片段中取最大值。

\(X_{t,k}=\sum_{n=0}^{N-1}x[n+tH]w[n]e^{-j2\pi kn/N},\quad N=8192,\;H=4096\) \(f_{\mathrm{max}}=\max_{t,k}\{f_k:\lvert X_{t,k}\rvert>0.005\cdot\max_j\lvert X_{t,j}\rvert\}\)

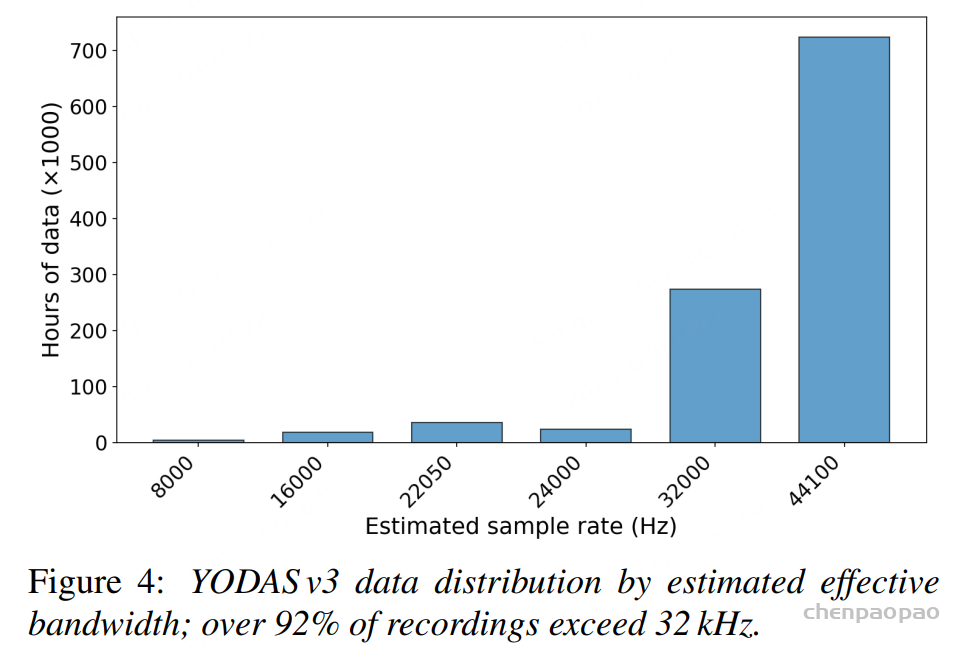
作者把 fmax 映射到候选等效采样率集合 {8, 16, 22.05, 24, 32, 44.1 kHz},选择满足 Nyquist 条件的最小采样率。这里的“44.1 kHz 类”是等效采样率类别,不是说频谱真的延伸到 44.1 kHz;48 kHz PCM 的 Nyquist 频率约为 24 kHz。

结果是:约 67.3% 的数据属于 44.1 kHz 等效带宽类别,论文报告约 92.5% 的数据达到 32 kHz 及以上类别。Figure 4 建议放在本节。这个指标是“检测到的最高频率”而不是对每个片段的主观听感或音乐保真度承诺,噪声、响度和编码伪影都会影响阈值结果。
5.4 多声道与有效声道数

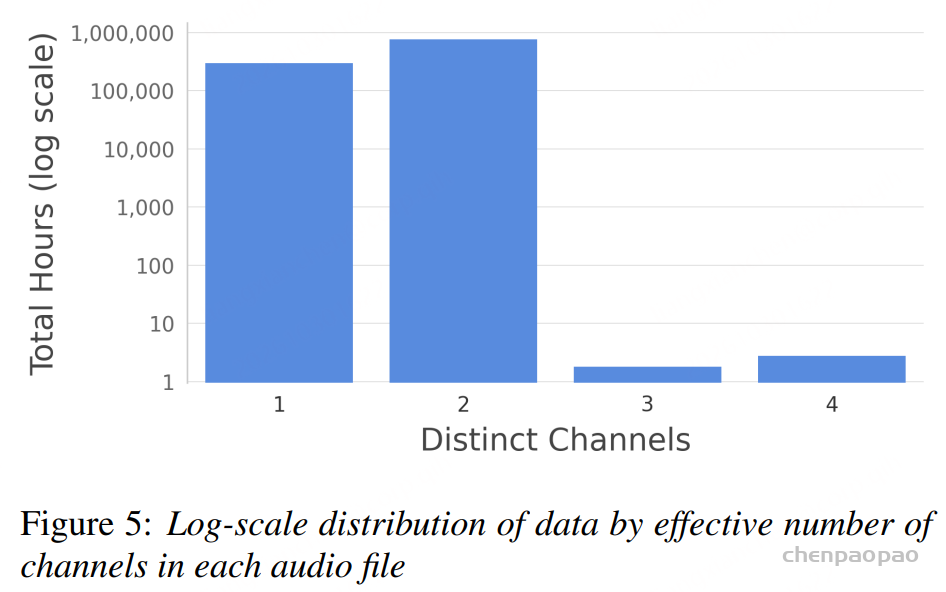
对每个音频文件,论文计算每一对声道的残差 RMS,并用两声道平均 RMS 归一化。若归一化残差低于 10^-3,则将两声道视为有效相同。

\(d_{ij}=\frac{\mathrm{RMS}(x_i-x_j)}{(\mathrm{RMS}(x_i)+\mathrm{RMS}(x_j))/2}\)

超过 71% 的音频文件、约 78 万小时,被判定为真正的多声道;绝大多数是双声道,少量 3 至 4 个有效声道主要来自 5.1 等容器。数据卡还报告约 25% 的视频属于双声道封装但有效单声道的 dual-mono,不能把“容器有两个声道”直接等同于“有空间差异”。不同声道也可能来自音乐混音或编辑后的左右声道,而不是规范的麦克风阵列几何。
六、实验一:ASR 的过滤阈值实验

6.1 实验设置

论文没有训练一个百万小时级的新型语音基础模型,而是使用 OWSM v4 base(约 102M 参数)和 ESPnet,训练 40k steps,验证数据能否支撑多语言 ASR。随机抽取 7 种语言:英语约 4500 小时,德语、法语、日语、葡萄牙语、俄语、越南语各约 100 小时。处理流程固定包含 CTC segmentation 和语言过滤,然后对 CTC 置信分数做分位数过滤。阈值 0.00 表示不做 CTC 分数过滤,但仍然做前面的分段与语言过滤。

Common Voice 作为七种语言的测试集;英语、德语、法语、葡萄牙语、俄语和越南语使用 WER,日语使用 CER。

\(\mathrm{WER}=\frac{S+D+I}{N}\times 100\%,\qquad\mathrm{CER}=\frac{S_c+D_c+I_c}{N_c}\times 100\%\)

这里补充标准指标定义,方便理解表格:S、D、I 分别是替换、删除和插入数,N 是参考词数;CER 改为字符级计数。这不是论文提出的新指标。由于词与字符粒度不同,不能直接拿日语的 27.7 和英语的 15.9 排名判断哪种语言更难。

CTC 分数分位阈值英 WER德 WER法 WER日 CER葡 WER俄 WER越 WER
0.0015.914.417.227.711.115.320.6
0.1015.314.617.829.211.515.421.1
0.2015.315.418.830.912.216.020.8
0.3015.616.321.834.513.416.723.1
表 3:不同 CTC 过滤阈值下的 ASR 结果,数值越低越好。

6.2 如何理解这项“消融”

阈值是 CTC 分数的分位位置,不是一个可以跨模型、跨语言直接比较的绝对置信度分数。将阈值从 0.10 改成 0.30 表示提高分数筛选的严格程度;若要在自己的数据上复现,还需要明确是在每种语言内部还是整个集合上统计分位数,以及 CTC 分数是否做长度归一化。论文正文没有展开这些实现细节。

这是一项围绕数据过滤强度的质量—数量实验,不是模型结构消融。随着阈值从 0.00 提高到 0.30,低分片段被删除得更多,训练数据量下降。六个非英语语言的最佳结果都出现在 0.00;英语在 0.10 和 0.20 达到 15.3,差异很小;越南语在 0.10 到 0.20 还有轻微回落,因此不能把曲线概括成“阈值越低每一种语言必然越好”。

论文将这一点与 YODAS v2 的经验对照:v2 需要较强过滤才能避免超过 100 的 WER,而 v3 即使不做 CTC 分数过滤也能取得可用结果。作者推测原因包括 YouTube 自动字幕质量提高,但没有人工转写金标准、随机种子重复或严格相同数据量控制,因此应把结论写成“观察到的过滤趋势”,而不是普适的最优阈值。

具体看数值,从阈值 0.30 放宽到 0.00,法语 WER 从 21.8 降至 17.2,改善 4.6 个百分点;日语 CER 从 34.5 降至 27.7,改善 6.8 个百分点。这个收益对应“保留更多样本与改变样本质量分布”的联合变化。论文没有报告每个阈值最终保留多少小时,所以无法进一步区分收益究竟来自新增时长、困难样本覆盖还是字幕错误分布。

七、实验二:神经音频编解码器

7.1 设置和基线

作者从 YODAS v3 随机抽取 1200 小时,分别以 16、24 和 48 kHz 训练 DAC 架构,使用 ESPnet-Codec 的官方配置。对照数据为 LibriTTS(585 小时、英语朗读)和 AMUSE(约 33k 小时、包含多语言语音、音乐和声音)。VERSA 工具包在 1000 个视频上做域内测试,并在 LibriTTS 上做域外测试,指标为 STOI 和 WavLM speaker similarity,二者均为越高越好。论文没有声称这是立体声 codec 的专门结构实验,也没有给出比特率、token 帧率和全部模型超参数。

训练数据采样率LibriTTS STOILibriTTS SPKYODAS v3 STOIYODAS v3 SPK
LibriTTS16 kHz0.950.760.740.69
LibriTTS24 kHz0.970.830.800.78
AMUSE16 kHz0.930.740.810.83
AMUSE44 kHz0.950.820.900.77
YODAS v316 kHz0.920.600.820.79
YODAS v324 kHz0.920.660.840.82
YODAS v348 kHz0.970.840.940.90
表 4:Codec 结果。论文表头写作 44 kHz,保留原表口径。

7.2 结果解读

YODAS v3 48 kHz 模型在 LibriTTS 域外测试上达到 STOI 0.97、SPK 0.84,在 YODAS v3 域内测试上达到 STOI 0.94、SPK 0.90。LibriTTS STOI 的 0.97 与 YODAS v3 48 kHz 并列最高,不应写成严格超过;但 YODAS v3 在说话人相似度上取得最高的两个数值。另一方面,较低采样率的 YODAS 模型并不是所有指标都优于基线:例如域外 STOI 仍受训练域、采样率和声音组成影响。

对所有行而言,YODAS 测试集的 STOI 低于 LibriTTS 测试集,符合嘈杂网页音频更难重建的直觉;但 SPK 并不都呈现相同趋势,因此不把“域内更难”推广为每一种指标必然下降。

这个实验支持“宽带、多样化数据有利于 48 kHz codec”的方向性结论,但不能推出所有高采样率任务都会提升,也不能把 STOI 和说话人相似度替代完整的空间听感评测。AMUSE 的数据量约为 33k 小时,远大于 YODAS 实验抽取的 1200 小时,因此表格同时混合了数据量、领域组成和采样率变量,不能单独解释为纯粹的规模定律。

八、结论:YODAS v3 真正解决的是数据形态问题

YODAS v3 的价值不只是把小时数做大,而是把开放语音数据从“单声道、窄带、单一字幕”推进到“宽带、多声道、带时间戳和翻译的弱监督样本”。

YODAS v3 发布了一个规模超过 110 万小时、覆盖 147 种语言的高带宽立体声语音数据集。核心特点可以概括成四点:

  • 第一,规模大。 达到百万小时级,是目前最大的开放语音数据集之一。
  • 第二,语言更均衡。 22 种语言超过 1 万小时,73 种语言超过 5000 小时,英语占比不到 2%。
  • 第三,真正的高带宽和多通道。 92.5% 数据有效带宽超过 32kHz,71% 以上是真正不同的多通道音频。
  • 第四,可以同时支持识别和生成任务。 ASR 实验说明自动转写质量已经比较高;Codec 实验也验证了 48kHz 高带宽数据对于高保真音频建模的价值。

YODAS v3 不只是把开放语音数据堆到 110 万小时,而是第一次把“百万小时、多语言、高带宽、真实立体声”这几个维度真正组合到了一起。

这也使它不再只是一个 ASR 数据集,而是可以进一步服务于 TTS、Audio Codec、语音增强、空间语音等下一代语音模型训练的大规模数据基础。
一些随笔….

最近越来越不敢笃定地谈未来。

以前谈职业规划,我至少还能给自己画一条大致的路线:把基础打牢,做几个有代表性的项目,逐渐从业务实现走向模型设计,再从模型设计走向系统架构。努力也许不会立刻兑现,但大方向似乎是清楚的。

现在这条路线开始变得模糊。

AI coding agent 正在越来越熟练地写代码、改代码、查资料、跑测试、定位 bug、读仓库,甚至能够自己拆任务、自己调用工具、自己评估结果。所谓 RSI,也就是 recursive self-improvement,已经不再只是科幻小说里的概念。我们正在亲眼看着一套由人类创造的系统,开始参与改进自己的工具、流程和能力。

而身处这个时代,没有办法假装这些变化与我无关。

我们亲手造出了会替代自己的工具

我们训练模型,设计数据管道,写推理服务,搭评测体系,优化 GPU 利用率,研究 agent 的工具调用和记忆机制。我们把自己的经验拆成代码、文档、流程和规则,再把这些东西交给模型学习。我们希望它更聪明、更便宜、更稳定、更自动化。

然后有一天,我们突然发现:模型正在学习的,正是我们过去赖以谋生的那部分能力。

它会写一个函数,于是初级开发工作减少了;它会完成一个模块,于是一些执行型岗位开始减少了;它能端到端地跑完一个实验,于是过去需要几个人协作的工作变成了一个人加几个 agent。公司看见的不是“技术进步”四个字,而是交付周期缩短、人员数量下降和成本表上的数字变小。

人类创造了 AI,却首先用它来压缩自己的劳动价值。这听起来像背刺,但如果站在企业的财务表上,它又可能被包装成效率提升、组织升级和结构优化。

真正残酷的是,背刺并不来自某个恶意的 AI。它来自我们共同参与建立的激励机制:谁能用更少的人做出更多的事,谁就更有竞争力;谁拒绝使用自动化,谁就可能先被淘汰。

所以我无法背道而驰。

不能因为害怕被替代,就拒绝使用 AI coding agent;不能因为担心岗位消失,就拒绝学习新的模型和工具;不能因为不喜欢这场变化,就假装它不会发生。

只能裹挟着前进。

当下应该如何面对

面对 AI,最容易掉进两个极端:要么把它当成救世主,觉得只要学会几个工具就能解决一切;要么把它当成敌人,拒绝使用,试图用过去的工作方式守住自己的位置。

更愿意把它看成一种新的工作环境。环境已经变了,首先要做的不是表态,而是建立自己的工作方法。

让我在变化发生时更清醒、更有行动能力,而不是完全依赖某个工具或某个岗位定义自己。

“算法工程师”这个身份正在被重新拆解

我以前把算法工程师理解成一个相对完整的角色:理解问题,设计模型,处理数据,训练和调参,部署服务,跟踪指标,最后把效果交付给业务。

但 AI 正在把这个角色拆开。

数据清洗可以被自动化,baseline 可以被快速生成,训练脚本可以由 agent 编写,实验配置可以自动搜索,部署流程可以被模板化,线上日志可以交给模型分析。过去需要工程师亲自完成的许多步骤,正在变成“提出目标—监督执行—验证结果”。

这会让很多人感到失落,因为我们曾经用大量时间换来的熟练度,正在变成工具的一次调用。

但这也逼着我们重新回答一个问题:如果写代码、调参数和跑实验不再构成全部价值,那么算法工程师究竟还剩下什么?

我现在越来越相信,真正难以被替代的,不是某个具体 API,也不是某种模型结构,而是以下几种能力的组合:

第一,定义问题的能力。知道什么值得做,什么指标只是幻觉,什么需求本质上是数据问题、产品问题或组织问题。

第二,判断结果的能力。模型可以生成十个方案,但它不会自动承担错误决策的后果。知道什么时候相信结果,什么时候怀疑结果,什么时候回到原始数据和业务现场,这仍然需要人。

第三,把不确定性变成系统的能力。真正的工程不是让 demo 跑起来,而是让它在脏数据、异常输入、成本约束、延迟要求和业务变化下仍然可控。

第四,理解现实世界的能力。医疗、金融、制造、教育、能源、内容安全,每个领域都有自己的规则和代价。模型知识可以迁移,责任不能凭空迁移。

第五,和人一起做事的能力。算法最终要进入组织、产品和客户的工作流。能不能把复杂问题讲清楚,能不能推动不同角色达成共识,能不能在失败之后继续合作,决定了技术是否真的产生价值。

这些能力听起来不像过去那种容易写进简历的“硬技能”,但它们可能会成为 AI 普及后最重要的部分。

问题在于,环境不会因为这些能力重要,就自动给我们足够时间去培养。我们必须一边完成当下的工作,一边学习新工具,一边重新理解自己的专业价值。

真正身处的困境:未来需要更高阶的能力,但变化本身已经在今天发生。

我不想把“拥抱 AI”说成一句轻松的话

我不太喜欢“拥抱变化”这类过于顺滑的表达。变化不是发布会上的新功能,而是每天都会进入工作流程的新工具、新标准和新期待。说“你要积极拥抱 AI”,有时只是把系统性的压力重新交给个人,让个人为一场并非由自己决定的技术竞赛负责。

使用 AI,是因为我必须参与这场变化;但保持警惕,是因为参与不等于认同所有结果。

我希望把什么留在自己手里

想留下的不是某个项目的名字,而是对问题的理解方式;不是一次性的结果,而是如何做数据分析、如何设计实验、如何评估模型;不是某个框架的熟练度,而是能否快速进入一个陌生系统并找到关键路径。

希望把几个东西握在自己手里:对技术边界的理解,对问题价值的判断,对结果负责的习惯,以及持续学习和独立思考的能力。

这不是为了获得一种永远稳定的状态,而是为了在环境变化时,不至于完全失去方向。

我们可能需要重新定义“前进”

过去的前进,常常意味着更高的职级、更大的团队、更复杂的项目和更高的薪资。

这些当然仍然重要,但在 AI 时代,我希望“前进”还包括另一层含义:让自己的判断、作品、关系和生活,不再全部依附于一个组织的评价。

也许未来一个算法工程师不再需要亲自写完所有代码,但必须比以前更懂系统;不再需要独自完成全部实验,但必须更会设计实验;不再只是训练模型,而要决定模型应该被用来解决什么问题,以及什么时候不应该使用它。

也许我们无法阻止企业用 AI 降低人员需求,但可以尽量避免让自己只剩下可被单价比较的执行能力。

这并不意味着每个人都能轻松转型。现实没有这么公平。有人会因为家庭、年龄、地域、健康或经济压力,无法无缝进入下一个阶段。把一切归因于“学习不够努力”,只是对具体处境的忽视。

我们能做的,是尽量让自己的价值不只存在于某个岗位描述里,让自己的能力可以迁移,让自己的判断不被单一工具代替,让自己的生活仍然保留一点主动性。

我没有答案,但我不想把自己交给答案

我不知道 AI coding agent 最终会改变多少算法工作,也不知道 RSI 会把软件生产推到什么程度。我不知道“算法工程师”这个称呼会不会变成一个过渡性的历史名词。

但我不想用过度乐观来掩盖恐惧,也不想用彻底悲观来提前放弃。

我会继续学习 AI,因为我没有办法背道而驰;我会继续使用 agent,因为停在原地不会让世界停下来;我会继续怀疑这条路,因为技术进步不等于每个人都会因此获益。

人类创造了能够放大生产力的工具,但没有同时解决收益、权力和安全感如何分配的问题。

所以我们面对的,不只是“AI 会不会替代我”这个问题,还包括:当我的工作被重新定义,我希望自己成为什么样的人?当效率不再稀缺,我还能不能保留判断、责任、创造和同理心?当未来越来越不确定,我能不能为自己建立一点不依赖承诺的退路?

我暂时没有答案。

我只是决定,一边害怕,一边继续走;一边使用工具,一边观察工具正在改变什么;一边为最坏的结果做准备,一边不把最坏的结果当成唯一的结局。

这可能不是勇敢。

但至少,这是我在被裹挟着前进时,仍然能够保留的一点主动权。

Nemotron 3.5 Transcribe 深度拆解:Cache-Aware FastConformer-RNNT 与 Granary v2 语音数据工厂

\(P(y_{1:T}\mid x)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x)\)

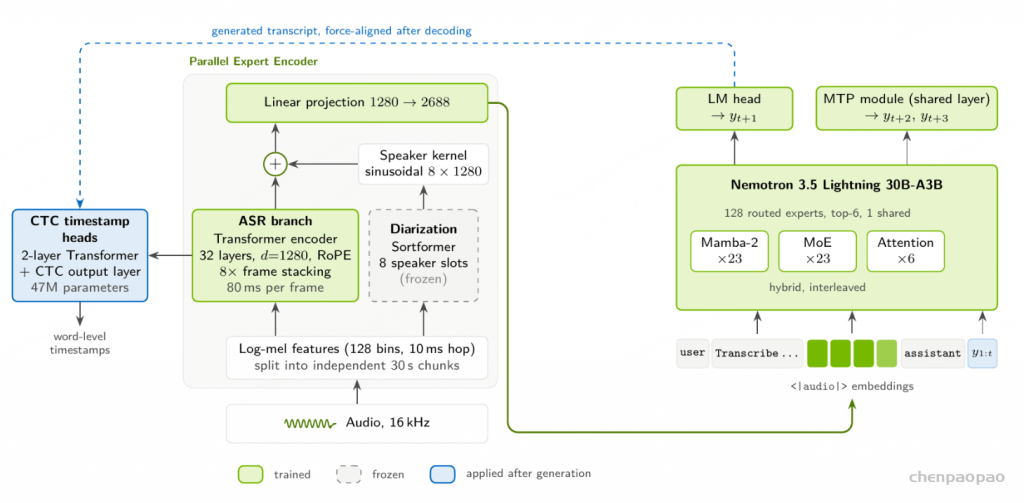
一、核心结论

  • Nemotron 3.5 ASR Streaming 是约 0.6B 参数的多语言流式 ASR。
  • 核心架构是 24 层 Cache-Aware FastConformer 编码器、RNN-T 解码器和语言 ID Prompt Conditioning。
  • 声学表示维度为 1024,语言向量为 128 维;一个 checkpoint 支持 40 个 language locale。
  • 运行时支持 80 ms、160 ms、320 ms、560 ms、1.12 s 五个 chunk 配置。
  • FLEURS 上,Transcription-ready 19 个 locale 的平均 LangID WER 从 80 ms 的 10.38% 降到 1.12 s 的 8.84%;Auto-detect 从 11.14% 降到 9.21%。
  • 单张 H100 上,80 ms 时约支持 240 路并发流,Parakeet RNNT 1.1B buffered streaming 约 14 路;1.12 s 时约为 2,400 路对 400 路。

设计目标不是只追求离线 WER,而是在准确率、端到端延迟、显存和并发之间提供可调的 Pareto 点。

二、模型架构

2.1 Cache-Aware FastConformer

FastConformer 结合卷积对局部声学模式的建模能力和注意力对长程依赖的建模能力。Nemotron 3.5 使用 24 层 Cache-Aware FastConformer。缓存同时覆盖 self-attention 和 convolution 状态,因此当前 chunk 可以复用上一 chunk 的隐藏状态。

设第 k 个音频块为 x_k,上一步缓存为 C_(k-1):

\((H_k, C_k) = Encoder(x_k, C_(k-1))\)

传统 buffered streaming 会把上一段上下文与当前音频重新拼接,导致重叠帧重复计算;Cache-Aware 方案只计算新到达的帧,缓存负责保留上下文。

2.2 语言 ID Prompt Conditioning

编码器输出 H_a 的形状是 (1024,T)。语言 ID 被编码为 128 维向量 e_lang,沿时间轴广播为 H_l,二者拼接后经过投影层送入 RNNT:

\(H_a = FastConformer(x_1:T), H_a in R^(1024 x T)\) \(H_l = Broadcast(e_lang,T), e_lang in R^128\) \(H_f = Proj([H_a;H_l]), [H_a;H_l] in R^(1152 x T)\)

已知语言时可以输入 en-US、de-DE、zh-CN 等 locale;未知语言时使用 auto 模式。语言向量是每个时间帧都可见的条件信号,而不是附加在最终文本后的标签。

2.3 RNN-T

RNN-T 用 prediction network 建模已输出的 token 历史,用 joint network 融合声学状态与标签状态:

\(z_(t,u) = f_joint(h_t,g_u), P(y_(t,u)|x,y_<u) = softmax(z_(t,u))\)

它能在音频流持续到达时逐步发射 token,比必须等待整段音频的离线 encoder-decoder 更适合实时语音代理。

三、创新点

  • 缓存级流式计算,减少 buffered streaming 的重叠重算。
  • 语言提示让一个共享 checkpoint 覆盖多语言 locale。
  • chunk size 可在推理时切换,不需要重新训练。
  • 原生支持 punctuation 和 capitalization。
  • 0.6B 参数配合缓存式推理,在 H100 上获得高并发。

四、训练数据:规模、来源与标签

官方模型卡给出的训练数据范围是 10,000 到 1,000,000 小时,覆盖 40 个 language locale。来源包括 NVIDIA Riva multilingual ASR training set(专有)、NVIDIA Granary、Multilingual LibriSpeech、Mozilla Common Voice、FLEURS、VoxPopuli 和 Europarl-ASR。

训练标签包括人工标签和合成标签。合成 ASR 标签来自 Canary、Parakeet Multilingual 1.1B RNNT、Parakeet CTC 1.1B、Whisper large-v3 与 FunASR 的模型集成;标点和大小写由 Qwen3-32B 生成:

\(y_hat_i = Consensus(Canary(x_i), Parakeet(x_i), Whisper(x_i), FunASR(x_i))\) \(y_PnC_i = Qwen3-32B(y_hat_i, language_i)\)

Consensus 不能被擅自解释为简单多数投票,因为官方没有披露集成规则。工程上还应结合语言一致性、字符速率、重复检测、空输出和长度比过滤。

4.1 Granary 数量级

Granary 覆盖 25 种欧洲语言,聚合规模约 1M 小时;ASR 侧约 643,238 小时,AST 侧约 351,000 小时。

来源语言数过滤后小时数格式
YODAS-Granary23192,17216 kHz WAV
VoxPopuli24206,116FLAC
YouTube-Commons24122,475WAV
LibriLight英语约 23,500FLAC
ASR 合计25643,238混合格式

Granary 主要提供 NeMo JSONL manifest 和元数据,部分来源需要另行下载音频。典型字段包括 audio_filepath、text、source_lang、target_lang、original_source_id 和 dataset_source。

五、训练阶段

  • 阶段 A:收集和统一 manifest。保留路径、时长、采样率、语言、来源、许可证和原始 ID。
  • 阶段 B:切分、VAD、说话人和语言质检。检查时长、静音比例、字符速率、语言一致性、空文本和异常重复。
  • 阶段 C:多模型伪标注与 PnC。生成候选、做一致性筛选,再用 Qwen3-32B 统一标点和大小写。
  • 阶段 D:流式多语言 ASR 训练。使用 Cache-Aware FastConformer-RNNT、语言 ID 条件和混合多语言数据。
  • 阶段 E:多延迟点评测。以 80 ms 为基本帧,测试 80 ms、160 ms、320 ms、560 ms、1.12 s。
\(D_train = Filter(Normalize(D_public union D_private))\) \(theta* = argmin_theta E[-log P_theta(y | x, language)]\)

六、Granary v2 流水线

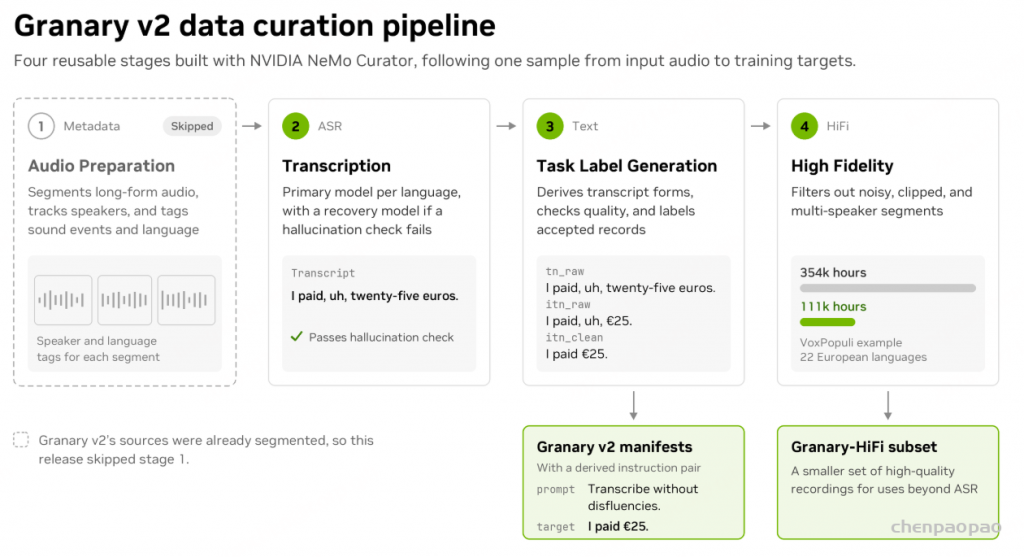
Granary v2 把原始录音加工成带元数据、可追溯、可继续处理的训练数据。官方教程包括 Metadata extraction、Indic ASR、Qwen Omni ASR 和 Text pipeline。

6.1 Metadata extraction

  • 读取 recording manifest,重采样到单声道 16 kHz WAV。
  • Sortformer 做说话人分离并输出 RTTM。
  • Silero TensorRT VAD 切分语音段。
  • CNN14 TensorRT 预测声音事件。
  • SpeechBrain、Indic Canary、Whisper 做多级语言识别。
  • 根据一致性选择 source_lang,保留拒绝原因。
  • 片段编码为 Opus,并写出 JSONL metadata。

没有语音的录音保留 vad_empty 审计行;语言意见不一致时保留 skip 标记和预测结果,避免把“无语音”和“文件缺失”混为一谈。

6.2 Indic ASR

Hindi 示例有 11 个阶段:读取 manifest;准备单声道 16 kHz 音频;Canary 主转写;主结果 hallucination 检查;Parakeet 恢复候选;恢复结果检查;选择最佳预测;正则清洗;缩写合并;计算 WER;写回 JSONL。两个 ASR 模型会对每个有效片段都运行。

示例限制 0.5 到 40 秒;最终字段包括 primary_model_prediction、fallback_model_prediction、best_prediction、cleaned_text、abbreviated_text 和 wer_pct。

6.3 Qwen Omni ASR 与 Text pipeline

Qwen3-Omni 生成主转写,已有 transcript 只作为回退文本,不发送给 Qwen。随后执行规则型 hallucination 检查、最佳预测选择、标点和空白清理、缩写合并。Text pipeline 不读取音频,负责实体恢复、PnC、语言识别与验证、逆文本规范化、captioning、code switching 和 speech QA。

6.4 Xenna 与 Ray Data 吞吐

管道基准数据XennaRay Data
Metadata30,631 录音 / 107.76357 小时472.309 audio-hours/hour166.251
Indic ASR216,164 Hindi 片段 / 531.75763 小时3,604.471387.649
Qwen Omni ASR22,710 英语片段 / 80.61259 小时406.615228.424
Text pipeline14,290 行 transcript30.283 rows/s12.217 rows/s

官方对比使用 8 张 H100 80 GB GPU、相同 cohort、镜像、模型和 stage 设置。音频管道吞吐包含模型启动时间;Text pipeline 复用了已启动的模型服务器。

七、实验对比:FLEURS 与流式延迟

分组模式80 ms160 ms320 ms560 ms1.12 s
Transcription-ready 19 localesLangID 平均 WER10.3810.009.499.128.84
Transcription-ready 19 localesAuto-detect 平均 WER11.1410.6710.059.639.21
Broad-coverage 13 localesLangID 平均 WER25.8625.1424.1123.0922.13
Broad-coverage 13 localesAuto-detect 平均 WER27.6226.6525.4124.4423.09

在 1.12 s、LangID 条件下,官方表中英语 WER 为 7.91%,西班牙语 4.11%,意大利语 4.25%,葡萄牙语 5.48%,Hindi 6.81%,德语 8.31%,法语 9.03%,俄语 9.17%,乌克兰语 13.07%。Hindi 在 80 ms 下 LangID 为 8.13%,Auto-detect 为 11.47%;1.12 s 下分别为 6.81% 和 8.23%。日语、韩语和普通话使用 CER。

chunk 增大通常带来更多右侧上下文,平均 WER 下降但等待时间上升:

\(WER(c_1) >= WER(c_2), c_1 < c_2\)

八、吞吐对比与系统意义

配置Nemotron 3.5 ASRParakeet RNNT 1.1B优势
80 ms约 240 路约 14 路约 17 倍
1.12 s约 2,400 路约 400 路约 6 倍

优势来自参数规模、缓存复用、chunk 粒度和 H100 推理实现的共同作用,而不是单纯参数更小:

\(Cost_per_stream proportional to GPU_hourly_cost / sustainable_concurrent_streams\)

WenetSpeech-Min:用于方言语音处理的大规模闽南语语音语料库及双重转写

  • paper: https://arxiv.org/abs/2609.36834
  • code: https://github.com/ASLP-lab/WenetSpeech-Min-Repo

WenetSpeech-Min 是一个开源的大规模闽南语语音语料库,来自不同的在线媒体来源。该语料库包含约 10,000 小时的真实语音数据。每一条语音记录都配有闽南语和普通话的转录文本,这使得系统能够同时实现保留方言特征的识别功能,以及输出清晰的普通话文本功能。

  • 在现实世界中,语音数据来自多个来源,涵盖了各种说话风格、应用场景以及声音条件。
  • 双重转录方式:闽南方言保留了当地的口语表达形式;而普通话则提供了与闽南方言相对应的书面表达形式。
  • 公开基准数据:包括人工验证的闽南语语音识别、普通话语音识别以及闽南语语音合成评估数据。

数据构建流程

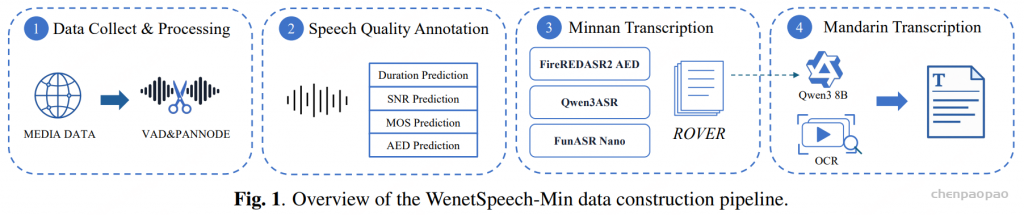
该流程由两个主要部分组成:音频处理和配对转写生成。第一部分对音频进行分段,并依据语音内容和声学质量对所得片段进行过滤。第二部分结合多个闽南语 ASR 系统获得方言转写,然后生成对应的普通话转写。

音频处理: 从各种在线媒体来源收集闽南语语音,VAD切分,计算信噪比(SNR)和时长,计算WV-MOS来描述片段的声学质量,预测AED (声学事件检测) , 估计片段包含语音的置信度,并移除低于预定义阈值的片段,最后使用 pyannote 估计每个保留片段中的说话人数;

文本标注工具:使用人工转写的闽南语语音构建专用标注模型,使用 1,600 小时带有人工核验闽南语转写的语音,对 Qwen3-ASR、FireRedASR2-AED 和 Fun-ASR-Nano进行微调,用于生成方言转写候选结果。对一个 600 小时的子集进行标注,并人工核验配对的闽南语和普通话转写,使用 LoRA 对 Qwen3-8B进行微调,从而得到专用的闽南语到普通话翻译模型,用于生成普通话转写。

配对转写生成:三个 ASR 标注模型产生互补的候选结果;随后使用ROVER 对这些结果进行对齐和组合。组合结果被保留为方言转写。普通话转写通过两条路径之一获得。对于带有内嵌字幕的媒体,用 OCR提取字幕文本,并直接使用归一化后的字幕文本。对于其他媒体,则由微调后的 Qwen3-8B 翻译模型将 ROVER 组合得到的方言转写转换为书面普通话。随后对候选转写进行归一化,并对每个音频—文本对执行一致性检查。对于分段不可靠或内容置信度较低的样本,会将其删除或退回修正。

Dataset

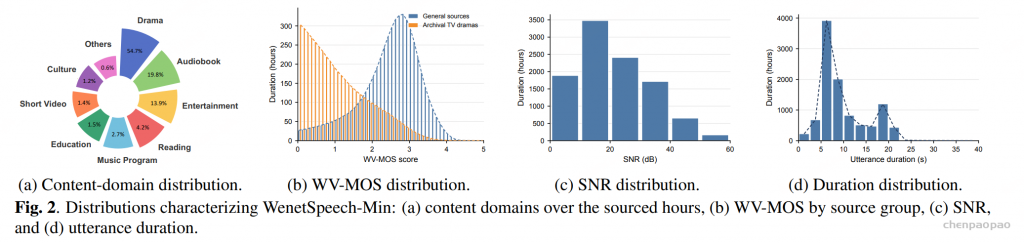
WenetSpeech-Min 涵盖了大约 10,000 小时的语音数据。平均语音持续时间为 7.24 秒;中位数则在 5 到 7.5 秒之间,语料库以短话语为主,同时包含少量更长的连续语音片段。其中,约 8,500 小时的语音数据来源于不同来源:戏剧类内容占 54.7%,有声书占 19.8%,而娱乐类内容占 13.9%。

该语料库特意包含了相对清晰的语音记录以及具有挑战性的档案式电视素材。这样可以保留自然的多语言交互场景、富有情感的表达方式,以及多种多样的真实录音环境。

SNR 分布分布主要集中在 10 至 40 dB 之间,占总时长的 73.8%。按时长加权的平均 SNR 为 21.3 dB,中位数落在 19–20 dB 区间,表明所发布的语料库总体具有中等到较高的声学质量,同时保留了相当范围的录音条件

基准

ASR 基准:WS-Min-Eval-ASR,每个话语都配有两份人工核验的参考文本:一份闽南语转写和一份普通话转写。这种配对设计使得两种转写目标能够使用相同的音频片段和标注协议进行评估。所有系统都遵循统一的文本归一化和评分流程。对于闽南语转写,我们针对闽南语参考文本报告方言字符错误率(D-CER)。对于普通话转写,我们针对普通话参考文本报告普通话双语评估替补(M-BLEU)和普通话字符错误率(M-CER)。当有效的普通话表达在措辞上可能不同时,M-BLEU 作为 n-gram 重叠的补充度量;M-CER 则衡量字符级准确率。

TTS 基准:由 LLM 生成、并经过自然度和方言真实性优化的专家核验闽南语文本组成。Easy 子集包含 500 条日常话语,Hard 子集包含 250 条具有挑战性的文本:其中 46 条为 161–270 字的长文本,189 条为包含五至七次重复的高重复文本,15 条为绕口令。我们根据声学质量和方言真实性,从内部闽南语语料库中选取 9 名参考说话人。对于客观评估,使用 Qwen3-ASR-WSM-Min 模型生成的转写,通过 CER 衡量可懂度;说话人相似度(SIM)则计算合成语音与参考语音的 WavLM [2] 嵌入之间的余弦相似度。对于主观评估,23 名以闽南语为母语的听众对 40 个随机选取的测试案例进行评估,指标包括可懂度(I-MOS)、说话人相似度(S-MOS)和口音真实性(A-MOS);其中每个子集抽取 20 个案例。

ASR Leaderboard

 D-CER 和 M-CER 来说,数值越低越好;而对于 M-BLEU 则相反,数值越高越好。†符号表示使用的是商业 API。

闽南语:

ModelD-CER (%) ↓
Hy-ASR-3.0-Preview†32.78
CN-MultiDialect-ASR18.59
Qwen3-ASR34.61
Qwen3-ASR-WSM-Min17.59
Qwen3-ASR-WSM-Min + internal data15.21
FireRedASR2-AED43.39
FireRedASR2-AED-WSM18.95

普通话转录:

Each entry reports M-BLEU ↑ / M-CER ↓; GigaSpeech denotes GigaSpeechBench.

ModelWS-MinGigaSpeechMinSpeechAvg.
FunASR-Realtime†39.09/45.4153.37/32.6228.22/63.2340.23/47.09
SeedASR2.0†38.91/47.5855.32/32.5068.53/26.2154.25/35.43
Qwen3-ASR-MinSpeech20.34/60.5712.39/71.2667.94/23.9333.56/51.92
Qwen3-ASR-WSM-Mandarin42.93/42.5651.20/34.0159.82/29.4251.32/35.33
Qwen3-ASR-WSM-Mandarin
+ internal data
49.39/36.8147.65/36.6665.69/26.2154.24/33.05
FireRedASR2-AED18.05/64.4036.91/49.3513.60/85.0222.85/66.26
FireRedASR2-AED-WSM46.06/39.5357.73/28.6157.73/31.8553.73/33.33

TTS Leaderboard

Lower CER is better; higher is better for all other metrics. † indicates a commercial API. ‡ denotes a single-fixed-speaker API, for which SIM and S-MOS are not evaluated.

WS-Min-Eval-TTS Easy

ModelCER (%) ↓SIM ↑I-MOS ↑S-MOS ↑A-MOS ↑
QwenAudio-3.0-TTS†19.900.6723.883.853.62
Qwen3TTS-Flash†‡24.44–3.93–3.93
FireRedTTS333.760.7473.303.323.13
VoxCPM228.160.7073.453.543.38
MERaLiON-TTS21.250.6223.833.733.65
CosyVoice363.690.6542.132.131.49
CosyVoice3-WSM20.260.6783.853.753.65

WS-Min-Eval-TTS Hard

ModelCER (%) ↓SIM ↑I-MOS ↑S-MOS ↑A-MOS ↑
QwenAudio-3.0-TTS†35.090.6853.753.733.70
Qwen3TTS-Flash†‡38.02–3.75–3.73
FireRedTTS355.330.7313.153.393.04
VoxCPM240.500.6813.173.483.36
MERaLiON-TTS37.280.6223.583.733.63
CosyVoice360.350.6102.002.401.43
CosyVoice3-WSM35.980.6693.653.853.70

Fish Audio Drama 3 技术报告详解:面向导演式语音生成的 35B -A3B MoE 架构、训练数据与工程优化

一、论文要点与模型定位

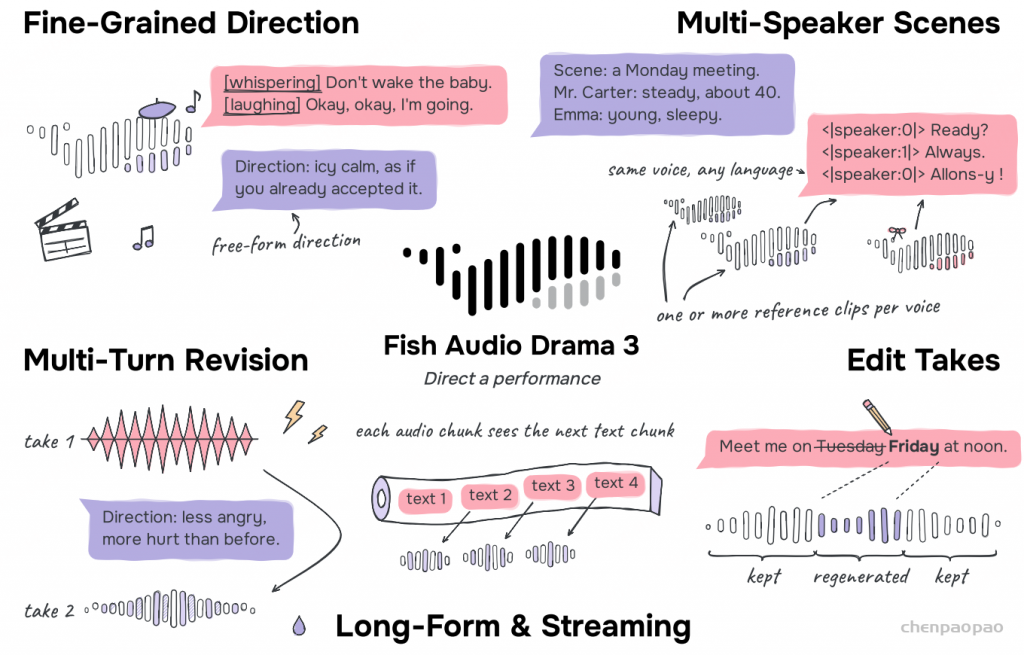
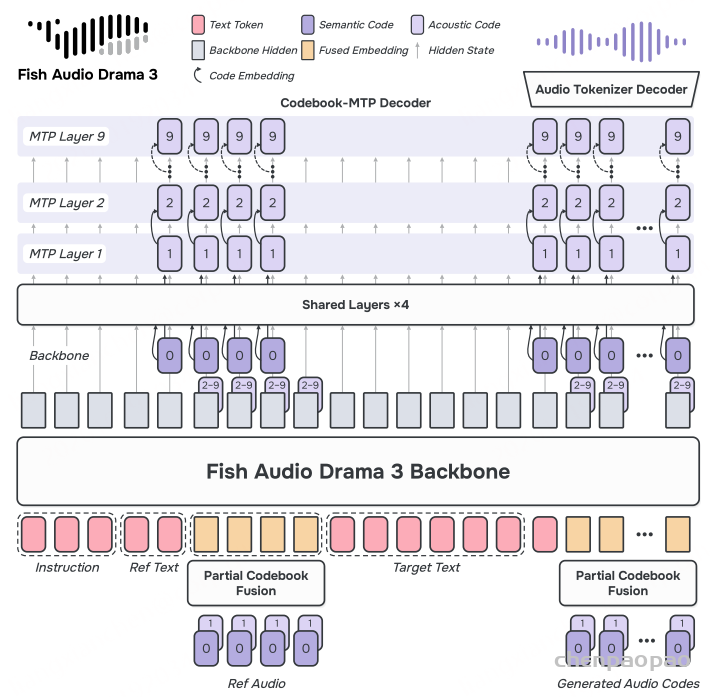
Drama 3 是一个开放权重语音生成模型,总参数量约 35B,但采用稀疏混合专家结构,每个 Token 实际激活约 3B 参数。模型主干由 Qwen3.5-35B-A3B 初始化,采用 40 层混合架构:每四层包含三层 Gated DeltaNet 线性注意力和一层 Gated Full Attention。语音部分沿用 Fish Audio S2 的离散音频 Tokenizer,每个音频帧由 10 个 Codebook 表示;模型主干预测语义 Codebook,新的 Codebook-MTP Decoder 在同一时间位置并行预测其余 9 个声学 Codebook。

论文把创新概括为三点:

  • Hybrid Backbone + Codebook-MTP Decoder:用线性注意力处理长上下文,同时用少量 Full Attention 保留远距离检索能力,并将 S2 的逐 Codebook Fast AR 替换成一次运行 13 层的多 Token 预测解码器。
  • 一个模型统一多任务:多参考音色克隆、自然语言控制、多角色场景、多轮导演式修改、Speech Infilling、长文本合成和 Streaming Text Input 使用同一种交错文本—音频 Token 流表示。
  • 单一人类偏好奖励:RL 不再把 ASR WER、音质模型和 Speaker Similarity 作为规则奖励,而是训练一个小型 Speech Language Model 作为人类偏好 Reward Model。

二、总体架构

Drama 3 没有额外的音频编码器。参考音频、提示音频和生成音频都先通过离散 Audio Tokenizer 转换成 Codebook 序列,之后与文本 Token 交错输入语言模型。每一个音频帧只占用一个 Backbone 序列位置,因此一秒语音约占 21.5 个位置,与该帧包含多少个 Codebook 无关。

2.1 音频 Tokenizer

  • 基于 Descript Audio Codec,输入采样率为 44.1 kHz。
  • 约每秒 21.5 个音频帧,每帧 10 个 Codebook。
  • Codebook 0 是语义码,Codebook 1–9 是逐级增加细节的残差声学码。
  • 编码和解码完全因果,可以流式运行。
  • 参考音频以离散 Token 进入上下文,因此参考音频的细粒度声学信息可以被后续 Decoder 直接访问。

2.2 Hybrid Backbone 与 MoE

主干初始化自 Qwen3.5-35B-A3B,仅使用其语言模型部分。40 层结构由三层 Gated DeltaNet 加一层 Gated Full Attention 组成周期。DeltaNet 使用近似常数大小的状态保存历史,只有每四层中的 Full Attention 保留随上下文增长的 KV Cache;Full Attention 用来精确检索长上下文中的参考音色、早先台词和场景信息。

每一层的前馈网络都是 MoE:共有 256 个 Routed Experts,每个 Token 路由到 8 个专家,并额外经过一个 Shared Expert。总参数约 35B,但每个 Token 约激活 3B 参数。MoE Router 在预训练和 SFT 阶段都加入负载均衡损失,避免大多数 Token 集中到少数专家。

2.3 Partial Codebook Fusion

S2 将 10 个 Codebook 全部反馈给 Backbone。Drama 3 只把语义码和第一层声学码反馈给 Backbone,Codebook 2–9 绕过 Backbone,作为 Decoder 的侧输入。这样既保留参考音频和已生成语音的粗粒度声学线索,也减少模型暴露在自身采样细节上的误差累积。

设第 t 帧的语义码和第一层声学码分别为 \(q_t^{(0)}\) 和 \(q_t^{(1)}\),则 Backbone 的音频输入为:

\( \mathbf{x}_{t}=\frac{1}{\sqrt{2}}\left(\mathbf{E}^{\mathrm{LM}}\left[s\left(q_t^{(0)}\right)\right]+\mathbf{E}^{(1)}\left[q_t^{(1)}\right]\right) \)

其中 \(s(\cdot)\) 把语义码映射到新增的 4096 个语义 Token,\(\mathbf{E}^{\mathrm{LM}}\) 是语言模型词嵌入,\(\mathbf{E}^{(1)}\) 是第一声学 Codebook 的嵌入表。文本位置只使用语言模型嵌入;Codebook 2–9 不进入 Backbone。

2.4 Codebook-MTP Decoder

在第 t 个位置,Backbone 预测下一帧的语义码 \(q_{t+1}^{(0)}\);Decoder 在同一位置预测下一帧的 9 个声学码 \(q_{t+1}^{(1)},\ldots,q_{t+1}^{(9)}\)。Decoder 共有 13 层:前 4 层是共享层,后 9 层分别对应声学 Codebook 1–9。每一层沿完整时间序列做因果注意力,所以每一个声学 Codebook 都能看到参考音频和此前所有帧的声学细节。

每层先把注入的 Codebook 嵌入与上一层隐藏状态合并:

\(\mathbf{u}^{(\ell)}_t=\mathbf{W}^{(\ell)}\left[\operatorname{RMSNorm}\left(\mathbf{e}^{(\ell)}_t\right);\operatorname{RMSNorm}\left(\mathbf{h}^{(\ell-1)}_t\right)\right]\)

随后经过因果 Transformer Block:

\(\mathbf{h}^{(\ell)}_t=\operatorname{RMSNorm}\left(\operatorname{Block}^{(\ell)}\left(\mathbf{u}^{(\ell)}_{1:t}\right)\right)\)

第 k 个 Codebook 的输出分布可以写为:

\(q_{t+1}^{(k)}\sim\operatorname{softmax}\left(\mathbf{W}_{\mathrm{out}}^{(k)}\mathbf{h}^{(4+k)}_t\right),\qquad k=1,\ldots,9\)

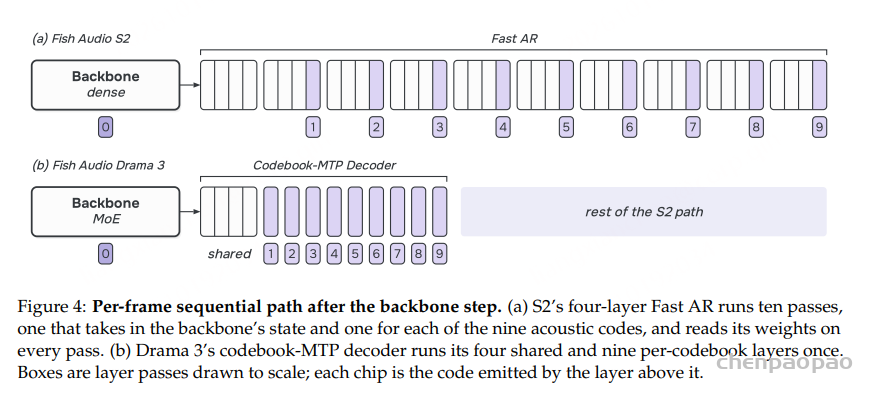
相较于 S2 的 4 层 Fast AR 重复运行 10 次,Drama 3 的 13 层 Decoder 每帧只运行一次,因而大幅缩短顺序路径。

三、训练数据与三阶段预训练

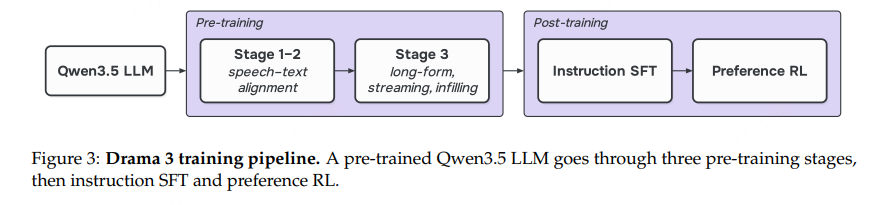
数据由完成转录的语音和文本文档组成;所有语音在进入训练前先经过质量控制;文本文档用于保持 Backbone 的语言建模能力;总体训练规模为数千亿 Token;语言覆盖沿用 S2,约 80 种语言和方言。

3.1 Stage 1:基础文本到语音映射

  • 最大序列长度 8K Token。
  • 训练样本包括纯文本文档和多轮 TTS 对话。
  • 目标是学习文本到音频 Token 的映射、普通 TTS 和零样本音色克隆。
  • System 轮保存任务指令和参考音频,User 轮保存待合成文本,Assistant 轮保存目标音频 Token。
  • 损失只计算在 Assistant 的音频输出、必要的分隔符和结束 Token 上。

3.2 Stage 2:降低梯度噪声

Stage 2 继续使用 Stage 1 的序列格式和任务分布,主要变化是 Batch Size 翻倍,从而降低梯度噪声;学习率衰减留到 Stage 3。它并非独立的新任务阶段,而是让基础语音建模能力在更稳定的优化条件下继续收敛。

3.3 Stage 3:长音频、流式和编辑

  • 最大序列长度提升到 16K Token。
  • 加入整段录音合成:参考音频来自同一录音的后部,目标是前部,避免参考片段和监督目标重叠。
  • 加入逐行合成,用 \(<|audio_separator|>\) 对齐输入文本行和输出音频段。
  • 加入 Streaming Interleave:每个 User 轮包含当前文本块和一个前瞻文本块,模型边生成当前块边知道后续内容。
  • 加入 Speech Infilling:保留原音频编辑窗口前后的 Token,只生成窗口内部的新内容。
  • 样本使用 Document Masking 打包成每行 128K Token,优化器为 Muon。

3.4 预训练目标

令 \(\mathcal{T}\) 为需要监督的文本位置(包括结束 Token 和逐行分隔符),\(\mathcal{S}\) 为语义 Codebook 监督位置,则:

\(\mathcal{L}_{\mathrm{text}}=-\frac{1}{|\mathcal{T}|}\sum_{t\in\mathcal{T}}\log p_{\theta}(x_t\mid x_{<t})\) \(\mathcal{L}_{\mathrm{sem}}=-\frac{1}{|\mathcal{S}|}\sum_{t\in\mathcal{S}}\log p_{\theta}\left(q_t^{(0)}\mid x_{<t}\right)\) \(\mathcal{L}_{\mathrm{cb}}=\frac{1}{9}\sum_{k=1}^{9}\left(-\frac{1}{|\mathcal{S}|}\sum_{t\in\mathcal{S}}\log p_{\phi}\left(q_t^{(k)}\mid\mathbf{h}_{<t},\mathbf{q}_{<t},q_t^{(<k)}\right)\right)\)

总损失为:

\(\mathcal{L}=\mathcal{L}_{\mathrm{text}}+0.5\mathcal{L}_{\mathrm{sem}}+0.5\mathcal{L}_{\mathrm{cb}}\)

文本、语义码和声学码各自按自己的监督桶取平均,避免一个 Batch 中文本和语音比例变化导致损失权重漂移;声学 Codebook 损失会反向传播到 Backbone。预训练和 SFT 同时加入 MoE Router 负载均衡损失。

四、Instruction SFT 阶段:如何让模型学会“听懂导演指令”

SFT 从 Stage 3 Checkpoint 开始,最大序列长度为 32K Token,使用 Indexed Reference Layout。SFT 的目标不是重新学习基础发音,而是把已经具备 TTS 和克隆能力的模型转化为能够遵循复杂自然语言指令、处理对话和场景的生成器。

4.1 SFT 数据类型

  • 普通音色克隆:一段或多段参考音频 + 待合成文本。
  • Point Tags:在文本位置插入 [laughs]、[pause]、[coughs] 等局部事件。
  • Scoped Tags:用 <whisper>...</whisper> 只控制被包围的词或短语。
  • Style Prefix:控制整句的情绪、语速、表达方式。
  • Director’s Note:用自然语言描述意图、节奏、重音和表演方式。
  • 多说话人对话:每个角色绑定一个或多个参考音频,通过 speaker Token 切换角色。
  • 多角色场景:一次提供所有台词,并使用显式分隔符,使当前句能够利用后续台词和场景上下文。
  • 多轮修改:保留旧参考和上一版生成结果,下一轮用“更柔和、更温暖”“比上一版更快”等相对指令生成新版本。
  • 长文本、Speech Infilling 和 Text-only Chat:继续混入训练,防止 SFT 破坏 Stage 3 已学能力。

4.2 SFT 样本如何组织

训练序列采用 ChatML 风格。System 轮包含“把给定文本转换成语音”的任务说明、参考文本和参考音频;User 轮包含目标文本、说话人标记、控制标签和语言/时长提示;Assistant 轮以 \(<|voice|>\) 开始,输出目标音频的 10 个 Codebook。对于多轮修改,旧的 Assistant 音频保留在上下文中,下一轮 User 给出相对上一版的修改意见。

损失只作用于模型自己的 Assistant 输出:语音帧的 10 个 Codebook、需要学习的音频分隔符和 \(<|im_end|>\)。参考音频只提供上下文,不直接产生生成损失。Speech Infilling 额外对编辑窗口两侧的接缝加大监督,使新旧音频能够自然拼接。

五、RL:从可控生成到符合人类偏好的表演

RL 从 SFT Checkpoint 开始。S2 使用 ASR 转录错误、语音质量和 Speaker Similarity 三类规则奖励;Drama 3 去掉它们,因为笑声和长停顿会改变 ASR 结果,耳语和喊叫会降低与中性参考的相似度,而整句质量模型无法评价某个词是否按指令变得更柔和或更有情绪。

5.1 人类偏好 Reward Model

Reward Model 是一个较小的 Speech Language Model,使用相同的 Audio Tokenizer 和序列格式预训练到 Stage 2,并在每条 Take 的结束 Token 上增加 Scalar Head。它直接读取完整 Prompt 和生成音频 Token,不需要额外运行 ASR、Tokenizer Decoder 或 Speaker Model,因此参考音色、文本内容和表演风格都能在同一奖励路径中被判断。

对两条 Take 的人类偏好使用 Bradley–Terry 损失:

\(\mathcal{L}_{\mathrm{RM}}=-\left[y\log\sigma(s_a-s_b)+(1-y)\log\sigma(s_b-s_a)\right]+10^{-3}(s_a^2+s_b^2)\)

5.2 GRPO 配置

  • 每个 Prompt 采样 \(G=8\) 条 Take,温度为 1,不使用 Top-p 或 Top-k 截断。
  • 每条 Take 最长约为期望时长的 2.5 倍,且不超过 4096 帧,约 190 秒。
  • 组内 Reward 标准差低于 0.05 的组丢弃。
  • 使用 Group Relative Policy Optimization,采用均值中心化优势,不使用 KL Penalty 和 Reference Model。
  • 每一步使用 1536 个 Prompt × 8 条 Take,采用大 Batch、少步骤、恒定 Muon 学习率和无 Weight Decay。
  • RL 时 Codebook-MTP Decoder 保持冻结,只更新 Backbone 的语义 Token 策略。
  • Rollout 使用块缩放 FP8 专家权重;训练器使用 BF16,并通过路由回放减少训练和推理路由不一致。

奖励标准化与组内相对比较可写为:

\(z_i=\operatorname{clip}\left(\frac{s_i-\mu_0}{\sigma_0},-3,3\right),\qquad R_i=\frac{1}{n-1}\sum_{j\ne i}\sigma(z_i-z_j)\)

论文强调,大 Batch、少更新步可以让策略朝向更广泛的人类偏好移动,并减少小 Batch、多步训练出现的 Reward Over-optimization。

六、推理引擎与吞吐优化

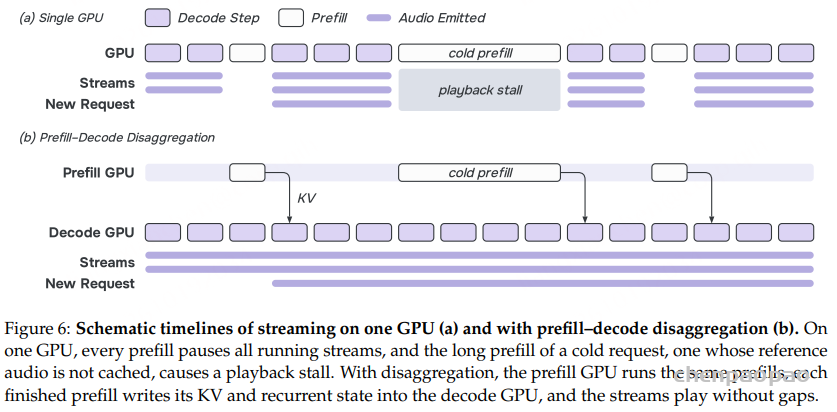
线上请求分为 Prefill 和 Decode 两阶段:Prefill 一次读取文本与参考音频,Decode 每帧执行一步。单 GPU 同时服务多个流,按轮次执行新请求 Prefill 或所有运行中流的一步 Decode。

指标Drama 3Fish Audio S2
Backbone 后的顺序层数1340
每帧读取权重约 6.0 GB约 15.6 GB
其中 Backbone(不含 Routed Experts)2.9 GB7.3 GB
Codebook-MTP / Fast AR2.1 GB8.3 GB
上下文 KV Cache 增长的层数2336
单 H200 单流速度271 frames/s177 frames/s
  • 减少顺序路径:Codebook-MTP 13 层每帧运行一次;S2 的 Fast AR 需要 10 次、共 40 层顺序 Pass。
  • FP8 Routed Experts:专家使用块缩放 FP8,每个专家参数约 1 Byte。Drama 3 每帧读取约 6.0 GB 权重,不到 S2 的五分之二。
  • 删除 CUDA Graph 之外的 Kernel:辅助 Decode Kernel 从 1429 个降到 1278 个,B300、并发 32 时提升 1.7%;融合 Gated DeltaNet Decode 和采样器计数器后减少 100 个 Kernel,单流提升 4.2%。
  • Prefill Graph:Gated DeltaNet Prefill 每层 Kernel 从 23 个降为 13 个;首帧采样的 Host 时间从 30.9 ms 降至 14.7 ms,早期开发模型在 H200 并发 32 时提升 15.3%。
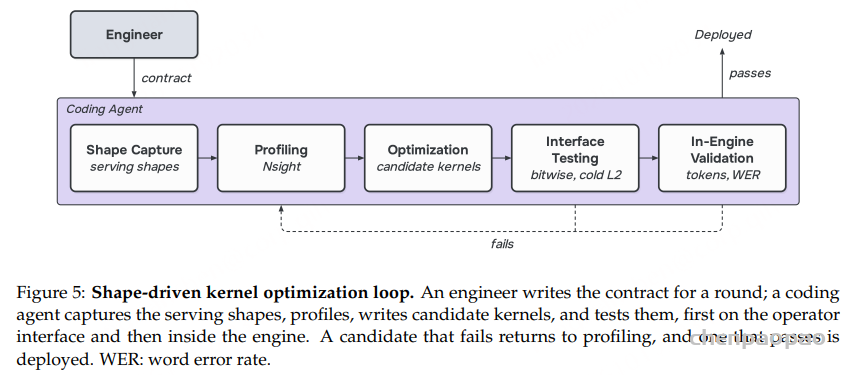
  • 按线上 Shape 优化 Kernel:从真实服务日志抓取矩阵形状、Batch 和并发分布,再做 Nsight Profiling、算子级验证、引擎内 Token/WER 验证和同机 A/B 测试。FP8 MoE Kernel 在 \(M=256\) 时将 MoE 层耗时降低 19.2%。
  • Prefill–Decode 解耦:新请求的 Prefill 不再阻塞正在播放的 Decode 流,降低高并发下的流式卡顿。

七、实验设置与结果

实验统一使用论文附录中的 Prompt 格式,采样温度 0.7、Top-p 0.7、Top-k 30。静音、语音过短、长度失控、长段噪声或长段静音的输出会被重新生成并重新计分。中文使用 Paraformer-zh 转录,其余语言使用 Whisper-large-v3;Speaker Similarity 使用 WavLM-large + ECAPA-TDNN 说话人嵌入余弦相似度。

7.1 Preference Reward 对表达性的影响

在 Expresso 中,将同一说话人同一句话的中性读法与风格读法配对。耳语相对中性读法的 SIM 下降 0.310,笑声使 WER 上升 0.79 个百分点;因此相似度奖励在耳语样本中 99.7% 偏好中性读法,在笑声样本中 93.9% 偏好中性读法。Drama 3 的 Preference RM 在提示中明确写出风格后,偏好耳语的比例为 62.2%,偏好笑声的比例为 64.4%;不写方向时分别只有 10.6% 和 27.1%。

在 Seed-TTS-Eval 上,RL 后 Drama 3 的首轮中文 CER 从 SFT 的 1.66 降到 1.00,英文 WER 从 3.49 降到 2.20;信号检查失败率从中文 2.82% 降到 1.24%,英文 3.40% 降到 1.84%。重生成异常样本后,中文 CER 为 0.83,英文 WER 为 1.54。

7.2 多参考零样本音色克隆

论文在 LibriSpeech-PC test-clean 上扩展多参考测试集:1127 句、39 位说话人,每个目标说话人额外提供两段不包含目标句的参考音频。Drama 3 使用一段参考时 WER 1.85%、SIM 0.605、UTMOS 4.31;使用三段参考时 WER 仍为 1.85%,SIM 提升到 0.633,UTMOS 仍为 4.31。单参考时,UTMOS 4.31 高于 OmniVoice 的 4.28 和 CosyVoice 3 的 4.28;Qwen3-TTS 为 4.41,但其 WER 和 SIM 分别为 1.60 和 0.704。

7.3 MiniMax 多语言克隆

MiniMax Multilingual Testset 覆盖 24 种语言。Drama 3 相比 OmniVoice 在 15 种语言上错误率更低,相比 FireRedTTS3-Base 在 17 种语言上更低;在阿拉伯语、中文、荷兰语、英语、芬兰语、法语、德语、波兰语、葡萄牙语、土耳其语和越南语 11 种语言上同时低于 OmniVoice、FireRedTTS3-Base 和 Fish Audio S2。与实际通过 API 运行的商业系统比较时,Drama 3 低于 Inworld TTS-2 的语言数为 18,低于 Soniox TTS RT v2 的语言数为 21/23,低于 ElevenLabs v4 的语言包括中文、荷兰语、英语、德语、韩语、俄语、西班牙语、泰语和土耳其语。

语言指标Drama 3OmniVoiceFireRedTTS3Fish Audio S2
中文CER0.631.010.910.73
荷兰语WER0.591.361.150.99
英语WER1.131.562.121.62
芬兰语WER3.093.753.103.33
法语WER2.683.352.642.86
德语WER1.081.501.931.46
土耳其语WER1.622.932.472.25

7.4 Streaming Synthesis

在 1088 条 Seed-TTS-Eval 英文测试句上,流式输出 WER 为 1.86,非流式输出 WER 为 1.83;两者 SIM 都为 0.640。结果说明把音频边生成边发送不会带来明显质量损失。

7.5 Speech Infilling 编辑

在 Ming-Freeform-Audio-Edit 中,先用 Qwen3-ForcedAligner-0.6B 将源音频和转录对齐,再把从第一个不同词到最后一个不同词的区域作为编辑窗口。删除操作还会包含相邻未改变词,以保证窗口有可学习的边界。模型保留窗口前后源音频 Token,只生成窗口内部的目标文本,然后整体解码,避免把源波形直接贴回造成拼接痕迹。

系统英文插入 WER / SIM / MAE英文删除英文替换
Drama 33.03 / 0.905 / 0.2085.79 / 0.838 / 0.1742.08 / 0.866 / 0.181
VoiceCraft-X5.74 / 0.85 / 0.1669.71 / 0.80 / 0.1727.29 / 0.81 / 0.155
LEMAS-Edit6.04 / 0.81 / 0.1589.29 / 0.80 / 0.1676.09 / 0.80 / 0.167
CosyEdit21.90 / 0.93 / 0.1075.52 / 0.90 / 0.1311.43 / 0.89 / 0.137

中文结果中,Drama 3 在插入和替换上的 SIM 分别为 0.909 和 0.898,高于专用编辑模型 CosyEdit2 的 0.89;删除 WER 为 7.82,低于 CosyEdit2 的 8.23。与 Cartesia Sonic-3 的 Infill API 比较,Drama 3 在 Ming-Freeform 基础集/完整集上的英文 WER 为 3.49/3.43,中文为 3.69/2.35;Cartesia 对应为英文 4.58/4.68、中文 8.64/6.53。

7.6 多轮导演式修改

Step-Audio-Edit 要求模型先克隆声音,再通过最多三轮指令逐步靠近目标情绪或风格。Drama 3 在每轮中保留原始参考和上一版 Take,并以 [happier versus previous] 一类相对指令重生成。情绪准确率从第 0 轮的 55.5% 提升到第 3 轮的 58.2%,风格准确率从 76.5% 提升到 81.8%。使用 [coughs] 等 Point Tag 进行局部插入并 Infilling 后,拟声事件评分从 1.32 提升到 2.32。

指标第 0 轮第 1 轮第 2 轮第 3 轮
Drama 3 情绪准确率55.557.257.558.2
Drama 3 风格准确率76.579.480.581.8
Drama 3 拟声事件评分1.322.32––
Step-Audio-EditX 情绪准确率53.666.868.769.3
Step-Audio-EditX 风格准确率45.662.764.263.8

八、工程实现启示

  • 长上下文语音模型可以采用“多数线性注意力 + 少量 Full Attention”,在降低 KV Cache 成本的同时保留参考音频和早期台词的精确检索。
  • 多 Codebook 音频生成不必让主干逐一预测所有声学码;将粗语义信息反馈给 Backbone,把细节留给时间因果 MTP Decoder,可以同时降低曝光偏差和推理顺序长度。
  • 如果训练目标是表现力,WER、SIM 和整句音质分数不宜直接作为唯一奖励。更合理的做法是让 Reward Model 读取“指令 + 参考音频 + 生成音频 Token”的完整上下文。
  • SFT 数据应把多轮对话、参考音频索引、Point/Scoped Tag、分隔符和编辑窗口作为一等数据结构,而不是只把音频和文本做成单句配对。
  • 线上性能主要受权重搬运、Kernel Launch 和 Prefill 阻塞影响。需要从真实服务 Shape 出发做算子优化,并将 Prefill 与 Decode 分离。

九、结论

Drama 3 的关键不只是把模型扩大到 35B,而是把模型、数据格式、SFT 任务和 RL 奖励统一到“导演式表演”这一目标上。Hybrid Backbone 解决长上下文,Partial Codebook Fusion 控制反馈复杂度,Codebook-MTP Decoder 直接利用参考音频的细粒度声学信息;三阶段预训练建立基础语音能力,32K Token 的 Instruction SFT 教会模型遵循指令和维护多轮上下文,单一人类偏好 Reward Model 则让笑声、耳语、停顿和情绪表达不再被传统规则奖励压制。

从实验结果看,Drama 3 在多参考克隆、多语言识别准确率、流式生成、语音编辑和多轮修改上都表现出统一模型的优势;从工程结果看,它在单 H200 上达到 271 frames/s,高于参数量小得多的 Fish Audio S2。论文没有公开完整数据来源和样本规模,这一限制需要在复现或二次训练时单独补齐。

Qwen-Audio-Jev 技术报告详解:用一个决策头统一音频选择、二元判断与质量评分

论文的核心问题是:很多音频理解任务最终只需要一个有限答案,例如从几个候选项中选一个、判断一个命题是否成立,或者给语音质量打分。如果仍然让大型音频语言模型逐字生成答案,就会产生额外的解码延迟、格式解析和结果校验成本。

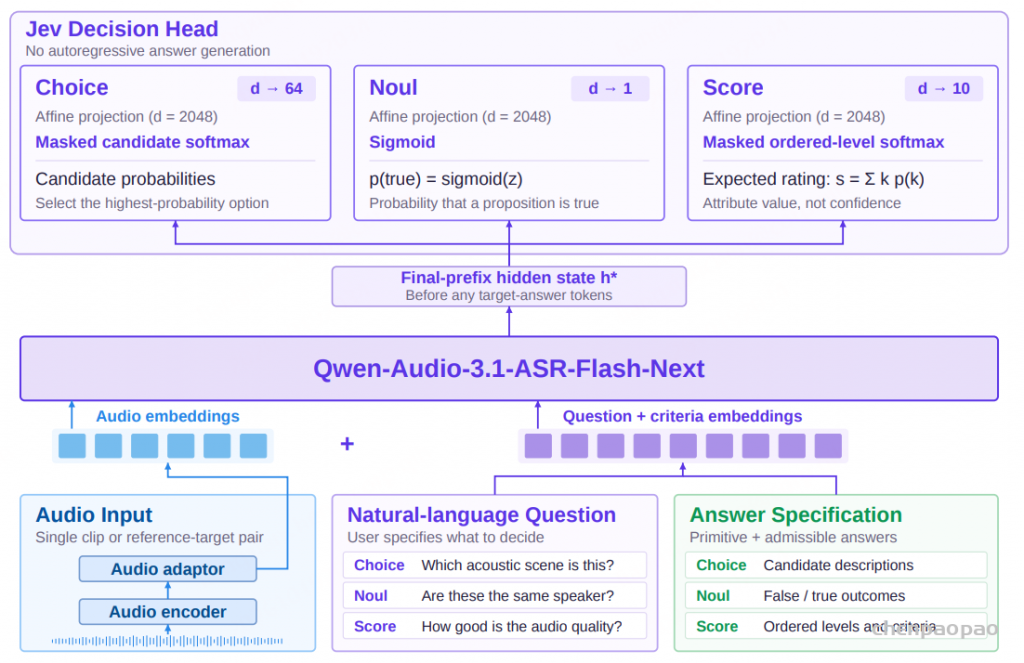
Qwen-Audio-Jev 保留 Qwen-Audio-3.1-ASR-Flash-Next 的音频编码器、音频到语言适配器和 MoE 语言解码器,在“答案开始之前”的隐藏状态上增加一个专用决策头。模型通过自然语言问题和显式答案规范理解任务,然后直接输出概率分布或数值分数,不再自回归生成答案文本。论文在 18 个标注配置上评测:MMAU-mini 准确率 78.70%,MMSU 准确率 84.06%,VoxCeleb1-O 说话人验证 EER 为 6.50%,NISQA overall 质量评分归一化 MAE 为 0.1062,Pearson 为 0.8210,Spearman 为 0.8074;在论文给定的推理设置下,速度约为原始 Qwen-Audio-3.1-ASR-Flash-Next 的 20 倍。

一、论文要解决的实际问题

传统大模型适合生成开放式文本,但在音频筛选、批量质检、说话人验证和数据标注中,输出空间往往是有界的。比如“这段音频属于哪种声学场景”“两个录音是否来自同一说话人”“这段语音的噪声等级是多少”,都可以表示为有限类别、真假概率或有序评分。自回归文本生成会带来三类问题:

  • 需要逐 Token 解码,短答案也要承担语言模型生成的时间开销。
  • 生成结果还要经过字符串解析、候选映射和格式校验,工程链路更长。
  • 文本答案的概率不一定等于任务本身的类别概率,难以直接做校准和阈值控制。

Jev 的思路是将问题、答案空间和输出类型显式写入接口。模型仍然可以使用自然语言描述音频任务,但最后由固定维度的决策读出完成选择、判断或打分。

二、模型总体设计

2.1 Qwen-Audio-3.1-ASR-Flash-Next 基座

基座模型包含三个主要表示模块:

  • Audio Encoder:从波形中提取声学、说话人、环境声音和韵律等表示。
  • Audio-to-Language Adaptor:对相邻编码帧做时间下采样,并将结果投影到语言解码器的隐藏维度。
  • MoE Language Decoder:把音频表示与文本指令、问题和上下文融合,形成问题条件的隐藏状态。

论文实验使用的解码器为 40 层 MoE,隐藏维度为 2048,共 256 个 Routed Experts,每个 Token 选择 8 个专家。原始模型通过自回归概率生成文字答案:

\(p_{\theta}(y\mid x,u)=\prod_{\ell=1}^{L}p_{\theta}\left(y_{\ell}\mid y_{<\ell},\mathbf{a},u\right)\)

其中 \(x\) 是输入音频,\(\mathbf{a}\) 是音频编码和适配后的表示,\(u\) 是文本指令和上下文。Qwen-Audio-Jev 保留这个音频条件表示通路,但把最终答案从“生成文本”改成“读取决策状态”。

2.2 Jev 决策头插入位置

设 \(q\) 为自然语言问题,设 \(c\) 为答案规范。答案规范规定使用哪一种决策原语、合法答案空间是什么,以及候选项或评分等级的含义。问题和规范被序列化为文本前缀,与音频表示一起送入共享解码器:

\(\mathbf{H}=D_{\theta}\left(\operatorname{Fuse}\left(\mathbf{a},\operatorname{Embed}\left(\operatorname{Serialize}(q,c)\right)\right)\right)\)

决策状态取问题前缀最后一个 Token 的隐藏向量:

\(\mathbf{h}_{\star}=\mathbf{H}_{t_{\star}}\)

\(t_{\star}\) 位于目标答案 Token 之前,因此因果注意力无法读取训练样本中的正确答案,避免标签泄漏。决策头包含三个独立的仿射投影:

\(\mathbf{z}^{\mathrm{Choice}}=\mathbf{W}_{C}\mathbf{h}_{\star}+\mathbf{b}_{C}\) \(z^{\mathrm{Noul}}=\mathbf{W}_{N}\mathbf{h}_{\star}+b_{N}\) \(\mathbf{z}^{\mathrm{Score}}=\mathbf{W}_{S}\mathbf{h}_{\star}+\mathbf{b}_{S}\)

当前实现中,决策头维度分别为 \(\mathbf{W}_{C}\in\mathbb{R}^{64\times d}\)、\(\mathbf{W}_{N}\in\mathbb{R}^{1\times d}\)、\(\mathbf{W}_{S}\in\mathbb{R}^{10\times d}\),其中 \(d=2048\)。Choice 和 Score 只对当前问题实际提供的候选或评分等级做归一化,未使用的位置不参与 Softmax。

2.3 三种类型化输出

统一接口可以写成:

\(f_{\theta}(x,q,c)\longrightarrow r_{\tau},\qquad \tau\in\{\mathrm{Choice},\mathrm{Noul},\mathrm{Score}\}\)

Choice:从候选项中选择

Choice 适用于声学场景、乐器、人类非语音声音、性别、情绪和音频问答。当前实现支持 2 到 64 个候选项。候选项的语义由问题中的描述决定,而不是绑定到一个固定的全局类别 ID:

\(p_{ik}=\frac{\exp(z^{\mathrm{Choice}}_{ik})}{\sum_{j\in\mathcal{C}_{i}}\exp(z^{\mathrm{Choice}}_{ij})},\qquad \hat{k}=\arg\max_{k\in\mathcal{C}_{i}}p_{ik}\)

训练时会随机打乱 Choice 候选项,同时同步打乱候选描述和标签概率,防止模型记住“第一个位置通常是正确答案”。

Noul:二元命题的真实性概率

Noul 适用于“两个录音是不是同一个说话人”“这段音频是否包含讽刺”“音频是否为深度伪造”等二元问题。输出是命题为真的概率:

\(p_{i}=\sigma(z^{\mathrm{Noul}}_{i})=\frac{1}{1+\exp\left(-z^{\mathrm{Noul}}_{i}\right)}\)

Score:有序等级上的分布与期望分数

Score 适用于 NISQA、VoiceMOS 和 BVCC 等主观质量评估。评分等级从 \(0\) 到 \(K_i-1\),模型不只输出一个回归数,还输出完整的等级概率分布。预测期望和目标期望分别为:

\(\hat{s}_{i}=\sum_{k=0}^{K_i-1}k p_{ik},\qquad s_i^{\star}=\sum_{k=0}^{K_i-1}k t_{ik}\)

这种设计同时保留分类分布、评分顺序和原始 MOS 尺度,适合需要概率校准的质量控制系统。

2.4 推理过程

推理时输入音频、自然语言问题和答案规范,模型只执行一次共享解码器前向计算,再读取被请求的输出头。Choice 和 Score 对有效候选或等级做 Softmax;Noul 对单个 Logit 做 Sigmoid。无需生成“答案是……”“评分为……”之类的文本,也不需要后处理字符串。

三、训练数据:

3.1 任务数据

决策类型论文涉及的数据集/配置监督信号典型任务
ChoiceCochlScene、NSynth、NonSpeech7k、DiDiSpeech、MELD、MMAU、MMSU、MMAR类别标签或多选答案声学场景、乐器、咳嗽/笑声等非语音声音、性别、情绪、音频问答
NoulVoxCeleb1-O、Clotho-AQA、PodSarc、In-the-Wild二元真假标签说话人验证、二元音频问答、讽刺检测、音频深度伪造检测
ScoreNISQA overall/noise/coloration/discontinuity/loudness、VoiceMOS有序等级或 MOS 评分噪声、染色、断续、响度、整体语音质量

论文将每条训练样本统一成“音频—问题—答案规范—目标”的格式。一个音频不需要同时拥有 Choice、Noul 和 Score 三类标注;样本只对已有且可靠的目标计算损失,缺失标注不产生 Loss。这是论文处理异构数据的关键。

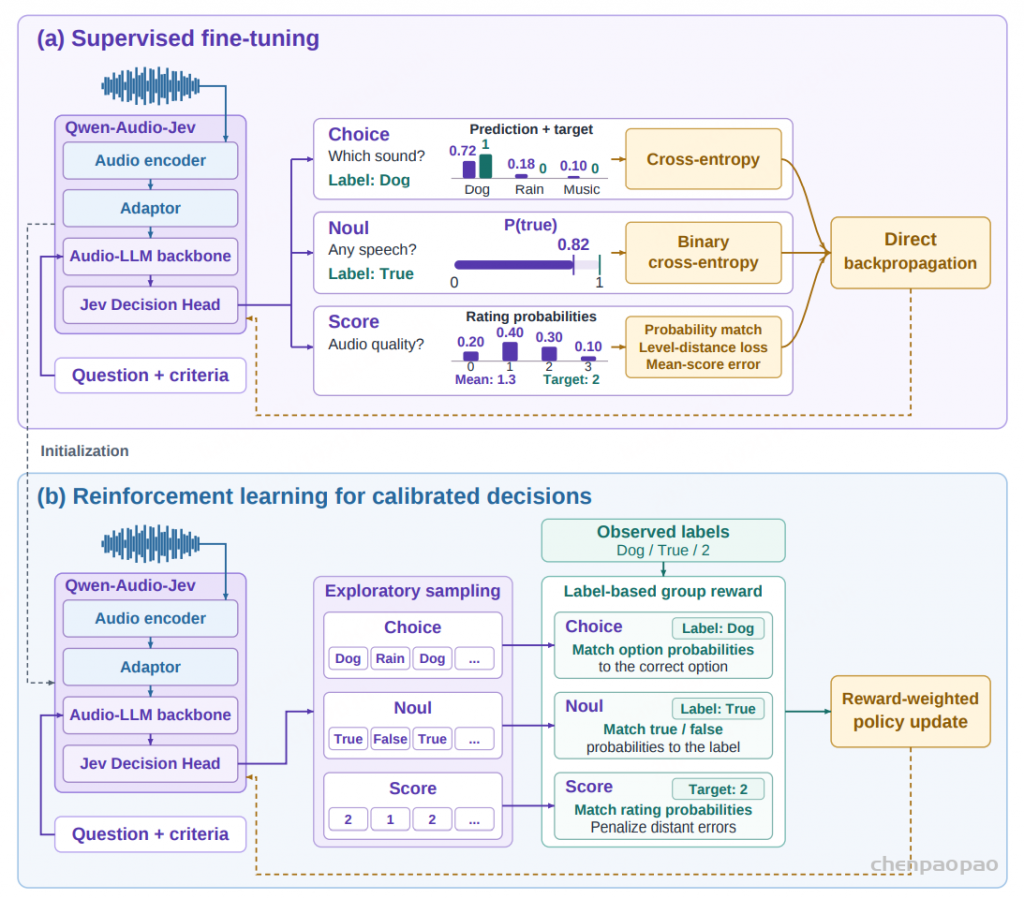
四、SFT:异构音频任务的联合监督

SFT 阶段联合优化 Audio Encoder、Audio-to-Language Adaptor、语言模型 Backbone 和 Jev 决策头。每条样本只激活其请求的决策原语,另外两个读出头不接受该样本的任务损失。论文没有把训练拆成多个串行阶段,而是把三类任务放入同一个监督微调流中;因此这里的“训练阶段”主要是 SFT 和后续 RLCD-inspired 强化学习两个阶段。

4.1 Choice 损失

对有效候选集合 \(\mathcal{C}_i\),候选概率为:

\(p_{ik}=\frac{\exp(z_{ik})}{\sum_{j\in\mathcal{C}_i}\exp(z_{ij})},\qquad k\in\mathcal{C}_i\)

交叉熵为:

\(\ell_i^{\mathrm{choice}}=-\sum_{k\in\mathcal{C}_i}t_{ik}\log p_{ik}\)

硬标签是 One-hot 分布;当数据提供人工标注分布时,使用 Soft Target。Choice 的候选随机排列是论文中特别强调的抗位置偏置增强。

4.2 Noul 损失

二元标签 \(y_i\in\{0,1\}\) 经过 Sigmoid 得到真值概率,使用 Binary Cross Entropy:

\(p_i=\sigma(z_i),\qquad \ell_i^{\mathrm{noul}}=-y_i\log p_i-(1-y_i)\log(1-p_i)\)

论文同时允许 \(y_i\in[0,1]\) 的软二元标注。这样可以用于多人标注后的概率标签,而不是强行压缩为单一真假值。

4.3 Score 损失

Score 同时使用等级分布交叉熵、累计分布误差和期望分数的 SmoothL1。预测和目标的累计概率分别为:

\(P_{im}=\sum_{k=0}^{m}p_{ik},\qquad T_{im}=\sum_{k=0}^{m}t_{ik}\)

三项损失为:

\(C_i=-\sum_{k=0}^{K_i-1}t_{ik}\log p_{ik}\) \(D_i=\frac{1}{K_i-1}\sum_{m=0}^{K_i-2}(P_{im}-T_{im})^2\) \(H(e)=\begin{cases}\frac{1}{2}e^2,&|e|<1,\\ |e|-\frac{1}{2},&|e|\ge 1\end{cases}\) \(\ell_i^{\mathrm{score}}=C_i+\lambda_{\mathrm{cdf}}D_i+\lambda_{\mathrm{mean}}H(\hat{s}_i-s_i^{\star})\)

论文固定使用 \(\lambda_{\mathrm{cdf}}=0.25\) 和 \(\lambda_{\mathrm{mean}}=0.10\)。这比单一 MSE 回归更适合有序评分:交叉熵约束等级分布,CDF 项惩罚等级距离,SmoothL1 约束原始评分尺度上的期望值。

4.4 SFT 总目标

每条样本只计算其激活原语的损失:

\(\mathcal{L}_{\mathrm{dec}}=\ell_i^{t_i}\)

完整 SFT 目标为:

\(\mathcal{L}_{\mathrm{SFT}}=\mathcal{L}_{\mathrm{dec}}+\lambda_{\mathrm{lb}}\mathcal{L}_{\mathrm{lb}}^{\mathrm{base}}+\mathcal{L}_{\mathrm{rz}}\)

其中 \(\mathcal{L}_{\mathrm{lb}}^{\mathrm{base}}\) 是语言模型 Backbone 的 MoE 负载均衡损失,\(\mathcal{L}_{\mathrm{rz}}\) 是 Router z-loss。论文明确指出,SFT 不包含下一 Token 或多 Token 预测目标。

五、RLCD-inspired 强化学习:优化概率校准

强化学习从 SFT Checkpoint 开始,把每个类型化决策视为一步 Contextual Bandit。它不是为了让模型生成更长的解释,而是让概率分布同时具备正确性和校准性。论文使用基于 Brier Score 和 Ranked Probability Score 的组奖励,并通过采样动作做 REINFORCE 更新。

5.1 探索策略

对于第 \(i\) 个问题,Choice 和 Score 从候选或有序等级分布中采样,Noul 视为 False/True 两类策略。每个问题独立采样 \(M=32\) 个动作,探索行为策略为:

\(\mu_{\theta,i}(a)=(1-\epsilon)p_{\theta,i}(a)+\frac{\epsilon}{K_i},\qquad \epsilon=0.05\)

重要性权重为:

\(w_{ir}=\frac{p_{\theta,i}(a_{ir})}{\mu_{\theta,i}(a_{ir})}\)

5.2 校准导向的组奖励

对真实答案 \(y_i\),Brier 误差为:

\(B_i=\sum_{k=0}^{K_i-1}\left(p_{\theta,i}(k)-\mathbf{1}[k=y_i]\right)^2\)

Score 任务额外加入累计概率误差:

\(D_i=\frac{1}{K_i-1}\sum_{h=0}^{K_i-2}\left(\sum_{k=0}^{h}p_{\theta,i}(k)-\mathbf{1}[y_i\le h]\right)^2\)

论文构造的采样组奖励期望满足:

\(\mathbb{E}[\widehat{J}_i]=-B_i-\lambda_iD_i\)

其中 Score 任务使用 \(\lambda_i=0.25\),Choice 和 Noul 不使用有序等级项。该奖励不只奖励“猜对”,还奖励把概率质量放在正确等级附近,并减少过度自信。

5.3 策略梯度更新

论文使用 Leave-one-out Baseline,构造每个采样动作的 Return 和 Advantage,最终的策略梯度损失为:

\(\ell_i^{\mathrm{PG}}=-\frac{1}{M}\sum_{r=1}^{M}\operatorname{sg}\left[w_{ir}A_{ir}\right]\log p_{\theta,i}(a_{ir})\)

\(\operatorname{sg}\) 表示 Stop-gradient;采样动作、奖励、Baseline 和重要性权重视为常量,梯度只通过动作概率流动。这个阶段的重点是校准概率,而不是增加新的标签类型。

六、评测设置与数据集

论文共评测 18 个标注配置:8 个 Choice、4 个 Noul、6 个 Score。评测覆盖分类、音频问答、说话人验证、讽刺和深度伪造检测,以及语音质量评分。论文重点报告模型自身在这些任务上的结果,而不是逐任务与所有原始基座模型做完整消融对比。

6.1 Choice 任务

Benchmark任务Accuracy (%)
CochlScene声学场景分类77.8717
NSynth instrument乐器识别72.2900
NonSpeech7k sound人类非语音声音识别92.6897
DiDiSpeech gender说话人性别分类100.0000
MELD emotion对话情绪识别57.3072
MMAU多模态音频问答78.7000
MMSU语义、韵律和副语言理解84.0568
MMAR复杂混合音频问答69.9000

Choice 结果显示,性别分类和人类非语音声音识别超过 90%,而 MELD 情绪识别只有 57.31%,是最弱配置。模型对说话人属性和明显的副语言事件更容易判断,对对话情绪这种依赖上下文、语气和角色关系的任务仍有明显提升空间。三个音频问答数据集中,MMSU 最好,MMAU 居中,MMAR 最低,说明复杂混合音频问答比基础类别识别更难。

6.2 Noul 二元判断

ConfigurationAccuracy (%)EER (%)AUCBrierFPR (%)FNR (%)
VoxCeleb1-O93.54416.49800.9822670.0486957.32145.5901
Clotho-AQA79.890119.82510.8786520.14639114.412124.4898
PodSarc98.26511.44270.9952300.0164062.17251.2149
In-the-Wild76.323220.94690.8763180.1581123.782257.2867

PodSarc 和 VoxCeleb1-O 同时具备较高 AUC 和较低阈值错误,说明模型在说话人验证和讽刺检测上的概率排序、二元决策与概率误差都较稳定。In-the-Wild 与 Clotho-AQA 的 AUC 接近,但 In-the-Wild 在 0.5 阈值下 FNR 达到 57.29%,说明它不是不能排序,而是在当前阈值下漏掉了大量正样本。实际部署时应根据业务成本重新选择阈值,而不能只看默认 0.5。

6.3 Score 质量评分

ConfigurationMOS MAEMOS RMSENormalized MAENormalized RMSEPearsonSpearman
NISQA overall0.4246420.5463440.1061600.1365860.8210020.807382
NISQA noise0.5844990.7388430.1461250.1847110.7360520.722851
NISQA coloration0.3453700.4319120.0863420.1079780.8098830.808054
NISQA discontinuity0.4305620.5397930.1076400.1349480.8009400.725388
NISQA loudness0.4369850.5230980.1092460.1307750.7282350.689991
VoiceMOS0.8134971.0040480.2033740.2510120.7230590.753843

NISQA overall 和 coloration 的 MOS 误差较低且相关性接近 0.8;loudness 的平均误差与 overall 接近,但 Pearson 较低,说明“平均偏差小”和“随样本质量变化的趋势一致”是两个不同维度。VoiceMOS 的 Pearson 和 Spearman 都为正,但原始 MOS MAE 为 0.813,高于 NISQA 各维度,说明跨数据集评分尺度和主观一致性仍是难点。

七、对 ASR 和音频理解系统的工程启示

  • 把“识别”和“决策”分开:ASR、说话人验证、质量审核和音频筛选常常只需要结构化结果,直接读出比生成解释文本更适合高吞吐服务。
  • 使用问题条件化的候选空间:同一个输出位置可以在一个问题中表示场景,在另一个问题中表示情绪,候选语义放在问题中,比固定分类头更容易扩展新任务。
  • 把概率校准作为一等目标:线上系统通常需要阈值、置信度和风险排序,Brier、CDF 和概率分布损失比只优化准确率更贴近实际。
  • 允许部分标注:不同音频数据集的标签互不相同,统一“音频—问题—规范—目标”格式,可以在不强行补全标签的情况下联合训练。
  • 对 Score 保留有序结构:语音质量的 2 分和 3 分比 2 分和 5 分更接近,CDF 损失可以把这种等级距离纳入训练。
  • 部署时重新选阈值:In-the-Wild 结果说明 AUC 相近的系统,在固定 0.5 阈值下可能出现完全不同的 FNR,生产系统应根据漏检和误报成本选择 operating point。

Qwen-Audio-Jev 的主要价值在于重新定义音频语言模型的输出接口:输入仍然是音频、自然语言问题和答案规范,输出则从开放式文本改为三种类型化决策。Choice 负责有限候选选择,Noul 负责二元命题概率,Score 负责有序质量分布和期望分数。模型通过共享的 Qwen-Audio-3.1-ASR-Flash-Next 表示通路和一个决策头覆盖多个数据集,再用异构标签的 SFT 和面向校准的 RLCD-inspired 训练统一优化。

论文结果说明,这种设计在音频筛选、说话人验证、深度伪造检测、语音质量评估和批量音频问答中具有工程潜力;但它还不是完整的端到端复现方案,因为训练数据总量、数据配比、完整消融和统一速度基准仍未公开。对于 ASR 团队,最值得借鉴的是:把高频、有限答案的后处理任务从“生成式问答”改造成“问题条件化决策”,并把概率校准、候选重排和缺失标签处理直接纳入训练接口。

Index-Translate 深度解析:从 150 语种翻译到语音、可控配音与长文档的一体化模型家族

摘要:哔哩哔哩 Index LLM 团队在 2026 年 9 月发布了 Index-Translate。它不是单一的“文本翻译模型”,而是以 Qwen3.5 为基础,向文本、语音翻译、音节可控配音和原生长文档翻译扩展的模型家族。

Index-Translate 35B-A3B preview、9B 与 2B 文本模型的七维翻译能力对比

一、项目定位:把“翻译质量”扩展为可交付能力

传统机器翻译通常优化句子级质量,但真实内容生产还需要保留 JSON、CSV、Markdown、变量占位符和术语;字幕要适配时长;社区文本要翻出梗意;书籍翻译要维持人物、术语和概念层级。Index-Translate 的核心判断是:翻译模型应当同时优化语义、约束、模态和上下文,而不是只追求一个 BLEU 或 COMET 分数。

模型家族目前包含五类成员:

  • Index-Translate:文本、结构化内容、指令翻译与社区表达,覆盖 150 种语言,提供 2B、9B 和 35B-A3B(preview)。
  • Index-Echo:语音到文字(S2TT)和语音到语音(S2ST),支持目标语言字幕、配音与说话人声音条件。
  • Index-Homura:接收目标音节数,在保持语义的同时重组译文长度。
  • Index-NativeLong:输入完整文档并连续生成译文,面向书籍、网文和长篇资料的一致性。

二、统一基础模型:多语种中训 + 专家融合

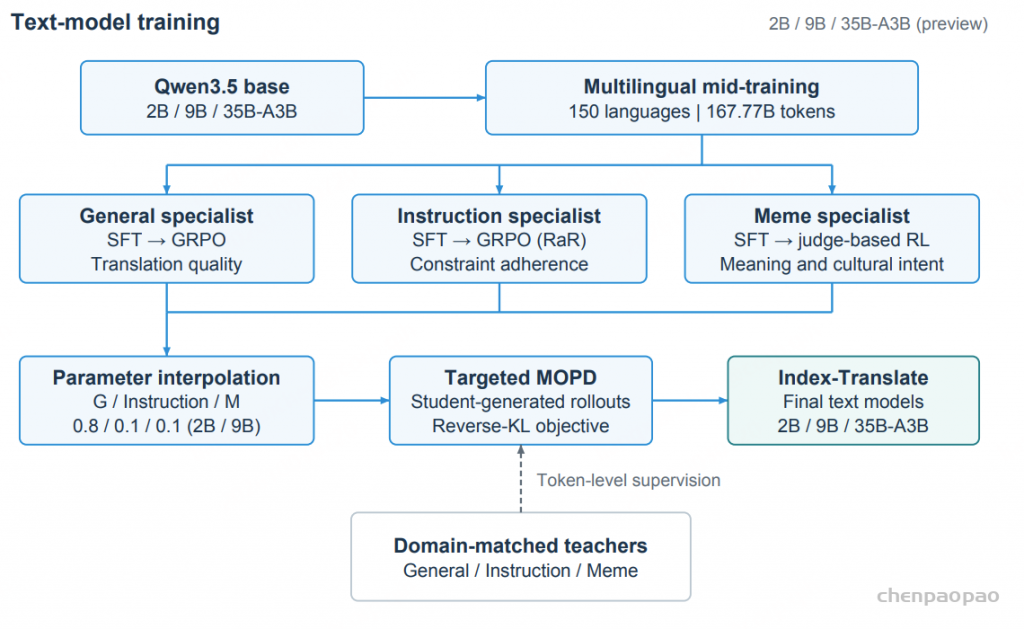
1. 多语言 Mid-training

技术报告将训练拆成 constant 和 decay 两阶段。constant 阶段混合通用文本、平行语料和单语文本,采样比例为 1:1:1,7,000 步、117.44B tokens;decay 阶段使用通用文本、pivot-20 与 pivot-148 数据,比例为 1:4:2,3,000 步、50.33B tokens。总预算约 167.77B tokens,序列长度通常为 4,096,随后为长文档任务增加更长上下文。

这里的 pivot 组织不是简单地把双语句对堆在一起,而是通过英文锚点把多个语言版本连接起来。例如:

\(x_{zh}\leftrightarrow x_{ja}\) 表示普通平行数据;\(x_{zh}\leftrightarrow x_{en}\leftrightarrow x_{ja}\) 表示 pivot 数据。报告中的消融显示,多语言覆盖能明显提升非核心语言表现,同时仍需控制对通用能力的损耗。

2. 专家训练与融合

团队分别训练通用翻译专家、指令翻译专家和 MEME(社区文化表达)专家。指令专家使用约 104.5 万条、覆盖十类真实场景的样本;训练目标既包括术语、格式和结构保护,也包括风格、上下文消歧和跨句一致性。通用翻译和指令翻译使用 GRPO,MEME 使用参考引导的 LLM judge。

融合不是简单拼接多个 LoRA,而是先做参数插值:

\(\theta_{merge}=w_G\theta_G+w_I\theta_I+w_M\theta_M,\quad w_G+w_I+w_M=1\)

发布模型使用的代表性权重为 \(w_G:w_I:w_M=0.8:0.1:0.1\),之后用针对弱项的多教师 on-policy distillation(MOPD)修补融合后的能力缺口。这种设计的价值在于:通用质量、指令遵循和文化适配可以共享底座,但不必强行用一个训练目标解决所有任务。

三、三项关键扩展:语音、音节与长文档

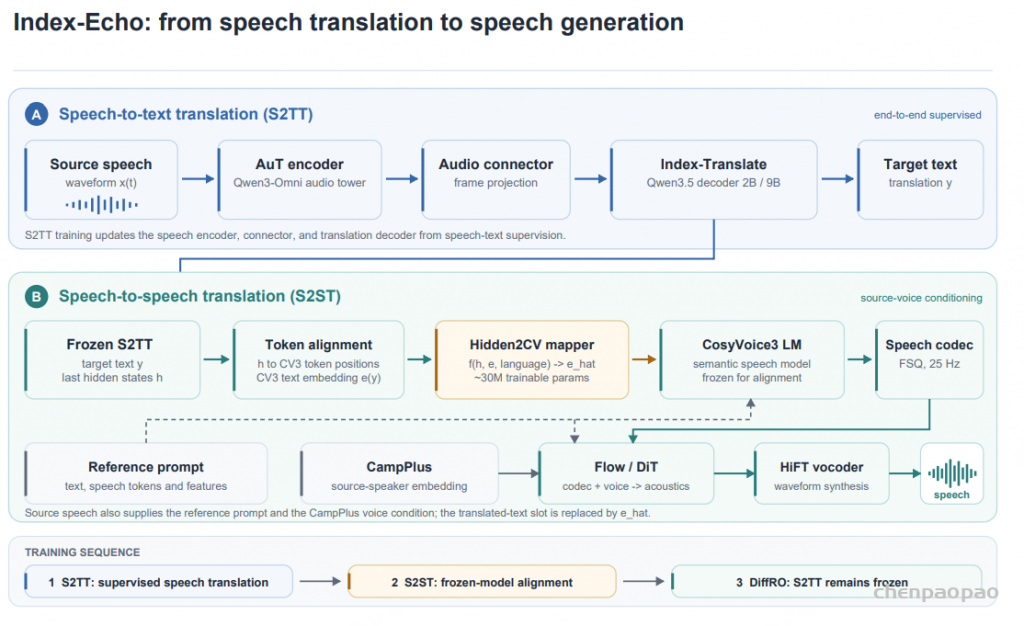
1. Index-Echo:从“翻译文本”到“翻译声音”

Index-Echo S2TT 将 Qwen3-Omni AuT 音频编码器与 Index-Translate 解码器连接起来,直接从源音频生成目标语言文字。S2ST 则在 S2TT 基础上增加约 3,000 万参数的 Hidden2CV 映射器,把翻译器隐藏状态映射到 CosyVoice3 的语义层,并使用 DiffRO 通过 Gumbel-Softmax 语音 token 优化内容一致性;源音频还提供说话人 embedding 与声音提示。

任务/模型MT judgeASR/WER 中位误差起始时间 MAE
Index-Echo-2B S2TT0.8250.0880.395 s
Index-Echo-9B S2TT0.8570.1020.488 s
Qwen3.8-Omni-Flash0.8870.1121.004 s
SeamlessM4T-v20.0601.000—

报告还比较了 pipeline 与端到端 S2ST。以中文到日语为例,9B 端到端方案的内容错误率均值/中位数为 0.0436/0.021,音色相似度 Spk 为 0.782;这说明语音翻译的评价不能只看文本,还要同时考察内容、时间轴和说话人条件。

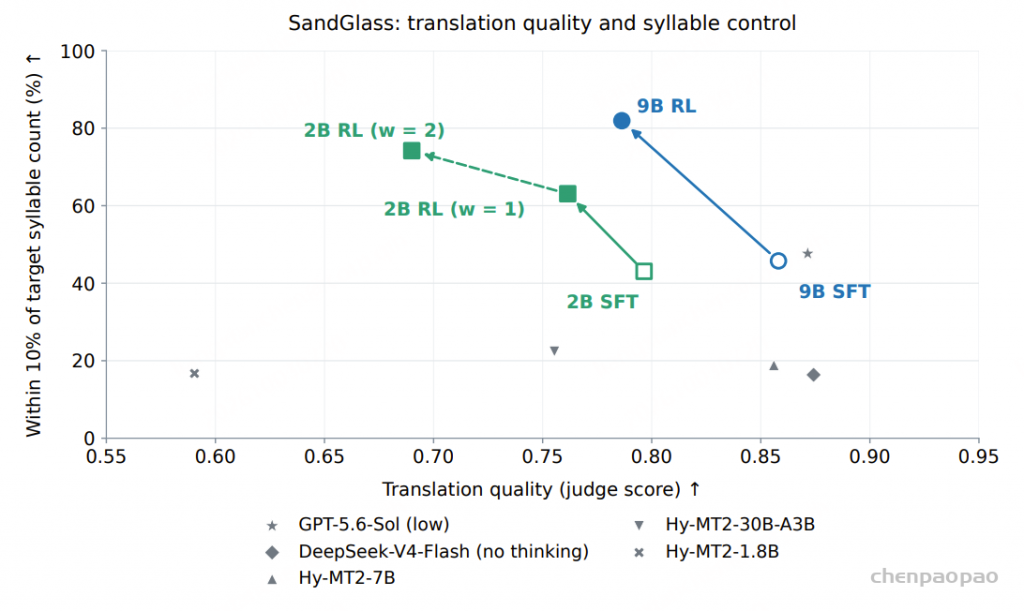
2. Index-Homura:把音节预算写进优化目标

HOMURA 论文指出,大语言模型翻译存在跨语言“冗长偏置”:译文往往比时间预算允许的长度更长。它提出 Sand-Glass 基准,用真实视频转写、停顿分段和信息密度校准构造音节级时长约束。中文到英文、德文、西班牙文的理论扩展约为 1.03、1.19、1.49 倍,但未经约束的 LLM 平均扩展可达到 1.35、1.59、1.84 倍。

HOMURA 的基本长度比定义为:

\(\rho(x,y)=\frac{\sigma(y)}{\max(\sigma(x),1)}\)

其中 \(\sigma(\cdot)\) 是音节数。模型使用动态区间 \([L(x),R(x)]\),短句会适当放宽下界,长度奖励采用区间内满分、区间外指数衰减;质量奖励则由回译语义相似度、流畅性判定和可选的 GenRM 组成。整体目标可写为:

\(R(x,c,y)=\lambda_{len}R_{len}(x,y)+\lambda_{qual}R_{qual}(x,y)\)

在 3,600 条 Sand-Glass 测试案例中,Index-Homura-9B 的输出有 81.92% 与目标音节数偏差不超过 10%,明显高于普通模型的约 13%–48%。代价是:当约束越来越紧时,COMET 等质量指标会下降,模型必须在信息密度与自然度之间做可解释的折中。

模型Quality偏差≤1 音节偏差≤10%长度拟合斜率
Index-Homura-9B(RL)0.786374.42%81.92%0.968
Index-Homura-9B(SFT)0.858141.39%45.75%0.680
GPT-5.6-Sol(low)0.871542.53%47.64%0.891
Qwen3.5-9B0.718315.61%16.39%0.430

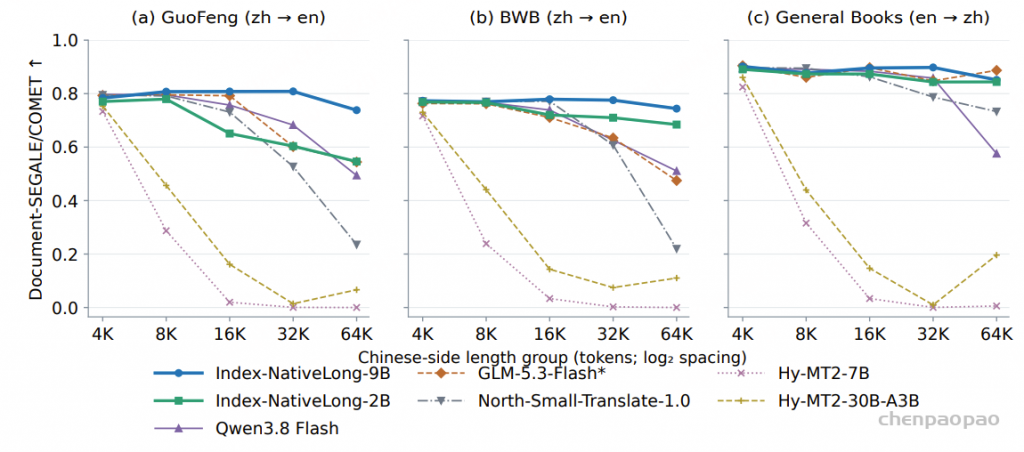
3. Index-NativeLong:原生长文档而不是“分块 + 词表”

NativeLong 的关键假设是:书籍翻译中的人物身份、术语层级和叙事关系,不能完全依靠分块翻译后再拼接。2B/9B 模型通过约 4K–64K 中文侧 token 的双向文档监督进行全参数 SFT,并在 mid-training decay 阶段使用 128K 序列实验。报告显示,Index-NativeLong-9B 在 GuoFeng、BWB、General Books 上的平均得分分别为 0.7891、0.7683、0.8848。

案例中,32K token 奇幻文本里的“王妃”在原生全文翻译的三个位置都保持为 Wang Fei,而同一 9B 模型使用分块和自动词表时,后文变成 the Dean、The Queen Consort。冰川史案例也显示,原生全文能够区分 ice age(冰河时代)、glacials(冰期)和 interglacials(间冰期),避免把上下位概念压成同一个词。

四、RIVAL 与 HOMURA:两条强化学习技术线

Index-Translate 技术报告明确吸收了 RIVAL 的训练思想。RIVAL 发现,传统 RLHF 中离线 reward model 会因为策略分布不断变化而失配,模型可能通过“奖励投机”获得高分,却生成不存在于原文的内容。因此 RIVAL 把 reward model 与翻译模型写成迭代的 min–max 对抗过程:

\(\min_{r_\phi}\max_{\pi_\theta}\;\mathbb{E}[r_\phi(x,\pi_\theta(y|x))]-\mathbb{E}_{y\sim P_{strong}}[r_\phi(x,y)]\quad\text{s.t.}\quad D_{KL}(\pi_\theta\|\pi_{ref})<\eta\)

RIVAL 的 reward model 同时学习定性偏好和定量偏好:前者用强/弱翻译排序,后者用 BLEU 的 MAE 近似。实验中,MAE 的定量误差为 0.19、定性准确率为 99.5%,优于 MSE 的 0.93 和 97.0%。在中文到英文的口语字幕任务上,RIVAL-Iter1 的 GPT-4o 平均评分为 3.68,优于 Qwen2.5-7B-SFT 的 3.46;WMT 中文到英文在 Iter2 达到 BLEU 33.42、COMETKiwi 73.61。

两条技术线各自解决不同问题:RIVAL 解决 reward model 与策略分布漂移,HOMURA 解决时长约束下的质量—压缩折中。Index-Translate 则把这些训练方法组合到通用翻译、指令翻译、MEME 和字幕任务中。

五、实验对比:质量、约束遵循与小语种不能混成一个分数

技术报告使用 FLORES-200、FLORES 低资源对、WMT24++、WMT26、instTrans、IFMTBench、MEME、OPUS-Books、Biomedical、MTNT、MuST-Cinema 和 GuoFeng-Webnovel 等数据。需要注意:COMET-22、XCOMET-XXL、WMT judge、IFscore 和 MEME 分数的量纲不同,不能直接横向相加。

模型FLORES COMET-22WMT26 JudgeinstTrans IFscoreMEME
Index-Translate-35B-A3B(preview)0.879476.760.83360.7405
Index-Translate-9B0.878975.350.82090.7387
Index-Translate-2B0.865560.260.75690.6443
Hy-MT2-7B0.874760.510.60790.5139
GPT-5.6-Sol0.865089.100.76240.7194

低资源结果更能体现项目的训练取向:35B-A3B 在 FLORES_minor_pair 上取得 COMET-22 0.8168、XCOMET-XXL 0.7164,off-target 仅 2.4%;9B 在 instTrans_minor 上取得 IFscore 0.7725,且 off-target 为 3.47%。指令基准 instTrans 包含 3,000 条中文到 20 种语言任务,低资源扩展另有 2,793 条;MEME 则包含 3,638 条中译英社区表达,覆盖 703 个词语和 857 个词义。

通用能力方面,Index-Translate-9B 的 C-Eval、GPQA-Diamond、INCLUDE、MMMLU 分数分别为 69.6、36.3、63.1、66.6;这说明专家融合后仍保留一定基础模型能力,但它的主要优势仍在翻译与约束任务,而非通用问答榜单。

六、最值得关注的创新点

  • 能力边界被显式建模:把“格式是否保留、术语是否一致、目标语言是否正确、音节是否命中、长文身份是否稳定”作为可测量目标,而不是只看译文流畅度。
  • 多语基础与专门模型分工:150 语种共享基础模型,语音、音节、长文档采用专门训练,避免一个模型在所有约束上互相牺牲。
  • 奖励函数更接近生产需求:通用翻译使用 XCOMET、目标语言 gate 和 adequacy;指令翻译加入硬约束 gate;HOMURA 加入动态音节奖励;RIVAL 用迭代 reward model 缓解 reward hacking。
  • 参数融合后再定向蒸馏:先用 0.8/0.1/0.1 融合通用、指令和 MEME 专家,再通过 MOPD 修复融合造成的局部退化。
  • 从句子级走向内容生产级:语音输出、时间轴、声音条件、结构化数据和全篇一致性都进入同一产品路线。

七、局限与使用建议

第一,35B-A3B 仍是 preview,论文与 README 的部分评测使用不同解码和汇总口径;引用数据时应注明模型版本和指标。第二,音节数只是语音时长代理,真实配音还受语速、停顿、音素时长和声码器影响。第三,NativeLong 对超长文档的显存、吞吐和错误恢复要求较高,生产部署仍要评估上下文窗口与并发成本。第四,LLM judge、回译和 XCOMET 都可能存在偏差,官方也记录了引用后缀、终止标记等 judge failure cases。

如果你的任务是结构化资料、社区内容或多语言产品文本,优先选择 Index-Translate-9B;如果是低延迟或资源受限场景,可从 2B 开始。如果是视频字幕和配音,建议使用 Index-Echo + Index-Homura 的组合,并把实际音频时长作为最终验收标准;如果是书籍、网文或技术报告,优先测试 NativeLong 的全篇一致性,再决定是否采用分块流程。

八、结语

Index-Translate 的价值不只在于“多翻几种语言”,而在于重新定义翻译模型的交付指标:能否保留结构、接住语境、压进时长、维持音色,并在一整本书里保持同一个人物和概念。它的工程路线也很清晰:共享多语底座,专家化训练,参数融合与定向蒸馏,再为语音、长度和长文档建立专门接口。对于希望把翻译直接接入内容生产流程的团队,这种模型家族式设计比单一榜单分数更值得关注。

参考资料

Qwen-Audio-3.0-ASR:用 MoE、上下文与指令控制把 ASR 推向真实工业场景

论文:Qwen-Audio-3.0-ASR Technical Report

一、先说结论:这不是只追求 Benchmark 的 ASR

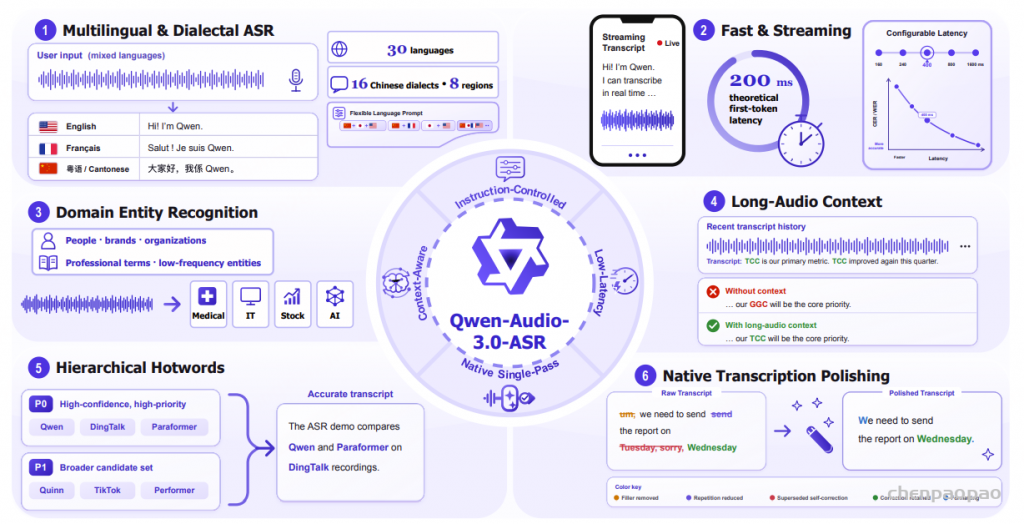
Qwen-Audio-3.0-ASR 的核心目标,是把“听清楚”扩展成“在真实产品里持续可用”。论文把问题归纳为四类:多语言和地区方言、动态人名/品牌/专业术语、长语音跨句上下文,以及停顿、重复、口误和自我纠正等自然口语现象。

模型采用 Qwen Mixture-of-Experts(MoE)语言模型作为解码器,训练数据达到数千万小时量级,统一支持 30 种语言和 16 种中文方言变体。更重要的是,它把语言指定、历史文本、P0/P1 分层热词和文本润色都设计成输入指令,而不是为每种任务维护一套独立模型。

  • 30 种语言,覆盖东亚、东南亚、南亚、阿拉伯语区和欧洲多种语言。
  • 16 种中文方言/方言变体,覆盖 8 个主要方言区,既支持方言转写,也支持方言到普通话的语音翻译。
  • 行业实体识别、分层热词、长音频上下文和原生单次解码润色。
  • 独立的 Qwen-Audio-3.0-ASR-Streaming 流式版本,以及面向语音输入、会议、采访和客服的 Message ASR 部署形态。
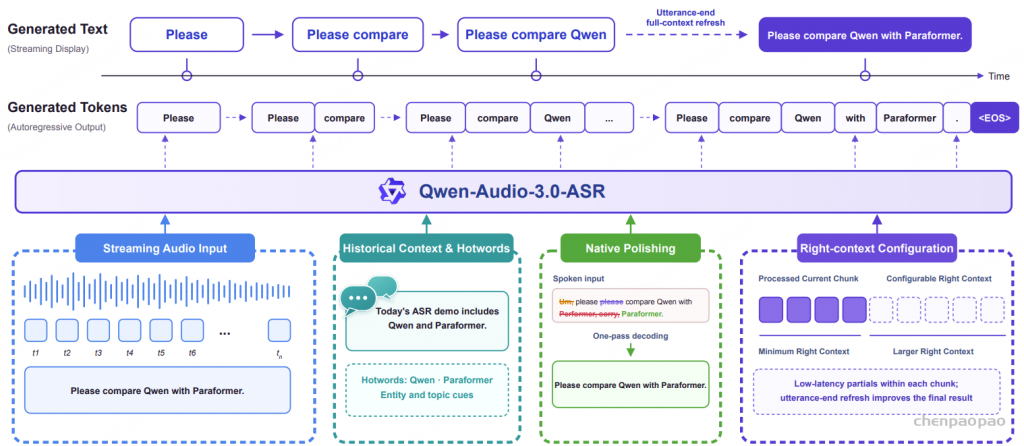
系统总览:多语言/方言、流式、行业实体、长上下文、热词和原生润色,以及“指令控制、上下文感知、单次生成、低延迟”四个系统级属性。

二、研究背景:数据、模型和 LLM 三条路线正在汇合

论文把近年的 ASR 演进概括为三个互补方向:

  • Data Scaling:Whisper 系列从约 3,000 小时扩大到 68 万小时以上后,WER 下降超过 20 个点;领先系统的训练规模已经进入数千万小时。
  • Model Scaling:Whisper 参数量从约 38M 增加到 1.5B,多语言 WER 继续显著改善。
  • LLM Integration:Seed-ASR、FireRedAudio 等模型利用语言知识、世界知识和上下文推理能力,处理同音词、实体歧义和语义不完整等纯声学模型难以解决的问题。

但 Benchmark 的低 CER/WER 并不自动等价于产品体验。传统系统往往需要按语言或市场部署多个 checkpoint,热词更新要依赖外部 biasing 模块,口语润色又要额外串联一个 LLM。Qwen-Audio-3.0-ASR 的设计取舍是:把这些控制信号放进同一个 instruction-following ASR 解码过程里。

三、模型设计:四个模块加一个统一指令接口

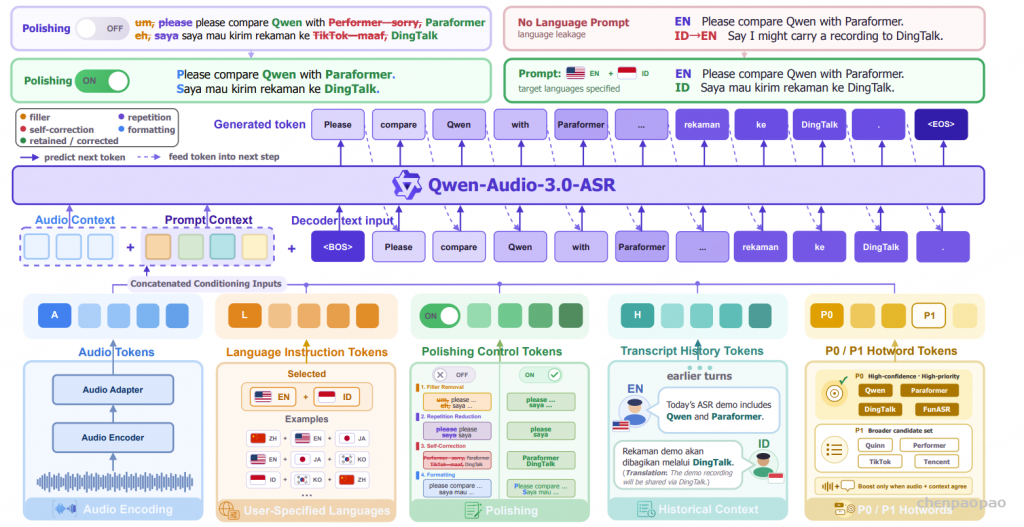
Qwen-Audio-3.0-ASR 延续上一代 Fun-ASR 的整体拓扑,但把原来的 7B Dense LLM Decoder 换成 Qwen MoE Backbone。一次请求除了音频,还可以携带目标语言列表、是否润色、历史转写,以及 P0/P1 热词。

  • Audio Encoder:多层 Transformer Encoder,使用 SenseVoice 音频编码器,把波形转换为声学表示。
  • Audio Adapter:两层 Transformer Encoder,将声学表示映射到 LLM 可消费的表示空间。
  • CTC Decoder:挂在 Audio Encoder 上方,生成粗粒度识别假设。它不负责最终输出,而是为热词定制和长音频上下文注入提供候选与对齐信号。
  • LLM Decoder:Qwen MoE 解码器,综合 Audio Representation、CTC Hypothesis、Instruction 和 Context,自回归生成最终文本。

最终输出可以抽象为:

\(P(y_{1:T}\mid x,c)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x,c)\)

其中 \(x\) 是音频, \(c\) 是语言、历史上下文、热词和润色等条件。关键变化不在音频前端,而在解码器:MoE 通过稀疏专家路由维持较大的总语言容量,同时只激活部分专家,降低每个 token 的实际计算成本。

“音频 + 指令条件 -> CTC 粗假设/音频表示 -> Qwen MoE 解码 -> 最终转写”的流程。

四、训练方案:五阶段逐步对齐声学、语言和产品目标

训练顺序为:Audio Encoder Pretraining -> Audio LLM Pretraining -> LLM Cooldown Adaptation -> Supervised Fine-tuning(SFT)-> Reinforcement Learning(RL)。这条链路的含义是,先获得稳健声学表示,再对齐 Qwen 的语言空间,随后用高质量数据收敛,最后直接优化生产指标。

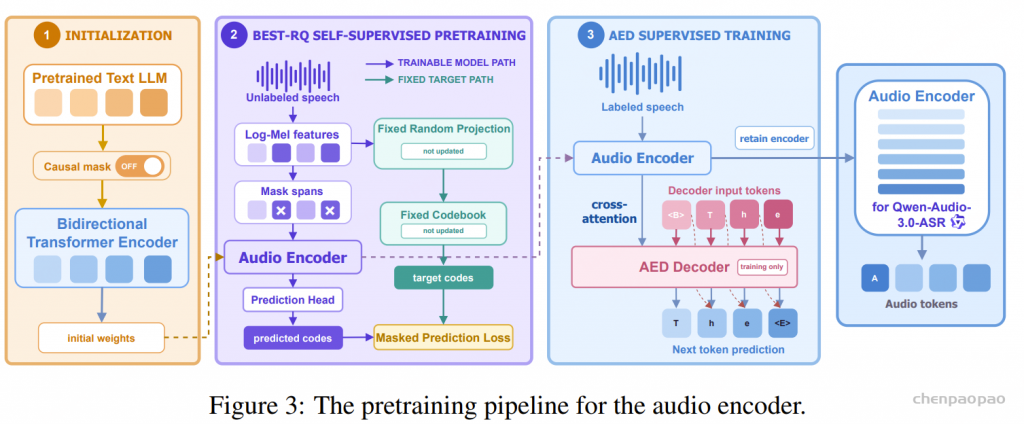
4.1 Audio Encoder:BEST-RQ 自监督 + AED 有监督

第一阶段使用 BEST-RQ 在海量无标注语音上训练。随机遮蔽声学帧,目标是预测由固定随机投影和冻结 codebook 生成的离散目标。部分 Transformer 层从预训练 Qwen3 初始化,但将语言模型中的 causal attention 改为双向 attention,以适应语音编码。数据覆盖 AI、生物科技、电商、教育、娱乐、金融、出行等真实场景,两阶段合计达到数千万小时。

第二阶段把编码器放进 attention-based encoder-decoder(AED)模型,用中文和英文为主的带标注或伪标注数据继续训练。数据流程包含 VAD、多 ASR 模型伪标签(Paraformer-V2、Whisper、SenseVoice)和 ITN。训练结束后,AED Decoder 被丢弃,只保留训练好的 Audio Encoder 作为后续初始化。

BEST-RQ 到 AED 的两阶段音频编码器预训练图

4.2 Audio LLM Pretraining:约 2,000 万小时做音频-文本对齐

Audio Encoder 在这一阶段冻结,Audio Adapter 和 Qwen MoE Decoder 联合训练。数据约 2,000 万小时,主要由 ASR 数据和交错 text-audio 数据组成,目标是文本 token 的交叉熵:

\(\mathcal{L}_{CE}=-\sum_{t=1}^{T}\log P_{\theta}(y_t\mid y_{<t},x,c)\)

这一阶段把声学表示对齐到 LLM 的文本表示空间,形成多语言知识、世界知识、同音词和实体消歧能力,以及后续指令跟随能力。

4.3 LLM Cooldown:减少数量,增加质量与平衡

Cooldown 使用约 100 万小时的更高质量数据,并重新平衡语言和方言分布,同时加入 Audio Understanding、Speaker Diarization 和 SpeechQA。ASR 数据经 VibeVoice 重识别,错误率大于 0.3 的样本被过滤。Audio Encoder 继续冻结,只更新 Adapter 和 Decoder。它的作用不是继续堆数据,而是把大规模预训练模型“收敛”到更可靠、更均衡的音频语言任务。

4.4 SFT:统一指令格式覆盖 30 语言、16 方言和多种业务条件

SFT 使用数千万小时语音,包含人工标注、高置信伪标签、噪声增强、TTS、流式模拟、远场/房间模拟、code-switch、多语言/方言和业务场景数据。Audio Encoder 与 Adapter 更新,Base LLM 冻结并通过 LoRA 适配 Decoder,训练序列最多 8,192 tokens。

  • 指定语言转写:单语场景只输出指定语言;多语混说保留各语言原始书写形式,减少 language leakage。
  • 行业实体增强:从 AI、金融、医疗、IT 等领域挖掘实体,经过“实体 -> 事实检索 -> LLM 造句 -> CosyVoice3 合成 -> 当前 ASR 重识别过滤 -> SFT”流程,强化长尾词。
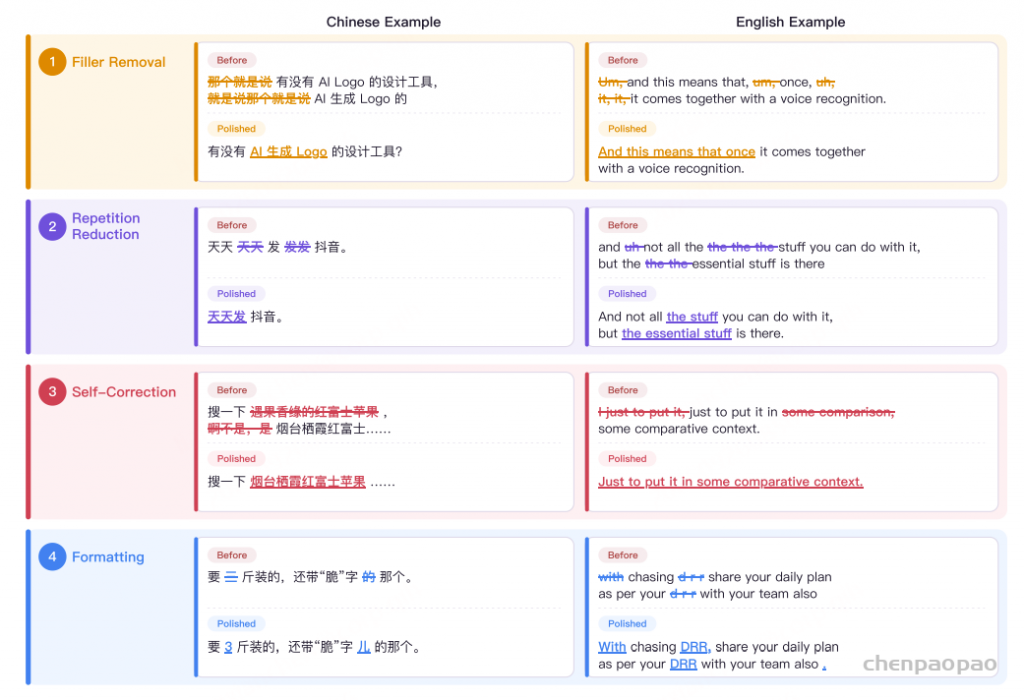
  • 原生润色:用二值指令控制 verbatim 或 polished 输出,学习删除 filler、消除重复、处理 self-correction、补标点和规范格式。
  • 历史上下文:将同一 session 的前序转写作为 context,同时训练正确、冲突、噪声和空 context,明确告诉模型音频始终是主要证据。
  • 分层热词:P0 是高置信、高优先级词;P1 是更宽的候选池。LLM 根据 reference transcript 做语义匹配,P0 bias 更强但仍需得到声学和语义证据支持。

分层热词可以形式化为:对 P0 候选使用更高的条件权重,对 P1 使用较弱权重;目标不是把候选词硬塞进结果,而是在召回长尾词和抑制错误插入之间取得平衡。

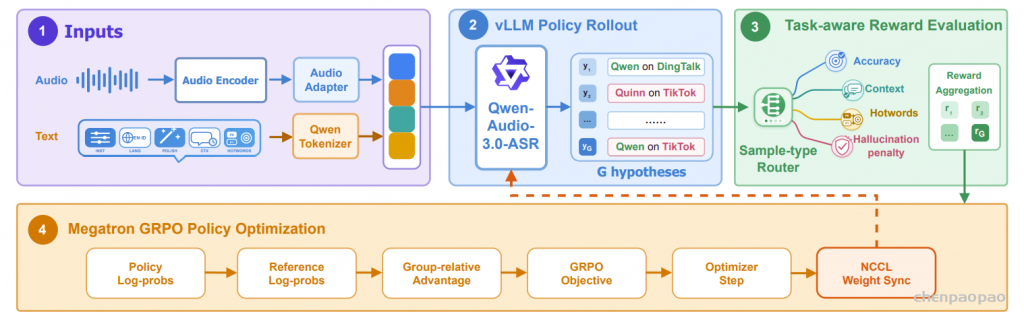
4.5 RL:FunVerl-ASR + GRPO,直接优化 ASR 产品指标

RL 数据集强调 compact、high-quality、hard cases:模型与 Whisper/FireRed-ASR/SenseVoice 不一致的样本、超过 20 秒的长语音、幻觉样本、关键词/热词样本,以及用于防止灾难性遗忘的普通 ASR 数据。

FunVerl-ASR 为音频大模型扩展了普通文本 RL 框架,包含四个并行模块:

  • Audio Processor:波形转 Mel 特征,指令文本转 token。
  • vLLM Rollout Engine:冻结 Audio Encoder/Adapter 生成音频 embedding,与文本 embedding 合并后由 MoE 生成多个候选。
  • Reward Module:支持 CER、关键词召回、热词命中、上下文实体匹配、幻觉检测、语言一致性和 LLM Judge。
  • Megatron Policy Trainer:使用 tensor/pipeline/expert parallel,更新后通过 NCCL 将 Decoder 权重同步回 rollout worker。

其工程创新是 fully asynchronous loop:rollout 持续生成轨迹并放入消息队列,trainer 独立消费并更新策略;当轨迹对应的旧策略过于陈旧时直接丢弃。默认每个 prompt 生成 8 个 hypothesis,每次 actor update 使用 32 个 prompt,在 32 张 A100(rollout 和训练各 16 张)上,一天内完成完整 RL。

GRPO 不需要单独训练 value network。组内 advantage 为:

\(\hat{A}_{i,t}=\frac{R_i-\operatorname{mean}(\{R_j\}_{j=1}^{G})}{\operatorname{std}(\{R_j\}_{j=1}^{G})}\)

策略目标使用 clipped objective 和 KL 惩罚:

\(\mathcal{L}_{GRPO}(\theta)=\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_t\min\left(r_{i,t}(\theta)\hat{A}_{i,t},\operatorname{clip}(r_{i,t}(\theta),1-\epsilon,1+\epsilon)\hat{A}_{i,t}\right)-\beta D_{KL}(\pi_{\theta}\parallel\pi_{ref})\)

当 reward 只有 WER 时,GRPO 与 ASR 中的 MWER 训练接近;论文进一步使用组合 reward:

  • \(R_1=1-WER\):总体识别准确率。
  • 关键词准确率与召回率:既奖励命中,也惩罚错误插入。
  • 热词 reward:分别评价 P0/P1,并使用不对称正负权重。
  • 上下文 reward:奖励命中历史实体,惩罚错误复制。
  • 幻觉抑制:按幻觉 span 长度惩罚。
FunVerl-ASR 的异步 RL 架构图,突出 rollout、reward、policy trainer 和 NCCL 权重同步

五、部署形态:一个模型,三种产品能力

5.1 多语言与方言:从多 checkpoint 变成运行时指令

上一代 Fun-ASR 需要中文英文主模型和独立的 Fun-ASR-ML 多语言 checkpoint。Qwen-Audio-3.0-ASR 改成一个模型加 runtime language instruction,例如 Chinese+English+Japanese、Chinese+French、English+Indonesian。支持语言包括中文、日语、韩语、越南语、泰语、印尼语、马来语、菲律宾语、印地语、阿拉伯语,以及英语、法语、德语、西班牙语、葡萄牙语、俄语、意大利语、荷兰语、瑞典语、丹麦语、芬兰语、希腊语、波兰语、捷克语、匈牙利语、罗马尼亚语、保加利亚语、克罗地亚语、斯洛伐克语和挪威语。

5.2 Streaming:先快后准的混合式解码

流式模型先用短 chunk 和有限 right context 连续输出临时文本;端点检测后,再用完整上下文大模型重算并刷新最终文本。chunk size 与 right context 可以独立调整:上下文越短,响应越快;上下文越长,准确率越高。论文在 H100 上测量 first-token latency 和 text-display latency,低延迟配置下前者低于 200 ms,后者低于 300 ms。

5.3 Message ASR:面向会议、采访和客服的组合式接口

Message ASR 不是另一个模型,而是把 streaming audio、历史上下文、P0/P1 热词、native polishing 和 right context 组合成一个部署 profile。它在说话过程中提供 partial result,结束后用完整 utterance 刷新结果;上下文帮助维持主题和实体一致性,热词帮助识别人名、产品和技术术语,但音频证据始终优先于 context 和 hotword。

Message ASR 工作流图: “识别、上下文、润色和流式延迟在同一接口内完成”

六、公开基准:在统一评测下,中文、英文和多语言都具竞争力

论文同时使用公开数据集和内部工业测试集。公开集包括 AISHELL-1、AISHELL-2、FLEURS、LibriSpeech、WeNetSpeech、GigaSpeechBench 和 Common Voice 15。中文使用 CER,英文使用 WER;数值越低越好。

作者将中文英文结果分为两组:Panel A 是各模型官方报告结果,Panel B 是所有系统通过同一个 API 评测流程得到的结果。Panel A 可能存在预处理、参考文本和打分约定差异,因此真正适合横向比较的是 Panel B。

测试集指标GPT-4o TranscribeAzureDoubao-ASRFun-ASR-FlashTencent Hy-ASR-3.0-previewQwen-Audio-3.0-ASR
AISHELL-1CER3.341.601.540.760.781.03
AISHELL-2CER4.473.242.661.932.152.02
FLEURS-zhCER6.145.518.185.522.382.08
FLEURS-enWER5.795.476.504.955.454.17
LibriSpeech-cleanWER1.581.903.361.351.601.19
LibriSpeech-otherWER3.873.544.462.512.682.24
WeNetSpeech-netCER12.274.584.813.834.164.31
表 1:统一 API 评测结果,单位为百分比,越低越好。

在 Panel B 中,Qwen-Audio-3.0-ASR 在 7 个测试集中的 4 个取得最低错误率:FLEURS-zh 2.08%、FLEURS-en 4.17%、LibriSpeech-clean 1.19%、LibriSpeech-other 2.24%。相对同一 pipeline 下最强竞争系统,分别降低 0.30、0.78、0.16 和 0.27 个百分点;AISHELL-2 也只落后最佳结果 0.09 个百分点。

6.1 多语言结果:GigaSpeechBench 与 Common Voice 15 的宏平均领先

数据集Qwen-Audio-3.0-ASR 宏平均对比结论
GigaSpeechBench22.50%在完整覆盖的系统中最低;7 种语言中 5 种最低
Common Voice 154.57%宏平均最低;7 种语言中 6 种最低
FLEURS4.94%9 种语言中 4 种最低,整体具有竞争力
表 2:多语言宏平均结果。宏平均只统计覆盖对应全部语言的系统。

这组结果体现了论文的主要平衡:模型不是在每一种语言、每一个测试集上都绝对第一,但在跨语言覆盖面和宏平均稳定性上表现很强,尤其适合一个模型服务多个市场的场景。

七、内部工业评测:论文真正想证明的四项能力

7.1 16 种中文方言:CER 与任务一致性同时评估

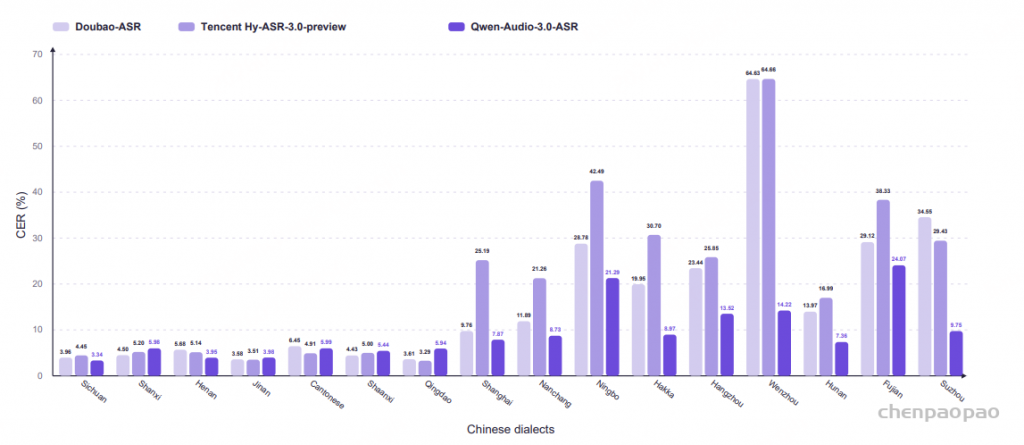
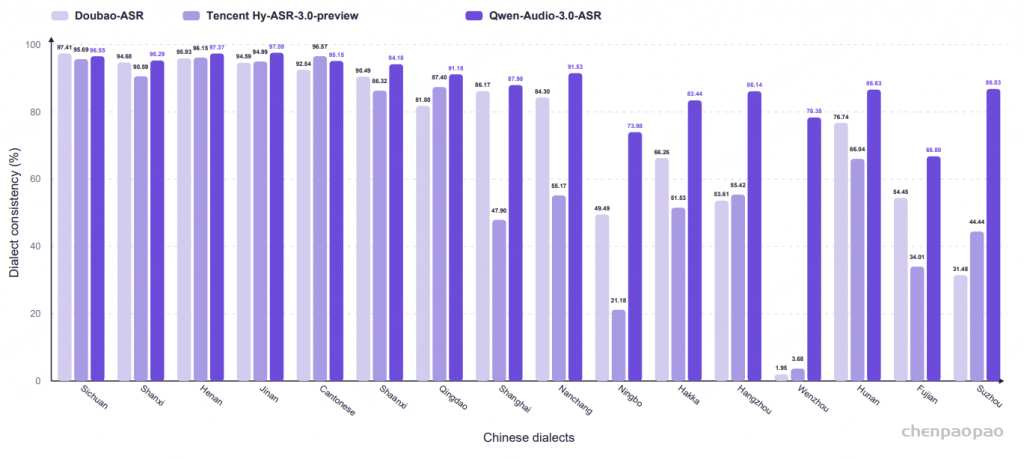
方言测试覆盖 16 种方言。四川、山西、河南、济南、粤语、陕西、青岛采用 ASR 设置,要求保留目标方言;上海、南昌、宁波、客家、杭州、温州、湖南、福建、苏州采用 AST 设置,要求翻译为自然普通话。

一致性由 Qwen3.7-Max 按 0-10 分评价,分数至少为 6 才算一致。计算公式为:

\(Consistency=\frac{100}{N}\sum_{i=1}^{N}\mathbf{1}[s_i\ge 6]\)

Qwen-Audio-3.0-ASR 在 16 个方言子集中的 11 个取得最低 CER,宏平均 CER 为 9.40%,对比 Doubao-ASR 的 16.77% 和 Tencent Hy-ASR-3.0-preview 的 20.40%。在温州话上,模型 CER 为 14.22%,而两个对比系统分别为 64.63% 和 64.66%,差距尤其明显。

16 方言 CER
任务一致性率

7.2 行业实体:15 个领域全部取得最高召回

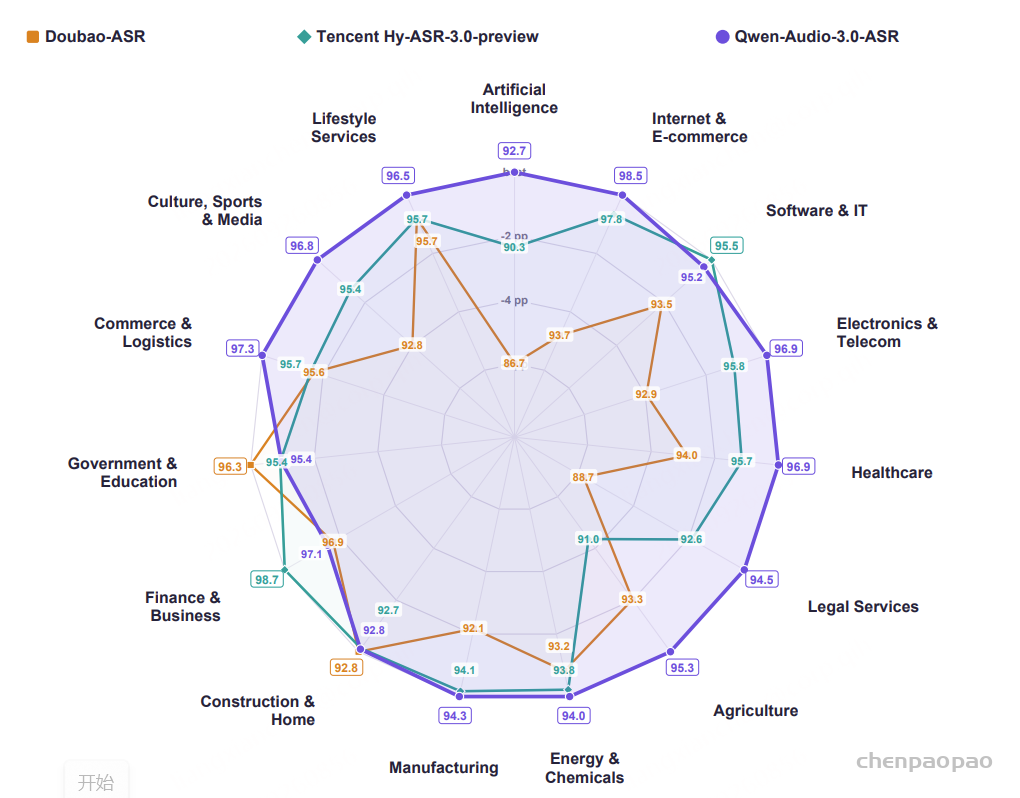
内部行业测试覆盖 15 个领域,包括 AI、医疗、农业、制造、文化体育媒体、软件与 IT 等。Qwen-Audio-3.0-ASR 在所有领域的 entity recall 都高于 Doubao-ASR 和 Tencent Hy-ASR-3.0-preview,软件与 IT 的提升最明显,因为其中包含大量低频、快速变化的软件库、框架和 API 名称。

这里需要保持严谨:论文认为实体挖掘和数据合成 pipeline 很可能是主要贡献之一,但不能据此证明所有提升都由该模块单独带来,因为 MoE 解码器、更多数据和 RL 也可能共同贡献。

15 个行业的实体召回雷达图

7.3 分层热词:P0 召回接近 99%,P1 有意保持更弱 bias

类别Qwen 无热词Qwen + 热词说明
Person names P062.12%99.43%提升 37.31 个百分点
Subject terms P069.36%99.42%高优先级词强增强
Trending buzzwords P063.08%99.46%动态热词效果明显
AI entities P088.22%99.39%接近饱和召回
Brand names P083.83%97.95%实体类别稳定提升
Product entities P072.87%99.07%长尾产品名受益明显
Subject terms P188.46%95.31%较弱 bias,避免误插词
Trending buzzwords P174.00%88.34%保守增强
表 3:Qwen-Audio-3.0-ASR 不同热词层级的召回率。

7.4 长音频上下文:把前文变成 running context cache

很多错误不是当前片段的声学信息不足,而是同音实体、文件名、技术缩写或人名需要跨句记忆。模型把同一 session 中已经识别的前序文本作为上下文,不要求人工维护完整热词表。例如前文已经确认“style.xsl”、TCC、unigram、softmax、debug 或某个人名,后续再次出现时可以抑制声学上相近但错误的替代词。

前文线索参考无长上下文有长上下文
xsltproc style.xsl input.xmlstyle.xsl data.xml > out.htmlxsl data.xml > out.htmlstyle.xsl data.xml > out.html
“这叫法条竞合”法条竞合划掉即可法条竞合
unigram 已出现两次我们称之为 unigramuniqueunigram
TCC 已被反复确认our TCC will be…our GGC will be…our TCC will be…
softmax 已出现softmax 形式softmap 形式softmax 形式
表 4:长音频上下文带来的代表性纠错。

7.5 原生单次润色:可读性接近两阶段级联

传统做法是 ASR 先输出原始转写,再调用一个 LLM 清理 filler、重复和自我纠正。Qwen-Audio-3.0-ASR 用一个 polishing flag 在同一次自回归解码中选择 verbatim 或 polished 输出。

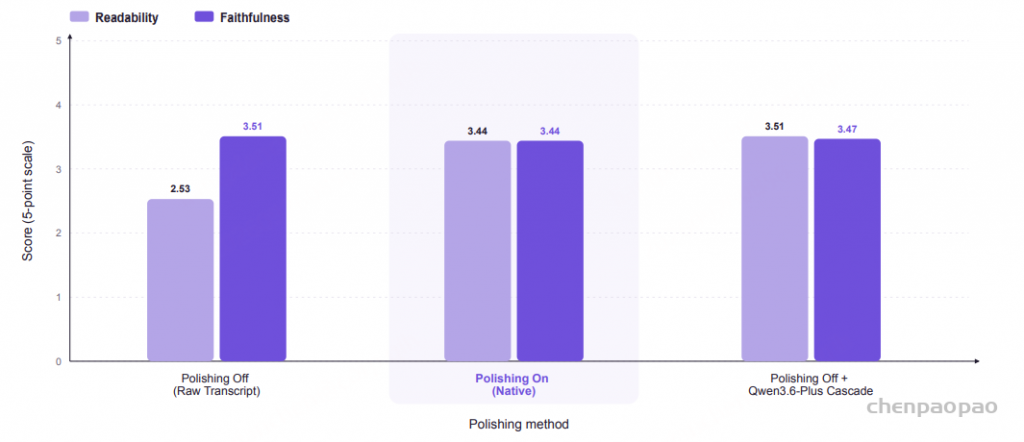
内部 5 分制评测中,原始输出可读性为 2.53,原生润色提升到 3.44;忠实度为 3.44,与两次调用的 ASR + Qwen3.6-Plus 级联方案 3.47 接近,但只需要一次推理。代表性行为包括删除 um/uh、消除 the the the、解析 false start、补充标点并规范缩写。

7.6 流式延迟-准确率:400 ms 是一个可用折中点

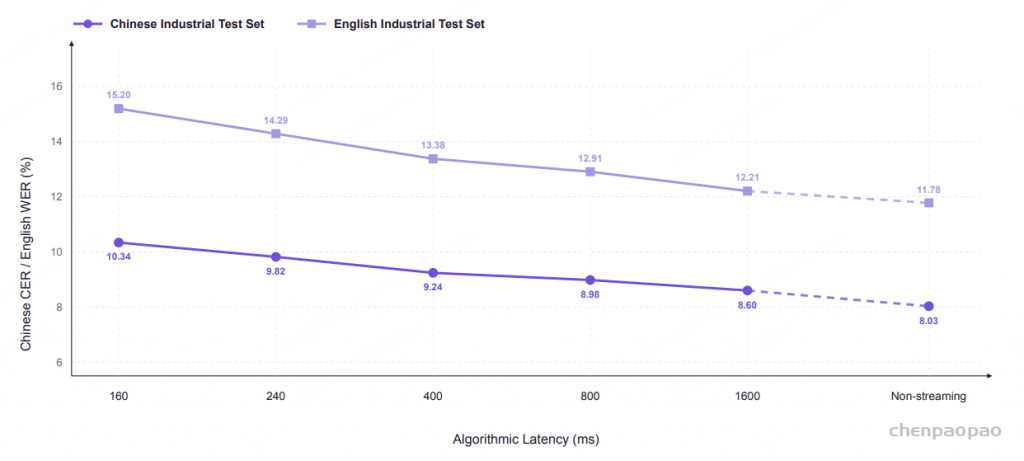
随着 algorithmic latency 增加,中文 CER 和英文 WER 持续下降;非流式模式准确率最低。论文给出 400 ms 延迟点的结果:中文 CER 9.24%、英文 WER 13.38%;非流式分别为 8.03% 和 11.78%,相对错误率增加约 15.1% 和 13.6%。这说明系统可以按产品需求在响应速度和准确率之间选 operating point。

配延迟-准确率曲线,测试硬件为 NVIDIA H100

八、创新点总结:真正有价值的不是单个模块,而是组合方式

  1. MoE LLM-ASR:以 Qwen MoE 替换 Dense Decoder,在增加语言/世界知识容量的同时控制 token 级计算。
  2. 统一 instruction-controlled ASR:语言、历史上下文、热词和润色不是外挂,而是同一解码接口中的条件。
  3. 分层 P0/P1 热词:用优先级和证据约束同时优化长尾召回和错误插入。
  4. 原生单次润色:把“识别 + 可读化”放到一次生成中,减少后处理延迟。
  5. 上下文缓存式长音频建模:利用此前已确认的文本维持跨句实体一致性,不依赖人工热词维护。
  6. FunVerl-ASR 异步 RL:针对音频大模型补齐 rollout、奖励和训练的异步系统,并用复合 reward 优化真实业务目标。
  7. 流式与全上下文结合:实时给反馈,结束后再用完整音频刷新最终文本。

九、如何理解论文的实验优势

从公开 Benchmark 看,Qwen-Audio-3.0-ASR 的优势是整体均衡:中文和英文各有多个测试集领先,多语言宏平均在 GigaSpeechBench 和 Common Voice 15 上领先。从工业集看,最明显的提升集中在通用 CER/WER 难以表达的部分:方言一致性、行业实体、热词、跨句上下文和可读性。

更准确地说,论文证明的不是“每个数据集都第一”,而是“一个统一模型可以同时覆盖多种生产约束”。这对会议记录、客服质检、跨境语音输入和企业知识场景,比只看单一测试集的 SOTA 排名更有意义。

十、局限性

  • Panel A 不完全可比:官方结果可能使用不同预处理、参考文本和评分协议。作者也建议优先参考统一 API 的 Panel B。
  • 大量工业测试集未公开:15 行业实体、16 方言、润色和流式延迟的内部数据有较强应用价值,但外部研究者难以完整复现。
  • MoE 规模信息有限:论文强调稀疏激活带来的效率,但没有在报告中完整披露总参数、激活参数、专家数量和详细吞吐。
  • LLM Judge 可能引入评测偏差:方言一致性使用 Qwen3.7-Max,部分 reward 也支持 LLM Judge;这适合产品质量评估,但需要独立人工标注或跨模型验证。
  • 上下文和热词不是无条件增益:论文反复强调音频是第一证据,错误、过时或冲突的 context/hotword 不应被模型机械复制。
  • 低延迟仍有代价:低于 200 ms 的 first-token latency 与非流式准确率并非同时达到,实际部署必须根据业务选择 operating point。

十一、结语

Qwen-Audio-3.0-ASR 的核心贡献,可以概括为一句话:它把 ASR 从“音频到文字”的单一任务,升级成“音频 + 指令 + 上下文 + 业务词表 -> 可直接使用文本”的统一生成系统。

其工程路线也很清晰:用数千万小时数据建立规模基础,用 Qwen MoE 提供语言和世界知识,用 SFT 把产品控制信号统一进解码,用异步 GRPO 直接优化 CER、热词、上下文和幻觉指标,再通过 streaming/full-context 和 Message ASR 落到低延迟业务。公开基准证明了竞争力,工业测试则说明它的真正卖点在长尾实体、方言、上下文和可读性。

如果把这篇报告放到 ASR 的发展脉络里看,它的重要性不只是“又一个更大的模型”,而是尝试回答一个更实际的问题:在多语言、长音频、动态热词和低延迟约束同时存在时,能否用一个可控的音频大模型替代多套串联系统。Qwen-Audio-3.0-ASR 给出的答案是肯定的,但其内部数据、模型规模和评测可复现性仍值得后续公开与验证。

参考资料:
1. Qwen-Audio-3.0-ASR Technical Report, arXiv:2609.07549v2, https://arxiv.org/abs/2609.07549
2. Nova Speech,《最新工业SOTA转写模型:Qwen-Audio-3.0-ASR》,https://mp.weixin.qq.com/s/_jWVjU0XslOw31WPAjhEdg

dLLM-ASR:更快的扩散式大语言模型语音识别框架

  • 论文题目:dLLM-ASR: A Faster Diffusion LLM-based Framework for Speech Recognition
  • 论文链接:arXiv:2601.17902

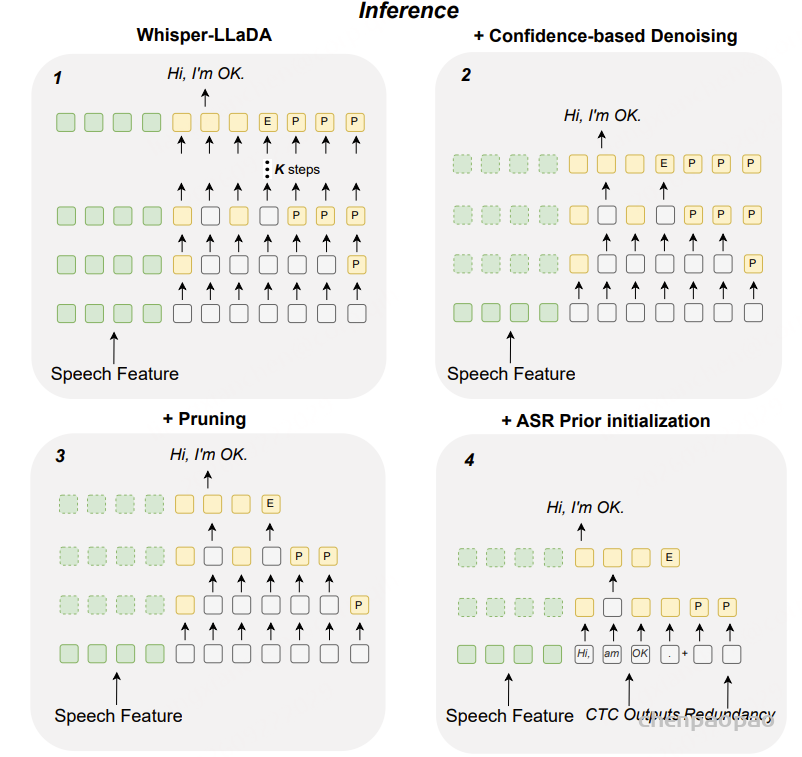
大语言模型语音识别(LLM-ASR)通常“准”,但解码仍是逐 token 的自回归生成,延迟会随句子长度线性增长。离散扩散大语言模型(dLLM)可以并行生成整段序列,却容易从全掩码开始、固定输出长度,并让每个 token 使用同样的去噪步数。论文提出的 dLLM-ASR 将 ASR 解码重新定义为先验引导的自适应去噪:用轻量 ASR 先验提供更好的初始状态和长度锚点,用长度自适应剪枝去掉冗余填充 token,再用基于置信度的早停把计算集中到仍然模糊的位置。

一句话结论:dLLM-ASR 在保持与自回归 LLM-ASR 接近的识别准确率的同时,平均 RTF 降至 0.063,相对 Whisper-LLaMA3 取得 4.44× 加速,并在论文比较的模型中给出了最好的精度—效率折中。

一、为什么要把扩散语言模型用于 ASR

LLM-ASR 通常由语音编码器、模态对齐模块和 LLM 解码器组成。它可以利用预训练语言模型的语义推理、长尾词汇和上下文建模能力,但自回归(AR)解码必须按顺序预测每一个 token,复杂度近似为:

\(T_{\mathrm{AR}}=\mathcal{O}(N)\)

非自回归(NAR)模型可以并行预测,理论上更快,但往往缺少大规模基础模型的语言知识。dLLM 在离散 token 空间中进行多轮并行去噪,在保留预训练 LLM 语义能力的同时,将生成过程改写为有限轮数的迭代 refinement:

\(T_{\mathrm{dLLM}}=\mathcal{O}(K),\quad K\ll N\)

问题在于,文本 dLLM 面向的是开放式生成,而 ASR 是由声学输入强约束的映射任务。直接移植会产生三类浪费:从全掩码序列开始,忽略语音中已有的信息;输出长度预先写死,过长会产生大量 padding,过短又可能截断;所有 token 使用统一的去噪预算,已经确定的简单词仍被重复计算。

二、dLLM-ASR 的整体设计

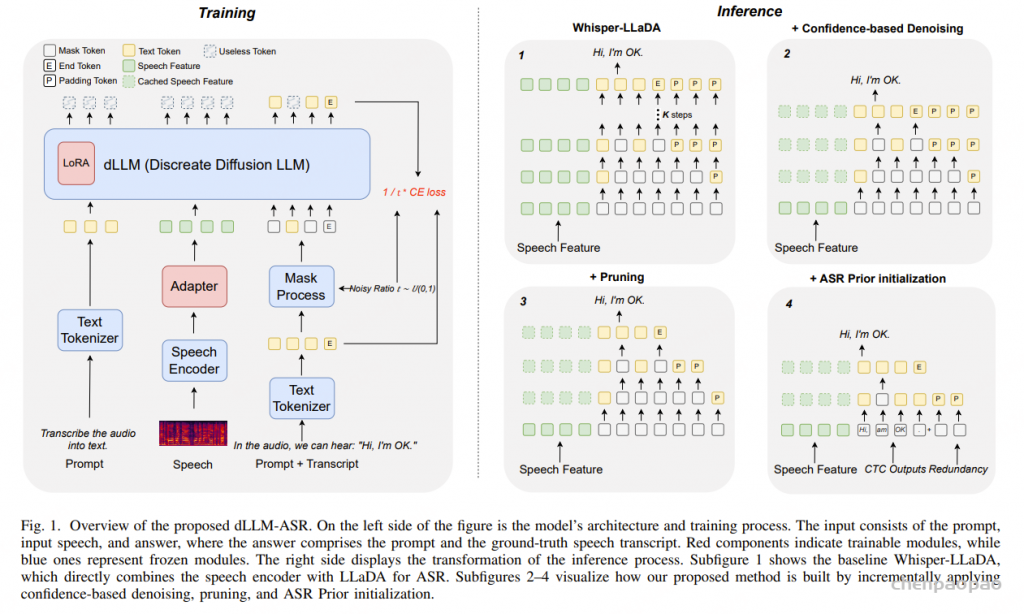
dLLM-ASR 由三部分组成:冻结的 Whisper-large-v3 语音编码器、轻量级 adapter,以及以 LLaDA-8B-Instruct 为基础的 dLLM 解码器。语音编码器以 25 Hz 输出声学表示;adapter 先用 kernel size 为 3、stride 为 2 的一维卷积把帧率降到 12.5 Hz,再通过线性层将 1280 维声学特征投影到 LLaDA 的 4096 维 embedding 空间。

设输入语音为 \(W\),声学条件特征为:

\(A=\mathrm{Projector}\big(\mathrm{SpeechEncoder}(W)\big)\)

解码器接收文本提示、语音特征和转写序列。训练时,真实转写 \(x_0\) 中的 token 以概率 \(t\in(0,1]\) 独立替换为特殊掩码 \([\mathrm{M}]\),得到 \(x_t\);模型根据 \(x_t\) 和语音条件 \(A\) 恢复被掩盖的 token。论文采用带 \(1/t\) 归一化的掩码重建目标:

\(\mathcal{L}=-\mathbb{E}_{t,x_0,x_t}\left[\frac{1}{t}\sum_{i=1}^{L}\mathbb{I}(x_t^i=[\mathrm{M}])\log p_\theta(x_0^i\mid x_t,A)\right]\)

当掩码比例较低时,\(1/t\) 会提高该样本的权重,避免不同噪声水平造成训练偏置;同时以概率 \(\alpha\) 令 \(t=1\),增强模型从全掩码状态恢复转写的鲁棒性。

两阶段训练与聊天式数据格式

第一阶段只训练 adapter,冻结语音编码器和 dLLM;第二阶段在 LLaDA 中加入 LoRA,同时优化 adapter 与 LoRA 参数,从而尽量保留预训练 dLLM 的语言能力。论文还发现,数据格式对生成质量影响明显:把语音表示和转写包装成类似文本 LLM 的 chat-style prompt,有助于激活模型原有的指令跟随能力,并缩小跨模态差距。

三、核心创新:先验引导的自适应去噪

1. ASR 先验初始化。论文增加一个极轻量的 CTC 分支,在冻结语音编码器输出上预测初始 ASR 先验。该分支仅包含下采样卷积和分类头,额外计算开销很小。先验不要求一次性给出最终答案,而是作为扩散过程的起点:它提供较好的语义锚点,也自然给出候选序列长度。与从全掩码开始相比,第一轮就会有更多 token 达到置信度阈值。

2. 基于置信度的 token 早停。每一轮去噪后,若某个 token 的最大预测概率超过阈值 \(\tau\),就将其固定并退出后续迭代。这样,清晰的词或字符只需较少步数,难点位置则继续 refinement。为避免错误 token 过早锁定,论文采用较高阈值,并在没有 token 达标时选择置信度最高的 top-\(\gamma\) 个 token 推进过程。

3. 长度自适应剪枝。ASR 中 padding token 往往熵低、收敛快,第一轮即可识别。模型在固定高置信 token 的同时检测序列尾部 padding,并逐轮删除冗余位置,动态收紧长度上界。该策略避免了固定 128 token 生成长度带来的无效计算。

4. 语音 KV cache。模型缓存与语音特征对应的 Key/Value,并在后续去噪轮次复用;由于缓存严格限制在 speech features 上,论文观察到几乎没有精度损失。这使每一轮只需更新尚未确定的文本位置。

完整推理流程可以概括为:先验初始化状态与长度 → 第一轮锁定高置信 token、提取语音 KV cache、识别尾部 padding → 后续轮次复用 cache,只更新未决位置并持续剪枝 → 所有位置确定后结束。

四、实验设置

训练数据共 13,900 小时,来自 LibriSpeech、CommonVoice 22.0 English 和 GigaSpeech。测试集包括 LibriSpeech test-clean、LibriSpeech test-other、CommonVoice English test,并加入域外的 VoxPopuli English test 检验泛化能力。

解码器为 8B 参数的 LLaDA-8B-Instruct,语音编码器为冻结的 Whisper-large-v3。训练时总 mask 概率 \(\alpha=0.2\);LoRA rank 为 16,缩放系数为 32,dropout 为 0.05;优化器为 AdamW(\(\beta_1=0.9,\ \beta_2=0.999\))。两阶段均训练 5 个 epoch、总 batch size 256,学习率先在线性 warm-up 4,000 步后升至 \(1\times10^{-4}\),再按 cosine 调度衰减。所有实验使用 16 张 NVIDIA A100。

对比模型包括自回归的 Whisper-LLaMA3 8B、Whisper-Qwen3 8B,以及直接把语音编码器、adapter 与 LLaDA 拼接的 Whisper-LLaDA。后者固定生成长度为 128 token,覆盖约 99% 的语音转写。评价指标为词错误率(WER,越低越好)和实时率(RTF,计算时间/音频时长,越低越好)。

五、主要结果:速度和准确率同时进入更优区域

模型解码器参数LS clean WER / RTFLS other WER / RTFCV test WER / RTFVoxPopuli WER / RTF平均 WER / RTF
Whisper-LLaMA38.03B2.15 / 0.3175.58 / 0.3308.55 / 0.2039.89 / 0.2686.54 / 0.280
Whisper-Qwen38.19B2.72 / 0.4106.62 / 0.4279.18 / 0.35510.06 / 0.3647.15 / 0.389
Whisper-LLaDA8.02B2.34 / 1.6785.22 / 1.8928.80 / 2.0299.68 / 1.3446.51 / 1.736
dLLM-ASR8.02B2.28 / 0.0575.17 / 0.0768.36 / 0.0579.56 / 0.0606.34 / 0.063
表 1:论文主要测试结果。WER 为百分比,RTF 越低表示推理越快。

从表 1 可以看到,dLLM-ASR 的平均 WER 为 6.34%,优于 Whisper-LLaMA3 的 6.54%、Whisper-Qwen3 的 7.15%,也略优于直接移植的 Whisper-LLaDA(6.51%)。在更具挑战性的 LibriSpeech test-other、CommonVoice 和 VoxPopuli 上,dLLM-ASR 均取得最低 WER;在 test-clean 上也保持竞争力。

速度差异更明显:dLLM-ASR 平均 RTF 仅为 0.063,而 Whisper-LLaMA3、Whisper-Qwen3 和 Whisper-LLaDA 分别为 0.280、0.389 和 1.736。换算后,dLLM-ASR 相对 Whisper-LLaMA3 加速约 4.44×,相对 Whisper-Qwen3 加速约 6.17×,相对直接的 Whisper-LLaDA 加速约 27.6×。这说明扩散模型本身并不会自动带来速度优势,真正关键的是先验初始化、长度剪枝和 token 级早停的协同。

六、消融实验说明了什么

模型/变体LS clean WER / RTFLS other WER / RTF
dLLM-ASR2.28 / 0.0575.17 / 0.076
w/o ASR Prior2.29 / 0.0695.20 / 0.084
w/o Length Pruning2.27 / 0.0715.13 / 0.089
w/o Chat-Style Prompt2.87 / 0.0565.76 / 0.076
Whisper-LLaDA2.34 / 1.6785.22 / 1.892
Whisper-LLaDA + confidence denoising2.98 / 0.0775.98 / 0.108
表 2:论文消融实验结果。

去掉 ASR prior 后,LS clean/other 的 RTF 从 0.057/0.076 上升到 0.069/0.084,说明更好的初始状态可以显著减少去噪轮次。去掉长度剪枝后,RTF 进一步上升到 0.071/0.089,验证了删除 padding 对效率的直接贡献。去掉 chat-style prompt 虽然速度变化不大,却使 WER 明显恶化到 2.87/5.76,说明数据组织方式对跨模态对齐和生成质量非常关键。

值得注意的是,仅把 confidence-based denoising 加到 Whisper-LLaDA 上,RTF 可以降到 0.077,但 WER 反而升至 2.98/5.98。这一结果说明“早停”不能孤立使用:如果没有先验提供可靠起点、没有长度剪枝控制候选空间,单独追求更少的迭代会造成错误过早固化。

阈值的选择

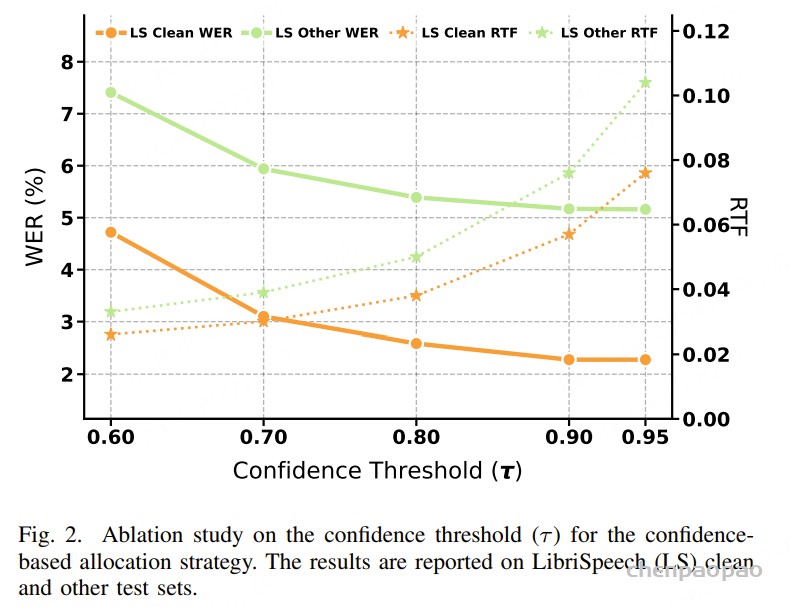
论文进一步扫描置信度阈值 \(\tau\)。阈值从 0.6 提高到 0.9 时,token 接受更谨慎,WER 改善但 RTF 变高;阈值继续从 0.9 提高到 0.95,WER 差异已经很小。因此作者将 \(\tau=0.9\) 作为默认值,在速度和精度之间取得更好的平衡;推理时 top-\(\gamma\) 参数取 1。

七、如何理解这项工作的价值

dLLM-ASR 的关键不只是“把 LLM 换成扩散 LLM”,而是针对 ASR 的结构性约束重新设计推理过程。语音已经提供了强条件,因此没有必要像开放式文本生成那样从纯噪声猜测;ASR 的输出存在明显的长度和 padding 结构,因此可以主动删掉简单位置;不同词的识别难度不同,因此计算预算应当按 token 分配,而不是统一分配给整句。

从系统角度看,这是一种“先验负责覆盖,扩散负责纠错”的组合:轻量 CTC 分支快速给出可用草稿,dLLM 再利用强语言模型能力修正含糊、长尾或上下文依赖的位置。最终模型在精度—效率平面上形成新的 Pareto 前沿,尤其适合对实时性敏感、又不能接受明显识别退化的语音应用。

八、局限与后续方向

论文当前主要验证英语离线或整段语音识别,默认仍需要为一段输入建立完整的候选序列。阈值、先验质量和 padding 剪枝规则也会影响不同数据域下的稳定性。作者将后续工作指向流式 ASR 和更多任务场景,这也是检验扩散式解码能否在持续输入、动态上下文中保持优势的关键。

结语

dLLM-ASR 给出了一个清晰的答案:扩散 LLM 可以用于高质量语音识别,但必须从“通用文本生成”转向“受语音先验约束的自适应 refinement”。通过 ASR prior、长度自适应剪枝、置信度早停和语音 KV cache,论文在 8B 参数规模下实现了平均 WER 6.34%、平均 RTF 0.063,并相对自回归 Whisper-LLaMA3 达到 4.44× 加速。其更具普适性的启示是:当生成任务拥有强条件输入时,最有效的扩散推理往往不是从噪声开始,而是从一个便宜但有信息的先验开始。

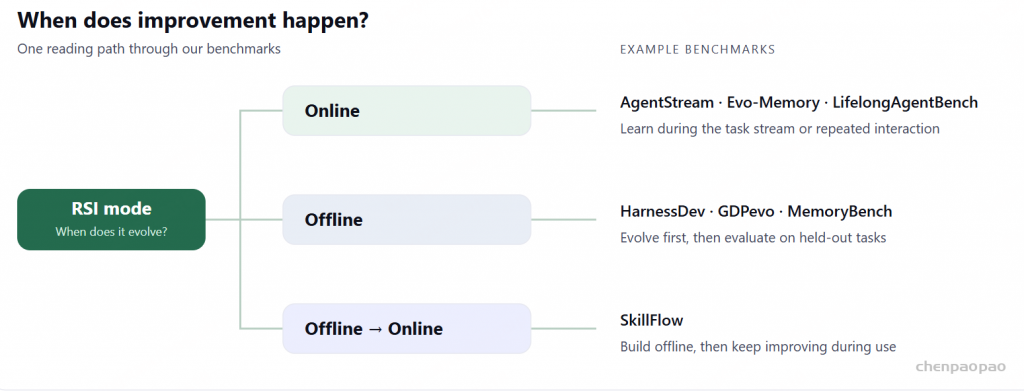
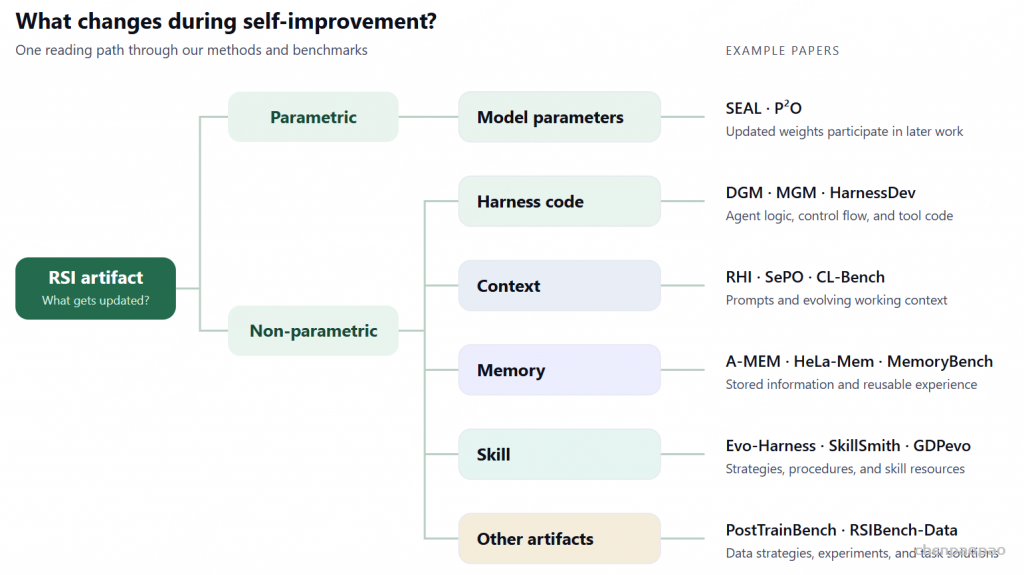
RSI – [Recursive Self-Improvement]

Awesome RSI 仓库(网站),尝试从分类的视角整理现有 RSI 工作

https://github.com/Prism-Shadow/awesome-rsi

收录关于智能体从自身经验中学习的论文、书籍与课程,涵盖自我演化、技能学习、记忆、持续学习和自动化 AI 研究。你可以按主题筛选、搜索,并按时间或影响力排序。