Confucius4-R2T2:让语音识别学会何时输出、何时等待

摘要:流式 ASR 的难点不只是“尽快识别”,还包括决定哪些文字已经足够可靠、可以提交给字幕、翻译或语音智能体,以及哪些内容应该继续等待。网易有道开源的 Confucius4-R2T2(Real Real-Time Transcription)以 Qwen3-ASR-1.7B 为基础,通过 Longest Stable Prefix(LSP,最长稳定前缀)学习和显式 Wait token,把“何时输出”变成模型训练目标。模型只追加已经提交的前缀,不回改已发布文本,同时通过 chunk size 和暂留 token 数 U 调整质量与延迟。

一、流式 ASR 为什么会“闪烁”

离线 ASR 可以等待完整语句,再利用完整上下文生成结果;流式 ASR 只能根据当前已经收到的声音逐步输出。比如用户说 I have two cats,系统可能先输出 I have to,随后变成 I have too,最后才确定为 I have two cats。对人类字幕来说这是文字闪烁,对下游系统来说则可能导致翻译、检索、工具调用或 LLM 推理重复执行。

R2T2 要求所有时刻的对外输出满足前缀单调性:如果 yt 是时间 t 的已发布文本,那么任意更晚时刻 t’ 都必须满足:

\(y_t\preceq y_{t’}\)

也就是说,后续文本只能在末尾追加,不能修改早先已经发布的字符或 token。

二、R2T2 的核心定位

  • 基础模型:Qwen3-ASR-1.7B。
  • 后训练数据:约 1,500 小时中英文语音,约 600,000 条样本,中文和英文各 300,000 条。
  • 训练组件:冻结音频编码器和 projector,只训练语言解码器。
  • 架构变化:不增加预测头,不做因果化编码器,不使用额外的因果 attention mask。
  • 流式 chunk:支持 80 ms 到 2 s;主实验使用 160 ms。
  • 输出策略:稳定前缀只追加;不稳定的尾部由 Wait 或内部暂留机制处理。
  • 部署形态:支持 vLLM、Transformers 离线推理、llama.cpp 和 WebSocket 流式服务。

R2T2 的思想不是把基础模型完全改造成因果 ASR,而是保留全上下文模型的声学能力,再让解码器学习在不完整音频下做“提交/等待”决策。

三、基础架构:Qwen3-ASR-1.7B 上只改解码器

Qwen3-ASR-1.7B 由 Qwen3-1.7B 语言模型、音频 projector 和 AuT 音频编码器组成。AuT 编码器约 300M 参数,隐藏维度 1,024,对 128 维 log-Mel/Fbank 特征进行 8 倍 CNN 下采样,输出约每 80 ms 一个音频位置,即 12.5 Hz。

模块R2T2 处理原因
音频编码器冻结保留预训练的双向声学表示
Projector冻结保持声学表示到语言模型输入空间的映射
语言解码器训练学习 LSP 内容、Wait 和发射时机
额外预测头不增加Wait 与文本 token 共用词表
因果化编码器不做保留双向注意力和全上下文识别能力

这种设计的代价是活动窗口在新音频到达时仍需重新编码;收益是避免重新训练因果编码器和重新建立完整的声学-文字对齐。
R2T2 模型与流式推理框架图

四、Longest Stable Prefix(LSP)是什么

常规 ASR 训练只有“音频-完整转写”配对,并没有标注模型在某个中间时刻可以提交到哪里。R2T2 先让基础模型逐步读取音频前缀,再用模型完整听完音频后的输出作为锚点。

设完整音频为 x,同一模型听完整音频得到:

\(\bar y=M(x)\)

只听到时间 t 的音频前缀时,模型输出:

\(y_t=M(x_{\le t})\)

LSP 定义为:在此前已经产生的完整输出中,最长的、同时也是完整输出 \bar y 的前缀:

\(L_t=\operatorname{LSP}(M,x,t)=\bar y_{1:m_t}\) \(m_t=\max_{j\le t}n_j\mathbf{1}[y_j\preceq\bar y],\qquad n_j=|y_j|\)

这里的关键是“完整输出过”。如果某次模型输出 I have too,不能把它人工截成 I have 当成一条新的 LSP;只有模型此前完整输出过 I have,它才具有 model-admissible 性。

4.1 为什么 LSP 会单调增长

随着更多音频到达,已经确认的 LSP 只会保持不变或变长,不会缩短。最终完整音频时,LSP 等于模型完整输出。它的稳定性不是来自“把当前结果截掉几个词”,而是来自对模型历史输出的严格筛选。

需要特别注意,LSP 锚定的是模型自己的完整音频输出,不是人工参考文本。因此 LSP 主要负责稳定性与提交时机;模型听完整音频仍然识别错误时,LSP 也可能忠实地稳定输出错误内容,准确率必须另用 WER/CER 评估。

五、Wait 标签:把“继续输出”与“先等待”分开

研究者每隔 80 ms 把更长的音频前缀送入教师模型,记录输出等于 LSP 的稳定区间。连续稳定端点合并为:

\(I_i=[s_i,e_i]\)

训练时随机选择切点 t,只保留 x≤t,模拟在线识别。如果切点位于稳定区间,则目标是稳定前缀;如果切点落在稳定区间之间,则目标是在 LSP 后面追加 Wait:

\(y_t^*=\begin{cases}LSP(M,x,t),&\exists i:s_i\le t\le e_i\\LSP(M,x,t)\oplus Wait,&\text{otherwise}\end{cases}\)

Wait 是普通词表中的一个特殊 token,不是额外的二分类头。模型因此同时学习:

学习目标问题输出
内容决策现在可以提交哪些文字文本 token
时机决策当前信息是否足够Wait token

这也是 R2T2 与“把当前截断音频强行完整转写”的重要区别:R2T2 的目标是预测当前条件下最终转写的安全前缀,而不是猜测截断句子的完整尾部。
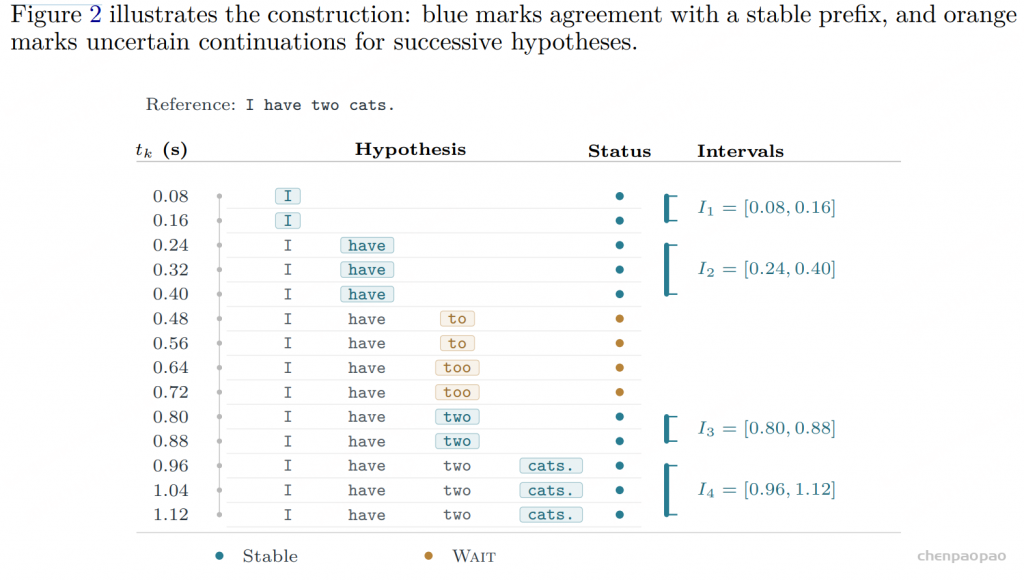
“I have to / I have too / I have two” 的稳定区间和 Wait 标签图

六、Streamability:选择适合流式改造的基础模型

streamability 衡量模型在音频逐渐到达时,LSP 增长得有多快。对每个时刻,先统计平均 LSP 长度:

\(l(M,t)=\frac{1}{|N(t)|}\sum_{x\in N(t)}|LSP(M,x,t)|\)

还可以将音频进度和 LSP 长度归一化:

\(\tau_{x,t}=\frac{t}{|x|},\qquad\bar l_{x,t}=\frac{|LSP(M,x,t)|}{|M(x)|}\)

再对归一化曲线求面积:

\(s(M)=AUC(\bar l(M,\tau))\)

在 1,860 条 Buckeye 英语语句上,Qwen3-ASR-1.7B 的归一化 streamability 为 0.493,在比较模型中最高。它表示这个基础模型更容易从完整上下文转换成稳定前缀流式模型,不等于真实设备上的端到端延迟。
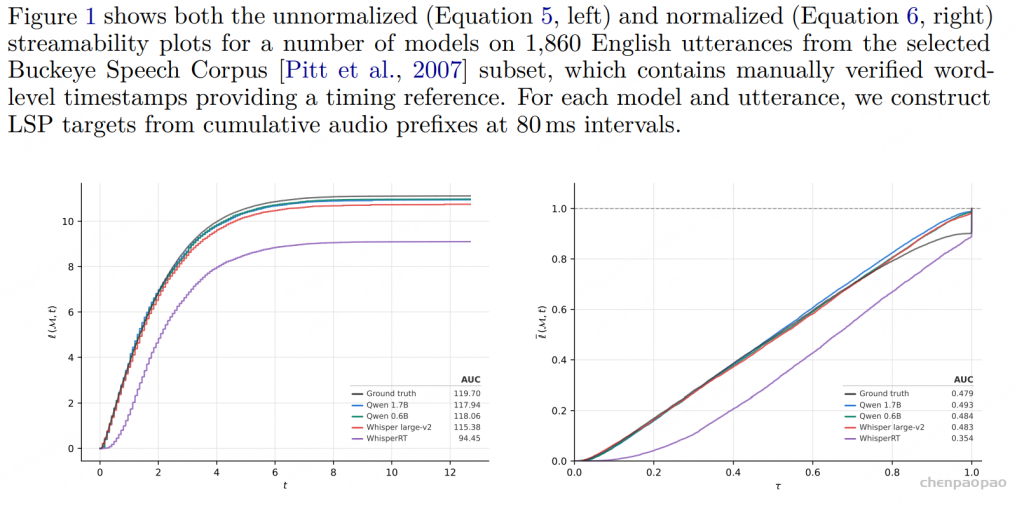
不同模型的 streamability 曲线与 AUC

七、训练数据与增强

项目配置
数据规模约 1,500 小时、600,000 条中英文语音
语言比例中文 300,000 条,英文 300,000 条
公开数据SFT 和 GRPO 不使用公开训练数据,评测集不进入后训练
特征10 ms Fbank hop,128 维 log-Mel
编码器帧间隔80 ms,12.5 Hz
噪声 SNR10-35 dB
纯噪声替换10%
混合噪声30% 条件概率
混响40%,其中 90% 真实 RIR、10% 模拟 RIR
语言标签翻转10%

增强针对流式 ASR 的实际失败模式:纯噪声或无语音时的幻觉、噪声和混响下的识别退化、语言标签错误导致的语言跑偏,以及短音频前缀导致的过早续写。语言标签翻转让模型更依赖实际声学内容,而不是无条件相信提示。

八、两阶段后训练:SFT + GRPO

8.1 SFT

SFT 使用 LSP 转写和 Wait 目标的交叉熵。训练 1 个 epoch,Fused AdamW,初始学习率 1e-5,2% warmup 后线性衰减,有效全局 batch size 为 64;只更新语言解码器,音频编码器和 projector 冻结,LoRA 不启用。

  • 10% 样本使用完整 utterance 和完整转写,保持离线识别能力。
  • 90% 样本随机取音频前缀。
  • 前缀切点中,50% 位于 LSP 稳定区间,学习输出稳定文字。
  • 另外 50% 位于稳定区间之间,学习输出 LSP + Wait。
  • 音频注意力窗口随机取 1-8 秒,窗口内保持双向注意力。

8.2 GRPO

GRPO 从 SFT 模型开始,对每个 prompt 采样多个流式轨迹,使用组内相对奖励优化质量和等待行为。轨迹可以跨越 1、2 或 4 个流式 turn,使模型接受更多音频后仍能被评估。

奖励项权重主要作用
CER0.300主要字符级识别信号
Precision0.150惩罚错误插入
Length0.150惩罚过长续写
Repetition0.125抑制重复字符和重复片段
Language Consistency0.150保持中文/拉丁字符构成与目标一致
Tail0.050惩罚稳定区间内的尾部冗余
Word Accuracy0.050评价稳定区间内局部词/字准确性
Cut Marker0.025监督 Wait 是否存在以及位置是否正确

加权奖励经过空输出、精确匹配和退化输出等特殊规则后,使用:

\(R(y_t,y_t^*)=\tanh(3R_{raw}(y_t,y_t^*))\)

这些奖励共同抑制:没有足够声音时继续编造、重复输出、语言跑偏、把 Wait 放在文本中间、在稳定区间外输出未经支持的尾部。论文指出,单个奖励分量的独立作用仍需要受控消融,不能把全部收益归因于某一个奖励。

九、流式推理的四项优化

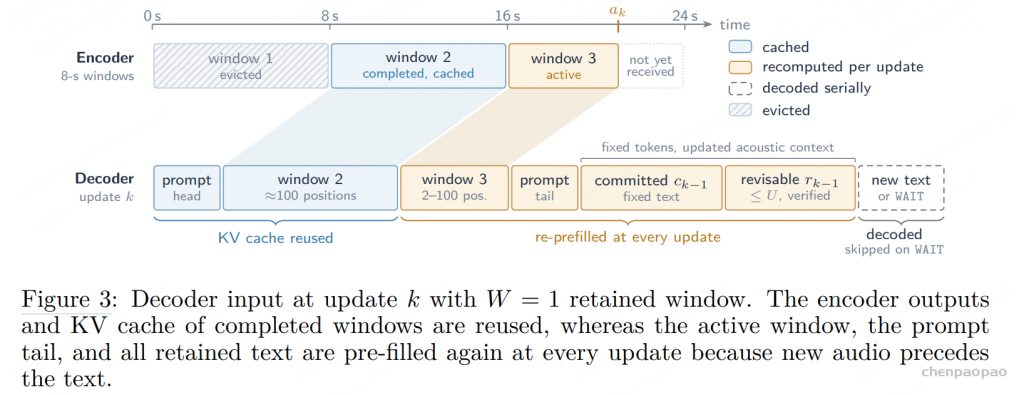
编码器每 80 ms 产生一个位置;主实验使用 160 ms chunk,因此每条流每秒约更新 6.25 次。为了让每次更新及时完成,R2T2 使用四项优化。

9.1 编码器缓存

推理时使用不重叠的 8 秒窗口。完整窗口的编码结果不再依赖未来音频,可以缓存;每次只重新编码正在增长的活动窗口。活动窗口最多约 100 个 80 ms 位置。

9.2 Wait 终止解码

每轮 pre-fill 后的第一个预测就是当前动作。如果预测为 Wait,本轮立即结束,不再执行串行 token 解码;如果不是 Wait,才继续生成,直到遇到 Wait 或 EOS。静音或信息不足的更新因此只需要一次 pre-fill。

9.3 有界上下文

只缓存完成窗口仍会让上下文不断变长。R2T2 只保留最近 W 个完成窗口和当前活动窗口,驱逐更早窗口及其之前已经提交的文本。上下文上限为:

\(8(W+1)\text{ 秒}\)

主实验使用 W=1,相当于一个最近完成窗口加一个活动窗口,约 16 秒音频上下文。

9.4 Pre-fill verification

当 U>0 时,上次生成但尚未提交的最后 U 个 token 作为可变后缀。新音频到达后,pre-fill 已经计算主模型在这些位置的新预测。系统保留与新预测一致的最长前缀,在第一个分歧处截断 KV cache,用新 token 替换,再继续解码。这相当于把暂留后缀当作 draft,用主模型 pre-fill 做局部核验;已经提交的前缀永远不回改。
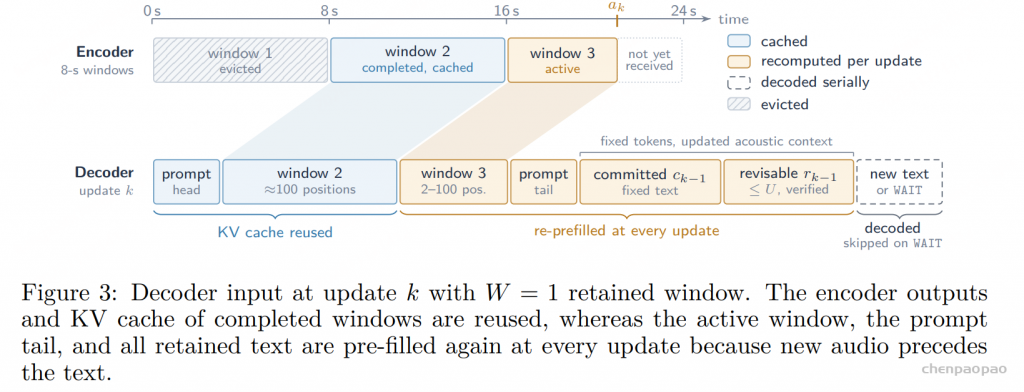
prompt head、完成窗口、活动窗口、已提交文本和可变后缀的更新布局图

十、U 参数:质量优先还是延迟优先

配置含义典型取舍
U=0不额外暂留 token延迟更低,错误率略高
U=1最后一个 token 暂留内部质量优先,等待少量更多上下文
U=5暂留最后五个 token基础模型 2 s 参考配置,延迟更高

U 不代表固定毫秒数。同一个 token 在不同语言、语速和 BPE 分词下对应的音频时长不同。它是“暂留 token 数”的控制旋钮,而不是严格的时间延迟参数。

十一、实验结果:流式质量接近离线模型

配置13 个测试集宏平均错误率解释
基础模型,完整音频5.15%离线全上下文参考
基础模型,2 s,U=55.25%准确率参考,发射更晚
基础模型,160 ms,U=121.01%小 chunk 下明显退化
R2T2,160 ms,U=15.76%质量优先
R2T2,160 ms,U=06.40%延迟优先
X-ASR,160 ms8.97%开源对比配置
AssemblyAI,160 ms8.27%商业 API 对比
Commercial A,160 ms6.23%商业 API 对比
Commercial B,160 ms6.01%商业 API 对比

160 ms、U=1 时,R2T2 在表中列出的全部中英文测试集上优于基础模型同条件配置,宏平均错误率从 21.01% 降到 5.76%,相对下降约 72.6%。与基础模型完整音频的 5.15% 相比,仅差约 0.61 个百分点。R2T2 在纳入排名的流式配置中取得最低综合错误率,但并非每个单独测试集都超过所有商业系统。

评测集包含英文 AMI、Giga-clean、LibriSpeech、VoxPopuli、Earnings22、TED-LIUM、EN-RealSI,以及中文 Wenet-net、Wenet-meeting、SPEECHIO-06、SPEECHIO-07、CN-RealSI。英文使用 WER,中文使用 CER,每个数据集等权计算宏平均。

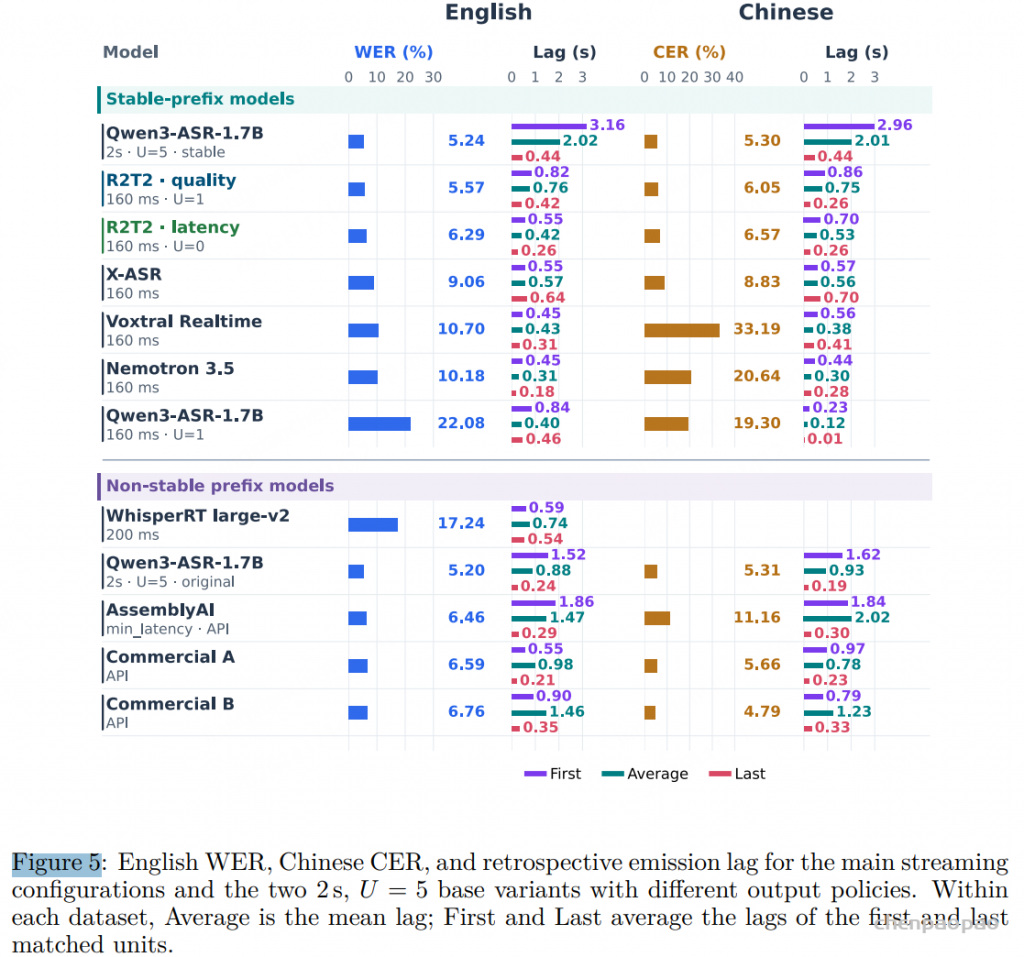
图片占位(论文 Table 3,ID:tab:main-recognition-comparison;论文 Figure 5,
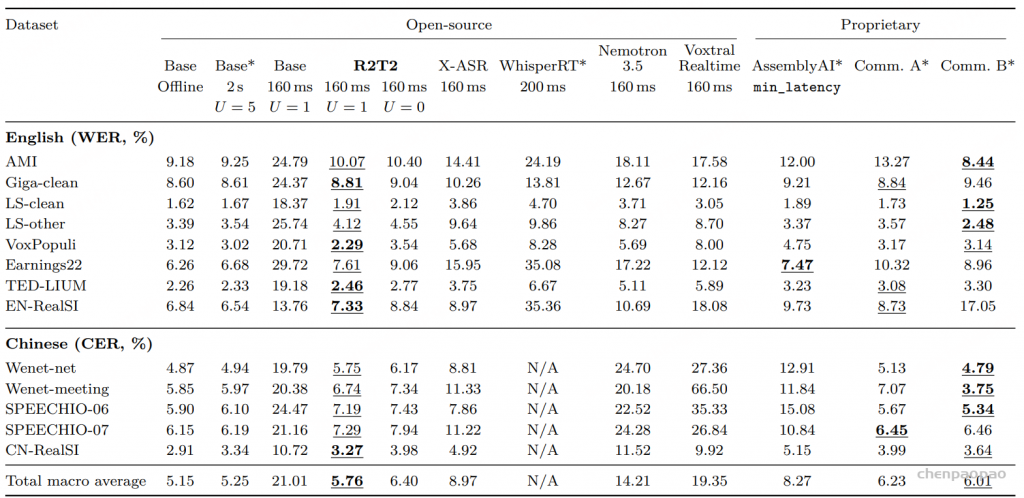
11.1 跨语言迁移结果

虽然 R2T2 后训练只使用中文和英文,但在另外 10 种语言的 18 个测试集上,160 ms、U=1 的错误率都低于基础模型同条件配置,宏平均从 30.75% 降到 8.40%。这些语言包括阿拉伯语、德语、西班牙语、法语、日语、韩语、葡萄牙语、俄语、泰语和越南语。这个结果说明模型学到了一部分与“稳定前缀和等待”有关的通用能力,但不应被理解为这些语言都经过了专门后训练。

十二、发射延迟如何计算

论文使用回溯性发射延迟(retrospective emission lag)。对齐后,一个正确识别单位的延迟为:

\(\mathrm{Lag}=t_{\mathrm{first\ permanently\ stable\ output}}-t_{\mathrm{aligned\ acoustic\ end}}\)

该指标只统计 Levenshtein 对齐后正确匹配的英文词或中文字符,排除高错误率语句;沿音频时间轴计算,不包含推理计算、排队、网络和界面渲染时间。因此它不是服务器端端到端响应延迟,而是“如果系统能跟上音频,正确文字多久变成永久稳定前缀”的指标。

160 ms、U=1 的平均回溯性延迟约为英文 0.76 秒、中文 0.75 秒;U=0 时英文约 0.42 秒、中文约 0.53 秒。进一步使用 80 ms、U=0 时,中英文平均延迟都可以低于 0.5 秒,但识别错误率继续上升。
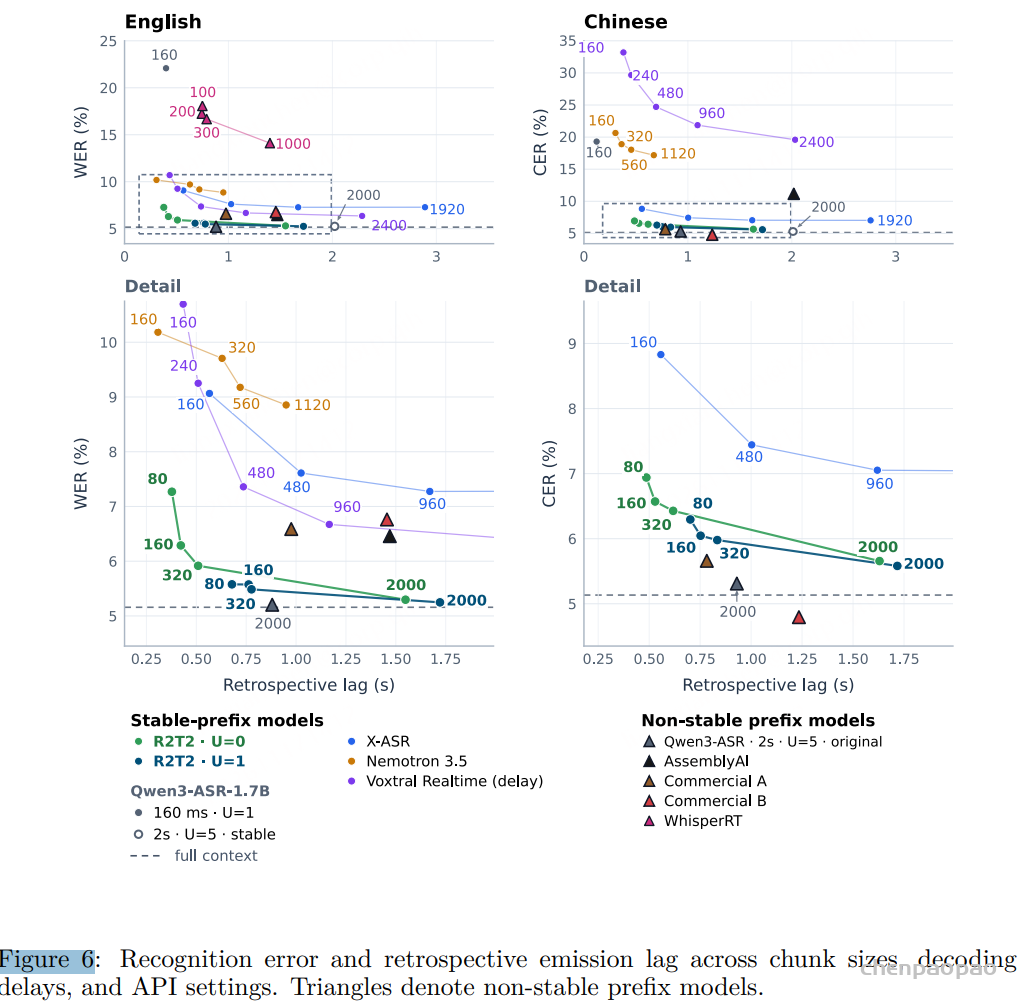
chunk size、U 与识别错误率/发射延迟的折中曲线

十三、R2T2 与普通“不断改写”流式 ASR 的区别

方案模型中是否学习提交时机已经发布文本下游系统
滚动重解码通常没有可能回改需要 diff、撤销和重复处理
Local Agreement/Hold-n主要是外部提交规则提交后可不回改稳定,但模型自身不一定知道何时等待
R2T2LSP + Wait 直接训练只追加、不回改可直接消费 finalized prefix
因果交错模型通过因果结构约束通常不回改需要重新训练编码器和解码器

R2T2 的关键不是简单把输出尾部截掉,而是让模型在生成过程中学会:当前信息不足时不要猜,直接 Wait;当前前缀稳定时才提交。

十四、开源使用方式

官方仓库提供 vLLM、Transformers 离线推理、llama.cpp 和 WebSocket 服务器。模型权重位于 Hugging Face,GGUF 权重位于 Confucius4-R2T2-GGUF。

git clone https://github.com/netease-youdao/Confucius4-R2T2.git
cd Confucius4-R2T2
conda create -n confucius4-r2t2 python=3.12 -y
conda activate confucius4-r2t2
pip install -e .
./run_example.sh /path/to/audio.wav \
  --model_path /path/to/Confucius4-R2T2 \
  --infer_mode stream_vllm \
  --language Chinese \
  --chunk_size_ms 160
参数含义
chunk_size_ms流式 chunk,支持 80 ms-2 s
unfixed_token_numU,1 偏质量,0 偏延迟
lookahead_ms首轮更新使用的额外音频缓存
context主题、词汇或热词提示
languageChinese、English 等语言提示

14.1 Python 流式接口的关键语义

state = asr.init_streaming_state(
    context="",
    language="Chinese",
    unfixed_chunk_num=0,
    unfixed_token_num=1,
    chunk_size_sec=0.16,
)

_, committed_text = asr.streaming_transcribe(seg, state, max_new_tokens=4)
asr.finish_streaming_transcribe(state)

官方示例强调:如果下游系统要求文字不可回改,应使用 finalized prefix;当前 hypothesis 可能还包含内部暂留尾部。最终 flush 后再读取完整文本。

14.2 WebSocket 服务

仓库提供 ws_server.py 和示例客户端,端点为 /asr_stream_api_v1。客户端发送 16 kHz、单声道、int16 PCM 二进制帧,参考帧约 160 ms;结束时发送 YOUDAO_ONETIME_ASR_STREAM_EOS。服务端返回 JSON,msg.text 是相对于上一条消息的新增增量片段,客户端可将其追加获得完整转写。

十五、总结:R2T2 真正解决的是什么问题

R2T2 的核心不是让 ASR 在每个时刻都给出一个“完整猜测”,而是让模型学习当前音频已经支持到哪一个安全前缀。能够确认时输出文字,不确定时输出 Wait;已经发布的文字永远不回改。

技术路径可以概括为:

\(\text{Qwen3-ASR-1.7B}+\text{LSP labels}+\text{Wait supervision}+\text{SFT}+\text{GRPO}+\text{cache optimizations}\rightarrow\text{stable-prefix streaming ASR}\)

在 160 ms chunk、U=1 的质量优先模式下,R2T2 把流式识别错误率从基础模型的 21.01% 降到 5.76%,接近基础模型完整音频的 5.15%;在 U=0 或更小 chunk 下,又可以换取更低的发射延迟。对需要持续消费文本的字幕、同传和语音智能体来说,这种“只追加输出”的接口比单纯追求最终 WER 更接近真实生产需求。
详解 ASR 投机解码:以 NVIDIA Nemotron 3.5 Transcribe 为例

摘要:自动语音识别(ASR)通常由语音编码器把音频转换成声学表示,再由语言模型逐 token 生成转写文本。自回归解码的主要瓶颈是:每生成一个 token,都要等待前一个 token 的结果。投机解码(Speculative Decoding)引入一个更便宜的草稿路径,先提出多个候选 token,再让主模型一次性验证这些候选。通过的前缀直接接受,发生分歧的位置由主模型纠正,后面的草稿丢弃并从新的正确前缀重新生成。
本文以 NVIDIA Nemotron 3.5 Transcribe 相关资料为主,结合其 MTP(Multi-Token Prediction,多词元预测)模块、可选的 DFlash2 草稿模型、NeMo SpeechLM 实现、vLLM 核验逻辑、Hugging Face Assisted Generation 和原始投机解码论文,解释 ASR 投机解码为什么可以加速、核验如何并行、缓存如何回退、音频表示到底是什么,以及这种方法的适用边界。

阅读约定:文中的英文示例为了说明机制,把一个英文单词暂时当作一个 token。真实系统通常使用子词、标点和特殊 token,不能把示例中的“词”直接等同于模型 tokenizer 的 token。

一、先给结论:投机解码到底改变了什么

投机解码并没有把主模型换成一个不可靠的小模型,也不是让草稿模型直接决定最终转写。它改变的是生成调度方式:

  • 普通解码:主模型生成一个 token,等待结果,再生成下一个 token。
  • 投机解码:草稿模型或草稿模块先提出一段候选,主模型一次计算这段候选各位置的概率,再按顺序接受能够通过核验的前缀。
  • 出现分歧:主模型保留最终决定权;错误位置由主模型的选择替换,依赖错误前缀的后续草稿全部丢弃。
  • 没有分歧:如果整段候选都被接受,主模型还可能额外提供一个 bonus token。

因此,在正确实现的贪心投机解码中,最终输出应当与主模型逐 token 贪心解码一致,或者在数值实现存在微小差异时非常接近。它优化的是速度,不是把主模型变成“听得更准”的模型。输出与真实录音是否完全正确,仍然取决于模型本身的识别能力。

二、Nemotron 3.5 Transcribe 使用哪些草稿路径

相关资料介绍了两条草稿路径:

草稿路径基本方式特点最终决策者
MTP(Multi-Token Prediction)模型内部的多词元预测模块提出后续 token可以重复调用同一个模块生成多个草稿位置主模型
DFlash2独立提供的草稿模型提出候选序列可以并行提出一组候选主模型

两者的共同点是:草稿只负责提出候选,主模型仍然必须核验。草稿模型越便宜、越容易提出与主模型一致的候选,接受率就越高,投机解码越可能带来收益。

三、Q1:ASR 中的投机解码具体怎么做

假设录音内容是:

Please turn on the lights.

系统已经确认的文字是:

Please

草稿路径提出三个候选:

turn off the lights
草稿 token主模型核验处理结果
turn主模型也选择 turn接受
off主模型更倾向于 on拒绝,并替换为 on
the是在 off 条件下预测的本轮丢弃
lights依赖错误的 off 前缀本轮丢弃

本轮确认结果为:

Please turn on

为什么后面的 the lights 不能直接保留?因为它们是在错误前缀 Please turn off 的条件下计算出来的。正确的下一轮必须从:

Please turn on

重新提出草稿。投机解码接受的是“从当前正确前缀出发仍然有效的最长前缀”,而不是把草稿整段当成一个不可拆分的答案。

3.1 贪心核验的形式化表示

设当前已确认前缀为 c,草稿模型提出:

\(D=(d_1,d_2,\ldots,d_K)\)

主模型在相应位置给出自己的贪心选择:

\(M=(m_1,m_2,\ldots,m_K,m_{K+1})\)

从左到右找到第一个不一致位置:

\(j=\min\{i:d_i\ne m_i\}\)

则保留:

\(d_1,d_2,\ldots,d_{j-1}\)

并在第 j 个位置使用主模型的 m_j。如果所有草稿都匹配,主模型还可能输出第 K+1 个 bonus token。

实际 tokenizer 可能把一个单词拆成多个子词,因此这里的“第一个不一致位置”通常是 token 位置,而不一定是人眼看到的完整单词边界。

四、Q2:每轮核验都要重新运行音频编码器吗

通常不需要。投机解码真正节省时间的前提,就是不要因为每一轮多提出几个 token,就把整条“音频 → 编码器 → 解码器”流水线从头运行一遍。

初始处理大致是:

音频
  ↓
语音编码器和适配器
  ↓
声学 embedding
  ↓
语言模型 prefill
  ↓
保存解码上下文

之后的草稿核验主要运行语言模型解码部分。已经处理过的音频和文字上下文通过缓存继续发挥作用,典型状态包括:

  • Transformer 注意力层的 KV cache;
  • Mamba 层的循环状态;
  • 已经确认文字对应的历史状态;
  • 与当前录音相关的音频前缀表示。

NeMo 的实现把音频处理接口与语言模型 forward 分开。长录音可以在编码器内部进行分块处理,但这和投机解码中的“每一轮都重新编码音频”是两回事。关键点是:同一轮草稿和核验不应重复从头计算已经完成的音频编码。

4.1 拒绝后为什么需要缓存回退

假设草稿是:

Please turn off the lights

主模型在 off 处拒绝并改成 on。那么后面的 the lights 不能继续使用。缓存也必须回到确认的前缀:

Please turn on

注意力层可以调整 KV cache 的有效末尾;Mamba 层的循环状态则需要专门的回退机制。论文资料提到 ReplaySSM,通过“状态检查点 + 最近输入缓冲区”支持 Mamba 状态回退。没有回退,模型就可能错误地保留已经被拒绝 token 对内部状态造成的影响。

4.2 bonus token 的隐藏状态细节

一个容易忽略的实现细节是:主模型根据前一个位置的 logits 选出的纠正 token,虽然已经可以加入最终输出,但它自己的隐藏状态通常还没有在同一轮中完整计算出来。这个 token 往往会作为下一轮的起始输入,继续经过模型处理。

因此,“已经输出了 token”与“这个 token 的隐藏状态已经被写入全部缓存”不是完全相同的概念。投机解码实现必须同时管理:

  • 最终接受了哪些 token;
  • 哪些 token 的 logits 已经计算;
  • 哪些 token 的隐藏状态已经写入缓存;
  • 拒绝后缓存需要回退到哪里。

五、Q3:主模型仍然要计算,为什么还能加速

投机解码不是减少所有主模型计算,而是把原本无法并行的多次小步计算,重排为一次包含多个位置的成块计算。

普通自回归解码投机解码
主模型选择 token 1草稿路径先提出 token 1、2、3
主模型读取 token 1 后再选择 token 2主模型一次核验多个候选位置
主模型读取 token 2 后再选择 token 3按因果遮罩分别计算每个位置
每一步单独启动解码计算多个位置共享权重访问和算子执行

加速来源主要包括:

  • 一次成块计算可以服务多个 token 位置;
  • 减少重复的 kernel launch 和调度开销;
  • 多个位置共享模型权重访问;
  • GPU 更擅长处理具有规则形状的矩阵运算;
  • 把原本串行的部分依赖转换成“候选先给出、主模型并行核验”。

这里的“权重读取”主要指 GPU 显存到计算单元之间的数据移动和相关缓存访问,不是每生成一个 token 都从硬盘重新读取模型文件。模型权重通常已经驻留在 GPU 显存或相关设备内存中。

5.1 一个示意性时延例子

下面的数字是解释机制的假设,不是 NVIDIA 实测结果。假设希望确认 4 个 token:

步骤普通解码投机解码
生成草稿不单列3 ms
主模型计算4 × 10 ms = 40 ms一次成块核验:14 ms
接收、回退和缓存处理计入每一步1 ms
总时间40 ms3 + 14 + 1 = 18 ms

示意加速比为:

\(\mathrm{Speedup}=\frac{40}{18}\approx 2.2\times\)

这个例子说明:一次核验 4 个位置的成本可能高于单步 10 ms,但只要远低于连续执行 4 次单步,整体仍然可以变快。反过来,如果草稿质量差、拒绝频繁,草稿成本和核验成本无法被接受 token 摊薄,投机解码可能没有收益,甚至变慢。

5.2 什么时候会变慢

  • 草稿模型本身太慢;
  • 草稿与主模型差异太大,接受率低;
  • 每轮核验产生大量被拒绝 token;
  • 缓存回退和拒绝处理成本较高;
  • GPU 已经被其他请求的 batch 填满;
  • 核验块形状不适合当前硬件或算子实现;
  • 短音频中编码器和 prefill 占比过高,解码加速无法覆盖总成本。

六、Q4:投机解码会加速音频编码器吗

投机解码直接加速的是自回归文字生成阶段,不会自动让音频编码器变快。

可以把一次请求的耗时粗略写成:

\(T_{\mathrm{total}}=T_{\mathrm{audio\ encoder}}+T_{\mathrm{prefill}}+T_{\mathrm{text\ generation}}\)

投机解码主要影响最后一项。加入草稿和核验后,文字生成阶段的实际时间可以写成近似形式:

\(T’_{\mathrm{total}}\approx T_{\mathrm{audio\ encoder}}+T_{\mathrm{prefill}}+\frac{T_{\mathrm{text\ generation}}}{s}\)

其中 s 是把草稿、核验、缓存处理等开销全部算进去后的文字生成加速比。

例如,假设原始请求总时间为 100 ms,其中音频编码和 prefill 占 50 ms,文字生成占 50 ms。即使投机解码把文字生成从 50 ms 降到 25 ms,总时间也只是从 100 ms 降到 75 ms,整体加速约为:

\(\frac{100}{75}\approx 1.33\times\)

所以“解码阶段 2 倍加速”不等于“端到端请求 2 倍加速”。编码器量化、CUDA Graph、批处理和音频分块优化可以进一步降低总时间,但它们属于其他优化手段。

七、Q5:投机解码是不是 batch inference

两者都利用了成块计算,但“成块的对象”不同。

比较项普通请求批处理投机核验
一起处理的对象多条独立请求同一条转写序列中的多个候选位置
请求之间是否独立通常相互独立位置之间存在因果依赖
候选是否提前知道每条请求有自己的输入草稿路径提前提供未来 token
遮罩要求按 batch 样本隔离需要因果遮罩和顺序接收规则

因此,单条请求也可以使用投机解码;外层仍然可以同时对多条音频请求做 batch。两种优化可以叠加,但如果普通 batch 已经把 GPU 利用率推得很高,投机核验额外增加的计算可能反而减少收益。

八、Q6:为什么历史变长,矩阵仍然可以写成 [4,H] × [H,H]

关键是区分:

  • 表示宽度:每个 token 用多少维向量表示,记作 H;
  • 历史长度:当前 token 可以访问多少个过去位置,表现为序列长度和 KV cache 长度。

假设最后一个已确认 token 为 c,草稿为 d_1,d_2,d_3,本轮输入为:

\([c,d_1,d_2,d_3]\)

若每个位置的隐藏向量宽度为 H,本轮输入表示为:

\(X\in\mathbb{R}^{4\times H}\)

线性层可以做:

\([4,H]\times[H,H]\rightarrow[4,H]\)

这只是逐位置的线性变换,并不表示每个位置只能看到 4 个位置。历史长度真正进入注意力计算。

8.1 注意力中的历史长度

设在 c 之前已经缓存了 N 个位置,这些位置可能包括:

  • 音频 embedding;
  • 任务指令;
  • 更早的确认文字;
  • 系统提示和其他固定前缀。

对一个注意力头,设头维度为 d_h:

\(Q\in\mathbb{R}^{4\times d_h},\qquad K,V\in\mathbb{R}^{(N+4)\times d_h}\)

注意力分数为:

\(S=\frac{QK^{\mathsf T}}{\sqrt{d_h}}+M\)

其中:

\(QK^{\mathsf T}:[4,d_h]\times[d_h,N+4]\rightarrow[4,N+4]\)

最后通过:

\(O=\operatorname{softmax}(S)V\)

得到:

\([4,N+4]\times[N+4,d_h]\rightarrow[4,d_h]\)

所以,历史变长主要体现在 N+4 这个维度和缓存大小上;每个 token 的表示宽度仍然是固定的 H。

九、Q7:是不是共用一段物理上下文,再用因果遮罩选择有效历史

可以这样理解。缓存中的 K/V 存储范围相同,但不同查询行通过因果遮罩看到的有效前缀不同。

查询行允许访问的内容预测内容
c音频/指令/历史缓存 + cd1
d1音频/指令/历史缓存 + c + d1d2
d2音频/指令/历史缓存 + c + d1 + d2d3
d3音频/指令/历史缓存 + c + d1 + d2 + d3bonus token 或后续 token

可形式化为:

\(p_1(w)=P_{\mathrm{main}}(w\mid A,C)\) \(p_2(w)=P_{\mathrm{main}}(w\mid A,C,d_1)\) \(p_3(w)=P_{\mathrm{main}}(w\mid A,C,d_1,d_2)\) \(p_4(w)=P_{\mathrm{main}}(w\mid A,C,d_1,d_2,d_3)\)

其中 A 表示音频和指令上下文,C 表示已经确认的文字。

最关键的是“输入和预测错开一位”:

  • c 所在行预测 d1;
  • d1 所在行核验 d2;
  • d2 所在行核验 d3;
  • d3 所在行给出 bonus token。

因此,负责核验 d1 的输出不能看到 d1 自己,不存在把答案提前泄露给模型的问题。被因果遮罩屏蔽的分数在 softmax 前加上 \(-\infty\),softmax 后对应注意力权重为 0。

如果 d2 被拒绝,那么依赖 d2 的 d3 不能继续用于最终输出,即使 d3 单独看起来合理,也必须在新的正确前缀上重新生成。

十、Q8:音频编码器输出的是每个词的向量吗

通常不是。音频编码器输出的是沿音频时间轴排列的声学表示,而不是先把录音切成 “Please / turn / on / the / lights” 五个词,再为每个词各输出一个向量。

可以把过程示意为:

录音:“Please turn on the lights”
        ↓
语音编码器:[a1, a2, ..., aT]
        ↓
文字解码器:[Please, turn, on, the, lights]

资料中给出的 Nemotron 3.5 Transcribe 近似值是:编码后的音频表示约每 80 ms 一个位置,也就是每秒约 12.5 个声学位置。一个 2 秒录音可能有约 25 个声学位置,即使最终文字示例只有 5 个词。

声学时间步和文字 token 数量通常不同,也不天然一一对应。一个声学表示可以包含一段局部声学上下文;一个文字 token 也可能对应多个声学时间步。词级时间戳需要额外的对齐方法,不能直接把声学位置当作词位置。

十一、Q9:解码器是否看到覆盖整段录音的声学表示

对于资料讨论的 Nemotron 离线转写流程,输入请求在开始生成文字前已经提供了完整录音。编码器可以在内部对长音频分块处理,但最终保留的声学表示覆盖本次请求提供的音频。

其输入形式可以理解为:

[音频 embedding][任务指令][文字前缀]

当解码器生成句子前半部分时,音频 embedding 已经在语言模型输入上下文中。文字位置之间的因果遮罩限制的是“未来文字 token”,并不是根据当前转写进度把后面的音频表示逐步隐藏。因此,在离线模式中,模型可以利用完整录音的声学信息。

这与真正的实时流式 ASR 不同:

模式解码时可用的音频是否可以看到尚未到达的音频
离线转写后流式返回文字请求开始时已上传的完整录音可以使用完整录音
真正实时流式 ASR截至当前时刻已经收到的音频不能使用尚未到达的未来声音

因此,“先上传完整录音,再逐步返回识别文本”在系统层面仍然可能是离线音频处理;不能仅凭输出逐步到达,就判断模型是实时流式编码。

十二、Q10:草稿模型输出 token ID 还是 logits

两者都会出现,但处在不同阶段。

草稿模型隐藏状态
        ↓
词表输出头
        ↓
logits
        ↓
argmax 或采样
        ↓
候选 token ID
        ↓
主模型核验

如果草稿模型一次提出 K 个位置,那么草稿 logits 可以表示为:

\(Z_{\mathrm{draft}}\in\mathbb{R}^{K\times |\mathcal V|}\)

其中 |V| 是词表大小。通过词表维度选择候选:

\(d_i=\operatorname*{argmax}_{w\in\mathcal V}z_i(w)\)

最终送入主模型核验的是候选 token ID 序列:

\(D=(d_1,d_2,\ldots,d_K)\)

主模型会对这些候选 ID 做自己的 embedding 和前向计算,并重新产生主模型 logits。草稿模型的 logits 或概率不能替代主模型的判断。

12.1 贪心解码与随机采样的区别

在贪心投机解码中,可以直接比较:

\(d_i\stackrel{?}{=}\operatorname*{argmax}_{w}p_{\mathrm{main}}(w\mid\text{当前前缀})\)

但如果使用随机采样,不能简单采用“token ID 相同就接受”。为了严格保持主模型目标分布,通常需要:

  • 草稿分布 q;
  • 主模型目标分布 p;
  • 按概率比进行接受或拒绝;
  • 拒绝后按照修正后的分布重新采样。

因此,本文的“候选 ID 与主模型 argmax 比较”主要对应贪心核验,不能直接推广为所有采样策略。

十三、投机解码的完整伪代码

confirmed = initial_prefix
initialize_audio_embeddings_and_decoder_cache(audio)

while not finished:
    draft_tokens = draft_model.generate(confirmed, K)

    main_logits, candidate_states = main_model.verify_block(
        prefix=confirmed,
        candidates=draft_tokens,
        causal_mask=True
    )

    accepted = []
    for i in range(K):
        main_token = argmax(main_logits[i])
        if draft_tokens[i] == main_token:
            accepted.append(draft_tokens[i])
        else:
            accepted.append(main_token)
            rollback_cache_to(confirmed + accepted)
            break

    if all_draft_tokens_accepted:
        accepted.append(select_bonus_token(main_logits[-1]))

    confirmed = confirmed + accepted
    update_cache_for_confirmed_prefix(confirmed)

这段伪代码为了说明流程进行了简化。真实实现还需要处理:

  • 子词 token 和特殊 token;
  • EOS 或结束标记;
  • 草稿长度动态调整;
  • KV cache 的写入和回退;
  • Mamba 状态检查点和 ReplaySSM;
  • 多请求 batch;
  • 设备间权重和状态同步;
  • 贪心与随机采样的不同接收规则。

十四、ASR 投机解码中的音频信息究竟存在哪里

可以将一次离线 ASR 请求拆成三类信息:

信息典型形式作用
音频信息声学 embedding 序列提供发音、韵律、声音事件和说话证据
文字上下文已确认 token、指令、历史前缀决定语言模型条件和生成路径
缓存状态Transformer KV cache、Mamba 循环状态避免每轮从头处理历史输入

音频编码器通常输出按声学时间步排列的表示:

\(A=(a_1,a_2,\ldots,a_T)\)

文字解码器则生成:

\(Y=(y_1,y_2,\ldots,y_L)\)

T 主要与音频时长和编码器下采样有关,L 主要与实际转写内容和 tokenizer 有关。通常 T 不等于 L,也不存在天然的一一对应关系。

十五、投机解码和真正流式 ASR 的边界

投机解码可以加速离线转写,也可以用于某些流式系统的文字生成阶段,但它本身并不等于实时流式 ASR。

问题离线投机解码真正实时流式 ASR
音频是否完整到达通常在生成前已提供完整录音音频边到达边处理
未来音频是否可用可以使用整段录音的声学表示只能使用已经到达的部分
投机优化的位置主要是文字生成阶段还要考虑增量编码、缓存和端点检测
输出是否可修改通常生成完整结果部分结果可能随新音频修订

例如,先上传一段完整录音,然后用流式接口逐步返回文字,仍然可能属于“离线音频处理 + 流式输出”。判断一个系统是否真正实时,需要确认音频编码和解码时是否看到了尚未到达的音频。

十六、如何评价投机解码是否真的有效

不能只看“草稿长度”或“一次核验多少 token”。至少需要同时观察以下指标:

  • 端到端延迟:从音频输入到最终文字完成的时间。
  • 解码阶段延迟:排除音频编码后的纯文字生成时间。
  • 接受率:草稿 token 被主模型接受的比例。
  • 平均接受长度:每轮实际确认了多少 token。
  • 草稿成本:草稿模型本身的计算和显存开销。
  • 核验成本:批量前向、缓存管理和回退成本。
  • 输出一致性:与主模型普通贪心输出的差异。
  • 识别质量:CER、WER、关键词召回和专业实体召回。
  • 不同并发度下的吞吐:单请求低延迟和多请求吞吐可能结论不同。

一个简单的速度模型是:

\(T_{\mathrm{spec}}=T_{\mathrm{draft}}+T_{\mathrm{verify}}+T_{\mathrm{accept}}+T_{\mathrm{rollback}}\)

只有当这些额外成本被成功接受的多个 token 摊薄,且小于普通解码的多次串行执行成本时,投机解码才会带来净收益。

十七、常见误解

  • 误解一:投机解码让 ASR 更准确。它主要让生成更快;在正确核验下,目标是保持主模型输出,不是自动提升声学识别能力。
  • 误解二:草稿模型的答案可以直接使用。草稿只是候选,主模型拥有最终决定权。
  • 误解三:核验一个块等于只计算一个 token。核验块通常要为多个位置计算主模型 logits,只是这些计算可以更好地利用硬件。
  • 误解四:拒绝一个 token 后,后面的候选仍然有效。后续候选依赖错误前缀,必须丢弃并重新生成。
  • 误解五:历史长度变长就意味着每个向量变宽。向量宽度 H 通常固定,历史变长主要体现为 KV cache 和注意力序列维度增长。
  • 误解六:输出逐步返回就一定是真正流式编码。如果完整音频在生成前已经上传,系统仍可能是离线编码后逐步返回文字。
  • 误解七:草稿 logits 就是最终概率。草稿 logits 用于产生候选 ID,最终是否接受由主模型 logits 决定。

十八、工程实现时需要重点处理什么

  • 草稿质量:草稿模型不一定越大越好,关键是单位成本下的接受率。
  • 草稿长度:过短无法摊薄核验成本,过长则可能增加拒绝和回退开销。
  • 缓存管理:必须区分已确认前缀、临时草稿、拒绝位置和 bonus token 的状态。
  • 因果遮罩:核验第 i 个候选时不能看到候选 token 自己,否则会造成信息泄露。
  • Mamba 回退:如果模型包含循环状态,需要检查点和回放机制。
  • 数值一致性:不同精度、融合算子和 GPU kernel 可能导致极小的 logits 差异。
  • 贪心与采样分开实现:贪心可以比较 argmax;采样需要严格的接受、拒绝和重采样公式。
  • 完整请求指标:不能只报告 decode speedup,还要报告音频编码、prefill、排队和网络时间。

十九、文章中示例数字的边界

文中 3 ms 草稿、14 ms 核验、1 ms 缓存处理、18 ms 总耗时和约 2.2 倍加速,是为了展示计算组织方式的示意数字,不是 NVIDIA 对 Nemotron 3.5 Transcribe 的实测性能承诺。

实际速度取决于:

  • 音频长度和文字长度;
  • 草稿模型大小;
  • 草稿接受率和平均接受长度;
  • 主模型参数规模与 MoE 激活路径;
  • GPU 型号、显存带宽和 kernel 实现;
  • 量化精度;
  • 请求并发度;
  • 音频编码、prefill、排队和网络开销。

二十、总结:如何用一句话理解 ASR 投机解码

ASR 投机解码可以概括为:

让便宜的草稿路径提前猜,让主模型一次检查多个位置;接受与主模型一致的前缀,遇到分歧立即纠正并回退,从而在尽量保持主模型输出行为的同时减少串行解码开销。

对于 Nemotron 3.5 Transcribe,音频编码器负责把录音转成沿时间轴排列的声学表示,语言模型负责生成转写,MTP 或 DFlash2 负责提出候选,主模型负责核验。投机解码的核心收益来自“候选位置可以提前准备”和“主模型可以对多个位置做成块计算”,而不是来自减少音频编码或绕过主模型。

真正评估一个投机解码系统时,应同时看速度、接受率、输出一致性、显存占用和 CER/WER,而不能只看某一次演示中的加速比。

参考资料与延伸阅读

Qwen-Audio-3.1-ASR 技术详解:从多语言、方言与专业词识别,到说话人日志和通用音频理解

论文:Qwen-Audio-3.1-ASR Technical Report(arXiv:2610.28711) 

一、先给结论:Qwen-Audio-3.1-ASR 做了什么

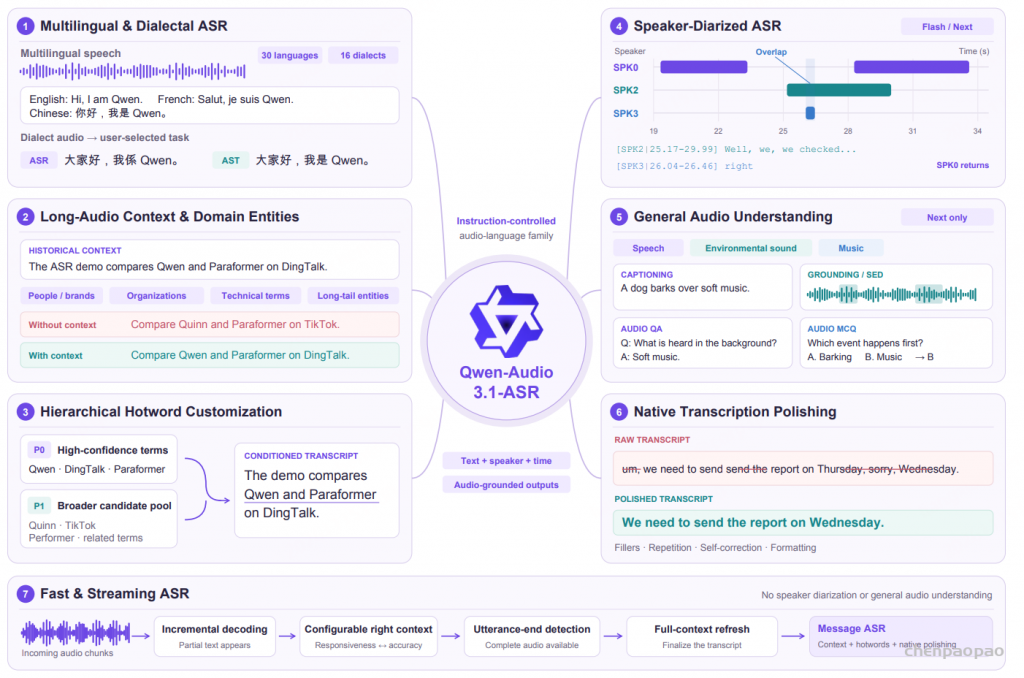
Qwen-Audio-3.1-ASR 不是只把语音转成一串文字的单一 ASR 模型,而是一组由指令控制的 Audio-Language Model。它在保留 Qwen-Audio-3.0-ASR 多语言识别、历史上下文、热词和原生润色能力的基础上,增加了两类能力:第一,输出带有说话人标签和时间戳的说话人日志;第二,Qwen-Audio-3.1-ASR-Next 能够处理声音描述、时间定位、声音事件和音频问答。

  • 支持 30 种语言,以及 16 种中文方言。
  • 中文方言可以在推理时选择“保留方言原话的 ASR”,也可以选择“翻译成普通话文字的 AST”。
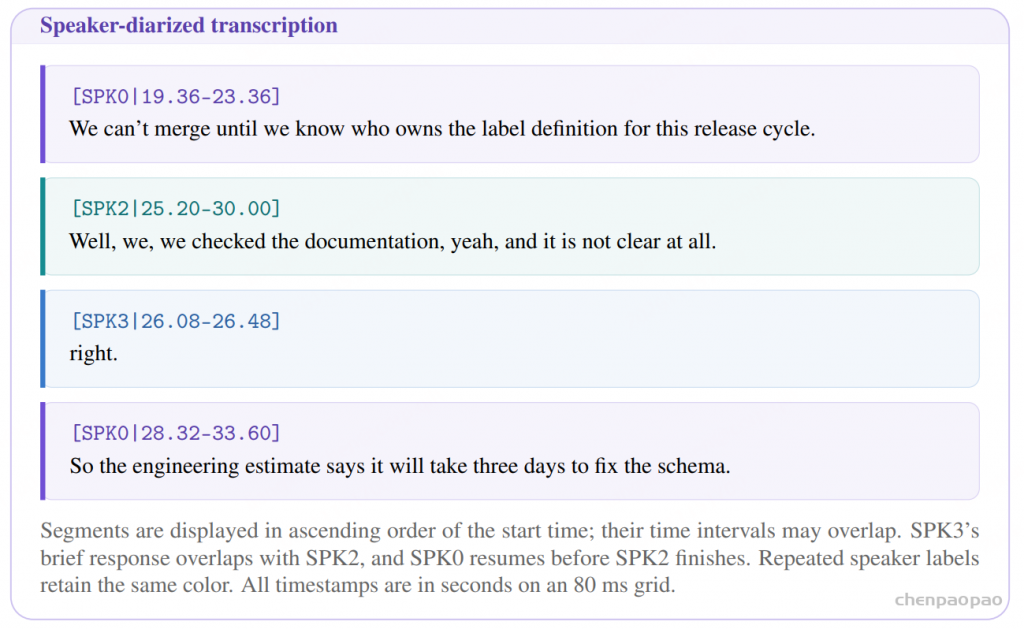
  • 非流式 Flash 和 Next 版本支持说话人日志,输出格式为 [SPK|start-end]text,支持不同说话人的时间区间重叠。
  • Message 版本采用“流式实时显示 + 句末非流式刷新”,并在同一识别流程中支持历史上下文、分层热词和原生转写润色。
  • 训练流程包含六个阶段:音频编码器预训练、Audio LLM 预训练、LLM cooldown adaptation、监督微调、强化学习和多教师在策略蒸馏(MOPD)。

二、模型家族与部署版本

版本主要场景ASR说话人日志通用音频理解上下文热词原生润色
Qwen-Audio-3.1-ASR-Flash-Filetrans异步文件转写支持不支持不支持支持支持不支持
Qwen-Audio-3.1-ASR-Flash-Streaming实时流式识别支持不支持不支持支持支持不支持
Qwen-Audio-3.1-ASR-Flash-Message交互式语音输入支持不支持不支持支持支持支持
Qwen-Audio-3.1-ASR-Flash非流式转写支持支持不支持支持支持支持
Qwen-Audio-3.1-ASR-Next非流式转写与音频分析支持支持支持支持支持支持

论文中的实验名称略有简化:实验表格中的 Qwen-Audio-3.1-ASR 通常指 Flash 基础模型的非流式接口;Qwen-Audio-3.1-ASR-Next 指带通用音频理解能力的 Next 版本;Message 延迟和行业术语召回实验使用 Qwen-Audio-3.1-ASR-Flash-Message。

三、总体架构:声音、指令和上下文共同参与解码

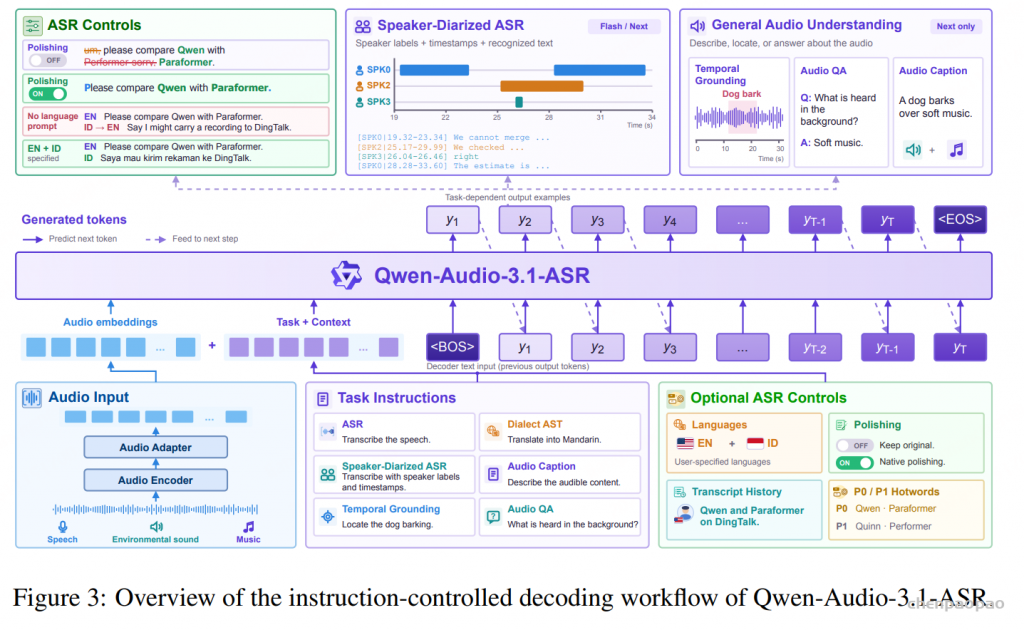
Qwen-Audio-3.1-ASR 的核心由三部分组成:音频编码器(audio encoder)、音频适配器(audio adapter)和基于 Qwen 的 LLM 解码器。音频编码器从波形中提取声学表示;适配器把声学表示映射到语言模型可以接收的表示空间;LLM 解码器根据声音、任务指令、可选文本条件和已经生成的前缀逐 token 产生结果。

对于音频输入 x、任务指令 q 和可选文本条件 c,可以把模型抽象为:

\(H=A(E(x)),\qquad p_{\theta}(y\mid x,q,c)=\prod_{t=1}^{T}p_{\theta}(y_t\mid y_{<t},H,q,c)\)

其中,E 是音频编码器,A 是音频适配器,H 是音频 embedding 序列,y 是输出 token 序列。c 可以包含目标语言、历史转写、P0/P1 热词或润色指令。由于解码器仍然直接接收音频表示,因此上下文提示是辅助证据,不能简单替代声学证据。

模型还保留一条辅助 CTC 路径。CTC 分支从音频编码器表示中生成初步识别假设和粗粒度位置,用于帮助热词定制与长音频上下文注入;最终输出仍由音频、指令、上下文和自回归解码共同决定,不能把 CTC 初稿当作最终答案。

3.1 说话人日志的结构化输出

说话人日志不再是单一文本串,而是多个带结构字段的片段。可以抽象为:

\(\mathcal{S}=\{(b_i,e_i,k_i,w_i)\}_{i=1}^{M}\)

b_i 和 e_i 是片段起止时间,k_i 是录音内部的说话人标签,w_i 是对应文字。实际序列化格式为 [SPK|start-end]text,例如 [SPK2|25.20-30.00]Well, we checked the documentation.。同一录音中同一说话人会重复使用相同标签;不同说话人的时间区间可以重叠,因此可以表示插话、短响应和同时说话。标签只表示录音内部的参与者,不等于现实世界身份识别。

四、六阶段训练流程

4.1 第一阶段:音频编码器预训练

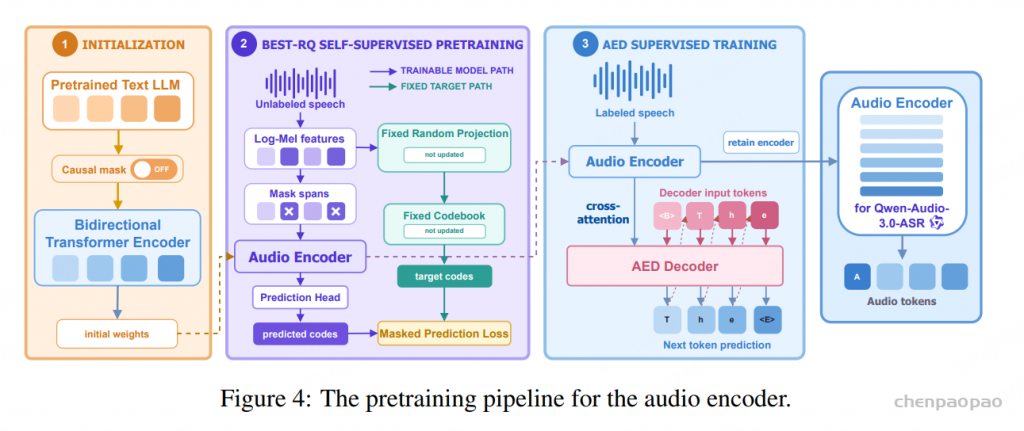
音频编码器预训练分为 BEST-RQ 自监督预训练和 AED 监督训练两步,论文称两阶段合计使用了数千万小时、覆盖多种真实场景的音频。音频来自人工智能、生物技术、电商、教育、娱乐、金融、出行等领域,但论文没有公开每个领域的具体时长。

  • Qwen3 初始化:从预训练 Qwen3 LLM 中初始化结构兼容的 Transformer 层。非流式编码器使用双向注意力,以便同时查看语音前后文;声学前端单独初始化。
  • BEST-RQ:随机遮挡声学帧,使用未遮挡特征经过固定随机投影和冻结 codebook 得到的离散目标,训练编码器预测被遮挡位置的目标。这样可以利用大量无转写语音学习上下文声学表示。
  • AED 监督训练:把编码器接入 attention-based encoder-decoder,用配对的音频和文字逐 token 预测转写。标注数据经过 VAD、Paraformer-V2、Whisper-large-v3、SenseVoice 等多系统伪标签生成和 ITN 处理。完成后丢弃 AED 解码器,只保留训练好的编码器初始化主模型。

4.2 第二阶段:Audio LLM 预训练

Audio LLM 解码器从 Qwen 的语言模型部分初始化,采用 Mixture-of-Experts(MoE)骨干。论文给出的预训练规模约为 2,000 万小时多语言数据,主要包括 ASR 数据和文字-音频交错数据。此阶段冻结音频编码器,只联合训练音频适配器和 LLM 解码器,并使用目标文字上的交叉熵损失建立音频表示与语言表示之间的对齐。

这一阶段带来的不仅是发音到文字的映射,也包括多语言知识、世界知识和语义消歧能力。例如,当声音在同音词之间存在歧义时,语言模型可以利用话题、实体和常识进行候选排序,但最终仍需要以音频为主要证据。

4.3 第三阶段:LLM Cooldown Adaptation

Cooldown 阶段使用约 100 万小时的更高质量音频-文字数据,重点不是继续简单扩大数据量,而是重新平衡语言和中文方言比例、提高转写质量并增加任务多样性。混合数据包括常规 ASR、音频理解、说话人日志、语音问答和对话数据。

质量过滤方面,团队使用 VibeVoice 对 ASR 音频重新识别,再与已有参考文本比较;词错误率大于 0.3 的样本被移除。重要的是,这个过程只是筛选数据,不是用 VibeVoice 输出替换原参考文本。

4.4 第四阶段:监督微调(SFT)

SFT 把模型变成真正的指令控制 Audio-Language Model。每个样本由用户指令、音频和 assistant 目标回答构成,覆盖多语言、方言、代码切换、噪声、远场、行业术语、说话人日志和通用音频理解。

SFT 时联合更新音频编码器和音频适配器;基础 LLM 参数冻结,只通过 LoRA 适配解码器。训练目标仍是目标回答的自回归交叉熵。语言控制样本会明确要求“按指定语言转写”“保留多语言原有书写系统”,避免模型把较低资源语言擅自替换成更熟悉的语言。

4.4.1 行业实体数据合成

团队从人工智能、金融、医疗、IT 等领域挖掘稀有实体和长尾词,结合检索到的事实背景让 LLM 生成包含实体的多样短句,再用 CosyVoice3 合成语音;对难以稳定合成的术语补充人工录音。随后用当前 ASR 模型重新识别,并过滤实体明显不一致的样本。这样可以让模型在训练中同时“看到”和“听到”不常见的名称,而不是只在词表中加入文字。

4.4.2 原生转写润色

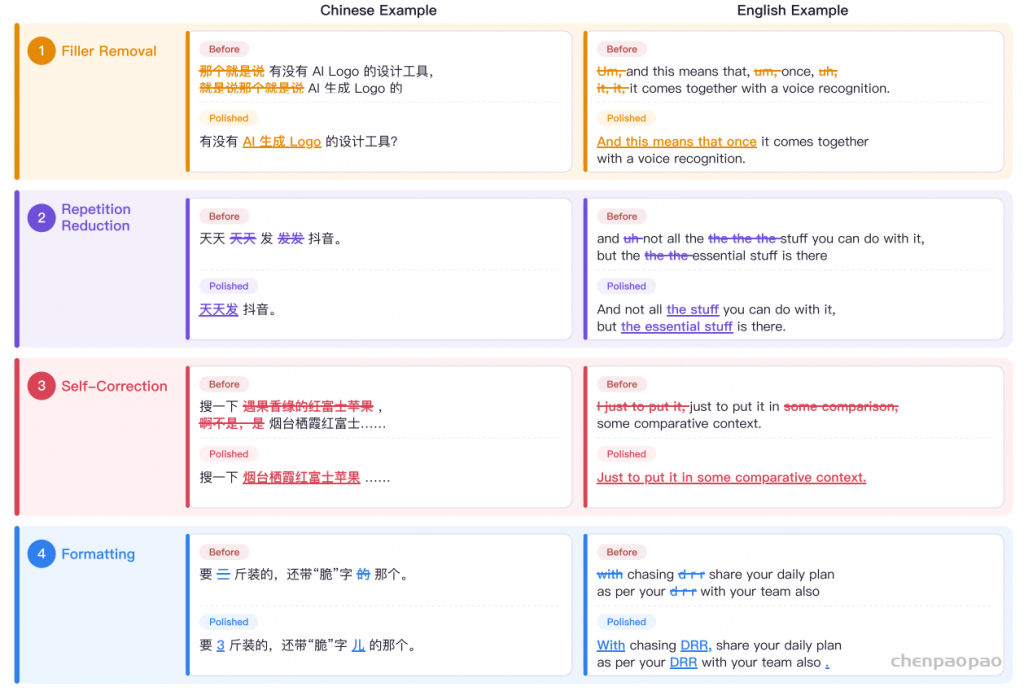
通过一个二值润色指令控制输出是逐字稿还是清洁稿。润色样本教模型删除非语义填充词、合并口吃和不必要重复、处理说话人的自我纠正,并规范标点和格式。真实语音保留原始音频,再用文本 LLM 生成润色监督,并用保真度过滤去除语义损失或无依据添加;合成数据则在标准文本中注入填充词、重复和自我修正,再通过 TTS、发音过滤和噪声增强生成音频。

4.4.3 历史上下文与同音词消歧

上下文训练把同一会话前面已经出现的转写或交互记录作为参考。指令明确告诉模型:历史上下文可能不完整、无关甚至错误,当前音频仍是首要证据。真实数据按照音频 ID 找回原会话,恢复时间顺序,只使用当前语音之前的轮次,不对历史文本做 LLM 改写;合成数据则专门构造正确、冲突、噪声和空白上下文,用来训练模型既会利用有效提示,也不会无条件复制提示。

这解释了“没有外部知识时如何利用同一句话内部线索”的基本机制:音频编码器提供发音证据,当前句子已生成的前缀、指令和历史片段提供语义约束;如果目标词是专名或同音词,模型可以通过同一句中的动作、对象、数量、主题和显式拼字说明来提高候选概率。训练时还要加入冲突提示和无关提示,避免模型形成“提示了什么就一定输出什么”的捷径。

4.4.4 分层热词 P0/P1

P0 是高置信度、高优先级候选,例如关键人名和上下文中确定出现的实体;P1 是更宽的候选池。LLM 根据候选与参考转写的语义匹配把词分层。推理时 P0 获得更强条件,但模型仍需同时满足声学和上下文证据;P1 用于扩大覆盖而不是强制替换。

4.4.5 说话人日志 SFT、speaker loss 与时间量化

说话人日志训练数据由人工转写和模型生成监督组成。影视数据使用原始字幕,并结合语言识别、声音事件检测和说话人日志模型交叉校验;另外用 LLM 生成会议话题,模拟多人会议,并加入不同混响和噪声。

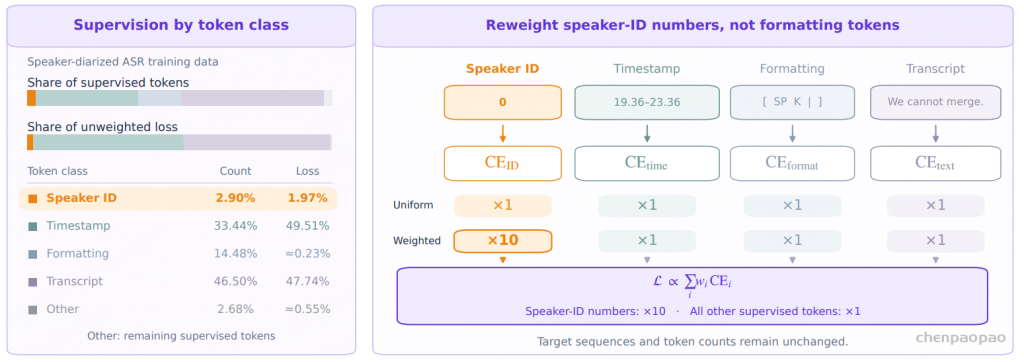
输出按时间顺序序列化为 [SPK|start-end]text。同一说话人保持一致标签,区间允许重叠。训练语料中,speaker-ID 数字 token 占全部监督 token 的 2.90%,但只贡献未加权交叉熵损失的 1.97%;时间戳 token 占 33.44%,贡献 49.51%;格式 token 占 14.48%,损失约 0.23%;转写 token 占 46.50%,损失 47.74%。因此只对 speaker-ID 数字 token 施加 10 倍损失权重,其余 token 保持 1 倍。

在说话人日志训练中,不同类型的输出 token 对训练损失的贡献并不均衡。模型可能花了大量训练资源学习时间戳和转写文字,但真正决定“谁在说话”的 Speaker-ID token 获得的有效监督相对不足。只提高 Speaker-ID 数字 token 的损失权重,其他 token 的权重保持不变。

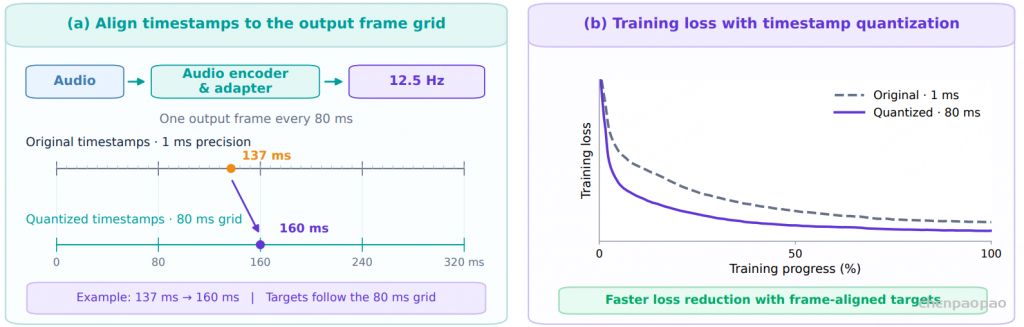
时间戳从原始 1 ms 精度量化到 80 ms 网格,与编码器和适配器的 12.5 Hz 表示帧率对齐。论文报告,相比 1 ms 目标,80 ms 量化能带来更快的损失、DER 和 cpWER 收敛,并在相同数据混合下取得更好的 DER 和 cpWER。

\(L=\sum_i w_i\,\mathrm{CE}_i,\qquad w_i=\begin{cases}10,&i\text{ 为 speaker-ID 数字 token}\\1,&\text{其他 token}\end{cases}\)

4.5 第五阶段:强化学习(RL)

RL 数据集聚焦真实困难样本,包括多个 ASR 系统(Whisper、FireRed-ASR、SenseVoice)意见不一致的样本、超过 20 秒的长语音、幻觉与长重复、关键词/热词样本,以及用于防止灾难性遗忘的常规 ASR 数据。上下文样本保留原有历史文本和指令,以便奖励真正反映指定任务。

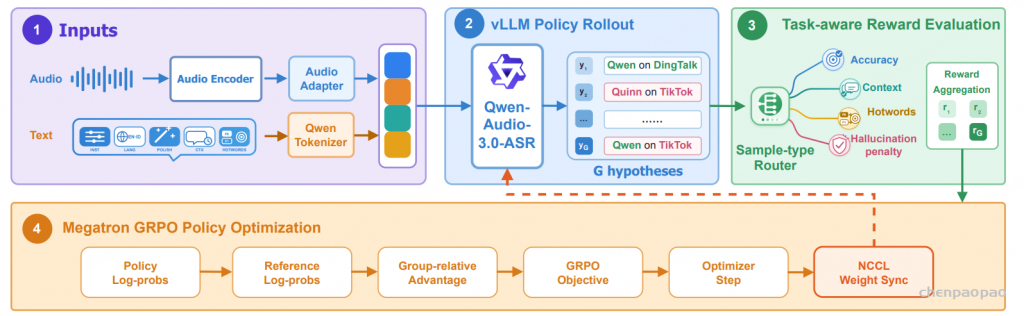
团队实现了异步音频强化学习框架 FunVerl:音频处理器提取 Mel 特征并 token 化文本;vLLM 生成一组候选答案;奖励模块按任务计算分数;Megatron trainer 使用张量、流水线和专家并行更新策略。轨迹队列把生成和优化解耦,NCCL 同步更新后的权重,并通过策略版本阈值过滤过旧轨迹。

对每个输入 q,旧策略生成 G 个回答,组内标准化奖励得到共享优势:

\(\hat A_{i,t}=\frac{R_i-\operatorname{mean}(\{R_j\}_{j=1}^{G})}{\operatorname{std}(\{R_j\}_{j=1}^{G})+\delta}\)

GRPO 的裁剪目标为:

\(J_{\mathrm{GRPO}}(\theta)=\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_t\left[\min\left(r_{i,t}\hat A_{i,t},\operatorname{clip}(r_{i,t},1-\varepsilon,1+\varepsilon)\hat A_{i,t}\right)-\beta D_{\mathrm{KL}}(\pi_\theta\|\pi_{\mathrm{ref}})\right]\)
  • 普通 ASR 奖励:1-WER 为主,结合关键词召回、关键词准确率、P0/P1 热词奖励、上下文实体命中与误插入惩罚。
  • 幻觉抑制:通过模式匹配检测幻觉片段,并按幻觉长度惩罚。
  • 说话人日志奖励:使用 DER、cpWER 和 tcpWER,分别关注说话人活动/混淆、按说话人拼接后的识别、以及带时间约束的词对齐。

4.6 第六阶段:多教师在策略蒸馏(MOPD/OPD)

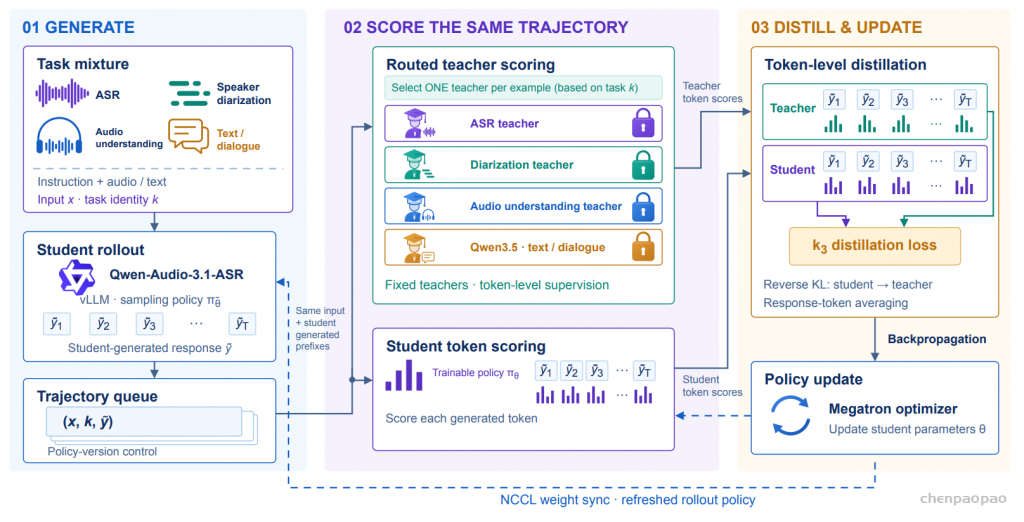
多教师在策略蒸馏的通俗理解是:不是让学生只背固定标准答案,而是先让学生按当前能力自己生成,再让最适合该任务的教师在学生实际走到的前缀上给出 token 级指导。这样,学生前面即使已经犯错,教师仍能在学生真实访问到的状态上纠偏,减轻训练分布与推理分布不一致的问题。

任务路由使用四类教师:ASR 教师负责语音转写;说话人日志教师负责 speaker、时间和文字结构;音频理解教师负责声音描述、时间定位和音频问答;Qwen3.5 文本/对话教师负责保留语言模型和对话能力。

设学生采样回答为 \tilde y,输入为 x,任务对应教师为 p_{\phi_k}。对学生生成的第 t 个 token,使用 k3 估计器:

\(\rho_t(\theta)=\frac{p_{\phi_k}(\tilde y_t\mid x,\tilde y_{<t})}{\pi_\theta(\tilde y_t\mid x,\tilde y_{<t})},\qquad d_t^{(k_3)}=\rho_t-\log\rho_t-1\)

完整蒸馏损失为:

\(\mathcal L_{\mathrm{OPD}}(\theta)=\mathbb E_{(x,k),\tilde y\sim\pi_{\bar\theta}}\left[\frac{1}{|\tilde y|}\sum_{t=1}^{|\tilde y|}d_t^{(k_3)}(\theta)\right]\)

蒸馏数据混合 ASR、speaker diarization、audio understanding,以及文本和对话数据。论文没有给出各教师、各任务的具体采样比例,也没有公开单独的 MOPD 增益表,因此可以确认其设计目标是能力合并和稳定化,但不能把最终成绩定量归因于 MOPD 单一步骤。

五、推理与部署:流式、上下文和方言任务

5.1 多语言和代码切换

推理时可以指定目标语言列表,模型在同一个 checkpoint 中处理多语言和代码切换,并保留各语言原有书写系统。例如日语保留汉字与假名,韩语保留韩文。公众号给出的韩语金融口述和日语求职咨询样例,强调专业词、语气和关键信息的保留,而不是把所有语言统一翻译成中文。

5.2 方言 ASR 与方言到普通话 AST

同一段方言有两种合法目标:ASR 要求保留方言原话;AST 要求把方言意思翻译成书面普通话。比如“大家好,我係 Qwen。”在方言 ASR 中保留“我係”,在方言到普通话 AST 中输出“我是”。这两个任务必须分开评测,不能把方言原文 CER 和普通话翻译的语义准确率混为一谈。

5.3 流式识别与 Message ASR

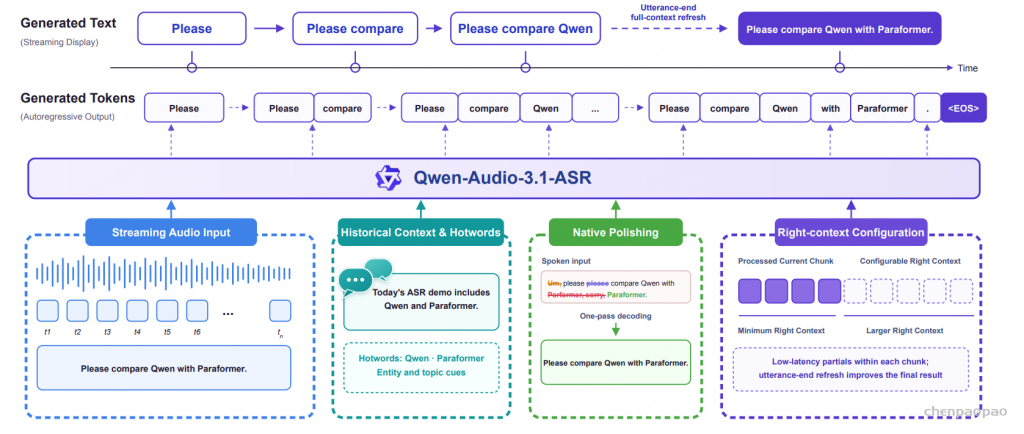
Streaming 版本把音频切成短 chunk,并配置有限的 right context,以在延迟和准确率之间折中。短 right context 更快,长 right context 能看到更多声学证据;随着更多音频到达,部分假设可以被修订。句末检测后,完整 utterance 会被重新解码并刷新最终文本。

Message ASR 在此基础上叠加历史转写、P0/P1 热词和原生润色。它的设计重点是“先让用户看到字,再在句末用完整上下文刷新”,而不是要求流式阶段立即输出最终完美结果。

Overview of the Message ASR workflow used in Qwen-Audio-3.1-ASR
连续音频输入
      ↓
音频切成短 chunk
      ↓
加入有限的未来音频 right context
      ↓
流式编码与增量解码
      ↓
输出临时文本
      ↓
继续接收新的音频
      ↓
修订尚未稳定的文本尾部
      ↓
检测到 utterance 结束
      ↓
取完整语句音频
      ↓
使用完整上下文重新解码
      ↓
刷新最终转写文本

六、实验设置与指标

论文覆盖公开 ASR、多语言、方言、行业实体、热词、长音频上下文、原生润色、Message 延迟、说话人日志和通用音频理解。公开数据集包括 AISHELL-1、AISHELL-2、FLEURS、LibriSpeech、WeNetSpeech、GigaSpeechBench、Common Voice 15、KeSpeech、WSYue、AISHELL-4、AliMeeting-test、MLC-SLM、MagicData-RAMC、MMAU、MMSU、CochlScene、Nonspeech7k、MELD、NSynth、DiDiSpeech、Clotho-Moment 和 DESED。

常用指标定义如下:

  • CER:中文或逐字评价中的字符错误率,越低越好。
  • WER:英文等按词评价的词错误率,越低越好。
  • DER:说话人日志错误率,反映漏检、误报和说话人混淆。
  • cpWER:按说话人拼接后,在最佳说话人置换下计算的词错误率,降低了 SPK0/SPK1 名称任意性的影响。
  • tcpWER:带时间约束的 cpWER,要求词与时间区间兼容。
  • 实体召回率:参考文本中关键名称和术语被正确识别的比例。
  • 语义句准确率:方言 AST 中输出是否保留人名、数量、否定、动作、对象、时间、地点等关键意义。
  • mIoU:时间定位预测区间与标注区间的平均交并比。

内部方言 AST 的语义句准确率为:

\(\mathrm{Semantic\ Sentence\ Accuracy}(\%)=\frac{100}{N}\sum_{i=1}^{N}\mathbf 1[z_i=0]\)

其中 z_i=1 表示第 i 个输出存在语义错误,z_i=0 表示没有语义错误。人工标注子集与 Qwen3.7-Max 判断的一致率为 95.35%,这 95.35% 是评估器一致率,不是方言翻译准确率。

七、主要实验结果

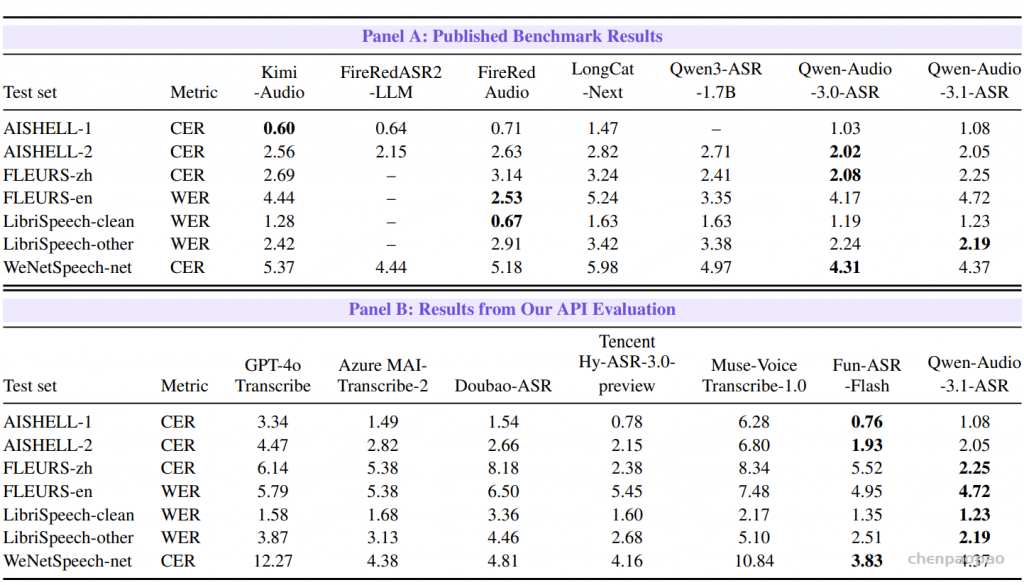
7.1 中文和英文公开 ASR

测试集指标Qwen-Audio-3.0-ASRQwen-Audio-3.1-ASR3.1 观察
AISHELL-1CER1.03%1.08%略高于上一代;统一 API 评测中 Fun-ASR-Flash 为 0.76%
AISHELL-2CER2.02%2.05%与上一代接近
FLEURS-zhCER2.08%2.25%统一 API 评测中为参评系统最低
FLEURS-enWER4.17%4.72%统一 API 评测中为参评系统最低
LibriSpeech-cleanWER1.19%1.23%统一 API 评测中为参评系统最低
LibriSpeech-otherWER2.24%2.19%论文公开结果中达到最低值
WeNetSpeech-netCER4.31%4.37%统一 API 评测中 Fun-ASR-Flash 为 3.83%

论文特别区分了“公开来源结果”和“统一 API 评测”。由于公开结果可能使用不同预处理和打分协议,直接比较应优先看 Panel B。统一 API 评测中,Qwen-Audio-3.1-ASR 在七个测试集中的四个取得最低错误率:FLEURS-zh 相对最强基线降低 0.13 个百分点,FLEURS-en 降低 0.23 个百分点,LibriSpeech-clean 降低 0.12 个百分点,LibriSpeech-other 降低 0.32 个百分点;AISHELL-1、AISHELL-2 和 WeNetSpeech-net 则由 Fun-ASR-Flash 最低。

7.2 多语言 ASR

测试组Qwen-Audio-3.0-ASR 宏平均Qwen-Audio-3.1-ASR 宏平均结论
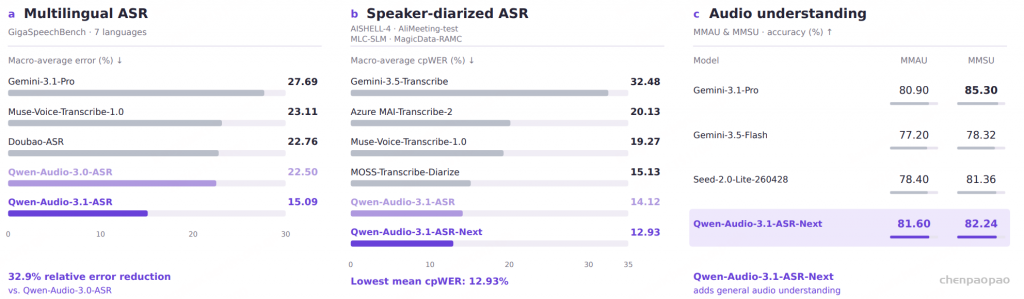
GigaSpeechBench(印尼、日、泰、菲、越、韩、马来)22.50%15.09%相对降低 32.9%,七种语言均低于上一代
Common Voice 15(8 种语言)未提供完整上一代结果3.74%有完整结果的参评系统中最低
FLEURS(9 种语言)4.94%3.85%低于上一代,但 Azure MAI-Transcribe-2 为 3.25%

GigaSpeechBench 中,日语 CER 从 28.48% 降到 18.47%,泰语 CER 从 16.22% 降到 7.75%,马来语 WER 从 34.65% 降到 25.04%。FLEURS 中,Qwen-Audio-3.1-ASR 在印尼语、日语和韩语取得该表最低错误率;但泰语、菲律宾语、越南语和马来语的最佳值由 Azure MAI-Transcribe-2 获得,说明不同语言和录音条件下仍存在系统差异。

7.3 中文方言 ASR 与 AST

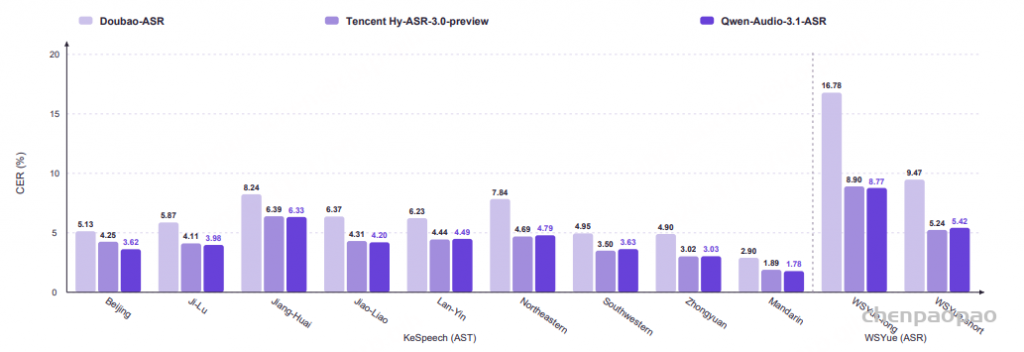
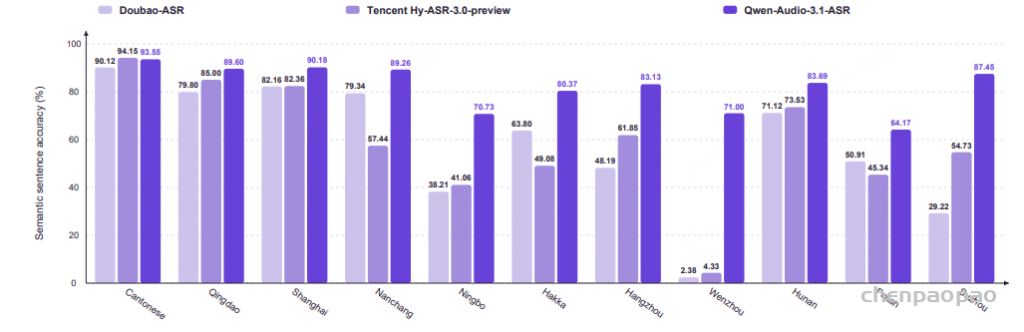
公开方言基准包含 9 个 KeSpeech AST 子集和 WSYue 粤语长/短语音 ASR 子集。Qwen-Audio-3.1-ASR 的宏平均 CER 为 4.55%,Doubao-ASR 为 7.15%,Tencent Hy-ASR-3.0-preview 为 4.61%,并在 6 个子集取得最低 CER。

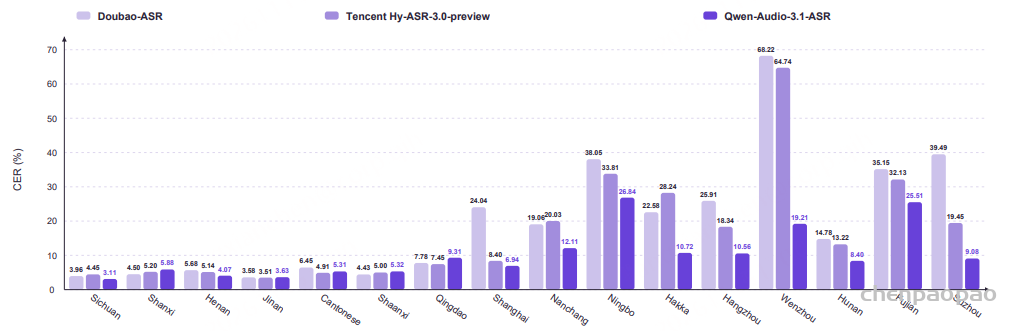
内部 16 方言 ASR 测试中,Qwen-Audio-3.1-ASR 在 11 个子集取得最低 CER,宏平均为 10.38%,低于 Doubao-ASR 的 20.23% 和 Tencent Hy-ASR-3.0-preview 的 17.13%。温州话 CER 为 19.21%,对应两个基线分别为 68.22% 和 64.74%。

内部 11 方言 AST 测试中,对 Doubao-ASR 可比的上海、客家和粤语子集,Qwen-Audio-3.1-ASR 语义句准确率宏平均为 88.03%,Doubao-ASR 为 78.69%;对 Tencent Hy-ASR-3.0-preview 可比的南昌、湖南、粤语和青岛子集,宏平均为 89.03%,基线为 77.53%。这些结果评估的是意义是否保留,不等于普通话表达是否最自然。

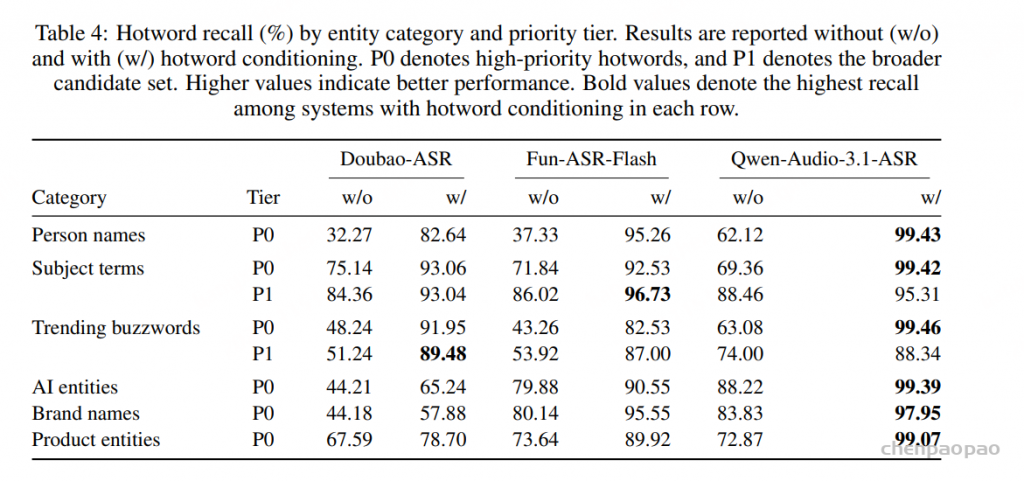
7.4 行业实体与热词

15 个行业的内部实体识别测试中,Qwen-Audio-3.1-ASR 在 9 个领域取得最高实体召回率,并在建筑与家居、制造业两个领域并列最高;召回率范围为 94.9%–99.5%。相较更强竞争系统,人工智能、农业、商业与物流的提升分别为 2.3、2.2 和 2.1 个百分点。论文也明确提醒:该结果不能单独证明实体合成流水线的因果增益,因为它与其他改进一起加入了最终模型。

热词类别层级无热词有热词说明
人名P062.12%99.43%高优先级人名提升显著
主题词P069.36%99.42%P0 强条件
主题词P188.46%95.31%P1 提升较温和
趋势词P063.08%99.46%P0 强条件
AI 实体P088.22%99.39%长尾实体召回
品牌名P083.83%97.95%有热词时明显改善
产品实体P072.87%99.07%有热词时明显改善

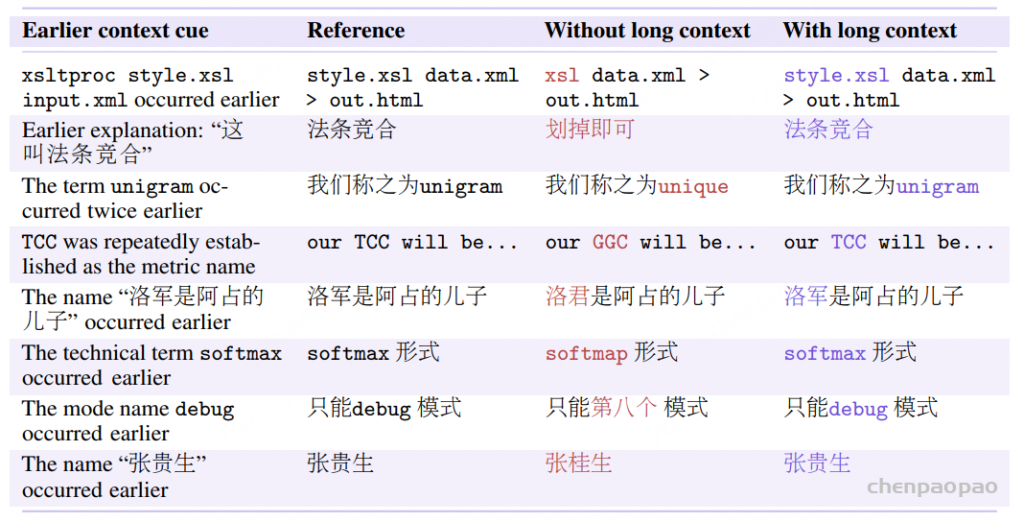
7.5 长音频上下文

论文给出的定性案例显示,前面出现过的代码文件名、法条名称、unigram、TCC、softmax、debug 模式和人名,可以帮助后续片段纠正音近但错误的结果。例如前文出现 style.xsl,后文不带上下文时识别为 xsl,加入历史上下文后恢复为 style.xsl;“张贵生”也能从“张桂生”纠正回来。这里的上下文来自同一会话的此前转写,不是外部知识库。

这些例子是定性展示,不是受控的上下文消融实验。论文没有公开一个统一的“有上下文/无上下文”总体 CER 降幅,因此应把它们理解为机制示例,而非单独的性能承诺。

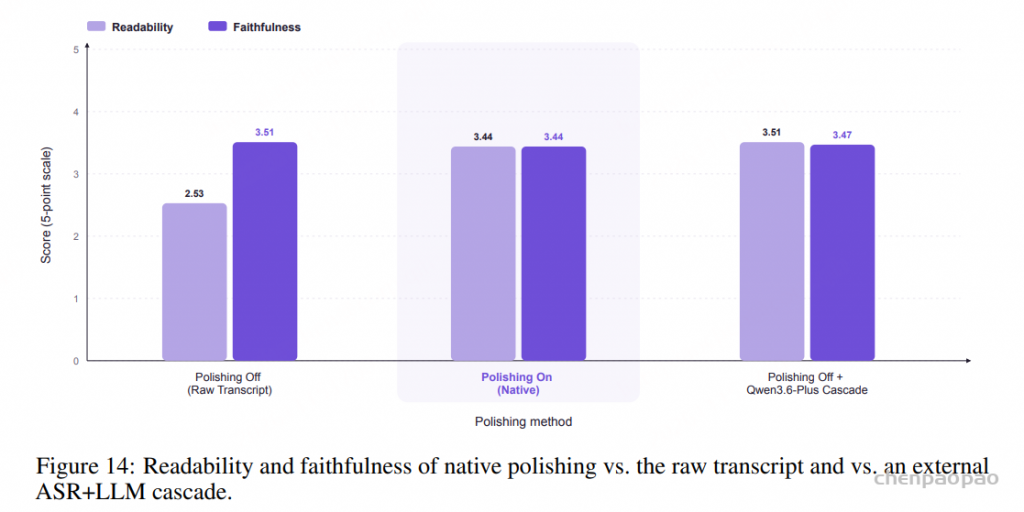
7.6 原生转写润色

在五分制内部评分中,原始转写可读性为 2.53,原生润色提高到 3.44,外部 ASR+Qwen3.6-Plus 串联为 3.51;原生润色的忠实度为 3.44,串联为 3.47,原始转写为 3.51。也就是说,原生润色显著改善可读性,只带来有限的忠实度下降,并省掉额外的文本 LLM 调用。

公众号和论文示例包括删除 um/uh、合并 the the the、处理 false start、吸收说话人的最终自我修正,以及把口述字母 d r r 规范成 DRR。

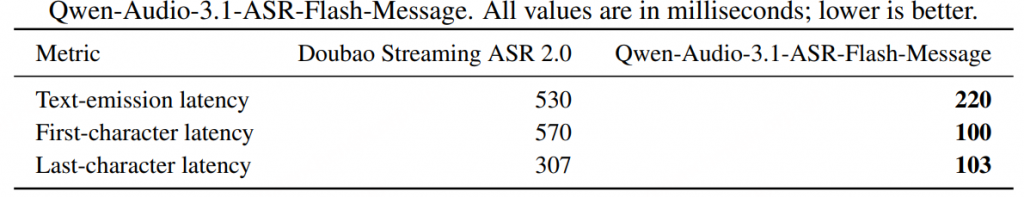
7.7 Message ASR 延迟与行业词召回

指标(毫秒)Doubao Streaming ASR 2.0Qwen-Audio-3.1-ASR-Flash-Message
文本输出延迟530220
首字符延迟570100
末字符延迟307103

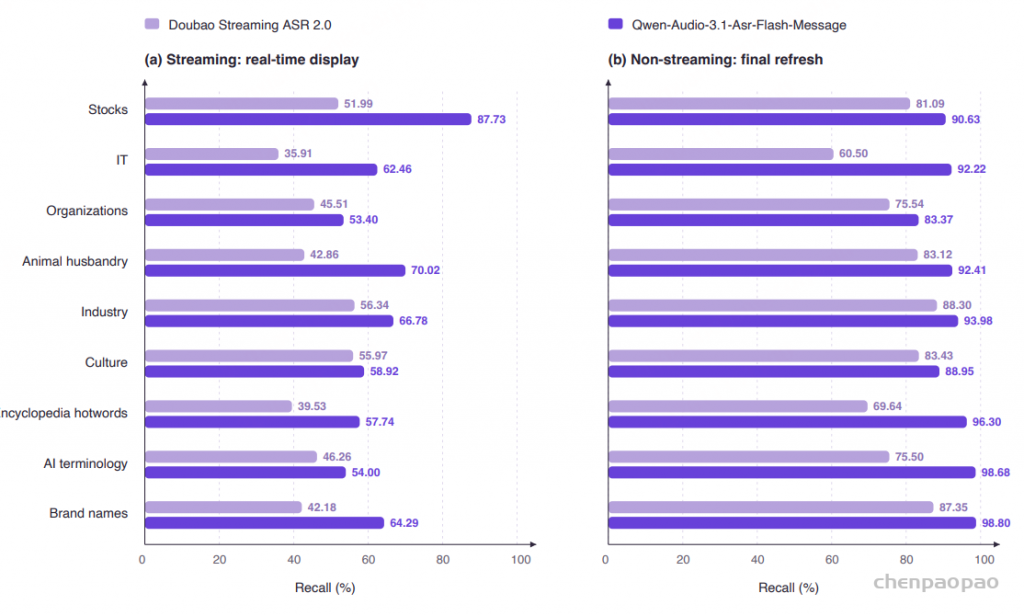
测试使用 10 路并发音频流,Qwen 服务运行在 NVIDIA H100,自建服务;网络延迟假设相近。九个行业测试集上,Qwen 流式显示阶段平均实体召回率为 63.93%,Doubao 为 46.28%;句末非流式刷新阶段为 92.82%,Doubao 为 78.27%。因此流式输出负责即时反馈,句末刷新负责更高质量的最终文本。

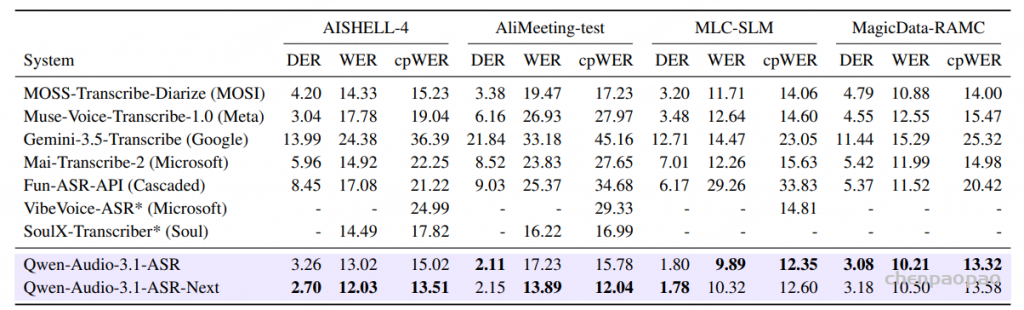
7.8 说话人日志 ASR

测试集Qwen 3.1 ASR DERQwen 3.1 ASR cpWERQwen 3.1 ASR-Next DERQwen 3.1 ASR-Next cpWER
AISHELL-43.26%15.02%2.70%13.51%
AliMeeting-test2.11%15.78%2.15%12.04%
MLC-SLM1.80%12.35%1.78%12.60%
MagicData-RAMC3.08%13.32%3.18%13.58%

两种 Qwen 版本合计在四个数据集的 12 个数据集-指标组合中都取得最低错误率;两者各有优势。Next 在 AISHELL-4 的 DER/WER/cpWER、AliMeeting-test 的 WER/cpWER 等项目更强;基础 ASR 在 AliMeeting-test DER、MLC-SLM WER/cpWER 和 MagicData-RAMC 三项指标更强。所有 Qwen 版本都在四个数据集上同时优于级联 Fun-ASR 的 DER 和 cpWER。为公平比较,长音频测试统一切成约 4 分钟片段,论文提供了 SDR Evaluation Toolkit。

7.9 通用音频理解与时间定位

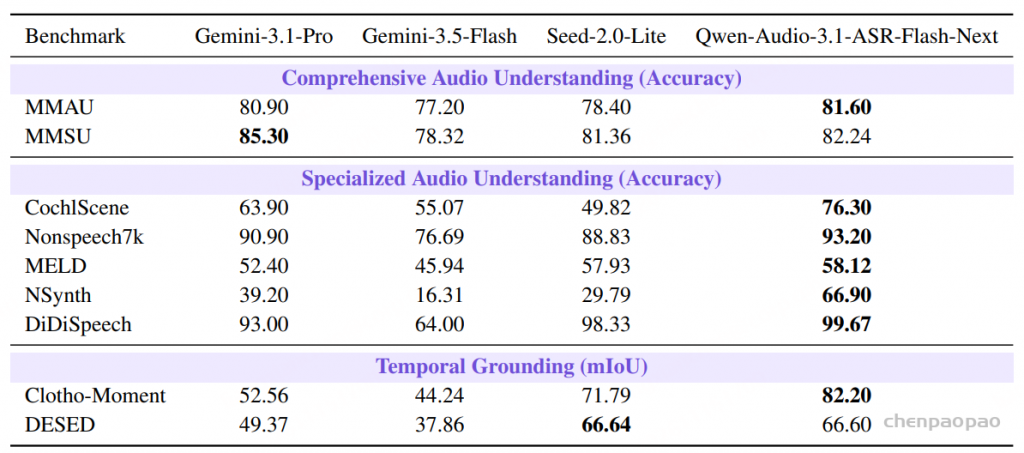
基准任务/指标Qwen-Audio-3.1-ASR-Flash-Next结果解读
MMAU综合音频理解准确率81.60%高于 Gemini-3.1-Pro 0.70 个百分点
MMSU细粒度语音理解准确率82.24%低于最佳结果 3.06 个百分点
CochlScene声学场景准确率76.30%领先次优 12.40 个百分点
Nonspeech7k非语音声音准确率93.20%该任务最佳
MELD情绪识别准确率58.12%该任务最佳
NSynth乐器识别准确率66.90%领先次优 27.70 个百分点
DiDiSpeech说话人性别准确率99.67%该任务最佳
Clotho-Moment单区间时间定位 mIoU82.20%领先次优 10.41 个百分点
DESED多区间事件检索 mIoU66.60%仅低于最佳 0.04 个百分点

Next 在 9 个基准中的 7 个取得最佳结果。它把 ASR 扩展为对语音、环境声和音乐的统一音频理解,但这类能力只在 Next 非流式接口提供,不能与 Streaming 或 Message 版本混用。

八、论文中真正的创新点

  • 从平面 ASR 到结构化音频输出:同一个指令控制框架覆盖普通转写、说话人+时间戳转写和音频理解。
  • 说话人日志直接生成:把 speaker、时间和文字序列化为统一自回归目标,并支持重叠语音,避免单独 diarization、ASR、对齐模块之间的级联误差。
  • 面向长尾实体的训练闭环:行业词挖掘、事实驱动句子生成、TTS/人工录音、重新识别过滤,形成专门的实体数据合成流水线。
  • 上下文与热词的分层控制:历史转写提供话题线索,P0/P1 把高置信度候选和宽候选分开,同时用冲突/无关上下文训练模型避免盲目复制。
  • 时间戳和 speaker token 的针对性优化:speaker-ID loss 乘 10,时间戳对齐到 80 ms 音频帧网格。
  • 异步 GRPO 与 MOPD:RL 用序列级指标直接优化;MOPD 用多个任务教师在学生实际轨迹上提供 token 级指导。
  • 流式显示与句末刷新结合:用实时性和最终准确率两个阶段分别服务用户体验和最终稿质量。
  • 原生润色:把逐字识别与清洁稿生成放进同一次音频条件解码,减少额外 ASR+LLM 串联调用。

Qwen-Audio-3.1-ASR 的关键变化不是简单堆叠更多语言,而是把 ASR 放进一个更完整的音频语言建模框架:音频编码器负责提取可对齐的声学证据,Qwen MoE 解码器负责语言和语义组织,指令决定输出任务,上下文与热词负责在有依据时解决长尾实体和同音词,RL 和 MOPD 进一步把序列级指标与任务教师反馈纳入优化。

从结果看,它在多语言、中文方言、行业术语、说话人日志和通用音频理解上形成了较完整的能力谱系;从工程上看,Flash/Streaming/Message/Next 的版本拆分说明不同能力之间存在真实的延迟、上下文和输出结构取舍。对于实际应用,最合理的使用方式不是只追求一个最低 CER,而是根据任务选择:实时输入用 Message,异步文件和说话人日志用非流式 Flash,音频描述、声音事件和时间定位用 Next;涉及关键实体时,再结合 P0/P1 热词和同一会话历史上下文。

Hy ASR 3.0 技术报告详解:LLM 语音识别、上下文利用、方言与多阶段强化学习

论文:Hy ASR 3.0 Technical Report
团队:Hy ASR team / Tencent Hy
arXiv:2611.14908v1

Hy ASR 3.0 是一个建立在预训练 Hy3 基座模型之上的大语言模型式自动语音识别系统。它的目标不只是降低普通话和英语的 CER/WER,还要同时处理粤语与其他中文方言、热词和对话上下文、同音词消歧、长音频、儿童与老年人语音、低音量和噪声环境。系统由音频编码器、音频适配器、Hy3 LLM 解码器和音频条件热词检索模块组成,训练流程则覆盖自监督编码器训练、大规模 ASR 预训练、定向持续预训练、SFT、领域专家 RL、多教师 on-policy 蒸馏和行为强化学习。

一、核心结论与关键贡献

  • LLM-based ASR:音频编码器提取声学表示,音频适配器将其投影到 LLM 输入空间,Hy3 LLM 自回归生成转写。
  • 多种外部上下文:支持热词列表、问答式对话历史和摘要;热词先通过音频条件检索模块筛选,再与其他上下文一起作为文本前缀。
  • 句内上下文消歧:模型能够利用同一条语音其他位置的语义或显式拼字说明,识别同音、近音和生僻词,无需额外外部上下文。
  • 大规模自监督编码器:采用 Best-RQ 启动、迭代 HuBERT 和残差向量量化,在数千万小时语音上训练。
  • 大规模伪标签:多套 ASR 系统独立生成候选转写,以 ROVER 投票融合,再经过多阶段质量过滤。
  • 数据效率:领域平衡和数据压缩后,只使用原训练数据的 50% 仍获得更好性能;持续预训练对齐 SFT 分布后,SFT 数据可压缩到原来的 1/10,同时保持模型性能。
  • 专家强化学习:分别训练通用 ASR、方言 ASR、上下文偏置 ASR 三个专家,以降低跨领域目标干扰。
  • MOPD:学生先生成 on-policy 假设,再按领域路由给相应专家做 token 级 KL 蒸馏,把三个专家合并为一个统一模型。
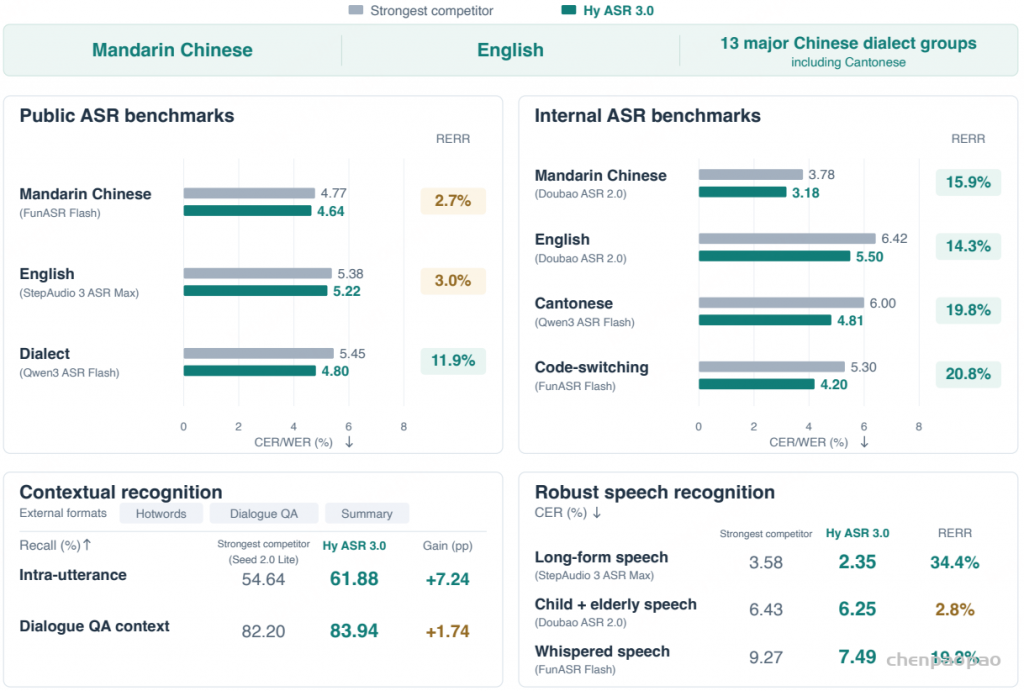
  • 公开基准:论文报告中文聚合错误率 4.64%、英文 5.22%、方言组合 4.80%;粤语四个子集的非加权均值为 5.06%。
  • 内部基准:普通话、英语、粤语、代码切换分别为 3.18%、5.50%、4.81%、4.20%,在论文比较的系统中均为最低。
  • 上下文与鲁棒性:句内上下文关键词召回 61.88%,对话 QA 上下文召回 83.94%;长音频 CER 2.35%,儿童+老年语音 6.25%,低音量+噪声 7.49%。
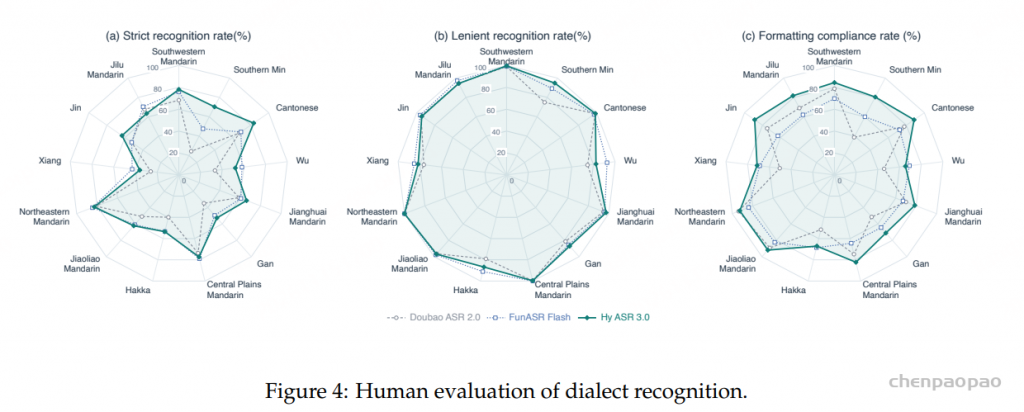
  • 方言人工评测:覆盖 13 个方言大类、91 个次区域变体,严格识别率 64.7%,格式合规率 80.3%。
Hy ASR 3.0 能力与主要基准结果总览,包括普通话、英语、方言、上下文识别和鲁棒性。

二、任务定位:

Hy ASR 3.0 的输出目标是语音内容转写,即把音频转换为文字。它关注的核心是四类问题:

  1. 普通话、英语、粤语和中文方言的识别准确率;
  2. 热词、历史问答和摘要等外部上下文如何帮助识别;
  3. 同一语句内部的语义、对比和逐字解释如何消除同音歧义;
  4. 长音频、不同年龄人群、低音量和噪声等真实业务条件下的鲁棒性。

三、模型架构

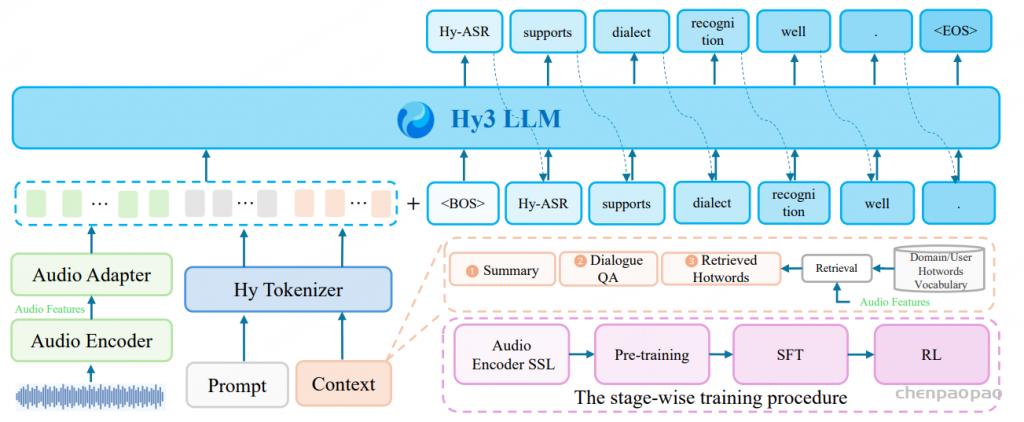
Hy ASR 3.0 模型架构与分阶段训练流程。图中包含 Audio Encoder、Audio Adapter、Hy Tokenizer、Hy3 LLM、摘要/对话 QA/检索热词前缀,以及 Encoder SSL、Pre-training、SFT、RL 四段训练链路。

3.1 音频编码器

音频编码器的训练采用迭代的 HuBERT 式自监督流程。先训练一个 Bootstrap Encoder,并用 Best-RQ 对它选定的中间表示做量化,得到离散目标;再用这些目标训练一个 Intermediate HuBERT 模型;随后对它的表示做残差向量量化,得到多级目标;最后训练最终编码器,从被掩码的语音输入预测这些目标。整个阶段的直接监督来自语音自身的量化表示,人工逐字标注留给后续需要监督的任务。

编码器在数千万小时语音上分 2 阶段训练,数据以普通话和英语为主,也包含粤语和其他汉语方言。第一阶段覆盖较广的语音混合,第二阶段继续预训练时重新平衡数据,更强调汉语方言,降低噪声录音和短句的权重,并加强掩码策略和 utterance mixing,以提高对干扰语音的鲁棒性。

Best-RQ × HuBERT 式自监督学习 × 残差向量量化: Best-RQ 先提供可训练的 bootstrap 目标和量化表示,HuBERT 式自监督学习把这些表示变成掩码预测任务,残差向量量化再把表示分成多级离散目标。三者的分工是:Best-RQ 解决起始监督,HuBERT 式流程解决从掩码语音学习语义表示,残差向量量化提供更细的多级预测目标;组合后,最终音频编码器不需要人工逐字标签,就能从大量无标注语音中学习可供 LLM 使用的表示。

PS:

  • Best-RQ 的核心思想是:不需要预训练教师模型,也不需要人工标签,通过随机投影和随机码本,就能将连续语音特征转换成离散 Token,作为模型学习的伪标签。
  • HuBERT(Hidden-Unit BERT)的核心思想是:先为语音生成离散伪标签,再遮挡输入语音的一部分,让模型根据未被遮挡的上下文预测被遮挡位置的离散标签。建模上下文中的声学和语义关联,迫使模型学习更强的上下文表示。
  • RVQ,即残差向量量化,核心思想是:不再使用一个码本对连续向量进行一次量化,而是使用多个码本逐级量化前一级未能表示的残差,从而实现多级离散编码。提高离散表示的表达容量。保留更细粒度的声学和语音信息。提供多个离散预测目标,丰富自监督训练信号。
无标注语音
   ↓
Bootstrap Encoder
   ↓
Best-RQ 量化中间表示
   ↓
离散伪标签
   ↓
Intermediate HuBERT
   ↓
残差向量量化 RVQ
   ↓
多级离散伪标签
   ↓
最终 Encoder
   ↓
遮蔽语音预测多级目标

3.2 音频适配器

音频适配器将编码器的声学表示映射到 Hy3 LLM 的输入嵌入空间,使连续音频表示能够与文本 token、提示词和上下文前缀处在同一个条件序列中。

3.3 外部上下文与音频条件热词检索

系统支持三种外部上下文:

  • Hotword list:明确给出专有名词、产品名、人名、地名等候选词。
  • Dialogue QA:先前轮次的问答历史,为当前语音提供对话语义。
  • Summary:对任务、会议或对话主题的摘要。

候选热词表可能很大,直接把所有词塞入 LLM 前缀会造成无关干扰和上下文浪费。因此热词检索模块同时观察音频表示和候选热词,只选择与当前音频相关的词,形成 retrieved hotwords。检索结果与摘要、对话 QA 一起编码成文本前缀,排在音频嵌入之前。

3.4 LLM 自回归转写

Hy3 LLM 根据外部上下文前缀、音频嵌入和此前已经生成的 token,自回归地产生转写:

\(P(y_{1:T}\mid x,c)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x,c)\)

其中 \(x\) 是音频表示,\(c\) 可以包含检索热词、摘要和历史对话。论文强调,句内上下文不是单独输入项:模型通过整段音频和已生成转写序列,自然利用语句其他位置的信息。

四、音频编码器的自监督训练

4.1 Best-RQ 启动编码器

第一步先用 Best-RQ 训练一个 bootstrap encoder。Best-RQ 通过随机投影量化产生离散目标,避免一开始就依赖高质量人工标签。训练完成后,从该编码器选定的中间层提取表示并量化,作为下一轮 HuBERT 的离散监督。

4.2 中间 HuBERT 与多级目标

用 bootstrap encoder 生成的离散标签训练中间 HuBERT 模型。然后再对这个 HuBERT 的表示应用残差向量量化(Residual Vector Quantization,RVQ),形成多级离散目标。RVQ 不只给一个 code,而是用多个残差量化层逐级逼近表示,因此最终编码器可以学习不同粒度的声学—语义结构。

4.3 最终编码器的掩码预测

最终音频编码器接收被遮蔽的语音输入,并预测 RVQ 产生的多层离散目标。这一流程与 HuBERT 的“先聚类/量化、再预测掩码位置伪标签”思想一致,但目标构建经历了 Best-RQ 启动、中间 HuBERT 和残差量化的迭代精炼。

4.4 编码器数据与两阶段配比

编码器使用数千万小时语音训练,主要为普通话和英语,也包含粤语与其他中文方言。论文没有公开精确小时数、数据集清单和各语言比例。

  1. 大规模预训练:先在宽泛的语音混合上训练,获取通用声学与语义表示。
  2. 持续预训练:重新平衡数据,提高中文方言占比,降低噪声录音和短语音的采样权重。

编码器训练还加强了掩码策略,并采用 utterance mixing,把不同语句混合,提升对干扰语音的鲁棒性。论文引用了相关混合方法,但没有给出混合概率、信噪比或具体增强参数。

五、大规模 ASR 预训练:数据如何获取与后处理

5.1 第一阶段:Web 级大规模预训练

第一阶段使用来自 Web 的数千万小时语音。如此大规模的数据不可能全部依赖人工转写,团队构建了多系统自动标注流水线:

  1. 多个不同 ASR 系统对同一音频独立生成候选转写;
  2. 使用 ROVER(Recognizer Output Voting Error Reduction)对多个候选进行对齐和投票;
  3. 对融合后的伪转写进行多阶段质量过滤,去除不可靠样本;
  4. 进行领域感知的数据平衡,避免高频领域过度占用训练容量;
  5. 进行数据压缩,删除冗余信息,把预算集中到更有信息量的样本。

ROVER 的核心思想是把多套识别结果对齐成词图/混淆网络,再根据系统投票选出更可信的 token 序列。给出了总体效果:经过平衡与压缩后,使用原始训练数据的 50% 就能获得更好的模型性能。这说明“规模”不是唯一变量,数据冗余、领域失衡和伪标签噪声同样重要。

5.2 第二阶段:定向持续预训练

第二阶段提高以下数据的比例:

  • 中文方言语音;
  • 上下文偏置/热词相关数据;
  • 困难声学条件下的语音。

这个阶段有两个目的:一是直接增强方言、上下文和噪声鲁棒性;二是让预训练分布更接近后续 SFT 数据。论文报告,经过这种分布对齐后,SFT 数据可缩减到原来的 1/10,同时保持模型性能,从而显著加快 SFT 实验迭代。

六、后训练:SFT、专家 RL、MOPD 与行为 RL

6.1 监督微调 SFT

SFT 重点提升方言、上下文偏置和困难声学场景,同时保持预训练阶段的通用 ASR 能力。训练数据也采用迭代自举:

  1. 持续改进自动转写流水线的各个标注组件;
  2. 每轮选择上一轮表现最好的 SFT 检查点作为教师;
  3. 教师为下一轮数据生成伪转写;
  4. 逐轮提高伪标签质量,并补充方言与其他困难场景的定向数据。

6.2 三个领域专家的强化学习

团队从同一个 SFT 检查点初始化三个独立专家:

  • 通用领域 ASR 专家;
  • 方言 ASR 专家;
  • 上下文偏置 ASR 专家。

分开训练可以减少通用准确率、方言行为和上下文关键词识别之间的梯度冲突。每个专家的奖励按领域特点设计,不仅考虑整体识别准确率,也考虑关键词识别和语句级转写流畅度。报告没有公开奖励函数的精确公式和各项权重。

6.3 多教师 On-Policy 蒸馏(MOPD)

三个专家最终需要合并为一个服务模型。MOPD 的流程是:学生先对每条语音生成自己的 on-policy 识别假设;根据样本领域,把该学生轨迹路由给对应专家;专家在学生实际访问的 token 前缀状态上提供 token 级分布监督。

\(\mathcal{L}_{\mathrm{MOPD}}=\mathbb{E}\left[\frac{1}{T}\sum_{t=1}^{T}D_{\mathrm{KL}}\left(\pi_{\theta}(\cdot\mid\mathbf{s}_t)\Vert\pi_{\phi_d}(\cdot\mid\mathbf{s}_t)\right)\right]\) \(T=|\hat{\mathbf{y}}|,\qquad \mathbf{s}_t=(\mathbf{x},\hat{\mathbf{y}}_{<t})\)

其中 \(\pi_{\theta}\) 是学生策略,\(\pi_{\phi_d}\) 是领域 \(d\) 对应的专家,\(\mathbf{x}\) 包含声学输入和可选上下文,\(\hat{\mathbf{y}}\) 是学生自己生成的序列。采用 on-policy 轨迹的好处是:专家监督发生在学生真实会遇到的状态上,而不是只在标准答案前缀上蒸馏,可缓解训练—推理状态分布不一致。

KL 的方向是学生到教师:

\(D_{\mathrm{KL}}(\pi_{\theta}\Vert\pi_{\phi_d})=\sum_{v}\pi_{\theta}(v\mid\mathbf{s}_t)\log\frac{\pi_{\theta}(v\mid\mathbf{s}_t)}{\pi_{\phi_d}(v\mid\mathbf{s}_t)}\)

6.4 Model-Behavior RL

最后阶段针对真实使用中发现的 hard cases 做行为强化,重点是必须依赖周围语义才能正确识别的关键词。这一阶段直接奖励上下文依赖的关键词识别和整句连贯、流畅的转写。它更接近产品反馈闭环:先发现线上困难行为,再构造定向强化样本,而不是只优化平均 CER/WER。

七、数据规模、获取与处理:

阶段论文披露的数据规模获取/处理方式未披露项
音频编码器自监督训练数千万小时普通话和英语为主,含粤语与其他方言;Best-RQ、HuBERT、RVQ、掩码预测;持续预训练重平衡精确小时数、来源清单、语言比例
ASR 大规模预训练数千万小时 Web 语音多 ASR 候选、ROVER 融合、多阶段过滤、领域平衡、数据压缩教师系统、过滤阈值、原始/保留小时数
定向持续预训练未给精确规模提高方言、上下文偏置、困难声学数据比例各类占比、训练步数
SFT可压缩到原规模的 1/10迭代教师伪标签,定向补充方言与困难场景原始规模、最终规模、人工/伪标签比例
专家 RL 与 MOPD未披露通用/方言/上下文三专家,领域路由蒸馏样本量、奖励权重、采样和训练超参数
Model-Behavior RL未披露来自真实使用的 hard cases,强调上下文关键词数据收集与隐私流程、规模、奖励公式

八、评测设置、对比系统与指标

对比系统包括 Qwen3 ASR Flash、FunASR Flash、Doubao ASR 2.0、Seed 2.0 Lite、StepAudio 3 ASR Max 和 Hy ASR 3.0 Preview。论文说明,这些系统名称与服务来自其技术报告或官方服务页面,但表中的数值是本研究自己的评测结果,不是从外部文档直接摘录的排行榜分数。

  • CER/WER:客观识别错误率,越低越好。
  • Target-keyword recall:目标关键词召回率,越高越好。
  • 人工方言指标:严格识别率、宽松识别率、格式合规率,越高越好。
  • 相对错误率下降:以最强非 Hy 对手为基准。
\(\mathrm{CER}=\frac{S+D+I}{N_{\mathrm{char}}},\qquad \mathrm{WER}=\frac{S+D+I}{N_{\mathrm{word}}}\) \(\mathrm{RERR}=\frac{E_{\mathrm{comp}}-E_{\mathrm{Hy}}}{E_{\mathrm{comp}}}\times100\%\)

其中 S、D、I 分别为替换、删除和插入。召回率或人工百分比之间的差异使用“百分点”,不使用相对错误率公式。

九、公开 ASR 基准

公开测试覆盖 AISHELL-1/2、AliMeeting、WenetSpeech、FLEURS、Common Voice、SpeechIO、LibriSpeech、GigaSpeech、TED-LIUM 3、VoxPopuli、MLS、WenetSpeech-Yue 和 KeSpeech。论文声称进行了严格去污染:训练中不包含评测语音,也不包含其音频或文本近重复。

聚合组Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
中文5.734.775.555.426.984.734.64
英文6.216.027.935.565.385.285.22
方言组合5.455.467.666.736.265.234.80

相对最强外部对手,三组分别约降低 2.7%、3.0% 和 11.9%;相对 Preview 分别约降低 1.9%、1.1% 和 8.2%。这些聚合提升并不意味着每个子集都第一。

9.1 普通话子集

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
AISHELL-12.121.011.902.031.401.211.37
AISHELL-2 Android/iOS/Mix2.70/2.59/2.552.16/1.91/2.142.67/2.55/2.692.68/2.75/2.782.30/2.20/2.352.02/2.03/2.102.05/2.02/1.98
AliMeeting Near/Far7.13/23.145.94/22.025.88/26.186.27/24.817.89/34.235.84/21.275.47/21.52
WenetSpeech Net/Meeting4.96/6.163.74/3.624.11/4.544.13/4.236.63/8.523.91/4.313.74/4.16
FLEURS-zh2.952.002.402.131.851.841.84
CommonVoice-zh4.414.105.614.545.004.524.49
SpeechIO Locked/Unlocked3.62/6.475.95/2.612.52/5.525.09/2.628.50/2.945.04/2.634.63/2.36

Hy ASR 3.0 的优势集中在 AISHELL-2 Mix、AliMeeting Near、SpeechIO Unlocked,并在 WenetSpeech test-net 与 FLEURS-zh 并列最佳。但 AISHELL-1、WenetSpeech Meeting、CommonVoice-zh 和 SpeechIO Locked 并非最好,说明总体聚合提升来自跨数据集平衡,而非全面碾压。

9.2 英文子集

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
LibriSpeech Clean/Other1.33/2.601.31/2.502.87/5.851.37/2.651.17/2.251.28/2.591.19/2.31
CommonVoice-en6.326.3114.186.817.215.535.48
FLEURS-en2.663.246.382.552.952.642.53
GigaSpeech Test9.159.969.589.439.688.278.27
TED-LIUM 33.003.393.183.042.482.502.44
VoxPopuli Test/Accented5.99/20.976.06/16.849.52/12.577.40/13.287.08/11.755.98/14.755.84/15.27
MLS Test-en3.874.577.273.543.853.993.69

Hy ASR 3.0 在 Common Voice、FLEURS、TED-LIUM 3、VoxPopuli 普通测试集上最好,并在 GigaSpeech 与 Preview 持平。但 LibriSpeech 两个子集仍由 StepAudio 领先;VoxPopuli accented 上 Hy ASR 3.0 为 15.27%,不仅落后 StepAudio 的 11.75%,还比 Preview 的 14.75% 更差,论文把带口音英语列为后续改进方向。

9.3 粤语与 KeSpeech

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
FLEURS-yue2.973.246.522.643.052.762.63
CommonVoice-yue4.674.985.846.285.903.493.56
WenetSpeech-Yue Short/Long6.51/8.585.73/9.019.48/11.338.27/10.777.09/9.865.38/9.345.00/9.05
KeSpeech4.514.335.125.685.395.173.77

Table 1 的“方言 4.80%”把四个粤语子集与 KeSpeech 合并。若只计算 FLEURS-yue、CommonVoice-yue、WenetSpeech-Yue Short/Long 四个粤语子集的非加权均值,Hy ASR 3.0 为 5.06%,Qwen3 为 5.68%,相对下降约 11.0%。KeSpeech 从 Preview 的 5.17% 降到 3.77%,相对下降 27.1%。

十、内部主语言基准

内部测试集来自真实业务数据,用来补充公开数据不能覆盖的实际分布。论文未公开数据规模、领域构成和采样方法。

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
普通话4.944.153.785.565.303.353.18
英语8.767.546.428.7810.685.785.50
粤语6.0019.407.497.907.004.924.81
代码切换8.805.306.496.376.904.354.20

Hy ASR 3.0 在四类内部测试中都最低,并全面优于 Preview。相对图 1 中所列最强外部对手,普通话、英语、粤语和代码切换分别给出约 15.9%、14.3%、19.8% 和 20.8% 的相对错误率下降。

十一、上下文利用

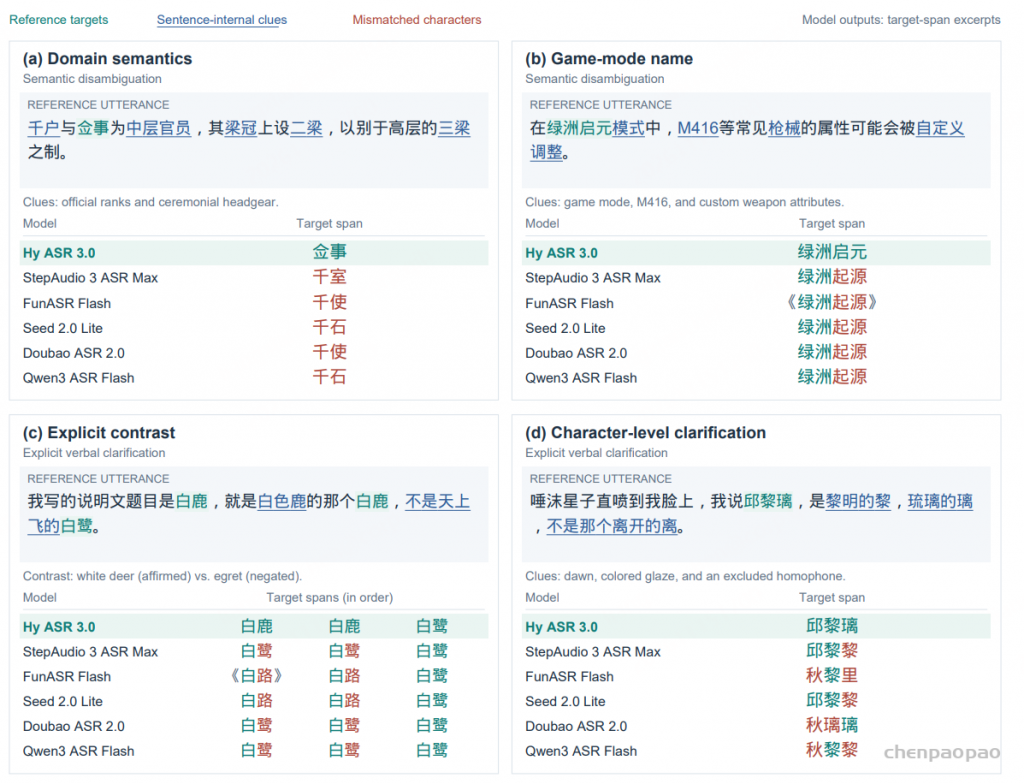
四个句内消歧案例。面板 (a)–(b) 为语义消歧,(c)–(d) 为显式口头澄清;所有线索都在当前语句内部。

11.1 四个定性案例

  • 历史官职:根据“负责太子中属官员、祭祀及礼仪”等语义,识别罕见官职名称,而其他模型输出近音常见词。
  • 游戏模式名:根据游戏、M416 和自定义调整等领域语义,选择正确的专名写法。
  • 显式对比:说话者明确说明“白鹿的鹿,不是白鹭的鹭”,模型需保留肯定项并排除否定同音词。
  • 逐字解释姓名:通过“哪个部首/哪个字”的解释区分姓名中相邻同音字;部分模型虽然转对了解释,却仍在姓名中重复同一个字。

这些案例证明输出与上下文线索一致,但它们只是定性示例,不是“关闭上下文/开启上下文”的受控消融。

11.2 关键词召回结果

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
句内上下文46.6051.1651.8654.6450.7558.1261.88
对话 QA 上下文71.6877.3378.4782.2069.3279.4483.94

相对最强非 Hy 对手 Seed 2.0 Lite,Hy ASR 3.0 分别提高 7.24 和 1.74 个百分点。需要再次强调,这是跨系统比较,不是同一模型有无上下文的消融,因此不能精确量化每种上下文模块的单独贡献。

十二、鲁棒性

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
长音频3.863.985.604.993.582.962.35
儿童 + 老年人9.987.876.4310.499.907.186.25
低音量 + 噪声14.729.2715.7517.3143.028.487.49

相对最强非 Hy 对手,三项 CER 分别下降 34.4%、2.8% 和 19.2%。长音频和低音量/噪声的改进更明显。儿童与老年人被合并成一个测试集,因此 6.25% 不能证明模型分别在儿童和老年人子集都同样提升。

十三、方言识别与人工评测

许多方言缺乏统一书写标准,同一句口语可能有多个合理写法,传统 WER/CER 未必能公平衡量。论文对缺少标准正字法的方言采用翻译式表示,把口语内容转成更一致的书面表达。模型开发阶段使用 LLM judge 评估语义错误率和转写风格一致性,但最终以人工评测为准。

人工评测覆盖 13 个方言大类、91 个次区域变体,对比 FunASR Flash 与 Doubao ASR 2.0。指标含义如下:

  • 严格识别率:转写内容被判断为完全正确的比例。
  • 宽松识别率:允许不改变语义的措辞差异,判断语义正确的比例。
  • 格式合规率:没有标点、逆文本归一化(ITN)和流畅性问题的比例。

Hy ASR 3.0 的总体严格识别率为 64.7%,比 FunASR 高 2.8 个百分点、比 Doubao 高 12.5 个百分点;格式合规率为 80.3%,分别高 11.4 和 13.7 个百分点。宽松识别率高于 Doubao,但比 FunASR 低 1.0 个百分点。

分方言看,闽南语与粤语的严格识别率分别达到 70.3% 和 83.3%,比各自最强对手高 22.7 和 14.2 个百分点;但吴语三个指标都仍由 FunASR 领先,说明模型在不同地区变体上的能力并不均衡。

13 个方言类别在严格识别率、宽松识别率、格式合规率上的三张雷达图

十四、总结

Hy ASR 3.0 的主线不是提出一个单独的新网络层,而是构建一套大规模、分阶段的 LLM-ASR 训练体系:先用迭代 HuBERT 风格的离散目标训练强音频编码器,再用多系统 ROVER 伪标签和数据压缩做 Web 级预训练,随后用方言/上下文/困难声学数据持续预训练,通过迭代教师 SFT 提高监督质量,最后把通用、方言和上下文三个 RL 专家的能力用 MOPD 汇入一个学生,并对真实 hard cases 做行为强化。

从结果看,这套路线在聚合普通话、英语、粤语/方言、上下文关键词和实际鲁棒性上取得了较均衡的性能;真正值得关注的创新是“数据治理 + 上下文输入组织 + 领域专家 RL + on-policy 多教师蒸馏”的组合。它的主要不足则是复现信息不够完整、缺少模块级消融、内部评测不可公开验证,而且带口音英语和部分方言类别仍有明显提升空间。

Nemotron 3 Diarization 论文详解:面向 8 说话人的高精度、高吞吐流式说话人日志

论文:Nemotron 3 Diarization: Advancing the Accuracy-Efficiency Frontier in Streaming Speaker Diarization
作者:Ivan Medennikov、Taejin Park、Tatiana Timofeeva、He Huang、Alexander Polok、Sofia Kostandian、Weiqing Wang、Dongji Gao、Jagadeesh Balam、Boris Ginsburg
机构:NVIDIA、Brno University of Technology
arXiv:2611.12246v1
模型:nvidia/Nemotron-3-Diarization
官方博客:Know Who Spoke When

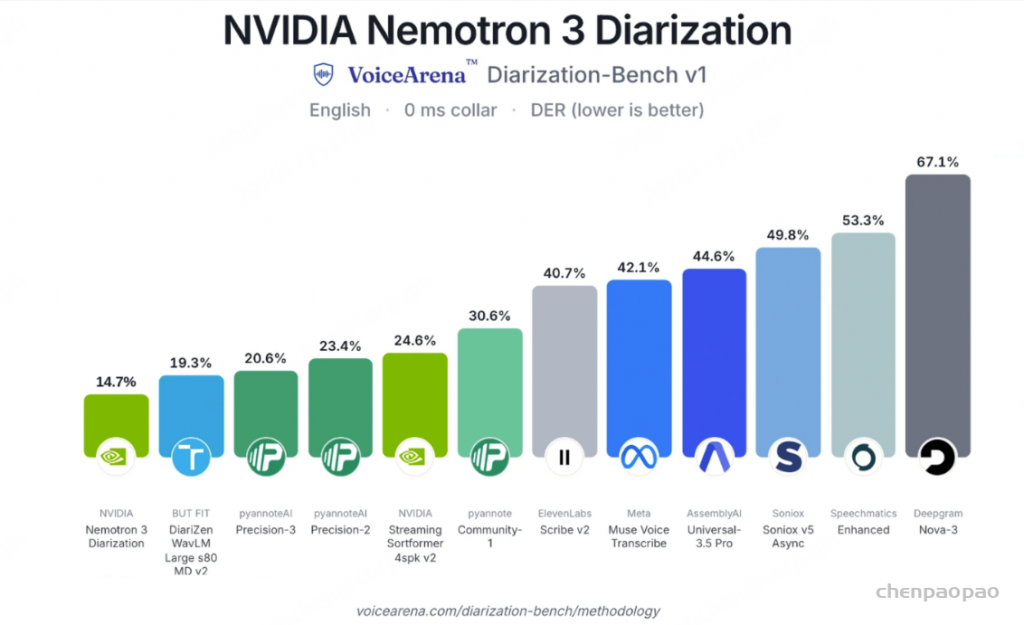
Nemotron 3 Diarization 是一个约 1 亿参数、最多支持 8 名说话人的开放权重说话人日志模型。它同时覆盖离线和流式推理:同一个检查点可以运行在 30.4 秒“离线式”输入缓冲,也可以运行在 1.04 秒、0.64 秒和 0.32 秒低延迟配置下。论文最核心的价值不只是把上一代 Streaming Sortformer 的上限从 4 人扩展到 8 人,而是在容量翻倍的同时,将参数量从 117M 降到约 99M/100M,并获得更低的 DER、更细的 10 ms 时间分辨率和最高约 6.4 倍的推理吞吐提升。需要区分的是:该任务识别的是“匿名说话人何时发言”,不是实名身份识别,也不是把重叠声源分离成独立波形。

一、先给结论:这项工作的核心贡献

  • 说话人容量:从上一代最多 4 人扩展到最多 8 个匿名说话人通道,输出通道按说话人首次出现顺序排列。
  • 骨干网络:用单一的 31 层 Transformer + RoPE,替换“17 层 FastConformer + 18 层 Transformer”的混合骨干;参数量由 117M 降至 99M 左右。
  • 高分辨率输出:编码器仍以 80 ms 步长运行,但通过宽度为 3 的一维子像素卷积,将表示学习式上采样 8 倍到 10 ms,兼顾边界精度和计算效率。
  • 流式记忆:Arrival-Order Speaker Cache(AOSC)从 188 帧扩容到 264 帧,并配合 FIFO 最近上下文,在分块处理中维持跨块说话人身份。
  • 新训练目标:增加 activity loss,学习静音、单人语音、重叠语音三类无排列活动;增加 phantom loss,抑制未使用通道中的“幽灵说话人”高置信激活。
  • 大规模数据:约 10,000 小时真实会话,加 82,611 小时模拟多说话人混合;其中约 5,000 小时为人工标注真实录音,约 5,000 小时为伪标签 YODAS-v2。
  • 两阶段训练:先只用模拟混合训练离线 Sortformer,再用真实与模拟数据联合进行流式 AOSC 微调。
  • 效果:在 DIHARD III、CALLHOME 上刷新论文所比较系统中的 DER;作为 DiCoW 的条件输入时,在 AMI 与 NOTSOFAR-1 的单麦条件上取得新的 tcpWER 最优结果。
  • 效率:相对相同设置下的旧 FastConformer 编码器,训练显存降低 2.8 倍、迭代速度提升 2.2 倍;推理端在部分配置达到约 6.4 倍吞吐提升。
  • 开放性:训练代码公开,权重使用 OpenMDW-1.1 许可,可用于商业或非商业场景,但实际部署仍需针对目标领域验证。
VoiceArena Diarization-Bench 排名图,Nemotron 3 Diarization 以 14.72% DER 排名第一。

二、任务背景:说话人日志究竟解决什么问题

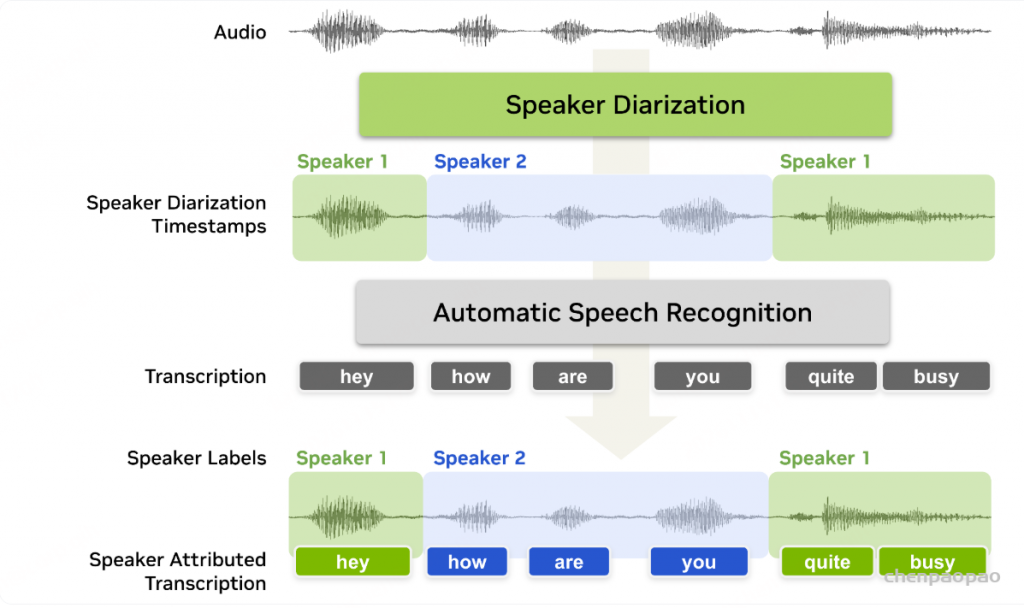
自动语音识别回答“说了什么”,说话人日志回答“谁在什么时候说话”。标准输出不是实名身份,而是一组匿名通道,例如 speaker_0、speaker_1,以及各自的起止时间。若两个人同时说话,同一时间帧可以有两个通道同时激活,因此该任务天然需要建模重叠语音。

传统流水线通常包含语音活动检测、分段、说话人嵌入、聚类和重叠处理。EEND(End-to-End Neural Diarization)则直接预测联合说话人活动。Sortformer 属于固定容量 EEND:模型提供固定数量的输出通道,并使用排列不变损失 PIL 与到达时间排序监督 ATS 解决说话人标签排列问题。Streaming Sortformer 又加入 AOSC,使说话人通道能够跨音频块保持一致。

上一代公开模型的主要限制是:最多 4 人、输出步长 80 ms、扩大缓存会增加推理成本,而且在大多数录音中,多余通道容易产生错误激活。Nemotron 3 Diarization 的设计目标因此是同时满足:更多说话人、更精细边界、低延迟、低显存、高吞吐和同一检查点覆盖多种上下文长度。

三、模型架构详解

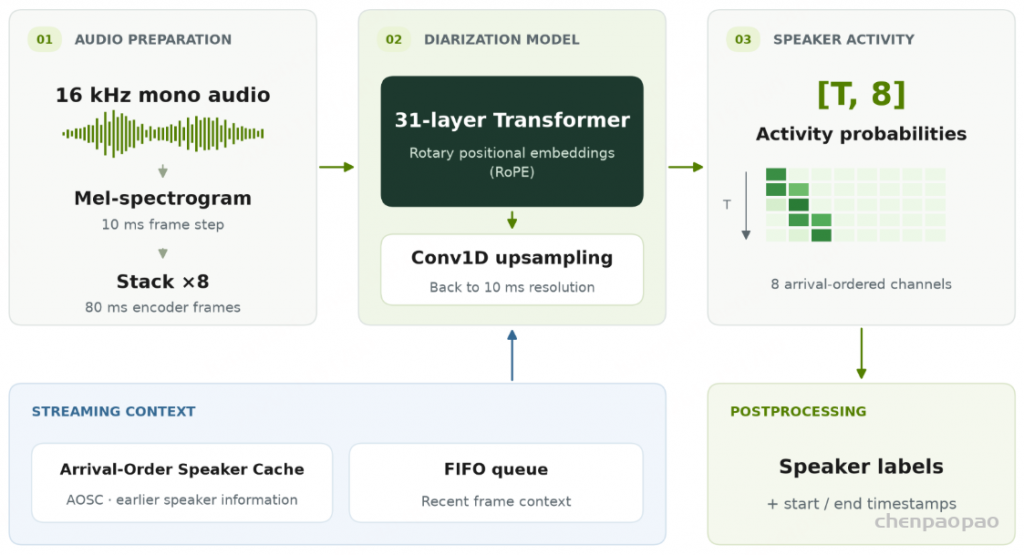
从 16 kHz 单通道音频到到达顺序说话人活动概率的整体流程,包含 10 ms Mel 特征、80 ms Transformer 编码、Conv1D 上采样、AOSC 与 FIFO。

3.1 输入与特征

  • 输入为 16 kHz、单通道音频;模型卡列出 WAV、FLAC、OPUS、MP3。
  • 音频被转换为 10 ms 步长的 Mel 频谱特征。
  • 连续 8 帧特征做 feature stacking,时间轴下采样 8 倍,因此编码器每帧对应 80 ms。
  • 分块推理没有固定的模型最大音频时长,但超长音频、严重噪声、强混响、远场和领域偏移仍可能造成性能下降。

3.2 31 层纯 Transformer 编码器

旧模型使用 17 层 FastConformer 后接 18 层 Transformer。新模型改为单一的 31 层 Transformer,并使用旋转位置编码 RoPE。论文给出两个动机:第一,纯 Transformer 的计算效率与扩展性更好;第二,AOSC 中缓存的说话人块不一定是连续时间序列,局部卷积可能跨“人工拼接的块边界”混合本不相邻的状态,而纯注意力骨干更适合这种缓存结构。参数量从 117M 降至 99M;

3.3 80 ms 编码、10 ms 输出:学习式子像素上采样

如果直接让 Transformer 在 10 ms 序列上运行,序列长度会增大 8 倍,注意力成本显著上升。论文的解决方案是在编码器之后添加一维子像素卷积:宽度为 3 的 Conv1D 将每个 H 维状态映射为 8H 个通道,再重排为 8 个连续的 H 维状态。

\(Z=\mathrm{Conv1D}_{k=3}(H_{80\mathrm{ms}}),\qquad Z\in\mathbb{R}^{T\times 8H}\) \(\mathrm{PixelShuffle}_{1D}:\mathbb{R}^{T\times 8H}\rightarrow\mathbb{R}^{8T\times H}\)

这样,重计算昂贵的编码器仍维持 80 ms 步长,输出头却能在 10 ms 分辨率下预测短说话轮次和精细边界。消融实验还表明,收益不仅来自评分时更细的时间网格:把 10 ms 预测下采样为 80 ms 后再评分,只损失约 0.61–0.67 DER;完全不使用上采样、直接以 80 ms 训练与预测,则损失约 2.03–2.27 DER。

3.4 到达顺序输出、AOSC 与 FIFO

模型的 8 个通道不是固定人物身份,而是按首次到达顺序编号:第一个出现的新声音进入 speaker_0,第二个进入 speaker_1,依次类推。该约束减少了每个音频块重新求解通道排列的需要。

  • AOSC:保存较早音频块中的说话人证据,并按到达顺序组织,负责长期身份一致性。
  • FIFO:保存当前块之前的最近帧,提供短期上下文。
  • Right context:当前块之后的一小段未来音频,有助于判断边界,但会增加输入缓冲延迟。
  • 缓存扩容:AOSC 容量由 188 帧增加到 264 帧,以支持 8 个说话人。
  • 可学习分隔:旧方案用平均静音嵌入分隔缓存中的说话人,新方案改为可学习嵌入。

模型默认输出形状为 [T, 8],每个值是相应说话人在该帧处于活动状态的概率。两个或更多通道可以同时为高概率,因此能够表示重叠语音。

\(P\in[0,1]^{T\times 8},\qquad P_{t,s}=P(\text{speaker }s\text{ active at frame }t\mid x)\)

四、训练数据:规模、来源与处理

4.1 总体规模

数据类别规模说明
人工标注真实录音约 5,000 小时多领域、多语言真实会话
伪标签真实录音约 5,000 小时YODAS-v2 多说话人子集
真实会话合计约 10,000 小时论文与模型卡一致
模拟多说话人混合82,611 小时(论文约写 82,600)1–8 人,每条 180–200 秒
用于生成模拟混合的单说话人源音频约 28,000 小时模型卡披露的原始源音频规模
NEST 自监督初始化900,000 小时Granary-v2 子集,用于预训练编码器初始化,不是日志监督数据

4.2 真实会话数据

公开语料包括 AISHELL-4、AliMeeting、AMI、CALLHOME Part 1、DIHARD III Development、DiPCo、DISPLACE-2024、DISPLACE-M、Fisher English、ICSI、NOTSOFAR-1 和 VoxConverse-v0.3。模型卡进一步明确了主要 split,例如 Fisher Training Part 1/2、AMI train/dev、AISHELL-4 train、AliMeeting train、NOTSOFAR-1 train/dev 等。

  • David AI:约 1,000 小时、3–4 名说话人的英文会话,授权使用。
  • YODAS-v2:5,000 小时多说话人子集;由 9 个 Sortformer 组成的集成系统生成伪标签,再用 DOVER-Lap 合并重叠感知的日志输出。
  • 语言范围:公开与授权数据覆盖英语、普通话、印地语、卡纳达语、泰卢固语、孟加拉语及其他多语言来源。

4.3 模拟混合数据与后处理

模拟数据使用 FastMSS 工具和论文所称的 “Mind the Gap” 协议生成。每条混合包含 1–8 名说话人,时长 180–200 秒。关键不是简单叠加音频,而是要控制说话轮次、停顿、重叠和声学增强,使合成会话更接近真实交互。

混合来源生成后的多说话人小时数
LibriSpeech6,694
AMI 头戴麦克风6,743
AliMeeting 头戴麦克风6,745
Fisher English6,755
David AI 英语36,458
David AI 多语言(21 种语言)19,216
合计82,611

David AI 英语模拟源来自约 22,000 小时授权音频;多语言模拟源来自约 2,000 小时、21 种语言的授权音频。模拟前使用 Montreal Forced Aligner 获得紧致的说话人活动区域,避免把转写片段内部的大段静音错误标成语音。模型卡还列出 MUSAN 噪声作为增强来源。

五、训练目标:PIL、ATS、Activity Loss 与 Phantom Loss

PIL 使用最佳目标说话人排列进行监督;ATS 则把目标通道按说话人首次出现时间排序。Nemotron 3 在这两个标准 Sortformer 目标之外增加两项辅助损失。

5.1 Activity Loss

一个独立辅助头从编码器表示预测三类无排列帧状态:静音、单说话人语音、重叠语音。该任务不需要知道具体是哪位说话人,因此能以更稳定的方式监督总体语音活动,并作为正则项改善主任务。

\(\mathcal{L}_{\mathrm{act}}=-\frac{1}{BT}\sum_{b=1}^{B}\sum_{t=1}^{T}\log q_{bt,c_{bt}},\qquad c_{bt}\in\{\text{silence},\text{single},\text{overlap}\}\)

5.2 Phantom Loss

当实际录音只有少数说话人时,8 个输出通道中的空通道可能出现高置信激活,形成“幽灵说话人”。对 PIL 与 ATS 对齐后都为空的通道,论文选出后验概率高于阈值的有效帧:

\(\mathcal{I}_{bs}=\{t:\operatorname{sg}(p_{bts})>\theta\}\)

其中 sg 表示 stop-gradient。每个被选中帧的非活动标签负对数似然为:

\(\ell_{bts}=-\log(1-p_{bts})\)

最终使用归一化 log-mean-exp 聚合:

\(\mathcal{L}_{\mathrm{ph}}=\frac{\tau}{BS}\sum_{b=1}^{B}\sum_{s=1}^{S}\log\left[\frac{1}{|\mathcal{I}_{bs}|}\sum_{t\in\mathcal{I}_{bs}}\exp\left(\frac{\ell_{bts}}{\tau}\right)\right]\)

论文设置 \(\theta=0.25\)、\(\tau=0.5\)、\(S=8\);若集合为空,该项贡献为 0。log-mean-exp 会更关注最大的错误激活,但不会让损失直接随选中帧数线性增长。

总目标可以按阶段写成加权和:

\(\mathcal{L}=\lambda_{\mathrm{PIL}}\mathcal{L}_{\mathrm{PIL}}+\lambda_{\mathrm{ATS}}\mathcal{L}_{\mathrm{ATS}}+\lambda_{\mathrm{act}}\mathcal{L}_{\mathrm{act}}+\lambda_{\mathrm{ph}}\mathcal{L}_{\mathrm{ph}}\)

六、两阶段训练流程

训练使用 NVIDIA NeMo Speech,在 64 张 NVIDIA A100-SXM4-80GB GPU 上完成,即 8 个节点、每节点 8 卡。精度模式为 bf16-mixed。

6.1 阶段一:离线 Sortformer 训练

  • 只使用模拟多说话人混合。
  • 编码器由 NEST Transformer 自监督检查点初始化;该检查点在 Granary-v2 的 900,000 小时子集上预训练。
  • 从完整录音中在线随机抽取 60 秒片段。
  • 损失权重:PIL=0.5、ATS=0.5、activity=0.5、phantom=0。
  • 此阶段保持原生 80 ms 输出,不使用上采样层。

6.2 阶段二:流式 AOSC 微调

  • 启用 AOSC,联合使用真实数据和模拟数据。
  • 训练样本长度为 105 秒。
  • 以 0.5 概率把同一源录音不同位置的两个片段拼接,以制造更复杂的长程说话人重新出现模式。
  • 采样偏向包含更多活跃说话人的样本。
  • 损失权重:PIL=0.75、ATS=0.25、activity=0.5、phantom=0.1。
  • 在此阶段加入上采样层,初始化为把每个编码器状态重复到 8 个输出位置,再与全模型联合训练 10 ms 目标。

6.3 Block-Causal Tail:让一个检查点覆盖多种延迟

为了防止模型在训练时过度依赖未来上下文,每个 batch 以 0.5 概率使用 block-causal tail。注意力掩码由双向前缀和随机尾部组成;尾部被切分为 1–8 帧的小块。块内双向注意,当前块可以看前缀和更早块,但不能看未来块。全上下文 batch 与这组可变掩码共同训练,使同一检查点能够适配离线和多种流式上下文长度。

6.4 SpecAugment

两个阶段都使用 SpecAugment:两条频率掩码,每条最多覆盖 24 个频率 bin。论文公开了 NeMo 的离线 8 说话人与流式 8 说话人 YAML 配置,可用于复现实验中的详细优化参数。

七、流式推理配置与延迟公式

所有流式参数都以 80 ms 编码器帧为单位。输入缓冲延迟只统计模型运行前必须等待的音频,不包含 GPU 计算、网络、ASR 和业务处理:

\(\mathrm{Latency}_{\mathrm{buffer}}=(\mathrm{CHUNK\_LEN}+\mathrm{RIGHT\_CONTEXT})\times 80\ \mathrm{ms}\)
配置输入缓冲延迟SPKCACHEFIFOCHUNKRIGHT CONTEXTUPDATE PERIOD
离线式30.4 s2644034040300
低延迟1.04 s26426494222
很低延迟0.64 s26426462222
超低延迟0.32 s26426431222

模型技术上可使用 80 ms 输入缓冲,但官方建议的最低配置是 0.32 秒。降低延迟通常会同时降低准确率和吞吐,因此产品选型不能只看缓冲长度。

八、评测数据、指标与可比性

评测集录音数说话人数条件边界容忍
DIHARD III Eval2591–911 个领域、多语言0 s
CALLHOME Part 22502–6电话语音、多语言0.25 s
AliMeeting Near/Far20 个会议、两种条件2–4近讲混合头戴麦、远场0 s
AMI MHM/SDM16 个会议、两种条件3–4混合头戴麦、单远场麦0 s
NOTSOFAR-1 MHM/SC160 个会议、两种条件3–7多麦混合、单通道0 s

合计为 901 个“条件特定”的录音条目。所有测试都计入重叠语音。AMI、AliMeeting 和 NOTSOFAR-1 使用强制对齐参考标签,而不是原始为转写设计的片段级标签。原因是原始片段可能把内部静音也标成语音,从而在帧级 DER 中夸大漏检。不同参考 RTTM、collar 和 overlap 设置会改变 DER,不能把不同协议下的数字直接比较。

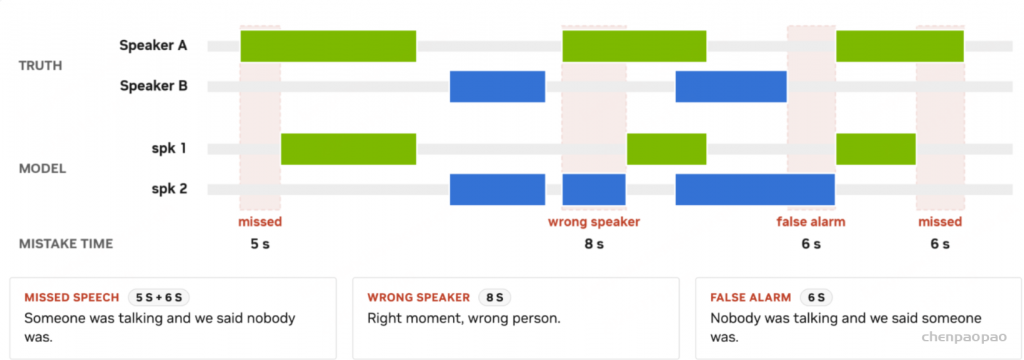
DER 由漏检、误报和说话人混淆组成:

\(\mathrm{DER}=\frac{T_{\mathrm{Miss}}+T_{\mathrm{FA}}+T_{\mathrm{Conf}}}{T_{\mathrm{RefSpeaker}}}\)
DER 中 Miss、False Alarm、Speaker Confusion 的构成示意。

九、核心 DER 结果(论文 Table 1)

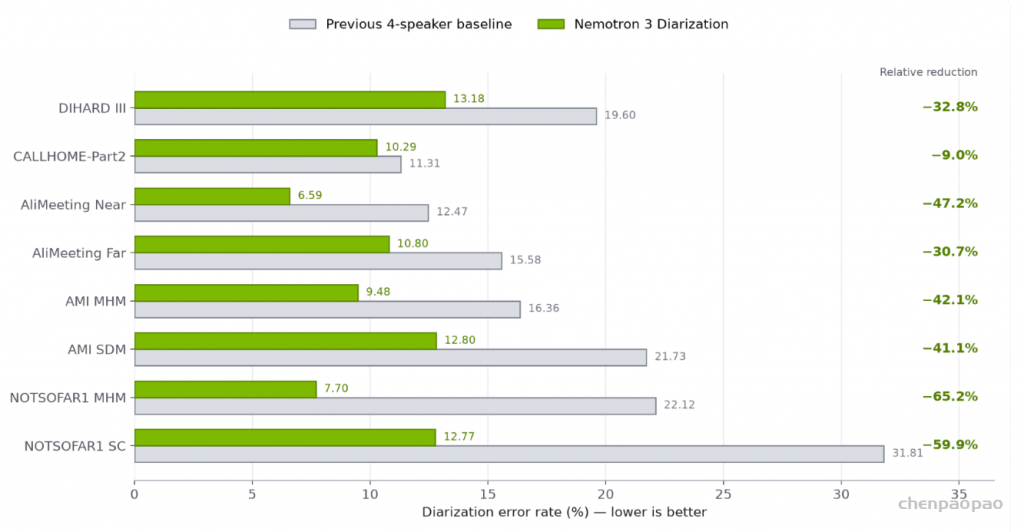
系统延迟DH3CHAli-NearAli-FarAMI-MHMAMI-SDMNSF1-MHMNSF1-SC
DiariZen离线14.5014.6816.7810.8*15.5613.9*14.2016.7*
Sortformer-v2.130.4 s19.0910.3211.5713.6915.8121.4221.7730.49
Nemotron 330.4 s12.739.106.4010.479.2511.146.7711.00
Sortformer-v2.11.04 s19.6011.3112.4715.5816.3621.7322.1231.81
Nemotron 31.04 s13.1810.296.5910.809.4812.807.7012.77
Sortformer-v2.10.32 s19.8512.6713.6816.8517.7723.8923.3732.95
Nemotron 30.32 s13.5511.327.1911.6010.0512.958.6514.53
* 使用原始/默认参考标注,而本文相应结果使用强制对齐标注,因此不能直接比较。

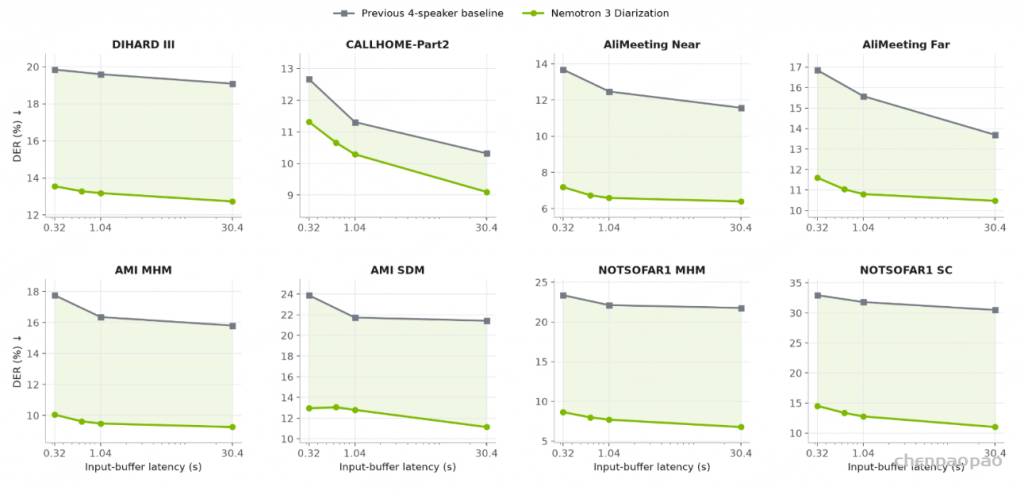
从 30.4 秒降到 0.32 秒,Nemotron 3 在各测试集上的 DER 只增加 0.79–3.53 个绝对百分点,表现出相对平滑的退化。所有三个共同延迟点上,它都在全部八种评测条件中优于 Sortformer-v2.1。论文据此正式宣称 DIHARD III 和 CALLHOME 达到新的 SOTA;对 AMI、AliMeeting、NOTSOFAR-1 则因参考标注协议不同而保持谨慎,没有做严格的跨论文 SOTA 声明。

图片占位

1.04 秒输入缓冲下八个条件的 DER 对比。
30.4、1.04、0.64、0.32 秒延迟下的完整 DER 曲线。
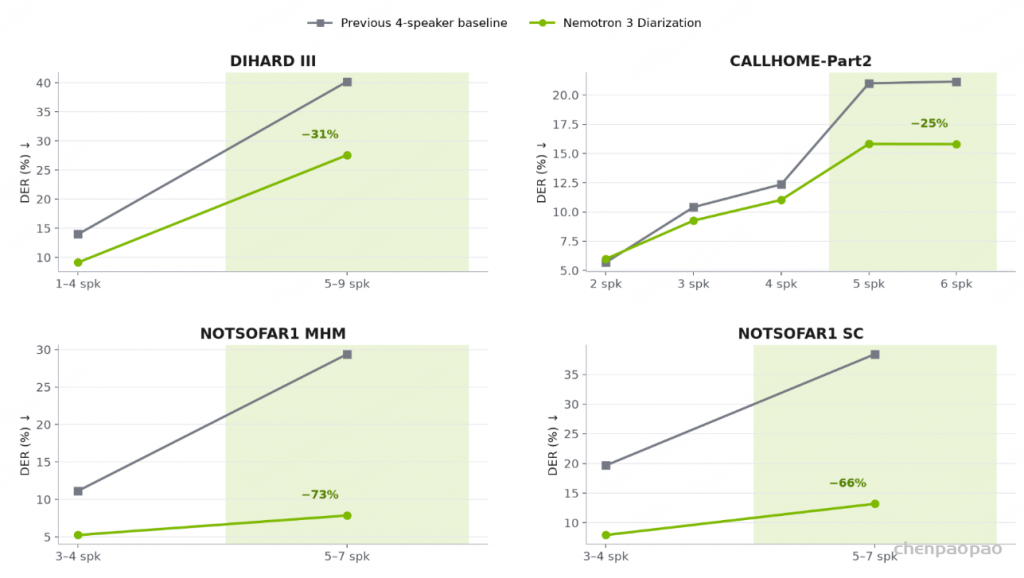
按说话人数拆分的 DER;阴影区域为超过 4 人的录音

十、训练与推理效率

训练侧,在 64 张 A100、bf16-mixed 下,纯 Transformer 相对相同设置的旧 FastConformer 编码器,显存消耗降低 2.8 倍、单步时间缩短 2.2 倍。

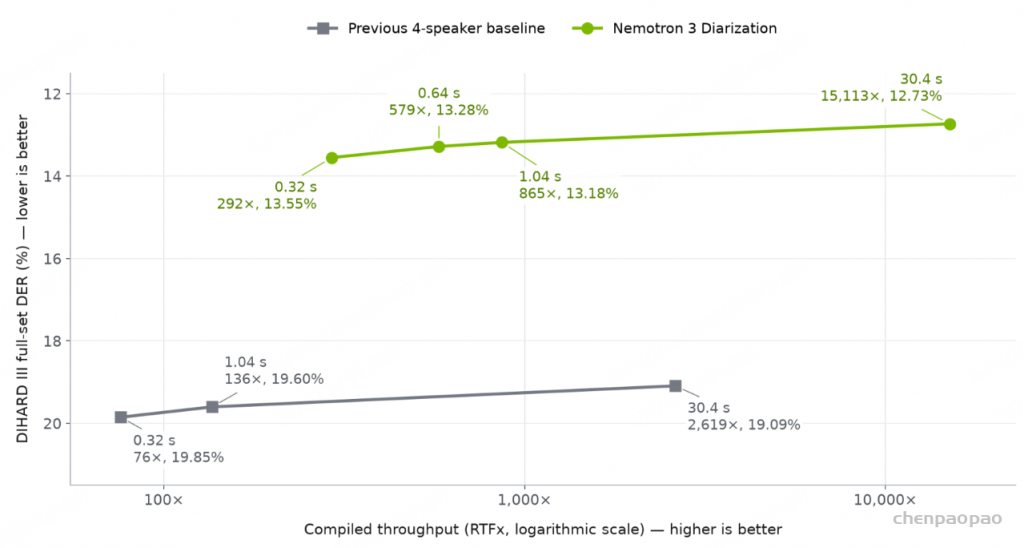
模型延迟Batch 1 eagerBatch 1 compiledBatch 32 eagerBatch 32 compiled
DiariZen离线20—44—
Sortformer-v2.130.4 s874146832042619
Nemotron 330.4 s134043851219615113
Sortformer-v2.11.04 s1642193136
Nemotron 31.04 s38164581865
Sortformer-v2.10.32 s82110176
Nemotron 30.32 s12.554199292
RTFx 越高越好。硬件为单张 NVIDIA RTX PRO 5000 Blackwell,BF16;compiled 使用 torch.compile,排除一次性编译和预热。

RTFx 定义为总音频时长除以总处理时间:

\(\mathrm{RTFx}=\frac{\text{total audio duration}}{\text{wall-clock processing time}}\)

30.4 秒、Batch 32 compiled 从 2619 提升到 15113,约 5.77 倍;1.04 秒从 136 提升到 865,约 6.36 倍。需要注意,这些是披露硬件上的批处理吞吐,不等于单路端到端应用延迟。

DIHARD III DER 与 Batch 32 compiled RTFx 的准确率—吞吐权衡。

十一、消融实验

系统变体30.4 s DER变化0.32 s DER变化
完整 Nemotron 310.42—12.06—
换回 FastConformer 编码器11.36+0.9413.33+1.27
无 NEST 初始化12.05+1.6314.28+2.22
10 ms 预测下采样到 80 ms 再评分11.09+0.6712.67+0.61
不使用上采样,原生 80 ms12.69+2.2714.09+2.03
无 phantom loss10.41-0.0112.15+0.09
无 activity loss11.42+1.0013.03+0.97
无 SpecAugment10.88+0.4612.47+0.41
无 block-causal tail10.50+0.0812.36+0.30
无模拟数据13.40+2.9815.21+3.15
无 David AI 数据11.19+0.7712.83+0.77
无 YODAS 数据10.81+0.3912.38+0.32
复合评测集,全局汇总、0 collar。每个消融只有一次训练运行,论文报告观察到的效应量,不声称统计显著性。

11.1 消融结论

  • 模拟数据最重要:移除后 DER 恶化 2.98/3.15,是最大退化,说明高质量合成会话对 EEND 至关重要。
  • NEST 初始化非常关键:无自监督初始化恶化 1.63/2.22,说明日志监督数据不足以从零学到同等稳健的声学表示。
  • 高分辨率训练不仅是评分优势:完全无上采样的退化远大于仅在评分前下采样,证明 10 ms 学习目标本身改善了模型。
  • Activity loss 稳定有效:两种延迟分别改善约 1.00 和 0.97 DER。
  • Phantom loss 的主收益不在 DER:移除后 DER 基本不变,但说话人数 MAE 从 0.157 升到 0.222(30.4 秒),从 0.270 升到 0.491(0.32 秒),说明它主要抑制过计数。
  • Block-causal tail 更利于极低延迟:30.4 秒只改善 0.08,但 0.32 秒改善 0.30。
  • 授权与伪标签数据都有增益:移除 David AI 在两种延迟都恶化 0.77;移除 YODAS 恶化 0.39/0.32。
  • 纯 Transformer 不只是更快:换回 FastConformer 后 DER 也明显恶化。

十二、下游多说话人 ASR

DER 高度依赖参考标注风格,因此论文进一步考察说话人日志是否真正改善带说话人归属的转写。指标使用 meeteval 的 tcpWER,默认 5 秒 collar 和 chime8 文本归一化。评测包括流式 Multitalker-Parakeet-v1(1.12 秒输入缓冲)与离线 DiCoW-v3.3-large。

ASR/日志条件AMI-MHMAMI-SDMNSF1-MHMNSF1-SC
流式 Multitalker-Parakeet-v1,1.12 s
Oracle 日志12.6617.7916.8626.34
Sortformer-v2.118.6434.1335.5951.35
Nemotron 3 hard13.8421.1818.6831.65
离线 DiCoW-v3.3-large,greedy
Oracle 日志11.7215.278.7815.45
DiariZen15.1719.3218.5725.63
Sortformer-v2.118.1730.1130.1442.56
Nemotron 3 hard12.6517.1910.4719.23
Nemotron 3 soft12.3517.0610.3018.95
此前 SOTA(09/2026)15.218.5N/A23.63

hard 表示分段级条件,soft 表示直接使用后验概率条件。Nemotron 3 的 soft 条件在四种条件下都进一步降低 tcpWER;论文称这是 DiCoW 中首次观察到一致的 soft-over-hard 增益。流式 Parakeet 结果同样显著优于旧 Sortformer,说明提升不仅是更贴合强制对齐标签,而是真正传递到了下游转写。

十三、限制、风险与正确解读

  • 最多 8 人:超过上限时,语音可能漏检或被错误合并到已有通道。DIHARD III 的 5–9 人分组甚至包含 9 人录音,已超出标称上限。
  • 匿名标签不是身份识别:speaker_2 不等于某个真实姓名。若要映射到身份,必须结合会议元数据、用户配置或说话人验证系统。
  • DER 协议敏感:参考 RTTM、collar、是否计重叠、VAD 来源都会改变结果。
  • 低延迟有代价:0.32 秒相较 30.4 秒存在稳定的准确率与吞吐下降;80 ms 虽可运行,但不是推荐配置。
  • 领域偏移:强噪声、混响、远场、极长会话和新领域会增加漏检、误报、混淆和边界错误。
  • ASR 对齐不是说话人分离:简单用单词中点匹配活跃说话人,遇到重叠时只能标为歧义,不能判断某个词究竟由哪位同时发言者说出。
  • 消融的统计限制:每个变体只有一次训练运行,小于约 0.1–0.3 的差异应谨慎解读。
  • 许可证与合规:权重使用 OpenMDW-1.1;生产系统仍需对目标数据、隐私、偏差、安全和行业要求进行完整验证。

十四、总结

Nemotron 3 Diarization 的技术路线非常清晰:通过纯 Transformer 和 80 ms 编码降低主干成本,用学习式上采样恢复 10 ms 边界精度;通过更大的 AOSC 和到达顺序监督扩展到 8 人;通过 activity loss、phantom loss、可变上下文掩码和大规模合成/伪标签数据,解决低延迟、多通道空置和真实监督不足的问题。最终,它同时改善了 DER、说话人数估计、下游 tcpWER、训练显存和推理吞吐,是一项较完整的“模型—数据—训练—系统”协同优化工作。

如果应用场景是会议、客服、播客、实时字幕或多说话人语音助手,这个模型尤其值得关注;但上线时应以目标音频重新评测,并把 0.32–30.4 秒的延迟配置视为产品级准确率—响应速度—吞吐三者之间的可调旋钮。

YODAS v3 论文拆解:110 万小时高带宽立体声多语言语料,如何从检索到训练落地

一、论文到底贡献了什么

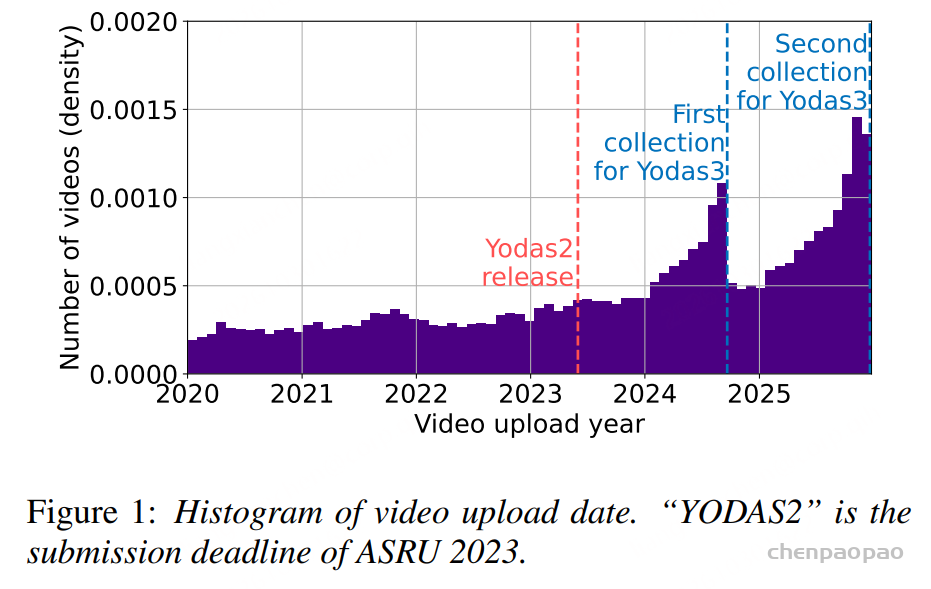
YODAS v3 的核心贡献不是提出一个新的 ASR 网络,而是提出一套面向大规模、多语言、宽带和立体声语音的数据构建方法,并用两个基线任务验证数据是否可用。论文将开源语音数据的瓶颈概括为三点:大量语料仍是 16 kHz 或 24 kHz 单声道;中低资源语言在通用网页检索中容易被高资源语言挤压;仅有音频时长而没有字幕、翻译和时间戳,难以直接用于监督训练。

二、和已有开源语音语料相比,YODAS v3 的位置

论文 Table 1 使用论文撰写时的统一口径比较规模、采样率、立体声、标注与许可证。下面完整保留该表的关键数字;“Stereo”表示数据集是否以立体声或多声道为主要发布形态,而不是说每一个文件都一定有两个互不相同的声道。

数据集语言数规模(小时)采样率立体声有标注许可证
Common Voice13733k48 kHz否是CC0
MLS851k16 kHz否是CC BY 4
FLEURS1021k16 kHz否是CC BY 2.5
VoxLingua1071077k16 kHz否是CC BY 4
LibriLight160k16 kHz否否CC BY 4
VoxPopuli23400k16 kHz否否CC0
Emilia6100k24 kHz否是CC BY-NC 4
Unsupervised People’s Speech89740k48 kHz是否CC BY-SA 4
YODAS v2140550k24 kHz否是CC BY 3
YODAS v31471100k48 kHz是弱标注CC BY 3
表 1:论文中的开源大规模语音数据集比较。

这里的“147 languages”需要谨慎理解。论文分析章节按 YouTube 上传者提供的 locale 统计,locale 是语言分布的代理字段,不是对每段音频进行人工或模型语音识别后的金标准语言标签。当前 Hugging Face 数据卡又提供了 transcript_lang 目录,因此会出现 103 个目录(102 个语言码加 unk)与论文 147 个 locale 代码并存的情况;二者是不同字段、不同统计问题,并不矛盾。

从 Table 1 看,v3 相比 v2 的名义时长约翻倍,并保留更高采样率与多声道;相比 Unsupervised People’s Speech,则额外提供可用于监督训练的字幕。但表中的“有标注”只表示存在标注机制,不能解释为全部音频都有人工标注。

三、数据采集流水线:从 Wikipedia 关键词到 Creative Commons 视频

3.1 关键词生成:解决“用英文搜全世界”的偏置

YODAS v2 复用共享的多语言 Wiki 关键词列表,容易出现两类错误:低资源语言没有足够查询词,以及查询词实际上是英语或其他语言。v3 改成“每种语言单独生成关键词”。作者下载每种语言的 Wikipedia dump,先按规则过滤候选词:不能只有数字或标点;首字符不能是数字或标点;长度限制为 3 至 30 个字符;排除文件名、DOI、Wikipedia Template 和 Request 页面。

接着,作者在每种语言的候选词上训练 unigram subword tokenizer。词表有预设大小;如果候选语料太小,便逐步减半词表直到 tokenizer 能够训练。对候选关键词分词后,用 unigram 语言模型概率排序,保留似然较高且不太罕见的词。论文没有公开固定的词表大小、最终 top-K 数量或每种语言的搜索预算,因此复现时应把这几个量视为需要自行设定的工程超参数。

\(\log P(w)=\sum_{i=1}^{m}\log p(s_i),\quad w=(s_1,s_2,\ldots,s_m)\)

上式是对论文步骤的工程化表达:将关键词 w 切成若干 subword 后累加 unigram 对数概率。它帮助筛掉模板词、极罕见实体和无法代表自然语言内容的条目,但不是论文单独编号的理论创新公式。

3.2 视频搜索:按语言分治,并使用两轮检索

3.3 下载与弱标注

下载时优先使用视频原始语言的人工字幕;没有人工字幕时使用 YouTube 自动字幕。如果存在非英语字幕,还保存英文字幕。每个字幕条目保留开始时间和持续时间,并与音频文件建立 ID 级关联。视频 description 也被保存,论文把它视为未来检索、摘要和多模态任务的潜在信号,而没有在本文实验中单独证明其收益。

v3 中人工字幕占比约 3.7%,低于 v2 的约 20%。作者推测 YouTube 自动字幕质量提升,降低了上传者制作人工字幕的必要性;论文没有提供人工转写对照集、字幕字符错误率或显著性检验,因此不能把“自动字幕质量提升”写成已验证的定量结论。

“3.7%”的分母在论文中没有进一步细分为视频数、句子数还是小时数,因此本文保留原文的占比表述,不据此推算人工字幕小时数。另外,原始视频音轨可以包含音乐、背景噪声和多个声源,110 万小时是抓取音轨时长,并非经过 VAD 验证后的纯语音时长。

阶段输入主要操作输出
关键词各语言 Wikipedia dump规则过滤、unigram tokenizer、似然排序每种语言的查询词
检索语言查询词、YouTubeCreative Commons、两轮搜索、优先新上传、去除 v2 ID候选视频 ID
字幕人工字幕或自动字幕优先原语言,补充英文字幕,保存时间戳弱监督 transcript/translation
音频最高质量视频流下载 48 kHz 多声道 Opus/WebM原始宽带音频
分析音频和字幕元数据语言、时长、带宽、声道、质量过滤数据卡和实验子集
YODAS v3 采集流程的工程化摘要。
论文 Table 2 元数据示例或含义
Channels / Effective channels容器声道数与去除重复后的有效声道数,例:2 / 2
Sampling rate / Max bandwidth解码采样率与最高有效频率,例:48 kHz / 20 kHz
Views / Language观看次数、语言代理标签,例:67 / French
Transcript / Translation原语言字幕与英文翻译
Description视频描述,可为检索或摘要提供上下文
表 2:论文给出的元数据示例。其字段集合不等于当前 Parquet 的完整 schema。

四、数据组成与 Hugging Face 发布结构

数据卡中的 id 是 32 位十六进制字符串,shard 是四位编号。音频文件、JSON 和 Parquet 行应通过同一 id 与 shard 关联,不要假设 tar 内文件顺序与 Parquet 行号一致。transcript 字段通常是 JSON 字符串或 null;解析后可得到 segment 的 start/duration,以及相对于 segment 起点的 word 时间偏移。音频 length 以秒计,字幕时间戳以毫秒记录。

当前默认 preview 配置只是预览集,不代表完整的一百多万小时。完整数据应按语言和 shard 流式处理。论文的下载流水线与 Hugging Face 的打包流水线也不是一回事:前者解释数据如何被发现和筛选,后者解释已经发布的文件如何组织。

data/
  <lang>/
    audio/0000.tar
    audio/0001.tar
    metadata/0000.parquet
    metadata/0001.parquet
  unk/  # 没有字幕语言可用于分组的音频
当前数据卡字段单位 / 解释使用注意
id、shard样本标识、四位分片号以 ID 关联音频与元数据
transcriptJSON 字符串或 nullsegment 时间为毫秒,words.t 是相对 segment.start 的偏移
translation_en英文翻译 JSON 或 null只有句级时间戳;卡片报告约 107 万个视频有该字段
transcript_lang、locale_lang字幕轨语言、上传者 locale文件级字段不代表每一句都使用同一种语言
length秒卡片范围 1–153284,均值约 952;长视频宜分段解码
audio_bitratekbit/s容器码率约 3.6–569,中位数约 122;1461 个视频缺失
max_freq_hzHz,约 35–24000约 28.3 万条缺失,不能直接当作低带宽
estimated_bandwidth_hz等效采样率分档8000、16000、22050、24000、32000、44100 或 null
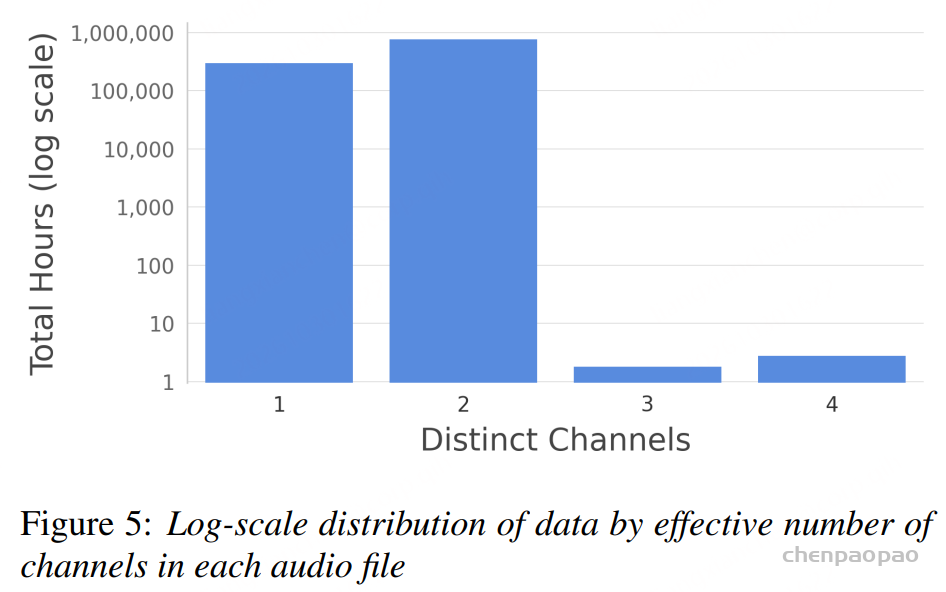
channels容器声道数1、2、4、6;约 99.8% 为 2
n_distinct_channels实测有效声道数1–5 或 null;581 条分析失败,不能当作单声道
当前 Hugging Face 数据卡的发布字段与统计,不是论文 Table 2 的逐列复制。

75%、60%、95% 分别针对是否有字幕、非英语数据是否有翻译、已有字幕是否包含词时间戳,条件集合不同。尤其不要将“60% 非英语数据有翻译”直接换算为“总量的 60% 都是可训练翻译对”。没有字幕的 unk 数据仍可用于无监督音频建模;带字幕的数据也需要检查原语言与翻译是否覆盖同一时间段。

五、规模与音频属性分析

5.1 语言分布:更均衡,但不是严格均衡

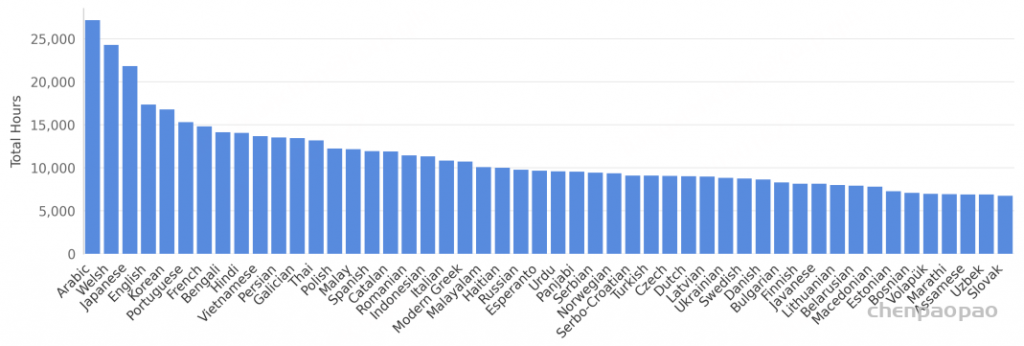
论文统计中,阿拉伯语和威尔士语约 2.5 万小时,日本语约 2.1 万小时,英语约 1.7 万小时且低于总量的 2%;共有 22 种语言超过 1 万小时、73 种语言超过 5000 小时。平均数约 7400 小时而中位数约 5180 小时,说明分布仍然长尾,只是比单纯依靠全球热门查询词更平衡。

5.2 视频时长与有效样本量

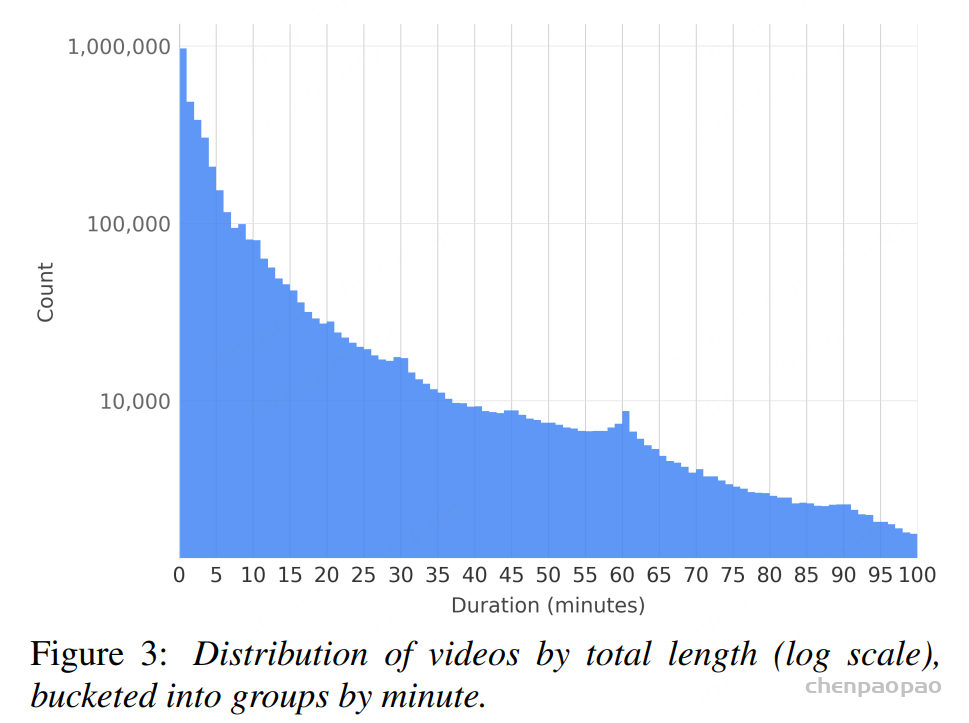
约 400 万个视频中,超过 24% 的视频短于 1 分钟,作者将其与 Shorts 生态联系起来。约 170 万个视频长于 5 分钟,总时长约 100 万小时;约 120 万个视频长于 10 分钟,总时长约 95 万小时。后两个集合是嵌套关系,不能相加。同时数据呈明显长尾分布。约有 400 万个视频(占 24%)少于 1 分钟,作者认为这可能和 YouTube Shorts 的流行有关。论文还指出存在大量超过 60 分钟的直播类视频,但没有给出一个可直接复核的精确小时数。

这组统计提醒我们:总小时数很大,并不意味着每个训练样本都长、都干净或都包含完整对话。做 ASR 时需要按 utterance 切片;做编解码器或空间音频任务时,可能需要重新设计长音频采样和直播片段去重策略。

5.3 48 kHz 不等于每个文件都包含完整 24 kHz 频谱

Opus 解码后可以得到 48 kHz PCM,但上传者的麦克风、混音和编码模式可能只保留较窄频带。论文用 8192 点 Hann 窗、50% 重叠的 STFT 估计最高有效频率:跳过 RMS 不超过 10^-6 的静音帧,找出幅度超过该帧最大幅度 0.5% 的最高频率,再在短视频全程或长视频随机抽取的五个 60 秒片段中取最大值。

\(X_{t,k}=\sum_{n=0}^{N-1}x[n+tH]w[n]e^{-j2\pi kn/N},\quad N=8192,\;H=4096\) \(f_{\mathrm{max}}=\max_{t,k}\{f_k:\lvert X_{t,k}\rvert>0.005\cdot\max_j\lvert X_{t,j}\rvert\}\)

作者把 fmax 映射到候选等效采样率集合 {8, 16, 22.05, 24, 32, 44.1 kHz},选择满足 Nyquist 条件的最小采样率。这里的“44.1 kHz 类”是等效采样率类别,不是说频谱真的延伸到 44.1 kHz;48 kHz PCM 的 Nyquist 频率约为 24 kHz。

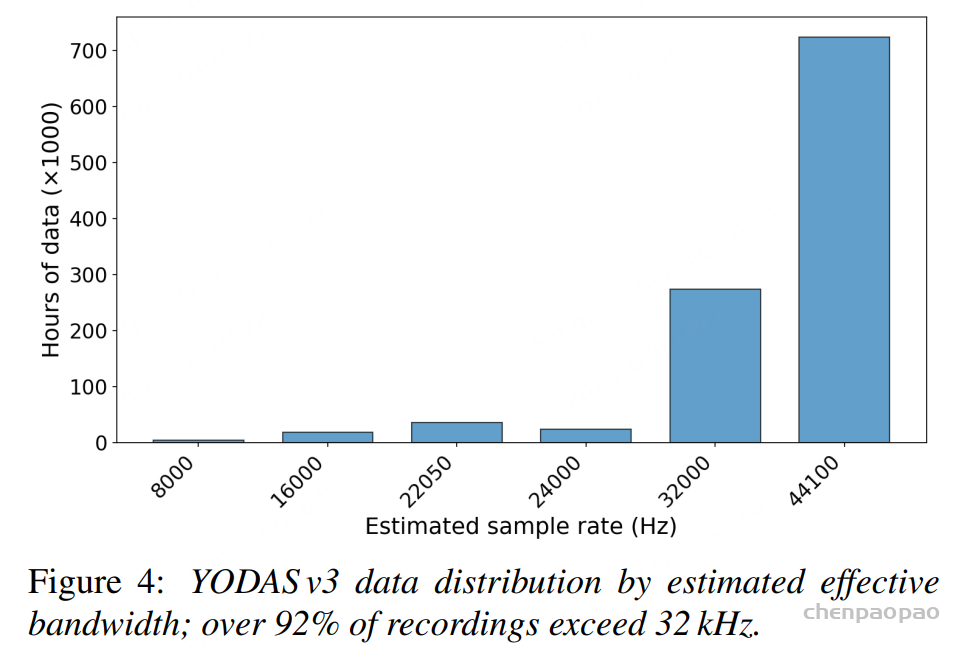
结果是:约 67.3% 的数据属于 44.1 kHz 等效带宽类别,论文报告约 92.5% 的数据达到 32 kHz 及以上类别。Figure 4 建议放在本节。这个指标是“检测到的最高频率”而不是对每个片段的主观听感或音乐保真度承诺,噪声、响度和编码伪影都会影响阈值结果。

5.4 多声道与有效声道数

对每个音频文件,论文计算每一对声道的残差 RMS,并用两声道平均 RMS 归一化。若归一化残差低于 10^-3,则将两声道视为有效相同。

\(d_{ij}=\frac{\mathrm{RMS}(x_i-x_j)}{(\mathrm{RMS}(x_i)+\mathrm{RMS}(x_j))/2}\)

超过 71% 的音频文件、约 78 万小时,被判定为真正的多声道;绝大多数是双声道,少量 3 至 4 个有效声道主要来自 5.1 等容器。数据卡还报告约 25% 的视频属于双声道封装但有效单声道的 dual-mono,不能把“容器有两个声道”直接等同于“有空间差异”。不同声道也可能来自音乐混音或编辑后的左右声道,而不是规范的麦克风阵列几何。

六、实验一:ASR 的过滤阈值实验

6.1 实验设置

论文没有训练一个百万小时级的新型语音基础模型,而是使用 OWSM v4 base(约 102M 参数)和 ESPnet,训练 40k steps,验证数据能否支撑多语言 ASR。随机抽取 7 种语言:英语约 4500 小时,德语、法语、日语、葡萄牙语、俄语、越南语各约 100 小时。处理流程固定包含 CTC segmentation 和语言过滤,然后对 CTC 置信分数做分位数过滤。阈值 0.00 表示不做 CTC 分数过滤,但仍然做前面的分段与语言过滤。

Common Voice 作为七种语言的测试集;英语、德语、法语、葡萄牙语、俄语和越南语使用 WER,日语使用 CER。

\(\mathrm{WER}=\frac{S+D+I}{N}\times 100\%,\qquad\mathrm{CER}=\frac{S_c+D_c+I_c}{N_c}\times 100\%\)

这里补充标准指标定义,方便理解表格:S、D、I 分别是替换、删除和插入数,N 是参考词数;CER 改为字符级计数。这不是论文提出的新指标。由于词与字符粒度不同,不能直接拿日语的 27.7 和英语的 15.9 排名判断哪种语言更难。

CTC 分数分位阈值英 WER德 WER法 WER日 CER葡 WER俄 WER越 WER
0.0015.914.417.227.711.115.320.6
0.1015.314.617.829.211.515.421.1
0.2015.315.418.830.912.216.020.8
0.3015.616.321.834.513.416.723.1
表 3:不同 CTC 过滤阈值下的 ASR 结果,数值越低越好。

6.2 如何理解这项“消融”

阈值是 CTC 分数的分位位置,不是一个可以跨模型、跨语言直接比较的绝对置信度分数。将阈值从 0.10 改成 0.30 表示提高分数筛选的严格程度;若要在自己的数据上复现,还需要明确是在每种语言内部还是整个集合上统计分位数,以及 CTC 分数是否做长度归一化。论文正文没有展开这些实现细节。

这是一项围绕数据过滤强度的质量—数量实验,不是模型结构消融。随着阈值从 0.00 提高到 0.30,低分片段被删除得更多,训练数据量下降。六个非英语语言的最佳结果都出现在 0.00;英语在 0.10 和 0.20 达到 15.3,差异很小;越南语在 0.10 到 0.20 还有轻微回落,因此不能把曲线概括成“阈值越低每一种语言必然越好”。

论文将这一点与 YODAS v2 的经验对照:v2 需要较强过滤才能避免超过 100 的 WER,而 v3 即使不做 CTC 分数过滤也能取得可用结果。作者推测原因包括 YouTube 自动字幕质量提高,但没有人工转写金标准、随机种子重复或严格相同数据量控制,因此应把结论写成“观察到的过滤趋势”,而不是普适的最优阈值。

具体看数值,从阈值 0.30 放宽到 0.00,法语 WER 从 21.8 降至 17.2,改善 4.6 个百分点;日语 CER 从 34.5 降至 27.7,改善 6.8 个百分点。这个收益对应“保留更多样本与改变样本质量分布”的联合变化。论文没有报告每个阈值最终保留多少小时,所以无法进一步区分收益究竟来自新增时长、困难样本覆盖还是字幕错误分布。

七、实验二:神经音频编解码器

7.1 设置和基线

作者从 YODAS v3 随机抽取 1200 小时,分别以 16、24 和 48 kHz 训练 DAC 架构,使用 ESPnet-Codec 的官方配置。对照数据为 LibriTTS(585 小时、英语朗读)和 AMUSE(约 33k 小时、包含多语言语音、音乐和声音)。VERSA 工具包在 1000 个视频上做域内测试,并在 LibriTTS 上做域外测试,指标为 STOI 和 WavLM speaker similarity,二者均为越高越好。论文没有声称这是立体声 codec 的专门结构实验,也没有给出比特率、token 帧率和全部模型超参数。

训练数据采样率LibriTTS STOILibriTTS SPKYODAS v3 STOIYODAS v3 SPK
LibriTTS16 kHz0.950.760.740.69
LibriTTS24 kHz0.970.830.800.78
AMUSE16 kHz0.930.740.810.83
AMUSE44 kHz0.950.820.900.77
YODAS v316 kHz0.920.600.820.79
YODAS v324 kHz0.920.660.840.82
YODAS v348 kHz0.970.840.940.90
表 4:Codec 结果。论文表头写作 44 kHz,保留原表口径。

7.2 结果解读

YODAS v3 48 kHz 模型在 LibriTTS 域外测试上达到 STOI 0.97、SPK 0.84,在 YODAS v3 域内测试上达到 STOI 0.94、SPK 0.90。LibriTTS STOI 的 0.97 与 YODAS v3 48 kHz 并列最高,不应写成严格超过;但 YODAS v3 在说话人相似度上取得最高的两个数值。另一方面,较低采样率的 YODAS 模型并不是所有指标都优于基线:例如域外 STOI 仍受训练域、采样率和声音组成影响。

对所有行而言,YODAS 测试集的 STOI 低于 LibriTTS 测试集,符合嘈杂网页音频更难重建的直觉;但 SPK 并不都呈现相同趋势,因此不把“域内更难”推广为每一种指标必然下降。

这个实验支持“宽带、多样化数据有利于 48 kHz codec”的方向性结论,但不能推出所有高采样率任务都会提升,也不能把 STOI 和说话人相似度替代完整的空间听感评测。AMUSE 的数据量约为 33k 小时,远大于 YODAS 实验抽取的 1200 小时,因此表格同时混合了数据量、领域组成和采样率变量,不能单独解释为纯粹的规模定律。

八、结论:YODAS v3 真正解决的是数据形态问题

YODAS v3 的价值不只是把小时数做大,而是把开放语音数据从“单声道、窄带、单一字幕”推进到“宽带、多声道、带时间戳和翻译的弱监督样本”。

YODAS v3 发布了一个规模超过 110 万小时、覆盖 147 种语言的高带宽立体声语音数据集。核心特点可以概括成四点:

  • 第一,规模大。 达到百万小时级,是目前最大的开放语音数据集之一。
  • 第二,语言更均衡。 22 种语言超过 1 万小时,73 种语言超过 5000 小时,英语占比不到 2%。
  • 第三,真正的高带宽和多通道。 92.5% 数据有效带宽超过 32kHz,71% 以上是真正不同的多通道音频。
  • 第四,可以同时支持识别和生成任务。 ASR 实验说明自动转写质量已经比较高;Codec 实验也验证了 48kHz 高带宽数据对于高保真音频建模的价值。

YODAS v3 不只是把开放语音数据堆到 110 万小时,而是第一次把“百万小时、多语言、高带宽、真实立体声”这几个维度真正组合到了一起。

这也使它不再只是一个 ASR 数据集,而是可以进一步服务于 TTS、Audio Codec、语音增强、空间语音等下一代语音模型训练的大规模数据基础。

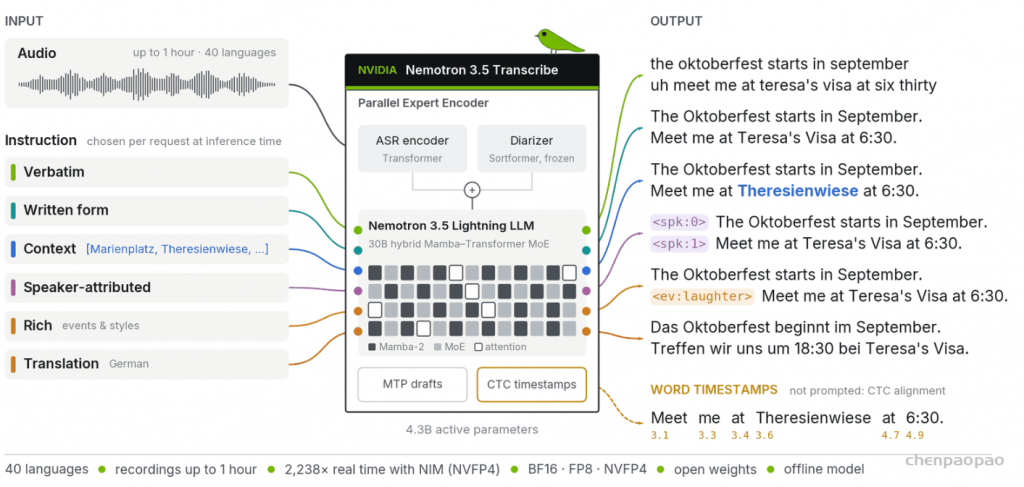
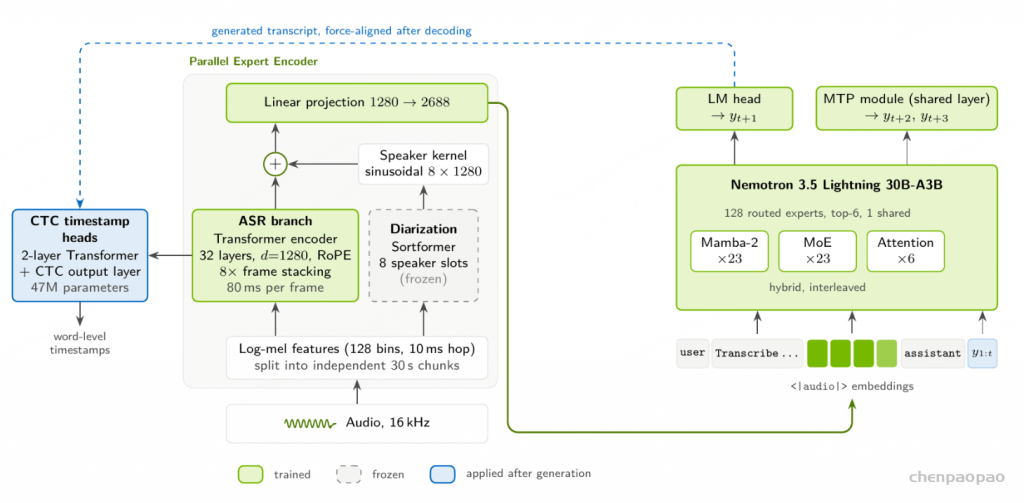
Nemotron 3.5 Transcribe 深度拆解:Cache-Aware FastConformer-RNNT 与 Granary v2 语音数据工厂

\(P(y_{1:T}\mid x)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x)\)

一、核心结论

  • Nemotron 3.5 ASR Streaming 是约 0.6B 参数的多语言流式 ASR。
  • 核心架构是 24 层 Cache-Aware FastConformer 编码器、RNN-T 解码器和语言 ID Prompt Conditioning。
  • 声学表示维度为 1024,语言向量为 128 维;一个 checkpoint 支持 40 个 language locale。
  • 运行时支持 80 ms、160 ms、320 ms、560 ms、1.12 s 五个 chunk 配置。
  • FLEURS 上,Transcription-ready 19 个 locale 的平均 LangID WER 从 80 ms 的 10.38% 降到 1.12 s 的 8.84%;Auto-detect 从 11.14% 降到 9.21%。
  • 单张 H100 上,80 ms 时约支持 240 路并发流,Parakeet RNNT 1.1B buffered streaming 约 14 路;1.12 s 时约为 2,400 路对 400 路。

设计目标不是只追求离线 WER,而是在准确率、端到端延迟、显存和并发之间提供可调的 Pareto 点。

二、模型架构

2.1 Cache-Aware FastConformer

FastConformer 结合卷积对局部声学模式的建模能力和注意力对长程依赖的建模能力。Nemotron 3.5 使用 24 层 Cache-Aware FastConformer。缓存同时覆盖 self-attention 和 convolution 状态,因此当前 chunk 可以复用上一 chunk 的隐藏状态。

设第 k 个音频块为 x_k,上一步缓存为 C_(k-1):

\((H_k, C_k) = Encoder(x_k, C_(k-1))\)

传统 buffered streaming 会把上一段上下文与当前音频重新拼接,导致重叠帧重复计算;Cache-Aware 方案只计算新到达的帧,缓存负责保留上下文。

2.2 语言 ID Prompt Conditioning

编码器输出 H_a 的形状是 (1024,T)。语言 ID 被编码为 128 维向量 e_lang,沿时间轴广播为 H_l,二者拼接后经过投影层送入 RNNT:

\(H_a = FastConformer(x_1:T), H_a in R^(1024 x T)\) \(H_l = Broadcast(e_lang,T), e_lang in R^128\) \(H_f = Proj([H_a;H_l]), [H_a;H_l] in R^(1152 x T)\)

已知语言时可以输入 en-US、de-DE、zh-CN 等 locale;未知语言时使用 auto 模式。语言向量是每个时间帧都可见的条件信号,而不是附加在最终文本后的标签。

2.3 RNN-T

RNN-T 用 prediction network 建模已输出的 token 历史,用 joint network 融合声学状态与标签状态:

\(z_(t,u) = f_joint(h_t,g_u), P(y_(t,u)|x,y_<u) = softmax(z_(t,u))\)

它能在音频流持续到达时逐步发射 token,比必须等待整段音频的离线 encoder-decoder 更适合实时语音代理。

三、创新点

  • 缓存级流式计算,减少 buffered streaming 的重叠重算。
  • 语言提示让一个共享 checkpoint 覆盖多语言 locale。
  • chunk size 可在推理时切换,不需要重新训练。
  • 原生支持 punctuation 和 capitalization。
  • 0.6B 参数配合缓存式推理,在 H100 上获得高并发。

四、训练数据:规模、来源与标签

官方模型卡给出的训练数据范围是 10,000 到 1,000,000 小时,覆盖 40 个 language locale。来源包括 NVIDIA Riva multilingual ASR training set(专有)、NVIDIA Granary、Multilingual LibriSpeech、Mozilla Common Voice、FLEURS、VoxPopuli 和 Europarl-ASR。

训练标签包括人工标签和合成标签。合成 ASR 标签来自 Canary、Parakeet Multilingual 1.1B RNNT、Parakeet CTC 1.1B、Whisper large-v3 与 FunASR 的模型集成;标点和大小写由 Qwen3-32B 生成:

\(y_hat_i = Consensus(Canary(x_i), Parakeet(x_i), Whisper(x_i), FunASR(x_i))\) \(y_PnC_i = Qwen3-32B(y_hat_i, language_i)\)

Consensus 不能被擅自解释为简单多数投票,因为官方没有披露集成规则。工程上还应结合语言一致性、字符速率、重复检测、空输出和长度比过滤。

4.1 Granary 数量级

Granary 覆盖 25 种欧洲语言,聚合规模约 1M 小时;ASR 侧约 643,238 小时,AST 侧约 351,000 小时。

来源语言数过滤后小时数格式
YODAS-Granary23192,17216 kHz WAV
VoxPopuli24206,116FLAC
YouTube-Commons24122,475WAV
LibriLight英语约 23,500FLAC
ASR 合计25643,238混合格式

Granary 主要提供 NeMo JSONL manifest 和元数据,部分来源需要另行下载音频。典型字段包括 audio_filepath、text、source_lang、target_lang、original_source_id 和 dataset_source。

五、训练阶段

  • 阶段 A:收集和统一 manifest。保留路径、时长、采样率、语言、来源、许可证和原始 ID。
  • 阶段 B:切分、VAD、说话人和语言质检。检查时长、静音比例、字符速率、语言一致性、空文本和异常重复。
  • 阶段 C:多模型伪标注与 PnC。生成候选、做一致性筛选,再用 Qwen3-32B 统一标点和大小写。
  • 阶段 D:流式多语言 ASR 训练。使用 Cache-Aware FastConformer-RNNT、语言 ID 条件和混合多语言数据。
  • 阶段 E:多延迟点评测。以 80 ms 为基本帧,测试 80 ms、160 ms、320 ms、560 ms、1.12 s。
\(D_train = Filter(Normalize(D_public union D_private))\) \(theta* = argmin_theta E[-log P_theta(y | x, language)]\)

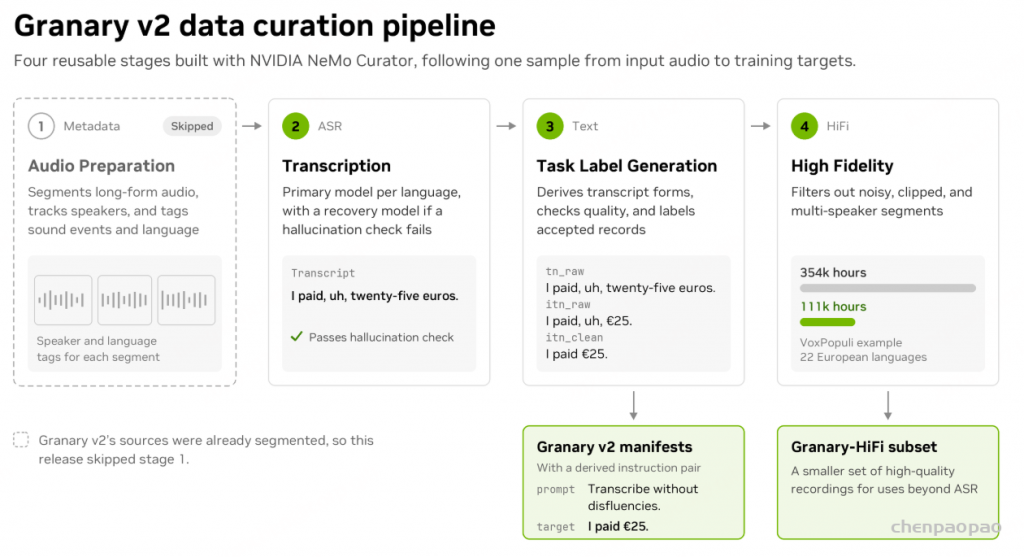
六、Granary v2 流水线

Granary v2 把原始录音加工成带元数据、可追溯、可继续处理的训练数据。官方教程包括 Metadata extraction、Indic ASR、Qwen Omni ASR 和 Text pipeline。

6.1 Metadata extraction

  • 读取 recording manifest,重采样到单声道 16 kHz WAV。
  • Sortformer 做说话人分离并输出 RTTM。
  • Silero TensorRT VAD 切分语音段。
  • CNN14 TensorRT 预测声音事件。
  • SpeechBrain、Indic Canary、Whisper 做多级语言识别。
  • 根据一致性选择 source_lang,保留拒绝原因。
  • 片段编码为 Opus,并写出 JSONL metadata。

没有语音的录音保留 vad_empty 审计行;语言意见不一致时保留 skip 标记和预测结果,避免把“无语音”和“文件缺失”混为一谈。

6.2 Indic ASR

Hindi 示例有 11 个阶段:读取 manifest;准备单声道 16 kHz 音频;Canary 主转写;主结果 hallucination 检查;Parakeet 恢复候选;恢复结果检查;选择最佳预测;正则清洗;缩写合并;计算 WER;写回 JSONL。两个 ASR 模型会对每个有效片段都运行。

示例限制 0.5 到 40 秒;最终字段包括 primary_model_prediction、fallback_model_prediction、best_prediction、cleaned_text、abbreviated_text 和 wer_pct。

6.3 Qwen Omni ASR 与 Text pipeline

Qwen3-Omni 生成主转写,已有 transcript 只作为回退文本,不发送给 Qwen。随后执行规则型 hallucination 检查、最佳预测选择、标点和空白清理、缩写合并。Text pipeline 不读取音频,负责实体恢复、PnC、语言识别与验证、逆文本规范化、captioning、code switching 和 speech QA。

6.4 Xenna 与 Ray Data 吞吐

管道基准数据XennaRay Data
Metadata30,631 录音 / 107.76357 小时472.309 audio-hours/hour166.251
Indic ASR216,164 Hindi 片段 / 531.75763 小时3,604.471387.649
Qwen Omni ASR22,710 英语片段 / 80.61259 小时406.615228.424
Text pipeline14,290 行 transcript30.283 rows/s12.217 rows/s

官方对比使用 8 张 H100 80 GB GPU、相同 cohort、镜像、模型和 stage 设置。音频管道吞吐包含模型启动时间;Text pipeline 复用了已启动的模型服务器。

七、实验对比:FLEURS 与流式延迟

分组模式80 ms160 ms320 ms560 ms1.12 s
Transcription-ready 19 localesLangID 平均 WER10.3810.009.499.128.84
Transcription-ready 19 localesAuto-detect 平均 WER11.1410.6710.059.639.21
Broad-coverage 13 localesLangID 平均 WER25.8625.1424.1123.0922.13
Broad-coverage 13 localesAuto-detect 平均 WER27.6226.6525.4124.4423.09

在 1.12 s、LangID 条件下,官方表中英语 WER 为 7.91%,西班牙语 4.11%,意大利语 4.25%,葡萄牙语 5.48%,Hindi 6.81%,德语 8.31%,法语 9.03%,俄语 9.17%,乌克兰语 13.07%。Hindi 在 80 ms 下 LangID 为 8.13%,Auto-detect 为 11.47%;1.12 s 下分别为 6.81% 和 8.23%。日语、韩语和普通话使用 CER。

chunk 增大通常带来更多右侧上下文,平均 WER 下降但等待时间上升:

\(WER(c_1) >= WER(c_2), c_1 < c_2\)

八、吞吐对比与系统意义

配置Nemotron 3.5 ASRParakeet RNNT 1.1B优势
80 ms约 240 路约 14 路约 17 倍
1.12 s约 2,400 路约 400 路约 6 倍

优势来自参数规模、缓存复用、chunk 粒度和 H100 推理实现的共同作用,而不是单纯参数更小:

\(Cost_per_stream proportional to GPU_hourly_cost / sustainable_concurrent_streams\)

WenetSpeech-Min:用于方言语音处理的大规模闽南语语音语料库及双重转写

  • paper: https://arxiv.org/abs/2609.36834
  • code: https://github.com/ASLP-lab/WenetSpeech-Min-Repo

WenetSpeech-Min 是一个开源的大规模闽南语语音语料库,来自不同的在线媒体来源。该语料库包含约 10,000 小时的真实语音数据。每一条语音记录都配有闽南语和普通话的转录文本,这使得系统能够同时实现保留方言特征的识别功能,以及输出清晰的普通话文本功能。

  • 在现实世界中,语音数据来自多个来源,涵盖了各种说话风格、应用场景以及声音条件。
  • 双重转录方式:闽南方言保留了当地的口语表达形式;而普通话则提供了与闽南方言相对应的书面表达形式。
  • 公开基准数据:包括人工验证的闽南语语音识别、普通话语音识别以及闽南语语音合成评估数据。

数据构建流程

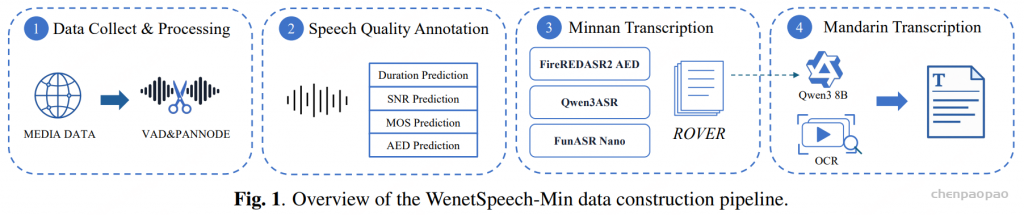
该流程由两个主要部分组成:音频处理和配对转写生成。第一部分对音频进行分段,并依据语音内容和声学质量对所得片段进行过滤。第二部分结合多个闽南语 ASR 系统获得方言转写,然后生成对应的普通话转写。

音频处理: 从各种在线媒体来源收集闽南语语音,VAD切分,计算信噪比(SNR)和时长,计算WV-MOS来描述片段的声学质量,预测AED (声学事件检测) , 估计片段包含语音的置信度,并移除低于预定义阈值的片段,最后使用 pyannote 估计每个保留片段中的说话人数;

文本标注工具:使用人工转写的闽南语语音构建专用标注模型,使用 1,600 小时带有人工核验闽南语转写的语音,对 Qwen3-ASR、FireRedASR2-AED 和 Fun-ASR-Nano进行微调,用于生成方言转写候选结果。对一个 600 小时的子集进行标注,并人工核验配对的闽南语和普通话转写,使用 LoRA 对 Qwen3-8B进行微调,从而得到专用的闽南语到普通话翻译模型,用于生成普通话转写。

配对转写生成:三个 ASR 标注模型产生互补的候选结果;随后使用ROVER 对这些结果进行对齐和组合。组合结果被保留为方言转写。普通话转写通过两条路径之一获得。对于带有内嵌字幕的媒体,用 OCR提取字幕文本,并直接使用归一化后的字幕文本。对于其他媒体,则由微调后的 Qwen3-8B 翻译模型将 ROVER 组合得到的方言转写转换为书面普通话。随后对候选转写进行归一化,并对每个音频—文本对执行一致性检查。对于分段不可靠或内容置信度较低的样本,会将其删除或退回修正。

Dataset

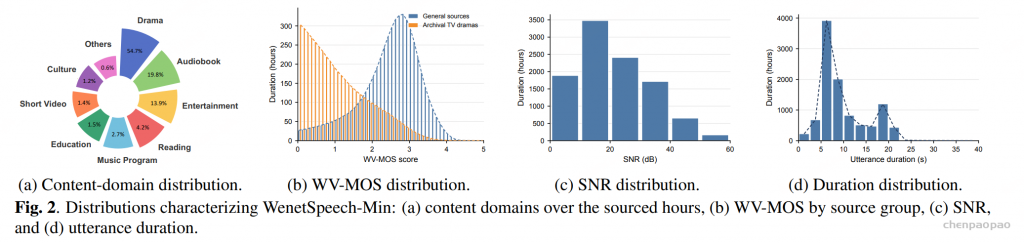
WenetSpeech-Min 涵盖了大约 10,000 小时的语音数据。平均语音持续时间为 7.24 秒;中位数则在 5 到 7.5 秒之间,语料库以短话语为主,同时包含少量更长的连续语音片段。其中,约 8,500 小时的语音数据来源于不同来源:戏剧类内容占 54.7%,有声书占 19.8%,而娱乐类内容占 13.9%。

该语料库特意包含了相对清晰的语音记录以及具有挑战性的档案式电视素材。这样可以保留自然的多语言交互场景、富有情感的表达方式,以及多种多样的真实录音环境。

SNR 分布分布主要集中在 10 至 40 dB 之间,占总时长的 73.8%。按时长加权的平均 SNR 为 21.3 dB,中位数落在 19–20 dB 区间,表明所发布的语料库总体具有中等到较高的声学质量,同时保留了相当范围的录音条件

基准

ASR 基准:WS-Min-Eval-ASR,每个话语都配有两份人工核验的参考文本:一份闽南语转写和一份普通话转写。这种配对设计使得两种转写目标能够使用相同的音频片段和标注协议进行评估。所有系统都遵循统一的文本归一化和评分流程。对于闽南语转写,我们针对闽南语参考文本报告方言字符错误率(D-CER)。对于普通话转写,我们针对普通话参考文本报告普通话双语评估替补(M-BLEU)和普通话字符错误率(M-CER)。当有效的普通话表达在措辞上可能不同时,M-BLEU 作为 n-gram 重叠的补充度量;M-CER 则衡量字符级准确率。

TTS 基准:由 LLM 生成、并经过自然度和方言真实性优化的专家核验闽南语文本组成。Easy 子集包含 500 条日常话语,Hard 子集包含 250 条具有挑战性的文本:其中 46 条为 161–270 字的长文本,189 条为包含五至七次重复的高重复文本,15 条为绕口令。我们根据声学质量和方言真实性,从内部闽南语语料库中选取 9 名参考说话人。对于客观评估,使用 Qwen3-ASR-WSM-Min 模型生成的转写,通过 CER 衡量可懂度;说话人相似度(SIM)则计算合成语音与参考语音的 WavLM [2] 嵌入之间的余弦相似度。对于主观评估,23 名以闽南语为母语的听众对 40 个随机选取的测试案例进行评估,指标包括可懂度(I-MOS)、说话人相似度(S-MOS)和口音真实性(A-MOS);其中每个子集抽取 20 个案例。

ASR Leaderboard

 D-CER 和 M-CER 来说,数值越低越好;而对于 M-BLEU 则相反,数值越高越好。†符号表示使用的是商业 API。

闽南语:

ModelD-CER (%) ↓
Hy-ASR-3.0-Preview†32.78
CN-MultiDialect-ASR18.59
Qwen3-ASR34.61
Qwen3-ASR-WSM-Min17.59
Qwen3-ASR-WSM-Min + internal data15.21
FireRedASR2-AED43.39
FireRedASR2-AED-WSM18.95

普通话转录:

Each entry reports M-BLEU ↑ / M-CER ↓; GigaSpeech denotes GigaSpeechBench.

ModelWS-MinGigaSpeechMinSpeechAvg.
FunASR-Realtime†39.09/45.4153.37/32.6228.22/63.2340.23/47.09
SeedASR2.0†38.91/47.5855.32/32.5068.53/26.2154.25/35.43
Qwen3-ASR-MinSpeech20.34/60.5712.39/71.2667.94/23.9333.56/51.92
Qwen3-ASR-WSM-Mandarin42.93/42.5651.20/34.0159.82/29.4251.32/35.33
Qwen3-ASR-WSM-Mandarin
+ internal data
49.39/36.8147.65/36.6665.69/26.2154.24/33.05
FireRedASR2-AED18.05/64.4036.91/49.3513.60/85.0222.85/66.26
FireRedASR2-AED-WSM46.06/39.5357.73/28.6157.73/31.8553.73/33.33

TTS Leaderboard

Lower CER is better; higher is better for all other metrics. † indicates a commercial API. ‡ denotes a single-fixed-speaker API, for which SIM and S-MOS are not evaluated.

WS-Min-Eval-TTS Easy

ModelCER (%) ↓SIM ↑I-MOS ↑S-MOS ↑A-MOS ↑
QwenAudio-3.0-TTS†19.900.6723.883.853.62
Qwen3TTS-Flash†‡24.44–3.93–3.93
FireRedTTS333.760.7473.303.323.13
VoxCPM228.160.7073.453.543.38
MERaLiON-TTS21.250.6223.833.733.65
CosyVoice363.690.6542.132.131.49
CosyVoice3-WSM20.260.6783.853.753.65

WS-Min-Eval-TTS Hard

ModelCER (%) ↓SIM ↑I-MOS ↑S-MOS ↑A-MOS ↑
QwenAudio-3.0-TTS†35.090.6853.753.733.70
Qwen3TTS-Flash†‡38.02–3.75–3.73
FireRedTTS355.330.7313.153.393.04
VoxCPM240.500.6813.173.483.36
MERaLiON-TTS37.280.6223.583.733.63
CosyVoice360.350.6102.002.401.43
CosyVoice3-WSM35.980.6693.653.853.70

Fish Audio Drama 3 技术报告详解:面向导演式语音生成的 35B -A3B MoE 架构、训练数据与工程优化

一、论文要点与模型定位

Drama 3 是一个开放权重语音生成模型,总参数量约 35B,但采用稀疏混合专家结构,每个 Token 实际激活约 3B 参数。模型主干由 Qwen3.5-35B-A3B 初始化,采用 40 层混合架构:每四层包含三层 Gated DeltaNet 线性注意力和一层 Gated Full Attention。语音部分沿用 Fish Audio S2 的离散音频 Tokenizer,每个音频帧由 10 个 Codebook 表示;模型主干预测语义 Codebook,新的 Codebook-MTP Decoder 在同一时间位置并行预测其余 9 个声学 Codebook。

论文把创新概括为三点:

  • Hybrid Backbone + Codebook-MTP Decoder:用线性注意力处理长上下文,同时用少量 Full Attention 保留远距离检索能力,并将 S2 的逐 Codebook Fast AR 替换成一次运行 13 层的多 Token 预测解码器。
  • 一个模型统一多任务:多参考音色克隆、自然语言控制、多角色场景、多轮导演式修改、Speech Infilling、长文本合成和 Streaming Text Input 使用同一种交错文本—音频 Token 流表示。
  • 单一人类偏好奖励:RL 不再把 ASR WER、音质模型和 Speaker Similarity 作为规则奖励,而是训练一个小型 Speech Language Model 作为人类偏好 Reward Model。

二、总体架构

Drama 3 没有额外的音频编码器。参考音频、提示音频和生成音频都先通过离散 Audio Tokenizer 转换成 Codebook 序列,之后与文本 Token 交错输入语言模型。每一个音频帧只占用一个 Backbone 序列位置,因此一秒语音约占 21.5 个位置,与该帧包含多少个 Codebook 无关。

2.1 音频 Tokenizer

  • 基于 Descript Audio Codec,输入采样率为 44.1 kHz。
  • 约每秒 21.5 个音频帧,每帧 10 个 Codebook。
  • Codebook 0 是语义码,Codebook 1–9 是逐级增加细节的残差声学码。
  • 编码和解码完全因果,可以流式运行。
  • 参考音频以离散 Token 进入上下文,因此参考音频的细粒度声学信息可以被后续 Decoder 直接访问。

2.2 Hybrid Backbone 与 MoE

主干初始化自 Qwen3.5-35B-A3B,仅使用其语言模型部分。40 层结构由三层 Gated DeltaNet 加一层 Gated Full Attention 组成周期。DeltaNet 使用近似常数大小的状态保存历史,只有每四层中的 Full Attention 保留随上下文增长的 KV Cache;Full Attention 用来精确检索长上下文中的参考音色、早先台词和场景信息。

每一层的前馈网络都是 MoE:共有 256 个 Routed Experts,每个 Token 路由到 8 个专家,并额外经过一个 Shared Expert。总参数约 35B,但每个 Token 约激活 3B 参数。MoE Router 在预训练和 SFT 阶段都加入负载均衡损失,避免大多数 Token 集中到少数专家。

2.3 Partial Codebook Fusion

S2 将 10 个 Codebook 全部反馈给 Backbone。Drama 3 只把语义码和第一层声学码反馈给 Backbone,Codebook 2–9 绕过 Backbone,作为 Decoder 的侧输入。这样既保留参考音频和已生成语音的粗粒度声学线索,也减少模型暴露在自身采样细节上的误差累积。

设第 t 帧的语义码和第一层声学码分别为 \(q_t^{(0)}\) 和 \(q_t^{(1)}\),则 Backbone 的音频输入为:

\( \mathbf{x}_{t}=\frac{1}{\sqrt{2}}\left(\mathbf{E}^{\mathrm{LM}}\left[s\left(q_t^{(0)}\right)\right]+\mathbf{E}^{(1)}\left[q_t^{(1)}\right]\right) \)

其中 \(s(\cdot)\) 把语义码映射到新增的 4096 个语义 Token,\(\mathbf{E}^{\mathrm{LM}}\) 是语言模型词嵌入,\(\mathbf{E}^{(1)}\) 是第一声学 Codebook 的嵌入表。文本位置只使用语言模型嵌入;Codebook 2–9 不进入 Backbone。

2.4 Codebook-MTP Decoder

在第 t 个位置,Backbone 预测下一帧的语义码 \(q_{t+1}^{(0)}\);Decoder 在同一位置预测下一帧的 9 个声学码 \(q_{t+1}^{(1)},\ldots,q_{t+1}^{(9)}\)。Decoder 共有 13 层:前 4 层是共享层,后 9 层分别对应声学 Codebook 1–9。每一层沿完整时间序列做因果注意力,所以每一个声学 Codebook 都能看到参考音频和此前所有帧的声学细节。

每层先把注入的 Codebook 嵌入与上一层隐藏状态合并:

\(\mathbf{u}^{(\ell)}_t=\mathbf{W}^{(\ell)}\left[\operatorname{RMSNorm}\left(\mathbf{e}^{(\ell)}_t\right);\operatorname{RMSNorm}\left(\mathbf{h}^{(\ell-1)}_t\right)\right]\)

随后经过因果 Transformer Block:

\(\mathbf{h}^{(\ell)}_t=\operatorname{RMSNorm}\left(\operatorname{Block}^{(\ell)}\left(\mathbf{u}^{(\ell)}_{1:t}\right)\right)\)

第 k 个 Codebook 的输出分布可以写为:

\(q_{t+1}^{(k)}\sim\operatorname{softmax}\left(\mathbf{W}_{\mathrm{out}}^{(k)}\mathbf{h}^{(4+k)}_t\right),\qquad k=1,\ldots,9\)

相较于 S2 的 4 层 Fast AR 重复运行 10 次,Drama 3 的 13 层 Decoder 每帧只运行一次,因而大幅缩短顺序路径。

三、训练数据与三阶段预训练

数据由完成转录的语音和文本文档组成;所有语音在进入训练前先经过质量控制;文本文档用于保持 Backbone 的语言建模能力;总体训练规模为数千亿 Token;语言覆盖沿用 S2,约 80 种语言和方言。

3.1 Stage 1:基础文本到语音映射

  • 最大序列长度 8K Token。
  • 训练样本包括纯文本文档和多轮 TTS 对话。
  • 目标是学习文本到音频 Token 的映射、普通 TTS 和零样本音色克隆。
  • System 轮保存任务指令和参考音频,User 轮保存待合成文本,Assistant 轮保存目标音频 Token。
  • 损失只计算在 Assistant 的音频输出、必要的分隔符和结束 Token 上。

3.2 Stage 2:降低梯度噪声

Stage 2 继续使用 Stage 1 的序列格式和任务分布,主要变化是 Batch Size 翻倍,从而降低梯度噪声;学习率衰减留到 Stage 3。它并非独立的新任务阶段,而是让基础语音建模能力在更稳定的优化条件下继续收敛。

3.3 Stage 3:长音频、流式和编辑

  • 最大序列长度提升到 16K Token。
  • 加入整段录音合成:参考音频来自同一录音的后部,目标是前部,避免参考片段和监督目标重叠。
  • 加入逐行合成,用 \(<|audio_separator|>\) 对齐输入文本行和输出音频段。
  • 加入 Streaming Interleave:每个 User 轮包含当前文本块和一个前瞻文本块,模型边生成当前块边知道后续内容。
  • 加入 Speech Infilling:保留原音频编辑窗口前后的 Token,只生成窗口内部的新内容。
  • 样本使用 Document Masking 打包成每行 128K Token,优化器为 Muon。

3.4 预训练目标

令 \(\mathcal{T}\) 为需要监督的文本位置(包括结束 Token 和逐行分隔符),\(\mathcal{S}\) 为语义 Codebook 监督位置,则:

\(\mathcal{L}_{\mathrm{text}}=-\frac{1}{|\mathcal{T}|}\sum_{t\in\mathcal{T}}\log p_{\theta}(x_t\mid x_{<t})\) \(\mathcal{L}_{\mathrm{sem}}=-\frac{1}{|\mathcal{S}|}\sum_{t\in\mathcal{S}}\log p_{\theta}\left(q_t^{(0)}\mid x_{<t}\right)\) \(\mathcal{L}_{\mathrm{cb}}=\frac{1}{9}\sum_{k=1}^{9}\left(-\frac{1}{|\mathcal{S}|}\sum_{t\in\mathcal{S}}\log p_{\phi}\left(q_t^{(k)}\mid\mathbf{h}_{<t},\mathbf{q}_{<t},q_t^{(<k)}\right)\right)\)

总损失为:

\(\mathcal{L}=\mathcal{L}_{\mathrm{text}}+0.5\mathcal{L}_{\mathrm{sem}}+0.5\mathcal{L}_{\mathrm{cb}}\)

文本、语义码和声学码各自按自己的监督桶取平均,避免一个 Batch 中文本和语音比例变化导致损失权重漂移;声学 Codebook 损失会反向传播到 Backbone。预训练和 SFT 同时加入 MoE Router 负载均衡损失。

四、Instruction SFT 阶段:如何让模型学会“听懂导演指令”

SFT 从 Stage 3 Checkpoint 开始,最大序列长度为 32K Token,使用 Indexed Reference Layout。SFT 的目标不是重新学习基础发音,而是把已经具备 TTS 和克隆能力的模型转化为能够遵循复杂自然语言指令、处理对话和场景的生成器。

4.1 SFT 数据类型

  • 普通音色克隆:一段或多段参考音频 + 待合成文本。
  • Point Tags:在文本位置插入 [laughs]、[pause]、[coughs] 等局部事件。
  • Scoped Tags:用 <whisper>...</whisper> 只控制被包围的词或短语。
  • Style Prefix:控制整句的情绪、语速、表达方式。
  • Director’s Note:用自然语言描述意图、节奏、重音和表演方式。
  • 多说话人对话:每个角色绑定一个或多个参考音频,通过 speaker Token 切换角色。
  • 多角色场景:一次提供所有台词,并使用显式分隔符,使当前句能够利用后续台词和场景上下文。
  • 多轮修改:保留旧参考和上一版生成结果,下一轮用“更柔和、更温暖”“比上一版更快”等相对指令生成新版本。
  • 长文本、Speech Infilling 和 Text-only Chat:继续混入训练,防止 SFT 破坏 Stage 3 已学能力。

4.2 SFT 样本如何组织

训练序列采用 ChatML 风格。System 轮包含“把给定文本转换成语音”的任务说明、参考文本和参考音频;User 轮包含目标文本、说话人标记、控制标签和语言/时长提示;Assistant 轮以 \(<|voice|>\) 开始,输出目标音频的 10 个 Codebook。对于多轮修改,旧的 Assistant 音频保留在上下文中,下一轮 User 给出相对上一版的修改意见。

损失只作用于模型自己的 Assistant 输出:语音帧的 10 个 Codebook、需要学习的音频分隔符和 \(<|im_end|>\)。参考音频只提供上下文,不直接产生生成损失。Speech Infilling 额外对编辑窗口两侧的接缝加大监督,使新旧音频能够自然拼接。

五、RL:从可控生成到符合人类偏好的表演

RL 从 SFT Checkpoint 开始。S2 使用 ASR 转录错误、语音质量和 Speaker Similarity 三类规则奖励;Drama 3 去掉它们,因为笑声和长停顿会改变 ASR 结果,耳语和喊叫会降低与中性参考的相似度,而整句质量模型无法评价某个词是否按指令变得更柔和或更有情绪。

5.1 人类偏好 Reward Model

Reward Model 是一个较小的 Speech Language Model,使用相同的 Audio Tokenizer 和序列格式预训练到 Stage 2,并在每条 Take 的结束 Token 上增加 Scalar Head。它直接读取完整 Prompt 和生成音频 Token,不需要额外运行 ASR、Tokenizer Decoder 或 Speaker Model,因此参考音色、文本内容和表演风格都能在同一奖励路径中被判断。

对两条 Take 的人类偏好使用 Bradley–Terry 损失:

\(\mathcal{L}_{\mathrm{RM}}=-\left[y\log\sigma(s_a-s_b)+(1-y)\log\sigma(s_b-s_a)\right]+10^{-3}(s_a^2+s_b^2)\)

5.2 GRPO 配置

  • 每个 Prompt 采样 \(G=8\) 条 Take,温度为 1,不使用 Top-p 或 Top-k 截断。
  • 每条 Take 最长约为期望时长的 2.5 倍,且不超过 4096 帧,约 190 秒。
  • 组内 Reward 标准差低于 0.05 的组丢弃。
  • 使用 Group Relative Policy Optimization,采用均值中心化优势,不使用 KL Penalty 和 Reference Model。
  • 每一步使用 1536 个 Prompt × 8 条 Take,采用大 Batch、少步骤、恒定 Muon 学习率和无 Weight Decay。
  • RL 时 Codebook-MTP Decoder 保持冻结,只更新 Backbone 的语义 Token 策略。
  • Rollout 使用块缩放 FP8 专家权重;训练器使用 BF16,并通过路由回放减少训练和推理路由不一致。

奖励标准化与组内相对比较可写为:

\(z_i=\operatorname{clip}\left(\frac{s_i-\mu_0}{\sigma_0},-3,3\right),\qquad R_i=\frac{1}{n-1}\sum_{j\ne i}\sigma(z_i-z_j)\)

论文强调,大 Batch、少更新步可以让策略朝向更广泛的人类偏好移动,并减少小 Batch、多步训练出现的 Reward Over-optimization。

六、推理引擎与吞吐优化

线上请求分为 Prefill 和 Decode 两阶段:Prefill 一次读取文本与参考音频,Decode 每帧执行一步。单 GPU 同时服务多个流,按轮次执行新请求 Prefill 或所有运行中流的一步 Decode。

指标Drama 3Fish Audio S2
Backbone 后的顺序层数1340
每帧读取权重约 6.0 GB约 15.6 GB
其中 Backbone(不含 Routed Experts)2.9 GB7.3 GB
Codebook-MTP / Fast AR2.1 GB8.3 GB
上下文 KV Cache 增长的层数2336
单 H200 单流速度271 frames/s177 frames/s
  • 减少顺序路径:Codebook-MTP 13 层每帧运行一次;S2 的 Fast AR 需要 10 次、共 40 层顺序 Pass。
  • FP8 Routed Experts:专家使用块缩放 FP8,每个专家参数约 1 Byte。Drama 3 每帧读取约 6.0 GB 权重,不到 S2 的五分之二。
  • 删除 CUDA Graph 之外的 Kernel:辅助 Decode Kernel 从 1429 个降到 1278 个,B300、并发 32 时提升 1.7%;融合 Gated DeltaNet Decode 和采样器计数器后减少 100 个 Kernel,单流提升 4.2%。
  • Prefill Graph:Gated DeltaNet Prefill 每层 Kernel 从 23 个降为 13 个;首帧采样的 Host 时间从 30.9 ms 降至 14.7 ms,早期开发模型在 H200 并发 32 时提升 15.3%。
  • 按线上 Shape 优化 Kernel:从真实服务日志抓取矩阵形状、Batch 和并发分布,再做 Nsight Profiling、算子级验证、引擎内 Token/WER 验证和同机 A/B 测试。FP8 MoE Kernel 在 \(M=256\) 时将 MoE 层耗时降低 19.2%。
  • Prefill–Decode 解耦:新请求的 Prefill 不再阻塞正在播放的 Decode 流,降低高并发下的流式卡顿。

七、实验设置与结果

实验统一使用论文附录中的 Prompt 格式,采样温度 0.7、Top-p 0.7、Top-k 30。静音、语音过短、长度失控、长段噪声或长段静音的输出会被重新生成并重新计分。中文使用 Paraformer-zh 转录,其余语言使用 Whisper-large-v3;Speaker Similarity 使用 WavLM-large + ECAPA-TDNN 说话人嵌入余弦相似度。

7.1 Preference Reward 对表达性的影响

在 Expresso 中,将同一说话人同一句话的中性读法与风格读法配对。耳语相对中性读法的 SIM 下降 0.310,笑声使 WER 上升 0.79 个百分点;因此相似度奖励在耳语样本中 99.7% 偏好中性读法,在笑声样本中 93.9% 偏好中性读法。Drama 3 的 Preference RM 在提示中明确写出风格后,偏好耳语的比例为 62.2%,偏好笑声的比例为 64.4%;不写方向时分别只有 10.6% 和 27.1%。

在 Seed-TTS-Eval 上,RL 后 Drama 3 的首轮中文 CER 从 SFT 的 1.66 降到 1.00,英文 WER 从 3.49 降到 2.20;信号检查失败率从中文 2.82% 降到 1.24%,英文 3.40% 降到 1.84%。重生成异常样本后,中文 CER 为 0.83,英文 WER 为 1.54。

7.2 多参考零样本音色克隆

论文在 LibriSpeech-PC test-clean 上扩展多参考测试集:1127 句、39 位说话人,每个目标说话人额外提供两段不包含目标句的参考音频。Drama 3 使用一段参考时 WER 1.85%、SIM 0.605、UTMOS 4.31;使用三段参考时 WER 仍为 1.85%,SIM 提升到 0.633,UTMOS 仍为 4.31。单参考时,UTMOS 4.31 高于 OmniVoice 的 4.28 和 CosyVoice 3 的 4.28;Qwen3-TTS 为 4.41,但其 WER 和 SIM 分别为 1.60 和 0.704。

7.3 MiniMax 多语言克隆

MiniMax Multilingual Testset 覆盖 24 种语言。Drama 3 相比 OmniVoice 在 15 种语言上错误率更低,相比 FireRedTTS3-Base 在 17 种语言上更低;在阿拉伯语、中文、荷兰语、英语、芬兰语、法语、德语、波兰语、葡萄牙语、土耳其语和越南语 11 种语言上同时低于 OmniVoice、FireRedTTS3-Base 和 Fish Audio S2。与实际通过 API 运行的商业系统比较时,Drama 3 低于 Inworld TTS-2 的语言数为 18,低于 Soniox TTS RT v2 的语言数为 21/23,低于 ElevenLabs v4 的语言包括中文、荷兰语、英语、德语、韩语、俄语、西班牙语、泰语和土耳其语。

语言指标Drama 3OmniVoiceFireRedTTS3Fish Audio S2
中文CER0.631.010.910.73
荷兰语WER0.591.361.150.99
英语WER1.131.562.121.62
芬兰语WER3.093.753.103.33
法语WER2.683.352.642.86
德语WER1.081.501.931.46
土耳其语WER1.622.932.472.25

7.4 Streaming Synthesis

在 1088 条 Seed-TTS-Eval 英文测试句上,流式输出 WER 为 1.86,非流式输出 WER 为 1.83;两者 SIM 都为 0.640。结果说明把音频边生成边发送不会带来明显质量损失。

7.5 Speech Infilling 编辑

在 Ming-Freeform-Audio-Edit 中,先用 Qwen3-ForcedAligner-0.6B 将源音频和转录对齐,再把从第一个不同词到最后一个不同词的区域作为编辑窗口。删除操作还会包含相邻未改变词,以保证窗口有可学习的边界。模型保留窗口前后源音频 Token,只生成窗口内部的目标文本,然后整体解码,避免把源波形直接贴回造成拼接痕迹。

系统英文插入 WER / SIM / MAE英文删除英文替换
Drama 33.03 / 0.905 / 0.2085.79 / 0.838 / 0.1742.08 / 0.866 / 0.181
VoiceCraft-X5.74 / 0.85 / 0.1669.71 / 0.80 / 0.1727.29 / 0.81 / 0.155
LEMAS-Edit6.04 / 0.81 / 0.1589.29 / 0.80 / 0.1676.09 / 0.80 / 0.167
CosyEdit21.90 / 0.93 / 0.1075.52 / 0.90 / 0.1311.43 / 0.89 / 0.137

中文结果中,Drama 3 在插入和替换上的 SIM 分别为 0.909 和 0.898,高于专用编辑模型 CosyEdit2 的 0.89;删除 WER 为 7.82,低于 CosyEdit2 的 8.23。与 Cartesia Sonic-3 的 Infill API 比较,Drama 3 在 Ming-Freeform 基础集/完整集上的英文 WER 为 3.49/3.43,中文为 3.69/2.35;Cartesia 对应为英文 4.58/4.68、中文 8.64/6.53。

7.6 多轮导演式修改

Step-Audio-Edit 要求模型先克隆声音,再通过最多三轮指令逐步靠近目标情绪或风格。Drama 3 在每轮中保留原始参考和上一版 Take,并以 [happier versus previous] 一类相对指令重生成。情绪准确率从第 0 轮的 55.5% 提升到第 3 轮的 58.2%,风格准确率从 76.5% 提升到 81.8%。使用 [coughs] 等 Point Tag 进行局部插入并 Infilling 后,拟声事件评分从 1.32 提升到 2.32。

指标第 0 轮第 1 轮第 2 轮第 3 轮
Drama 3 情绪准确率55.557.257.558.2
Drama 3 风格准确率76.579.480.581.8
Drama 3 拟声事件评分1.322.32––
Step-Audio-EditX 情绪准确率53.666.868.769.3
Step-Audio-EditX 风格准确率45.662.764.263.8

八、工程实现启示

  • 长上下文语音模型可以采用“多数线性注意力 + 少量 Full Attention”,在降低 KV Cache 成本的同时保留参考音频和早期台词的精确检索。
  • 多 Codebook 音频生成不必让主干逐一预测所有声学码;将粗语义信息反馈给 Backbone,把细节留给时间因果 MTP Decoder,可以同时降低曝光偏差和推理顺序长度。
  • 如果训练目标是表现力,WER、SIM 和整句音质分数不宜直接作为唯一奖励。更合理的做法是让 Reward Model 读取“指令 + 参考音频 + 生成音频 Token”的完整上下文。
  • SFT 数据应把多轮对话、参考音频索引、Point/Scoped Tag、分隔符和编辑窗口作为一等数据结构,而不是只把音频和文本做成单句配对。
  • 线上性能主要受权重搬运、Kernel Launch 和 Prefill 阻塞影响。需要从真实服务 Shape 出发做算子优化,并将 Prefill 与 Decode 分离。

九、结论

Drama 3 的关键不只是把模型扩大到 35B,而是把模型、数据格式、SFT 任务和 RL 奖励统一到“导演式表演”这一目标上。Hybrid Backbone 解决长上下文,Partial Codebook Fusion 控制反馈复杂度,Codebook-MTP Decoder 直接利用参考音频的细粒度声学信息;三阶段预训练建立基础语音能力,32K Token 的 Instruction SFT 教会模型遵循指令和维护多轮上下文,单一人类偏好 Reward Model 则让笑声、耳语、停顿和情绪表达不再被传统规则奖励压制。

从实验结果看,Drama 3 在多参考克隆、多语言识别准确率、流式生成、语音编辑和多轮修改上都表现出统一模型的优势;从工程结果看,它在单 H200 上达到 271 frames/s,高于参数量小得多的 Fish Audio S2。论文没有公开完整数据来源和样本规模,这一限制需要在复现或二次训练时单独补齐。

Qwen-Audio-Jev 技术报告详解:用一个决策头统一音频选择、二元判断与质量评分

论文的核心问题是:很多音频理解任务最终只需要一个有限答案,例如从几个候选项中选一个、判断一个命题是否成立,或者给语音质量打分。如果仍然让大型音频语言模型逐字生成答案,就会产生额外的解码延迟、格式解析和结果校验成本。

Qwen-Audio-Jev 保留 Qwen-Audio-3.1-ASR-Flash-Next 的音频编码器、音频到语言适配器和 MoE 语言解码器,在“答案开始之前”的隐藏状态上增加一个专用决策头。模型通过自然语言问题和显式答案规范理解任务,然后直接输出概率分布或数值分数,不再自回归生成答案文本。论文在 18 个标注配置上评测:MMAU-mini 准确率 78.70%,MMSU 准确率 84.06%,VoxCeleb1-O 说话人验证 EER 为 6.50%,NISQA overall 质量评分归一化 MAE 为 0.1062,Pearson 为 0.8210,Spearman 为 0.8074;在论文给定的推理设置下,速度约为原始 Qwen-Audio-3.1-ASR-Flash-Next 的 20 倍。

一、论文要解决的实际问题

传统大模型适合生成开放式文本,但在音频筛选、批量质检、说话人验证和数据标注中,输出空间往往是有界的。比如“这段音频属于哪种声学场景”“两个录音是否来自同一说话人”“这段语音的噪声等级是多少”,都可以表示为有限类别、真假概率或有序评分。自回归文本生成会带来三类问题:

  • 需要逐 Token 解码,短答案也要承担语言模型生成的时间开销。
  • 生成结果还要经过字符串解析、候选映射和格式校验,工程链路更长。
  • 文本答案的概率不一定等于任务本身的类别概率,难以直接做校准和阈值控制。

Jev 的思路是将问题、答案空间和输出类型显式写入接口。模型仍然可以使用自然语言描述音频任务,但最后由固定维度的决策读出完成选择、判断或打分。

二、模型总体设计

2.1 Qwen-Audio-3.1-ASR-Flash-Next 基座

基座模型包含三个主要表示模块:

  • Audio Encoder:从波形中提取声学、说话人、环境声音和韵律等表示。
  • Audio-to-Language Adaptor:对相邻编码帧做时间下采样,并将结果投影到语言解码器的隐藏维度。
  • MoE Language Decoder:把音频表示与文本指令、问题和上下文融合,形成问题条件的隐藏状态。

论文实验使用的解码器为 40 层 MoE,隐藏维度为 2048,共 256 个 Routed Experts,每个 Token 选择 8 个专家。原始模型通过自回归概率生成文字答案:

\(p_{\theta}(y\mid x,u)=\prod_{\ell=1}^{L}p_{\theta}\left(y_{\ell}\mid y_{<\ell},\mathbf{a},u\right)\)

其中 \(x\) 是输入音频,\(\mathbf{a}\) 是音频编码和适配后的表示,\(u\) 是文本指令和上下文。Qwen-Audio-Jev 保留这个音频条件表示通路,但把最终答案从“生成文本”改成“读取决策状态”。

2.2 Jev 决策头插入位置

设 \(q\) 为自然语言问题,设 \(c\) 为答案规范。答案规范规定使用哪一种决策原语、合法答案空间是什么,以及候选项或评分等级的含义。问题和规范被序列化为文本前缀,与音频表示一起送入共享解码器:

\(\mathbf{H}=D_{\theta}\left(\operatorname{Fuse}\left(\mathbf{a},\operatorname{Embed}\left(\operatorname{Serialize}(q,c)\right)\right)\right)\)

决策状态取问题前缀最后一个 Token 的隐藏向量:

\(\mathbf{h}_{\star}=\mathbf{H}_{t_{\star}}\)

\(t_{\star}\) 位于目标答案 Token 之前,因此因果注意力无法读取训练样本中的正确答案,避免标签泄漏。决策头包含三个独立的仿射投影:

\(\mathbf{z}^{\mathrm{Choice}}=\mathbf{W}_{C}\mathbf{h}_{\star}+\mathbf{b}_{C}\) \(z^{\mathrm{Noul}}=\mathbf{W}_{N}\mathbf{h}_{\star}+b_{N}\) \(\mathbf{z}^{\mathrm{Score}}=\mathbf{W}_{S}\mathbf{h}_{\star}+\mathbf{b}_{S}\)

当前实现中,决策头维度分别为 \(\mathbf{W}_{C}\in\mathbb{R}^{64\times d}\)、\(\mathbf{W}_{N}\in\mathbb{R}^{1\times d}\)、\(\mathbf{W}_{S}\in\mathbb{R}^{10\times d}\),其中 \(d=2048\)。Choice 和 Score 只对当前问题实际提供的候选或评分等级做归一化,未使用的位置不参与 Softmax。

2.3 三种类型化输出

统一接口可以写成:

\(f_{\theta}(x,q,c)\longrightarrow r_{\tau},\qquad \tau\in\{\mathrm{Choice},\mathrm{Noul},\mathrm{Score}\}\)

Choice:从候选项中选择

Choice 适用于声学场景、乐器、人类非语音声音、性别、情绪和音频问答。当前实现支持 2 到 64 个候选项。候选项的语义由问题中的描述决定,而不是绑定到一个固定的全局类别 ID:

\(p_{ik}=\frac{\exp(z^{\mathrm{Choice}}_{ik})}{\sum_{j\in\mathcal{C}_{i}}\exp(z^{\mathrm{Choice}}_{ij})},\qquad \hat{k}=\arg\max_{k\in\mathcal{C}_{i}}p_{ik}\)

训练时会随机打乱 Choice 候选项,同时同步打乱候选描述和标签概率,防止模型记住“第一个位置通常是正确答案”。

Noul:二元命题的真实性概率

Noul 适用于“两个录音是不是同一个说话人”“这段音频是否包含讽刺”“音频是否为深度伪造”等二元问题。输出是命题为真的概率:

\(p_{i}=\sigma(z^{\mathrm{Noul}}_{i})=\frac{1}{1+\exp\left(-z^{\mathrm{Noul}}_{i}\right)}\)

Score:有序等级上的分布与期望分数

Score 适用于 NISQA、VoiceMOS 和 BVCC 等主观质量评估。评分等级从 \(0\) 到 \(K_i-1\),模型不只输出一个回归数,还输出完整的等级概率分布。预测期望和目标期望分别为:

\(\hat{s}_{i}=\sum_{k=0}^{K_i-1}k p_{ik},\qquad s_i^{\star}=\sum_{k=0}^{K_i-1}k t_{ik}\)

这种设计同时保留分类分布、评分顺序和原始 MOS 尺度,适合需要概率校准的质量控制系统。

2.4 推理过程

推理时输入音频、自然语言问题和答案规范,模型只执行一次共享解码器前向计算,再读取被请求的输出头。Choice 和 Score 对有效候选或等级做 Softmax;Noul 对单个 Logit 做 Sigmoid。无需生成“答案是……”“评分为……”之类的文本,也不需要后处理字符串。

三、训练数据:

3.1 任务数据

决策类型论文涉及的数据集/配置监督信号典型任务
ChoiceCochlScene、NSynth、NonSpeech7k、DiDiSpeech、MELD、MMAU、MMSU、MMAR类别标签或多选答案声学场景、乐器、咳嗽/笑声等非语音声音、性别、情绪、音频问答
NoulVoxCeleb1-O、Clotho-AQA、PodSarc、In-the-Wild二元真假标签说话人验证、二元音频问答、讽刺检测、音频深度伪造检测
ScoreNISQA overall/noise/coloration/discontinuity/loudness、VoiceMOS有序等级或 MOS 评分噪声、染色、断续、响度、整体语音质量

论文将每条训练样本统一成“音频—问题—答案规范—目标”的格式。一个音频不需要同时拥有 Choice、Noul 和 Score 三类标注;样本只对已有且可靠的目标计算损失,缺失标注不产生 Loss。这是论文处理异构数据的关键。

四、SFT:异构音频任务的联合监督

SFT 阶段联合优化 Audio Encoder、Audio-to-Language Adaptor、语言模型 Backbone 和 Jev 决策头。每条样本只激活其请求的决策原语,另外两个读出头不接受该样本的任务损失。论文没有把训练拆成多个串行阶段,而是把三类任务放入同一个监督微调流中;因此这里的“训练阶段”主要是 SFT 和后续 RLCD-inspired 强化学习两个阶段。

4.1 Choice 损失

对有效候选集合 \(\mathcal{C}_i\),候选概率为:

\(p_{ik}=\frac{\exp(z_{ik})}{\sum_{j\in\mathcal{C}_i}\exp(z_{ij})},\qquad k\in\mathcal{C}_i\)

交叉熵为:

\(\ell_i^{\mathrm{choice}}=-\sum_{k\in\mathcal{C}_i}t_{ik}\log p_{ik}\)

硬标签是 One-hot 分布;当数据提供人工标注分布时,使用 Soft Target。Choice 的候选随机排列是论文中特别强调的抗位置偏置增强。

4.2 Noul 损失

二元标签 \(y_i\in\{0,1\}\) 经过 Sigmoid 得到真值概率,使用 Binary Cross Entropy:

\(p_i=\sigma(z_i),\qquad \ell_i^{\mathrm{noul}}=-y_i\log p_i-(1-y_i)\log(1-p_i)\)

论文同时允许 \(y_i\in[0,1]\) 的软二元标注。这样可以用于多人标注后的概率标签,而不是强行压缩为单一真假值。

4.3 Score 损失

Score 同时使用等级分布交叉熵、累计分布误差和期望分数的 SmoothL1。预测和目标的累计概率分别为:

\(P_{im}=\sum_{k=0}^{m}p_{ik},\qquad T_{im}=\sum_{k=0}^{m}t_{ik}\)

三项损失为:

\(C_i=-\sum_{k=0}^{K_i-1}t_{ik}\log p_{ik}\) \(D_i=\frac{1}{K_i-1}\sum_{m=0}^{K_i-2}(P_{im}-T_{im})^2\) \(H(e)=\begin{cases}\frac{1}{2}e^2,&|e|<1,\\ |e|-\frac{1}{2},&|e|\ge 1\end{cases}\) \(\ell_i^{\mathrm{score}}=C_i+\lambda_{\mathrm{cdf}}D_i+\lambda_{\mathrm{mean}}H(\hat{s}_i-s_i^{\star})\)

论文固定使用 \(\lambda_{\mathrm{cdf}}=0.25\) 和 \(\lambda_{\mathrm{mean}}=0.10\)。这比单一 MSE 回归更适合有序评分:交叉熵约束等级分布,CDF 项惩罚等级距离,SmoothL1 约束原始评分尺度上的期望值。

4.4 SFT 总目标

每条样本只计算其激活原语的损失:

\(\mathcal{L}_{\mathrm{dec}}=\ell_i^{t_i}\)

完整 SFT 目标为:

\(\mathcal{L}_{\mathrm{SFT}}=\mathcal{L}_{\mathrm{dec}}+\lambda_{\mathrm{lb}}\mathcal{L}_{\mathrm{lb}}^{\mathrm{base}}+\mathcal{L}_{\mathrm{rz}}\)

其中 \(\mathcal{L}_{\mathrm{lb}}^{\mathrm{base}}\) 是语言模型 Backbone 的 MoE 负载均衡损失,\(\mathcal{L}_{\mathrm{rz}}\) 是 Router z-loss。论文明确指出,SFT 不包含下一 Token 或多 Token 预测目标。

五、RLCD-inspired 强化学习:优化概率校准

强化学习从 SFT Checkpoint 开始,把每个类型化决策视为一步 Contextual Bandit。它不是为了让模型生成更长的解释,而是让概率分布同时具备正确性和校准性。论文使用基于 Brier Score 和 Ranked Probability Score 的组奖励,并通过采样动作做 REINFORCE 更新。

5.1 探索策略

对于第 \(i\) 个问题,Choice 和 Score 从候选或有序等级分布中采样,Noul 视为 False/True 两类策略。每个问题独立采样 \(M=32\) 个动作,探索行为策略为:

\(\mu_{\theta,i}(a)=(1-\epsilon)p_{\theta,i}(a)+\frac{\epsilon}{K_i},\qquad \epsilon=0.05\)

重要性权重为:

\(w_{ir}=\frac{p_{\theta,i}(a_{ir})}{\mu_{\theta,i}(a_{ir})}\)

5.2 校准导向的组奖励

对真实答案 \(y_i\),Brier 误差为:

\(B_i=\sum_{k=0}^{K_i-1}\left(p_{\theta,i}(k)-\mathbf{1}[k=y_i]\right)^2\)

Score 任务额外加入累计概率误差:

\(D_i=\frac{1}{K_i-1}\sum_{h=0}^{K_i-2}\left(\sum_{k=0}^{h}p_{\theta,i}(k)-\mathbf{1}[y_i\le h]\right)^2\)

论文构造的采样组奖励期望满足:

\(\mathbb{E}[\widehat{J}_i]=-B_i-\lambda_iD_i\)

其中 Score 任务使用 \(\lambda_i=0.25\),Choice 和 Noul 不使用有序等级项。该奖励不只奖励“猜对”,还奖励把概率质量放在正确等级附近,并减少过度自信。

5.3 策略梯度更新

论文使用 Leave-one-out Baseline,构造每个采样动作的 Return 和 Advantage,最终的策略梯度损失为:

\(\ell_i^{\mathrm{PG}}=-\frac{1}{M}\sum_{r=1}^{M}\operatorname{sg}\left[w_{ir}A_{ir}\right]\log p_{\theta,i}(a_{ir})\)

\(\operatorname{sg}\) 表示 Stop-gradient;采样动作、奖励、Baseline 和重要性权重视为常量,梯度只通过动作概率流动。这个阶段的重点是校准概率,而不是增加新的标签类型。

六、评测设置与数据集

论文共评测 18 个标注配置:8 个 Choice、4 个 Noul、6 个 Score。评测覆盖分类、音频问答、说话人验证、讽刺和深度伪造检测,以及语音质量评分。论文重点报告模型自身在这些任务上的结果,而不是逐任务与所有原始基座模型做完整消融对比。

6.1 Choice 任务

Benchmark任务Accuracy (%)
CochlScene声学场景分类77.8717
NSynth instrument乐器识别72.2900
NonSpeech7k sound人类非语音声音识别92.6897
DiDiSpeech gender说话人性别分类100.0000
MELD emotion对话情绪识别57.3072
MMAU多模态音频问答78.7000
MMSU语义、韵律和副语言理解84.0568
MMAR复杂混合音频问答69.9000

Choice 结果显示,性别分类和人类非语音声音识别超过 90%,而 MELD 情绪识别只有 57.31%,是最弱配置。模型对说话人属性和明显的副语言事件更容易判断,对对话情绪这种依赖上下文、语气和角色关系的任务仍有明显提升空间。三个音频问答数据集中,MMSU 最好,MMAU 居中,MMAR 最低,说明复杂混合音频问答比基础类别识别更难。

6.2 Noul 二元判断

ConfigurationAccuracy (%)EER (%)AUCBrierFPR (%)FNR (%)
VoxCeleb1-O93.54416.49800.9822670.0486957.32145.5901
Clotho-AQA79.890119.82510.8786520.14639114.412124.4898
PodSarc98.26511.44270.9952300.0164062.17251.2149
In-the-Wild76.323220.94690.8763180.1581123.782257.2867

PodSarc 和 VoxCeleb1-O 同时具备较高 AUC 和较低阈值错误,说明模型在说话人验证和讽刺检测上的概率排序、二元决策与概率误差都较稳定。In-the-Wild 与 Clotho-AQA 的 AUC 接近,但 In-the-Wild 在 0.5 阈值下 FNR 达到 57.29%,说明它不是不能排序,而是在当前阈值下漏掉了大量正样本。实际部署时应根据业务成本重新选择阈值,而不能只看默认 0.5。

6.3 Score 质量评分

ConfigurationMOS MAEMOS RMSENormalized MAENormalized RMSEPearsonSpearman
NISQA overall0.4246420.5463440.1061600.1365860.8210020.807382
NISQA noise0.5844990.7388430.1461250.1847110.7360520.722851
NISQA coloration0.3453700.4319120.0863420.1079780.8098830.808054
NISQA discontinuity0.4305620.5397930.1076400.1349480.8009400.725388
NISQA loudness0.4369850.5230980.1092460.1307750.7282350.689991
VoiceMOS0.8134971.0040480.2033740.2510120.7230590.753843

NISQA overall 和 coloration 的 MOS 误差较低且相关性接近 0.8;loudness 的平均误差与 overall 接近,但 Pearson 较低,说明“平均偏差小”和“随样本质量变化的趋势一致”是两个不同维度。VoiceMOS 的 Pearson 和 Spearman 都为正,但原始 MOS MAE 为 0.813,高于 NISQA 各维度,说明跨数据集评分尺度和主观一致性仍是难点。

七、对 ASR 和音频理解系统的工程启示

  • 把“识别”和“决策”分开:ASR、说话人验证、质量审核和音频筛选常常只需要结构化结果,直接读出比生成解释文本更适合高吞吐服务。
  • 使用问题条件化的候选空间:同一个输出位置可以在一个问题中表示场景,在另一个问题中表示情绪,候选语义放在问题中,比固定分类头更容易扩展新任务。
  • 把概率校准作为一等目标:线上系统通常需要阈值、置信度和风险排序,Brier、CDF 和概率分布损失比只优化准确率更贴近实际。
  • 允许部分标注:不同音频数据集的标签互不相同,统一“音频—问题—规范—目标”格式,可以在不强行补全标签的情况下联合训练。
  • 对 Score 保留有序结构:语音质量的 2 分和 3 分比 2 分和 5 分更接近,CDF 损失可以把这种等级距离纳入训练。
  • 部署时重新选阈值:In-the-Wild 结果说明 AUC 相近的系统,在固定 0.5 阈值下可能出现完全不同的 FNR,生产系统应根据漏检和误报成本选择 operating point。

Qwen-Audio-Jev 的主要价值在于重新定义音频语言模型的输出接口:输入仍然是音频、自然语言问题和答案规范,输出则从开放式文本改为三种类型化决策。Choice 负责有限候选选择,Noul 负责二元命题概率,Score 负责有序质量分布和期望分数。模型通过共享的 Qwen-Audio-3.1-ASR-Flash-Next 表示通路和一个决策头覆盖多个数据集,再用异构标签的 SFT 和面向校准的 RLCD-inspired 训练统一优化。

论文结果说明,这种设计在音频筛选、说话人验证、深度伪造检测、语音质量评估和批量音频问答中具有工程潜力;但它还不是完整的端到端复现方案,因为训练数据总量、数据配比、完整消融和统一速度基准仍未公开。对于 ASR 团队,最值得借鉴的是:把高频、有限答案的后处理任务从“生成式问答”改造成“问题条件化决策”,并把概率校准、候选重排和缺失标签处理直接纳入训练接口。