RSI – [Recursive Self-Improvement]

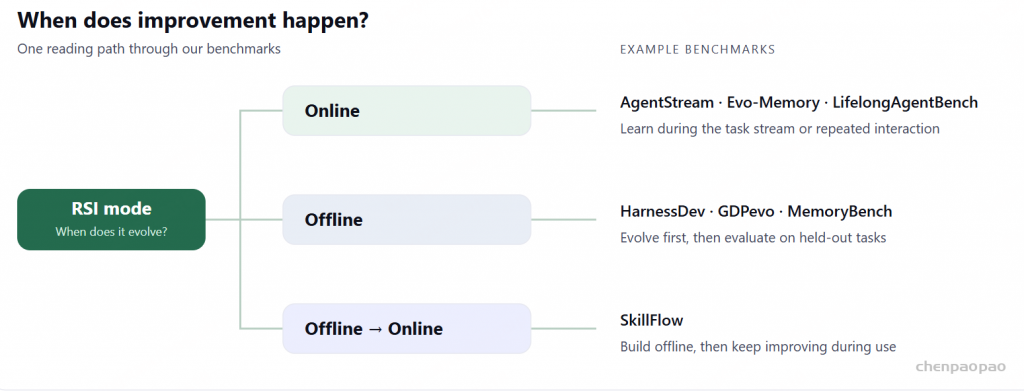
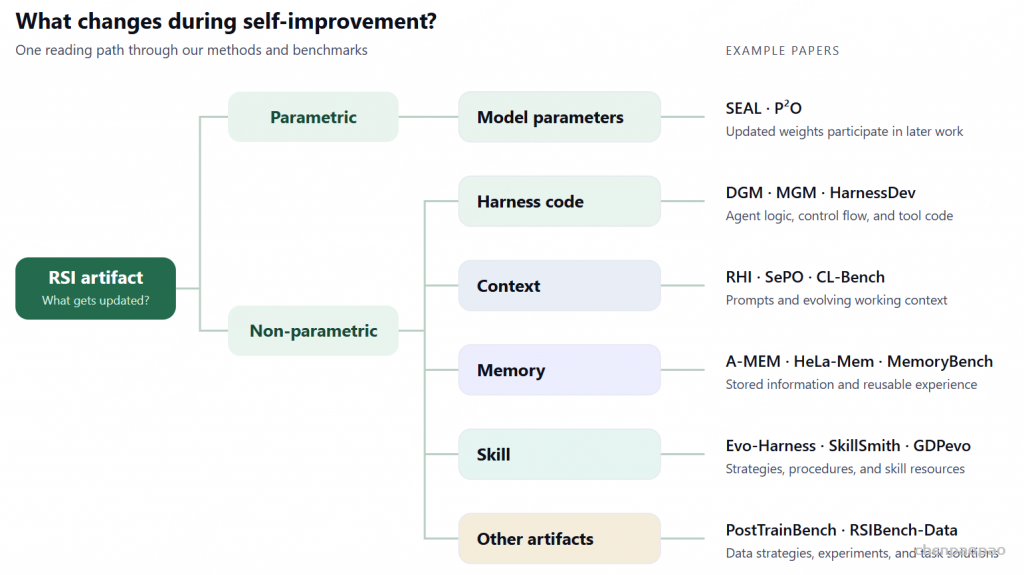
Awesome RSI 仓库(网站),尝试从分类的视角整理现有 RSI 工作

https://github.com/Prism-Shadow/awesome-rsi

收录关于智能体从自身经验中学习的论文、书籍与课程,涵盖自我演化、技能学习、记忆、持续学习和自动化 AI 研究。你可以按主题筛选、搜索,并按时间或影响力排序。
Jev 深度解析:面向结构化决策的 System One 模型、原理、优势与工程实践

最近,TypeSafe AI 发布的 Jev 引发了开发者社区的集中讨论。它的定位并不是“又一个更小的聊天大模型”,而是一种面向软件系统的 System One(系统 1)模型:接收当前状态和一组预先定义的问题,快速返回类型化答案、概率分布与置信度,让程序可以直接据此分支、路由或触发动作。

这篇文章综合 TypeSafe 官方文档、Eigent 的技术解读,以及社区对 Jev 的端侧复现和应用观察,系统说明 Jev 是什么、为什么快、如何减少结构化输出错误、适合哪些场景、有哪些局限,以及如何把它放进 Agent 和自动化系统中。需要特别说明的是:Jev 目前是闭源服务,具体模型结构、训练数据和 RLCD 的完整实现尚未公开;本文会把官方事实、厂商自报指标和社区推测分开表述。

一、Jev 是什么:把“判断”从文本生成中剥离出来

传统 LLM 的基本接口是“输入文本,生成文本”。即使我们只想知道“这个工单应该交给哪个部门”,也往往需要模型逐个 token 生成 JSON,再由程序解析、校验和兜底。Jev 采用了相反的设计:调用方先声明问题和合法答案空间,模型只在这个空间内进行判断。

可以把一次 Jev 调用抽象为:

\( (s, Q) \xrightarrow{\text{Jev}} (a, P, c) \)

其中,s 是应用提供的状态(字符串、JSON 或文本数组),Q 是类型化问题集合,a 是答案,P 是答案空间上的概率分布,c 是供程序使用的置信度。Jev 不负责写解释、代码或回复,而是把判断结果交还给确定性代码。

二、System One 与 System Two:Jev 在 AI 栈中的位置

“System One”借用了 Daniel Kahneman《思考,快与慢》中的概念。System 1 代表快速、直觉式判断;System 2 代表慢速、审慎的推理。映射到 Agent 架构中:

  • System 2(传统前沿 LLM):理解复杂目标、规划多步任务、生成代码和自然语言、处理开放式推理。
  • System 1(Jev):分类、选择、评分、风险判断、工具路由、完成检测等高频且边界明确的局部决策。

因此,Jev 不是 GPT、Claude 等模型的替代品,更像是软件里的“智能 if 语句”或快速决策层:复杂问题交给 System 2,局部判断交给 System 1。

三、Jev 的三种基本原语

TypeSafe 官方文档将 Jev 的问题接口归纳为三种原语。它们看起来简单,但正是“可约束、可校验、可被代码直接消费”的基础。

原语回答的问题典型输出适合场景
Choice从有限选项中选一个选项、各选项概率、置信度部门路由、工具选择、下一步动作
Score在文字定义的量表上评分连续或离散分数及分布情绪、复杂度、风险、优先级
Noul一个是/否问题0 到 1 的概率是否退款、是否危险、是否完成

Choice 的答案空间通常由调用方显式提供,官方资料提到最多可配置 255 个选项;Score 则允许模型在量表之间给出更细的数值,例如 1.4,而不是被迫四舍五入到某一档。多个问题可以在一次请求中并行评估,例如同时询问“应该由哪个团队处理”“客户有多生气”“是否明确要求退款”。

四、为什么 Jev 可能更快:从自回归生成到受限决策

1. LLM 的瓶颈:逐 token 生成

自回归 LLM 生成长度为 T 的答案时,需要重复进行多轮解码:

\( P(y_{1:T}\mid x)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x) \)

每一步都要从完整词表中选择下一个 token。输出越长,延迟越高;如果还要求 JSON,就必须生成括号、键名、引号和字段值,任何一步出错都可能导致解析失败。

2. Jev 的思路:一次前向传播,直接对答案空间打分

在受限决策中,答案集合是已知的。模型可以对候选答案直接计算 logits,再在候选集合上做归一化:

\( p_i=\frac{e^{z_i}}{\sum_{j=1}^{K}e^{z_j}},\quad i\in\{1,\ldots,K\} \)

这里的 K 是候选答案数量,z_i 是对应分数。程序拿到概率最高的候选即可执行下一步,不必等待模型生成一段文本。

社区对 Jev 的端侧复现进一步提出了一个工程假设:可以把多个问题共享的 KV-Cache 广播给各个问题头,再对候选 token 做词表切片,从而将“多个字段的判断”并行化。这个解释与受限分类器的常见实现相符,但由于 Jev 权重和内部架构没有公开,它属于合理的逆向推测,不应当当作官方实现细节。
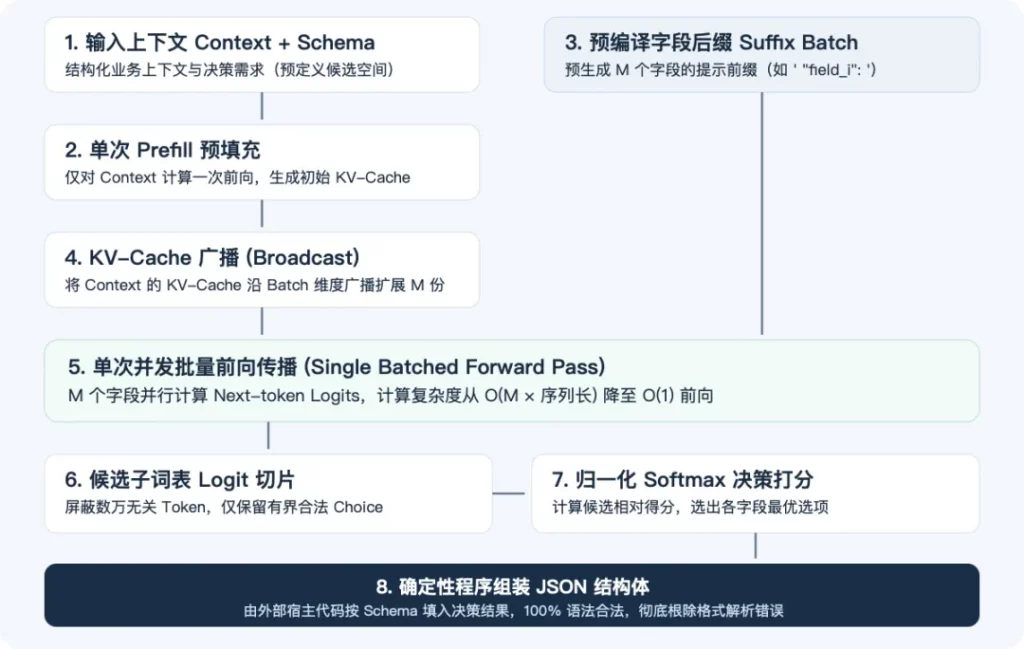
在底层逻辑上,Jev 彻底重构了模型的输入与输出范式:

  • 输入端:结构化上下文(JSON) + 决策需求定义。Jev 的定位不是处理自然语言闲聊,而是接收结构化的上下文与调用方严格定义的决策需求(例如:从有限的候选动作集合中单选、判断某个布尔条件是否满足、或输出特定区间的分数等)。
  • 推理端:隐状态直接打分。Jev 彻底跳过了一个 Token 一个 Token 的自回归生成文本的过程。它并不输出自由文本去拼出一个 JSON 字符串,而是直接利用模型内部隐状态对预设的类型化输出空间进行直接投影打分,一步到位输出结构化判定。
  • 训练端:RLCD(校准决策强化学习)。传统大模型普遍采用 RLHF(基于人类反馈的强化学习)一类的对齐训练,偏向于迎合人类的对话审美,常常导致模型为了“显得有说服力”而盲目自信、甚至编造胡话;而 Jev 采用的 RLCD(Reinforcement Learning for Calibrated Decisions),其核心思想是概率校准(Probability Calibration),让模型输出的得分具备严格的置信度含义,我们只要设定一个置信度的阈值,就可以筛除不确定的答案。

由于 Jev 未公开具体的训练方案与技术架构的细节,这里尝试用开源的 Qwen3.5 9B 模型进行了复现。核心点:在结构化决策与分类场景中,字段候选值通常是有界的。所以我们无需让模型逐 Token 自回归生成文本,可以通过“KV-Cache 广播 + 词表切片”,将所有字段候选值的选择并行化为O(1)次批量前向传播,这样就可以成倍提升吞吐与响应速度。

传统 LLM 自回归生成在每一步都会在全词表(以 Qwen 3.5 为例,全词表包含 248,320 个 Token,约 24.8 万)上进行采样,这赋予了模型“胡说八道”的自由度。Jev 模型将自由文本生成转化为封闭决策,仅在调用方提供的选项中进行选择,决策空间被严格约束在预定义集合内,模型从数学上就不可能产生未定义选项的幻觉。

传统 LLM 输出一个 JSON,需要逐 Token 吐出 {、"field_name":、, 等语法字符。模型一旦出现注意力衰减,就会漏掉字段、写错括号或者自行脑补多余的 Key。我们将模型的能力边界严格限定为“特征分类器”,剥离了其组织语法的职责;最后的 JSON 结构由宿主程序以确定性代码直接填装,使得 JSON 语法有效率 100% 保证,字段缺失率与语法错误降为绝对的 0。

传统 LLM 在自回归解码中,生成第 10 个字段时,输入不仅包含原始文档,还包含了前 9 个字段生成的输出。如果前面的字段存在微弱偏差,这个偏差就会污染 KV-Cache,引发自回归级联误差。通过 KV-Cache 广播 将各字段解耦,每一个字段的决策都是直接基于原始输入和 Schema 定义进行评估,字段与字段之间互不干扰,这样就切断了自回归误差放大链条。

3. 结构化输出错误为什么接近于零

如果模型负责生成 JSON,它需要同时承担“判断”和“语法组织”两项工作。Jev 则只负责在合法候选中做选择,最终 JSON 由 SDK 或宿主程序按照 Schema 组装:

\( \text{JSON}_{\text{final}}=\text{Serialize}(\text{Schema},\text{TypedAnswer}) \)

因此,“未定义选项”“漏字段”“括号不匹配”等语法型错误可以从生成环节被消除。这里的“0% 类型错误”是由输出约束和确定性序列化保证的;它不等于 0% 语义错误,模型仍可能在合法选项中选错。

五、RLCD 与概率校准:Jev 的核心价值不只是快

传统 RLHF 往往围绕人类偏好、可读性和对话体验优化;Jev 所强调的 RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习)则把重点放在“概率是否具有实际意义”上。

理想的校准意味着:在所有给出约 0.8 置信度的预测中,长期平均约有 80% 是正确的。一个常见的评估指标是期望校准误差(ECE):

\( \mathrm{ECE}=\sum_{m=1}^{M}\frac{|B_m|}{n}\left|\mathrm{acc}(B_m)-\mathrm{conf}(B_m)\right| \)

其中,样本按置信度划分为多个区间 Bm,比较每个区间的实际准确率与平均置信度。ECE 越小,说明概率越接近“可解释的风险信号”。

Choice 和 Score 通常返回完整概率分布。分布越集中,置信度越高;越平坦,说明模型更不确定。也可以用熵描述这种不确定性:

\( H(P)=-\sum_{i=1}^{K}p_i\log p_i \)

TypeSafe 文档强调,校准是大量预测上的统计性质,并不保证某一次回答一定正确。因此,置信度应该被当作“是否自动执行”的控制信号,而不是绝对真理。

RLCD 的具体原理:把“答对”与“知道自己有多确定”同时优化

TypeSafe 官方的 AI primer 明确了 RLCD 的目标:模型不生成文本,而是返回决策和概率;更高的概率应该对应更高的正确概率。官方公开资料目前没有披露完整的奖励函数、训练数据、模型头结构或优化超参数,因此下面分为“官方已确认”和“基于概率预测训练的工程解释”两部分。

官方已确认的训练目标

  • 输出契约不同:RLHF 主要优化人类偏好的自然语言回复,RLVR 主要优化可验证任务的结果,RLCD 则优化类型化决策和校准概率。
  • 概率必须可解释:一批预测中,给出 0.2 概率的事件应大约有 20% 发生,给出 0.8 概率的事件应大约有 80% 发生。
  • 面向软件使用:概率不是展示给用户看的装饰,而是让代码决定自动执行、请求确认或升级人工的控制信号。
  • 不是单次正确率保证:校准描述的是一组预测的统计关系,不能保证某一个样本一定正确。

一个可理解的 RLCD 训练流程

从机器学习角度,可以把 Jev 的决策模型抽象成 pθ(a|x,q):给定状态 x 和问题定义 q,模型参数 θ 输出各合法答案的概率分布:

\( p_{\theta}(a\mid x,q),\qquad a\in\mathcal{A}(q) \)

一次训练样本不仅包含“正确答案” y,还包含该答案是否真实发生、是否满足业务结果等可验证 outcome。训练过程大致可以理解为:

  1. 构造决策样本:从历史工单、工具调用、网页状态或人工标注中得到状态 x、问题 q、正确答案 y 和最终 outcome。
  2. 产生候选概率:模型对有限答案集合计算 logits,并通过 Softmax 得到概率分布。
  3. 同时评价准确性与概率质量:正确答案应获得较高概率;错误答案或不确定样本不能被赋予虚高概率。
  4. 用强化学习继续优化:把“决策正确”“概率与长期结果一致”“答案符合类型约束”等信号组合成奖励,更新策略模型。
  5. 在独立校准集上验证:检查 ECE、Brier score、可靠性曲线、选择性风险和不同场景的升级率,而不仅是 top-1 accuracy。

奖励信号可能如何组成

TypeSafe 没有公开 RLCD 的精确 reward 公式。对“校准决策强化学习”最合理的工程化理解,是同时使用正确性奖励和概率评分规则。常见的概率损失包括对数损失:

\( L_{\mathrm{log}}=-\frac{1}{N}\sum_{n=1}^{N}\log p_{\theta}(y_n\mid x_n,q_n) \)

以及 Brier score:

\( L_{\mathrm{Brier}}=\frac{1}{N}\sum_{n=1}^{N}\sum_{k=1}^{K}(p_{n,k}-\mathbb{1}[y_n=k])^2 \)

在二分类 Noul 问题中,Brier score 可以简化为:

\( L_{\mathrm{Brier}}=\frac{1}{N}\sum_{n=1}^{N}(p_n-y_n)^2 \)

一个用于理解的组合目标可以写成:

\( L_{\mathrm{total}}=L_{\mathrm{decision}}+\lambda L_{\mathrm{calibration}}+\beta L_{\mathrm{constraint}} \)

其中 Ldecision 衡量是否选对,Lcalibration 衡量概率是否与实际结果一致,Lconstraint 则惩罚非法选项、类型错误或违反 Schema 的输出。上式是解释 RLCD 的概念模型,不是 TypeSafe 已公布的内部公式。

RLCD 与 RLHF、RLVR 的区别

方法主要优化对象典型奖励适合的输出
RLHF人类偏好、可读性、遵循指令偏好模型分数聊天回复、解释、写作
RLVR可验证答案或推理结果数学/代码测试器是否通过推理、数学、代码任务
RLCD决策正确性与概率校准结果正确、概率评分合理、输出受约束Choice、Score、Noul 等软件决策

这也解释了为什么 RLHF 模型可能“说得很像正确答案”,却不适合直接承担自动化决策:它被奖励的是让人满意的表达,而不是让概率在长期统计上可信。RLCD 的目标是让模型在不确定时保留不确定性,而不是用流畅语言掩盖信息不足。

如何测量 RLCD 是否真的有效

  • 准确率:答案是否选对,适合衡量决策能力,但不能单独说明置信度是否可信。
  • ECE:概率分桶后比较平均置信度与实际准确率。
  • Brier / Log loss:同时惩罚错误答案和过度自信。
  • 可靠性曲线:横轴是预测概率,纵轴是实际发生率,理想情况接近对角线。
  • 选择性风险:只自动执行高置信度样本时,错误率是否显著下降。
  • 覆盖率—风险曲线:在自动处理更多样本与保留较低错误率之间寻找平衡。

例如,系统可以定义自动执行集合:

\( S_{\tau}=\{x:c(x)\ge\tau\} \)

然后计算该集合上的选择性风险:

\( R(\tau)=\Pr(\hat{y}\ne y\mid x\in S_{\tau}) \)

如果提高阈值 τ 后,自动处理覆盖率下降但风险稳定下降,说明置信度可以作为有效的治理开关。真正上线前,还应按业务动作分别校准阈值,而不是全系统共用一个数字。

六、最重要的工程模式:置信度门控与级联路由

一个可靠的 Jev 工作流通常不是“模型说什么就执行什么”,而是让代码根据置信度和操作风险分流:

  1. 准备状态:用户消息、页面元素、交易记录、策略规则或工具结果。
  2. 并行提出多个 Choice、Score、Noul 问题。
  3. 读取答案、概率分布和置信度。
  4. 由确定性代码执行阈值判断。
  5. 高置信度且低风险时自动执行;中等置信度时请求确认或补充信息;低置信度或高风险时升级人工或调用更强的 System 2 模型。

可以形式化为:

\( a=\begin{cases} \text{自动执行}, & c\ge\tau_{\text{auto}} \land r\le r_0 \\ \text{请求确认/补充信息}, & \tau_{\text{review}}\le c<\tau_{\text{auto}} \\ \text{升级人工或 System 2}, & c<\tau_{\text{review}} \end{cases} \)

阈值不应只有一个。只读操作可以使用较低阈值;删除、支付、下单、发送邮件等不可逆操作应使用更高阈值,并配合人工确认。

七、Jev 的典型应用场景

  • Browser Use / Computer Use:先扫描真实存在且可交互的 DOM 或无障碍节点,再让 Jev 从候选动作中选择点击、输入、滚动或结束。模型不生成不存在的选择器,能显著减少“选择器幻觉”。
  • 邮件、工单和客服路由:并行判断部门、紧急程度、垃圾邮件概率、退款意图和是否需要人工介入。
  • Agent Harness:判断任务是否完成、是否卡住、是否偏离目标、工具调用是否危险、哪些上下文应该保留。
  • 模型与工具路由:在每个回合开始时选择便宜模型、强模型、搜索工具或专用子 Agent。
  • 内容审核和数据筛选:对新闻、帖子、论文摘要、商品或文档进行高频分类、评分和过滤。
  • 实时控制和游戏:对模拟器状态、游戏状态或设备状态进行低延迟动作选择。交易、支付等高风险场景必须采用 advisory 或人工确认模式。

这些场景的共同点是:判断频率高、答案空间窄、延迟或成本敏感,而且最终动作可以由程序执行。它们不是开放式写作、代码生成或长链推理。

八、社区端侧复现说明:哪些可以复现,哪些仍是推测

APUS AI 实验室的文章基于 Qwen3.5-9B 等开源模型,尝试复现 Jev 的关键思想,并开源了 fast-browser-use。其路线包括:候选动作枚举、单 token logits 决策、KV-Cache 广播、受限动作空间和 Harness 防护。测试显示,在 Apple M2 Pro、MLX 和 4-bit 本地权重上,多个浏览器任务可以在数秒到几十秒内完成。

这类项目证明的是“受限决策模型”这一范式可以在开源模型上落地,并不等于复现了 Jev 的权重、训练配方或全部性能。社区文章中的速度、准确率和成本数字属于特定硬件、页面和实现下的实验结果,不能直接与 TypeSafe 的云端基准横向等同。

九、Jev 的优势

  • 低延迟:避免长文本自回归,适合实时循环和高频 Agent 步骤。
  • 低成本:官方公开价格曾宣传为输入每百万 token 约 0.042 美元、输出免费;具体价格和可用性应以当前控制台为准。
  • 类型安全:答案空间由调用方定义,JSON 由程序生成,结构化解析错误可被系统性消除。
  • 天然可并行:一次调用可同时询问多个独立问题,适合扇出式评估。
  • 置信度可用于治理:概率和置信度让自动执行、人工复核和升级模型之间有明确边界。
  • 便于审计:问题定义、候选集合、模型答案、概率、阈值和最终动作都可以记录为 Trace。

十、局限与风险:Jev 不是什么

  • 不是生成模型:不能替代对话、写作、代码生成或复杂解释。
  • 没有主动世界知识:它只判断传入的状态,不会自动浏览互联网或调用工具;信息收集必须由外部程序完成。
  • 概率不等于正确:校准是群体统计性质,单次预测仍可能错误。
  • 强依赖问题设计:如果候选选项遗漏了正确答案,模型只能在错误的集合中做选择。必要时应加入“其他/不确定”选项。
  • 闭源与供应商依赖:权重和完整训练细节未公开,延迟、价格和配额可能变化。
  • 高风险动作不能只看模型:支付、交易、删除、外发消息等必须有确定性规则、幂等保护、二次确认和审计。

十一、如何设计一个可靠的 Jev 问题

  1. 把问题写成一个原子判断,不要把规划、解释和执行混在一起。
  2. 显式列出合法答案,并加入 other、unknown 或 need_human 等兜底选项。
  3. 让状态尽量结构化,去掉与当前问题无关的上下文。
  4. 一次并行询问多个相互独立的问题,减少往返。
  5. 为每类动作建立独立阈值,并用离线标注集校准。
  6. 把 Jev 的答案、置信度和最终动作全部写入 Trace,便于回放和误差分析。
  7. 对副作用动作使用外部状态断言,例如 URL、页面标题、数据库状态或业务回执,而不是把模型返回的 DONE 当成事实。

十二、一个混合 Agent 架构示例

用户请求
  ↓
System 2:理解目标、制定计划
  ↓
程序收集状态(页面、工具结果、权限、策略)
  ↓
Jev:Choice / Score / Noul 并行判断
  ↓
确定性代码:阈值、权限、幂等、审计
  ├─ 高置信度 + 低风险 → 自动执行
  ├─ 中等置信度 → 请求确认或补充信息
  └─ 低置信度/复杂情况 → 升级人工或 System 2
  ↓
外部状态断言与 Trace 记录

这个架构的关键不是“让 Jev 接管 Agent”,而是把它放在最适合的位置:成为快速、局部、可审计的决策层。主 LLM 负责方向,程序负责边界,Jev 负责高频判断。

十三、Jev 技术架构细节:如何一次回答多个问题并提升吞吐

下面这套架构是根据 TypeSafe 对 System One 的公开描述,以及社区端侧复现文章所还原出的工程模型。TypeSafe 尚未公开 Jev 的权重和完整实现,因此其中涉及 KV-Cache 广播、Suffix Batch 和候选 token 映射的部分,应理解为“高度合理的实现路径”,而不是官方确认的内部代码。

1. 输入不是一段提示词,而是 Context + Schema

调用方首先准备两类数据:

  • Context:当前业务状态,例如工单正文、用户资料、页面 DOM 摘要、交易记录或游戏状态。
  • Schema:要问的问题、问题类型和合法答案集合。例如 team ∈ {billing, technical, account}、risk ∈ {low, medium, high},以及若干 Noul 和 Score 问题。

可以形式化为:

\( Q=\{q_1,q_2,\ldots,q_M\},\qquad q_i=(\text{name}_i,\text{type}_i,\mathcal{A}_i) \)

其中 M 是一次请求中的问题数量,𝒜i 是第 i 个问题的合法答案空间。关键点是:这些问题可以相互独立地基于同一份 Context 判断,而不需要让第 2 个问题读取第 1 个问题生成的文本。

2. 单次 Prefill:Context 只编码一次

在普通自回归 LLM 中,每个字段的生成过程可能重复携带上下文,或者在生成后续字段时继续依赖前面字段的 KV-Cache。Jev 式架构把共享的 Context 前缀单独处理:模型先对 Context 做一次 Prefill,得到初始 Key/Value 缓存。

\( (K_0,V_0)=\mathrm{Prefill}(X_{\text{context}}) \)

如果有 M 个问题,最昂贵的上下文编码只发生一次。后续每个问题只追加自己的问题前缀、字段名和候选答案提示。

3. Suffix Batch:把多个问题组织成批次

为每个问题预先构造一个短的 suffix(后缀提示),例如 field="team":、field="urgent":、field="refund":。这些 suffix 的作用不是让模型生成完整 JSON,而是把模型引导到对应字段的决策位置。

随后将同一个 Context 的 KV-Cache 沿 batch 维度广播 M 份:

\( (K_0,V_0)\;\xrightarrow{\text{broadcast along batch}}\; (K_0^{(1:M)},V_0^{(1:M)}) \)

第 i 个 batch 样本只附加第 i 个问题的 suffix。这样做的效果是:共享上下文不重复计算,问题之间彼此解耦,同时又可以交给 GPU、NPU 或高效 CPU 内核进行批量矩阵运算。

4. Single Batched Forward Pass:一次前向得到 M 个问题的 logits

完成广播和 suffix 拼接后,系统执行一次批量前向传播:

\( Z=\mathrm{Forward}\left(\mathrm{Batch}\left[X_{\text{context}}+S_1,\ldots,X_{\text{context}}+S_M\right]\right) \)

输出 Z 包含每个问题在“下一个决策位置”上的 logits。传统做法可能需要为 M 个字段分别调用 M 次推理;批处理后,它们共享一次 kernel 调度和一次上下文计算,工程上可以显著提升吞吐。

需要准确理解“复杂度降低”的含义:它不是把所有计算神奇地变成常数,而是把最昂贵的共享前向从 M 次重复执行变成 1 次,并将问题特有的工作放入并行 batch。理想情况下,端到端延迟更接近一次前向加上批量宽度带来的并行开销,而不是 M 次串行延迟。

若串行方案的近似耗时为:

\( T_{\text{serial}}\approx M(T_{\text{prefill}}+T_{\text{decode}}) \)

而共享 Prefill、批量决策的方案近似为:

\( T_{\text{batched}}\approx T_{\text{prefill}}+T_{\text{batched\_forward}}+T_{\text{assemble}} \)

则理论加速比可以写成:

\( S=\frac{T_{\text{serial}}}{T_{\text{batched}}} \)

当 M 较大、Context 较长且硬件具备批处理能力时,S 会明显增大;当 Context 很短、问题数量很少或 batch 已经受限于内存带宽时,加速比则会下降。

5. 候选子词表 Logit 切片:不再扫描完整词表

普通语言模型的输出层通常面对完整词表 V。但在 Jev 的 Choice 问题中,调用方只允许模型从 K 个候选中选择,其中 K≪V。因此,系统可以先把每个合法选项映射到 tokenizer 中的候选 token,再只保留这些位置的 logits:

\( z_{\text{choice}}=Z[:,\mathcal{I}_{\text{valid}}],\qquad |\mathcal{I}_{\text{valid}}|=K\ll |V| \)

然后在候选集合内部重新 Softmax:

\( p(a_i\mid X,Q)=\frac{\exp(z_i)}{\sum_{j=1}^{K}\exp(z_j)} \)

这样可以避免让模型在数万或数十万 token 中自由采样,既减少输出层计算和内存搬运,也从结构上阻断“生成未定义选项”的路径。工程上应特别注意 tokenizer 校验:一个业务选项未必对应一个单独 token,必要时需要使用唯一的短标签(例如 A、B、C),再由程序把标签映射回业务值。

6. 多个问题的输出如何组装

Jev 或类似受限决策模型的核心输出通常不是一段完整 JSON,而是“每个问题一个结构化结果”。宿主程序负责把这些结果放回 Schema 定义的字段中。

可以把第 i 个问题的结果表示为:

\( r_i=\{\text{name}:n_i,\text{type}:t_i,\text{value}:a_i,\text{probabilities}:P_i,\text{confidence}:c_i\} \)

之后通过确定性映射函数把所有结果组装成最终对象:

\( R=\mathrm{Assemble}(\mathrm{Schema},r_1,r_2,\ldots,r_M) \)
// Schema(示意)
{
  "team":  { "type": "choice", "options": ["billing", "technical", "account"] },
  "score": { "type": "score",  "min": 0, "max": 2 },
  "refund":{ "type": "noul" }
}

// 模型只返回各问题的决策分布
{
  "team":   { "choice": "billing", "probabilities": {"billing": 0.91, "technical": 0.06, "account": 0.03}, "confidence": 0.91 },
  "score":  { "value": 1.4, "probabilities": {"0": 0.08, "1": 0.22, "2": 0.70}, "confidence": 0.70 },
  "refund": { "probability": 0.96 }
}

// 宿主程序再添加策略字段
{
  "team": "billing",
  "frustration_score": 1.4,
  "refund_requested": true,
  "route": "human_review",
  "reason": "refund probability is high but operation is high-risk"
}

最后三个字段 route、reason 和是否执行,并不是 Jev 自由生成的文本,而是程序根据概率、风险等级、权限和业务规则计算出来的。这样可以保证:模型负责判断,程序负责字段完整性、默认值、类型转换、阈值和副作用。

7. Choice、Score、Noul 的组装差异

类型模型侧输出宿主程序组装
Choice候选标签或索引、候选概率分布标签映射为业务枚举值,计算置信度和路由
Score量表各等级的分布或期望分数转换为业务分数、优先级或风险等级
Noul条件成立的概率按阈值转换为 true、false 或 need_review

例如 Noul 不应简单地写成“概率大于 0.5 就执行”。更安全的逻辑是把概率阈值和动作风险同时纳入:

\( \text{allow}=\left(p_{\text{allow}}\ge\tau_{\text{allow}}\right)\land\left(r_{\text{action}}\le r_{\text{max}}\right) \)

8. 为什么这套架构能减少级联误差

在传统 JSON 自回归生成中,第 i+1 个字段的输入往往包含第 i 个字段已经生成的文本。一旦前一个字段出现偏差,后续 KV-Cache 可能继续携带这个偏差,形成级联错误。

批量受限决策则让每个问题直接基于原始 Context 和自己的 Schema 分支:

\( a_i=f_i(X_{\text{context}},q_i),\qquad a_i\perp a_j\mid X_{\text{context}}\; (i\ne j) \)

这里的条件独立是架构目标,而不是说业务语义一定独立。程序仍然可以在第一批结果出来后,再有条件地发起第二批问题;但在同一批次中,一个字段不会因为另一个字段生成了错误文本而被迫污染。

9. 吞吐提升不只来自模型,还来自调度和内存布局

  • 减少重复 Prefill:长 Context 只编码一次。
  • 批量矩阵乘:多个问题共享一次 forward 的 kernel 调度,提升硬件利用率。
  • 缩短解码长度:从生成几十到几百个 JSON token,变成一次或少量决策 token。
  • 候选集合裁剪:只处理合法答案对应的 logits,减少无关词表计算。
  • 字段解耦:问题可以并行完成,不必等待前一个字段生成结束。
  • 宿主侧零 token 组装:JSON 序列化、默认值和字段映射由普通代码完成,几乎不占用模型推理时间。

不过,实际吞吐仍受 Context 长度、batch 大小、设备显存、内存带宽、网络 RTT、SDK 序列化和业务后处理影响。因此“成倍提升”应通过真实任务基准验证,而不能仅由单次 logits 计算推导出来。

十四、速度与成本数据应该如何解读

TypeSafe 和社区资料中出现过 70–500 毫秒延迟、比传统 LLM 快几十到数百倍、成本低几十到数百倍等数字。这些数字很有吸引力,但应视为厂商或项目方在特定条件下的自测结果:硬件、网络、批量大小、输入长度、对比模型、是否包含编排和浏览器等待,都会显著影响结果。

工程上更可靠的做法是针对自己的任务建立基准:固定数据集,分别测量端到端延迟、模型延迟、准确率、校准误差、升级率、单位任务成本和副作用错误率。只有当 Jev 在真实流量和风险约束下仍然改善整体指标,才算产生了实际收益。

十五、结论:Jev 代表一种“决策优先”的 AI 工程范式

Jev 最值得关注的地方,不只是某个 API 有多快,而是它重新划分了 AI 系统中的职责:不是所有智能都需要通过生成文字来表达。大量软件任务真正需要的是“选哪个”“是否允许”“风险多高”“是否需要升级”,这些判断可以拥有受限的答案空间、显式的概率和明确的代码边界。

如果把传统 LLM 看作负责深思熟虑的 System 2,那么 Jev 就是负责快速分诊和局部控制的 System 1。最有前景的落地方式,是让两者形成级联:Jev 先以低延迟完成分类、路由和护栏检查;复杂、模糊或高风险任务再交给更强模型或人工。

现阶段,Jev 仍处于早期阶段,官方模型闭源,性能数据主要来自厂商和社区自测。建议从范围明确、可回放、风险较低的任务开始试用,例如工单路由、工具选择、Agent 完成检测和浏览器候选动作选择,并用自己的数据验证准确率、校准和成本。真正成熟的 Jev 系统,最终应当是“模型做判断,代码守边界,外部状态作验收”。

参考资料

从自己出题到自己选题:耶鲁新方法让大模型 Self-Evolution 又进一步

摘自:https://mp.weixin.qq.com/s/eR1m3_i9c24fN0HPHSNaYw

关键词:Self-Evolution、Self-Improvement、INFUSER、Influence Score、AI4AI、合成数据、课程学习

大模型正在越来越会“自己训练自己”。没有足够的人工标注数据?那就让模型自己出题、自己做题,再通过强化学习继续训练自己。这样的 Self-Evolution / Self-Improvement 路线,正在成为近期 AI4AI 中越来越重要的方向。

但这里藏着一个关键问题:

模型自己生成 100 万道题,它怎么知道其中哪些题真的值得学?

一道题很难,不代表它有用;模型做错一道题,也不意味着训练这道题就一定能让模型变强。
来自 Yale、Stanford、UChicago、UCSD 等机构的研究者提出了 INFUSER(Influence-Guided Self-Evolution),给出了一个很有意思的答案:

不要只看一道题难不难,而要看:训练完这道题之后,模型是不是真的朝着我们希望的方向变强了。

换句话说,INFUSER 想让 AI 不只是会“自己出题”,还开始学会判断:什么才是自己当前最值得学的东西。
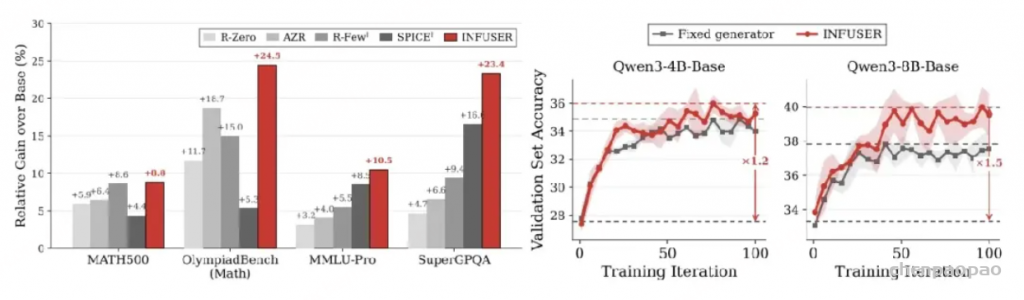
01|Self-Evolution 最大的问题:什么才算一道“好题”?

现在不少 Self-Evolution 方法,基本遵循这样的闭环:

模型生成问题 → 模型回答 → 根据回答结果做强化学习 → 得到更强的模型 → 再继续生成新问题。

真正麻烦的地方在于:我们应该鼓励模型生成什么样的问题?

一种直觉答案是,生成那些“刚好有点难”的问题。如果一道题模型每次都能做对,说明太简单;如果永远做不出来,又可能太难。因此,一些已有方法会寻找模型正确率处于中间区域的问题,把 Difficulty 当成“训练价值”的代理指标。

Hard ≠ Useful。

模型做不出一道题,可能是缺少某种推理能力,也可能只是因为题目写得不好、答案有问题、表述存在歧义,甚至问题本身过于偏门。这样的题当然很“难”,但反复训练未必能提升我们真正关心的能力。

于是 INFUSER 把问题从:

“这道题对模型来说难不难?”

换成了:

“如果模型训练这道题,它会不会真的变得更好?”

这就是整篇工作的核心变化。

02|Influence Score:别看题目本身,看它把模型推向哪里

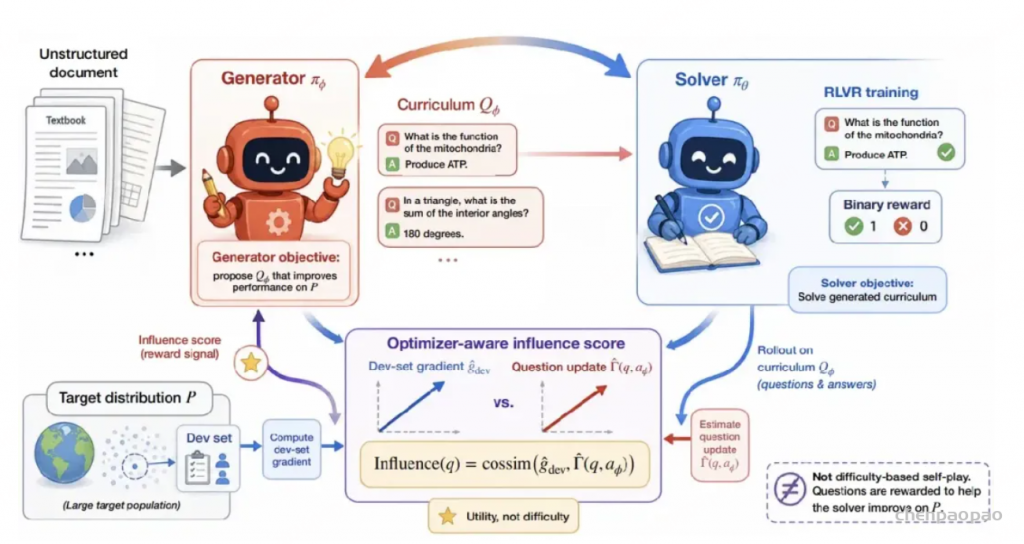
INFUSER 引入了一个核心概念:Influence Score(影响力分数)。

假设我们真正希望模型提升的是某一类目标能力。INFUSER 会保留一小批目标任务的 Dev Set,让模型在这些数据上计算一个目标梯度方向。可以把它粗略理解为:如果模型想在真正关心的任务上表现更好,那么参数应该朝哪个方向更新。

接下来,Generator 生成一道新的训练题,Solver 回答这道题并据此学习,同样产生一个参数更新方向。系统要比较的,就是这两个方向到底有多相似。

cos(g_target, g_question) → 1
如果两个方向高度一致,说明训练这道题恰好让模型朝我们希望的方向前进,这是高价值训练数据。如果两个方向近乎垂直,题目可能很难,但对目标能力帮助不大;如果两个方向相反,训练甚至可能把模型带向错误方向。

因此,INFUSER 对“好数据”的定义发生了变化:

  • 传统指标:Difficulty、Correctness、Quality;
  • INFUSER 更关心:Learning Utility,即这条数据能否对当前模型产生有价值的学习更新。

03|一个 Generator,一个 Solver:两个模型一起进化

INFUSER 系统包含两个核心角色:

  • Generator:负责出题;
  • Solver:负责做题并学习。

两者最初可以来自同一个 pretrained model,但之后拥有独立的参数和优化过程。
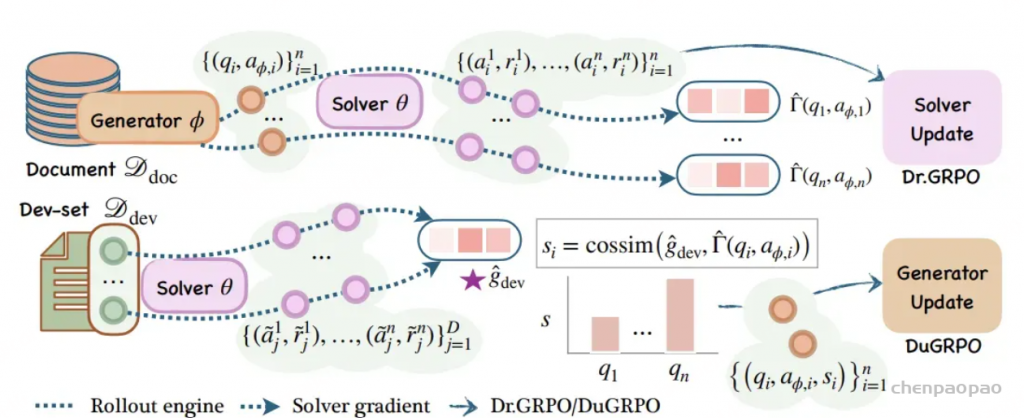
整个训练过程可以概括为四步:

  1. 确定方向:用少量目标 Dev Set 计算 Target Gradient,告诉系统 Solver 最终应该朝哪里变强。
  2. 自动出题:Generator 从教材、科学文本、代码等未标注文档中生成 Question 和 Reference Answer。
  3. Solver 学习:Solver 回答问题,并通过强化学习更新能力。
  4. 反过来训练 Generator:比较每道题造成的 Solver 参数更新与 Target Gradient 的一致性,并把 Influence Score 作为 Generator 的奖励。

于是 Generator 会逐渐发现:“原来这种问题,对现在这个 Solver 最有帮助。”随后,它会倾向于产生更多类似的高价值训练数据,而 Solver 又会因为这些数据不断变强。

最终形成动态闭环:

Generator 出更合适的题 → Solver 变强 → Solver 的能力边界变化 → Generator 重新调整 curriculum → Solver 再继续提升。

这就是 INFUSER 所说的 Co-Evolution。

04|它追求的不是“越来越难”,而是“现在最值得学”

我们很容易把 Self-Improvement 理解成:模型越来越强,于是给自己生成越来越难的问题,再继续把自己练得更强。但 INFUSER 的观点并不是这样。

最难的题,不等于当前最值得学的题。

假设一个模型当前的能力大致如下:

领域当前能力
微积分90%
概率论70%
组合数学40%
拓扑学10%

如果只根据 Difficulty 生成数据,Generator 很可能不断给模型出它完全不会的拓扑学难题。但这些问题距离模型当前能力边界太远,并不一定是最高效的学习材料。

Influence-based Generator 可能发现:当前训练一些中等难度的组合数学问题,反而最能推动整体推理能力提升。

这很像现实中的优秀老师。优秀的老师并不是永远给学生出最难的题,而是知道:这个学生现在到底应该做什么题。

从这个角度看,INFUSER 中的 Generator 已经不只是简单的 Data Generator,而开始像一个 Adaptive Teacher。

05|为什么 Influence Score 没有一路上涨?

既然 Generator 越来越会生成“有价值的问题”,直觉上我们可能认为 Influence Score 应该随训练一路上涨。但论文中的结果并不是这样。
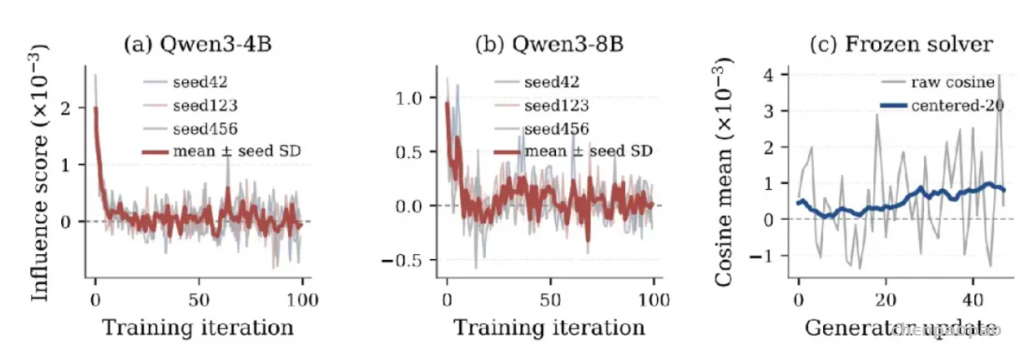
在完整的 INFUSER 训练过程中,Influence Score 早期为正,随后有所下降,并长期在接近 0 的区域附近波动。这并不奇怪,因为 Generator 在学习,Solver 也在学习。

昨天对 Solver 非常有帮助的问题,今天可能已经被 Solver 掌握;今天的高价值数据,到了下一阶段又可能变得过于简单。Generator 实际上一直在追逐一个不断移动的目标:

当前这个 Solver,下一步到底最需要学什么?

作者还做了一个 control experiment:固定 Solver,也固定 document batch,只继续训练 Generator。此时“学生”不再变化,Generator 的 influence alignment 就明显提升。

这说明 Generator 确实可以学会生成更有价值的问题。完整系统中看不到 Influence Score 一路上升,并不是 Generator 没学会,而是 Solver 本身也一直在成长。这恰恰体现了 Co-Evolution:老师越来越会教,学生也越来越会学;学生变强之后,老师又必须调整下一阶段该教什么。

06|甚至,小模型老师可能比大模型老师更会教

论文比较了两种 Generator:一种是随着 Solver 一起进化的 8B Generator;另一种是能力更强、但始终被冻结的 32B Thinking Generator。

按照直觉,32B 模型本身更强,似乎应该更会生成高质量问题。但在 Math 和 Coding 等实验中,INFUSER 中持续 co-evolving 的 8B Generator 反而取得了更好的效果。
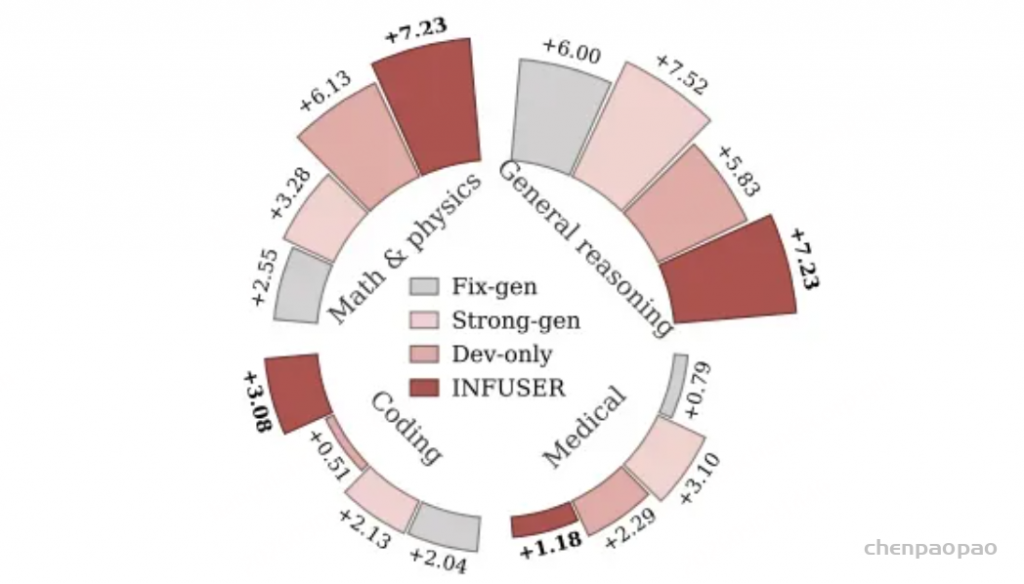
一个更聪明的老师,不一定比一个更了解学生当前状态的老师更会教。

32B Generator 可能知识更多、推理能力更强,但它并不知道现在这个 Solver 到底缺什么。INFUSER 的 Generator 却一直在接收直接反馈:“你刚才出的这道题,究竟有没有让这个学生朝正确方向进步?”

因此,真正重要的可能不只是 Strong Teacher,而是 Adaptive Teacher。

07|实验效果怎么样?

作者分别从 Qwen3-4B-Base 和 Qwen3-8B-Base 出发进行 Self-Evolution,测试覆盖 General Reasoning、Math、Physics、Medical、Coding 等多个方向,共 14 个 benchmark,并与 R-Zero、AZR、R-Few、SPICE 等方法进行比较。
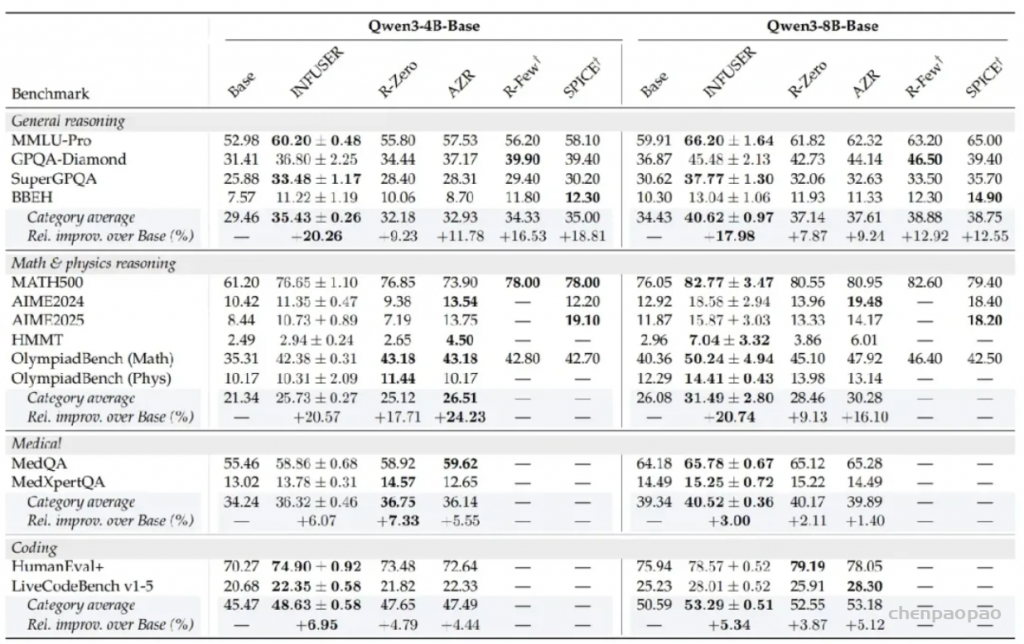
以 Qwen3-8B 为例,在 General Reasoning 上的结果如下:

MethodAverage
Base34.43
R-Zero37.14
AZR37.61
R-Few38.88
SPICE38.75
INFUSER40.62

相比 Base,整体提升约 17.98%。一些单项 benchmark 的变化也比较明显:

  • SuperGPQA:30.62 → 37.77
  • OlympiadBench Math:40.36 → 50.24
  • HMMT:2.96 → 7.04

相比单纯生成更多数据,自动寻找“对当前模型最有学习价值的数据”,可能是 Self-Evolution 更关键的一步。

08|不过,它离“AI 完全自主进化”还有一步

不能把 INFUSER 理解成 AI 已经不需要任何人类信号、可以无限自我进化。它仍然依赖一个关键组件:Target Dev Set。

系统需要一小部分目标数据,通过这些数据计算 Target Gradient,从而告诉 Generator:我们最终希望 Solver 往哪个方向发展。实验也显示,Dev Set 太小时,估计出来的 Target Gradient 会更加 noisy,进而影响训练效果。

所以,更准确的描述是:

少量目标信号 + 大量无标注文档 + 自动生成训练 curriculum。

人类仍然需要回答“模型最终应该往哪里进化”,但一旦方向被给定,AI 开始尝试解决另一个过去高度依赖研究员的问题:

为了往这个方向变强,我下一步究竟应该学什么?

09|从 Data Generator,到 AI Training Scientist

如果只把 INFUSER 看成一种新的 synthetic data 或 RL 方法,可能低估了这项工作的意义。它背后体现的是一个更大的趋势:AI 开始参与“训练 AI”这件事情本身。

传统模型研发闭环大致是:

研究员观察模型 → 分析模型弱点 → 设计数据 → 训练 → Evaluation → 分析结果 → 再设计下一轮数据。

其中包含大量过去只能由 researcher 完成的判断:模型现在缺什么?什么数据最值得加入?下一轮应该训练什么能力?

INFUSER 自动化掉的是其中非常关键的一环:Curriculum Design。

Generator 不再只是批量制造 Question-Answer Pair,而是观察 Solver 当前的学习状态,通过真实的参数更新效果判断什么样的数据最值得当前模型学习。

于是它的角色开始从 Data Generator 逐渐走向 AI Training Scientist。

从更长远的 AI4AI / Self-Improving AI 视角看,完整闭环可能是:

发现问题 → 提出任务 → 生成数据 → 训练模型 → Evaluation → 分析结果 → 决定下一轮实验。

INFUSER 自动化的正是其中一个关键问题:下一步,到底应该让模型学什么?

10|最后

如果只记住 INFUSER 的一个观点,可以记住这一句:

Self-Evolution 的关键,不是让模型给自己出越来越难的题,而是让模型找到“当前最值得学的题”。

过去讨论 synthetic data 时,我们经常问:这条数据本身质量高不高?INFUSER 提供了另一种值得关注的视角:

所谓高质量训练数据,也许不存在完全脱离模型的绝对标准。真正重要的是,它能不能让“当前这个模型”朝我们希望的方向发生改变。

从 Data Quality 到 Learning Utility,从 Difficulty 到 Influence,再从简单的 Data Generator 走向根据模型状态动态调整 curriculum 的 Adaptive Teacher——这或许正是 Self-Improving AI 接下来最值得关注的一条路线。


论文:INFUSER: Influence-Guided Self-Evolution Improves Reasoning

微信公众号文章

原文:微信公众号文章

大模型自动化训练资源技术报告

摘自:Github https://github.com/BinHPdev/awesome-algorithm-auto-tools

整理日期:2026-09-07(十次更新版)
核心方向:用 AI/大模型 自动化驱动模型训练、实验、调优的工具与框架
参考标杆:Karpathy AutoResearch、HuggingFace Skills、AutoML 系列


目录

  1. AI 自主实验 / 研究框架
  2. Agent 驱动的训练 Skills(HuggingFace 生态)
  3. LLM 微调框架(高效训练基础设施)
  4. 强化学习对齐训练框架(RLHF / GRPO)
  5. 自动化超参数优化 / AutoML Agent
  6. 自进化 / Self-Play 训练方法
  7. 合成数据生成与数据治理
  8. 知识蒸馏框架
  9. 模型合并与量化
  10. 轻量级预训练与分布式训练
  11. 推理引擎(RL 训练循环核心组件)
  12. 多模态训练框架
  13. 实验追踪与编排平台
  14. Benchmark 与评测体系
  15. 辅助编码 Agent(可用于训练脚本开发)
  16. 总结对比表与选型指南

1. AI 自主实验 / 研究框架

这一类工具的核心是:让 AI Agent 自主设计实验、修改训练代码、评估结果、循环迭代——人类睡觉,AI 做实验。

1.1 Karpathy AutoResearch ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/karpathy/autoresearch
  • 发布: 2026-03-06
  • 核心理念: AI Agent 自主进行 ML 实验循环:读代码 → 提出假设 → 修改代码 → 训练 5 分钟 → 评估 → 保留/丢弃 → 循环
  • 关键特性:
    • 仅 630 行 Python 代码,极简设计
    • 固定 5 分钟时间预算 → 约 12 次实验/小时,一晚约 100 次实验
    • 基于 nanochat(单 GPU LLM 训练框架)
    • 实际效果: 2 天约 700 次自主实验,发现约 20 个可叠加改进,”Time to GPT-2″ 从 2.02h → 1.80h(11% 效率提升),且改进可迁移到更大模型
  • 适用场景: ML 模型训练调优、超参数搜索、架构探索、训练技巧发现
  • 许可: MIT
  • 为什么重要: 证明了 “AI 自主做 ML 研究” 的范式可行,是本报告的核心参考范式

1.2 Sakana AI Scientist v2 ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/SakanaAI/AI-Scientist-v2
  • 核心理念: 全自动开放式科学发现 → 假设 → 实验设计 → 执行 → 论文撰写
  • 关键特性:
    • Agentic Tree Search:树状搜索实验空间
    • VLM 反馈:视觉语言模型理解实验图表
    • 并行实验执行
    • v2 消除了对人工代码模板的依赖,可跨多个 ML 领域直接部署
  • 相关项目:
    • ShinkaEvolve — 用 LLM 作为变异算子的程序进化框架,用于科学发现
  • 适用场景: 自动化 ML 研究、模型架构搜索、训练策略探索
  • 许可: 开源

1.3 AutoML-Agent ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/DeepAuto-AI/automl-agent
  • 来源: ICML 2025
  • 核心理念: 多 Agent LLM 框架实现全流程 AutoML
  • 关键特性:
    • 并行化专用 Agent:数据预处理、架构设计、超参优化各有专门 Agent
    • 检索增强规划(Retrieval-Augmented Planning)
    • 多阶段验证机制
    • 在 14 个数据集上测试验证
  • 适用场景: 全自动化 ML Pipeline

1.4 auto-ml-agent ⭐⭐⭐⭐

  • GitHub: https://github.com/Nikhil-Doye/auto-ml-agent
  • 核心理念: LLM 编排的自主 ML Pipeline,覆盖完整生命周期
  • 关键特性:
    • 从数据预处理到模型部署全自动化,无需人工干预
    • 多 Agent 架构 + 沙盒执行
    • 自然语言报告
    • Streamlit 界面
  • 适用场景: 端到端自动化数据科学/ML 工程

1.5 MLAgentBench ⭐⭐⭐⭐

  • GitHub: https://github.com/snap-stanford/MLAgentBench
  • 来源: Stanford SNAP Lab
  • 核心理念: 评测 AI Agent 做 ML 实验的能力
  • 关键特性:
    • 13 个端到端 ML 任务(CIFAR-10 到 BabyLM)
    • Agent 可执行:读写文件、执行代码、检查输出
    • Claude v3 Opus 最佳成功率 37.5%
  • 适用场景: 评估/开发 ML 研究 Agent

1.6 AutoAgent ⭐⭐⭐⭐

  • GitHub: https://github.com/HKUDS/AutoAgent
  • 核心理念: 零代码创建和部署 LLM Agent
  • 关键特性:
    • 用自然语言描述需求即可生成 Agent
    • Self-play 自我定制:通过迭代自我改进生成工具、Agent 和工作流
    • 支持自定义工具和环境
  • 适用场景: 快速搭建自动化训练 Agent

1.7 AI-Supervisor ⭐⭐⭐⭐ 🆕

  • 论文: https://arxiv.org/abs/2603.24402
  • 发布: 2026-03-25
  • 核心理念: 通过持久化研究世界模型(Knowledge Graph)实现自主 AI 研究监督
  • 关键特性:
    • 多 Agent 共识协议:专用 Agent 分工进行文献综述、差距发现、方法开发、评估、论文撰写
    • 持续演化的 Research World Model(知识图谱),记录方法、基准、局限和未探索空间
    • 通过 GPU 计算和 API 验证声明,而非仅生成文本
    • 整合 OpenReview 等平台的审稿反馈
  • 适用场景: 全自动化 AI 研究监督与科学发现

1.8 ARIS (Auto-Research-In-Sleep) ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/wanshuiyin/Auto-claude-code-research-in-sleep
  • 核心理念: 轻量级 Markdown-only 技能系统,让 AI 在你睡觉时做 ML 研究
  • 关键特性:
    • 零依赖、零锁定:整个系统仅由纯 Markdown 文件组成
    • 跨模型审查循环:Claude Code 做研究,外部 LLM 做批判性审查
    • 实际效果:一夜 4 轮循环自主运行 20+ GPU 实验,重写论文叙事,剔除站不住脚的声明
    • 兼容任何 LLM Agent(Codex CLI、Cursor、Windsurf 等)
  • 适用场景: 个人研究者的过夜自动化 ML 研究

1.9 AutoKernel ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/RightNow-AI/autokernel
  • 核心理念: 把 “Autoresearch” 范式下沉到 GPU kernel 层——给它任意 PyTorch 模型,睡一觉,醒来得到优化后的 Triton kernel
  • 关键特性:
    • 1.2K+ stars,发展迅速
    • 在 H100 上对 RMSNorm 相比 PyTorch eager 实现了 5.29x 加速
    • 与 KernelBench 集成,自动评测生成的 kernel
    • 自主 Agent 循环:profile → 合成 → 验证 → 迭代
  • 适用场景: 训练基础设施优化;为自定义算子寻找高性能 kernel 实现

1.10 KernelAgent(Meta PyTorch)⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/meta-pytorch/KernelAgent
  • 核心理念: Meta 官方的自主 GPU kernel 生成与优化 Deep Agent 框架
  • 关键特性:
    • 隶属 meta-pytorch 官方组织
    • Auto-discover 策略自动探索 kernel 优化空间
    • 多模型中继(multi-model relay):不同能力的 LLM 分工协作
    • 2026-04 持续活跃,RMSNorm agent 等重点算子重构陆续落地
  • 适用场景: 大厂级训练基础设施 kernel 自动化;替代手写 CUDA

1.11 PaperOrchestra ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/Ar9av/PaperOrchestra
  • 核心理念: 基于 Google PaperOrchestra 论文的开源实现——把粗想法 + 原始实验日志,自动转换成可投稿级 LaTeX 论文
  • 关键特性:
    • 无需 API Key、无需 LLM SDK,纯通过 Coding Agent 的 Skill 调度
    • 支持 Claude Code、Cursor、Antigravity、Cline、Aider 等主流编码 Agent
    • 多 Agent 协作:写作 + 文献综述 + 引用验证 + 配图
    • 在 PaperWritingBench 上超越单 Agent 与树搜索基线
  • 适用场景: AI 自主研究闭环的最后一公里——从实验结果到论文产出

1.12 Deep Researcher Agent ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/Xiangyue-Zhang/auto-deep-researcher-24×7
  • 论文: https://arxiv.org/abs/2604.05854
  • 来源: 东京大学(2026-04-07)
  • 核心理念: 让 LLM Agent 全天候(24/7)自主运行深度学习实验,覆盖从假设提出到结果分析的完整实验生命周期
  • 关键特性:
    • 零成本监控:模型训练期间仅依赖进程级检查和日志读取,LLM API 调用成本为零
    • 双层恒定内存:上限约 5K 字符,无论运行多长时间均不增长,防止上下文爆炸
    • 最小工具集 Leader-Worker 架构:每个 Worker Agent 仅配备 3–5 个工具,每次调用 token 开销降低达 73%
    • 实际效果:持续部署 30+ 天,在 4 个并行研究项目中自主完成 500+ 实验循环;单个项目经 200+ 自动实验后基线提升 52%
    • 平均 LLM 成本仅 $0.08 / 24 小时
  • 适用场景: 资源受限的个人研究者;需要长期无人值守自动化实验的项目

1.13 AI-Researcher(港大)⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/HKUDS/AI-Researcher
  • 论文: https://arxiv.org/abs/2505.18705
  • 来源: 香港大学数据智能实验室(NeurIPS 2025 Spotlight)
  • 核心理念: 全自动研究系统——文献综述 → 假设生成 → 算法实现 → 论文撰写,最小人工干预
  • 关键特性:
    • 4.8K+ GitHub stars,NeurIPS 2025 Spotlight 论文
    • Resource Analyst Agent:将研究概念分解为原子组件,建立数学公式与代码实现的双向映射,大幅降低幻觉风险
    • 迭代精炼范式:专用 Agent 通过结构化反馈循环协作(写作、文献综述、引用验证、配图)
    • 层次化论文合成(Documentation Agent),解决长文本连贯性问题
    • Scientist-Bench:首个标准化自主研究评测基准,22 篇论文、多个 AI 领域
    • 生产就绪:已在 Novix 平台(novix.science)部署为商用 AI Co-Scientist
  • 适用场景: 自动化 ML 研究;从实验到论文的完整自动化闭环

1.14 Deli_AutoResearch ⭐⭐⭐⭐ 🆕

  • 作者/主页: Chen Deli(陈德力,GitHub @victorchen96)— https://victorchen96.github.io/auto_research/framework.html
  • 核心理念: 面向「长周期(数天到数周)」自主任务的协议框架——只规定约定/规范而非提供可执行代码,专治长程 Agent 的三大失效模式:认知死循环、停滞、运行时崩溃
  • 关键特性:
    • 编排器 + 全新会话 Worker:每个任务在隔离的新会话中执行,只从状态文件读取精炼上下文,从不靠对话历史续跑 → 杜绝上下文累积
    • 防循环机制:强制方向多样性,stale_count ≥ 2 时结构性切换方向
    • 三层心跳看门狗:Shell 守护(L0)+ 每小时调度(L1)+ 业务循环回调(L2),检测超过 2 小时的停滞
    • 状态持久化:progress.json / findings.jsonl / directions_tried.json 等版本化 JSON 文件
    • 行为约束:运行期间零用户交互、”ready 即执行”(动作前不二次确认)、guardian/worker 角色分离
    • 实测:自主产出 4 篇综述论文(59–75 页 / 共 265 页、1158 引用、自评 8.5+/10),含一个 285B 参数 GRPO 实验;最长单次连续运行 72 小时,约 44h 产出全部 4 篇
  • 适用场景: 需要数天/数周无人值守的长程自主研究;强调「执行与评估分离 + 量化停滞指标」的 Agent 编排范式

1.15 AutoResearchClaw ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/aiming-lab/AutoResearchClaw
  • 一句话: “Chat an Idea. Get a Paper. 🦞”——全自主、自进化的「想法 → 论文」研究流水线
  • 核心理念: 输入一个研究主题,经 23 阶段流水线自动产出含真实文献引用、沙箱实验、统计分析、同行评审、会议级 LaTeX 的完整论文
  • 关键特性:
    • 13.5K+ stars,MIT 许可,2026-05 仍活跃(v0.5.0 引入多领域实验 Agent + ARC-Bench)
    • 多源文献发现:OpenAlex / Semantic Scholar / arXiv 真实论文,4 层引用验证防幻觉
    • 硬件感知执行:自动识别 NVIDIA GPU / Apple MPS / CPU;OpenCode Beast Mode 生成复杂实验
    • 6 种人机协作模式:full-auto / gate-only / checkpoint / step-by-step / co-pilot / custom,配 Idea Workshop、Baseline Navigator、Paper Co-Writer
    • 自学习:经 MetaClaw 从每次运行中提炼经验;反伪造实验诊断与修复循环
    • 已演示在 8 个领域(数学、统计、生物、计算、NLP、RL、视觉、鲁棒性)自动产出 8 篇论文
  • 适用场景: 端到端自主科研;从一个 idea 直接产出可投稿论文,可按需插入人工干预

1.16 pi-autoresearch ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/davebcn87/pi-autoresearch
  • 核心理念: 把 Karpathy 的 autoresearch 循环从「ML 专用」泛化为领域无关的通用优化原语——任何可量化为数字的指标都能自主优化
  • 关键特性:
    • 7K+ stars,MIT 许可,2026-06 活跃
    • 扩展 = 基础设施,Skill = 领域知识:一个 extension 服务无限领域,只需换 skill
    • 可优化任意可测指标:测试执行时间、JS bundle 体积、构建速度、Lighthouse 分数、LLM 训练 loss……
    • 「试想法 → 测量 → 保留有效 → 回滚回退 → 永远循环」,每次实验追加写入 JSONL + markdown 会话文档
    • 可断点续跑:跨重启、跨 context reset 无缝恢复
    • 配套生态:pi-autoresearch-studio(仪表盘 + 计划编辑器 + PR 工作流编排)
  • 适用场景: 不限于 ML 的工程优化闭环——前端性能、构建提速、测试加速等任何「输出一个数字」的任务

1.17 OpenScience ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/synthetic-sciences/openscience
  • 官网/文档: https://www.openscience.sh/
  • 发布: 2026-07-05(2026-07-22 持续更新)
  • 来源: Synthetic Sciences
  • 核心理念: 模型无关的开源「AI 科研工作台」——把整个科研闭环交给 Agent 自主运行,覆盖机器学习、生物、物理、化学等领域,而不只是文献阅读
  • 关键特性:
    • 跑完整研究循环:文献调研 → 提出假设 → 编写代码 → 在真实算力上执行实验 → 分析结果 → 撰写报告
    • 模型完全可切换:任意模型皆可用(Claude、GPT、Gemini、GLM、Kimi、DeepSeek、本地微调模型),可按请求逐次切换
    • 内置 250+ 可编辑 Skills + 30+ 科学数据库(UniProt、PDB、ChEMBL、arXiv 等)作为 Agent 工具
    • 本地优先、无遥测:Agent 循环、Skills、数据库工具与工作区全部开源在仓库中,API Key 留在本机、请求直连提供商
    • Apache-2.0 许可,TypeScript 实现,可自托管
  • 适用场景: 需要把「读文献 → 假设 → 实验 → 论文」全链路交给 Agent 的跨学科自主科研;ML 之外的科学发现闭环

1.18 Arbor(人大 NLPIR)⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/RUC-NLPIR/Arbor
  • 论文: https://arxiv.org/abs/2606.11926(Toward Generalist Autonomous Research via Hypothesis-Tree Refinement)
  • 项目主页: https://ruc-nlpir.github.io/Arbor/
  • 来源: 中国人民大学 NLPIR 实验室(2026-06)
  • 核心理念: 通用自主研究 Agent——用 HTR(Hypothesis Tree Refinement,假设树精炼) 把自主研究从「一串孤立的局部尝试」变成「跨时间累积的过程」
  • 关键特性:
    • 长生命周期 Coordinator + 短生命周期 Executor:Coordinator 作为「研究总监」维护 Idea Tree、驱动 arbor 循环、派发实验;Executor 作为「研究工程师」在隔离的 git worktree 中忠实实现代码改动并跑实验
    • 持久化假设树:每个节点绑定「假设 + 实现该假设的产物版本 + 实验证据 + 提炼出的洞见」,结果、失败模式与洞见向上传播,后续想法起点更高,而不是随上下文滚动丢失
    • AO(Autonomous Optimization,自主优化)设定:不绑定特定 benchmark,只要「有可优化的产物 + 明确目标 + 可执行反馈信号」即可长程搜索——统一覆盖模型训练、Harness 工程、数据合成三类研究任务
    • 实测:6 个真实研究任务上 held-out 结果全部最优;同等资源预算下平均相对增益达 Codex 与 Claude Code 的 2.5 倍以上;同一 Controller 可直接迁移到 MLE-Bench Lite
    • v0.1.0 发布,890+ stars
  • 适用场景: 需要跨实验累积经验的长程自主研究;模型训练调优、Agent Harness 工程、数据合成流程的自主优化

1.19 Sibyl-AutoResearch ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/Sibyl-Research-Team/AutoResearch-SibylSystem
  • 论文: https://arxiv.org/abs/2605.22343(Autonomous Research Needs Self-Evolving Trial-and-Error Harnesses, Not Paper Generators)
  • 核心理念: 论文标题即观点——自主研究需要的是「自进化的试错 Harness」,而不是「论文生成器」;Harness 让 Agent 跑有界试验,同时保留正面与负面结果,并把教训回流到后续规划、验证、结论范围界定、调度、批判与写作中
  • 关键特性:
    • 双层自进化:过去的试验改变未来的研究行为;反复出现的流程性失败则改变 Harness 本身
    • 20+ 专用 Agent + 19 阶段状态机流水线:文献调研 → 想法生成 → 实验设计与执行 → 结果分析 → 论文撰写 → 同行评审,全程无需人工介入
    • Claude Code 原生(非 API 包装):直接构建在 fork skills、agent teams、MCP 工具之上,继承 SSH 远程执行、多模型交叉评审、云端同步等生态能力
    • GPU 实验并行调度(拓扑排序),文件化状态存储
  • 适用场景: 有 GPU 资源、希望以「组织」形态运行自主科研的团队;关注 Harness 自身可进化性而非单次论文产出的研究者

2. Agent 驱动的训练 Skills(HuggingFace 生态)

这一类的核心创新是:让编程 Agent(如 Claude Code)通过自然语言指令完成模型训练全流程。

2.1 HuggingFace Skills ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/huggingface/skills
  • 核心理念: 为 AI 编程 Agent 提供标准化的 ML 任务 Skill 包,用一句英文就能微调模型
  • 支持 Agent: Claude Code、OpenAI Codex、Google Gemini CLI、Cursor
Skill 名称功能关键技术
hugging-face-model-trainer微调语言模型TRL(SFT、DPO、GRPO),0.5B-70B
hugging-face-vision-trainer训练视觉模型RTDETRv2、YOLOS、DETR、ViT
hugging-face-jobs在 HF 基础设施上运行计算任务云 GPU 调度、成本估算
hugging-face-trackio实验追踪与指标记录实时 metrics logging
hugging-face-evaluation模型评估并更新 model cardlighteval
hugging-face-datasets创建/管理数据集Hub API
hugging-face-dataset-viewer数据集查询与探索REST API
hf-cliHub 操作(上传/下载/管理仓库)CLI
gradio构建交互式 DemoWeb UI
hugging-face-tool-builder构建可复用 API 自动化脚本Python
hugging-face-paper-publisher发布研究论文到 Hub—
transformers-js在 JS/TS 中运行 ML 模型ONNX Runtime
  • 典型工作流:
    1. 用自然语言告诉 Claude Code: “用 GRPO 在这个数据集上微调 Qwen-2.5-7B”
    2. Agent 自动生成训练脚本 → 提交到 HF Jobs → 监控训练指标 → 评估 checkpoint → 推送模型到 Hub
  • 为什么重要: 这是 “Vibe Training” 的范式——用自然语言驱动完整训练流程

2.2 HuggingFace AutoTrain ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/huggingface/autotrain-advanced
  • 官网: https://huggingface.co/autotrain
  • 论文: https://arxiv.org/abs/2410.15735
  • 核心理念: No-code 模型训练平台——上传数据,选择任务,自动完成一切
  • 支持任务:
    • LLM 微调(SFT)
    • VLM 微调
    • 文本分类/回归
    • Token 分类
    • Seq2Seq
    • Sentence Transformers 微调
    • 图像分类/回归
    • 表格数据分类/回归
  • 关键特性:
    • 自动选择最优模型
    • 自动处理训练、评估、Hub 发布
    • 免费使用(仅付计算资源费)
    • 支持本地运行或 HF Spaces
  • 适用场景: 快速原型验证、非 ML 专家的模型训练

2.3 ml-intern ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/huggingface/ml-intern
  • 核心理念: HuggingFace 官方开源 “ML 工程师实习生”——读论文、实现想法、在 HF Jobs 上跑端到端 LLM 后训练
  • 关键特性:
    • 900+ stars,2026-04-21 正式公开
    • 基于 smolagents 构建,深度整合 HF Hub / Jobs 生态
    • 提供 CLI 与 Web UI 两种交互方式
    • 覆盖完整后训练流程:SFT、DPO、GRPO 等
    • 每日活跃提交,迭代速度快
  • 适用场景: 需要把”想法 → 实验 → 落地模型”全链路交给 Agent 的 HF 用户

3. LLM 微调框架(高效训练基础设施)

这些是实际执行训练的”引擎”。AutoResearch / HF Skills 等上层 Agent 最终都需要调用这些框架。

3.1 Unsloth ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/unslothai/unsloth
  • 官网: https://unsloth.ai
  • 核心优势: 2x 训练速度,70% 更少显存
  • 关键特性:
    • 自定义 CUDA kernel,单 GPU 场景无敌
    • 支持 SFT + RL(GRPO、DPO、PPO)
    • FP8 强化学习:额外 1.4x 加速 + 60% 更少显存
    • 长上下文推理训练:仅 5GB VRAM 即可训练推理模型
    • MoE 模型训练:12x 更快,35% 更少 VRAM
    • 支持 GGUF 转换
    • Unsloth MCP Server: https://github.com/OtotaO/unsloth-mcp-server — 可被 AI Agent 直接调用
  • 支持模型: GPT-oss、DeepSeek、Qwen、Llama、Gemma 等
  • 适用场景: 单 GPU 高效微调、资源受限环境

3.2 Axolotl ⭐⭐⭐⭐⭐

  • 核心优势: 灵活性 + 生产就绪
  • 关键特性:
    • YAML 配置驱动,极易上手
    • v0.8.x: QAT(量化感知训练)、序列并行(长上下文)、GRPO(推理训练)、完整 RLHF Pipeline
    • 社区活跃,新模型/技术支持快
  • 适用场景: 生产级多 GPU 微调

3.3 LLaMA-Factory (LlamaFactory) ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/hiyouga/LlamaFactory
  • 核心优势: Web UI 一站式微调
  • 关键特性:
    • LlamaBoard Web UI:浏览器中配置和启动训练
    • 支持 100+ 模型
    • v0.9.4: OFT 支持、Megatron-LM 集成、KTransformers 后端
    • 支持 SFT、RLHF、DPO、PPO 等多种训练方法
  • 适用场景: 快速实验 + 不想写代码的场景

3.4 TRL (Transformer Reinforcement Learning) ⭐⭐⭐⭐⭐

  • 来源: HuggingFace 官方
  • 核心优势: HuggingFace 生态的 RL 训练标准库
  • 支持方法: SFT、DPO、GRPO、PPO、KTO、ORPO
  • 特点: 与 Transformers / PEFT / Accelerate 深度集成
  • 适用场景: 对齐训练、推理能力训练(是 HF Skills model-trainer 的底层引擎)

3.5 torchtune ⭐⭐⭐⭐

  • 来源: PyTorch 官方(Meta)
  • 核心优势: PyTorch 原生,无额外抽象层
  • 关键特性:
    • 2025-02 支持多节点训练
    • 高度可扩展
    • 与 PyTorch 生态无缝集成
  • 适用场景: 需要深度自定义训练流程的研究者

3.6 NVIDIA NeMo AutoModel ⭐⭐⭐⭐

  • GitHub: https://github.com/NVIDIA-NeMo/Automodel
  • 核心优势: NVIDIA 官方,DTensor-native SPMD,Day-0 HuggingFace 支持
  • 关键特性:
    • 从单节点到多节点多 GPU 无缝扩展
    • 支持 PEFT (LoRA) 和全量 SFT
    • 持续更新支持最新模型(DeepSeek-V3.2、Qwen3 等)
  • 适用场景: NVIDIA GPU 集群上的大规模训练

3.7 LMFlow ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/OptimalScale/LMFlow
  • 核心优势: 可扩展的大模型微调与推理工具箱
  • 关键特性:
    • LISA 内存高效训练(性能超越 LoRA)
    • FlashAttention-1/2 支持
    • NTK 缩放支持长上下文
    • NAACL Best Demo Paper
  • 适用场景: 需要内存高效训练的研究项目

3.8 H2O LLM Studio ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/h2oai/h2o-llmstudio
  • 核心优势: 无代码 GUI 微调框架
  • 关键特性:
    • 浏览器端 UI,无需编写代码
    • 支持 LoRA / 4-bit / 8-bit 量化训练
    • 支持 DPO / IPO / KTO 对齐方法
    • 回归与分类问题类型
    • 集成 W&B / Neptune 实验追踪
  • 适用场景: 团队快速验证、非技术用户

3.9 LitGPT ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/Lightning-AI/litgpt
  • 核心优势: 20+ 高性能 LLM 的预训练/微调/部署一体化
  • 关键特性:
    • CLI 驱动(litgpt finetune/pretrain/evaluate)
    • 4-bit & 8-bit 量化支持
    • 曾驱动 TinyLlama 项目
    • NeurIPS 2023 LLM Efficiency Challenge 起始套件
  • 适用场景: 快速原型 + CLI 偏好用户

3.10 InstructLab ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/instructlab
  • 来源: IBM / Red Hat
  • 核心优势: 通过合成数据协作定制 LLM
  • 关键特性:
    • LAB 对齐方法
    • 基于分类学(Taxonomy)的技能贡献机制
    • 从少量人工种子数据生成大规模训练数据
    • 面向 Granite 模型族
  • 适用场景: 社区协作式模型改进

4. 强化学习对齐训练框架(RLHF / GRPO)

2025-2026 趋势:GRPO(Group Relative Policy Optimization)正在取代 PPO 成为默认对齐方法——无需 Critic 模型,更简单稳定。
2026 新趋势:各大厂和实验室纷纷开源自己的 RL 训练框架,形成百花齐放格局。

4.1 OpenRLHF ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/OpenRLHF/OpenRLHF
  • 核心优势: 高性能 RLHF 框架,Ray + vLLM 分布式架构
  • 关键特性:
    • 支持 70B+ 全量微调
    • PPO、DAPO、REINFORCE++、TIS
    • 异步 RL 训练 (--async_train)
    • 异步 Agent RLHF (--agent_func_path)
    • MARTI 分支: 多 Agent RL 训练系统
    • OpenRLHF-M: 多模态模型 RLHF
  • 适用场景: 大规模 RLHF/对齐训练

4.2 verl(Volcano Engine RL)⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/volcengine/verl
  • 来源: 字节跳动火山引擎
  • 核心优势: 高性能、功能丰富的 LLM RL 训练栈
  • 关键特性:
    • HybridFlow 架构论文
    • 几行代码即可实现 GRPO/PPO
    • 3D-HybridEngine:集成 FSDP、Megatron-LM、vLLM、SGLang
    • 使用方: ByteDance、Alibaba Qwen、Anyscale、LMSys、UC Berkeley
  • 适用场景: 生产级 RL 训练,已被工业界广泛验证

4.3 DAPO ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/BytedTsinghua-SIA/DAPO
  • 来源: 字节跳动 Seed + 清华 AIR
  • 核心优势: 开源 RL 系统,AIME 2024 上达到 50 分
  • 关键特性:
    • 4 项关键稳定性技术:Clip-Higher、Dynamic Sampling、Token-Level PG Loss、Overlong Reward Shaping
    • 基于 verl 构建
    • Qwen2.5-32B 上验证效果
  • 适用场景: 数学推理能力 RL 训练

4.4 AReaL ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/inclusionAI/AReaL
  • 来源: 蚂蚁集团 + 清华大学
  • 核心优势: 全异步 RL 训练,速度最快
  • 关键特性:
    • v0.3: 相比同步训练 2.77x 加速
    • AReaL-lite 版本减少 80% 代码量
    • 升腾 NPU 支持
    • GSPO 算法
  • 适用场景: 追求极致训练速度的场景

4.5 slime ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/THUDM/slime
  • 来源: 清华大学 / GLM 团队
  • 核心优势: 驱动 GLM-4.5/4.6/4.7/5 模型训练的 RL 框架
  • 关键特性:
    • Megatron + SGLang 架构
    • 支持 Qwen3、DeepSeek V3
    • RLVE:400 个可验证环境
    • TritonForge GPU kernel 训练
  • 适用场景: 大规模模型的 RL 后训练

4.6 NeMo RL ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/NVIDIA-NeMo/RL
  • 来源: NVIDIA 官方
  • 核心优势: 可扩展的后训练 RL 库
  • 关键特性:
    • 支持 GRPO、SFT、DPO、DAPO 算法
    • Ray 资源管理
    • Megatron Core 并行
    • 训练了 Nemotron-3-Nano-30B
  • 适用场景: NVIDIA 生态的 RL 训练

4.7 NeMo Gym ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/NVIDIA-NeMo/Gym
  • 来源: NVIDIA 官方
  • 核心优势: 为 LLM 训练构建 RL 环境
  • 关键特性:
    • 多步骤、多轮环境脚手架
    • 与 NeMo RL、OpenRLHF、TRL、Unsloth 互操作
    • 内置 Reasoning Gym 和 Aviary 环境
  • 适用场景: 构建自定义 RL 训练环境

4.8 rLLM ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/rllm-org/rllm
  • 核心优势: 后训练(Post-training)RL 框架,专注于 Agent 训练
  • 关键特性:
    • 自定义 Agent + 环境 → RL 训练 → 部署
    • v0.2: AgentWorkflowEngine,支持任意 Agentic 程序训练
    • LoRA + VLM 训练支持
    • 实际案例: rLLM-FinQA-4B(4B 参数)在金融分析任务上超越 Qwen3-235B
  • 适用场景: Agent 能力 RL 训练

4.9 RAGEN ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/RAGEN-AI/RAGEN
  • 核心优势: 多轮 RL 框架,专注推理 Agent 训练
  • 关键特性:
    • StarPO 框架
    • 10 个内置环境(Sokoban、WebShop、Lean 等)
    • 发现并定义了 “Echo Trap” 训练不稳定性问题
    • RAGEN V2(2026-03)
  • 适用场景: 推理 Agent 的多轮 RL 训练

4.10 f-GRPO ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/rhaldarpurdue/f-GRPO
  • 论文: https://arxiv.org/abs/2602.05946
  • 核心优势: 基于 f-散度的 GRPO 扩展,提供更灵活的策略优化
  • 关键特性:
    • 支持 KL、反向 KL、Pearson、Hellinger、Jensen-Shannon、全变差等多种 f-散度
    • 在 RLVR(数学推理)和 PA(安全对齐)任务上均优于标准 GRPO
    • 基于 Unsloth 框架构建
  • 适用场景: 需要更精细控制策略优化方向的 RL 对齐训练

4.11 Tree-GRPO ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/AMAP-ML/Tree-GRPO
  • 来源: ICLR 2026
  • 核心优势: 用树搜索替代链式采样,大幅降低 RL 训练的采样开销
  • 关键特性:
    • 基于 ReAct 步骤级节点的语义搜索树
    • 共享前缀使得相同 token 预算下可获 4 倍 采样量
    • 树结构自然生成步骤级过程监督信号(仅需结果奖励)
    • 基于 Qwen2.5-3B 验证
  • 适用场景: LLM Agent 的 RL 训练,尤其适合多步推理和工具调用

4.12 SimpleRL-Reason ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/hkust-nlp/simpleRL-reason
  • 来源: 香港科技大学
  • 核心优势: 极简推理 RL 训练方案
  • 关键特性:
    • DeepSeek-R1 风格训练
    • 7B 模型仅需 8K 样本即达 33.3% AIME、77.2% MATH
    • 基于规则的奖励,无需 SFT 或 Reward Model
  • 适用场景: 低资源推理能力训练

4.13 SWE-RL ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/facebookresearch/swe-rl
  • 来源: Meta(NeurIPS 2025)
  • 核心优势: 面向软件工程推理的 RL 训练
  • 关键特性:
    • Llama3-SWE-RL-70B 在 SWE-bench Verified 上达 41%
    • 从开源软件演进数据中学习
    • Agentless Mini 自动代码修复框架
  • 适用场景: 训练编程 Agent

4.14 OpenManus-RL ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/OpenManus/OpenManus-RL
  • 来源: UIUC + MetaGPT 团队
  • 核心优势: 面向 LLM Agent 的 RL 微调
  • 关键特性:
    • PPO + AgentGym 环境 + verl 训练
    • 在 GAIA、AgentBench、WebShop、OSWorld 上测试
  • 适用场景: 通用 Agent 能力 RL 训练

4.15 Reasoning Gym ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/open-thought/reasoning-gym
  • 来源: NeurIPS 2025 Spotlight
  • 核心优势: 程序化推理环境集合
  • 关键特性:
    • 100+ 任务覆盖代数、算法、逻辑、游戏、几何
    • 无限可控任务生成
    • 已验证跨领域迁移效果
  • 适用场景: RLVR(基于可验证奖励的 RL)训练

4.16 LlamaGym ⭐⭐⭐

  • GitHub: https://github.com/KhoomeiK/LlamaGym
  • 核心理念: 用在线强化学习微调 LLM Agent
  • 特点: 定义 Agent → 创建 LLM → 编写 RL Loop
  • 适用场景: 快速实验 Agent RL 训练

4.17 ART (Agent Reinforcement Trainer) ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/OpenPipe/ART
  • 官方文档: https://art.openpipe.ai
  • 来源: OpenPipe
  • 核心理念: 开源 RL 框架,专为多步骤真实任务 Agent 训练设计——把 GRPO 引入任意 Python Agent 应用
  • 关键特性:
    • 原生多轮 + 工具调用支持:将每次 Agent 运行记录为完整 Trajectory(行动历史),天然适配工具调用和多轮对话
    • vLLM 负责推理 + Unsloth-powered GRPO 负责训练;每轮训练后自动加载新 LoRA checkpoint 到推理服务器
    • LangGraph 集成:直接对 LangGraph Agent 进行 RL 训练
    • MCP·RL:自动训练模型高效使用任意 MCP Server 工具
    • RULER:自动奖励生成,简化 reward function 设计
    • 客户端可在本地运行,服务端启动临时 GPU 环境,解耦部署
    • 支持 Qwen3.5、Llama、GPT-OSS 等主流模型
  • 适用场景: 需要把现有多步骤 Agent 应用(LangGraph / MCP)升级为可通过 RL 自我优化的智能 Agent

4.18 MARTI ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/TsinghuaC3I/MARTI
  • 来源: 清华大学 C3I(智能计算)研究组
  • 核心理念: 面向 LLM 多 Agent 系统的强化学习训练与推理框架——将中心化多 Agent 交互与分布式策略训练统一集成
  • 关键特性:
    • 基于 OpenRLHF 构建,整合最新 RL 训练技术,支持异质多 Agent 训练
    • 多轮异步 Rollout:提升训练效率,支持动态工作流
    • 动态奖励系统:同时支持基于规则的可验证奖励 + LLM 生成奖励
    • 高级 RL 技术:GSPO loss(序列级优化)、TIS 纠正、动态数据过滤、超长序列缓冲(最高 32K token)
    • MARTI-v2(2026-02):MARS2——树搜索增强的 RL,专为复杂代码生成推理设计,自适应节点扩展与精炼
  • 适用场景: 多 Agent 系统的 RL 训练;超长序列 RL;代码生成 Agent 树搜索 RL

4.19 Arctic RL(Snowflake)⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/Snowflake-AI-Research/Arctic-Platform
  • 官方博客: https://www.snowflake.com/en/blog/engineering/arctic-rl-open-source-backend/
  • 发布: 2026-06-29
  • 来源: Snowflake AI Research
  • 核心理念: 面向企业级 RL 后训练的开源系统基础设施与后端层——把 RL 算法逻辑与底层 GPU 系统优化解耦,让框架开发者专注算法
  • 关键特性:
    • ZoRRo(Zero Redundancy Rollouts,零冗余 Rollout):RL 训练(PPO/GRPO)中同一 prompt 被反复采样,长序列任务下 80–95% 的 token 是重复的 prompt token,配合注意力 O(n²) 开销成为主要成本;ZoRRo 自动去重、每个唯一 prompt 只打包/前向一次
    • 性能:Actor 更新最高 6x 加速、端到端 3.5x 加速;Arctic-Text2SQL-R2 训练从约 5 天缩短到 32 张 H200 上约 36 小时
    • 作为高吞吐 RL 训练/推理后端,可插入现有 RL 框架,非替代式重写
  • 适用场景: 长上下文 RL 训练的系统级提速;企业级大规模 RLHF/RLVR 降本

4.20 OpenRL(Google GKE Labs)⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/gke-labs/open-rl
  • 官方博客: https://opensource.googleblog.com/2026/06/introducing-openrl-a-self-hosted-post-training-api-for-fine-tuning-llms.html
  • 发布: 2026-06
  • 来源: Google GKE Labs
  • 核心理念: 自托管的后训练/微调 API——把 RL 基础设施从 AI 研究中抽象出来,让 ML 团队在自己的 Kubernetes 集群上扩展后训练工作流
  • 关键特性:
    • 实现 Tinker 兼容 API:用 Tinker SDK 从本地机器用命令式 Python 代码编排 RL 训练循环
    • 可在单机或 Kubernetes 集群上运行,起步聚焦 LoRA 微调
    • 多 RL 任务并行调度提升整体 GPU 利用率——传统 RL 循环严格串行,reward 计算等 CPU/网络任务常使 GPU 空闲
  • 适用场景: 需要在自有基础设施(K8s)上自托管、可扩展后训练的团队;Tinker 生态用户

4.21 OpenClaw-RL ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/Gen-Verse/OpenClaw-RL
  • 论文: https://huggingface.co/papers/2603.10165
  • 来源: 普林斯顿大学 / Gen-Verse
  • 核心理念: “Train any agent simply by talking”——全异步 RL 框架,把日常对话变成训练信号,在在线部署期间持续优化 Agent 策略,不打断使用
  • 关键特性:
    • 把自托管模型包装为 OpenAI 兼容 API,拦截实时多轮对话并在后台持续优化策略
    • 四组件全异步解耦:策略服务、环境执行、奖励评判、模型训练各自独立异步循环
    • 捕获转瞬即逝的”下一状态信号”(如用户纠正、终端 trace 报错),用标量过程奖励模型(PRM)+ token 级 Hindsight-Guided On-Policy Distillation(OPD)转换为优化梯度
    • 零人工标注;三种学习范式(Binary RL / OPD / Combine);同时支持个人 Agent 与通用 Agent;大规模环境并行
  • 适用场景: 部署即训练的常驻式在线 RL;个性化 Agent 持续自我改进

4.22 vime(vLLM 官方)⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/vllm-project/vime
  • 官方博客: https://vllm.ai/blog/2026-06-09-announcing-vime
  • 发布: 2026-06-09
  • 来源: vLLM 社区(官方项目)
  • 核心理念: vLLM 生态原生的 RL 后训练框架——”简单、稳定、高效”,把 Megatron 训练与 vLLM 推理统一到一条流水线
  • 关键特性:
    • 沿用 slime 成熟的训练栈与数据生成设计,默认用 vLLM(vllm-router)作为 rollout 后端
    • 三阶段解耦的训推架构:训练(Megatron)负责参数更新与权重同步,rollout(vLLM + Router)负责推理采样并产出带奖励/验证信号的训练样本
    • 全异步流水线 + 训推不一致(train-inference mismatch)纠正,保证训练稳定
    • 原生支持 Agentic RL:多轮工具调用与多 Agent 场景;快速跟进 MoE、VLM 等新架构
    • 继承 slime 的广泛模型支持(Qwen 系列、DeepSeek V3 等);已获 AMD ROCm 原生支持(MI355X 端到端 RL)
    • Apache-2.0 许可
  • 适用场景: 已在用 vLLM 推理栈、希望用同一生态做 RL 后训练的团队;追求训推对齐稳定性的 RL 训练

4.23 dLLM-RL(TraceRL)⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/Gen-Verse/dLLM-RL
  • 论文: https://arxiv.org/abs/2509.06949(TraceRL,ICLR 2026)
  • 来源: 普林斯顿 / Gen-Verse(杨凌等)
  • 核心理念: 首个面向扩散语言模型(Diffusion LLM)的强化学习后训练框架——把「偏好推理轨迹」引入 diffusion LLM 的后训练
  • 关键特性:
    • TraceRL(轨迹感知 RL):直接优化偏好推理轨迹,跨不同扩散架构通用
    • 引入基于扩散的价值模型增强训练稳定性、降低方差;可选过程奖励模型做细粒度监督
    • 完整覆盖 diffusion LLM 的 deployment / SFT / RL / RLHF,横跨数学、代码、多模态多种设定
    • 驱动 SOTA TraDo 系列:TraDo-8B-Instruct 在数学推理上相对 Qwen2.5-7B-Instruct 提升 6.1%;通过课程学习得到首个 long-CoT 扩散 LLM
  • 适用场景: 扩散语言模型的 RL 后训练;与 Open-dLLM 等扩散 LLM 全栈配合使用

4.24 Miles(LMSYS / SGLang 团队)⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/radixark/miles
  • 官方博客: https://www.lmsys.org/blog/2026-08-18-miles-v0-1/
  • 文档: https://radixark.mintlify.app/
  • 发布: v0.1 — 2026-08-18
  • 来源: LMSYS Org / SGLang 团队(RadixArk 维护)
  • 核心理念: 面向企业生产级的大规模 RL 后训练框架——从 slime fork 并与之协同演进,专注大规模 MoE 训练与生产落地
  • 关键特性:
    • SGLang 高吞吐 rollout + Megatron-LM 可扩展训练:在万亿参数规模下提供 RL 运行真正需要的精度、稳定性与可观测性能力
    • 全异步 RL:rollout worker 与 training worker 解耦,on-policy / off-policy 调度可配置;流水线针对减少气泡调优,异步 rollout 与 eval 模式可自定义
    • 完整 Agentic 训练工作流:多轮会话、工具执行、沙箱环境、token 级忠实轨迹捕获
    • LoRA / multi-LoRA:用一小部分 GPU 训练前沿规模模型,同一批 adapter 可直接加载进 SGLang 做 rollout
    • SGLang 的 memory-aware sleep/wake 机制在 RL 每步之间释放并恢复 KV cache 与权重,避免重复磁盘 I/O 与 CUDA graph 重捕获
    • 已获 AMD Instinct(ROCm) 支持
  • 适用场景: 企业级大规模 MoE 模型 RL 后训练;已使用 SGLang 推理栈、追求生产稳定性与可观测性的团队

4.25 Open-AgentRL(Gen-Verse)⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/Gen-Verse/Open-AgentRL
  • 来源: Gen-Verse(普林斯顿等,RLAnything 与 AutoTool 均为 ICML 2026)
  • 核心理念: 面向 LLM 与 Agentic 场景的开源 RL 全家桶——一套算法通吃终端、GUI、软件工程、工具调用等异构 Agent 环境
  • 关键特性:
    • RLAnything(ICML 2026):通用且可扩展的 Agentic RL 算法,跨 terminal / GUI / SWE / tool-call 设定通用;Qwen3-VL-8B-Thinking 在 OSWorld 上 +9.1%,Qwen2.5-7B-Instruct 在 AlfWorld 上 +18.7%、LiveBench 上 +11.9%
    • AutoTool(ICML 2026):让 Agent 在推理轨迹中具备动态工具选择能力,而非固定工具集
    • DemyAgent:仅 4B 参数的 DemyAgent-4B 在多个高难基准上匹敌甚至超越 14B/32B 模型,超过 ReTool-32B、rStar2-Agent-14B,达到 SOTA Agentic 推理水平
    • 是 OpenClaw-RL(4.21) 所基于的底层框架
  • 适用场景: 需要用同一套 RL 算法覆盖多类 Agent 环境;小参数量高性能 Agent 模型训练

5. 自动化超参数优化 / AutoML Agent

5.1 AgentHPO ⭐⭐⭐⭐

  • 论文: https://arxiv.org/abs/2402.01881
  • 核心理念: LLM 驱动超参数优化
  • 关键特性:
    • 自主处理任务、设计实验、基于历史迭代优化
    • 12 个 ML 任务上匹配/超越人类最佳试验
    • 提供可解释结果
  • 适用场景: 任何需要超参数调优的 ML 训练

5.2 AutoML-Agent ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/DeepAuto-AI/automl-agent
  • 来源: ICML 2025
  • 核心理念: 多 Agent 协作的全流程 AutoML
  • 关键特性:
    • 并行化专用 Agent 分工协作
    • 检索增强规划
    • 多阶段验证
    • 14 个数据集验证
  • 适用场景: 全自动化 ML Pipeline

5.3 Optuna ⭐⭐⭐⭐⭐

  • 官网: https://optuna.org
  • 定位: 超参数优化框架(行业标准)
  • 关键特性: Bayesian 搜索、剪枝、可视化 Dashboard、分布式执行
  • 适用场景: 训练流程中的标准超参数搜索组件

5.4 Microsoft NNI ⭐⭐⭐⭐

  • GitHub: https://github.com/microsoft/nni
  • 核心功能: AutoML 全生命周期
    • 特征工程自动化
    • 神经架构搜索(NAS)
    • 超参数调优
    • 模型压缩
  • 关键特性:
    • 支持本地/远程/云多种环境
    • Web UI 管理实验
    • 可扩展 API 自定义算法
  • 适用场景: 企业级 AutoML、NAS、模型压缩

5.5 W&B Sweeps ⭐⭐⭐⭐

  • 官网: https://wandb.ai/site/sweeps
  • 核心功能: 自动化超参数搜索 + 实验追踪
  • 关键特性:
    • Bayesian / Grid / Random 搜索
    • Hyperband 早停:自动杀掉差的实验,释放 GPU
    • 参数重要性分析
    • 可跨多机并行
  • 适用场景: 与 W&B 实验追踪深度集成的超参数优化

6. 自进化 / Self-Play 训练方法

核心思路:模型自己生成训练数据来训练自己,减少对人工标注的依赖。

6.1 SPIN (Self-Play Fine-Tuning) ⭐⭐⭐⭐⭐

6.2 SPPO (Self-Play Preference Optimization) ⭐⭐⭐⭐

  • 来源: UCLA ML Lab
  • 核心理念: 通过迭代策略更新逼近 Nash 均衡
  • 特点: 有理论收敛保证
  • 适用场景: 偏好对齐的理论驱动方法

6.3 SPC (Self-Play Critic) ⭐⭐⭐⭐ 🆕

  • 官网: https://chen-judge.github.io/SPC/
  • 核心理念: 对抗式自对弈进化推理评判者
  • 关键特性:
    • “狡猾生成器” vs “评判者” 博弈机制
    • 消除手动步骤级标注需求
    • 提升推理验证能力
  • 适用场景: 训练更强的推理验证/评判模型

6.4 SPELL ⭐⭐⭐⭐ 🆕

  • 论文: https://arxiv.org/html/2509.23863
  • 核心理念: 自对弈 RL 进化长上下文语言模型
  • 关键特性:
    • 无标签自对弈方法
    • 基础模型在长上下文任务上超越经过指令微调的版本
  • 适用场景: 长上下文能力训练

6.5 Multi-Agent Evolve (MAE) ⭐⭐⭐⭐

  • 论文: https://arxiv.org/html/2510.23595v1
  • 核心理念: 一个 LLM 同时扮演 Proposer、Solver、Judge 多个角色,协同进化
  • 验证: Qwen2.5-3B-Instruct 在数学、编程、推理、通识上均有提升
  • 适用场景: 多角色自进化训练

6.6 Multiagent Finetuning ⭐⭐⭐⭐

  • 官网: https://llm-multiagent-ft.github.io/
  • 核心理念: 从同一 base model 初始化多个模型,通过多 Agent 交互生成数据,独立更新
  • 关键发现: 多 Agent 微调可持续多轮迭代改进,而单模型自训练会 plateau
  • 适用场景: 克服自训练瓶颈

6.7 CORY (Cooperative Multi-Agent RL Fine-Tuning) ⭐⭐⭐

  • 来源: NeurIPS 2024
  • 核心理念: 将 LLM 复制为 Pioneer + Observer 两个 Agent,协作 RL 微调
  • 适用场景: RL 微调的新范式

7. 合成数据生成与数据治理 🆕

自动化训练 Pipeline 的关键环节:大规模生成高质量训练数据,无需人工标注。

7.1 数据生成框架

Distilabel ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/argilla-io/distilabel
  • 来源: Argilla
  • 核心理念: 基于已验证研究论文的合成数据和 AI 反馈 Pipeline
  • 关键特性:
    • 模块化 Pipeline 架构(可链式组合的 Steps/Tasks)
    • 支持 SFT、DPO、UltraFeedback、DEITA 等技术
    • 统一 API 对接任何 LLM 提供商
    • 内置 Argilla 集成用于标注和审核
  • 适用场景: 规模化生成 SFT/DPO/偏好数据

Magpie ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/magpie-align/magpie
  • 来源: ICLR 2025
  • 核心理念: 从零开始合成对齐数据,无需 Prompt Engineering 或种子问题
  • 关键特性:
    • 利用对齐 LLM 的预查询模板自动生成
    • 生成 4M 条指令,筛选后 300K 高质量样本
    • 在 Magpie 数据上微调的模型匹配官方 Llama-3-8B-Instruct
    • Magpie Reasoning V2: 250K 条 CoT 推理样本
  • 适用场景: 低成本大规模对齐数据生成

DataDreamer ⭐⭐⭐⭐

  • GitHub: https://github.com/datadreamer-dev/DataDreamer
  • 来源: ACL 2024
  • 核心理念: 可复现的合成数据生成与 LLM 工作流
  • 关键特性:
    • 多步 Prompting 工作流
    • 生成数据 + 对齐 + 微调 + 蒸馏一体化
    • 内置可复现性和缓存机制
  • 适用场景: 可复现的数据生成研究

Cosmopedia ⭐⭐⭐⭐

  • GitHub: https://github.com/huggingface/cosmopedia
  • 来源: HuggingFace
  • 核心理念: 大规模合成预训练数据 Pipeline
  • 关键特性:
    • 使用 Mixtral-8x7B 生成 25B tokens 的合成教科书、博客、故事
    • 使用 Stanford、Khan Academy、OpenStax、WikiHow 等话题
    • 最大的开放合成数据集
  • 适用场景: 预训练数据增强

InstructLab SDG ⭐⭐⭐⭐

  • GitHub: https://github.com/instructlab/sdg
  • 来源: IBM / Red Hat
  • 核心理念: 基于 LAB 方法论的合成数据生成
  • 关键特性:
    • Skills-SDG + Knowledge-SDG 双生成器
    • 从少量种子分类学自动扩展到大规模训练数据
    • 社区贡献机制
  • 适用场景: 社区驱动的模型能力扩展

Persona Hub ⭐⭐⭐⭐

  • GitHub: https://github.com/tencent-ailab/persona-hub
  • 来源: 腾讯 AI Lab
  • 核心理念: 基于角色驱动的十亿级合成数据
  • 关键特性:
    • 从网络数据中提取 10 亿个多样化角色
    • 2025-02 发布 3.7 亿 “精英” 角色
    • 驱动多样化合成数据生成
  • 适用场景: 需要高多样性训练数据的场景

synth_gen ⭐⭐⭐⭐

  • GitHub: https://github.com/facebookresearch/synth_gen
  • 来源: Meta
  • 核心理念: 带执行验证的合成数据生成
  • 关键特性:
    • 模块化验证器系统(检查器、错误消息、修复器)
    • 从种子生成已验证的训练对话
    • 基于解析器的代码验证
  • 适用场景: 需要高准确性的代码/推理数据生成

NeMo Data Designer ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/NVIDIA-NeMo/DataDesigner
  • 来源: NVIDIA NeMo 官方(v0.5.1,2026-02)
  • 核心理念: 超越简单 LLM 提示的生产级合成数据生成系统——统计采样器 + LLM 生成 + 依赖感知字段 + 自动验证
  • 关键特性:
    • 依赖感知生成:字段间可定义关联关系,保持数据内在一致性
    • 支持统计采样器、LLM 生成器和已有种子数据集三种来源
    • 内置验证器(Python、SQL、自定义)+ LLM-as-judge 质量评分
    • 支持图像生成(v0.5.1),可构建多模态合成数据集
    • Preview 模式快速迭代,满意后再全量生成
    • 支持 Docker Compose 或 Helm 部署
  • 适用场景: 需要结构化、高质量、可验证合成数据的大规模训练 Pipeline

Evidently ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/evidentlyai/evidently
  • 核心理念: 开源合成数据生成,支持用户画像与无代码界面
  • 关键特性:
    • 可定义用户画像(语气、意图、知识水平、”怪癖”)来塑造生成输入
    • 模型无关:可对接任何 LLM 提供商
    • 输出直接到 pandas DataFrame
    • Evidently Cloud 提供无代码 UI,产品经理和领域专家可直接使用
    • 内置 LLM 评估指标、合成数据生成、自动 Prompt 优化
  • 适用场景: LLM 系统测试数据生成、评估数据集构建

Meta Synthetic-Data-Kit ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/meta-llama/synthetic-data-kit
  • 来源: Meta(meta-llama 官方组织)
  • 核心理念: 轻量级 CLI 工具,从任意文档快速生成高质量 LLM 微调数据集,Llama 3 的大部分 SFT 语料即通过 6 轮迭代合成生成
  • 关键特性:
    • 四步流水线 CLI:ingest(解析文档)→ create(生成数据)→ curate(质量过滤)→ save-as(格式转换)
    • 支持多种输入格式:PDF、HTML、YouTube 字幕、DOCX、PPT、TXT
    • 生成数据类型:QA 对、CoT 推理链、摘要;支持自定义 Prompt 模板
    • LLM-as-judge:同一 LLM 既负责生成也负责质量过滤,可配置质量阈值
    • 导出格式:JSONL、Alpaca、ChatML、OpenAI,覆盖主流训练框架
    • 基于 vLLM 运行,可对接 Llama、Qwen 等本地模型
  • 适用场景: 从内部文档/论文/代码库快速构建领域专属微调数据集;无需外部数据标注团队

DataFlow ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/OpenDCAI/DataFlow
  • 论文: https://arxiv.org/abs/2512.16676(DataFlow: An LLM-Driven Framework for Unified Data Preparation and Workflow Automation)
  • 来源: OpenDCAI
  • 核心理念: LLM 驱动的统一数据准备与工作流自动化框架——用「可组合抽象 + LLM 优先的算子执行模型」把数据准备本身变成可自动编排的流水线
  • 关键特性:
    • 近 200 个可复用算子 + 6 条 SOTA 模板流水线:文本、数学推理、代码、Text-to-SQL、Agentic RAG 数据、大规模 QA 抽取
    • DataFlow-Agent:把自然语言需求自动翻译成可执行流水线——算子合成 → 流水线规划 → 迭代验证;也可按任务目标自行编写自定义算子
    • DataFlow-WebUI:拖拽式流水线编辑 + 自然语言交互的可视化工作台
    • 配套 DataFlow-Skills,可被编码 Agent 直接调用
  • 适用场景: 需要把「数据清洗 + 合成 + 评估」统一编排的训练前置流程;用自然语言驱动数据准备流水线

7.2 数据治理与筛选

NeMo Curator ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/NVIDIA-NeMo/Curator
  • 来源: NVIDIA
  • 核心优势: GPU 加速的大规模数据预处理与治理
  • 关键特性:
    • 30+ 启发式过滤器
    • fastText + GPU 加速分类器(领域/质量/安全)
    • 模糊去重:64 张 A100 上 1.8 小时处理 1.1T tokens
    • 支持文本、图像、视频、音频
    • 比替代方案快 16x
  • 适用场景: 大规模预训练数据清洗

DataTrove ⭐⭐⭐⭐

  • GitHub: https://github.com/huggingface/datatrove
  • 来源: HuggingFace
  • 核心优势: 平台无关的数据处理 Pipeline
  • 关键特性:
    • 模块化读取器/写入器/提取器/过滤器
    • 本地或 Slurm 集群运行
    • 低内存占用
    • 用于 FineWeb 和 Cosmopedia 数据集
  • 适用场景: 大规模文本数据处理

Dolma ⭐⭐⭐⭐

  • GitHub: https://github.com/allenai/dolma
  • 来源: AllenAI
  • 核心优势: 高性能数据集治理工具
  • 关键特性:
    • 支持数十亿文档的内置并行处理
    • CommonCrawl 下载、过滤、去重、分析
    • 语言检测、PII 清理
    • 用于 OLMo 训练语料(3T tokens)
  • 适用场景: 预训练语料治理

Data Prep Kit ⭐⭐⭐

  • GitHub: https://github.com/data-prep-kit/data-prep-kit
  • 来源: IBM
  • 核心优势: 非结构化数据准备
  • 关键特性:
    • Python / Ray / Spark 运行时
    • 从笔记本到数据中心扩展
    • Kubeflow Pipelines 工作流自动化
  • 适用场景: 多模态数据准备

8. 知识蒸馏框架 🆕

将大模型的能力压缩到小模型中,保持性能的同时降低部署成本。

8.1 EasyDistill ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/modelscope/easydistill
  • 来源: 阿里巴巴 / ModelScope(EMNLP 2025 Demo)
  • 核心优势: 综合蒸馏工具包,黑盒 + 白盒方法全覆盖
  • 关键特性:
    • 数据合成 + SFT + Logits 蒸馏 + 排序优化 + RL for KD
    • 包含蒸馏模型(DistilQwen)和开源数据集
  • 适用场景: 生产级模型蒸馏

8.2 DistillKit ⭐⭐⭐⭐

  • GitHub: https://github.com/arcee-ai/DistillKit
  • 来源: Arcee AI
  • 核心优势: 生产级 LLM 蒸馏工具
  • 关键特性:
    • 在线和离线蒸馏工作流
    • 驱动 Arcee Virtuoso、SuperNova Medius 等模型
  • 适用场景: 生产部署前的模型压缩

8.3 MiniPLM ⭐⭐⭐⭐

8.4 DistiLLM ⭐⭐⭐

8.5 EasyOPD ⭐⭐⭐⭐ 🆕

  • 论文: https://arxiv.org/abs/2607.11012(EasyOPD: An Easy-to-use On-Policy Distillation Framework for Large Language Models)
  • 发布: 2026-07-13
  • 核心理念: 首个统一的在线策略蒸馏(On-Policy Distillation, OPD)框架——学生模型自己生成、教师模型在线打分,把 OPD 做得像微调一样可配置
  • 关键特性:
    • 覆盖 10+ 种 OPD 方法,通过一行 YAML 切换:跨 tokenizer OPD、在线自蒸馏(self-distillation)、步骤级(step-wise)OPD 三大设定
    • 基于 verl 分布式 RL 后端构建,将用户侧配置、方法特定的监督逻辑与执行层解耦
    • 各方法模块通过统一扩展边界接入共享后端:损失构造、rollout 元数据、奖励处理、tokenizer 对齐、教师侧计算
    • 在推理、代码生成、科学知识、工具调用等多类基准上验证
    • 随附可运行 YAML 配置、文档、可安装的演示包与视频
  • 适用场景: 把在线策略蒸馏作为 SFT 与 RL 之间的标准后训练阶段;系统对比多种 OPD 方法

9. 模型合并与量化 🆕

组合多个模型或压缩模型,用于高效部署和训练。

9.1 模型合并

MergeKit ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/arcee-ai/mergekit
  • 来源: Arcee AI
  • 核心优势: 最流行的 LLM 模型合并工具
  • 关键特性:
    • 支持 SLERP、TIES、DARE、Passthrough、进化合并等方法
    • Out-of-core 方式,仅需 8GB VRAM 即可在 CPU 上合并
    • CMA-ES 优化合并配置
  • 适用场景: 免训练的模型能力组合

MergeLM ⭐⭐⭐

9.2 模型量化

GPTQModel ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/ModelCloud/GPTQModel
  • 核心优势: 生产级多方法量化工具
  • 关键特性:
    • 支持 GPTQ、AWQ、QQQ、GPTAQ、EoRA、GAR
    • 多后端支持(CPU/GPU)
    • 2026-03 支持 Qwen 3.5 MoE
  • 适用场景: 生产部署量化

AutoGPTQ ⭐⭐⭐⭐

  • GitHub: https://github.com/AutoGPTQ/AutoGPTQ
  • 核心优势: 易用的 GPTQ 量化
  • 关键特性:
    • 8/4/3/2-bit 量化
    • Marlin int4*fp16 kernel
    • 月下载量 ~150-200K
  • 适用场景: 快速 GPTQ 量化

AutoRound ⭐⭐⭐⭐

  • GitHub: https://github.com/intel/auto-round
  • 来源: Intel
  • 核心优势: 基于符号梯度下降的高精度量化
  • 关键特性:
    • 2-4 bit 高精度
    • 导出格式:GPTQ/AWQ/GGUF/AutoRound
    • 广泛硬件兼容(CPU、Intel GPU、CUDA、HPU)
  • 适用场景: 跨平台部署量化

NVIDIA Model Optimizer ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/NVIDIA/Model-Optimizer
  • 核心优势: 统一的量化、剪枝、蒸馏和投机解码优化库
  • 关键特性:
    • FP8/INT8/INT4 量化 + 结构化剪枝 + 知识蒸馏
    • 导出至 TensorRT-LLM、TensorRT、vLLM 等部署框架
    • NeMo Megatron Bridge 支持 Nemotron-3-Super 量化(PTQ 和 QAT)
  • 适用场景: NVIDIA 生态系统的模型压缩与加速

TurboQuant (Google) ⭐⭐⭐⭐ 🆕

llama.cpp ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/ggml-org/llama.cpp
  • 核心优势: 最通用的 LLM 推理 + GGUF 量化
  • 关键特性:
    • Q4_K_M 最佳平衡点:92% 质量,75% 体积缩减
    • CPU / GPU / Apple Silicon 全平台运行
    • ggml 团队已加入 HuggingFace(2026-02)
  • 适用场景: 本地部署、边缘设备

10. 轻量级预训练与分布式训练

配合 AutoResearch 等自主实验框架使用——小规模快速训练是自主实验的基础。

10.1 轻量级预训练

nanochat (Karpathy) ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/karpathy/nanochat
  • 定位: 最简 LLM 训练实验框架(AutoResearch 的底层)
  • 关键特性:
    • 单 GPU 节点,极简代码
    • 覆盖:Tokenization → 预训练 → 微调 → 评估 → 推理 → Chat UI
    • 约 $48(8xH100 约 2 小时)或 $15(Spot)训练 GPT-2 级别模型
  • 适用场景: 快速实验、教学、AutoResearch 底层

Nanotron (HuggingFace) ⭐⭐⭐⭐

  • GitHub: https://github.com/huggingface/nanotron
  • 定位: 极简但支持 3D 并行的 LLM 预训练框架
  • 关键特性:
    • 数据并行 + 张量并行 + 流水线并行
    • 灵活 API,优化大规模训练
  • 适用场景: 从小实验到大规模预训练的过渡

10.2 分布式训练框架 🆕

TorchTitan ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/pytorch/torchtitan
  • 来源: PyTorch 官方
  • 核心优势: PyTorch 原生的大规模训练平台
  • 关键特性:
    • 最高 4D 并行,无需修改模型代码
    • MXFP8 on Blackwell 支持
    • 262K token 上下文并行
    • 弹性扩缩容
  • 适用场景: 大规模预训练和微调

Open-dLLM ⭐⭐⭐

  • GitHub: https://github.com/pengzhangzhi/Open-dLLM
  • 核心优势: 首个开源扩散 LLM 全栈
  • 关键特性: 原始数据 → 训练 → Checkpoint → 评估 → 推理,一站式
  • 适用场景: 扩散语言模型研究

11. 推理引擎(RL 训练循环核心组件)🆕

推理引擎对 RL 训练至关重要——80% 的 RLHF 训练时间用于生成样本。快速推理 = 快速训练。

11.1 vLLM ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/vllm-project/vllm
  • 核心优势: 最成熟的开源 LLM 推理引擎
  • 关键特性:
    • PagedAttention 内存管理
    • v0.15.1: PyTorch 2.10、Blackwell SM120 支持
    • Blackwell 上 4x 吞吐量提升
    • FP8/FP4 注意力/GEMM kernel
    • OpenRLHF 的核心推理引擎
  • 适用场景: 生产推理 + RL 训练采样

11.2 SGLang ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/sgl-project/sglang
  • 核心优势: 高性能 LLM & 多模态推理
  • 关键特性:
    • H100 上约 16,200 tok/sec(超越 vLLM 的 ~12,500)
    • GB300 NVL72 上 25x 推理性能
    • RadixAttention 前缀缓存
    • 原生 TPU 支持
    • slime 的核心推理引擎
  • 适用场景: 高吞吐推理 + RL 训练采样

11.3 TensorRT-LLM ⭐⭐⭐⭐

  • GitHub: https://github.com/NVIDIA/TensorRT-LLM
  • 来源: NVIDIA
  • 核心优势: 硬件级深度优化
  • 关键特性:
    • FP8/FP4/INT4 AWQ/INT8 SmoothQuant 量化
    • EAGLE-3 推测解码
    • KV Cache Connector API
    • AutoDeploy beta 后端
  • 适用场景: 追求极致 GPU 性能

11.4 LMDeploy ⭐⭐⭐⭐

  • GitHub: https://github.com/InternLM/lmdeploy
  • 核心优势: LLM 压缩、部署、推理一体化
  • 关键特性:
    • TurboMind MXFP4 支持
    • H800 上 1.5x vLLM 性能
    • DeepSeek PD 解聚集(DLSlime/Mooncake 集成)
    • 双引擎架构:TurboMind (C++) + PyTorch (Python)
  • 适用场景: 量化模型推理服务

11.5 HuggingFace TGI ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/huggingface/text-generation-inference
  • 核心优势: 多后端统一推理前端
  • 关键特性:
    • 支持多后端:TensorRT-LLM、vLLM、llama.cpp
    • Token 流式输出、优化模型加载、分布式推理
    • 原生 HF Hub 集成
    • CPU/GPU/Inferentia/Trainium/TPU 支持
  • 适用场景: HuggingFace 生态的推理服务

11.6 NVIDIA Dynamo ⭐⭐⭐⭐

  • GitHub: https://github.com/ai-dynamo/dynamo
  • 来源: NVIDIA
  • 核心优势: 数据中心级分布式推理
  • 关键特性:
    • DeepSeek-R1 上 30x 请求吞吐量
    • 解聚集 prefill/decode 阶段
    • 动态 GPU 调度 + LLM 感知请求路由
    • Rust + Python 构建
    • 支持 vLLM、SGLang、TensorRT-LLM 作为后端
  • 适用场景: 大规模推理集群

12. 多模态训练框架 🆕

训练同时理解文本、图像、视频、音频的模型。

12.1 LLaVA-OneVision-1.5 ⭐⭐⭐⭐⭐

12.2 LLaVA-OneVision-1.5-RL ⭐⭐⭐⭐⭐

12.3 OpenRLHF-M ⭐⭐⭐⭐

12.4 LLaVA-KD ⭐⭐⭐⭐

  • GitHub: https://github.com/Fantasyele/LLaVA-KD
  • 来源: ICCV 2025
  • 核心优势: 多模态知识蒸馏
  • 关键特性: Multimodal Distillation + Relation Distillation
  • 适用场景: 将大 MLLM 蒸馏到小模型

12.5 MoE-LLaVA ⭐⭐⭐

12.6 LLaVA-OneVision-2 ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/EvolvingLMMs-Lab/LLaVA-OneVision-2
  • 论文: https://arxiv.org/abs/2605.25979(LLaVA-OneVision-2: Towards Next-Generation Perceptual Intelligence)
  • 项目主页: https://evolvinglmms-lab.github.io/LLaVA-OneVision-2/
  • 发布: 2026-05-25
  • 来源: EvolvingLMMs-Lab
  • 核心优势: 下一代完全开源的多模态训练框架,把图像、长视频、空间理解统一在单一架构下
  • 关键特性:
    • 基于原生 OneVision-Encoder(codec 对齐视觉编码器),图像、均匀采样帧、codec 对齐 token 走同一位置编码方案,无需为不同输入类型配置不同 tokenizer
    • Windowed Attention 在保持原生分辨率的同时实现高效局部计算
    • 8B 级模型,单一模型、原生分辨率、无需任务专用 adapter
    • 端到端全开放且可复现:数据、编码器、训练、checkpoint、日志逐阶段全部释出
    • 四段式紧凑训练:从 LLaVA-OneVision-1.5 引导视频能力(30s 短视频字幕)→ 大规模多模态指令微调(30–180s 视频字幕)
  • 适用场景: 需要图像+长视频+空间统一理解的多模态 LLM 训练;追求完整可复现训练配方

12.7 VeRL-Omni ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/verl-project/verl-omni
  • 官方博客: https://vllm.ai/blog/2026-05-14-verl-omni
  • 文档: https://verl-omni.readthedocs.io/
  • 来源: verl 项目官方(从 verl 的多模态生成 RL 分支独立)
  • 核心理念: 面向多模态生成模型的通用 RL 训练框架——”Easy, Fast, and Stable RL Training for Diffusion and Omni-Modality Models”
  • 关键特性:
    • 覆盖三类生成模型:图像/视频/音频扩散模型(Qwen-Image、Wan2.2、LTX-2.3)、统一理解+生成模型(BAGEL、HunyuanImage-3.0)、全模态模型(Qwen3-Omni)
    • vLLM-Omni 专用 rollout:request 级 / step-wise 批处理 + FA3,高吞吐扩散与多模态生成采样
    • 灵活的奖励流水线:规则奖励、模型奖励、多模态奖励计算可自由组合
    • 模块化训练后端:复用已有并行策略(FSDP、USP)与优化手段,而非从零重建训练栈
    • 已集成 DiffusionNFT、Diffusion DPO(Qwen-Image / SD3.5 已验证配方);v0.2.0 重建 Qwen3-Omni 多模态训练(DPO & GSPO)
  • 适用场景: 图像/视频/音频生成模型的 RL 后训练;全模态模型对齐

12.8 verl-vla ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/verl-project/verl-vla
  • 发布: v0.1.0 — 2026-08
  • 来源: verl 项目官方
  • 核心理念: 统一的视觉-语言-动作(VLA)策略后训练框架——把人在回路数据采集、监督微调、强化学习、策略评测收进同一套工作流
  • 关键特性:
    • 模型、环境、训练算法可独立接入,通过共享执行架构自由组合
    • 跨云边分布式部署:训练 Worker、仿真器、实体机器人可按各自的硬件与连通性需求跑在不同节点上
    • 人在回路:操作者可从任意联网设备监控、遥操作、介入仿真环境与真机的执行过程
    • 基于 verl 构建,复用其成熟的 RL 后训练栈
  • 适用场景: 具身智能 / 机器人策略的 RL 后训练;需要真机 + 仿真混合训练与人工介入的场景

13. 实验追踪与编排平台

13.1 Weights & Biases (W&B) ⭐⭐⭐⭐⭐

  • 官网: https://wandb.ai
  • 功能: 实验追踪 + Sweeps 超参数优化 + 模型版本管理 + 报告
  • 特点: 行业标准,与所有主流训练框架集成

13.2 MLflow 3.0 ⭐⭐⭐⭐

  • 功能: 实验追踪 + 超参数扫描 + 模型注册 + 模型服务
  • 特点: 开源、自托管、支持嵌套实验

13.3 ClearML ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/allegroai/clearml
  • 核心优势: 开源 MLOps 平台
  • 关键特性:
    • 150K+ 用户遍布 Fortune 500 企业
    • 自动日志记录
    • Pipeline 编排
    • 模型服务
    • 数据集版本管理
  • 适用场景: 企业级 MLOps

13.4 HuggingFace Trackio ⭐⭐⭐⭐

  • 定位: HF 生态的轻量级实验追踪
  • 特点: 与 HF Skills 深度集成,Agent 可直接读取指标并决策

14. Benchmark 与评测体系

14.1 ML Agent 评测基准

MLE-bench ⭐⭐⭐⭐⭐

  • 论文: https://arxiv.org/abs/2410.07095
  • 来源: OpenAI
  • 内容: 75 个 Kaggle ML 工程竞赛任务
  • 评估: AI Agent 训练模型、准备数据、运行实验的能力

MLAgentBench ⭐⭐⭐⭐

PaperBench ⭐⭐⭐⭐⭐ 🆕

  • 官网: https://openai.com/index/paperbench/
  • 来源: OpenAI
  • 评估: AI 从零复现 ICML 2024 论文的能力
  • 关键数据: 8,316 个可评分任务,覆盖 20 篇论文;最佳 Agent 得分 21%

CORE-Bench ⭐⭐⭐⭐ 🆕

MLRC-Bench ⭐⭐⭐

AgentBench ⭐⭐⭐⭐ 🆕

SWE-bench Verified ⭐⭐⭐⭐⭐ 🆕

  • 官网: https://www.swebench.com/
  • 评估: 人工验证的 GitHub Issue 解决
  • 关键数据: 编码 Agent 行业标准;顶级得分 70%+

LiveBench ⭐⭐⭐⭐ 🆕

  • 官网: https://livebench.ai/
  • GitHub: https://github.com/LiveBench/LiveBench
  • 评估: 抗污染、无需 LLM 裁判的综合 LLM 评测
  • 关键特性:
    • 6 大类别:数学、推理、数据分析、语言、编程、指令遵从
    • 题目每月更新,基于最新数学竞赛、arXiv 论文、新闻
    • 所有题目有客观可验证答案,自动评分,无需 LLM Judge
  • 适用场景: 无污染风险的 LLM 能力评测

AgenticDataBench ⭐⭐⭐⭐ 🆕

  • 论文: https://huggingface.co/papers/2607.01647(arXiv 2607.01647)
  • 发布: 2026-07-02
  • 核心优势: 面向 LLM 数据 Agent(Data Agent)的综合评测基准
  • 关键特性:
    • 覆盖 15 个领域 + 5 个真实 B2B 金融科技用例,贴近真实数据科学工作流
    • 提供细粒度技能级标签:schema 检查、表连接、数据清洗、可视化、业务上下文推理——而非只看单一任务成功率
    • 附带 GitHub 测试台 + Hugging Face 数据集,Apache-2.0,易于检查与复现
  • 适用场景: 评估自动化数据处理/数据科学 Agent 是否具备真实工作流能力

Terminal-Bench 2.1 ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/laude-institute/terminal-bench-2
  • 官网: https://www.tbench.ai/
  • 论文: https://huggingface.co/papers/2601.11868
  • 来源: 斯坦福大学 + Laude Institute + Terminal-Bench 开源社区
  • 评估: Agent 在命令行界面中完成硬核真实任务的能力——89 个精选任务
  • 关键特性:
    • 任务覆盖软件工程、系统管理、数据处理、安全、科学计算,以及模型训练——直接对应本报告关心的自动化训练场景
    • 每个任务给 Agent 一段书面指令 + 一个含相关文件/软件/工具的专用容器;Agent 可检视环境、执行命令、编辑文件、安装依赖并根据执行反馈修正方案,最后由自动化测试检查容器终态
    • 采用 Harbor 任务格式与 Harness 运行,开箱支持 Claude Code、Codex CLI、OpenHands、Mini-SWE-Agent、Terminus 2
    • v2.1 修复了 2.0 中 89 个任务里的 28 个(外部依赖变更、资源预算过紧、指令与测试不匹配),修复后不存在”无人可解”的任务——失败真实反映 Agent 能力而非环境缺陷
  • 适用场景: 横向对比不同编码 Agent / Harness 的真实终端作业能力;评估 Agent 能否胜任训练脚本编写与运维类任务

14.2 模型评测框架 🆕

DeepEval ⭐⭐⭐⭐⭐

  • GitHub: https://github.com/confident-ai/deepeval
  • 核心优势: 类 Pytest 的 LLM 评测框架
  • 关键特性:
    • v3.0: 组件级粒度
    • 14+ 评测指标(G-Eval、幻觉检测等)
    • 多轮对话模拟
    • DeepTeam 红队测试
  • 适用场景: CI/CD 中集成 LLM 评测

Opik ⭐⭐⭐⭐

  • GitHub: https://github.com/comet-ml/opik
  • 来源: Comet
  • 核心优势: 开源 LLM 可观测性与评测
  • 关键特性:
    • 深度追踪
    • LLM-as-a-Judge 指标
    • 幻觉检测
    • 生产环境仪表盘
  • 适用场景: 生产环境 LLM 监控

LMMs-Eval ⭐⭐⭐⭐

  • GitHub: https://github.com/EvolvingLMMs-Lab/lmms-eval
  • 核心优势: 跨文本、图像、视频、音频的多模态评测
  • 关键特性:
    • v0.6: eval-as-a-service HTTP 服务器
    • 7.5x 吞吐量提升
    • 50+ 新任务
    • 统计严格性(置信区间、配对 t 检验)
  • 适用场景: 多模态模型全面评测

Arize Phoenix ⭐⭐⭐⭐

  • GitHub: https://github.com/Arize-ai/phoenix
  • 核心优势: 开源 LLM 可观测性与评测
  • 关键特性: 完全自托管;追踪、评测、检索分析
  • 适用场景: 自部署的 LLM 监控

LiveCodeBench ⭐⭐⭐⭐


15. 辅助编码 Agent(可用于训练脚本开发)

这些 Agent 本身不直接训练模型,但可以编写和调试训练代码,配合 HF Skills 等实现完整自动化。

15.1 Aider ⭐⭐⭐⭐⭐

15.2 OpenHands ⭐⭐⭐⭐⭐

15.3 SWE-agent ⭐⭐⭐⭐⭐

15.4 Open-SWE ⭐⭐⭐⭐ 🆕

15.5 SERA ⭐⭐⭐⭐ 🆕

15.6 Cline ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/cline/cline
  • 用途: VS Code 内自主编码 Agent
  • 优势: 60K+ GitHub stars;5M+ 开发者信任;MCP 工具扩展;原生 subagents (v3.58);human-in-the-loop 审批机制

15.7 OpenCode ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/opencode-ai/opencode
  • 用途: Go 语言构建的终端 AI 编码 Agent
  • 优势: 95K+ GitHub stars;Bubble Tea TUI 交互界面;75+ LLM 提供商;650 万月活开发者;SQLite 持久化

15.8 Plandex ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/plandex-ai/plandex
  • 用途: 面向大型项目的终端编码 Agent
  • 优势: 2M token 上下文;tree-sitter 项目映射(30+ 语言);diff review 沙盒;自动调试浏览器应用

15.9 Roo Code ⭐⭐⭐⭐ 🆕

15.10 Gemini CLI ⭐⭐⭐⭐

  • GitHub: https://github.com/google-gemini/gemini-cli
  • 来源: Google(Apache 2.0)
  • 用途: Google 官方开源终端 AI Agent,直接在命令行调用 Gemini 模型进行编码、调试与任务自动化
  • 优势:
    • 免费额度充裕:个人 Google 账号每分钟 60 次、每天 1000 次请求,可免费使用 Gemini 2.5 Pro
    • 支持 MCP Server 扩展,可接入外部工具和训练基础设施
    • 每周发布稳定版,每周发布预览版,迭代活跃
    • 与 HF Skills 场景 B 组合——”用 Gemini CLI 驱动训练流程”
  • 适用场景: Google 生态用户;免费资源受限场景;配合 HF Skills 做自然语言驱动训练

15.11 Claw Code ⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/ultraworkers/claw-code
  • 官网: https://claw-code.codes/
  • 发布: 2026-04-02
  • 来源: Sigrid Jin / ultraworkers 社区
  • 核心理念: Claude Code 架构的开源 Rust 重写版——为开发者提供完全透明、可定制、可自托管的终端 AI 编码 Agent
  • 关键特性:
    • 100K+ GitHub stars,GitHub 史上最快突破 10 万 star 的项目之一
    • Clean-Room 重写(Rust ~4K 行 + Python ~1.5K 行),无专有代码,完全可审计
    • 多提供商支持:Anthropic、OpenAI、xAI/Grok、Alibaba Qwen、Ollama、OpenRouter 等任意 OpenAI 兼容端点
    • 核心工具集完整:Bash、Read、Write、Edit、Glob、Grep——与 Claude Code 工具层对等
    • 会话持久化(.claude/sessions 目录)+ OAuth 认证流
    • 支持本地模型(Ollama/LM Studio),无需云端 API
  • 适用场景: 需要完全开源、可离线运行的 Agent 环境;配合 HF Skills 做自然语言驱动训练;对 Claude Code 架构感兴趣的研究者

15.12 DeepSeek Harness (dsh) ⭐⭐⭐⭐⭐ 🆕

  • GitHub: https://github.com/deepseek-ai/deepseek-harness
  • 发布: 2026-08-13
  • 来源: DeepSeek AI 官方
  • 核心理念: “Everything is a Plugin”——DeepSeek 官方开源的 Agent Harness,把 Agent 运行时的每一层都做成可替换插件
  • 关键特性:
    • 两天突破 10 万 GitHub star,两周约 20 万 star,是 GitHub 有记录以来最快的开发者工具采纳曲线之一;MIT 许可
    • 一切皆插件:模型适配器、工具注册表、会话日志、沙箱,乃至 Agent 主循环本身都是插件,由 Cordis 插件框架驱动
    • Node.js 实现,完全本地运行;与 Claude Code、OpenAI Codex 对标同一片领地
    • Web-UI 优先(而非 TUI);目前是 developer preview,明确会有 breaking change
  • 适用场景: 需要深度定制 Agent 循环/工具层来驱动训练流程的团队;自建训练 Agent 基础设施

16. 总结对比表与选型指南

核心工具对比

工具定位自动化层级开源核心价值
AutoResearch自主实验循环🔴 全自动✅ MITAI 自主做 ML 实验
AI Scientist v2自主科学研究🔴 全自动✅AI 自主做研究 + 写论文
AutoML-Agent全流程 AutoML🔴 全自动✅多 Agent 协作 AutoML
HF SkillsAgent 训练能力🟡 自然语言驱动✅一句话完成模型训练全流程
HF AutoTrain无代码训练🟡 向导式✅上传数据自动训练
Unsloth高效微调引擎🟢 需配置✅2x 速度 70% 省显存
LlamaFactoryWeb UI 微调🟡 可视化✅浏览器中配置训练
Axolotl生产微调框架🟢 YAML 配置✅灵活 + 生产就绪
OpenRLHFRLHF 框架🟢 需配置✅70B+ 全量 RLHF
verlRL 训练框架🟢 需配置✅工业级 RL(字节/阿里/Berkeley)
DAPORL 算法🟢 需配置✅SOTA 推理 RL 训练
AReaL异步 RL 训练🟢 需配置✅2.77x 加速
slimeRL 后训练框架🟢 需配置✅驱动 GLM 系列模型
rLLMAgent RL 训练🟢 需配置✅Agent 能力 RL 训练
Distilabel合成数据生成🟡 Pipeline 式✅规模化 SFT/DPO 数据
Magpie对齐数据合成🔴 全自动✅零 prompt 工程
EasyDistill知识蒸馏🟡 半自动✅黑盒 + 白盒蒸馏
MergeKit模型合并🟡 配置式✅免训练能力组合
SPIN自进化训练🟡 半自动✅无需额外偏好数据
Optuna超参数优化🟡 自动搜索✅行业标准 HPO
NNIAutoML 全栈🟡 自动搜索✅NAS + HPO + 模型压缩
nanochat轻量预训练🟢 手动✅AutoResearch 底层
DeepEval模型评测🟡 自动化✅CI/CD 集成评测

按场景选型

场景 A:让 AI 全自动跑实验、自主优化模型

AutoResearch + nanochat + Optuna
AI Scientist v2(更偏研究侧)
AutoML-Agent(ICML 2025,多 Agent 协作)
Arbor(假设树累积经验,同预算下 2.5x 于 Codex / Claude Code)
Sibyl-AutoResearch(自进化试错 Harness,20+ Agent 研究组织)

场景 B:用自然语言指挥 Agent 完成模型训练

HF Skills(model-trainer + jobs + trackio + evaluation)
+ Claude Code / Codex / Gemini CLI

场景 C:高效微调现有模型

单 GPU: Unsloth(速度王)
多 GPU: Axolotl / LlamaFactory(灵活 + 易用)
NVIDIA 集群: NeMo AutoModel
PyTorch 原教旨: torchtune
无代码: H2O LLM Studio / HF AutoTrain

场景 D:RLHF / 对齐训练

标准 RLHF: OpenRLHF
字节生态: verl + DAPO
异步加速: AReaL(2.77x 加速)
GLM 生态: slime
NVIDIA 生态: NeMo RL + NeMo Gym
Agent RL: rLLM / RAGEN / OpenManus-RL
简单推理 RL: SimpleRL-Reason
GRPO(推理训练): TRL / Unsloth / Axolotl 均支持
f-散度 GRPO: f-GRPO(更灵活的策略优化)
Agent 树搜索 RL: Tree-GRPO(4x 采样效率)
RL 系统级提速: Arctic RL(ZoRRo 零冗余 Rollout,3.5x 端到端加速)
K8s 自托管后训练: OpenRL(Google,Tinker 兼容 API)
在线/常驻式 RL: OpenClaw-RL(部署对话即训练信号)
vLLM 生态原生 RL: vime(Megatron 训练 + vLLM rollout,训推对齐稳定)
扩散 LLM 的 RL: dLLM-RL / TraceRL(首个 diffusion LLM 后训练框架)
企业级大规模 MoE RL: Miles(SGLang rollout + Megatron 训练,万亿参数级)
跨环境通用 Agent RL: Open-AgentRL(RLAnything / AutoTool / DemyAgent)
扩散与全模态生成 RL: VeRL-Omni(Qwen-Image / Wan2.2 / Qwen3-Omni)
具身智能 VLA 后训练: verl-vla(人在回路 + 仿真/真机混合)

场景 E:自进化 / 减少人工标注

SPIN → 自对弈微调
SPC → 对抗式推理评判进化
SPELL → 长上下文自对弈
Multi-Agent Evolve → 多角色协同进化
Multiagent Finetuning → 多 Agent 持续迭代

场景 F:合成数据 → 训练 → 评测

Distilabel / Magpie → 数据生成
NeMo Curator / DataTrove → 数据清洗
Unsloth / TRL → 训练
DeepEval / LMMs-Eval → 评测

场景 G:模型压缩与部署

知识蒸馏: EasyDistill / DistillKit
模型合并: MergeKit
量化: GPTQModel / llama.cpp GGUF

场景 H:无代码快速原型

HF AutoTrain(上传数据即可)
LlamaFactory LlamaBoard(Web UI)
H2O LLM Studio(浏览器 GUI)

趋势观察(2026 Q3 更新)

  1. AutoResearch 范式兴起: Karpathy 证明 630 行代码即可实现”AI 自主做 ML 研究”(2026-04 已 66K+ stars)——现已形成完整衍生生态:ARIS、AI-Supervisor、AutoResearchClaw(想法→论文)、Deli_AutoResearch(长周期协议)、领域无关移植版 pi-autoresearch
  2. “Vibe Training” 到来: HF Skills 让用自然语言驱动完整训练流程成为现实
  3. GRPO 变体爆发: f-GRPO(f-散度家族)、Tree-GRPO(树搜索,ICLR 2026)、DAPO——GRPO 已成默认对齐方法,专门变体快速涌现
  4. RL 框架百花齐放: verl、DAPO、AReaL、slime、NeMo RL——各大厂和实验室纷纷开源 RL 训练框架
  5. Self-Play 突破瓶颈: 多 Agent 自进化训练(SPIN、MAE、SPC、SPELL)正在解决单模型自训练的 plateau 问题
  6. 合成数据成为基础设施: Distilabel、Magpie、Evidently 使数据生成成为训练 Pipeline 的一等公民;模型坍缩对策(Evol-Instruct)成为标配
  7. MCP 协议标准化: Agent 连接训练工具的标准协议,被 OpenAI / Google / Microsoft 采纳
  8. 单 GPU 也能做研究: Unsloth + nanochat + AutoResearch 组合让个人开发者也能高效做 LLM 实验
  9. 推理-训练一体化: vLLM/SGLang/TGI 已成为 RL 训练循环的核心组件,不仅仅是推理服务
  10. 多模态 RL: LLaVA-OneVision-1.5-RL 和 OpenRLHF-M 将 RL 对齐扩展到视觉语言模型
  11. 极限量化时代: Google TurboQuant(ICLR 2026)实现 3-bit KV Cache 零精度损失 6x 压缩;NVIDIA Model Optimizer 统一量化/剪枝/蒸馏
  12. 多 Agent 编码浪潮: 2026 年 2 月各大工具集中发布多 Agent 能力(Grok Build、Windsurf、Claude Code、Codex CLI、Devin)——编码 Agent 现在常规编写训练脚本
  13. Kernel 级 Autoresearch: 2026-04 新趋势——Meta KernelAgent、RightNow AI AutoKernel 把 “让 AI 睡觉时做研究” 的范式下沉到 GPU kernel 生成,训练基础设施本身也开始被 Agent 自动优化
  14. 多 Agent RL 系统: MARTI、rLLM、ART、OpenManus-RL——RL 训练对象正从单个模型扩展到多 Agent 系统;中心化多 Agent 交互 + 分布式策略训练成为新范式
  15. Agent 驱动数据创造: Meta synthetic-data-kit(文档 → 数据集的 4 步 CLI)和 Autodata 框架显示——让 AI Agent 迭代优化自己的数据生成过程,效果显著优于标准合成数据方法
  16. Autoresearch 成为通用原语: 2026-06 新趋势——「实验 → 测量 → 保留/回滚」循环已脱离 ML 专用,泛化为可复用基础设施:pi-autoresearch 可优化任意可量化指标(测试速度、bundle 体积、Lighthouse 分数),而想法→论文系统(AutoResearchClaw)与长周期协议(Deli_AutoResearch)把自主时长从分钟级推向数周级
  17. RL 系统层 + 在线常驻 RL: 2026-07 新趋势——RL 效率正独立成一个基础设施层:Snowflake Arctic RL(ZoRRo prompt 去重,端到端 3.5x 加速)与 Google Tinker 兼容的 OpenRL(K8s 原生、多任务 GPU 打包)把 RL 系统优化与算法解耦;而 OpenClaw-RL 把在线部署中的真实对话变成常驻训练信号——RL 正从离线批处理作业转向”部署即训练”的常驻式、持续学习服务
  18. 在线策略蒸馏(OPD)走向主流: 2026-07 新趋势——OPD(学生生成、教师在线打分)正成为介于 SFT 与 RL 之间的标准后训练阶段;EasyOPD 在 verl 之上统一 10+ 种 OPD 方法(跨 tokenizer、自蒸馏、步骤级),一行 YAML 即可切换,让蒸馏像微调一样可配置
  19. RL 拓展到新载体 + 全学科 Autoresearch: RL 后训练正突破自回归文本模型——Gen-Verse 的 dLLM-RL/TraceRL 把轨迹感知 RL 带到扩散语言模型(SOTA TraDo 系列),vLLM 官方的 vime 把 RL 后训练标准化进推理引擎生态;与此同时,autoresearch 循环从 ML 泛化为全学科科研工作台(OpenScience:文献 → 假设 → 实验 → 论文,覆盖 ML/生物/物理/化学)
  20. RL 框架分化为「模态专用矩阵」+ 企业级 RL: 2026-08 新趋势——verl 生态正式裂变为三条专线:verl(文本)、VeRL-Omni(扩散与全模态生成模型)、verl-vla(视觉-语言-动作机器人策略),RL 后训练由此从纯文本扩展到图像/视频/音频生成与实体机器人控制;与此同时 LMSYS/SGLang 团队的 Miles(v0.1,2026-08-18)把 RL 推向万亿参数 MoE 的生产场景——精度、稳定性、可观测性与吞吐同等重要
  21. 自主研究从「产出论文」转向「累积知识」: 最新一批研究 Agent 都在攻同一个失效点——每次实验都从零开始。人大 NLPIR 的 Arbor 用 Hypothesis-Tree Refinement 把「假设 → 产物 → 证据 → 洞见」持久化成树并向上传播教训(同等预算下平均相对增益达 Codex / Claude Code 的 2.5 倍);Sibyl-AutoResearch 则直接主张「自主研究需要的是自进化试错 Harness,而不是论文生成器」——反复出现的流程性失败会改写 Harness 自身
  22. Agent Harness 本身开源化、可插拔化: DeepSeek 开源自家 Harness(两天 10 万 star),模型适配器、工具注册表、沙箱乃至 Agent 主循环本身都是插件;继 Claw Code 的 Clean-Room 重写之后,Harness 层正从厂商锁定变为通用开源基础设施;而 Terminal-Bench 2.1(斯坦福 + Laude,89 个任务含模型训练)正成为跨 Harness 的共同标尺

相关 Awesome 列表


推荐组合(直接可用)

🥇 最完整自动化方案

HuggingFace Skills + Claude Code + Unsloth + W&B

用自然语言指挥 Claude Code,通过 HF Skills 调用 Unsloth 训练,W&B 追踪实验。

🥈 最轻量自主实验方案

AutoResearch + nanochat(单 GPU 即可启动)

睡前启动,醒来收获 100 次自主实验结果。

🥉 最灵活生产方案

Axolotl / LlamaFactory + OpenRLHF + Optuna + MLflow

YAML 配置训练 + 自动超参数搜索 + 实验追踪。

🏅 2026 SOTA RL 训练方案

verl / OpenRLHF + vLLM / SGLang + Reasoning Gym + W&B

最先进的 RL 训练 + 快速推理引擎 + 丰富环境 + 实验追踪。

🏅 合成数据全流程方案

Distilabel / Magpie → NeMo Curator → Unsloth / TRL → DeepEval / LMMs-Eval

规模化生成数据 → GPU 加速清洗 → 高效训练 → 全面评测。


本报告基于 2026 年 9 月公开资源整理(2026-09-07 更新),项目状态可能随时间变化。建议定期检查各项目 GitHub 获取最新状态。