摘要:哔哩哔哩 Index LLM 团队在 2026 年 9 月发布了 Index-Translate。它不是单一的“文本翻译模型”,而是以 Qwen3.5 为基础,向文本、语音翻译、音节可控配音和原生长文档翻译扩展的模型家族。
- Index-Translate GitHub README:https://github.com/bilibili/Index-Translate/blob/main/README_zh.md
- Index-Translate 技术报告:arXiv:2609.40181
- HOMURA:arXiv:2601.10187
- RIVAL:arXiv:2506.05070
- Hugging Face 论文合集:Index-Translate Papers

一、项目定位:把“翻译质量”扩展为可交付能力
传统机器翻译通常优化句子级质量,但真实内容生产还需要保留 JSON、CSV、Markdown、变量占位符和术语;字幕要适配时长;社区文本要翻出梗意;书籍翻译要维持人物、术语和概念层级。Index-Translate 的核心判断是:翻译模型应当同时优化语义、约束、模态和上下文,而不是只追求一个 BLEU 或 COMET 分数。
模型家族目前包含五类成员:
- Index-Translate:文本、结构化内容、指令翻译与社区表达,覆盖 150 种语言,提供 2B、9B 和 35B-A3B(preview)。
- Index-Echo:语音到文字(S2TT)和语音到语音(S2ST),支持目标语言字幕、配音与说话人声音条件。
- Index-Homura:接收目标音节数,在保持语义的同时重组译文长度。
- Index-NativeLong:输入完整文档并连续生成译文,面向书籍、网文和长篇资料的一致性。
二、统一基础模型:多语种中训 + 专家融合
1. 多语言 Mid-training
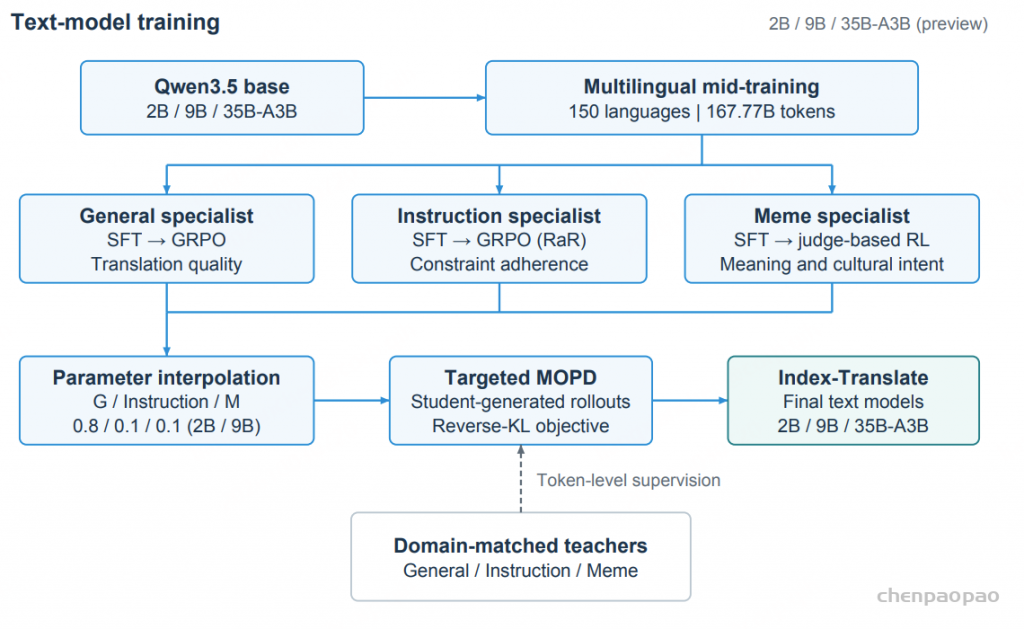
技术报告将训练拆成 constant 和 decay 两阶段。constant 阶段混合通用文本、平行语料和单语文本,采样比例为 1:1:1,7,000 步、117.44B tokens;decay 阶段使用通用文本、pivot-20 与 pivot-148 数据,比例为 1:4:2,3,000 步、50.33B tokens。总预算约 167.77B tokens,序列长度通常为 4,096,随后为长文档任务增加更长上下文。
这里的 pivot 组织不是简单地把双语句对堆在一起,而是通过英文锚点把多个语言版本连接起来。例如:
\(x_{zh}\leftrightarrow x_{ja}\) 表示普通平行数据;\(x_{zh}\leftrightarrow x_{en}\leftrightarrow x_{ja}\) 表示 pivot 数据。报告中的消融显示,多语言覆盖能明显提升非核心语言表现,同时仍需控制对通用能力的损耗。
2. 专家训练与融合
团队分别训练通用翻译专家、指令翻译专家和 MEME(社区文化表达)专家。指令专家使用约 104.5 万条、覆盖十类真实场景的样本;训练目标既包括术语、格式和结构保护,也包括风格、上下文消歧和跨句一致性。通用翻译和指令翻译使用 GRPO,MEME 使用参考引导的 LLM judge。
融合不是简单拼接多个 LoRA,而是先做参数插值:
\(\theta_{merge}=w_G\theta_G+w_I\theta_I+w_M\theta_M,\quad w_G+w_I+w_M=1\)发布模型使用的代表性权重为 \(w_G:w_I:w_M=0.8:0.1:0.1\),之后用针对弱项的多教师 on-policy distillation(MOPD)修补融合后的能力缺口。这种设计的价值在于:通用质量、指令遵循和文化适配可以共享底座,但不必强行用一个训练目标解决所有任务。
三、三项关键扩展:语音、音节与长文档
1. Index-Echo:从“翻译文本”到“翻译声音”
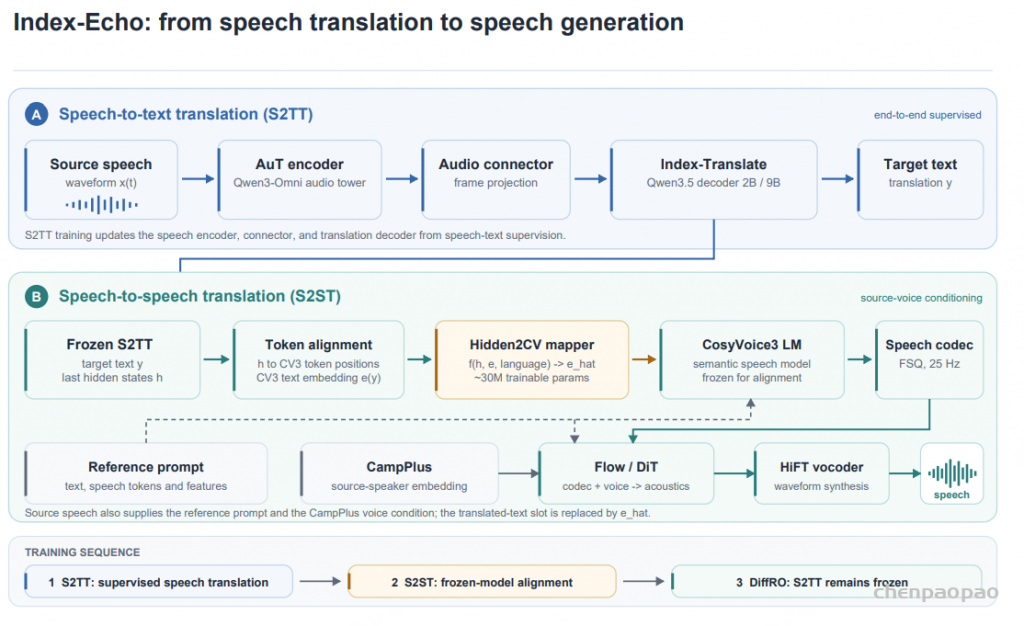
Index-Echo S2TT 将 Qwen3-Omni AuT 音频编码器与 Index-Translate 解码器连接起来,直接从源音频生成目标语言文字。S2ST 则在 S2TT 基础上增加约 3,000 万参数的 Hidden2CV 映射器,把翻译器隐藏状态映射到 CosyVoice3 的语义层,并使用 DiffRO 通过 Gumbel-Softmax 语音 token 优化内容一致性;源音频还提供说话人 embedding 与声音提示。
| 任务/模型 | MT judge | ASR/WER 中位误差 | 起始时间 MAE |
|---|---|---|---|
| Index-Echo-2B S2TT | 0.825 | 0.088 | 0.395 s |
| Index-Echo-9B S2TT | 0.857 | 0.102 | 0.488 s |
| Qwen3.8-Omni-Flash | 0.887 | 0.112 | 1.004 s |
| SeamlessM4T-v2 | 0.060 | 1.000 | — |
报告还比较了 pipeline 与端到端 S2ST。以中文到日语为例,9B 端到端方案的内容错误率均值/中位数为 0.0436/0.021,音色相似度 Spk 为 0.782;这说明语音翻译的评价不能只看文本,还要同时考察内容、时间轴和说话人条件。
2. Index-Homura:把音节预算写进优化目标
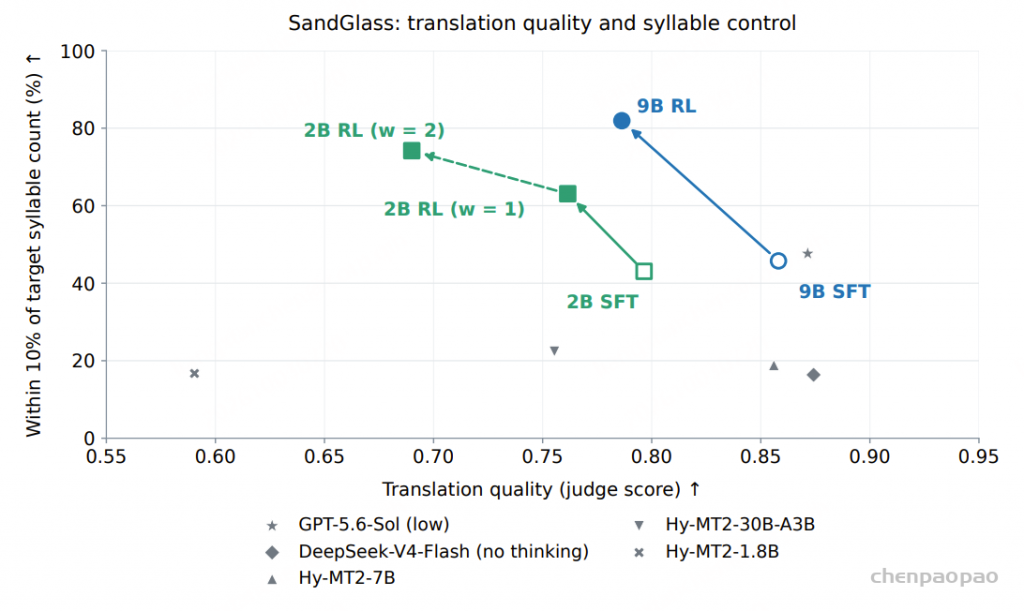
HOMURA 论文指出,大语言模型翻译存在跨语言“冗长偏置”:译文往往比时间预算允许的长度更长。它提出 Sand-Glass 基准,用真实视频转写、停顿分段和信息密度校准构造音节级时长约束。中文到英文、德文、西班牙文的理论扩展约为 1.03、1.19、1.49 倍,但未经约束的 LLM 平均扩展可达到 1.35、1.59、1.84 倍。
HOMURA 的基本长度比定义为:
\(\rho(x,y)=\frac{\sigma(y)}{\max(\sigma(x),1)}\)其中 \(\sigma(\cdot)\) 是音节数。模型使用动态区间 \([L(x),R(x)]\),短句会适当放宽下界,长度奖励采用区间内满分、区间外指数衰减;质量奖励则由回译语义相似度、流畅性判定和可选的 GenRM 组成。整体目标可写为:
\(R(x,c,y)=\lambda_{len}R_{len}(x,y)+\lambda_{qual}R_{qual}(x,y)\)在 3,600 条 Sand-Glass 测试案例中,Index-Homura-9B 的输出有 81.92% 与目标音节数偏差不超过 10%,明显高于普通模型的约 13%–48%。代价是:当约束越来越紧时,COMET 等质量指标会下降,模型必须在信息密度与自然度之间做可解释的折中。
| 模型 | Quality | 偏差≤1 音节 | 偏差≤10% | 长度拟合斜率 |
|---|---|---|---|---|
| Index-Homura-9B(RL) | 0.7863 | 74.42% | 81.92% | 0.968 |
| Index-Homura-9B(SFT) | 0.8581 | 41.39% | 45.75% | 0.680 |
| GPT-5.6-Sol(low) | 0.8715 | 42.53% | 47.64% | 0.891 |
| Qwen3.5-9B | 0.7183 | 15.61% | 16.39% | 0.430 |
3. Index-NativeLong:原生长文档而不是“分块 + 词表”
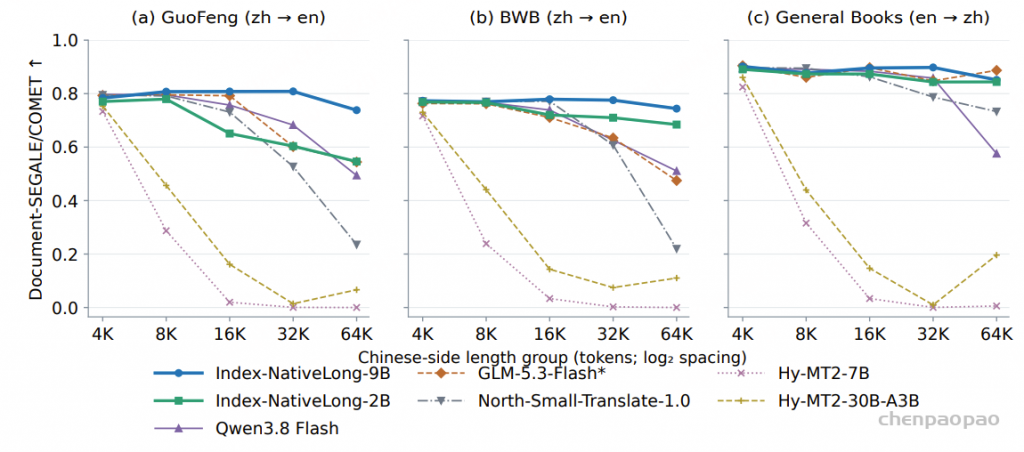
NativeLong 的关键假设是:书籍翻译中的人物身份、术语层级和叙事关系,不能完全依靠分块翻译后再拼接。2B/9B 模型通过约 4K–64K 中文侧 token 的双向文档监督进行全参数 SFT,并在 mid-training decay 阶段使用 128K 序列实验。报告显示,Index-NativeLong-9B 在 GuoFeng、BWB、General Books 上的平均得分分别为 0.7891、0.7683、0.8848。
案例中,32K token 奇幻文本里的“王妃”在原生全文翻译的三个位置都保持为 Wang Fei,而同一 9B 模型使用分块和自动词表时,后文变成 the Dean、The Queen Consort。冰川史案例也显示,原生全文能够区分 ice age(冰河时代)、glacials(冰期)和 interglacials(间冰期),避免把上下位概念压成同一个词。
四、RIVAL 与 HOMURA:两条强化学习技术线
Index-Translate 技术报告明确吸收了 RIVAL 的训练思想。RIVAL 发现,传统 RLHF 中离线 reward model 会因为策略分布不断变化而失配,模型可能通过“奖励投机”获得高分,却生成不存在于原文的内容。因此 RIVAL 把 reward model 与翻译模型写成迭代的 min–max 对抗过程:
\(\min_{r_\phi}\max_{\pi_\theta}\;\mathbb{E}[r_\phi(x,\pi_\theta(y|x))]-\mathbb{E}_{y\sim P_{strong}}[r_\phi(x,y)]\quad\text{s.t.}\quad D_{KL}(\pi_\theta\|\pi_{ref})<\eta\)RIVAL 的 reward model 同时学习定性偏好和定量偏好:前者用强/弱翻译排序,后者用 BLEU 的 MAE 近似。实验中,MAE 的定量误差为 0.19、定性准确率为 99.5%,优于 MSE 的 0.93 和 97.0%。在中文到英文的口语字幕任务上,RIVAL-Iter1 的 GPT-4o 平均评分为 3.68,优于 Qwen2.5-7B-SFT 的 3.46;WMT 中文到英文在 Iter2 达到 BLEU 33.42、COMETKiwi 73.61。
两条技术线各自解决不同问题:RIVAL 解决 reward model 与策略分布漂移,HOMURA 解决时长约束下的质量—压缩折中。Index-Translate 则把这些训练方法组合到通用翻译、指令翻译、MEME 和字幕任务中。
五、实验对比:质量、约束遵循与小语种不能混成一个分数
技术报告使用 FLORES-200、FLORES 低资源对、WMT24++、WMT26、instTrans、IFMTBench、MEME、OPUS-Books、Biomedical、MTNT、MuST-Cinema 和 GuoFeng-Webnovel 等数据。需要注意:COMET-22、XCOMET-XXL、WMT judge、IFscore 和 MEME 分数的量纲不同,不能直接横向相加。
| 模型 | FLORES COMET-22 | WMT26 Judge | instTrans IFscore | MEME |
|---|---|---|---|---|
| Index-Translate-35B-A3B(preview) | 0.8794 | 76.76 | 0.8336 | 0.7405 |
| Index-Translate-9B | 0.8789 | 75.35 | 0.8209 | 0.7387 |
| Index-Translate-2B | 0.8655 | 60.26 | 0.7569 | 0.6443 |
| Hy-MT2-7B | 0.8747 | 60.51 | 0.6079 | 0.5139 |
| GPT-5.6-Sol | 0.8650 | 89.10 | 0.7624 | 0.7194 |
低资源结果更能体现项目的训练取向:35B-A3B 在 FLORES_minor_pair 上取得 COMET-22 0.8168、XCOMET-XXL 0.7164,off-target 仅 2.4%;9B 在 instTrans_minor 上取得 IFscore 0.7725,且 off-target 为 3.47%。指令基准 instTrans 包含 3,000 条中文到 20 种语言任务,低资源扩展另有 2,793 条;MEME 则包含 3,638 条中译英社区表达,覆盖 703 个词语和 857 个词义。
通用能力方面,Index-Translate-9B 的 C-Eval、GPQA-Diamond、INCLUDE、MMMLU 分数分别为 69.6、36.3、63.1、66.6;这说明专家融合后仍保留一定基础模型能力,但它的主要优势仍在翻译与约束任务,而非通用问答榜单。
六、最值得关注的创新点
- 能力边界被显式建模:把“格式是否保留、术语是否一致、目标语言是否正确、音节是否命中、长文身份是否稳定”作为可测量目标,而不是只看译文流畅度。
- 多语基础与专门模型分工:150 语种共享基础模型,语音、音节、长文档采用专门训练,避免一个模型在所有约束上互相牺牲。
- 奖励函数更接近生产需求:通用翻译使用 XCOMET、目标语言 gate 和 adequacy;指令翻译加入硬约束 gate;HOMURA 加入动态音节奖励;RIVAL 用迭代 reward model 缓解 reward hacking。
- 参数融合后再定向蒸馏:先用 0.8/0.1/0.1 融合通用、指令和 MEME 专家,再通过 MOPD 修复融合造成的局部退化。
- 从句子级走向内容生产级:语音输出、时间轴、声音条件、结构化数据和全篇一致性都进入同一产品路线。
七、局限与使用建议
第一,35B-A3B 仍是 preview,论文与 README 的部分评测使用不同解码和汇总口径;引用数据时应注明模型版本和指标。第二,音节数只是语音时长代理,真实配音还受语速、停顿、音素时长和声码器影响。第三,NativeLong 对超长文档的显存、吞吐和错误恢复要求较高,生产部署仍要评估上下文窗口与并发成本。第四,LLM judge、回译和 XCOMET 都可能存在偏差,官方也记录了引用后缀、终止标记等 judge failure cases。
如果你的任务是结构化资料、社区内容或多语言产品文本,优先选择 Index-Translate-9B;如果是低延迟或资源受限场景,可从 2B 开始。如果是视频字幕和配音,建议使用 Index-Echo + Index-Homura 的组合,并把实际音频时长作为最终验收标准;如果是书籍、网文或技术报告,优先测试 NativeLong 的全篇一致性,再决定是否采用分块流程。
八、结语
Index-Translate 的价值不只在于“多翻几种语言”,而在于重新定义翻译模型的交付指标:能否保留结构、接住语境、压进时长、维持音色,并在一整本书里保持同一个人物和概念。它的工程路线也很清晰:共享多语底座,专家化训练,参数融合与定向蒸馏,再为语音、长度和长文档建立专门接口。对于希望把翻译直接接入内容生产流程的团队,这种模型家族式设计比单一榜单分数更值得关注。
参考资料
- Index-Translate GitHub README:https://github.com/bilibili/Index-Translate/blob/main/README_zh.md
- Index-Translate 技术报告:arXiv:2609.40181
- HOMURA:arXiv:2601.10187
- RIVAL:arXiv:2506.05070
- Hugging Face 论文合集:Index-Translate Papers
- 公众号文章:B站开源 Index-Translate 多语言翻译模型家族