- 论文题目:dLLM-ASR: A Faster Diffusion LLM-based Framework for Speech Recognition
- 论文链接:arXiv:2601.17902
大语言模型语音识别(LLM-ASR)通常“准”,但解码仍是逐 token 的自回归生成,延迟会随句子长度线性增长。离散扩散大语言模型(dLLM)可以并行生成整段序列,却容易从全掩码开始、固定输出长度,并让每个 token 使用同样的去噪步数。论文提出的 dLLM-ASR 将 ASR 解码重新定义为先验引导的自适应去噪:用轻量 ASR 先验提供更好的初始状态和长度锚点,用长度自适应剪枝去掉冗余填充 token,再用基于置信度的早停把计算集中到仍然模糊的位置。
一句话结论:dLLM-ASR 在保持与自回归 LLM-ASR 接近的识别准确率的同时,平均 RTF 降至 0.063,相对 Whisper-LLaMA3 取得 4.44× 加速,并在论文比较的模型中给出了最好的精度—效率折中。
一、为什么要把扩散语言模型用于 ASR
LLM-ASR 通常由语音编码器、模态对齐模块和 LLM 解码器组成。它可以利用预训练语言模型的语义推理、长尾词汇和上下文建模能力,但自回归(AR)解码必须按顺序预测每一个 token,复杂度近似为:
\(T_{\mathrm{AR}}=\mathcal{O}(N)\)非自回归(NAR)模型可以并行预测,理论上更快,但往往缺少大规模基础模型的语言知识。dLLM 在离散 token 空间中进行多轮并行去噪,在保留预训练 LLM 语义能力的同时,将生成过程改写为有限轮数的迭代 refinement:
\(T_{\mathrm{dLLM}}=\mathcal{O}(K),\quad K\ll N\)问题在于,文本 dLLM 面向的是开放式生成,而 ASR 是由声学输入强约束的映射任务。直接移植会产生三类浪费:从全掩码序列开始,忽略语音中已有的信息;输出长度预先写死,过长会产生大量 padding,过短又可能截断;所有 token 使用统一的去噪预算,已经确定的简单词仍被重复计算。
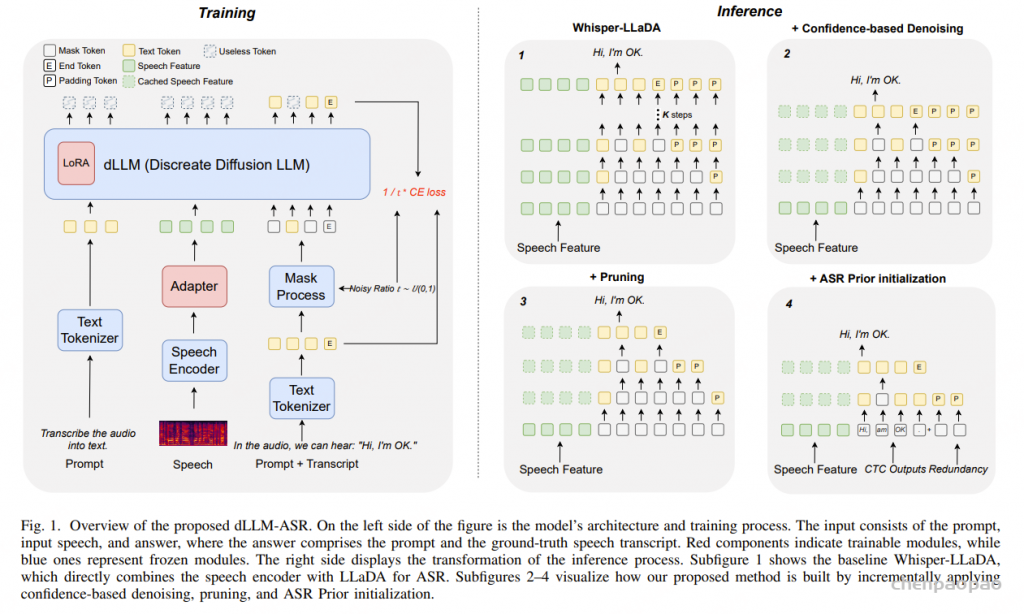
二、dLLM-ASR 的整体设计
dLLM-ASR 由三部分组成:冻结的 Whisper-large-v3 语音编码器、轻量级 adapter,以及以 LLaDA-8B-Instruct 为基础的 dLLM 解码器。语音编码器以 25 Hz 输出声学表示;adapter 先用 kernel size 为 3、stride 为 2 的一维卷积把帧率降到 12.5 Hz,再通过线性层将 1280 维声学特征投影到 LLaDA 的 4096 维 embedding 空间。
设输入语音为 \(W\),声学条件特征为:
\(A=\mathrm{Projector}\big(\mathrm{SpeechEncoder}(W)\big)\)解码器接收文本提示、语音特征和转写序列。训练时,真实转写 \(x_0\) 中的 token 以概率 \(t\in(0,1]\) 独立替换为特殊掩码 \([\mathrm{M}]\),得到 \(x_t\);模型根据 \(x_t\) 和语音条件 \(A\) 恢复被掩盖的 token。论文采用带 \(1/t\) 归一化的掩码重建目标:
\(\mathcal{L}=-\mathbb{E}_{t,x_0,x_t}\left[\frac{1}{t}\sum_{i=1}^{L}\mathbb{I}(x_t^i=[\mathrm{M}])\log p_\theta(x_0^i\mid x_t,A)\right]\)当掩码比例较低时,\(1/t\) 会提高该样本的权重,避免不同噪声水平造成训练偏置;同时以概率 \(\alpha\) 令 \(t=1\),增强模型从全掩码状态恢复转写的鲁棒性。
两阶段训练与聊天式数据格式
第一阶段只训练 adapter,冻结语音编码器和 dLLM;第二阶段在 LLaDA 中加入 LoRA,同时优化 adapter 与 LoRA 参数,从而尽量保留预训练 dLLM 的语言能力。论文还发现,数据格式对生成质量影响明显:把语音表示和转写包装成类似文本 LLM 的 chat-style prompt,有助于激活模型原有的指令跟随能力,并缩小跨模态差距。
三、核心创新:先验引导的自适应去噪
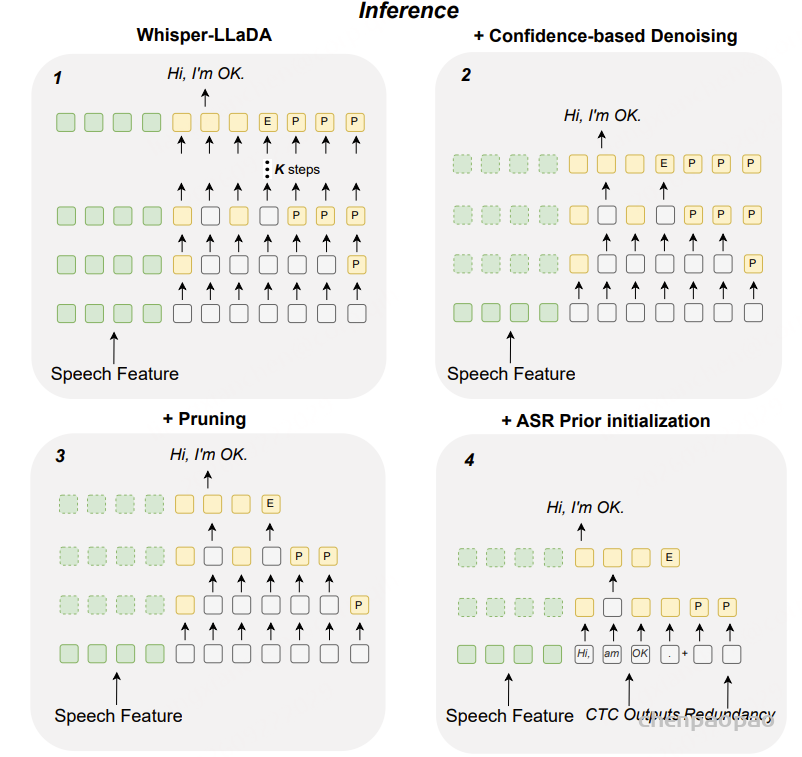
1. ASR 先验初始化。论文增加一个极轻量的 CTC 分支,在冻结语音编码器输出上预测初始 ASR 先验。该分支仅包含下采样卷积和分类头,额外计算开销很小。先验不要求一次性给出最终答案,而是作为扩散过程的起点:它提供较好的语义锚点,也自然给出候选序列长度。与从全掩码开始相比,第一轮就会有更多 token 达到置信度阈值。
2. 基于置信度的 token 早停。每一轮去噪后,若某个 token 的最大预测概率超过阈值 \(\tau\),就将其固定并退出后续迭代。这样,清晰的词或字符只需较少步数,难点位置则继续 refinement。为避免错误 token 过早锁定,论文采用较高阈值,并在没有 token 达标时选择置信度最高的 top-\(\gamma\) 个 token 推进过程。
3. 长度自适应剪枝。ASR 中 padding token 往往熵低、收敛快,第一轮即可识别。模型在固定高置信 token 的同时检测序列尾部 padding,并逐轮删除冗余位置,动态收紧长度上界。该策略避免了固定 128 token 生成长度带来的无效计算。
4. 语音 KV cache。模型缓存与语音特征对应的 Key/Value,并在后续去噪轮次复用;由于缓存严格限制在 speech features 上,论文观察到几乎没有精度损失。这使每一轮只需更新尚未确定的文本位置。
完整推理流程可以概括为:先验初始化状态与长度 → 第一轮锁定高置信 token、提取语音 KV cache、识别尾部 padding → 后续轮次复用 cache,只更新未决位置并持续剪枝 → 所有位置确定后结束。
四、实验设置
训练数据共 13,900 小时,来自 LibriSpeech、CommonVoice 22.0 English 和 GigaSpeech。测试集包括 LibriSpeech test-clean、LibriSpeech test-other、CommonVoice English test,并加入域外的 VoxPopuli English test 检验泛化能力。
解码器为 8B 参数的 LLaDA-8B-Instruct,语音编码器为冻结的 Whisper-large-v3。训练时总 mask 概率 \(\alpha=0.2\);LoRA rank 为 16,缩放系数为 32,dropout 为 0.05;优化器为 AdamW(\(\beta_1=0.9,\ \beta_2=0.999\))。两阶段均训练 5 个 epoch、总 batch size 256,学习率先在线性 warm-up 4,000 步后升至 \(1\times10^{-4}\),再按 cosine 调度衰减。所有实验使用 16 张 NVIDIA A100。
对比模型包括自回归的 Whisper-LLaMA3 8B、Whisper-Qwen3 8B,以及直接把语音编码器、adapter 与 LLaDA 拼接的 Whisper-LLaDA。后者固定生成长度为 128 token,覆盖约 99% 的语音转写。评价指标为词错误率(WER,越低越好)和实时率(RTF,计算时间/音频时长,越低越好)。
五、主要结果:速度和准确率同时进入更优区域
| 模型 | 解码器参数 | LS clean WER / RTF | LS other WER / RTF | CV test WER / RTF | VoxPopuli WER / RTF | 平均 WER / RTF |
|---|---|---|---|---|---|---|
| Whisper-LLaMA3 | 8.03B | 2.15 / 0.317 | 5.58 / 0.330 | 8.55 / 0.203 | 9.89 / 0.268 | 6.54 / 0.280 |
| Whisper-Qwen3 | 8.19B | 2.72 / 0.410 | 6.62 / 0.427 | 9.18 / 0.355 | 10.06 / 0.364 | 7.15 / 0.389 |
| Whisper-LLaDA | 8.02B | 2.34 / 1.678 | 5.22 / 1.892 | 8.80 / 2.029 | 9.68 / 1.344 | 6.51 / 1.736 |
| dLLM-ASR | 8.02B | 2.28 / 0.057 | 5.17 / 0.076 | 8.36 / 0.057 | 9.56 / 0.060 | 6.34 / 0.063 |
从表 1 可以看到,dLLM-ASR 的平均 WER 为 6.34%,优于 Whisper-LLaMA3 的 6.54%、Whisper-Qwen3 的 7.15%,也略优于直接移植的 Whisper-LLaDA(6.51%)。在更具挑战性的 LibriSpeech test-other、CommonVoice 和 VoxPopuli 上,dLLM-ASR 均取得最低 WER;在 test-clean 上也保持竞争力。
速度差异更明显:dLLM-ASR 平均 RTF 仅为 0.063,而 Whisper-LLaMA3、Whisper-Qwen3 和 Whisper-LLaDA 分别为 0.280、0.389 和 1.736。换算后,dLLM-ASR 相对 Whisper-LLaMA3 加速约 4.44×,相对 Whisper-Qwen3 加速约 6.17×,相对直接的 Whisper-LLaDA 加速约 27.6×。这说明扩散模型本身并不会自动带来速度优势,真正关键的是先验初始化、长度剪枝和 token 级早停的协同。
六、消融实验说明了什么
| 模型/变体 | LS clean WER / RTF | LS other WER / RTF |
|---|---|---|
| dLLM-ASR | 2.28 / 0.057 | 5.17 / 0.076 |
| w/o ASR Prior | 2.29 / 0.069 | 5.20 / 0.084 |
| w/o Length Pruning | 2.27 / 0.071 | 5.13 / 0.089 |
| w/o Chat-Style Prompt | 2.87 / 0.056 | 5.76 / 0.076 |
| Whisper-LLaDA | 2.34 / 1.678 | 5.22 / 1.892 |
| Whisper-LLaDA + confidence denoising | 2.98 / 0.077 | 5.98 / 0.108 |
去掉 ASR prior 后,LS clean/other 的 RTF 从 0.057/0.076 上升到 0.069/0.084,说明更好的初始状态可以显著减少去噪轮次。去掉长度剪枝后,RTF 进一步上升到 0.071/0.089,验证了删除 padding 对效率的直接贡献。去掉 chat-style prompt 虽然速度变化不大,却使 WER 明显恶化到 2.87/5.76,说明数据组织方式对跨模态对齐和生成质量非常关键。
值得注意的是,仅把 confidence-based denoising 加到 Whisper-LLaDA 上,RTF 可以降到 0.077,但 WER 反而升至 2.98/5.98。这一结果说明“早停”不能孤立使用:如果没有先验提供可靠起点、没有长度剪枝控制候选空间,单独追求更少的迭代会造成错误过早固化。
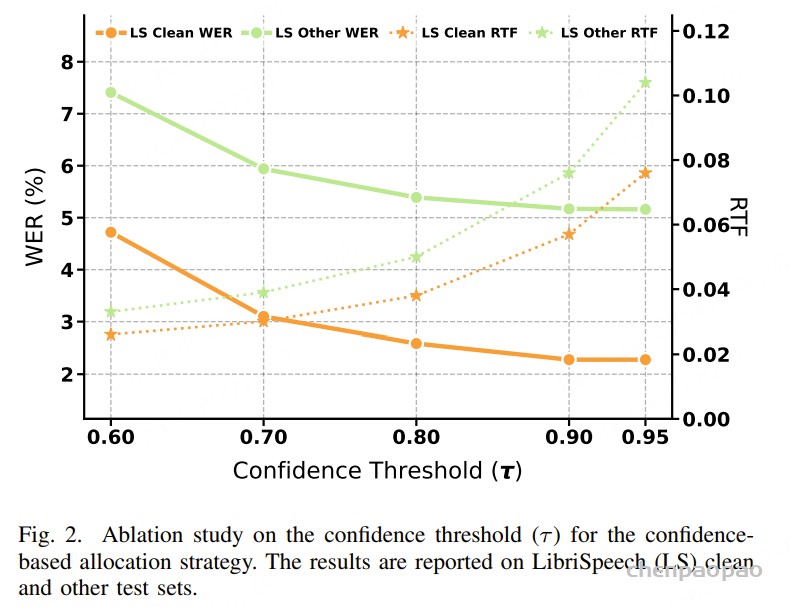
阈值的选择
论文进一步扫描置信度阈值 \(\tau\)。阈值从 0.6 提高到 0.9 时,token 接受更谨慎,WER 改善但 RTF 变高;阈值继续从 0.9 提高到 0.95,WER 差异已经很小。因此作者将 \(\tau=0.9\) 作为默认值,在速度和精度之间取得更好的平衡;推理时 top-\(\gamma\) 参数取 1。
七、如何理解这项工作的价值
dLLM-ASR 的关键不只是“把 LLM 换成扩散 LLM”,而是针对 ASR 的结构性约束重新设计推理过程。语音已经提供了强条件,因此没有必要像开放式文本生成那样从纯噪声猜测;ASR 的输出存在明显的长度和 padding 结构,因此可以主动删掉简单位置;不同词的识别难度不同,因此计算预算应当按 token 分配,而不是统一分配给整句。
从系统角度看,这是一种“先验负责覆盖,扩散负责纠错”的组合:轻量 CTC 分支快速给出可用草稿,dLLM 再利用强语言模型能力修正含糊、长尾或上下文依赖的位置。最终模型在精度—效率平面上形成新的 Pareto 前沿,尤其适合对实时性敏感、又不能接受明显识别退化的语音应用。
八、局限与后续方向
论文当前主要验证英语离线或整段语音识别,默认仍需要为一段输入建立完整的候选序列。阈值、先验质量和 padding 剪枝规则也会影响不同数据域下的稳定性。作者将后续工作指向流式 ASR 和更多任务场景,这也是检验扩散式解码能否在持续输入、动态上下文中保持优势的关键。
结语
dLLM-ASR 给出了一个清晰的答案:扩散 LLM 可以用于高质量语音识别,但必须从“通用文本生成”转向“受语音先验约束的自适应 refinement”。通过 ASR prior、长度自适应剪枝、置信度早停和语音 KV cache,论文在 8B 参数规模下实现了平均 WER 6.34%、平均 RTF 0.063,并相对自回归 Whisper-LLaMA3 达到 4.44× 加速。其更具普适性的启示是:当生成任务拥有强条件输入时,最有效的扩散推理往往不是从噪声开始,而是从一个便宜但有信息的先验开始。