文章:https://mp.weixin.qq.com/s/DM1FSdVinKyI_IYJ_e9dbg
语音增强评价方法(2):PESQ、STOI、SI-SDR 分别在测什么
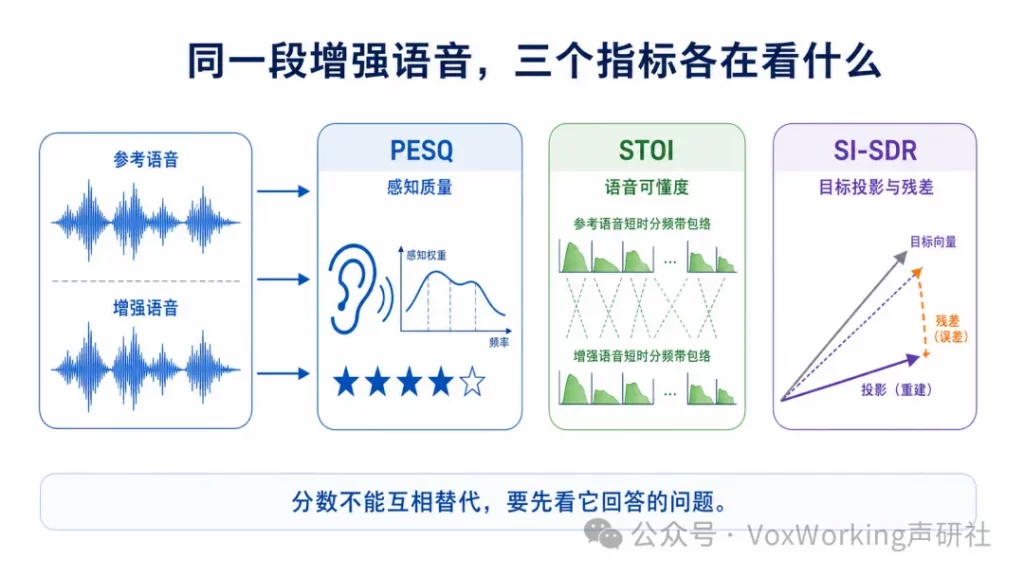
做语音增强时,模型输出更干净,未必听感最佳。本期介绍以下评价指标:PESQ、STOI 与 SI-SDR 分别从感知质量、可懂度和信号重建误差三个角度评价语音增强的效果,并使用Github开源代码对示例音频进行计算评价(附Github源码链接),让大家对这几个指标有个大致的认识。
1. PESQ 评价:与参考音频感知质量的相近程度
PESQ(Perceptual Evaluation of Speech Quality)是全参考语音质量指标,它需要一段干净参考语音和一段经过系统处理后的语音结果,用感知模型估计两者差异对听感质量的影响。它最初面向窄带电话网络、语音编解码和传输链路的端到端质量评估;宽带扩展也常被用于语音增强实验。
从计算过程来看,PESQ 先对参考语音与处理后的语音做时间对齐和电平处理,再映射到近似人耳感知的表示,聚合时频域中的感知扰动,最后输出一个质量预测分。需要注意的是参考和待测语音需要是同一句内容且需要对齐。可以把 PESQ 的处理过程概括为:
参考语音 + 处理后语音
        ↓
时间对齐与电平处理
        ↓
听觉频带 / 响度映射
        ↓
计算对称与非对称感知扰动
        ↓
聚合为 PESQ 质量预测分
Github源码链接:https://github.com/audiolabs/PESQ
2. STOI 评价:语音可懂度
STOI(Short-Time Objective Intelligibility)也是全参考指标,但侧重点偏向于“语音可懂度”。它由 Taal 等人在噪声与时频加权失真语音的可懂度预测任务中提出,目标是让自动分数与听音实验中的语音可懂度趋势相关。其核心思路是,比较干净语音与处理后语音在短时、分频带区域内的时间包络相关性,核心计算可以写成“分频带、短时间段相关系数的平均值”:
STOI = 平均值 { corr(xⱼ,m, y′ⱼ,m) }其中,xⱼ,m 是第 j 个三分之一倍频程内、以第 m 帧为末尾的一段参考语音包络;y′ⱼ,m 是与之对应、经过归一化和限幅处理后的增强语音包络;corr(·) 是两段包络的皮尔逊相关系数。也就是说,STOI 不直接比较逐个波形采样点,而是观察关键频带的短时能量起伏是否仍与参考语音保持一致。
从定义也可以看出来,STOI 更在意辅音、元音和音节节奏等承载内容的短时结构有没有被破坏。其计算时会去除低能量静音帧,将信号变换到短时频带表示,按三分之一倍频程汇聚包络,并在短时间段内计算参考与处理结果的相关性后求平均。同一组语料下,分数通常接近 0 到 1,数值更高通常表示预测可懂度更好。有时候一个模型可能把背景压得很低,STOI 却没有提升,甚至下降。原因往往是算法同时削弱了弱辅音、词尾或瞬态结构。
Github源码链接:https://github.com/mpariente/pystoi
3. SI-SDR评价: 尺度不变信号失真比
SI-SDR(Scale-Invariant Signal-to-Distortion Ratio,尺度不变信号失真比)常用于语音分离与端到端语音增强。它将估计语音 ŝ 投影到目标语音 s 的方向上,先允许一个最优的整体缩放,再把剩余部分看作失真。与直接比较幅度的指标不同,整体音量被放大或缩小本身不会改变 SI-SDR,这正是“scale-invariant”的含义。其常用定义如下,其中 ŝᵀs 表示内积,||·||² 表示信号能量:
α = (ŝᵀs) / ||s||²
e_target = αs
e_res = ŝ − e_target

SI-SDR = 10 log₁₀ (||e_target||² / ||e_res||²)因此它评价的是:在忽略一个全局增益差异后,估计结果中有多少能量落在目标语音方向上,剩余误差有多少。 分数越高,表示与目标信号的投影关系越好。SI-SDR 对训练和评测都很方便,尤其适合有明确干净目标或分离目标的监督任务。
Github源码链接:https://github.com/fgnt/pb_bss/blob/master/pb_bss/evaluation/module_si_sdr.py
4. 指标比较
| 指标 | 最主要的测量对象 | 更适合回答的问题 | 容易遗漏的方面 |
|---|---|---|---|
| PESQ | 感知质量预测 | 听起来是否更接近干净语音 | 语义是否可懂、分布外伪影 |
| STOI | 短时包络结构与可懂度趋势 | 语音内容是否仍容易辨认 | 自然度、残余噪声是否令人舒适 |
| SI-SDR | 与目标信号的投影误差 | 信号重建/分离误差是否减小 | 人耳感知质量与主观偏好 |
5. 评价示例
本文以一个示例音频(包括1个参考干净语音、相对应的1个经过降噪处理后的语音, 48k采样率)进行3个指标的计算,示例音频时域图如下:
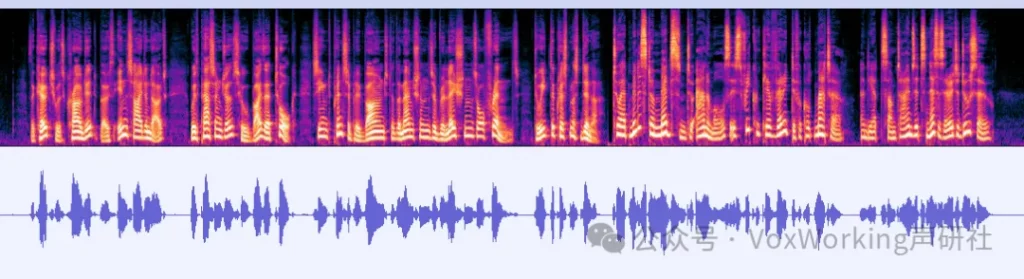
参考干净语音时域图与频谱图
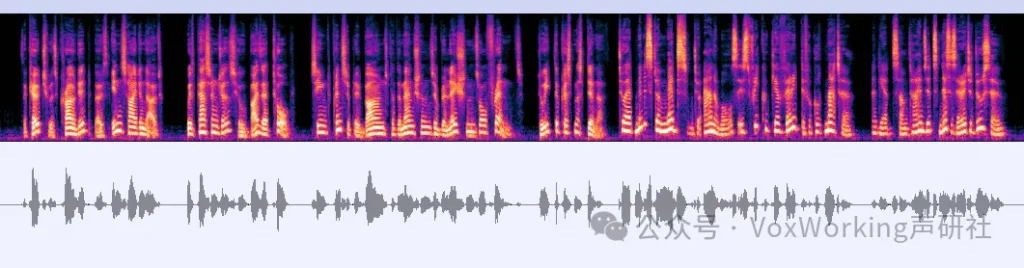
降噪处理后的语音时域图与频谱图
3个指标的计算结果如下:
| 指标 | 时延计算 | 未时间对齐 | 时间对齐后 |
|---|---|---|---|
| PESQ | 0.04s | — | 1.8573 |
| STOI | 0.04s | 0.2049 | 0.8418 |
| SI-SDR | 0.04s | -35.2156 dB | 6.7163 dB |
3个指标都需要对音频进行时间对齐的,其中PESQ由于源码内部做了时间对齐,所以PESQ结果暂时只有对齐后的结果,没有额外做“未时间对齐的结果”。从另外两个指标可以看到,时间对齐与否对结果的影响还是很大的。其中 PESQ 越接近分值 5,STOI越接近 1,SI-SDR越大,通常代表结果越好。
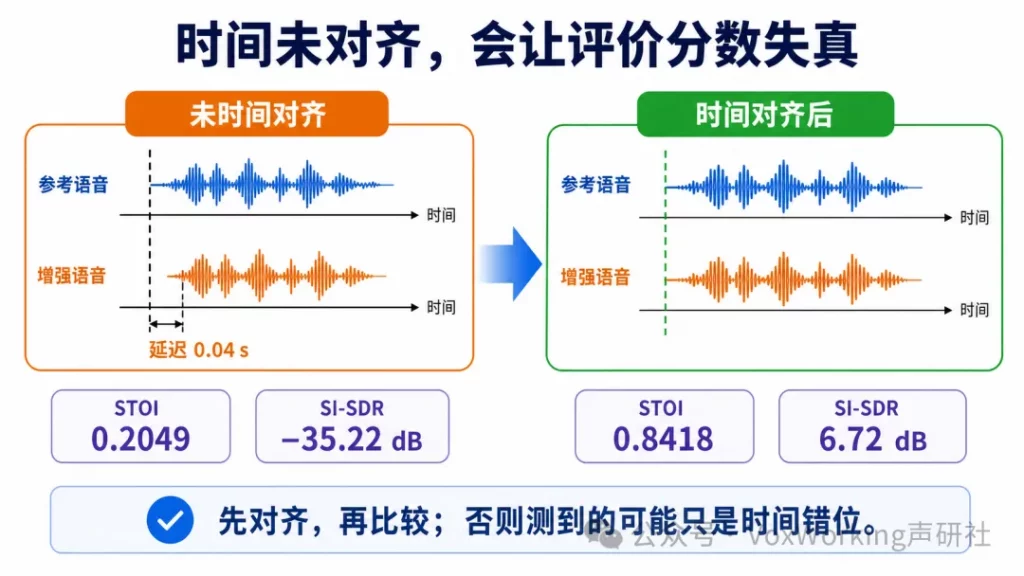
图 2:示例音频存在 0.04 s 时延。对齐前后的 STOI 和 SI-SDR 差异表明,评测前必须先处理时间错位。
6. 小结
PESQ、STOI、SI-SDR 并非三种对同一件事的重复评分:PESQ 侧重预测感知质量,STOI 侧重语音内容的可懂度,SI-SDR 侧重与目标语音的尺度不变重建误差。评测语音增强算法时,先明确应用是追求通话体验、内容可懂、信号分离,还是它们的组合;再用相应指标观察代价,并把异常样本带回试听和真实链路验证。
参考资料
- 1. ITU-T P.862, Perceptual evaluation of speech quality (PESQ): An objective method for end-to-end speech quality assessment of narrow-band telephone networks and speech codecs. ITU 页面。
- 2. C. H. Taal, R. C. Hendriks, R. Heusdens, J. Jensen, An Algorithm for Intelligibility Prediction of Time–Frequency Weighted Noisy Speech, IEEE/ACM TASLP, 2011. DOI。
- 3. J. Le Roux, S. Wisdom, H. Erdogan, J. R. Hershey, SDR – half-baked or well done?, ICASSP 2019. 论文。