- Fish Audio Drama 3 技术报告:https://arxiv.org/html/2610.18010v2
- Github:https://github.com/fishaudio/fish-speech
- Fish Audio 权重:https://huggingface.co/fishaudio/drama-3
一、论文要点与模型定位
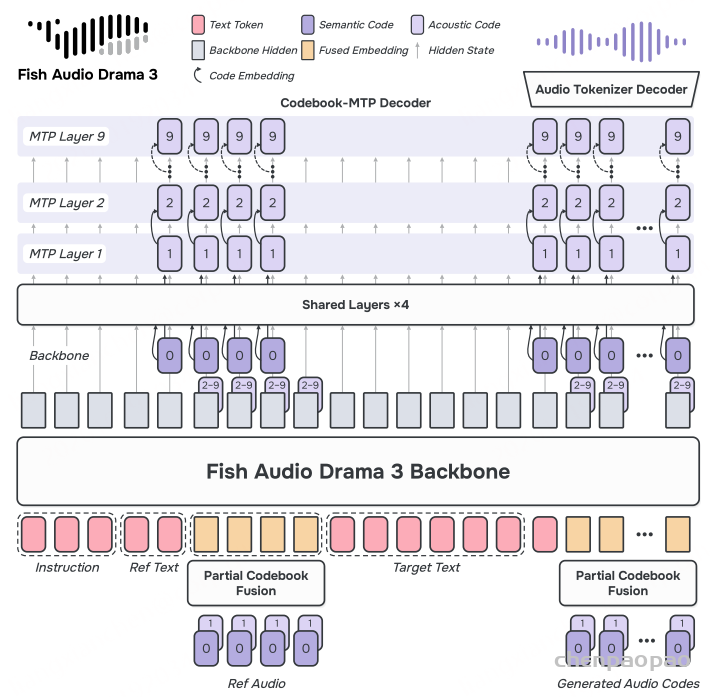
Drama 3 是一个开放权重语音生成模型,总参数量约 35B,但采用稀疏混合专家结构,每个 Token 实际激活约 3B 参数。模型主干由 Qwen3.5-35B-A3B 初始化,采用 40 层混合架构:每四层包含三层 Gated DeltaNet 线性注意力和一层 Gated Full Attention。语音部分沿用 Fish Audio S2 的离散音频 Tokenizer,每个音频帧由 10 个 Codebook 表示;模型主干预测语义 Codebook,新的 Codebook-MTP Decoder 在同一时间位置并行预测其余 9 个声学 Codebook。
论文把创新概括为三点:
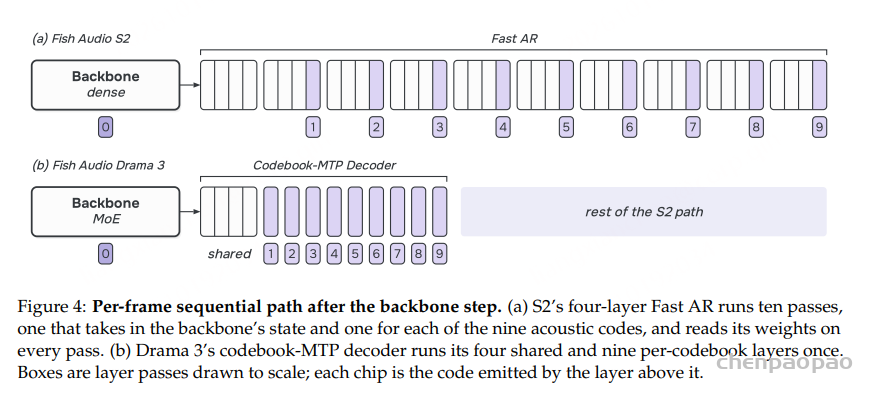
- Hybrid Backbone + Codebook-MTP Decoder:用线性注意力处理长上下文,同时用少量 Full Attention 保留远距离检索能力,并将 S2 的逐 Codebook Fast AR 替换成一次运行 13 层的多 Token 预测解码器。
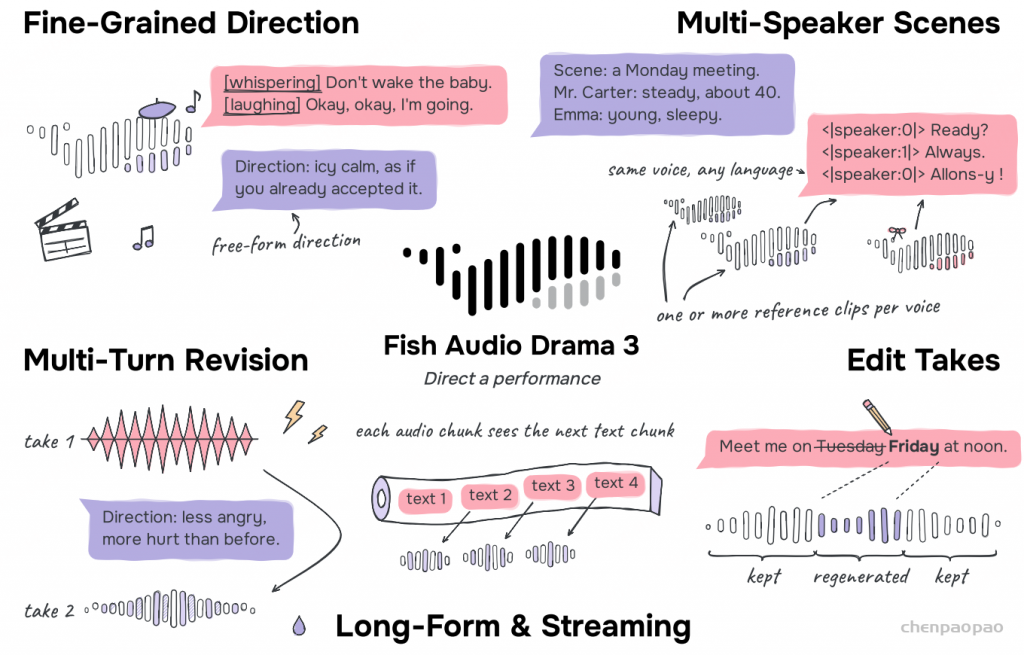
- 一个模型统一多任务:多参考音色克隆、自然语言控制、多角色场景、多轮导演式修改、Speech Infilling、长文本合成和 Streaming Text Input 使用同一种交错文本—音频 Token 流表示。
- 单一人类偏好奖励:RL 不再把 ASR WER、音质模型和 Speaker Similarity 作为规则奖励,而是训练一个小型 Speech Language Model 作为人类偏好 Reward Model。
二、总体架构
Drama 3 没有额外的音频编码器。参考音频、提示音频和生成音频都先通过离散 Audio Tokenizer 转换成 Codebook 序列,之后与文本 Token 交错输入语言模型。每一个音频帧只占用一个 Backbone 序列位置,因此一秒语音约占 21.5 个位置,与该帧包含多少个 Codebook 无关。
2.1 音频 Tokenizer
- 基于 Descript Audio Codec,输入采样率为 44.1 kHz。
- 约每秒 21.5 个音频帧,每帧 10 个 Codebook。
- Codebook 0 是语义码,Codebook 1–9 是逐级增加细节的残差声学码。
- 编码和解码完全因果,可以流式运行。
- 参考音频以离散 Token 进入上下文,因此参考音频的细粒度声学信息可以被后续 Decoder 直接访问。
2.2 Hybrid Backbone 与 MoE
主干初始化自 Qwen3.5-35B-A3B,仅使用其语言模型部分。40 层结构由三层 Gated DeltaNet 加一层 Gated Full Attention 组成周期。DeltaNet 使用近似常数大小的状态保存历史,只有每四层中的 Full Attention 保留随上下文增长的 KV Cache;Full Attention 用来精确检索长上下文中的参考音色、早先台词和场景信息。
每一层的前馈网络都是 MoE:共有 256 个 Routed Experts,每个 Token 路由到 8 个专家,并额外经过一个 Shared Expert。总参数约 35B,但每个 Token 约激活 3B 参数。MoE Router 在预训练和 SFT 阶段都加入负载均衡损失,避免大多数 Token 集中到少数专家。
2.3 Partial Codebook Fusion
S2 将 10 个 Codebook 全部反馈给 Backbone。Drama 3 只把语义码和第一层声学码反馈给 Backbone,Codebook 2–9 绕过 Backbone,作为 Decoder 的侧输入。这样既保留参考音频和已生成语音的粗粒度声学线索,也减少模型暴露在自身采样细节上的误差累积。
设第 t 帧的语义码和第一层声学码分别为 \(q_t^{(0)}\) 和 \(q_t^{(1)}\),则 Backbone 的音频输入为:
\( \mathbf{x}_{t}=\frac{1}{\sqrt{2}}\left(\mathbf{E}^{\mathrm{LM}}\left[s\left(q_t^{(0)}\right)\right]+\mathbf{E}^{(1)}\left[q_t^{(1)}\right]\right) \)其中 \(s(\cdot)\) 把语义码映射到新增的 4096 个语义 Token,\(\mathbf{E}^{\mathrm{LM}}\) 是语言模型词嵌入,\(\mathbf{E}^{(1)}\) 是第一声学 Codebook 的嵌入表。文本位置只使用语言模型嵌入;Codebook 2–9 不进入 Backbone。
2.4 Codebook-MTP Decoder
在第 t 个位置,Backbone 预测下一帧的语义码 \(q_{t+1}^{(0)}\);Decoder 在同一位置预测下一帧的 9 个声学码 \(q_{t+1}^{(1)},\ldots,q_{t+1}^{(9)}\)。Decoder 共有 13 层:前 4 层是共享层,后 9 层分别对应声学 Codebook 1–9。每一层沿完整时间序列做因果注意力,所以每一个声学 Codebook 都能看到参考音频和此前所有帧的声学细节。
每层先把注入的 Codebook 嵌入与上一层隐藏状态合并:
\(\mathbf{u}^{(\ell)}_t=\mathbf{W}^{(\ell)}\left[\operatorname{RMSNorm}\left(\mathbf{e}^{(\ell)}_t\right);\operatorname{RMSNorm}\left(\mathbf{h}^{(\ell-1)}_t\right)\right]\)随后经过因果 Transformer Block:
\(\mathbf{h}^{(\ell)}_t=\operatorname{RMSNorm}\left(\operatorname{Block}^{(\ell)}\left(\mathbf{u}^{(\ell)}_{1:t}\right)\right)\)第 k 个 Codebook 的输出分布可以写为:
\(q_{t+1}^{(k)}\sim\operatorname{softmax}\left(\mathbf{W}_{\mathrm{out}}^{(k)}\mathbf{h}^{(4+k)}_t\right),\qquad k=1,\ldots,9\)相较于 S2 的 4 层 Fast AR 重复运行 10 次,Drama 3 的 13 层 Decoder 每帧只运行一次,因而大幅缩短顺序路径。
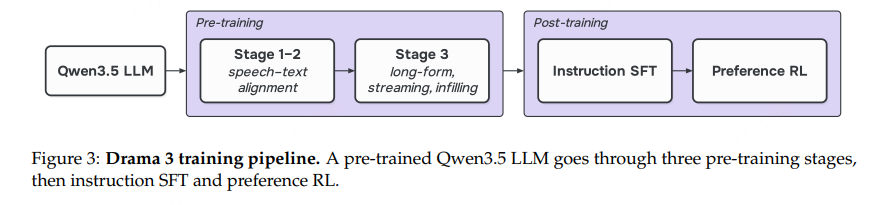
三、训练数据与三阶段预训练
数据由完成转录的语音和文本文档组成;所有语音在进入训练前先经过质量控制;文本文档用于保持 Backbone 的语言建模能力;总体训练规模为数千亿 Token;语言覆盖沿用 S2,约 80 种语言和方言。
3.1 Stage 1:基础文本到语音映射
- 最大序列长度 8K Token。
- 训练样本包括纯文本文档和多轮 TTS 对话。
- 目标是学习文本到音频 Token 的映射、普通 TTS 和零样本音色克隆。
- System 轮保存任务指令和参考音频,User 轮保存待合成文本,Assistant 轮保存目标音频 Token。
- 损失只计算在 Assistant 的音频输出、必要的分隔符和结束 Token 上。
3.2 Stage 2:降低梯度噪声
Stage 2 继续使用 Stage 1 的序列格式和任务分布,主要变化是 Batch Size 翻倍,从而降低梯度噪声;学习率衰减留到 Stage 3。它并非独立的新任务阶段,而是让基础语音建模能力在更稳定的优化条件下继续收敛。
3.3 Stage 3:长音频、流式和编辑
- 最大序列长度提升到 16K Token。
- 加入整段录音合成:参考音频来自同一录音的后部,目标是前部,避免参考片段和监督目标重叠。
- 加入逐行合成,用 \(<|audio_separator|>\) 对齐输入文本行和输出音频段。
- 加入 Streaming Interleave:每个 User 轮包含当前文本块和一个前瞻文本块,模型边生成当前块边知道后续内容。
- 加入 Speech Infilling:保留原音频编辑窗口前后的 Token,只生成窗口内部的新内容。
- 样本使用 Document Masking 打包成每行 128K Token,优化器为 Muon。
3.4 预训练目标
令 \(\mathcal{T}\) 为需要监督的文本位置(包括结束 Token 和逐行分隔符),\(\mathcal{S}\) 为语义 Codebook 监督位置,则:
\(\mathcal{L}_{\mathrm{text}}=-\frac{1}{|\mathcal{T}|}\sum_{t\in\mathcal{T}}\log p_{\theta}(x_t\mid x_{<t})\) \(\mathcal{L}_{\mathrm{sem}}=-\frac{1}{|\mathcal{S}|}\sum_{t\in\mathcal{S}}\log p_{\theta}\left(q_t^{(0)}\mid x_{<t}\right)\) \(\mathcal{L}_{\mathrm{cb}}=\frac{1}{9}\sum_{k=1}^{9}\left(-\frac{1}{|\mathcal{S}|}\sum_{t\in\mathcal{S}}\log p_{\phi}\left(q_t^{(k)}\mid\mathbf{h}_{<t},\mathbf{q}_{<t},q_t^{(<k)}\right)\right)\)总损失为:
\(\mathcal{L}=\mathcal{L}_{\mathrm{text}}+0.5\mathcal{L}_{\mathrm{sem}}+0.5\mathcal{L}_{\mathrm{cb}}\)文本、语义码和声学码各自按自己的监督桶取平均,避免一个 Batch 中文本和语音比例变化导致损失权重漂移;声学 Codebook 损失会反向传播到 Backbone。预训练和 SFT 同时加入 MoE Router 负载均衡损失。
四、Instruction SFT 阶段:如何让模型学会“听懂导演指令”
SFT 从 Stage 3 Checkpoint 开始,最大序列长度为 32K Token,使用 Indexed Reference Layout。SFT 的目标不是重新学习基础发音,而是把已经具备 TTS 和克隆能力的模型转化为能够遵循复杂自然语言指令、处理对话和场景的生成器。
4.1 SFT 数据类型
- 普通音色克隆:一段或多段参考音频 + 待合成文本。
- Point Tags:在文本位置插入
[laughs]、[pause]、[coughs]等局部事件。 - Scoped Tags:用
<whisper>...</whisper>只控制被包围的词或短语。 - Style Prefix:控制整句的情绪、语速、表达方式。
- Director’s Note:用自然语言描述意图、节奏、重音和表演方式。
- 多说话人对话:每个角色绑定一个或多个参考音频,通过 speaker Token 切换角色。
- 多角色场景:一次提供所有台词,并使用显式分隔符,使当前句能够利用后续台词和场景上下文。
- 多轮修改:保留旧参考和上一版生成结果,下一轮用“更柔和、更温暖”“比上一版更快”等相对指令生成新版本。
- 长文本、Speech Infilling 和 Text-only Chat:继续混入训练,防止 SFT 破坏 Stage 3 已学能力。
4.2 SFT 样本如何组织
训练序列采用 ChatML 风格。System 轮包含“把给定文本转换成语音”的任务说明、参考文本和参考音频;User 轮包含目标文本、说话人标记、控制标签和语言/时长提示;Assistant 轮以 \(<|voice|>\) 开始,输出目标音频的 10 个 Codebook。对于多轮修改,旧的 Assistant 音频保留在上下文中,下一轮 User 给出相对上一版的修改意见。
损失只作用于模型自己的 Assistant 输出:语音帧的 10 个 Codebook、需要学习的音频分隔符和 \(<|im_end|>\)。参考音频只提供上下文,不直接产生生成损失。Speech Infilling 额外对编辑窗口两侧的接缝加大监督,使新旧音频能够自然拼接。
五、RL:从可控生成到符合人类偏好的表演
RL 从 SFT Checkpoint 开始。S2 使用 ASR 转录错误、语音质量和 Speaker Similarity 三类规则奖励;Drama 3 去掉它们,因为笑声和长停顿会改变 ASR 结果,耳语和喊叫会降低与中性参考的相似度,而整句质量模型无法评价某个词是否按指令变得更柔和或更有情绪。
5.1 人类偏好 Reward Model
Reward Model 是一个较小的 Speech Language Model,使用相同的 Audio Tokenizer 和序列格式预训练到 Stage 2,并在每条 Take 的结束 Token 上增加 Scalar Head。它直接读取完整 Prompt 和生成音频 Token,不需要额外运行 ASR、Tokenizer Decoder 或 Speaker Model,因此参考音色、文本内容和表演风格都能在同一奖励路径中被判断。
对两条 Take 的人类偏好使用 Bradley–Terry 损失:
\(\mathcal{L}_{\mathrm{RM}}=-\left[y\log\sigma(s_a-s_b)+(1-y)\log\sigma(s_b-s_a)\right]+10^{-3}(s_a^2+s_b^2)\)5.2 GRPO 配置
- 每个 Prompt 采样 \(G=8\) 条 Take,温度为 1,不使用 Top-p 或 Top-k 截断。
- 每条 Take 最长约为期望时长的 2.5 倍,且不超过 4096 帧,约 190 秒。
- 组内 Reward 标准差低于 0.05 的组丢弃。
- 使用 Group Relative Policy Optimization,采用均值中心化优势,不使用 KL Penalty 和 Reference Model。
- 每一步使用 1536 个 Prompt × 8 条 Take,采用大 Batch、少步骤、恒定 Muon 学习率和无 Weight Decay。
- RL 时 Codebook-MTP Decoder 保持冻结,只更新 Backbone 的语义 Token 策略。
- Rollout 使用块缩放 FP8 专家权重;训练器使用 BF16,并通过路由回放减少训练和推理路由不一致。
奖励标准化与组内相对比较可写为:
\(z_i=\operatorname{clip}\left(\frac{s_i-\mu_0}{\sigma_0},-3,3\right),\qquad R_i=\frac{1}{n-1}\sum_{j\ne i}\sigma(z_i-z_j)\)论文强调,大 Batch、少更新步可以让策略朝向更广泛的人类偏好移动,并减少小 Batch、多步训练出现的 Reward Over-optimization。
六、推理引擎与吞吐优化
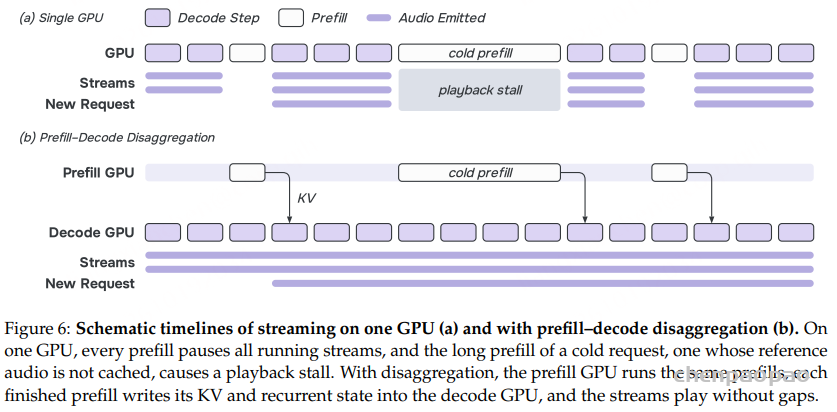
线上请求分为 Prefill 和 Decode 两阶段:Prefill 一次读取文本与参考音频,Decode 每帧执行一步。单 GPU 同时服务多个流,按轮次执行新请求 Prefill 或所有运行中流的一步 Decode。
| 指标 | Drama 3 | Fish Audio S2 |
|---|---|---|
| Backbone 后的顺序层数 | 13 | 40 |
| 每帧读取权重 | 约 6.0 GB | 约 15.6 GB |
| 其中 Backbone(不含 Routed Experts) | 2.9 GB | 7.3 GB |
| Codebook-MTP / Fast AR | 2.1 GB | 8.3 GB |
| 上下文 KV Cache 增长的层数 | 23 | 36 |
| 单 H200 单流速度 | 271 frames/s | 177 frames/s |
- 减少顺序路径:Codebook-MTP 13 层每帧运行一次;S2 的 Fast AR 需要 10 次、共 40 层顺序 Pass。
- FP8 Routed Experts:专家使用块缩放 FP8,每个专家参数约 1 Byte。Drama 3 每帧读取约 6.0 GB 权重,不到 S2 的五分之二。
- 删除 CUDA Graph 之外的 Kernel:辅助 Decode Kernel 从 1429 个降到 1278 个,B300、并发 32 时提升 1.7%;融合 Gated DeltaNet Decode 和采样器计数器后减少 100 个 Kernel,单流提升 4.2%。
- Prefill Graph:Gated DeltaNet Prefill 每层 Kernel 从 23 个降为 13 个;首帧采样的 Host 时间从 30.9 ms 降至 14.7 ms,早期开发模型在 H200 并发 32 时提升 15.3%。
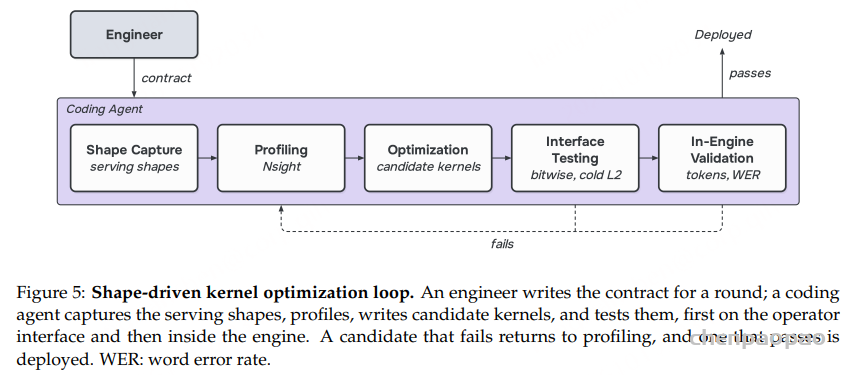
- 按线上 Shape 优化 Kernel:从真实服务日志抓取矩阵形状、Batch 和并发分布,再做 Nsight Profiling、算子级验证、引擎内 Token/WER 验证和同机 A/B 测试。FP8 MoE Kernel 在 \(M=256\) 时将 MoE 层耗时降低 19.2%。
- Prefill–Decode 解耦:新请求的 Prefill 不再阻塞正在播放的 Decode 流,降低高并发下的流式卡顿。
七、实验设置与结果
实验统一使用论文附录中的 Prompt 格式,采样温度 0.7、Top-p 0.7、Top-k 30。静音、语音过短、长度失控、长段噪声或长段静音的输出会被重新生成并重新计分。中文使用 Paraformer-zh 转录,其余语言使用 Whisper-large-v3;Speaker Similarity 使用 WavLM-large + ECAPA-TDNN 说话人嵌入余弦相似度。
7.1 Preference Reward 对表达性的影响
在 Expresso 中,将同一说话人同一句话的中性读法与风格读法配对。耳语相对中性读法的 SIM 下降 0.310,笑声使 WER 上升 0.79 个百分点;因此相似度奖励在耳语样本中 99.7% 偏好中性读法,在笑声样本中 93.9% 偏好中性读法。Drama 3 的 Preference RM 在提示中明确写出风格后,偏好耳语的比例为 62.2%,偏好笑声的比例为 64.4%;不写方向时分别只有 10.6% 和 27.1%。
在 Seed-TTS-Eval 上,RL 后 Drama 3 的首轮中文 CER 从 SFT 的 1.66 降到 1.00,英文 WER 从 3.49 降到 2.20;信号检查失败率从中文 2.82% 降到 1.24%,英文 3.40% 降到 1.84%。重生成异常样本后,中文 CER 为 0.83,英文 WER 为 1.54。
7.2 多参考零样本音色克隆
论文在 LibriSpeech-PC test-clean 上扩展多参考测试集:1127 句、39 位说话人,每个目标说话人额外提供两段不包含目标句的参考音频。Drama 3 使用一段参考时 WER 1.85%、SIM 0.605、UTMOS 4.31;使用三段参考时 WER 仍为 1.85%,SIM 提升到 0.633,UTMOS 仍为 4.31。单参考时,UTMOS 4.31 高于 OmniVoice 的 4.28 和 CosyVoice 3 的 4.28;Qwen3-TTS 为 4.41,但其 WER 和 SIM 分别为 1.60 和 0.704。
7.3 MiniMax 多语言克隆
MiniMax Multilingual Testset 覆盖 24 种语言。Drama 3 相比 OmniVoice 在 15 种语言上错误率更低,相比 FireRedTTS3-Base 在 17 种语言上更低;在阿拉伯语、中文、荷兰语、英语、芬兰语、法语、德语、波兰语、葡萄牙语、土耳其语和越南语 11 种语言上同时低于 OmniVoice、FireRedTTS3-Base 和 Fish Audio S2。与实际通过 API 运行的商业系统比较时,Drama 3 低于 Inworld TTS-2 的语言数为 18,低于 Soniox TTS RT v2 的语言数为 21/23,低于 ElevenLabs v4 的语言包括中文、荷兰语、英语、德语、韩语、俄语、西班牙语、泰语和土耳其语。
| 语言 | 指标 | Drama 3 | OmniVoice | FireRedTTS3 | Fish Audio S2 |
|---|---|---|---|---|---|
| 中文 | CER | 0.63 | 1.01 | 0.91 | 0.73 |
| 荷兰语 | WER | 0.59 | 1.36 | 1.15 | 0.99 |
| 英语 | WER | 1.13 | 1.56 | 2.12 | 1.62 |
| 芬兰语 | WER | 3.09 | 3.75 | 3.10 | 3.33 |
| 法语 | WER | 2.68 | 3.35 | 2.64 | 2.86 |
| 德语 | WER | 1.08 | 1.50 | 1.93 | 1.46 |
| 土耳其语 | WER | 1.62 | 2.93 | 2.47 | 2.25 |
7.4 Streaming Synthesis
在 1088 条 Seed-TTS-Eval 英文测试句上,流式输出 WER 为 1.86,非流式输出 WER 为 1.83;两者 SIM 都为 0.640。结果说明把音频边生成边发送不会带来明显质量损失。
7.5 Speech Infilling 编辑
在 Ming-Freeform-Audio-Edit 中,先用 Qwen3-ForcedAligner-0.6B 将源音频和转录对齐,再把从第一个不同词到最后一个不同词的区域作为编辑窗口。删除操作还会包含相邻未改变词,以保证窗口有可学习的边界。模型保留窗口前后源音频 Token,只生成窗口内部的目标文本,然后整体解码,避免把源波形直接贴回造成拼接痕迹。
| 系统 | 英文插入 WER / SIM / MAE | 英文删除 | 英文替换 |
|---|---|---|---|
| Drama 3 | 3.03 / 0.905 / 0.208 | 5.79 / 0.838 / 0.174 | 2.08 / 0.866 / 0.181 |
| VoiceCraft-X | 5.74 / 0.85 / 0.166 | 9.71 / 0.80 / 0.172 | 7.29 / 0.81 / 0.155 |
| LEMAS-Edit | 6.04 / 0.81 / 0.158 | 9.29 / 0.80 / 0.167 | 6.09 / 0.80 / 0.167 |
| CosyEdit2 | 1.90 / 0.93 / 0.107 | 5.52 / 0.90 / 0.131 | 1.43 / 0.89 / 0.137 |
中文结果中,Drama 3 在插入和替换上的 SIM 分别为 0.909 和 0.898,高于专用编辑模型 CosyEdit2 的 0.89;删除 WER 为 7.82,低于 CosyEdit2 的 8.23。与 Cartesia Sonic-3 的 Infill API 比较,Drama 3 在 Ming-Freeform 基础集/完整集上的英文 WER 为 3.49/3.43,中文为 3.69/2.35;Cartesia 对应为英文 4.58/4.68、中文 8.64/6.53。
7.6 多轮导演式修改
Step-Audio-Edit 要求模型先克隆声音,再通过最多三轮指令逐步靠近目标情绪或风格。Drama 3 在每轮中保留原始参考和上一版 Take,并以 [happier versus previous] 一类相对指令重生成。情绪准确率从第 0 轮的 55.5% 提升到第 3 轮的 58.2%,风格准确率从 76.5% 提升到 81.8%。使用 [coughs] 等 Point Tag 进行局部插入并 Infilling 后,拟声事件评分从 1.32 提升到 2.32。
| 指标 | 第 0 轮 | 第 1 轮 | 第 2 轮 | 第 3 轮 |
|---|---|---|---|---|
| Drama 3 情绪准确率 | 55.5 | 57.2 | 57.5 | 58.2 |
| Drama 3 风格准确率 | 76.5 | 79.4 | 80.5 | 81.8 |
| Drama 3 拟声事件评分 | 1.32 | 2.32 | – | – |
| Step-Audio-EditX 情绪准确率 | 53.6 | 66.8 | 68.7 | 69.3 |
| Step-Audio-EditX 风格准确率 | 45.6 | 62.7 | 64.2 | 63.8 |
八、工程实现启示
- 长上下文语音模型可以采用“多数线性注意力 + 少量 Full Attention”,在降低 KV Cache 成本的同时保留参考音频和早期台词的精确检索。
- 多 Codebook 音频生成不必让主干逐一预测所有声学码;将粗语义信息反馈给 Backbone,把细节留给时间因果 MTP Decoder,可以同时降低曝光偏差和推理顺序长度。
- 如果训练目标是表现力,WER、SIM 和整句音质分数不宜直接作为唯一奖励。更合理的做法是让 Reward Model 读取“指令 + 参考音频 + 生成音频 Token”的完整上下文。
- SFT 数据应把多轮对话、参考音频索引、Point/Scoped Tag、分隔符和编辑窗口作为一等数据结构,而不是只把音频和文本做成单句配对。
- 线上性能主要受权重搬运、Kernel Launch 和 Prefill 阻塞影响。需要从真实服务 Shape 出发做算子优化,并将 Prefill 与 Decode 分离。
九、结论
Drama 3 的关键不只是把模型扩大到 35B,而是把模型、数据格式、SFT 任务和 RL 奖励统一到“导演式表演”这一目标上。Hybrid Backbone 解决长上下文,Partial Codebook Fusion 控制反馈复杂度,Codebook-MTP Decoder 直接利用参考音频的细粒度声学信息;三阶段预训练建立基础语音能力,32K Token 的 Instruction SFT 教会模型遵循指令和维护多轮上下文,单一人类偏好 Reward Model 则让笑声、耳语、停顿和情绪表达不再被传统规则奖励压制。
从实验结果看,Drama 3 在多参考克隆、多语言识别准确率、流式生成、语音编辑和多轮修改上都表现出统一模型的优势;从工程结果看,它在单 H200 上达到 271 frames/s,高于参数量小得多的 Fish Audio S2。论文没有公开完整数据来源和样本规模,这一限制需要在复现或二次训练时单独补齐。