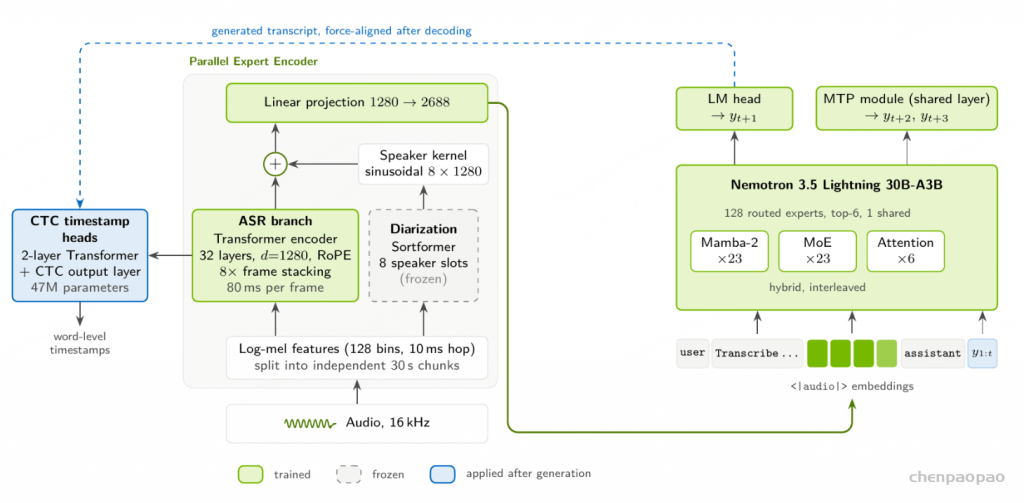
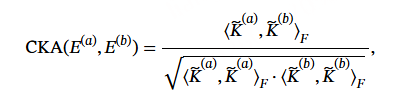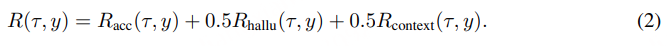Nemotron 3.5 Transcribe 深度拆解:Cache-Aware FastConformer-RNNT 与 Granary v2 语音数据工厂

\(P(y_{1:T}\mid x)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x)\)

一、核心结论

  • Nemotron 3.5 ASR Streaming 是约 0.6B 参数的多语言流式 ASR。
  • 核心架构是 24 层 Cache-Aware FastConformer 编码器、RNN-T 解码器和语言 ID Prompt Conditioning。
  • 声学表示维度为 1024,语言向量为 128 维;一个 checkpoint 支持 40 个 language locale。
  • 运行时支持 80 ms、160 ms、320 ms、560 ms、1.12 s 五个 chunk 配置。
  • FLEURS 上,Transcription-ready 19 个 locale 的平均 LangID WER 从 80 ms 的 10.38% 降到 1.12 s 的 8.84%;Auto-detect 从 11.14% 降到 9.21%。
  • 单张 H100 上,80 ms 时约支持 240 路并发流,Parakeet RNNT 1.1B buffered streaming 约 14 路;1.12 s 时约为 2,400 路对 400 路。

设计目标不是只追求离线 WER,而是在准确率、端到端延迟、显存和并发之间提供可调的 Pareto 点。

二、模型架构

2.1 Cache-Aware FastConformer

FastConformer 结合卷积对局部声学模式的建模能力和注意力对长程依赖的建模能力。Nemotron 3.5 使用 24 层 Cache-Aware FastConformer。缓存同时覆盖 self-attention 和 convolution 状态,因此当前 chunk 可以复用上一 chunk 的隐藏状态。

设第 k 个音频块为 x_k,上一步缓存为 C_(k-1):

\((H_k, C_k) = Encoder(x_k, C_(k-1))\)

传统 buffered streaming 会把上一段上下文与当前音频重新拼接,导致重叠帧重复计算;Cache-Aware 方案只计算新到达的帧,缓存负责保留上下文。

2.2 语言 ID Prompt Conditioning

编码器输出 H_a 的形状是 (1024,T)。语言 ID 被编码为 128 维向量 e_lang,沿时间轴广播为 H_l,二者拼接后经过投影层送入 RNNT:

\(H_a = FastConformer(x_1:T), H_a in R^(1024 x T)\) \(H_l = Broadcast(e_lang,T), e_lang in R^128\) \(H_f = Proj([H_a;H_l]), [H_a;H_l] in R^(1152 x T)\)

已知语言时可以输入 en-US、de-DE、zh-CN 等 locale;未知语言时使用 auto 模式。语言向量是每个时间帧都可见的条件信号,而不是附加在最终文本后的标签。

2.3 RNN-T

RNN-T 用 prediction network 建模已输出的 token 历史,用 joint network 融合声学状态与标签状态:

\(z_(t,u) = f_joint(h_t,g_u), P(y_(t,u)|x,y_<u) = softmax(z_(t,u))\)

它能在音频流持续到达时逐步发射 token,比必须等待整段音频的离线 encoder-decoder 更适合实时语音代理。

三、创新点

  • 缓存级流式计算,减少 buffered streaming 的重叠重算。
  • 语言提示让一个共享 checkpoint 覆盖多语言 locale。
  • chunk size 可在推理时切换,不需要重新训练。
  • 原生支持 punctuation 和 capitalization。
  • 0.6B 参数配合缓存式推理,在 H100 上获得高并发。

四、训练数据:规模、来源与标签

官方模型卡给出的训练数据范围是 10,000 到 1,000,000 小时,覆盖 40 个 language locale。来源包括 NVIDIA Riva multilingual ASR training set(专有)、NVIDIA Granary、Multilingual LibriSpeech、Mozilla Common Voice、FLEURS、VoxPopuli 和 Europarl-ASR。

训练标签包括人工标签和合成标签。合成 ASR 标签来自 Canary、Parakeet Multilingual 1.1B RNNT、Parakeet CTC 1.1B、Whisper large-v3 与 FunASR 的模型集成;标点和大小写由 Qwen3-32B 生成:

\(y_hat_i = Consensus(Canary(x_i), Parakeet(x_i), Whisper(x_i), FunASR(x_i))\) \(y_PnC_i = Qwen3-32B(y_hat_i, language_i)\)

Consensus 不能被擅自解释为简单多数投票,因为官方没有披露集成规则。工程上还应结合语言一致性、字符速率、重复检测、空输出和长度比过滤。

4.1 Granary 数量级

Granary 覆盖 25 种欧洲语言,聚合规模约 1M 小时;ASR 侧约 643,238 小时,AST 侧约 351,000 小时。

来源语言数过滤后小时数格式
YODAS-Granary23192,17216 kHz WAV
VoxPopuli24206,116FLAC
YouTube-Commons24122,475WAV
LibriLight英语约 23,500FLAC
ASR 合计25643,238混合格式

Granary 主要提供 NeMo JSONL manifest 和元数据,部分来源需要另行下载音频。典型字段包括 audio_filepath、text、source_lang、target_lang、original_source_id 和 dataset_source。

五、训练阶段

  • 阶段 A:收集和统一 manifest。保留路径、时长、采样率、语言、来源、许可证和原始 ID。
  • 阶段 B:切分、VAD、说话人和语言质检。检查时长、静音比例、字符速率、语言一致性、空文本和异常重复。
  • 阶段 C:多模型伪标注与 PnC。生成候选、做一致性筛选,再用 Qwen3-32B 统一标点和大小写。
  • 阶段 D:流式多语言 ASR 训练。使用 Cache-Aware FastConformer-RNNT、语言 ID 条件和混合多语言数据。
  • 阶段 E:多延迟点评测。以 80 ms 为基本帧,测试 80 ms、160 ms、320 ms、560 ms、1.12 s。
\(D_train = Filter(Normalize(D_public union D_private))\) \(theta* = argmin_theta E[-log P_theta(y | x, language)]\)

六、Granary v2 流水线

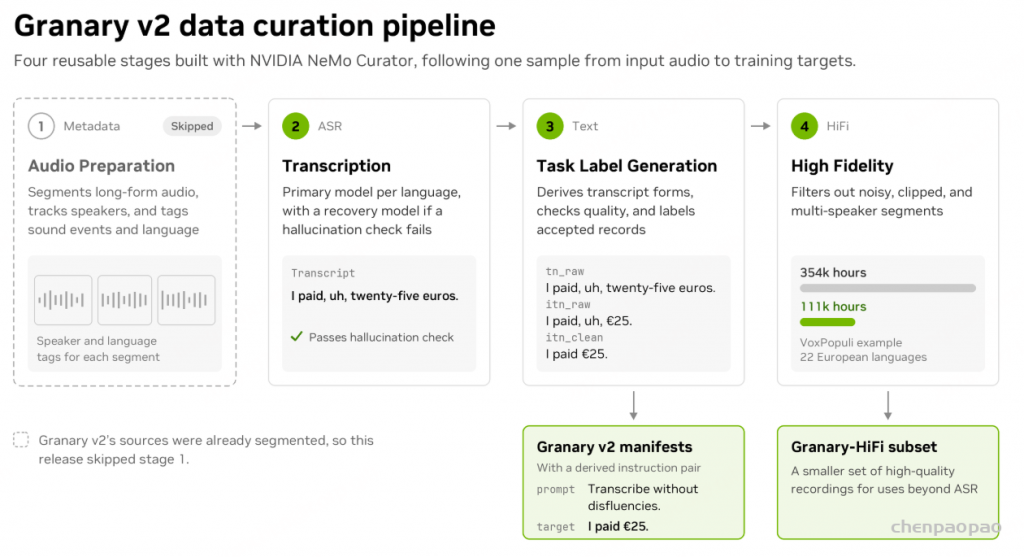
Granary v2 把原始录音加工成带元数据、可追溯、可继续处理的训练数据。官方教程包括 Metadata extraction、Indic ASR、Qwen Omni ASR 和 Text pipeline。

6.1 Metadata extraction

  • 读取 recording manifest,重采样到单声道 16 kHz WAV。
  • Sortformer 做说话人分离并输出 RTTM。
  • Silero TensorRT VAD 切分语音段。
  • CNN14 TensorRT 预测声音事件。
  • SpeechBrain、Indic Canary、Whisper 做多级语言识别。
  • 根据一致性选择 source_lang,保留拒绝原因。
  • 片段编码为 Opus,并写出 JSONL metadata。

没有语音的录音保留 vad_empty 审计行;语言意见不一致时保留 skip 标记和预测结果,避免把“无语音”和“文件缺失”混为一谈。

6.2 Indic ASR

Hindi 示例有 11 个阶段:读取 manifest;准备单声道 16 kHz 音频;Canary 主转写;主结果 hallucination 检查;Parakeet 恢复候选;恢复结果检查;选择最佳预测;正则清洗;缩写合并;计算 WER;写回 JSONL。两个 ASR 模型会对每个有效片段都运行。

示例限制 0.5 到 40 秒;最终字段包括 primary_model_prediction、fallback_model_prediction、best_prediction、cleaned_text、abbreviated_text 和 wer_pct。

6.3 Qwen Omni ASR 与 Text pipeline

Qwen3-Omni 生成主转写,已有 transcript 只作为回退文本,不发送给 Qwen。随后执行规则型 hallucination 检查、最佳预测选择、标点和空白清理、缩写合并。Text pipeline 不读取音频,负责实体恢复、PnC、语言识别与验证、逆文本规范化、captioning、code switching 和 speech QA。

6.4 Xenna 与 Ray Data 吞吐

管道基准数据XennaRay Data
Metadata30,631 录音 / 107.76357 小时472.309 audio-hours/hour166.251
Indic ASR216,164 Hindi 片段 / 531.75763 小时3,604.471387.649
Qwen Omni ASR22,710 英语片段 / 80.61259 小时406.615228.424
Text pipeline14,290 行 transcript30.283 rows/s12.217 rows/s

官方对比使用 8 张 H100 80 GB GPU、相同 cohort、镜像、模型和 stage 设置。音频管道吞吐包含模型启动时间;Text pipeline 复用了已启动的模型服务器。

七、实验对比:FLEURS 与流式延迟

分组模式80 ms160 ms320 ms560 ms1.12 s
Transcription-ready 19 localesLangID 平均 WER10.3810.009.499.128.84
Transcription-ready 19 localesAuto-detect 平均 WER11.1410.6710.059.639.21
Broad-coverage 13 localesLangID 平均 WER25.8625.1424.1123.0922.13
Broad-coverage 13 localesAuto-detect 平均 WER27.6226.6525.4124.4423.09

在 1.12 s、LangID 条件下,官方表中英语 WER 为 7.91%,西班牙语 4.11%,意大利语 4.25%,葡萄牙语 5.48%,Hindi 6.81%,德语 8.31%,法语 9.03%,俄语 9.17%,乌克兰语 13.07%。Hindi 在 80 ms 下 LangID 为 8.13%,Auto-detect 为 11.47%;1.12 s 下分别为 6.81% 和 8.23%。日语、韩语和普通话使用 CER。

chunk 增大通常带来更多右侧上下文,平均 WER 下降但等待时间上升:

\(WER(c_1) >= WER(c_2), c_1 < c_2\)

八、吞吐对比与系统意义

配置Nemotron 3.5 ASRParakeet RNNT 1.1B优势
80 ms约 240 路约 14 路约 17 倍
1.12 s约 2,400 路约 400 路约 6 倍

优势来自参数规模、缓存复用、chunk 粒度和 H100 推理实现的共同作用,而不是单纯参数更小:

\(Cost_per_stream proportional to GPU_hourly_cost / sustainable_concurrent_streams\)

Fish Audio Drama 3 技术报告详解:面向导演式语音生成的 35B -A3B MoE 架构、训练数据与工程优化

一、论文要点与模型定位

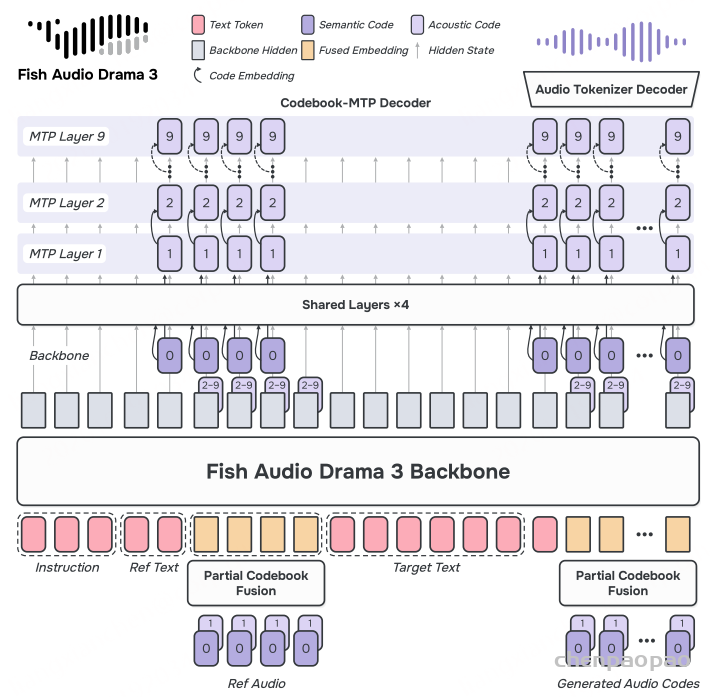
Drama 3 是一个开放权重语音生成模型,总参数量约 35B,但采用稀疏混合专家结构,每个 Token 实际激活约 3B 参数。模型主干由 Qwen3.5-35B-A3B 初始化,采用 40 层混合架构:每四层包含三层 Gated DeltaNet 线性注意力和一层 Gated Full Attention。语音部分沿用 Fish Audio S2 的离散音频 Tokenizer,每个音频帧由 10 个 Codebook 表示;模型主干预测语义 Codebook,新的 Codebook-MTP Decoder 在同一时间位置并行预测其余 9 个声学 Codebook。

论文把创新概括为三点:

  • Hybrid Backbone + Codebook-MTP Decoder:用线性注意力处理长上下文,同时用少量 Full Attention 保留远距离检索能力,并将 S2 的逐 Codebook Fast AR 替换成一次运行 13 层的多 Token 预测解码器。
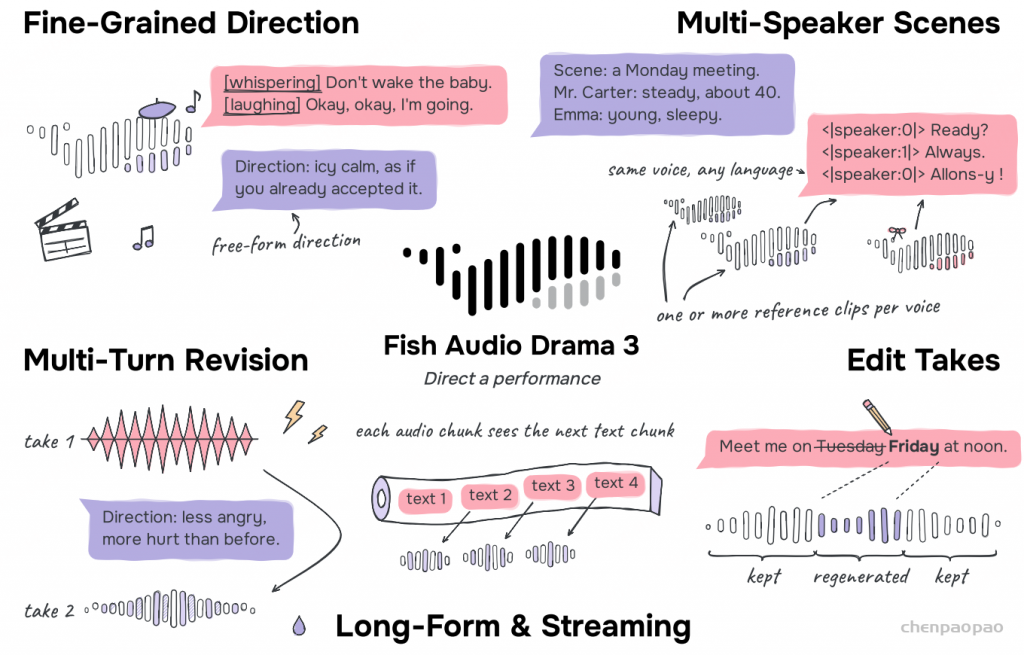
  • 一个模型统一多任务:多参考音色克隆、自然语言控制、多角色场景、多轮导演式修改、Speech Infilling、长文本合成和 Streaming Text Input 使用同一种交错文本—音频 Token 流表示。
  • 单一人类偏好奖励:RL 不再把 ASR WER、音质模型和 Speaker Similarity 作为规则奖励,而是训练一个小型 Speech Language Model 作为人类偏好 Reward Model。

二、总体架构

Drama 3 没有额外的音频编码器。参考音频、提示音频和生成音频都先通过离散 Audio Tokenizer 转换成 Codebook 序列,之后与文本 Token 交错输入语言模型。每一个音频帧只占用一个 Backbone 序列位置,因此一秒语音约占 21.5 个位置,与该帧包含多少个 Codebook 无关。

2.1 音频 Tokenizer

  • 基于 Descript Audio Codec,输入采样率为 44.1 kHz。
  • 约每秒 21.5 个音频帧,每帧 10 个 Codebook。
  • Codebook 0 是语义码,Codebook 1–9 是逐级增加细节的残差声学码。
  • 编码和解码完全因果,可以流式运行。
  • 参考音频以离散 Token 进入上下文,因此参考音频的细粒度声学信息可以被后续 Decoder 直接访问。

2.2 Hybrid Backbone 与 MoE

主干初始化自 Qwen3.5-35B-A3B,仅使用其语言模型部分。40 层结构由三层 Gated DeltaNet 加一层 Gated Full Attention 组成周期。DeltaNet 使用近似常数大小的状态保存历史,只有每四层中的 Full Attention 保留随上下文增长的 KV Cache;Full Attention 用来精确检索长上下文中的参考音色、早先台词和场景信息。

每一层的前馈网络都是 MoE:共有 256 个 Routed Experts,每个 Token 路由到 8 个专家,并额外经过一个 Shared Expert。总参数约 35B,但每个 Token 约激活 3B 参数。MoE Router 在预训练和 SFT 阶段都加入负载均衡损失,避免大多数 Token 集中到少数专家。

2.3 Partial Codebook Fusion

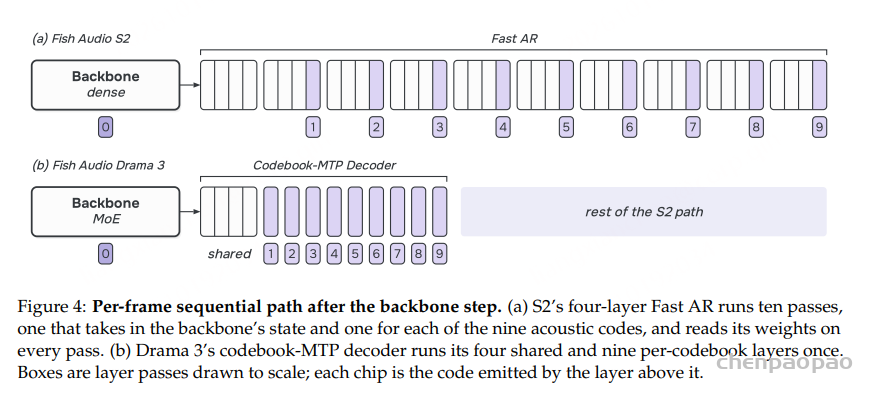
S2 将 10 个 Codebook 全部反馈给 Backbone。Drama 3 只把语义码和第一层声学码反馈给 Backbone,Codebook 2–9 绕过 Backbone,作为 Decoder 的侧输入。这样既保留参考音频和已生成语音的粗粒度声学线索,也减少模型暴露在自身采样细节上的误差累积。

设第 t 帧的语义码和第一层声学码分别为 \(q_t^{(0)}\) 和 \(q_t^{(1)}\),则 Backbone 的音频输入为:

\( \mathbf{x}_{t}=\frac{1}{\sqrt{2}}\left(\mathbf{E}^{\mathrm{LM}}\left[s\left(q_t^{(0)}\right)\right]+\mathbf{E}^{(1)}\left[q_t^{(1)}\right]\right) \)

其中 \(s(\cdot)\) 把语义码映射到新增的 4096 个语义 Token,\(\mathbf{E}^{\mathrm{LM}}\) 是语言模型词嵌入,\(\mathbf{E}^{(1)}\) 是第一声学 Codebook 的嵌入表。文本位置只使用语言模型嵌入;Codebook 2–9 不进入 Backbone。

2.4 Codebook-MTP Decoder

在第 t 个位置,Backbone 预测下一帧的语义码 \(q_{t+1}^{(0)}\);Decoder 在同一位置预测下一帧的 9 个声学码 \(q_{t+1}^{(1)},\ldots,q_{t+1}^{(9)}\)。Decoder 共有 13 层:前 4 层是共享层,后 9 层分别对应声学 Codebook 1–9。每一层沿完整时间序列做因果注意力,所以每一个声学 Codebook 都能看到参考音频和此前所有帧的声学细节。

每层先把注入的 Codebook 嵌入与上一层隐藏状态合并:

\(\mathbf{u}^{(\ell)}_t=\mathbf{W}^{(\ell)}\left[\operatorname{RMSNorm}\left(\mathbf{e}^{(\ell)}_t\right);\operatorname{RMSNorm}\left(\mathbf{h}^{(\ell-1)}_t\right)\right]\)

随后经过因果 Transformer Block:

\(\mathbf{h}^{(\ell)}_t=\operatorname{RMSNorm}\left(\operatorname{Block}^{(\ell)}\left(\mathbf{u}^{(\ell)}_{1:t}\right)\right)\)

第 k 个 Codebook 的输出分布可以写为:

\(q_{t+1}^{(k)}\sim\operatorname{softmax}\left(\mathbf{W}_{\mathrm{out}}^{(k)}\mathbf{h}^{(4+k)}_t\right),\qquad k=1,\ldots,9\)

相较于 S2 的 4 层 Fast AR 重复运行 10 次,Drama 3 的 13 层 Decoder 每帧只运行一次,因而大幅缩短顺序路径。

三、训练数据与三阶段预训练

数据由完成转录的语音和文本文档组成;所有语音在进入训练前先经过质量控制;文本文档用于保持 Backbone 的语言建模能力;总体训练规模为数千亿 Token;语言覆盖沿用 S2,约 80 种语言和方言。

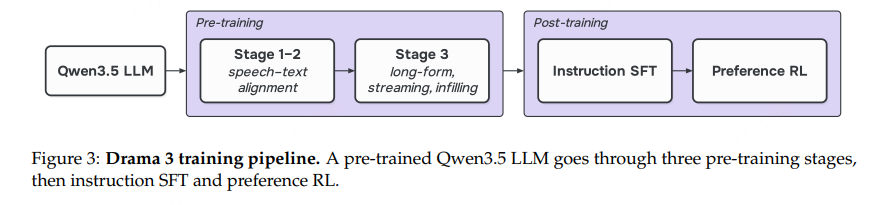
3.1 Stage 1:基础文本到语音映射

  • 最大序列长度 8K Token。
  • 训练样本包括纯文本文档和多轮 TTS 对话。
  • 目标是学习文本到音频 Token 的映射、普通 TTS 和零样本音色克隆。
  • System 轮保存任务指令和参考音频,User 轮保存待合成文本,Assistant 轮保存目标音频 Token。
  • 损失只计算在 Assistant 的音频输出、必要的分隔符和结束 Token 上。

3.2 Stage 2:降低梯度噪声

Stage 2 继续使用 Stage 1 的序列格式和任务分布,主要变化是 Batch Size 翻倍,从而降低梯度噪声;学习率衰减留到 Stage 3。它并非独立的新任务阶段,而是让基础语音建模能力在更稳定的优化条件下继续收敛。

3.3 Stage 3:长音频、流式和编辑

  • 最大序列长度提升到 16K Token。
  • 加入整段录音合成:参考音频来自同一录音的后部,目标是前部,避免参考片段和监督目标重叠。
  • 加入逐行合成,用 \(<|audio_separator|>\) 对齐输入文本行和输出音频段。
  • 加入 Streaming Interleave:每个 User 轮包含当前文本块和一个前瞻文本块,模型边生成当前块边知道后续内容。
  • 加入 Speech Infilling:保留原音频编辑窗口前后的 Token,只生成窗口内部的新内容。
  • 样本使用 Document Masking 打包成每行 128K Token,优化器为 Muon。

3.4 预训练目标

令 \(\mathcal{T}\) 为需要监督的文本位置(包括结束 Token 和逐行分隔符),\(\mathcal{S}\) 为语义 Codebook 监督位置,则:

\(\mathcal{L}_{\mathrm{text}}=-\frac{1}{|\mathcal{T}|}\sum_{t\in\mathcal{T}}\log p_{\theta}(x_t\mid x_{<t})\) \(\mathcal{L}_{\mathrm{sem}}=-\frac{1}{|\mathcal{S}|}\sum_{t\in\mathcal{S}}\log p_{\theta}\left(q_t^{(0)}\mid x_{<t}\right)\) \(\mathcal{L}_{\mathrm{cb}}=\frac{1}{9}\sum_{k=1}^{9}\left(-\frac{1}{|\mathcal{S}|}\sum_{t\in\mathcal{S}}\log p_{\phi}\left(q_t^{(k)}\mid\mathbf{h}_{<t},\mathbf{q}_{<t},q_t^{(<k)}\right)\right)\)

总损失为:

\(\mathcal{L}=\mathcal{L}_{\mathrm{text}}+0.5\mathcal{L}_{\mathrm{sem}}+0.5\mathcal{L}_{\mathrm{cb}}\)

文本、语义码和声学码各自按自己的监督桶取平均,避免一个 Batch 中文本和语音比例变化导致损失权重漂移;声学 Codebook 损失会反向传播到 Backbone。预训练和 SFT 同时加入 MoE Router 负载均衡损失。

四、Instruction SFT 阶段:如何让模型学会“听懂导演指令”

SFT 从 Stage 3 Checkpoint 开始,最大序列长度为 32K Token,使用 Indexed Reference Layout。SFT 的目标不是重新学习基础发音,而是把已经具备 TTS 和克隆能力的模型转化为能够遵循复杂自然语言指令、处理对话和场景的生成器。

4.1 SFT 数据类型

  • 普通音色克隆:一段或多段参考音频 + 待合成文本。
  • Point Tags:在文本位置插入 [laughs]、[pause]、[coughs] 等局部事件。
  • Scoped Tags:用 <whisper>...</whisper> 只控制被包围的词或短语。
  • Style Prefix:控制整句的情绪、语速、表达方式。
  • Director’s Note:用自然语言描述意图、节奏、重音和表演方式。
  • 多说话人对话:每个角色绑定一个或多个参考音频,通过 speaker Token 切换角色。
  • 多角色场景:一次提供所有台词,并使用显式分隔符,使当前句能够利用后续台词和场景上下文。
  • 多轮修改:保留旧参考和上一版生成结果,下一轮用“更柔和、更温暖”“比上一版更快”等相对指令生成新版本。
  • 长文本、Speech Infilling 和 Text-only Chat:继续混入训练,防止 SFT 破坏 Stage 3 已学能力。

4.2 SFT 样本如何组织

训练序列采用 ChatML 风格。System 轮包含“把给定文本转换成语音”的任务说明、参考文本和参考音频;User 轮包含目标文本、说话人标记、控制标签和语言/时长提示;Assistant 轮以 \(<|voice|>\) 开始,输出目标音频的 10 个 Codebook。对于多轮修改,旧的 Assistant 音频保留在上下文中,下一轮 User 给出相对上一版的修改意见。

损失只作用于模型自己的 Assistant 输出:语音帧的 10 个 Codebook、需要学习的音频分隔符和 \(<|im_end|>\)。参考音频只提供上下文,不直接产生生成损失。Speech Infilling 额外对编辑窗口两侧的接缝加大监督,使新旧音频能够自然拼接。

五、RL:从可控生成到符合人类偏好的表演

RL 从 SFT Checkpoint 开始。S2 使用 ASR 转录错误、语音质量和 Speaker Similarity 三类规则奖励;Drama 3 去掉它们,因为笑声和长停顿会改变 ASR 结果,耳语和喊叫会降低与中性参考的相似度,而整句质量模型无法评价某个词是否按指令变得更柔和或更有情绪。

5.1 人类偏好 Reward Model

Reward Model 是一个较小的 Speech Language Model,使用相同的 Audio Tokenizer 和序列格式预训练到 Stage 2,并在每条 Take 的结束 Token 上增加 Scalar Head。它直接读取完整 Prompt 和生成音频 Token,不需要额外运行 ASR、Tokenizer Decoder 或 Speaker Model,因此参考音色、文本内容和表演风格都能在同一奖励路径中被判断。

对两条 Take 的人类偏好使用 Bradley–Terry 损失:

\(\mathcal{L}_{\mathrm{RM}}=-\left[y\log\sigma(s_a-s_b)+(1-y)\log\sigma(s_b-s_a)\right]+10^{-3}(s_a^2+s_b^2)\)

5.2 GRPO 配置

  • 每个 Prompt 采样 \(G=8\) 条 Take,温度为 1,不使用 Top-p 或 Top-k 截断。
  • 每条 Take 最长约为期望时长的 2.5 倍,且不超过 4096 帧,约 190 秒。
  • 组内 Reward 标准差低于 0.05 的组丢弃。
  • 使用 Group Relative Policy Optimization,采用均值中心化优势,不使用 KL Penalty 和 Reference Model。
  • 每一步使用 1536 个 Prompt × 8 条 Take,采用大 Batch、少步骤、恒定 Muon 学习率和无 Weight Decay。
  • RL 时 Codebook-MTP Decoder 保持冻结,只更新 Backbone 的语义 Token 策略。
  • Rollout 使用块缩放 FP8 专家权重;训练器使用 BF16,并通过路由回放减少训练和推理路由不一致。

奖励标准化与组内相对比较可写为:

\(z_i=\operatorname{clip}\left(\frac{s_i-\mu_0}{\sigma_0},-3,3\right),\qquad R_i=\frac{1}{n-1}\sum_{j\ne i}\sigma(z_i-z_j)\)

论文强调,大 Batch、少更新步可以让策略朝向更广泛的人类偏好移动,并减少小 Batch、多步训练出现的 Reward Over-optimization。

六、推理引擎与吞吐优化

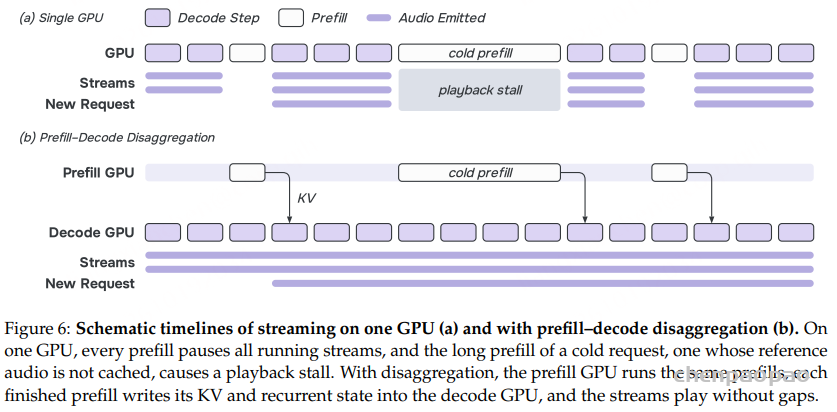
线上请求分为 Prefill 和 Decode 两阶段:Prefill 一次读取文本与参考音频,Decode 每帧执行一步。单 GPU 同时服务多个流,按轮次执行新请求 Prefill 或所有运行中流的一步 Decode。

指标Drama 3Fish Audio S2
Backbone 后的顺序层数1340
每帧读取权重约 6.0 GB约 15.6 GB
其中 Backbone(不含 Routed Experts)2.9 GB7.3 GB
Codebook-MTP / Fast AR2.1 GB8.3 GB
上下文 KV Cache 增长的层数2336
单 H200 单流速度271 frames/s177 frames/s
  • 减少顺序路径:Codebook-MTP 13 层每帧运行一次;S2 的 Fast AR 需要 10 次、共 40 层顺序 Pass。
  • FP8 Routed Experts:专家使用块缩放 FP8,每个专家参数约 1 Byte。Drama 3 每帧读取约 6.0 GB 权重,不到 S2 的五分之二。
  • 删除 CUDA Graph 之外的 Kernel:辅助 Decode Kernel 从 1429 个降到 1278 个,B300、并发 32 时提升 1.7%;融合 Gated DeltaNet Decode 和采样器计数器后减少 100 个 Kernel,单流提升 4.2%。
  • Prefill Graph:Gated DeltaNet Prefill 每层 Kernel 从 23 个降为 13 个;首帧采样的 Host 时间从 30.9 ms 降至 14.7 ms,早期开发模型在 H200 并发 32 时提升 15.3%。
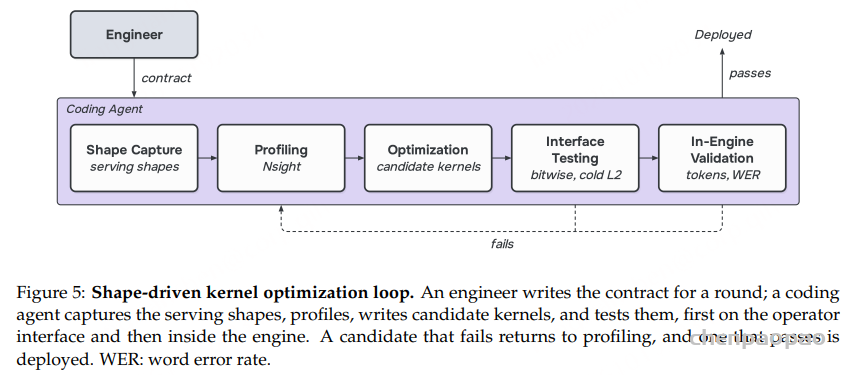
  • 按线上 Shape 优化 Kernel:从真实服务日志抓取矩阵形状、Batch 和并发分布,再做 Nsight Profiling、算子级验证、引擎内 Token/WER 验证和同机 A/B 测试。FP8 MoE Kernel 在 \(M=256\) 时将 MoE 层耗时降低 19.2%。
  • Prefill–Decode 解耦:新请求的 Prefill 不再阻塞正在播放的 Decode 流,降低高并发下的流式卡顿。

七、实验设置与结果

实验统一使用论文附录中的 Prompt 格式,采样温度 0.7、Top-p 0.7、Top-k 30。静音、语音过短、长度失控、长段噪声或长段静音的输出会被重新生成并重新计分。中文使用 Paraformer-zh 转录,其余语言使用 Whisper-large-v3;Speaker Similarity 使用 WavLM-large + ECAPA-TDNN 说话人嵌入余弦相似度。

7.1 Preference Reward 对表达性的影响

在 Expresso 中,将同一说话人同一句话的中性读法与风格读法配对。耳语相对中性读法的 SIM 下降 0.310,笑声使 WER 上升 0.79 个百分点;因此相似度奖励在耳语样本中 99.7% 偏好中性读法,在笑声样本中 93.9% 偏好中性读法。Drama 3 的 Preference RM 在提示中明确写出风格后,偏好耳语的比例为 62.2%,偏好笑声的比例为 64.4%;不写方向时分别只有 10.6% 和 27.1%。

在 Seed-TTS-Eval 上,RL 后 Drama 3 的首轮中文 CER 从 SFT 的 1.66 降到 1.00,英文 WER 从 3.49 降到 2.20;信号检查失败率从中文 2.82% 降到 1.24%,英文 3.40% 降到 1.84%。重生成异常样本后,中文 CER 为 0.83,英文 WER 为 1.54。

7.2 多参考零样本音色克隆

论文在 LibriSpeech-PC test-clean 上扩展多参考测试集:1127 句、39 位说话人,每个目标说话人额外提供两段不包含目标句的参考音频。Drama 3 使用一段参考时 WER 1.85%、SIM 0.605、UTMOS 4.31;使用三段参考时 WER 仍为 1.85%,SIM 提升到 0.633,UTMOS 仍为 4.31。单参考时,UTMOS 4.31 高于 OmniVoice 的 4.28 和 CosyVoice 3 的 4.28;Qwen3-TTS 为 4.41,但其 WER 和 SIM 分别为 1.60 和 0.704。

7.3 MiniMax 多语言克隆

MiniMax Multilingual Testset 覆盖 24 种语言。Drama 3 相比 OmniVoice 在 15 种语言上错误率更低,相比 FireRedTTS3-Base 在 17 种语言上更低;在阿拉伯语、中文、荷兰语、英语、芬兰语、法语、德语、波兰语、葡萄牙语、土耳其语和越南语 11 种语言上同时低于 OmniVoice、FireRedTTS3-Base 和 Fish Audio S2。与实际通过 API 运行的商业系统比较时,Drama 3 低于 Inworld TTS-2 的语言数为 18,低于 Soniox TTS RT v2 的语言数为 21/23,低于 ElevenLabs v4 的语言包括中文、荷兰语、英语、德语、韩语、俄语、西班牙语、泰语和土耳其语。

语言指标Drama 3OmniVoiceFireRedTTS3Fish Audio S2
中文CER0.631.010.910.73
荷兰语WER0.591.361.150.99
英语WER1.131.562.121.62
芬兰语WER3.093.753.103.33
法语WER2.683.352.642.86
德语WER1.081.501.931.46
土耳其语WER1.622.932.472.25

7.4 Streaming Synthesis

在 1088 条 Seed-TTS-Eval 英文测试句上,流式输出 WER 为 1.86,非流式输出 WER 为 1.83;两者 SIM 都为 0.640。结果说明把音频边生成边发送不会带来明显质量损失。

7.5 Speech Infilling 编辑

在 Ming-Freeform-Audio-Edit 中,先用 Qwen3-ForcedAligner-0.6B 将源音频和转录对齐,再把从第一个不同词到最后一个不同词的区域作为编辑窗口。删除操作还会包含相邻未改变词,以保证窗口有可学习的边界。模型保留窗口前后源音频 Token,只生成窗口内部的目标文本,然后整体解码,避免把源波形直接贴回造成拼接痕迹。

系统英文插入 WER / SIM / MAE英文删除英文替换
Drama 33.03 / 0.905 / 0.2085.79 / 0.838 / 0.1742.08 / 0.866 / 0.181
VoiceCraft-X5.74 / 0.85 / 0.1669.71 / 0.80 / 0.1727.29 / 0.81 / 0.155
LEMAS-Edit6.04 / 0.81 / 0.1589.29 / 0.80 / 0.1676.09 / 0.80 / 0.167
CosyEdit21.90 / 0.93 / 0.1075.52 / 0.90 / 0.1311.43 / 0.89 / 0.137

中文结果中,Drama 3 在插入和替换上的 SIM 分别为 0.909 和 0.898,高于专用编辑模型 CosyEdit2 的 0.89;删除 WER 为 7.82,低于 CosyEdit2 的 8.23。与 Cartesia Sonic-3 的 Infill API 比较,Drama 3 在 Ming-Freeform 基础集/完整集上的英文 WER 为 3.49/3.43,中文为 3.69/2.35;Cartesia 对应为英文 4.58/4.68、中文 8.64/6.53。

7.6 多轮导演式修改

Step-Audio-Edit 要求模型先克隆声音,再通过最多三轮指令逐步靠近目标情绪或风格。Drama 3 在每轮中保留原始参考和上一版 Take,并以 [happier versus previous] 一类相对指令重生成。情绪准确率从第 0 轮的 55.5% 提升到第 3 轮的 58.2%,风格准确率从 76.5% 提升到 81.8%。使用 [coughs] 等 Point Tag 进行局部插入并 Infilling 后,拟声事件评分从 1.32 提升到 2.32。

指标第 0 轮第 1 轮第 2 轮第 3 轮
Drama 3 情绪准确率55.557.257.558.2
Drama 3 风格准确率76.579.480.581.8
Drama 3 拟声事件评分1.322.32––
Step-Audio-EditX 情绪准确率53.666.868.769.3
Step-Audio-EditX 风格准确率45.662.764.263.8

八、工程实现启示

  • 长上下文语音模型可以采用“多数线性注意力 + 少量 Full Attention”,在降低 KV Cache 成本的同时保留参考音频和早期台词的精确检索。
  • 多 Codebook 音频生成不必让主干逐一预测所有声学码;将粗语义信息反馈给 Backbone,把细节留给时间因果 MTP Decoder,可以同时降低曝光偏差和推理顺序长度。
  • 如果训练目标是表现力,WER、SIM 和整句音质分数不宜直接作为唯一奖励。更合理的做法是让 Reward Model 读取“指令 + 参考音频 + 生成音频 Token”的完整上下文。
  • SFT 数据应把多轮对话、参考音频索引、Point/Scoped Tag、分隔符和编辑窗口作为一等数据结构,而不是只把音频和文本做成单句配对。
  • 线上性能主要受权重搬运、Kernel Launch 和 Prefill 阻塞影响。需要从真实服务 Shape 出发做算子优化,并将 Prefill 与 Decode 分离。

九、结论

Drama 3 的关键不只是把模型扩大到 35B,而是把模型、数据格式、SFT 任务和 RL 奖励统一到“导演式表演”这一目标上。Hybrid Backbone 解决长上下文,Partial Codebook Fusion 控制反馈复杂度,Codebook-MTP Decoder 直接利用参考音频的细粒度声学信息;三阶段预训练建立基础语音能力,32K Token 的 Instruction SFT 教会模型遵循指令和维护多轮上下文,单一人类偏好 Reward Model 则让笑声、耳语、停顿和情绪表达不再被传统规则奖励压制。

从实验结果看,Drama 3 在多参考克隆、多语言识别准确率、流式生成、语音编辑和多轮修改上都表现出统一模型的优势;从工程结果看,它在单 H200 上达到 271 frames/s,高于参数量小得多的 Fish Audio S2。论文没有公开完整数据来源和样本规模,这一限制需要在复现或二次训练时单独补齐。

Index-Translate 深度解析:从 150 语种翻译到语音、可控配音与长文档的一体化模型家族

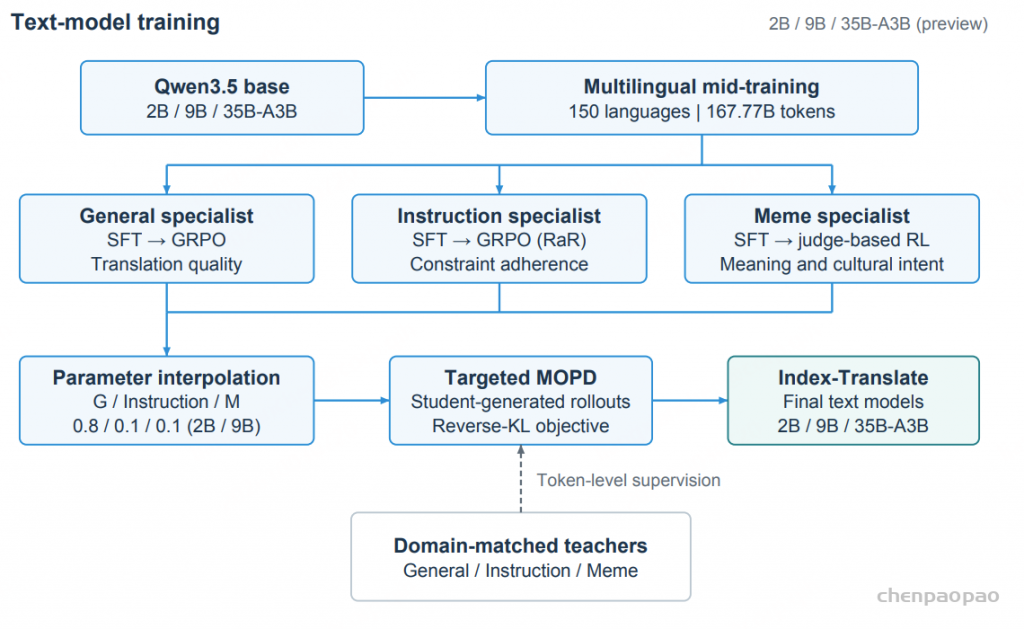
摘要:哔哩哔哩 Index LLM 团队在 2026 年 9 月发布了 Index-Translate。它不是单一的“文本翻译模型”,而是以 Qwen3.5 为基础,向文本、语音翻译、音节可控配音和原生长文档翻译扩展的模型家族。

Index-Translate 35B-A3B preview、9B 与 2B 文本模型的七维翻译能力对比

一、项目定位:把“翻译质量”扩展为可交付能力

传统机器翻译通常优化句子级质量,但真实内容生产还需要保留 JSON、CSV、Markdown、变量占位符和术语;字幕要适配时长;社区文本要翻出梗意;书籍翻译要维持人物、术语和概念层级。Index-Translate 的核心判断是:翻译模型应当同时优化语义、约束、模态和上下文,而不是只追求一个 BLEU 或 COMET 分数。

模型家族目前包含五类成员:

  • Index-Translate:文本、结构化内容、指令翻译与社区表达,覆盖 150 种语言,提供 2B、9B 和 35B-A3B(preview)。
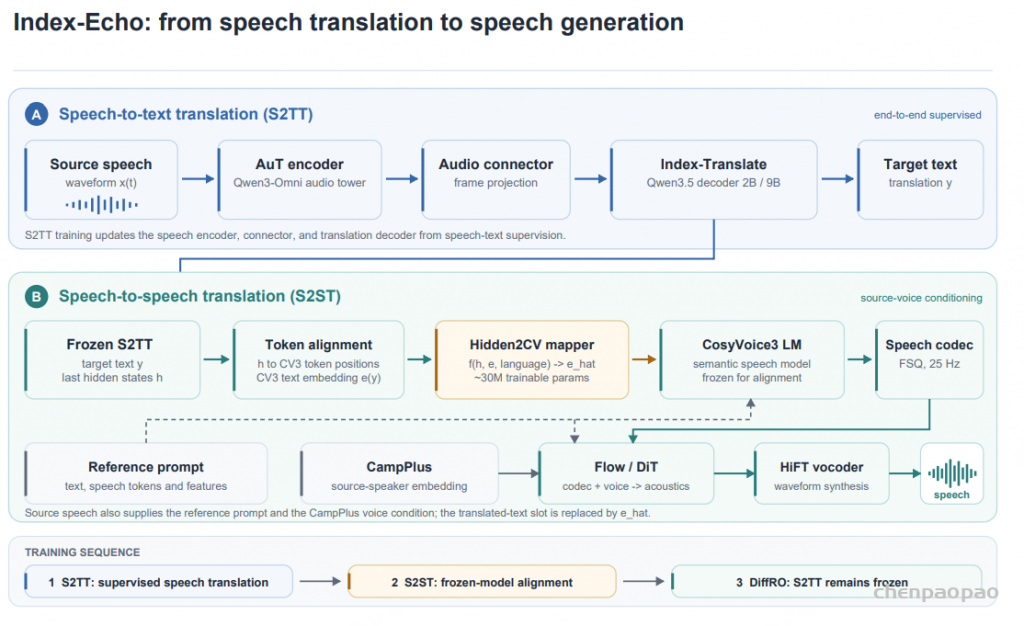
  • Index-Echo:语音到文字(S2TT)和语音到语音(S2ST),支持目标语言字幕、配音与说话人声音条件。
  • Index-Homura:接收目标音节数,在保持语义的同时重组译文长度。
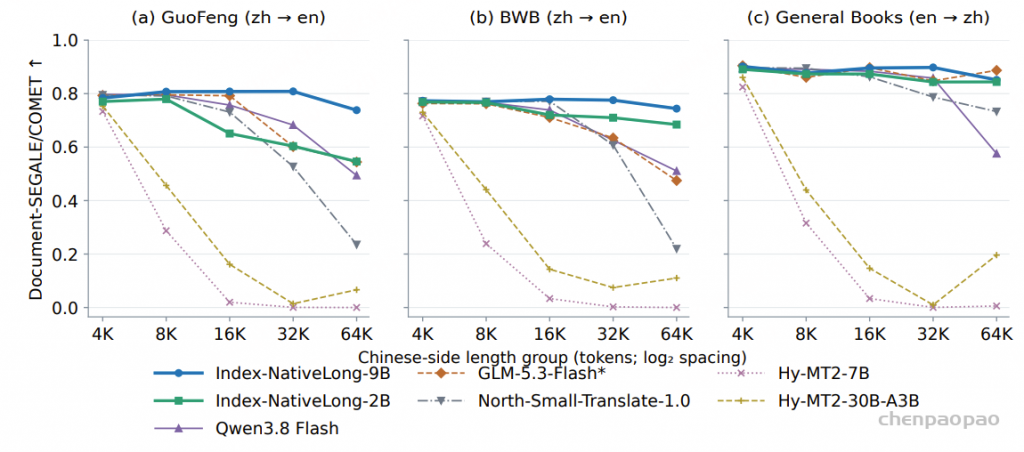
  • Index-NativeLong:输入完整文档并连续生成译文,面向书籍、网文和长篇资料的一致性。

二、统一基础模型:多语种中训 + 专家融合

1. 多语言 Mid-training

技术报告将训练拆成 constant 和 decay 两阶段。constant 阶段混合通用文本、平行语料和单语文本,采样比例为 1:1:1,7,000 步、117.44B tokens;decay 阶段使用通用文本、pivot-20 与 pivot-148 数据,比例为 1:4:2,3,000 步、50.33B tokens。总预算约 167.77B tokens,序列长度通常为 4,096,随后为长文档任务增加更长上下文。

这里的 pivot 组织不是简单地把双语句对堆在一起,而是通过英文锚点把多个语言版本连接起来。例如:

\(x_{zh}\leftrightarrow x_{ja}\) 表示普通平行数据;\(x_{zh}\leftrightarrow x_{en}\leftrightarrow x_{ja}\) 表示 pivot 数据。报告中的消融显示,多语言覆盖能明显提升非核心语言表现,同时仍需控制对通用能力的损耗。

2. 专家训练与融合

团队分别训练通用翻译专家、指令翻译专家和 MEME(社区文化表达)专家。指令专家使用约 104.5 万条、覆盖十类真实场景的样本;训练目标既包括术语、格式和结构保护,也包括风格、上下文消歧和跨句一致性。通用翻译和指令翻译使用 GRPO,MEME 使用参考引导的 LLM judge。

融合不是简单拼接多个 LoRA,而是先做参数插值:

\(\theta_{merge}=w_G\theta_G+w_I\theta_I+w_M\theta_M,\quad w_G+w_I+w_M=1\)

发布模型使用的代表性权重为 \(w_G:w_I:w_M=0.8:0.1:0.1\),之后用针对弱项的多教师 on-policy distillation(MOPD)修补融合后的能力缺口。这种设计的价值在于:通用质量、指令遵循和文化适配可以共享底座,但不必强行用一个训练目标解决所有任务。

三、三项关键扩展:语音、音节与长文档

1. Index-Echo:从“翻译文本”到“翻译声音”

Index-Echo S2TT 将 Qwen3-Omni AuT 音频编码器与 Index-Translate 解码器连接起来,直接从源音频生成目标语言文字。S2ST 则在 S2TT 基础上增加约 3,000 万参数的 Hidden2CV 映射器,把翻译器隐藏状态映射到 CosyVoice3 的语义层,并使用 DiffRO 通过 Gumbel-Softmax 语音 token 优化内容一致性;源音频还提供说话人 embedding 与声音提示。

任务/模型MT judgeASR/WER 中位误差起始时间 MAE
Index-Echo-2B S2TT0.8250.0880.395 s
Index-Echo-9B S2TT0.8570.1020.488 s
Qwen3.8-Omni-Flash0.8870.1121.004 s
SeamlessM4T-v20.0601.000—

报告还比较了 pipeline 与端到端 S2ST。以中文到日语为例,9B 端到端方案的内容错误率均值/中位数为 0.0436/0.021,音色相似度 Spk 为 0.782;这说明语音翻译的评价不能只看文本,还要同时考察内容、时间轴和说话人条件。

2. Index-Homura:把音节预算写进优化目标

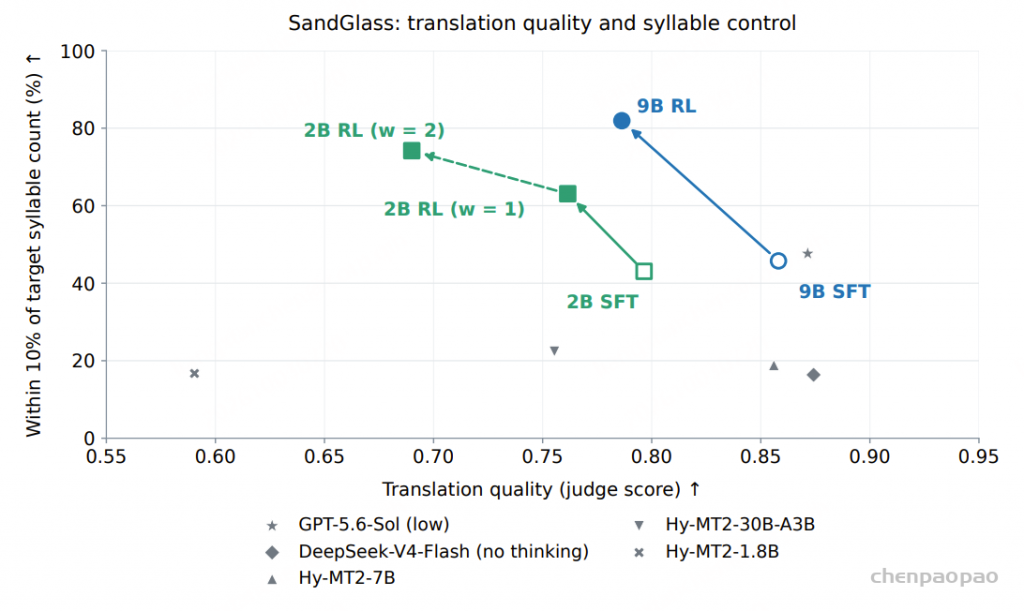
HOMURA 论文指出,大语言模型翻译存在跨语言“冗长偏置”:译文往往比时间预算允许的长度更长。它提出 Sand-Glass 基准,用真实视频转写、停顿分段和信息密度校准构造音节级时长约束。中文到英文、德文、西班牙文的理论扩展约为 1.03、1.19、1.49 倍,但未经约束的 LLM 平均扩展可达到 1.35、1.59、1.84 倍。

HOMURA 的基本长度比定义为:

\(\rho(x,y)=\frac{\sigma(y)}{\max(\sigma(x),1)}\)

其中 \(\sigma(\cdot)\) 是音节数。模型使用动态区间 \([L(x),R(x)]\),短句会适当放宽下界,长度奖励采用区间内满分、区间外指数衰减;质量奖励则由回译语义相似度、流畅性判定和可选的 GenRM 组成。整体目标可写为:

\(R(x,c,y)=\lambda_{len}R_{len}(x,y)+\lambda_{qual}R_{qual}(x,y)\)

在 3,600 条 Sand-Glass 测试案例中,Index-Homura-9B 的输出有 81.92% 与目标音节数偏差不超过 10%,明显高于普通模型的约 13%–48%。代价是:当约束越来越紧时,COMET 等质量指标会下降,模型必须在信息密度与自然度之间做可解释的折中。

模型Quality偏差≤1 音节偏差≤10%长度拟合斜率
Index-Homura-9B(RL)0.786374.42%81.92%0.968
Index-Homura-9B(SFT)0.858141.39%45.75%0.680
GPT-5.6-Sol(low)0.871542.53%47.64%0.891
Qwen3.5-9B0.718315.61%16.39%0.430

3. Index-NativeLong:原生长文档而不是“分块 + 词表”

NativeLong 的关键假设是:书籍翻译中的人物身份、术语层级和叙事关系,不能完全依靠分块翻译后再拼接。2B/9B 模型通过约 4K–64K 中文侧 token 的双向文档监督进行全参数 SFT,并在 mid-training decay 阶段使用 128K 序列实验。报告显示,Index-NativeLong-9B 在 GuoFeng、BWB、General Books 上的平均得分分别为 0.7891、0.7683、0.8848。

案例中,32K token 奇幻文本里的“王妃”在原生全文翻译的三个位置都保持为 Wang Fei,而同一 9B 模型使用分块和自动词表时,后文变成 the Dean、The Queen Consort。冰川史案例也显示,原生全文能够区分 ice age(冰河时代)、glacials(冰期)和 interglacials(间冰期),避免把上下位概念压成同一个词。

四、RIVAL 与 HOMURA:两条强化学习技术线

Index-Translate 技术报告明确吸收了 RIVAL 的训练思想。RIVAL 发现,传统 RLHF 中离线 reward model 会因为策略分布不断变化而失配,模型可能通过“奖励投机”获得高分,却生成不存在于原文的内容。因此 RIVAL 把 reward model 与翻译模型写成迭代的 min–max 对抗过程:

\(\min_{r_\phi}\max_{\pi_\theta}\;\mathbb{E}[r_\phi(x,\pi_\theta(y|x))]-\mathbb{E}_{y\sim P_{strong}}[r_\phi(x,y)]\quad\text{s.t.}\quad D_{KL}(\pi_\theta\|\pi_{ref})<\eta\)

RIVAL 的 reward model 同时学习定性偏好和定量偏好:前者用强/弱翻译排序,后者用 BLEU 的 MAE 近似。实验中,MAE 的定量误差为 0.19、定性准确率为 99.5%,优于 MSE 的 0.93 和 97.0%。在中文到英文的口语字幕任务上,RIVAL-Iter1 的 GPT-4o 平均评分为 3.68,优于 Qwen2.5-7B-SFT 的 3.46;WMT 中文到英文在 Iter2 达到 BLEU 33.42、COMETKiwi 73.61。

两条技术线各自解决不同问题:RIVAL 解决 reward model 与策略分布漂移,HOMURA 解决时长约束下的质量—压缩折中。Index-Translate 则把这些训练方法组合到通用翻译、指令翻译、MEME 和字幕任务中。

五、实验对比:质量、约束遵循与小语种不能混成一个分数

技术报告使用 FLORES-200、FLORES 低资源对、WMT24++、WMT26、instTrans、IFMTBench、MEME、OPUS-Books、Biomedical、MTNT、MuST-Cinema 和 GuoFeng-Webnovel 等数据。需要注意:COMET-22、XCOMET-XXL、WMT judge、IFscore 和 MEME 分数的量纲不同,不能直接横向相加。

模型FLORES COMET-22WMT26 JudgeinstTrans IFscoreMEME
Index-Translate-35B-A3B(preview)0.879476.760.83360.7405
Index-Translate-9B0.878975.350.82090.7387
Index-Translate-2B0.865560.260.75690.6443
Hy-MT2-7B0.874760.510.60790.5139
GPT-5.6-Sol0.865089.100.76240.7194

低资源结果更能体现项目的训练取向:35B-A3B 在 FLORES_minor_pair 上取得 COMET-22 0.8168、XCOMET-XXL 0.7164,off-target 仅 2.4%;9B 在 instTrans_minor 上取得 IFscore 0.7725,且 off-target 为 3.47%。指令基准 instTrans 包含 3,000 条中文到 20 种语言任务,低资源扩展另有 2,793 条;MEME 则包含 3,638 条中译英社区表达,覆盖 703 个词语和 857 个词义。

通用能力方面,Index-Translate-9B 的 C-Eval、GPQA-Diamond、INCLUDE、MMMLU 分数分别为 69.6、36.3、63.1、66.6;这说明专家融合后仍保留一定基础模型能力,但它的主要优势仍在翻译与约束任务,而非通用问答榜单。

六、最值得关注的创新点

  • 能力边界被显式建模:把“格式是否保留、术语是否一致、目标语言是否正确、音节是否命中、长文身份是否稳定”作为可测量目标,而不是只看译文流畅度。
  • 多语基础与专门模型分工:150 语种共享基础模型,语音、音节、长文档采用专门训练,避免一个模型在所有约束上互相牺牲。
  • 奖励函数更接近生产需求:通用翻译使用 XCOMET、目标语言 gate 和 adequacy;指令翻译加入硬约束 gate;HOMURA 加入动态音节奖励;RIVAL 用迭代 reward model 缓解 reward hacking。
  • 参数融合后再定向蒸馏:先用 0.8/0.1/0.1 融合通用、指令和 MEME 专家,再通过 MOPD 修复融合造成的局部退化。
  • 从句子级走向内容生产级:语音输出、时间轴、声音条件、结构化数据和全篇一致性都进入同一产品路线。

七、局限与使用建议

第一,35B-A3B 仍是 preview,论文与 README 的部分评测使用不同解码和汇总口径;引用数据时应注明模型版本和指标。第二,音节数只是语音时长代理,真实配音还受语速、停顿、音素时长和声码器影响。第三,NativeLong 对超长文档的显存、吞吐和错误恢复要求较高,生产部署仍要评估上下文窗口与并发成本。第四,LLM judge、回译和 XCOMET 都可能存在偏差,官方也记录了引用后缀、终止标记等 judge failure cases。

如果你的任务是结构化资料、社区内容或多语言产品文本,优先选择 Index-Translate-9B;如果是低延迟或资源受限场景,可从 2B 开始。如果是视频字幕和配音,建议使用 Index-Echo + Index-Homura 的组合,并把实际音频时长作为最终验收标准;如果是书籍、网文或技术报告,优先测试 NativeLong 的全篇一致性,再决定是否采用分块流程。

八、结语

Index-Translate 的价值不只在于“多翻几种语言”,而在于重新定义翻译模型的交付指标:能否保留结构、接住语境、压进时长、维持音色,并在一整本书里保持同一个人物和概念。它的工程路线也很清晰:共享多语底座,专家化训练,参数融合与定向蒸馏,再为语音、长度和长文档建立专门接口。对于希望把翻译直接接入内容生产流程的团队,这种模型家族式设计比单一榜单分数更值得关注。

参考资料

MiniMax Music 3.0-音乐创作模型

MiniMax Music 3 是一种高性能的音乐创作模型,能够生成时长可达五分钟的完整歌曲。该模型基于歌词和详细的音乐描述进行创作,能够生成结构紧凑、富有表现力的歌曲,同时具备稳定的长音频质量。只需提供一个创意想法和可选的歌词,模型即可在一次生成中完成作曲、编曲、演唱与制作,创作出一首完整的歌曲。

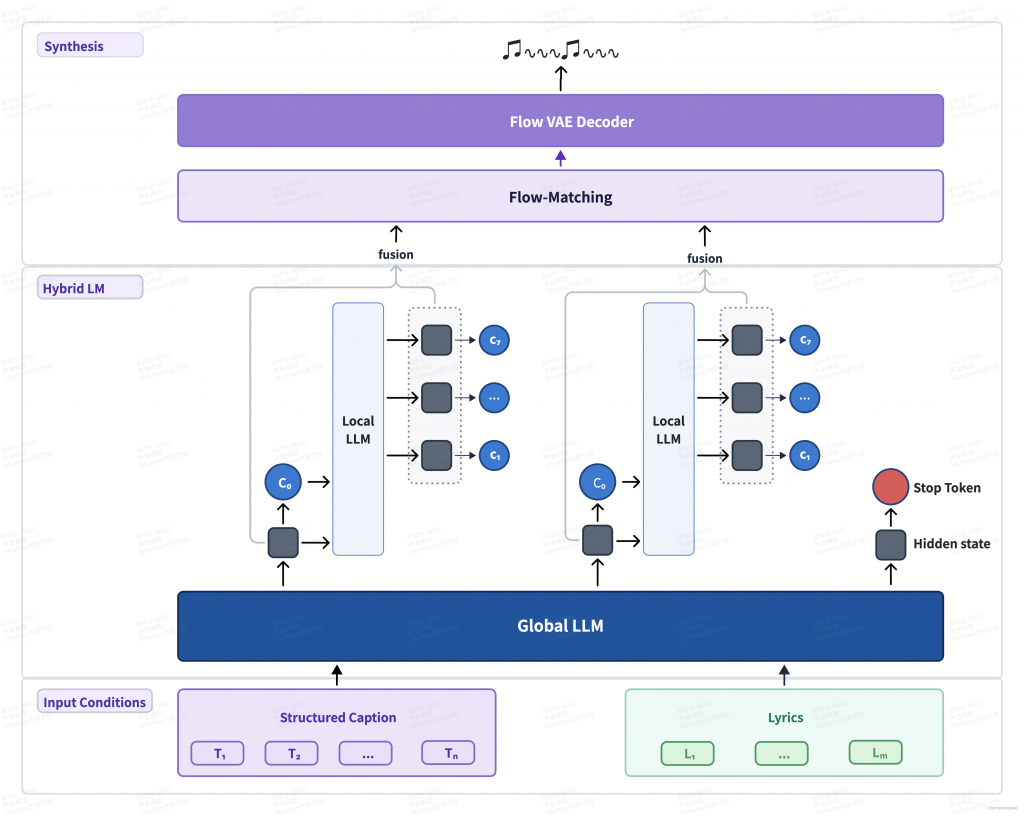
从音乐描述、语言模型到声音渲染重新设计了整条生成链路:用细粒度时序描述呈现情绪、配器与演唱的发展,以全局—局部协作的 Hybrid-LM 兼顾长程结构和声学细节,再通过多层 RVQ、Hidden States 融合与 Flow-Matching/Flow-VAE 提升最终声音的保真度。由此带来三项核心升级:更准确地理解创作意图、更完整且富于变化的编曲,以及更清晰、更自然的声音表现。

MiniMax Music 3 模型结合了一个 8 亿参数的全局语言模型,用于构建长期的音乐结构;以及一个 0.6 亿参数的局部语言模型,用于处理帧级的声音细节。该模型还采用了基于流匹配和流变显式估计的连续隐藏状态合成系统。最终,该模型能够生成 32 kHz 采样率、16 位立体声的 WAV 音频文件。

MiniMax Music 3.0 技术解析:开放权重音乐模型如何实现完整歌曲生成

MiniMax 正式推出新一代音乐生成模型 MiniMax Music 3.0。用户只需输入一个创意想法,并根据需要提供歌词,模型便可以在一次生成中完成作曲、编曲、演唱与制作,生成最长约 5 分钟的完整歌曲。

与只追求“生成一段好听音频”的传统方案不同,Music 3.0 更关注创作者意图能否贯穿整首作品:情绪是否持续一致,乐器是否按照结构合理进入和退出,人声是否自然,歌曲是否具有完整而连贯的发展。

MiniMax 官方将 Music 3.0 定义为开放权重、生产级全能音乐模型。其核心技术路线由 Tokenizer、Hybrid-LM 和 Synthesis 三个部分组成,并通过 Structured Caption、Hidden State Fusion、Flow-Matching 和 Flow-VAE 等技术,提升音乐结构、编曲细节与声音质量。

一、Music 3.0 解决了音乐生成中的哪些难题?

音乐生成看似只需要“输入提示词、输出音频”,但真正困难的地方在于如何把抽象的创作要求转化为可持续执行的音乐结构。

  • 用户指定的乐器能否贯穿整首歌曲,而不是只在开头出现?
  • 歌曲从主歌进入副歌时,情绪是否有自然的铺垫和释放?
  • 长达数分钟的生成过程中,节奏、调性和人声是否保持稳定?
  • 复杂编曲中,鼓组、贝斯、人声和旋律乐器能否保持清晰分离?
  • 生成的人声是否具有自然的发音、换气、连贯性和情感变化?

Music 3.0 的设计目标,正是同时解决这些问题。它不仅要生成一段合理的音乐,还要尽可能实现一套完整、连贯的创作构想。

二、三层技术架构:Tokenizer、Hybrid-LM 与 Synthesis

Music 3.0 的完整生成流程可以概括为三个阶段:

  1. Tokenizer:将音乐压缩成适合模型理解和预测的多层离散表示。
  2. Hybrid-LM:同时建模歌曲的全局结构和局部声学细节。
  3. Synthesis:将语言模型理解到的音乐信息还原为高保真音频。

1. 多层 RVQ:分离音乐结构与声学细节

Music 3.0 使用八层残差向量量化(Residual Vector Quantization,RVQ)表示音乐信息。

  • 第一层主要负责音乐的核心语义和结构。
  • 第二至第八层逐步补充声学残差和声音细节。
  • 第一层使用大小为 16,384 的码本。
  • 第二至第八层分别使用大小为 1,024 的码本。

在训练过程中,模型会先单独训练第一层,使其建立稳定的音乐信息骨架,再联合训练全部八层。这样的分层设计,可以避免单层 Token 同时承担过多的结构和音质信息,也有助于降低长歌曲生成时的累计误差。

2. Hybrid-LM:全局结构与局部声学协同建模

为了兼顾长程结构和局部细节,Music 3.0 采用了全局模型与局部模型协同工作的 Hybrid-LM 架构。

  • 8B Global LLM:基于 Qwen3.5-8B 初始化,负责逐帧预测音乐语义 Token,并理解整首歌曲的上下文、结构和发展方向。
  • 0.6B Local LLM:随机初始化,负责在每一帧内部沿深度轴预测声学 Token,补充局部的音色、演奏和声音细节。

训练过程分为两个阶段。第一阶段主要建立 Global LLM 对音乐语义的预测能力;第二阶段则对 Global LLM 与 Local LLM 进行全参数联合训练。

这种“全局负责方向、局部负责细节”的分工,使模型能够在最长 5 分钟的歌曲中保持结构稳定,同时保留不同段落应有的变化。

3. Hidden State Fusion:从离散预测走向连续声音渲染

传统音乐生成流程通常会将离散声学 Token 直接送入解码器。Music 3.0 则进一步融合 Global LLM 与 Local LLM 的连续 Hidden States,并将其作为声音生成模块的条件输入。

官方公布的声音生成链路为:

LLM 融合特征 → Flow-Matching → VAE Hidden States → Flow-VAE Decoder → 最终音频

其中,2.4B Flow-Matching 模块负责将融合后的语言模型特征映射至 VAE 隐空间;123M Flow-VAE 则负责完成最终的音频解码。

相比只依赖离散 Token,连续 Hidden States 能够保留更多高维声学信息,从而改善人声发音、乐器连贯性和音乐细节表现。

三、Structured Caption:让模型真正理解创作意图

音乐提示词最大的难点,是很多听感描述并不能直接转化为可执行的生成条件。例如,“温暖但克制”“逐渐变得宏大”“像一场现场演出”等表达,对人类音乐制作人来说很直观,但对模型而言却需要更细粒度的结构化描述。

Music 3.0 使用 Structured Caption 对音乐进行细粒度的时序描述。它不仅描述曲风,还会进一步说明:

  • 速度、拍号与调性;
  • 音乐情绪如何随时间变化;
  • 主奏和伴奏乐器何时进入、叠加或退出;
  • 鼓组、贝斯和律动基础如何发展;
  • 人声的音色、唱法、气声、假声与和声;
  • 空间感、混音质感、Delay 和 Autotune 等效果。

这套描述方式将抽象的音乐感受转化为更接近专业编曲语言的生成条件,使模型能够在歌曲发展过程中维持统一的音乐身份,同时保留合理的动态变化。

Prompt Enhancement:降低专业音乐创作门槛

为了让非专业用户也能使用这些复杂的音乐描述,MiniMax 构建了基于模板的 Prompt Enhancement System。

系统可以从专业 Structured Caption 模板库中选择合适的表达,并结合音乐术语与编曲规则,将用户的一句话扩展为逻辑更完整、细节更丰富的结构化提示词。

例如,用户只需输入“做一首温暖、克制的不插电歌曲”,系统就可以进一步补充人声类型、吉他演奏方式、空间感、动态变化和混音方向,使最终结果更接近用户真正想要的作品。

四、更完整、更富于变化的长歌曲编曲

长歌曲生成并不只是把音频“延长”。真正的难点在于让不同段落之间形成合理的发展关系。

Music 3.0 支持使用段落标签描述歌曲结构,包括:

  • [intro]:前奏
  • [verse]:主歌
  • [pre-chorus]:副歌前段
  • [chorus]:副歌
  • [bridge]:桥段
  • [instrumental]:器乐段
  • [solo]:独奏段
  • [outro]:尾奏

这些标签提供宏观结构,而 Structured Caption 则进一步描述每个时间阶段中的情绪、配器、人声、节奏和空间效果。两者结合后,模型可以更好地理解“哪里应该发生什么变化”。

在模型侧,8B Global LLM 负责维护全曲上下文,0.6B Local LLM 负责补充每个时间帧内的声学细节。这样的协作机制,可以帮助歌曲保持整体方向,同时避免长时间生成中出现段落重复、编曲单一或情绪突然中断。

五、声音品质升级:更清晰的混音与更真实的乐器

Music 3.0 在声音表现方面也进行了系统升级,目标是让混音更加开阔、清晰和平衡,减少传统生成音乐中常见的拥挤与浑浊感。

多层 RVQ 负责保留从核心结构到声学细节的不同层次信息;Hidden State Fusion 则在连续特征层面连接语言模型和声音渲染模块。通过这两种方式,模型可以更准确地响应具体的乐器指令,并呈现滑音、连奏等更接近真实演奏的技法。

  • 独奏乐器的触弦、运弓和演奏细节更加清晰;
  • 鼓组和贝斯具有更明确的冲击力与层次;
  • 复杂电子编曲中的声部分离度更高;
  • 低频保持力量感,同时减少对其他声部的遮蔽;
  • 人声周围的空间感更加自然。

六、重塑自然人声:减少“机器感”

人声往往是生成音乐中最容易暴露机器感的部分。高频伪影、发音不清、乐句僵硬、不自然的换气,都会影响听众对歌曲情感的感受。

Music 3.0 通过新的声音渲染系统,对音色、唱法、气声、假声、和声以及 Delay、Autotune 等人声效果进行更细致的描述。

结合 Global LLM 与 Local LLM 的连续 Hidden States,Flow-Matching 和 Flow-VAE 可以将这些演唱信息带入最终的音频生成过程,从而改善:

  • 歌词发音的准确性;
  • 旋律线条的连贯性;
  • 主歌与副歌之间的情绪变化;
  • 呼吸和停顿的自然程度;
  • 多层和声与主唱之间的融合。

理想情况下,生成的人声可以从克制的主歌逐渐过渡到开阔的副歌,也可以根据歌曲风格完成节奏型演唱、持续旋律、气声和声等不同表达。

七、一个适合 Music 3.0 的提示词示例

如果希望获得更稳定的结果,可以参考以下结构编写提示词:

温暖的中文流行抒情歌曲,74 BPM,A♭大调。
情绪从克制怀旧逐渐发展到温暖明亮的副歌。
成熟男中音,细腻但不过度夸张的演唱,
以钢琴、木吉他、古筝和柔和弦乐为主要配器。
主歌保持留白,副歌加入鼓组和宽阔和声,
整体采用自然的现场录音室混音质感。

[Intro]
[Verse]
[Pre-Chorus]
[Chorus]
[Bridge]
[Final Chorus]
[Outro]

这个提示词同时包含了风格、速度、调性、情绪发展、人声特征、配器、混音方向和歌曲结构,通常比单独输入“生成一首温暖的中文歌曲”更容易得到稳定、可控的结果。

八、Music 3.0 对 AI 音乐创作的意义

从技术路线来看,Music 3.0 的重点并不是单一模型规模的提升,而是对音乐生成全链路进行重新设计。

  • Tokenizer 负责把音乐拆解为结构与细节;
  • Hybrid-LM 负责同时理解长程结构和局部声学;
  • Structured Caption 负责把创作者意图转化为可执行描述;
  • Hidden State Fusion 负责连接语言理解与连续声音渲染;
  • Flow-Matching 与 Flow-VAE 负责还原更高保真的最终音频。

这意味着 AI 音乐正在从“生成一个片段”逐步走向“完成一首作品”。对于音乐人、短视频创作者、游戏开发者、影视制作团队和普通用户来说,未来的重点不再只是能否生成音乐,而是能否更准确地表达创作意图,并在生成过程中保持结构、情绪和声音质量的一致性。

结语

MiniMax Music 3.0 通过多层 RVQ、Hybrid-LM、Structured Caption、Prompt Enhancement、Hidden State Fusion、Flow-Matching 和 Flow-VAE 等技术,试图解决音乐生成中最具挑战的几个问题:长歌曲结构稳定、编曲具有发展、人声更加自然,以及复杂混音中的细节还原。

它所展示的方向非常明确:音乐生成不应只是“听起来像音乐”,而应该更加接近真正的创作流程,让用户可以从一个想法出发,逐步得到一首完整、连贯并具有制作质感的歌曲。

关于模型权重、使用方式和具体开放政策,请以 MiniMax 官方最新发布页面为准。

参考资料:
MiniMax Music 3.0:新一代开放权重、生产级全能音乐模型|MiniMax 官方技术博客

Hy ASR 3.0 preview-腾讯混元语音识别模型

Hy ASR 3.0 preview 融合高精度语音识别与深度语义理解能力,在通用识别、上下文感知、多场景鲁棒性以及方言覆盖等核心维度实现全面提升,能够在更复杂的真实输入中给出准确、连贯且更接近用户意图的转写结果,从“逐字转写、单点优化”演进为“理解语境、兼容场景、一键直出”。

架构、数据、后训练持续增强,提升语音识别能力上限

Hy ASR 3.0 preview 的能力提升并非来自单一模块,而是模型架构、数据  Scaling 与后训练优化共同作用的结果。

在架构层面,Hy ASR 3.0 preview 采用兼顾效率与性能的 MoE 架构,并将基座模型升级至 Hy3,进一步增强语言理解、上下文建模和语义推理能力。在语音侧,团队自研无监督语音 Encoder,通过数千万小时级无监督语音数据训练,使其能够从复杂音频中提取高质量的声学表征。

为了持续提升模型的语音建模与理解能力,混元团队对语音 Encoder 和大语言模型进行联合训练,引入数千万小时级、多来源的语音数据,覆盖多种方言、口音和声学环境,并通过高质量数据管线进行精细化标注。在大规模联合预训练的基础上,Hy ASR 3.0 preview 通过多阶段能力注入,逐步获得上下文感知、复杂场景适应和方言识别等能力。

围绕通用识别、上下文理解和复杂场景鲁棒性,团队构建了高质量的 SFT recipe,覆盖上下文 context、专业名词、不同声学环境以及多样人群语音。针对方言识别能力,SFT 数据体系进一步覆盖 10 大方言片区和 20 余个二级小片区。

在此基础上,团队进一步引入多阶段强化学习,分别针对通用转写准确性、Any-context 上下文能力和复杂长尾场景进行优化,降低模型在复杂声学环境中的误识别和漏识别问题。

AmphionASR-大规模热词的个性化语音识别

基于Qwen3-ASR-1.7B的统一条件化语音识别系统,将热词检索、目标说话人选择、退化鲁棒与耳语识别整合进单一1.7B参数SpeechLLM。

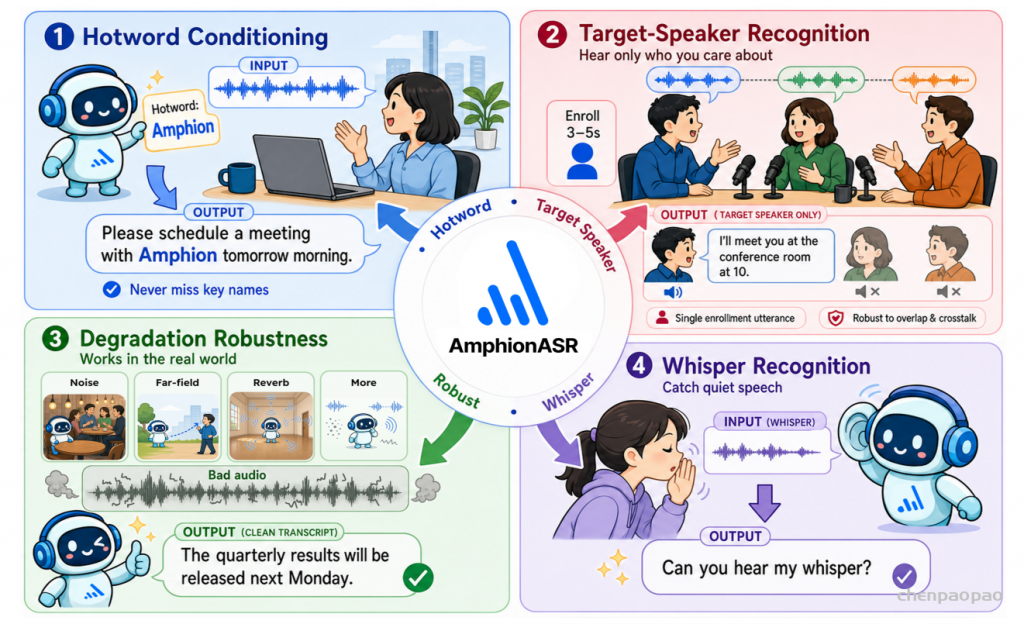
现实中的语音识别往往不只是“把声音转成文字”。用户可能希望模型优先识别人名、品牌名和行业术语,也可能只想转写某个指定说话人;输入音频还可能带有远场、噪声、混响、传输丢失,甚至是耳语。AmphionASR 的目标,就是用一个统一的 SpeechLLM 同时处理这些条件,而不是为每种场景分别维护一套模型。

论文最终给出的模型以 Qwen3-ASR-1.7B 为基础,通过分阶段微调、检索增强和目标说话人数据合成,将通用 ASR、热词 ASR、目标说话人 ASR、退化音频 ASR 和耳语 ASR 统一起来。其最突出的结果包括:热词检索 Recall@50 超过 94%,中英文实体错误率分别下降 55% 和 37%;目标说话人识别 WER 达到 13.02%;中文耳语 CER 为 0.58%,英文耳语 WER 为 6.11%。

AmphionASR 的四项主要条件化识别能力——热词、目标说话人、退化鲁棒性和耳语识别。

一、论文要解决什么问题

传统通用 ASR 默认将输入中的全部可听语音转写出来,但在实际业务里,“识别什么”和“在什么条件下识别”经常需要额外说明。论文将这些需求归纳为四类:

  • 热词条件识别:利用用户提供的词表,提高人名、地名、产品名和专业术语的识别率。
  • 目标说话人识别:给定目标说话人的短注册语音,只转写混合音频中该说话人的内容。
  • 退化音频识别:处理噪声、远场、遮挡、混响、录音染色、电子失真和传输丢失等情况。
  • 耳语识别:处理声带振动特征和正常语音明显不同的低能量耳语。

这些任务的附加信息不同,但输出目标相同:生成用户真正想要的那部分转写。AmphionASR 因而采用统一的指令接口,通过文本指令、热词列表或注册语音告诉模型当前任务。

本文提出 AmphionASR,一套可同时适配上述四类识别任务的统一模型。热词列表、目标说话人注册音频作为任务条件输入;各类受损语音、耳语样本则用于让模型适配非常规声学输入。该设计将通用识别主干网络,与 “识别对象、识别约束条件” 两类辅助信息解耦。 热词识别分支的技术路线参考已有研究,融合 GLCLAP Top-K 检索、提示词注入、基于强化学习的 GRPO 优化方案;本文重点是将整套热词流程集成至统一模型,并在四类任务上完成全面评测。

二、模型总体设计

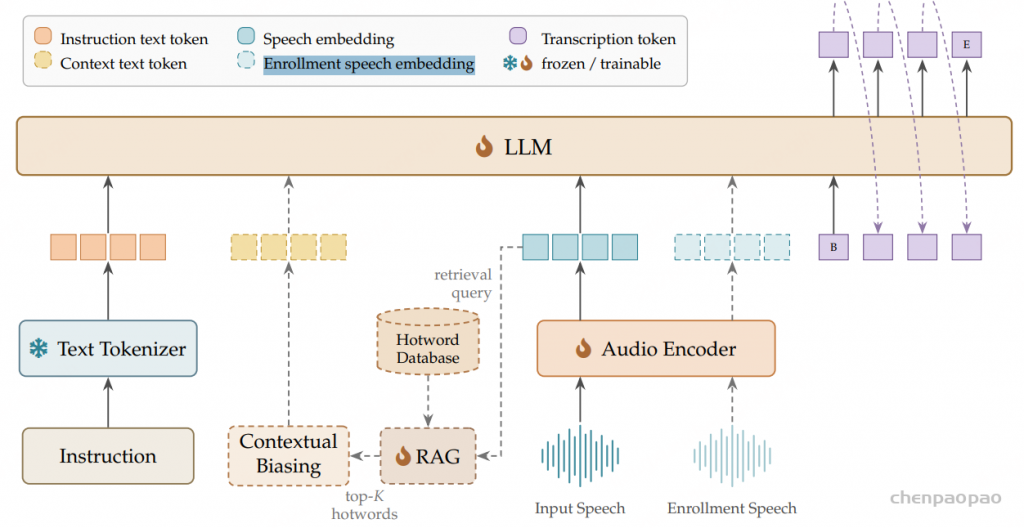
AmphionASR 由音频编码器、语言模型和热词检索分支组成。论文称其为 1.7B 模型,是按照 LLM 参数量命名;如果计入约 300M 的音频编码器和 2.6M 的检索适配器,总参数量约为 2.0B。

组件参数量主要设计
音频编码器300M初始化自 Qwen3-ASR-1.7B 的 AuT 编码器
语言模型1.7B28 层 Decoder-only Transformer,隐藏维度 2048
RAG 适配器2.6M音频和文本两侧的 MLP 投影层
合计约 2.0B音频编码器、LLM 与检索适配器
核心参数来自论文 Table 1。

Figure 2,AmphionASR 整体架构图

1. 音频编码器

输入为 16 kHz 单声道音频。前端提取 128 维 Log-Mel 特征,帧移为 10 ms,随后经过卷积下采样和 24 层 Whisper 风格的 Pre-LN Transformer,输出 2048 维、12.5 Hz 的音频帧表示。模型使用 800 帧的分块推理窗口,从而突破普通 30 秒输入限制。

2. 语言模型与统一提示词

音频表示会直接进入 Qwen3-ASR-1.7B 的语言模型嵌入空间,再由自回归解码器生成转写。不同任务不需要切换模型,只需要更换提示词和可选输入:

  • 通用 ASR:要求转写输入音频。
  • 热词 ASR:在提示词中增加 [Hotwords: ...]。
  • 目标说话人 ASR:先输入注册语音,再输入待转写的混合语音。
  • 耳语 ASR:明确告诉模型输入是一段 whispered audio。

目标说话人任务中的注册语音和混合语音共用同一个音频编码器,并以“注册语音在前、混合语音在后”的两个音频嵌入片段进入 LLM。这个设计没有增加独立的说话人编码网络,而是让语言模型在统一上下文中完成说话人条件选择。

三、细粒度热词检索:从万级词库中找出当前相关词

直接把上万个候选热词塞进提示词既浪费上下文,也会引入大量无关干扰。AmphionASR 因此先进行检索,只选出与当前音频最相关的 Top-K 热词,论文默认 K=50。

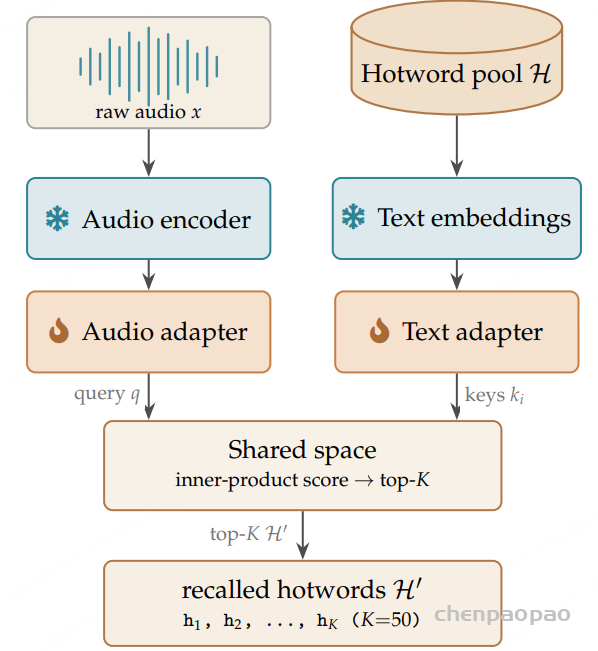
与将整段音频池化成一个向量的方案不同,AmphionASR 保留逐帧音频表示。音频帧和候选热词分别通过两个小型 MLP 映射到共享的 512 维空间:

\( a_t = g_{\mathrm{audio}}\!\left(\mathrm{AuT}(x)_t\right),\qquad k_h = g_{\mathrm{text}}\!\left(E_{\mathrm{tok}}(h)\right) \)

每个热词与所有音频帧计算内积,并取时间维度上的最大值作为相关性:

\( s_h = \max_t a_t^{\top}k_h,\qquad \mathcal{H}’=\operatorname{TopK}_{h\in\mathcal{H}}(s_h) \)

这种 max-over-time 方式强调局部匹配:即使热词只在长音频中短暂出现,也不容易被全句平均表示淹没。选出的热词随后作为逗号分隔的文本插入提示词,ASR 仍然只需要执行一次解码。

Figure 3,细粒度热词检索流程。该图用于说明音频帧、文本热词、共享空间和 Top-K 选择之间的关系

四、训练数据与三阶段训练

AmphionASR 基于低秩自适应微调(LoRA)有监督微调(SFT)三阶段训练方案完成训练。AmphionASR 使用 11 个公开语料构建出 8 个训练集合,总计 3,737,145 条训练样本。其中,目标说话人样本包含注册语音和混合语音两个音频输入,同时加入通用转写数据,缓解模型灾难性遗忘问题。

训练任务样本数主要来源
耳语 ASR222,440WhispEar,中英文耳语
退化鲁棒 ASR556,421Voice-in-the-Wild-2M
热词 ASR1,043,317CommonVoice、MagicData、AISHELL-1/3、THCHS-30
通用 ASR 保持1,290,464AISHELL-2、LibriSpeech
目标说话人 ASR624,503多个公开单说话人语料合成

训练阶段热词词表构建逻辑:

针对带热词的训练样本,每条样本动态生成专属热词列表,真实热词 + 干扰词总数量约束在 10~50 个,词表构建分三步:

  1. 真实实体词 每条标注真值热词有 5% 概率被随机剔除,模拟检索模块召回不完全的真实场景。保留绝大多数真实热词,使模型能够借助上下文偏置修正稀有实体、领域专业术语,解决无约束解码器极易错识这类词汇的问题。
  2. 难例负样本(易混淆干扰词) 在线检索器为每条样本最多召回 10 个高度混淆词汇;检索打分权重为:0.6× 字符重叠度 + 0.4× 二元组杰卡德相似度,中文额外增加音节级近邻检索扩充候选。这类字形、发音相近的干扰词用于训练模型区分相似热词,避免模型无脑匹配列表内任意词汇。
  3. 随机干扰词 词表剩余空位从全局热词库随机填充;优先填满难例负样本,再补充随机词,保证列表总长落在 10~50 区间。随机无关词汇用于约束提示词长度,防止模型过度依赖匹配候选词产生识别偏置。

每条语音样本有 80% 概率保留完整热词提示行,20% 概率直接舍弃热词输入。该策略让模型在训练时同时接触 “带热词辅助” 与 “无热词辅助” 两类输入,提升泛化能力。

阶段 1:适应耳语和退化音频

音频编码器和 LLM 同时训练,数据来自 Voice-in-the-Wild-2M 和 WhispEar。由于这些声学条件与普通清晰语音差异较大,论文首先允许声学表示和语言模型共同适应。

阶段 2:学习热词与目标说话人条件

冻结音频编码器,只更新 LLM。模型在这一阶段学习如何使用热词提示,以及如何根据注册语音从多人混合音频中选择目标说话人。

阶段 3:通过数据回放抑制灾难性遗忘

继续冻结音频编码器,在前两阶段数据之外加入 AISHELL-2 和 LibriSpeech 通用转写数据。目的不是追求新的通用 ASR SOTA,而是在增加个性化能力后尽量保留原模型的基础识别能力。

三个阶段均采用全线性层 LoRA,LoRA rank 为 64、alpha 为 128;每阶段训练 1 个 epoch,学习率为 \(1\times10^{-6}\),余弦衰减和 5% warmup,有效 batch size 为 384,使用 6 张 GPU。

GRPO:同时优化转写准确率和热词一致性

三阶段 SFT 后,论文冻结音频编码器,通过 GRPO 继续优化 LLM。ASR 奖励是经过截断的负 CER:

\( R_{\mathrm{asr}}(\hat y,y)=\max\left(0,1-\mathrm{CER}(\hat y,y)\right) \)

热词奖励检查每个候选词在预测和参考文本中的“出现/未出现”状态是否一致:

\( R_{\mathrm{hw}}(\hat y,y;C)=\frac{1}{|C|}\sum_{c\in C} \mathbf{1}\!\left\{\mathbf{1}[c\in\mathrm{Pred}]=\mathbf{1}[c\in\mathrm{Ref}]\right\} \)

总奖励为:

\( R=R_{\mathrm{asr}}+0.3R_{\mathrm{hw}} \)

这一设计不仅鼓励模型抄对热词,也惩罚它盲目输出提示词中实际没有被说出的词。不过论文没有提供“SFT 后、GRPO 前”的独立对照,因此实验无法单独量化 GRPO 的贡献。

五、目标说话人数据是如何合成的

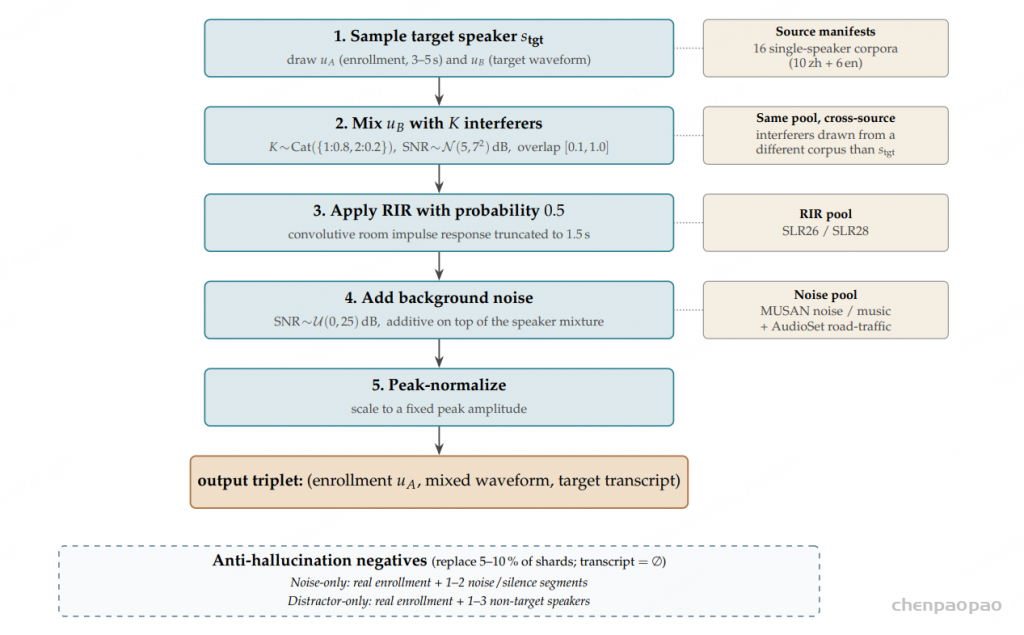
目标说话人训练数据由单说话人语料离线合成。对于同一目标说话人,系统选择两段不同录音:一段作为 3 至 5 秒注册音频,另一段作为待混合的目标语音,再加入 1 至 2 个非目标说话人。

混音过程可写为:

\( x_{\mathrm{mix}}[n]=s_{\mathrm{tgt}}[n]+\sum_{k=1}^{K}\alpha_k s_{\mathrm{int},k}[n-o_k],\qquad \alpha_k=\frac{\rho_{\mathrm{tgt}}}{\rho_{\mathrm{int},k}}10^{-\mathrm{SNR}_k/20} \)

其中 \(K\sim\mathrm{Cat}(\{1:0.8,2:0.2\})\),说话人间 SNR 服从均值 5 dB、标准差 7 dB 的正态分布,并截断到 -5 至 20 dB;干扰语音覆盖目标语音的比例从 0.1 到 1.0 均匀采样。之后以 0.5 的概率加入 RIR,再以 0 至 25 dB 的 SNR 加入 MUSAN 或 AudioSet 环境噪声。

为了降低“目标说话人不在场时仍然胡乱输出”的问题,训练集还包含 66,194 条空转写负样本,包括噪声/静音和只有非目标说话人的混合音频。这一部分是目标说话人系统能够学习保持沉默的关键。

Figure 4,目标说话人训练数据离线合成流程;可同时参考 Table 16 和 Table 17 的 RIR、噪声来源与负样本参数

六、实验结果

1. 热词和行业实体识别

在 GigaSpeechBench 的 12 个垂直领域中,加入 RAG 后,中文平均实体 B-CER 从 23.18% 降至 10.39%,相对下降约 55%;英文平均实体 B-WER 从 14.78% 降至 9.35%,相对下降约 37%。加入热词上下文后,AmphionASR 在中文 12 个领域中的 11 个、英文全部 12 个领域中优于无热词输入的 Qwen3-ASR-1.7B。

测试集无 RAG使用 RAGRecall@50
GigaSpeechBench 中文平均 B-CER23.18%10.39%–
GigaSpeechBench 英文平均 B-WER14.78%9.35%–
CommonVoice 中文热词9.27%2.30%94.52%
CommonVoice 英文热词28.93%9.81%95.19%
根据论文 Table 9、Table 10 和 Table 11 汇总,指标均越低越好,Recall 除外。

在约一万个候选词的词库上,相比已经预先计算好 Top-50 热词的条件,在线检索增加的配对中位延迟为英文 1.37 ms、中文 3.25 ms。但该实验每种语言只有 30 条音频,运行在共享 H20 上,没有并发和 RTF 数据,因此只能说明热状态下的相对开销,不能直接视为生产吞吐量结论。

2. 目标说话人识别

在内部合成的目标说话人测试集正样本上,AmphionASR 的 WER 为 13.02%,明显低于零样本 Qwen3-Omni-30B-A3B 的 31.91%,也远低于未进行目标说话人训练的 Qwen3-ASR-1.7B 的 78.99%。

模型正样本 WER目标缺席静音误报率
Qwen3-ASR-0.6B84.97%100.00%
Qwen3-ASR-1.7B78.99%100.00%
Qwen3-Omni-30B-A3B 零样本31.91%9.15%
AmphionASR13.02%6.10%
论文 Table 13,数值越低越好。

这一结果说明模型确实学到了“根据注册语音选择说话人”的能力,同时负样本降低了目标缺席时的幻觉。不过测试集由与训练相同的合成流水线生成,只是更换随机种子和说话人;论文也没有与专用 TS-ASR 模型进行完全一致协议下的比较,因此泛化能力仍需要公开真实重叠语音数据验证。

3. 真实退化音频鲁棒性

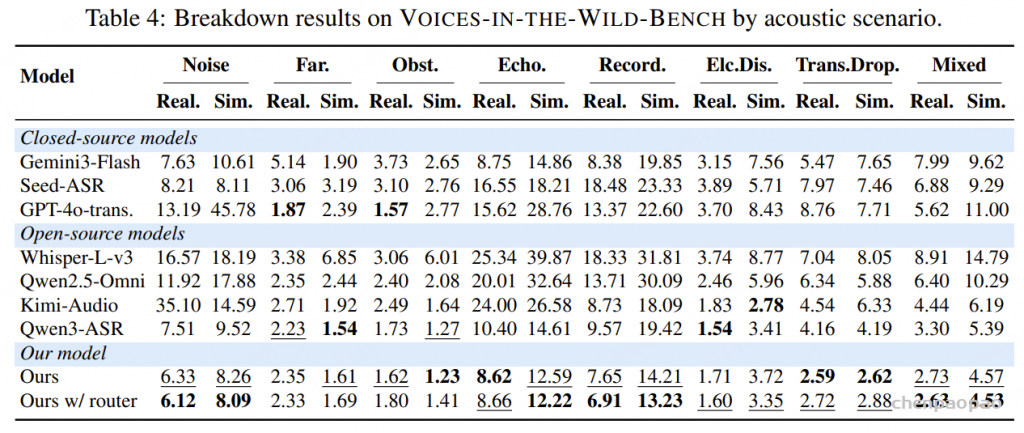
Voice-in-the-Wild-Bench 包含 5,000 条中英文音频,覆盖 7 类单一退化和 Mixed 复合退化,并分为真实录音与频谱模拟两组,共 16 个子集。AmphionASR 在其中 8 个子集取得最低 WER。

  • 真实录音领先项:遮挡 1.38%、混响 7.91%、录音染色 6.32%、传输丢失 2.32%。
  • 模拟退化领先项:噪声 7.24%、混响 11.49%、录音染色 11.55%、Mixed 4.19%。
  • Real-Mixed 为 2.85%,仅次于 Mega-ASR 的 2.63%。

这说明阶段 1 的退化训练具有明显效果,但 AmphionASR 并非在所有条件下都领先,例如真实噪声、远场、电子失真以及部分模拟条件仍有其他专用模型表现更好。

4. 耳语识别

耳语识别是论文中最稳定的优势之一。AmphionASR 在中文 wEar 上取得 0.58% CER,在英文 WTIMIT 上取得 6.11% WER,均为表中最低。

模型wEar 中文 CERWTIMIT 英文 WER
Whisper-large-v316.33%11.99%
Kimi-Audio-7B-Instruct1.48%10.95%
Qwen3-ASR-1.7B1.22%9.56%
FireRed-ASR2-LLM1.01%15.18%
AmphionASR0.58%6.11%
论文 Table 15 的主要模型结果。

相比基础模型 Qwen3-ASR-1.7B,AmphionASR 在中文耳语上绝对降低 0.64 个百分点,在英文耳语上绝对降低 3.45 个百分点。模型同时在中英文上领先,说明耳语训练没有出现明显的语言间取舍。

5. 通用 ASR 能力是否被遗忘

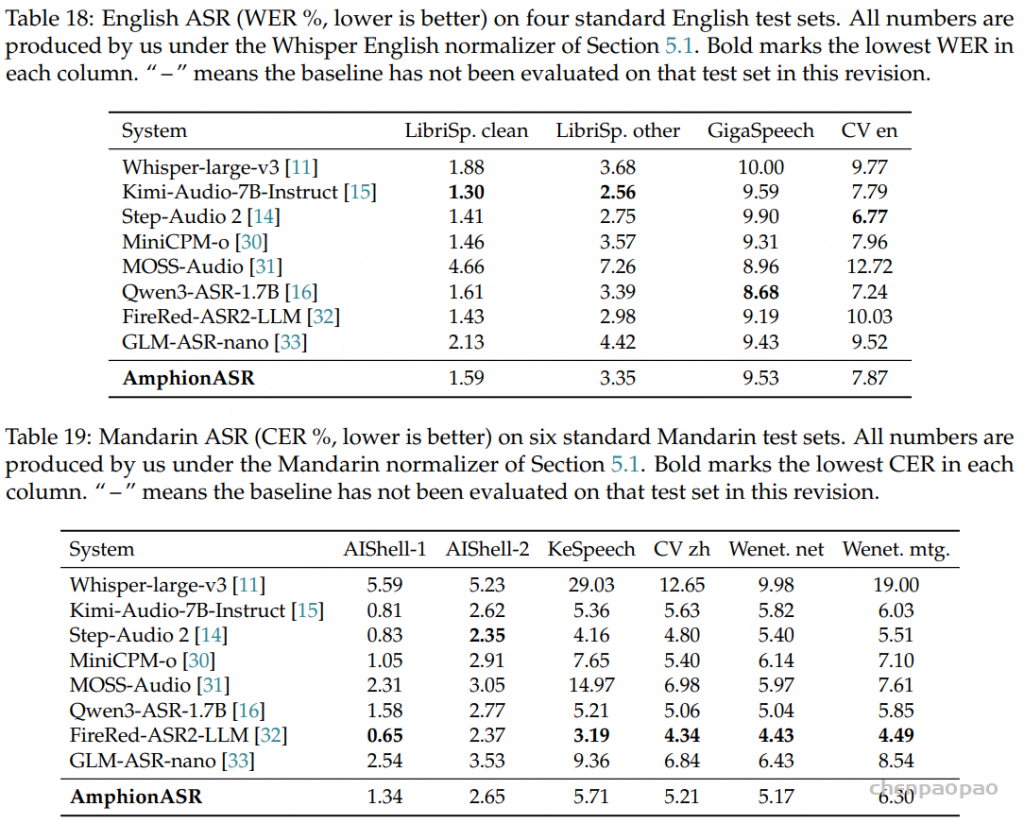
论文在 4 个英文和 6 个中文通用测试集上进行了保持性检查。与同规模的 Qwen3-ASR-1.7B 相比,AmphionASR 在每个测试集上的差距都不超过 0.85 个绝对 WER/CER 点,并在两者直接比较时赢下 10 个测试集中的 4 个。

需要区分的是:这不代表 AmphionASR 在 4 个数据集上取得所有系统中的最好结果。Table 18 和 Table 19 的整体领先者仍分散在 Kimi-Audio、Step-Audio、FireRed-ASR2 等模型中。论文将该实验定位为“能力保持检查”,而不是通用 ASR 的 SOTA 声明,这是较为客观的表述。

七、论文的主要创新点

  1. 用统一接口承载多种条件化 ASR。文本指令、热词和注册语音都被组织为 LLM 上下文,使不同任务共享音频编码器和解码器。
  2. 将帧级热词检索接入完整 SpeechLLM。局部 max-over-time 匹配比整句池化更适合发现短时出现的实体,并把万级候选库压缩到 Top-50。
  3. 通过双音频输入实现目标说话人选择。注册音频和混合音频共用声学编码器,不需要额外构建完全独立的 TS-ASR 网络。
  4. 系统化构造目标缺席负样本。噪声、静音和纯干扰说话人样本教会模型在找不到目标时保持沉默,从而降低幻觉。
  5. 分阶段训练兼顾专项能力与基础能力。先适应声学变化,再学习条件控制,最后回放通用数据,训练顺序与不同模块的职责相匹配。

需要注意,论文明确指出 GLCLAP Top-K 检索、提示词注入和 GRPO 的组合已有相关工作。AmphionASR 的贡献重点不是提出一种全新的检索或强化学习算法,而是把这些方法集成到统一模型中,并覆盖更多条件化识别任务。

八、局限性与值得继续验证的问题

  • 语言范围有限:当前核心评测只覆盖普通话和英语,尚不能证明统一训练方法对越南语等语言同样有效。
  • 热词对比并非完全同输入:多数基线没有收到热词,因而结果证明的是完整“检索加上下文提示”流水线价值,而不是公平条件下检索器单模块的增益。
  • GRPO 缺少独立消融:没有 SFT-only 对照,无法知道最终提升中有多少来自 GRPO。
  • 目标说话人测试仍偏内部合成:需要在公开真实会议、重叠说话和跨设备数据上验证。
  • 延迟测试规模较小:共享 GPU、每种语言 30 条请求、无并发、无 RTF,不能据此推断生产服务容量。
  • 统一模型并非所有任务都最优:它的优势是能力覆盖和共享部署,而不是在每个通用或退化子集上都击败专用模型。

九、总结

AmphionASR 最有价值的地方,是把 ASR 从“无条件转写器”推进成“可被用户条件控制的语音识别模型”。热词告诉模型哪些词值得重点关注,注册语音告诉模型应该听谁,任务指令告诉模型输入属于耳语还是普通语音,而退化数据让模型适应真实采集环境。

从实验结果看,热词和耳语是目前证据最充分的两项能力:前者在万级候选词库下显著降低实体错误,后者在中英文测试集上同时取得最好结果。目标说话人和退化鲁棒性同样表现出潜力,但还需要更严格的公开测试和生产级吞吐评估。

对于实际 ASR 系统,这篇论文给出的启发并不是必须把所有任务都塞进一个模型,而是可以建立一套共享的语音表示和解码骨干,再通过文本上下文、参考音频与检索结果描述用户意图。这样既能减少多模型维护成本,也让个性化语音识别拥有更统一的产品接口。


G-STAR: 端到端全局说话人追踪属性识别

paper: https://arxiv.org/pdf/2603.10468

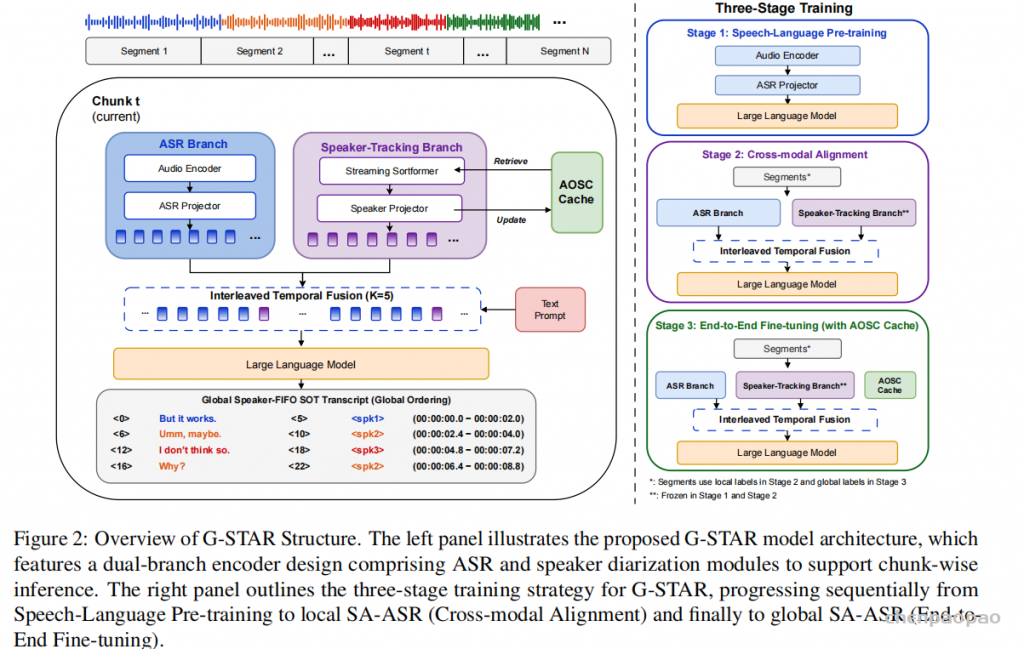
G-STAR是一个LLM-based端到端多说话人ASR系统:1)Sortformer风格流式说话人追踪模块 + 到达顺序说话人缓存(AOSC);2)Speech-LLM转录主干(Qwen2-7B-Instruct + LoRA);3)交错时序融合(K:1插入)结合声学和说话人嵌入;4)缓存一致的SOT解码。三阶段训练:会议式ASR预训练→局部SA-ASR训练→全局SA-ASR训练。

💡 为什么值得关注

     LLM-based ASR近两年进展比较显著,但在多说话人ASR场景,依然需要持续持续探索。G-STAR解决了局部说话人日志与全局身份一致性难以兼顾的问题,将“时间感知的说话人跟踪”与“基于LLM的转录生成”耦合在一个可端到端训练的框架中,从而在“何时”、“何人”、“说了什么”这三个维度的信息上实现协同。此外,G-STAR支持分块流式推理且无需用户提前进行语音注册。对做会议转录、语音助手的团队有直接参考价值。

多方会议转写不只是“把语音变成文字”。系统还需要判断每句话是谁说的、发生在什么时间,并且在长音频被切成多个片段处理时,让同一个人的说话人编号始终保持一致。G-STAR 的主要贡献,就是把带缓存的全局说话人跟踪器与 Speech-LLM 生成模型连接起来,让文字、时间戳和全局说话人标签在同一条件上下文中联合生成。

一、论文要解决什么问题

给定长音频波形,模型需要输出一组带说话人和时间边界的文本片段:

\( Y=\left\{\left(s_n,\tau_n^{\mathrm{st}},\tau_n^{\mathrm{ed}},y_n\right)\right\}_{n=1}^{N} \)

其中,\(s_n\) 是说话人身份,\(\tau_n^{\mathrm{st}}\) 和 \(\tau_n^{\mathrm{ed}}\) 是起止时间,\(y_n\) 是对应文本。真正困难的地方在于:长会议通常必须分块推理,但说话人身份不能在每个块中重新编号。例如第一块中的 spk1,到了第十块仍然应该指向同一个真实说话人。

此前方法通常只解决其中一部分问题:SpeakerLM 更擅长块内说话人建模,但缺少显式的跨块全局身份关联;JEDIS-LLM 使用说话人缓存维持全局标签,却没有细粒度时间边界;TagSpeech 强化了时间锚点和说话人提示,但没有解决长音频分块推理中的会议级身份链接。G-STAR 的目标是同时覆盖时间戳、重叠语音、说话人归属和跨块全局一致性。

二、G-STAR 的总体设计

G-STAR 由三部分组成:ASR 声学分支、说话人跟踪分支,以及维护全局身份的 Arrival-Order Speaker Cache(AOSC)。两条分支生成的特征按照时间顺序交错融合,随后送入大语言模型,以 Serialized Output Training(SOT)格式输出文字、时间戳和全局说话人标签。

1. 分块处理与全局输出格式

长音频 \(x\) 被划分为连续的 \(T\) 个块:

\( x=\left\{x^{(t)}\right\}_{t=1}^{T} \)

每个块生成一个序列化结果,结构可以表示为:

\( z^{(t)}=\left[\langle t_{\mathrm{st}}\rangle,\;w,\;\langle t_{\mathrm{ed}}\rangle,\;\langle \mathrm{spk}=k\rangle\right]^{*} \)

这里的 \(k\) 不是当前块内的临时编号,而是由 AOSC 维护的会议级到达顺序编号。

2. ASR 声学分支

音频编码器首先把第 \(t\) 个音频块转换为帧级声学特征:

\( H^{(t)}=f_{\mathrm{enc}}\left(x^{(t)}\right)\in\mathbb{R}^{L_t\times d_h} \)

随后 ASR projector 将其映射到 LLM 的嵌入空间:

\( U^{(t)}=g_1\left(H^{(t)}\right)\in\mathbb{R}^{L_t\times d_{\mathrm{llm}}} \)

实现中,音频编码器和投影器初始化自 FireRed-LLM,语言模型使用 Qwen2-7B-Instruct,并继承 FireRed-LLM 的 LoRA 权重。

3. 说话人跟踪分支与 AOSC

说话人分支采用 Streaming Sortformer。它不只读取当前音频,还读取上一块保留下来的缓存:

\( S^{(t)},C^{(t)}=f_{\mathrm{trk}}\left(x^{(t)},C^{(t-1)}\right),\qquad S^{(t)}\in\mathbb{R}^{M_t\times d_s} \)

其中 \(C^{(t-1)}\) 是历史 AOSC 状态,\(S^{(t)}\) 是当前块的帧同步说话人提示。实现中,该分支初始化自 NVIDIA 的 diar_streaming_sortformer_4spk-v2;说话人 projector 由步长为 5 的一维卷积降采样模块和两层 MLP 组成,再把提示映射到 LLM 空间:

\( V^{(t)}=g_2\left(S^{(t)}\right)\in\mathbb{R}^{M_t\times d_{\mathrm{llm}}} \)

AOSC 按说话人在会议中首次出现的顺序保存紧凑状态。新说话人出现时分配下一个槽位;历史说话人再次出现时,系统从缓存中找回原槽位。因此,全局编号具有可解释性,也避免了不同音频块之间的标签置换漂移。

4. 交错时间融合

论文没有在最后阶段才把 ASR 与说话人时间轴做“后融合”,而是把说话人特征直接插入声学 token 流。设插入步长为 \(K\),融合结果为:

\( E^{(t)}=\operatorname{Interleave}\left(U^{(t)},V^{(t)};K\right)\in\mathbb{R}^{N_t\times d_{\mathrm{llm}}} \) \( N_t\approx L_t+\left\lceil\frac{L_t}{K}\right\rceil \)

具体来说,每经过 \(K\) 个声学位置就插入一次说话人提示。如果两条分支的帧率不同,则使用确定性的最近邻或线性重采样对齐。论文默认重点验证 \(K=5\),即在信息密度和对词汇建模的干扰之间取折中。

5. 全局 SOT 解码

LLM 在文本提示、融合后的声学/说话人表示以及已生成 token 的条件下进行自回归解码:

\( p\left(z^{(t)}\mid x^{(t)},C^{(t-1)}\right)=\prod_{m=1}^{\left|z^{(t)}\right|}p\left(z_m^{(t)}\mid p,E^{(t)},z_{<m}^{(t)}\right) \)

由于 <spk=k> 与 AOSC 中第 \(k\) 个到达顺序槽位绑定,模型可以在逐块解码时直接生成全局一致的说话人标签,不再依赖会后全局聚类。

三、三阶段训练策略

  1. 会议风格 ASR 预训练:让音频编码器、ASR projector 和 LLM 适应对话及会议语音。
  2. 局部 SA-ASR 跨模态对齐:在最长 20 秒的分段语音上学习时间戳、文本和块内说话人标签。Figure 2 显示说话人跟踪模块在前两个阶段冻结。
  3. 全局 SA-ASR 端到端微调:引入 AOSC 和全局标签,训练跨块一致的说话人归属。同时使用四个数据集构造的 90 秒片段独立调优 Sortformer,以增强长音频跟踪能力。

Speech-LLM 各阶段保持可训练模块一致:ASR projector、说话人 projector 和 LoRA adapter。LoRA rank 为 64,缩放因子为 16,dropout 为 0.05。训练样本最大打包长度为 12,000 tokens。

前两个阶段分别训练 20,000 steps,峰值学习率为 \(5\times10^{-5}\);全局阶段训练 5,000 steps,峰值学习率降为 \(2\times10^{-5}\)。均使用 AdamW、0.01 warmup ratio 和余弦退火。Sortformer 调优采用学习率 \(10^{-4}\)、batch size 4,共训练 5 epochs。

为了让模型更加重视结构 token,论文使用分层交叉熵:时间戳 token 权重为 1.5,说话人标签 token 权重为 2。可将其直观写成:

\( \mathcal{L}=\mathcal{L}_{\mathrm{lexical}}+1.5\,\mathcal{L}_{\mathrm{timestamp}}+2\,\mathcal{L}_{\mathrm{speaker}} \)

四、数据集与评价协议

公开实验使用四个会议或对话数据集:MLC 英文子集、AMI、Fisher,以及只使用音频模态的 Candor。训练音频被切分为最长 20 秒的片段。内部模型还使用中文对话数据;公开配置则使用 AISHELL-4 和 AliMeeting 等公开会议数据作为对应数据来源。

  • 局部设置:输入不超过 20 秒,使用 oracle VAD/分段,重点考察后端的联合转写和说话人归属能力。
  • 全局设置:输入完整会议,各系统使用自己的 VAD 或分段前端并逐块推理,更接近真实部署,但 VAD 差异也会进入最终结果。
  • 指标:cpWER 衡量考虑说话人匹配后的转写错误,DER 衡量说话人日志错误;两者都是越低越好。
  • DER collar:公开实验为 0,内部测试集为 0.5 秒。模型幻觉产生的额外片段会被计入 cpWER 和 DER 错误。

论文还实现了一个受控后融合基线:ASR 使用同一 Speech-LLM 后端,VAD 切出语音段,CTC 强制对齐补充词级时间戳,Sortformer 生成全局说话人时间轴,最后再按时间重叠关系合并。这个对照可以较好地区分“组件更强”和“跟踪条件直接参与生成”之间的差异。

五、局部实验结果

表 1 对应论文 Table 1,单位为 cpWER/DER(%),输入最长 20 秒,oracle VAD,DER collar=0。

系统AMIFisherMLCCandor
Sortformer(仅 DER)— / 29.87— / 18.33— / 17.76— / 30.92
Parakeet(仅 cpWER)24.62 / —27.73 / —25.90 / —27.44 / —
VibeVoice-ASR30.51 / 31.9915.18 / 17.6821.74 / 14.0122.12 / 30.89
MOSS-Diarizen25.13 / 32.2011.69 / 21.6114.16 / 10.5816.38 / 31.76
G-STAR24.86 / 19.0010.29 / 8.1813.90 / 6.4914.54 / 17.56

G-STAR 在四个数据集上都显著降低了 DER,并且在 Fisher、MLC 和 Candor 上获得最低 cpWER。AMI 的 cpWER 为 24.86,与 Parakeet 的 24.62 基本相当,但 DER 从 Sortformer 的 29.87 降到 19.00。结果说明,说话人提示被注入 LLM 后,并没有以牺牲词汇识别为代价,反而提升了联合生成的稳定性。

六、完整会议的全局实验

表 2 对应论文 Table 2,单位为 cpWER/DER(%),完整会议逐块推理,DER collar=0。

系统FisherMLCCandorAMI
Sortformer(仅 DER)— / 15.21— / 21.92— / 18.03— / 28.35
Parakeet(仅 cpWER)24.41 / —31.03 / —26.92 / —35.70 / —
VibeVoice-ASR25.03 / 27.1525.41 / 19.8327.24 / 25.6834.19 / 39.95
受控后融合级联21.01 / 23.4123.18 / 21.3817.62 / 17.6739.52 / 37.63
G-STAR16.44 / 16.8517.15 / 14.2515.17 / 24.8930.85 / 32.23

G-STAR 在 Fisher、MLC、Candor 和 AMI 上都取得最低的会议级 cpWER。相对使用相近主干组件的受控后融合方案,cpWER 分别从 21.01、23.18、17.62、39.52 降至 16.44、17.15、15.17、30.85,相对降幅约为 21.8%、26.0%、13.9% 和 21.9%。这说明改进并不只是来自更强的 ASR 或说话人模块,而是因为说话人跟踪信息在生成过程中直接参与了决策。

不过,DER 结果需要客观看待:G-STAR 在 MLC 上最好,但 Fisher 的 Sortformer、Candor 的受控后融合方案以及 AMI 的 Sortformer 都得到更低 DER。换言之,G-STAR 的优势重点是最终的“谁说了什么”联合转写,而不是在所有场景中取代专门的说话人日志系统。

内部域外会议测试

内部测试集包含 0.50 小时双人会议、0.49 小时三人会议和 1.86 小时四人会议。论文将三至四人场景合并报告,DER collar 为 0.5 秒。

系统2 人3–4 人平均
VibeVoice-ASR11.10 / 14.8354.48 / 38.3347.64 / 34.62
聚类式 Pipeline23.56 / 14.2041.14 / 30.7638.37 / 28.15
G-STAR10.42 / 4.8638.85 / 28.5934.37 / 24.88

G-STAR 的平均 cpWER/DER 为 34.37/24.88,优于 VibeVoice-ASR 的 47.64/34.62,也优于聚类式 Pipeline 的 38.37/28.15。双人场景提升最明显,DER 只有 4.86;三至四人会议仍然明显更难,说明说话人数增加后,全局跟踪和重叠语音依旧是主要挑战。

七、消融实验说明了什么

表 3 对应论文 Table 4,单位为 cpWER/DER(%)。

分层 CE交错时间融合AMIFisherCandor
否是26.33 / 21.0610.88 / 10.2414.97 / 20.21
是否28.63 / 21.2814.23 / 9.0218.30 / 18.10
是是24.86 / 19.0010.29 / 8.1814.54 / 17.56

两项设计的作用并不相同。交错时间融合对 cpWER 的帮助更大,说明周期性注入说话人提示能够协助 LLM 同时生成正确文字和结构 token;分层交叉熵对 DER 的改善更直接,因为更高的时间戳与说话人 token 权重会强化边界和说话人切换预测。两者同时启用时,三个数据集都得到最佳综合结果。

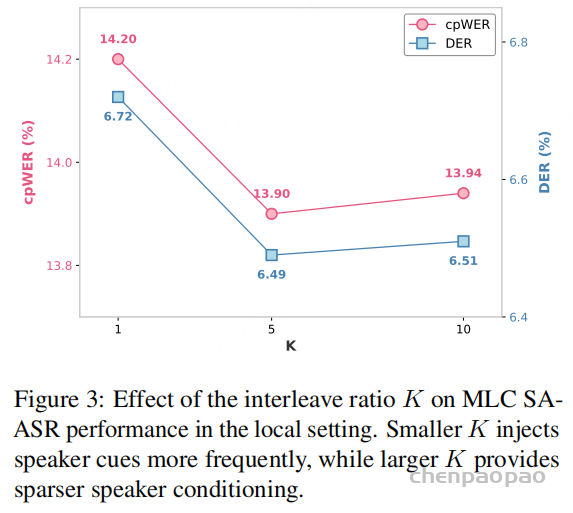
Figure 3 进一步比较了 MLC 上不同插入步长:

插入步长 KcpWERDER
114.206.72
513.906.49
1013.946.51

\(K=1\) 时提示过密,非词汇条件可能干扰语言建模;\(K=10\) 时提示偏稀疏;\(K=5\) 在 cpWER 和 DER 上取得最优平衡。

八、论文的主要创新点

  1. 把说话人归属从后处理变成生成条件。说话人时间信息在 LLM 解码前进入统一嵌入序列,而不是 ASR 完成后再做时间轴拼接。
  2. 用 AOSC 解决跨块身份漂移。按首次到达顺序维护说话人槽位,使长会议中的全局标签具备持续状态和可解释编号。
  3. 统一生成文字、时间戳和全局说话人标签。SOT 输出接口让多个结构化目标被组织为单一自回归序列,同时保留重叠语音片段。
  4. 兼顾模块化训练和端到端优化。说话人跟踪器可以独立调优,Speech-LLM 又能在其提示条件下联合优化,适合训练数据来源不一致或存在域偏移的情况。
  5. 建立局部与全局两套评价协议。oracle 分段实验隔离后端能力,完整会议实验则验证 VAD、跟踪、时间戳和转写共同作用下的真实表现。

九、局限性

第一,论文采用分块推理,但没有完整评估严格实时流式部署,尚缺少端到端延迟、缓存内存开销和在线缓存更新稳定性数据。第二,训练数据规模和多样性仍然有限,跨语言、复杂声学环境、更多说话人以及更强重叠场景的泛化能力还有提升空间。第三,从公开实验可以看到,模型对最终 cpWER 的优化非常稳定,但纯 DER 并非全面领先;如果应用只关注高精度说话人日志,专门的 diarization 系统仍可能更合适。

十、总结

G-STAR 最值得关注的不是简单增加一个说话人编码器,而是重新定义了说话人归属在 Speech-LLM 中的位置:它不再是 ASR 后面的拼接步骤,而是影响生成过程的显式条件。AOSC 负责记住“谁已经出现过”,交错时间融合负责在合适的时间点把信息交给 LLM,全局 SOT 则把文字、时间戳和身份转换为可直接阅读的统一序列。

实验表明,这一路线尤其适合长会议的“谁说了什么”任务:G-STAR 在四个完整会议基准上都获得最低 cpWER,并在内部域外数据上继续保持优势。其下一步关键问题,是把这种缓存条件生成机制推进到低延迟、严格在线的真实流式系统中。


ASR语音识别-MOE架构论文

MOE- Conformer :

MoE Adapter: https://arxiv.org/pdf/2601.02967

论文:Mixture-of-Expert Conformer for Streaming Multilingual ASR

这篇论文 Mixture-of-Expert Conformer for Streaming Multilingual ASR 讨论的是一个更偏工业部署的问题:如何让一个流式端到端 ASR 模型同时支持多种语言,又不把推理成本推到端侧设备难以承受的程度。作者选择的路线是把 Mixture-of-Experts 放进 Conformer,把模型总容量做大,但每次推理只激活一小部分参数。

摘要:容量变大,激活参数不线性变大

论文提出的模型是在流式多语种 Conformer 中加入 MoE 层。MoE 层由多个 FFN 专家和一个 softmax gate 组成,每个输入帧只选择权重最高的两个专家参与计算。这样,专家总数可以增加,模型总容量也可以增加,但推理时激活的专家数固定,因此计算和激活参数不会随专家数量线性增长。

论文中的 gate 先对第 l 层输入 x 做线性映射,再通过 softmax 得到专家权重:

\( g_l=\mathrm{Softmax}(W_l\cdot x) \)

随后只取 top-2 expert,并把两个 expert 的输出按 gate 权重加权求和:

\( y=\sum_{i=1}^{2}g_{l,i}\cdot e_{l,i} \)

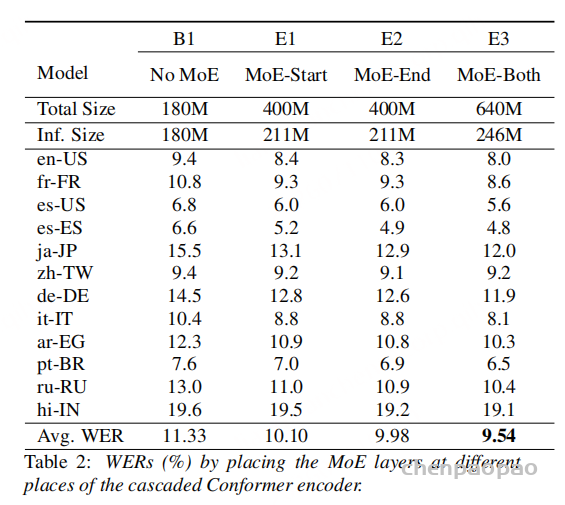
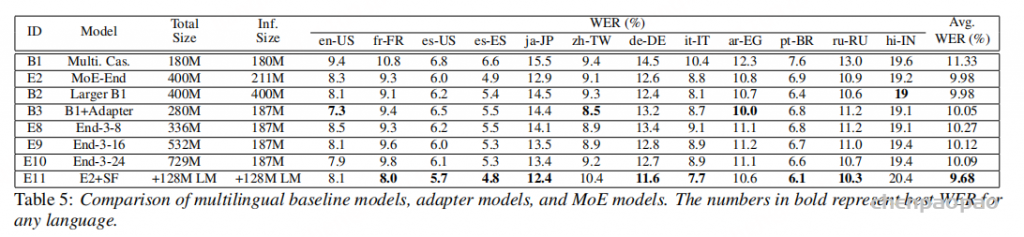
实验覆盖 12 个语言 locale。相对于 180M 参数的多语种 cascaded Conformer baseline,MoE-End 模型把平均 WER 从 11.33 降到 9.98,约 11.9% 相对改善。与同等总规模的 dense baseline 相比,MoE 达到类似 WER,但推理激活参数约为 211M,对比 dense 的 400M 更省。再结合多语种 neural LM 做 shallow fusion,平均 WER 还能进一步相对降低约 3%。

引言:多语种统一模型的容量问题

多语种端到端 ASR 的吸引力很直接:用一个模型识别多种语言,降低维护和部署复杂度。过去几年,CTC、LSTM、attention-based 模型以及流式 RNN-T 都在多语种 ASR 上取得了进展。尤其是端侧流式场景,模型既要有识别质量,又要满足低延迟和低计算。

经验上,模型容量越大,多语种 ASR 越容易受益。Whisper、USM 等大型模型也说明了大数据和大模型对语音识别质量的推动作用。但大模型的代价是训练和推理成本。对端侧应用来说,不能简单把模型扩大到数十亿参数。

已有一些效率方案依赖语言相关组件,比如按语言选择 adapter 或二阶段模型。但流式场景里,稳定预测语言信息本身就不容易,还可能引入错误传播。本文的 MoE 路线更直接:由输入表示动态选择专家,不需要显式语言标签,也不需要 ground-truth language information。

相关工作:专家模型与语言信息

论文把自己的方法放在几类工作之间比较。第一类是 ASR 中已有的 MoE 模型,但许多工作偏单语种,或者需要额外的共享 embedding 网络来做专家路由。第二类是 NLP 和视觉中的 MoE,比如 Switch Transformer 或 DeepMoE,不过这些结构在 ASR 尤其是流式多语种 ASR 中的直接效果并不确定。

第三类是 informed-expert:模型根据已知语言信息选择某个语言专家、adapter 或二阶段模块。这种做法在有可靠语言标签时很自然,但部署中会遇到两个麻烦:语言信息要么来自外部,要么需要模型先预测;一旦预测错了,后面的专家选择也会受影响。本文的 MoE 不显式使用语言信息,routing 由模型从声学表示中学出来。

MoE Conformer:把专家放在 FFN 位置

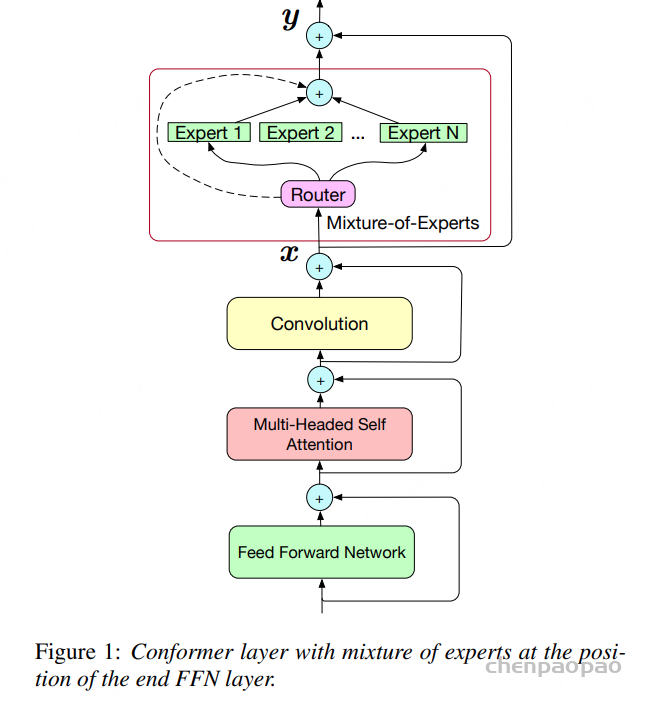
基础模块是 Conformer。一个 Conformer layer 通常包含两个 FFN、中间的 self-attention 和 convolution。作者把 MoE 主要用于替换 Conformer 里的 FFN,尤其是 end FFN。每个 MoE 层包含多个 FFN 专家和一个 router。

对每一帧表示,router 通过 softmax 计算各专家权重,然后选出 top-2 专家。两个专家的输出按路由权重加权求和,得到该 MoE 层输出。训练和推理都使用 top-2。为了防止专家使用不均衡,论文加入辅助负载均衡损失,让不同专家都有机会被训练到。

这个设计的关键是稀疏激活。比如总共有 8 个、16 个或 24 个专家时,每帧仍只走两个专家。总参数代表模型潜在容量,激活参数代表推理成本;MoE 的优势就在于让这两者不再完全绑定。

实验设置

模型训练使用 RNN-T loss,并额外加入专家负载均衡项。论文中的 auxiliary loss 写成:

\( l_{\mathrm{aux}}=\frac{1}{N}\sum_{i=1}^{N}c_i\cdot m_i \)

其中 m_i 是第 i 个 expert 的平均 gate,c_i 是 top-2 路由中该 expert 被选择的计数。

数据

实验使用 12 个语言 locale:美式英语、中文、法语、德语、日语、美式西班牙语、西班牙西班牙语、阿拉伯语、意大利语、印地语、葡萄牙语和俄语。训练数据来自 Voice Search、YouTube 等多个域,总计约 139.4M 条人工转写匿名语音。不同语言数据量差异很大,从 0.5M 到 25.2M utterances 不等。

测试集来自 Voice Search 流量,每个语言大约 1.4K 到 10K 条 utterances,与训练集不重叠。评价指标是 WER;对中文等语言,论文按字符计算错误率。

模型细节

baseline 是一个语言无关的多语种 transducer 模型,包含 7 层 causal Conformer encoder 和 10 层 non-causal cascaded encoder。causal 部分保证流式,non-causal cascaded 部分提供约 0.9 秒右上下文。模型使用 separate decoders 分别服务 causal 和 non-causal encoder,以获得更好质量。baseline 总参数约 180M。

MoE 改造主要发生在 cascaded encoder。作者尝试替换 start FFN、end FFN 或两者都替换。最多使用 24 个专家,但每次训练和推理只选 top-2。输入特征为 128 维 log-Mel filterbank,经连续帧堆叠形成 512 维输入,并下采样到 30ms 帧率;训练中使用 SpecAug 增强鲁棒性。

结果与比较

消融实验

首先看 MoE 放在哪里。baseline 平均 WER 为 11.33。把 MoE 放在 start FFN,平均 WER 为 10.10;放在 end FFN,平均 WER 为 9.98;两处都放,平均 WER 最好,为 9.54。不过两处都放会增加推理激活参数。作者最终更多采用 MoE-End,因为它在质量和效率之间更均衡。

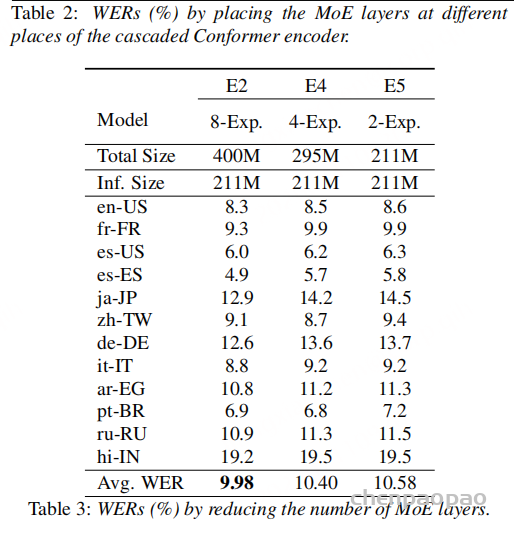
专家数量方面,8 experts 的 MoE-End 平均 WER 为 9.98;减少到 4 experts 后为 10.40;减少到 2 experts 后为 10.58。由于推理始终激活 top-2,专家总数减少主要影响总容量而不是激活参数。结果说明,额外专家确实被模型利用了。

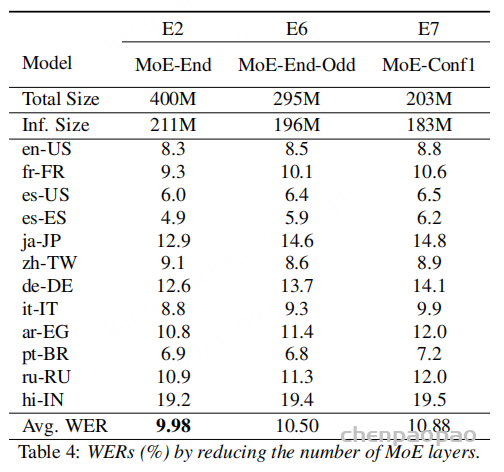
MoE 层数也很重要。只在隔层使用 MoE,平均 WER 退到 10.50;只在第一个 Conformer 层使用 MoE,为 10.88。即便只加一个 MoE 层也比 baseline 好,但完整地在 end FFN 位置加入 MoE 才能发挥主要效果。

与 dense baseline 和 adapter 比较

与 180M baseline 相比,MoE-End 模型总参数约 400M,推理激活约 211M,平均 WER 从 11.33 降到 9.98。为了排除“只是模型变大”的因素,作者构造了一个同为 400M 的大 dense baseline。这个 dense 模型平均 WER 也是 9.98,但推理需要激活 400M 参数;MoE 只激活 211M,约为 dense 的 53%。

与基于 ground-truth language information 的 adapter 模型相比,MoE 的意义更明显。Adapter 模型依赖真实语言信息选择对应模块;MoE 不需要语言标签,只根据输入动态路由。把 FFN multiplier 调小并增加专家数后,16 或 24 experts 的 MoE 在平均 WER 上接近 adapter,但部署上少了语言信息依赖。

Shallow Fusion 进一步提升

作者还训练了一个 128M 左右的多语种 neural LM,并在解码时做 shallow fusion。文本数据来自 12 种语言的监督训练文本和额外 text-only 数据。加入 LM 后,MoE 模型平均 WER 从 9.98 进一步降到 9.68,约 3% 相对改善。

不过改善并非所有语言都一致。法语收益最大,中文和印地语出现退化。作者推测,中文退化可能与 text-only 数据里混入粤语转写有关;印地语则可能因为 text-only 数据规模很大但与 Search 域不完全匹配,需要更好的过滤策略。

结论:MoE 的部署价值在于“不需要语言标签”

这篇论文展示了 MoE 在流式多语种 ASR 中的一个清晰用途:用更大的总容量提升多语种识别质量,同时通过 top-2 稀疏激活控制推理成本。最重要的是,模型不依赖语言标签完成专家选择,这比 adapter 或 per-language expert 在真实部署中更省心。

从结果看,MoE-End 相对于 baseline 有 11.9% 平均相对 WER 改善;与同规模 dense 模型相比,达到类似质量但只激活约 53% 参数;与语言标签 adapter 相比,质量接近但路由更自动。对端侧、流式、多语种这三个约束同时存在的场景,这种“动态容量”思路很值得继续跟进。

快手论文:Parameter-Efficient Conformers,利用MOE进行模型裁剪

这篇论文 Parameter-Efficient Conformers via Sharing Sparsely-Gated Experts for End-to-End Speech Recognition 关注一个非常实际的问题:Conformer 在端到端语音识别里效果很好,但模型层数和参数量上来之后,训练、部署、端侧运行都会变重。作者的思路不是简单砍层,也不是只做普通的参数共享,而是把“共享 Conformer 块”和“稀疏门控专家”结合起来,让少量参数被重复使用,同时用 MoE 保住表示容量。

摘要:少参数,不想少能力

论文的核心目标是构造一个参数高效的 Conformer 编码器。传统跨层权重共享可以减少参数,但也会压缩模型容量,导致识别性能下降。作者提出的方案是在共享的 Conformer 块中加入 sparsely-gated MoE:第二个前馈网络不再是单一路径,而是一组专家,由路由器选择其中一个专家参与计算。这样总参数增加了一些,但每次前向只激活一个专家,计算量基本保持在非 MoE 模型的水平。

为了让共享块在不同深度位置仍能适配不同层级的表示,论文还让路由器和归一化层保持独立,而不是所有内容都共享。最后,作者用全参数模型作为 teacher,通过隐藏层表示的知识蒸馏进一步弥补共享模型的能力损失。实验显示,在 AISHELL-1 上,最终模型用约三分之一的编码器参数取得了接近全参数模型的 CER。

引言:Conformer 很强,但部署不轻

端到端 ASR 中,Transformer 和 Conformer 已经是很常见的编码器选择。Conformer 在 Transformer 的全局建模基础上加入卷积模块,更适合语音这种既有长程依赖、又有局部结构的序列。相对位置编码、Macaron 风格 FFN、卷积增强等设计,都让它在语音识别中表现稳定。

问题在于,这类模型往往参数冗余。直接堆很多层可以换来更强表达,但也带来显存、存储和推理成本。已有工作会通过跨层共享参数降低模型规模,类似让同一个 block 被重复调用多次。这个办法省参数,但副作用也明显:自由参数少了,模型容量下降,性能容易掉。

作者的切入点是:既然共享会损失容量,那就在共享块内部引入 MoE 来补容量;既然 MoE 可以稀疏激活,那就只让少数专家参与一次前向,避免计算量跟着总参数线性增长。这个组合特别适合“参数少、计算不能太贵”的场景。

背景:Conformer Seq2Seq ASR

论文使用的是 attention-based encoder-decoder 框架。编码器把声学特征序列变成高层表示,解码器按 token 逐步生成文本序列,训练时优化负对数似然,推理时用 beam search 找更可能的输出。

论文中先把 AED 的逐 token 预测概率写成下面这个形式,其中 y<s 表示当前位置之前的 token 前缀:

\( P(y_s \mid y_{<s}, x)=\mathrm{Trfm}(y_{<s},x) \)

对应的最大似然训练目标,也就是负对数似然损失为:

\( L_{\mathrm{nll}}(\theta)=-\frac{1}{S}\sum_{s=1}^{S}\log P(y_s\mid y_{<s},x) \)

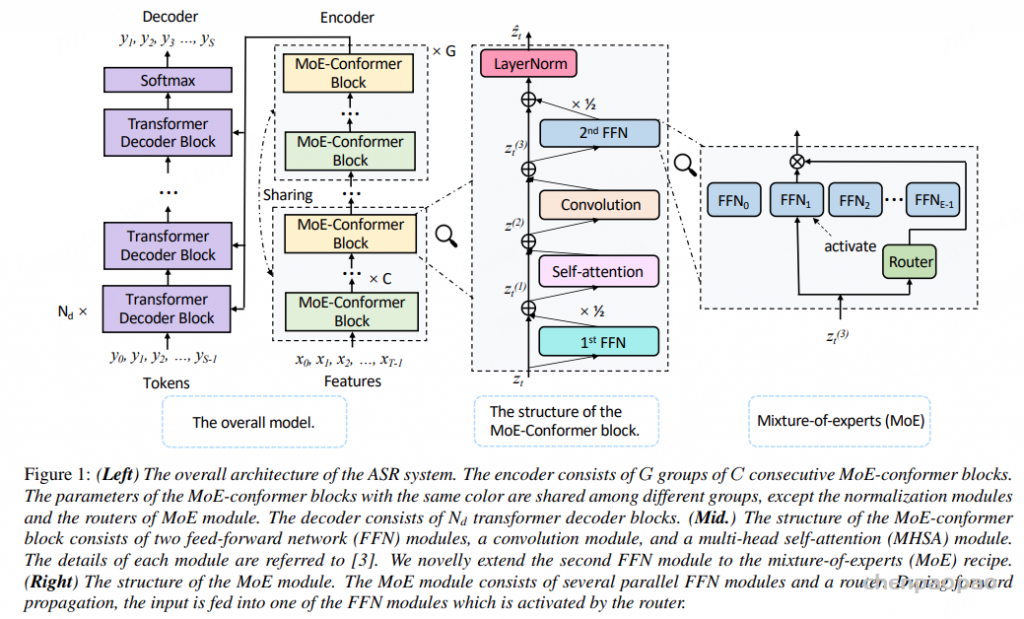
Conformer 块由两个 FFN、一个多头自注意力模块和一个卷积模块组成。两个 FFN 采用半步残差风格,注意力负责长程依赖,卷积负责局部模式。本文的 MoE 改造发生在第二个 FFN:作者把它替换成一个稀疏门控的专家集合,也就是 MoE-Conformer block。

论文把一个 MoE-Conformer block 的计算写成四步。最后一步中,第二个 FFN 被替换成 MoE 版本:

\( \begin{aligned} z_t^{(1)} &= z_t + \frac{1}{2}\mathrm{FFN}(z_t),\\ z_t^{(2)} &= z_t^{(1)} + \mathrm{MHSA}(z_t^{(1)}),\\ z_t^{(3)} &= z_t^{(2)} + \mathrm{Conv}(z_t^{(2)}),\\ \hat{z}_t &= \mathrm{LayerNorm}\left(z_t^{(3)}+\frac{1}{2}\mathrm{FFN}^{(\mathrm{MoE})}(z_t^{(3)})\right). \end{aligned} \)

方法:共享稀疏门控专家

Conformer 参数共享

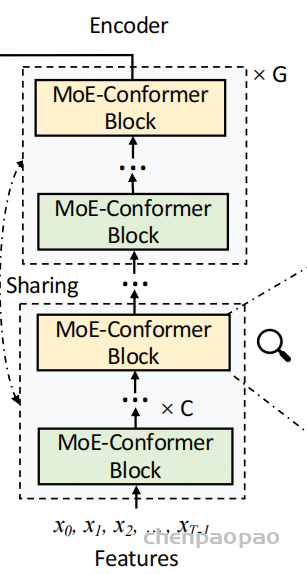
作者把连续的 C 个 Conformer 块看作一组,再堆叠 G 组。不同组中相同位置的块共享参数,相当于一组块被递归调用 G 次。这样做的好处很直接:如果想要 12 次变换,不一定真的保存 12 套编码器参数,可以用更少的块反复计算。

但是共享不是白来的。共享块在浅层和深层面对的表示分布不一样,如果完全用同一套参数、同一套路由、同一套归一化统计,模型会很难同时适配不同深度的表示。因此后面两个设计,也就是独立路由器和独立归一化,就变得很关键。

MoE 动态路由

MoE 模块由 E 个并行 FFN 专家和一个 router 组成。对每个时间步的表示,router 输出各专家的概率,论文采用 top-1 选择,只激活得分最高的专家。也就是说,虽然模型里存着多个专家参数,但每次计算只走其中一个 FFN。

top-1 MoE 的路由过程如下。router 先产生各 expert 的 gate 分数,再选择最大分数对应的 expert:

\( \begin{aligned} g &= [g_0,\cdots,g_{E-1}]=\mathrm{softmax}(\mathrm{router}(z_t^{(3)})),\\ i^* &= \arg\max_{0\le i\le E-1} g_i,\\ \mathrm{FFN}^{(\mathrm{MoE})}(z_t^{(3)}) &= g_{i^*}\mathrm{FFN}_{i^*}(z_t^{(3)}). \end{aligned} \)

这个设计把“容量”和“计算”部分解耦:总参数更多,潜在表达空间更大;但激活参数不增加太多,推理计算仍接近普通 FFN。为了避免所有样本都挤向同一个专家,作者加入 load balancing loss,同时在训练时给 router 加高斯噪声,让专家选择更分散。

负载均衡损失用于鼓励 expert 被更均匀地使用:

\( L_{\mathrm{balance}}=E\sum_{i=0}^{E-1}f_i\bar{g}_i \)

独立路由器与归一化

论文没有把所有 MoE router 都一起共享,而是让每个 MoE 模块拥有自己的 router。直觉上,同一个共享块在第 1 次、第 6 次、第 12 次递归调用时,输入表示已经处在不同层级;如果路由路径完全一致,就会限制专家选择的灵活性。

归一化层也类似。LayerNorm、BatchNorm 的统计和缩放偏移参数对表示分布很敏感。作者让归一化模块保持独立,使不同层级的表示能够维持各自合适的统计状态。论文还把归一化中的 scale 和 offset 看作一种轻量 adapter,用很少参数增强共享块的适配能力。

隐藏层知识蒸馏

共享模型再聪明,毕竟参数少。作者用全参数 Conformer 编码器作为 teacher,让共享模型的编码器输出尽量接近 teacher 的隐藏表示。这里不是只蒸馏最终预测分布,而是直接约束隐藏 embedding 的 L2 距离。这样做的目的,是让小模型学习 full model 的中间表征轨迹。

hidden embedding 蒸馏损失直接约束 student encoder 输出 h_t 与 teacher encoder 输出 h_t' 的距离:

\( L_{\mathrm{kd}}=\frac{1}{T}\sum_{t=0}^{T-1}\lVert h_t-h_t’\rVert_2 \)

训练目标

最终损失由三部分组成:主任务的负对数似然、MoE 的负载均衡损失、隐藏层知识蒸馏损失。负载均衡项负责让专家不塌缩,蒸馏项负责让共享模型贴近全参数 teacher。论文还在实验中加入 CTC loss 来辅助对齐。

\( L=L_{\mathrm{nll}}+\frac{\alpha}{C}\sum L_{\mathrm{balance}}+\beta L_{\mathrm{kd}} \)

这里 C 是 MoE module 的数量,α 和 β 分别控制负载均衡损失与蒸馏损失的权重。

与已有工作的关系

MoE 常被用来扩大模型容量,尤其是在 NLP 大模型里,通过条件计算扩展到很大的参数规模。但这篇论文不是追求超大规模,而是把 MoE 当作参数高效工具:共享专家、重复使用专家,让少量模块发挥更大作用。

跨层权重共享也不是新想法,ALBERT、Universal Transformer 以及若干 ASR 工作都用过类似机制。本文的不同点在于,它没有只做朴素共享,而是在共享结构里加入稀疏专家,同时让 router 和 normalization 独立,从而减少共享带来的容量和分布适配问题。

实验:

实验设置

实验使用 AISHELL-1 普通话语音识别数据集:约 150 小时训练语音、18 小时开发集、10 小时测试集。输入特征为 80 维 FBANK,窗口 25ms、步长 10ms,并使用全局 CMVN、速度扰动、SpecAugmentation 和 time stretch 等增强手段。词表包含 4235 个中文字符以及起止符号。

模型前端是两层 CNN subsampling,把帧率降到 25Hz。编码器维度为 256,MHSA 使用 4 个头,卷积核大小 15,FFN 中间维度 1024。MoE-Conformer 的第二个 FFN 使用 4 个专家,解码器是 4 层 Transformer。训练 80 个 epoch,使用 PyTorch 和 FastMoE 实现。

结果与分析

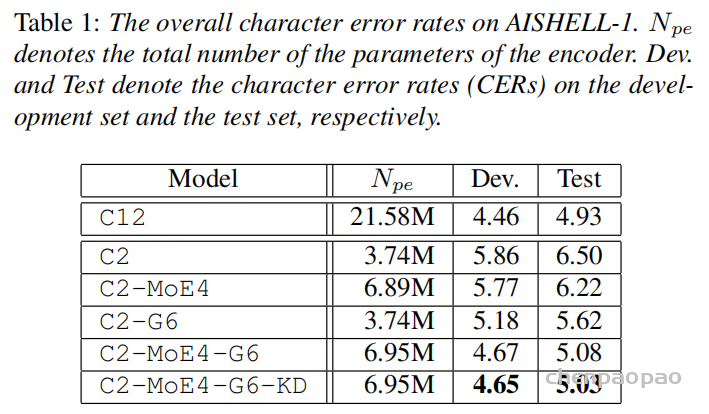
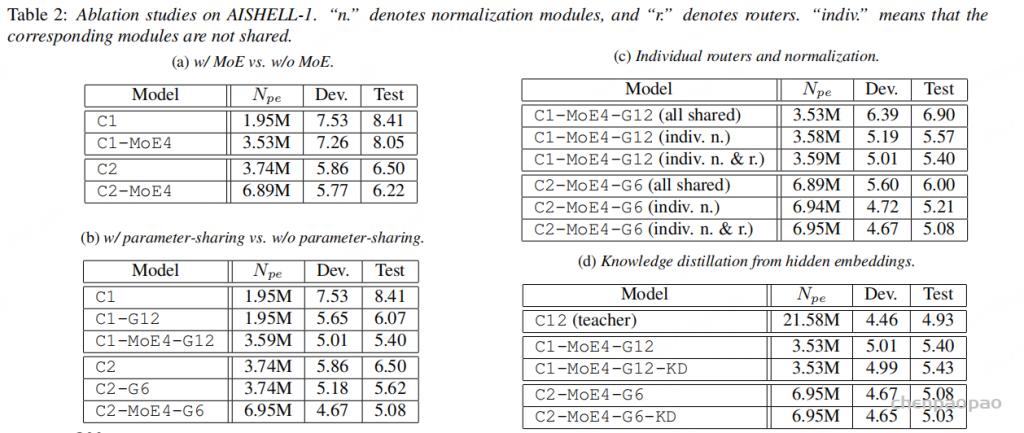
主表里,全参数 C12 编码器参数量为 21.58M,测试集 CER 为 4.93。最终的 C2-MoE4-G6-KD 只有 6.95M 编码器参数,测试集 CER 为 5.03。换句话说,它用大约三分之一的编码器参数,做到了非常接近 full-parameter 模型的结果。

消融实验显示,单独减少块数会明显损伤效果,例如 C2 的测试 CER 为 6.50;加入 MoE 后,C2-MoE4 降到 6.22,说明专家机制确实补了一部分容量。再加入跨层共享递归计算后,C2-G6 为 5.62,而 C2-MoE4-G6 达到 5.08,说明“共享 + MoE”的组合比任一单独机制更有价值。

独立路由器和归一化的作用也很明显。C2-MoE4-G6 如果全部共享,测试 CER 为 6.00;只让归一化独立,降到 5.21;归一化和 router 都独立后,进一步到 5.08。这说明共享模型最怕的不是参数少本身,而是不同深度表示被迫使用完全相同的适配路径。

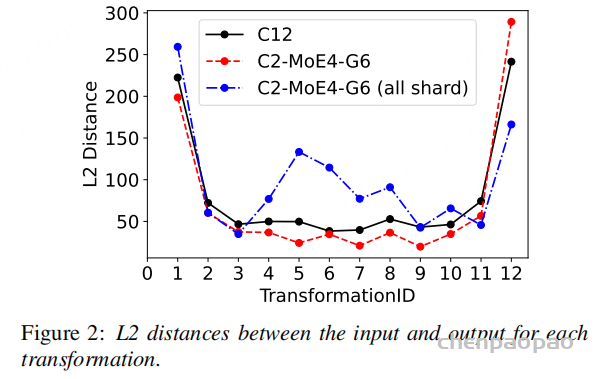
知识蒸馏带来的提升相对温和,但在 C2-MoE4-G6 上仍把测试 CER 从 5.08 推到 5.03。作者还通过输入输出 L2 距离观察模型内部变化:带独立 router 和 normalization 的共享模型更接近全参数 C12 的变化曲线,而全共享模型曲线更不稳定。

结论与未来方向

这篇论文的价值在于,它给出了一个较完整的参数高效 Conformer 方案:用跨层共享压缩参数,用稀疏 MoE 恢复容量,用独立路由器和归一化适配不同深度表示,再用隐藏层蒸馏补齐小模型表现。最终模型在 AISHELL-1 上以约三分之一编码器参数接近全参数模型。

它也留下了自然的后续问题:方法是否能在更大规模、多语种或更复杂的 ASR 数据集上保持优势?能否迁移到 RNN-T、CTC 或其他端到端 ASR 架构?从工程角度看,这类方案的吸引力很强,因为它不是单纯追求小模型,而是在“参数、计算、表达容量”之间做更细的拆分。

MoEAdapter for Large Audio Language Models: Sparsity, Disentanglement, and Gradient-Conflict-Free

这篇论文 MoE Adapter for Large Audio Language Models: Sparsity, Disentanglement, and Gradient-Conflict-Free 的问题意识很明确:大语言模型要理解真实世界,不能只看文本,音频是很重要的输入模态。但音频并不是一种均匀信号。语音、音乐、环境声承载的信息结构不同,如果用一个 dense adapter 把所有音频都压进同一个文本 embedding 空间,很容易出现参数更新方向互相冲突。

摘要:用专家分工处理异质音频

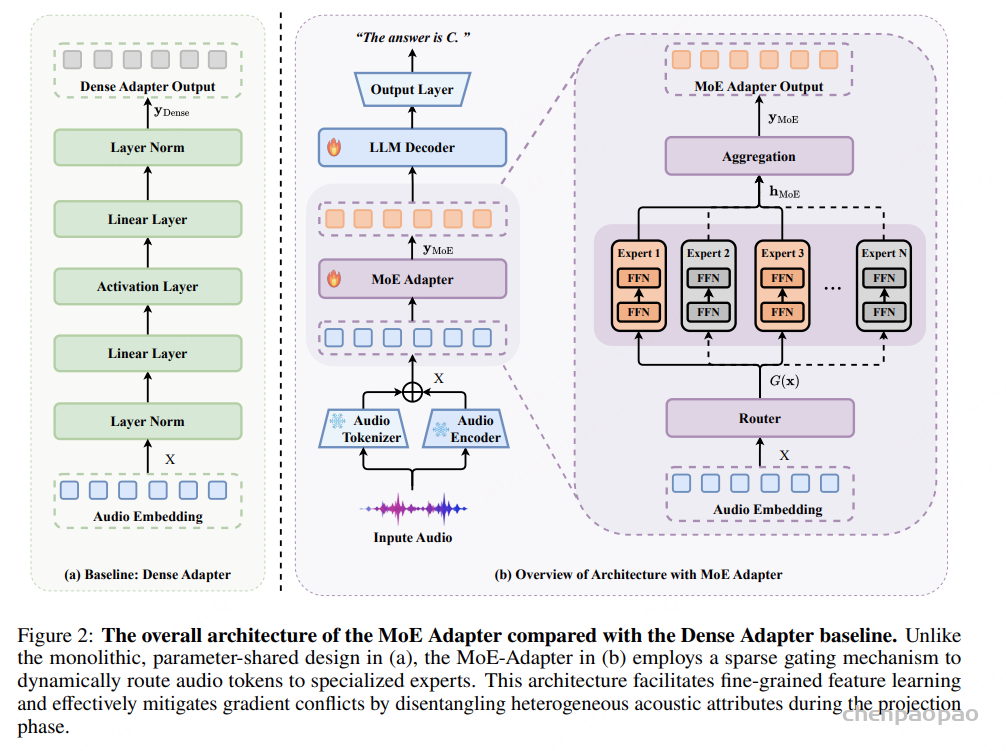
论文提出 MoE-Adapter,用稀疏 Mixture-of-Experts 替代传统的 dense audio adapter。它不是让所有音频 token 都通过同一套 FFN,而是用动态门控把 token 路由到若干专门专家,同时保留一定共享能力来捕捉全局上下文。这样,语音、音乐、环境声等不同属性可以在不同专家子空间中被建模,从而减轻梯度冲突。

实验基于 Qwen3-1.7B 骨干,音频前端使用 Whisper-VQ tokenizer 和 Whisper Encoder。作者在相同参数预算下比较 dense adapter 和 MoE-Adapter:两者总参数约 94.4M,但 MoE 因稀疏激活,推理时只激活约 70.8M 参数。结果显示,MoE-Adapter 在 MMSU、OBQA、MMAU 等音频理解和推理任务上均优于 dense baseline,并减少音频输入与文本输入之间的 modality gap。

引言:音频不是一种单一分布

大语言模型在文本推理上已经非常强,但只处理文本会限制它们感知现实世界的能力。音频包含人类说话、环境声音、音乐和情绪韵律等信息,是多模态智能绕不开的一环。当前许多大音频语言模型的主流做法,是加一个 adapter,把声学特征投影到 LLM 的文本语义空间里。

问题在于,很多 adapter 是 dense、参数共享的:所有音频都经过同一套投影层。这隐含一个假设,即不同音频类型可以被同一种映射均匀处理。作者认为这个假设过强。语音主要承载语义和语言结构,音乐更关注节奏、旋律和情感,环境声又有自己的声学模式。它们在表示空间中可能位于不同流形。

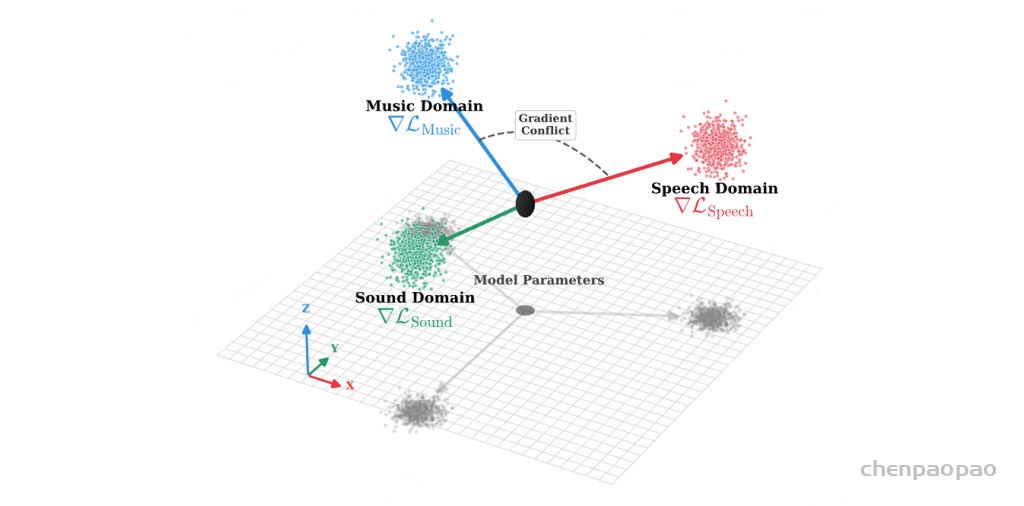
如果一个 dense adapter 同时学习这些相互差异很大的目标,不同数据类型的梯度可能朝相反方向更新同一组参数。这就是论文强调的 gradient conflict。MoE-Adapter 的贡献,就是用动态专家路由把这些冲突拆开:相似属性共享专家,冲突属性进入不同专家。

相关工作

大音频语言模型

早期音频问答或语音交互系统常采用级联管线:先 ASR 转文字,再交给 LLM。这样的系统容易受到识别错误传播影响,也会丢失语调、情绪、音乐和环境声等非文字信息。后来的端到端 LALM 通过可学习 adapter,把声学特征映射到文本空间,让 LLM 直接条件化在音频表示上。

现有 adapter 大致分为 Q-Former 类和 linear projector / MLP projector 类。后者结构简单、效率高,因此被许多最新模型采用。但这种全局共享投影层难以面对音频内部的分布差异。本文正是针对这个瓶颈,把稀疏 MoE 引入 audio-text alignment 阶段。

MoE 架构

MoE 的基本思想是让不同专家处理不同样本或不同 token,通过稀疏门控实现条件计算。它已经在语言模型、多模态模型、视觉语言模型等方向证明了对异质数据和任务冲突的缓解能力。音频领域也开始出现 MoE 相关工作,例如生成、医疗音频特征选择等。

不过,在通用 audio-text alignment 这个环节,主流 LALM 仍大量依赖静态、共享参数 adapter。本文的 MoE-Adapter 不只是借用 MoE 扩容量,而是把 MoE 作为一种“解耦工具”,专门处理音频属性之间的冲突。

方法

整体框架

模型采用类似 Kimi-Audio 的 dual-stream 音频前端:一条路径用冻结 tokenizer 提取离散语义 token,另一条路径用 speech encoder 提取连续声学特征。两类表示经过投影和融合后,进入 adapter。

传统方案会用 dense adapter 把融合音频特征映射到 LLM embedding 空间。本文则用 MoE-Adapter 完成这一步。最终,adapted audio embeddings 与文本 token embeddings 拼接,作为 LLM 的输入,并用标准自回归 next-token prediction 训练。

稀疏 MoE Adapter

Dense adapter 可以看作一个单体 FFN:所有音频 token 都通过同一组权重。作者指出,这种设计强制同一组参数同时容纳异质音频,会形成不必要的优化干扰。

论文先把 dense adapter 写成单体 FFN 投影。给定音频 token x,输出 embedding 为:

\( y=\mathcal{N}\left(W_{d2}\cdot\sigma\left(W_{d1}\cdot\mathcal{N}(x)\right)\right) \)

MoE-Adapter 把单体 FFN 替换成专家集合。每个专家都是轻量 FFN,router 根据输入 token 计算各专家得分,并通过 Top-k 选择保留若干活跃专家。被选中的专家输出按门控权重聚合,形成中间表示。随后再经过输出投影和 LayerNorm,对齐到 LLM embedding 维度,用来替换输入序列中的音频占位 token。

每个 expert 本身也是一个轻量 FFN:

\( E_i(x)=W_{e2}^{(i)}\cdot\phi\left(W_{e1}^{(i)}\cdot\mathcal{N}(x)\right) \)

router 根据 logits s=xW_g 做 Top-k 稀疏选择,再 softmax 得到门控概率:

\( G(x)=\mathrm{softmax}\left(T_k(s)\right),\quad s=xW_g \)

被选中的 expert 输出按 gate 权重聚合,并经过最终投影对齐到 LLM embedding 空间:

\( h_{\mathrm{MoE}}=\sum_{i\in I}G(x)_i\cdot E_i(x) \) \( y_{\mathrm{MoE}}=\mathcal{N}\left(W_P\cdot h_{\mathrm{MoE}}\right) \)

这套机制有两个效果:一是稀疏激活降低推理成本,二是专家分工让不同音频属性进入不同子空间。对于语音、音乐、环境声这种天然异质输入,第二点尤其重要。

训练目标

训练目标由 next-token prediction loss 和 auxiliary load-balancing loss 组成。前者让模型基于音频上下文预测后续文本 token,是主任务;后者用于避免 expert collapse,即所有 token 都涌向少数专家。

总训练目标为 next-token prediction 与负载均衡项的加权和:

\( L=L_{\mathrm{NTP}}+\lambda L_{\mathrm{aux}} \)

其中主任务 NTP loss 写成:

\( L_{\mathrm{NTP}}=-\sum_{t=1}^{T}\log P(y_t\mid y_{<t},X;\theta) \)

负载均衡损失会同时考虑专家的重要性和实际负载,让不同专家都被充分训练。这里有一个微妙的取舍:过强的均衡可能压制某些自然形成的专家偏好,但完全不均衡又会损害高层语义推理的泛化。论文后面的消融和分析专门讨论了这个矛盾。

论文将 expert importance 与 expert load 分别定义为:

\( \bar{P}_e=\frac{1}{B}\sum_{b=1}^{B}p_{b,e} \) \( \bar{f}_e=\frac{1}{B}\sum_{b=1}^{B}r_{b,e} \)

最终 auxiliary loss 为:

\( L_{\mathrm{aux}}=|\mathcal{E}_R|\sum_{e\in\mathcal{E}_R}\bar{P}_e\cdot\bar{f}_e \)

实验

实验设置

LLM 骨干是 Qwen3-1.7B,音频前端使用 Whisper-VQ tokenizer 和 Whisper Encoder。训练语料规模为 40B token,优化器为 AdamW,学习率调度采用 Warmup-Stable-Decay。为了公平比较,dense adapter 与 MoE-Adapter 的总参数预算都限制在约 94.4M。

评测覆盖几类能力。MMAU 用于音频感知和副语言理解,覆盖 speech、sound、music 等场景;VoiceBench 中的 MMSU 和 OpenBookQA 子集用于世界知识和语义推理,它们是从文本推理基准改造来的音频版本。所有评测采用 greedy decoding,避免采样随机性干扰比较。

主结果

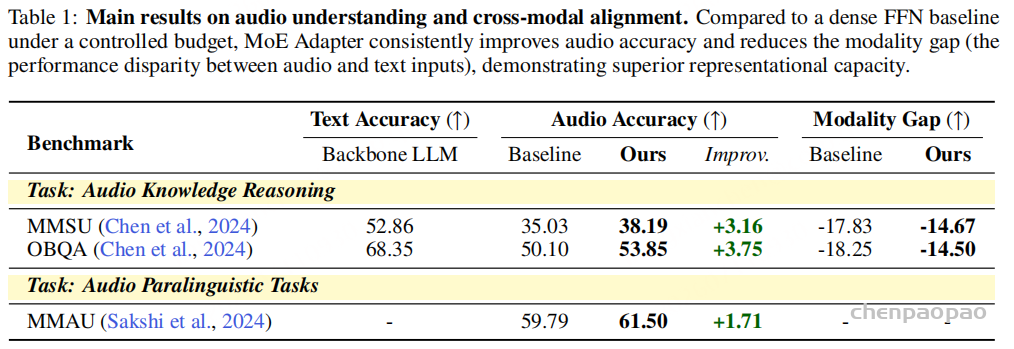
在知识推理任务上,MoE-Adapter 明显超过 dense baseline。MMSU 的 audio accuracy 从 35.03 提升到 38.19,OBQA 从 50.10 提升到 53.85。对比文本输入准确率,音频输入仍存在明显 gap,但 MoE 把这个差距分别缩小了约 3.16 和 3.75 个点。

在 MMAU 这类副语言和音频感知任务上,MoE-Adapter 也从 59.79 提升到 61.50。这个提升说明专家路由不仅对知识推理有用,也能帮助模型捕捉更复杂的声学线索。论文强调,MoE 的收益不是单纯参数变多,而是在相近总参数预算下更合理地分配表示能力。

消融实验

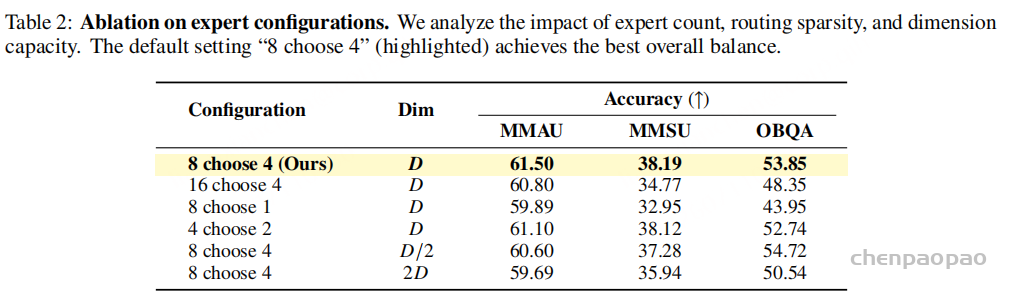
专家配置方面,默认的 “8 choose 4” 表现最均衡:MMAU 61.50、MMSU 38.19、OBQA 53.85。把专家数扩大到 “16 choose 4” 反而变差,说明专家总数不是越多越好。把路由变得过稀疏,例如 “8 choose 1”,也会显著伤害音频推理。论文的结论是,专家数量、激活数量和专家容量之间需要平衡,而不是盲目扩某一个维度。

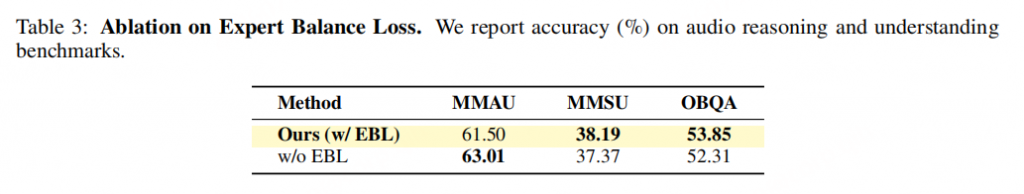
负载均衡损失的消融更有意思。去掉 EBL 后,MMAU 从 61.50 升到 63.01,但 MMSU 和 OBQA 分别下降到 37.37 和 52.31。作者解释说,MMAU 很异质且含有大量低层声学感知样本,不加均衡时 router 会集中使用少数“强专家”,反而有利于这类感知任务;但这会减少专家多样性,损害需要世界知识和语义推理的任务

专家分工与优化动态分析

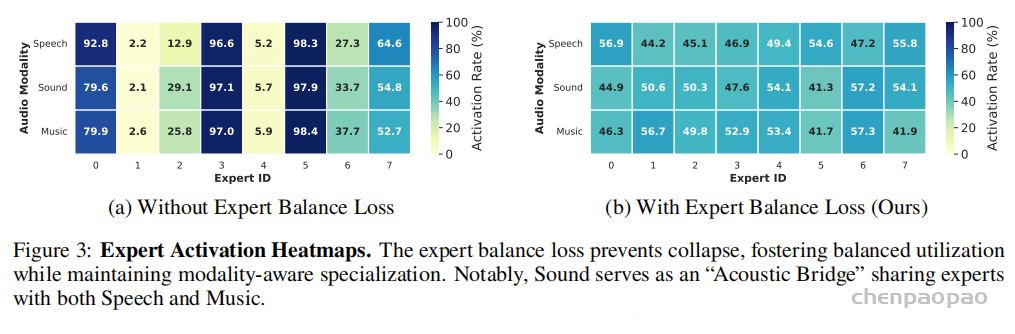
专家均衡如何影响路由

作者在 MMAU 上分析 speech、sound、music 三类样本的专家激活热力图。结果显示,模型确实学出了模态相关的专家分工:有些专家主要服务单一类别,有些专家在 sound 与 speech 或 sound 与 music 之间共享。值得注意的是,几乎没有专家同时专门服务 speech 和 music。

这个现象符合直觉:环境 sound 和 speech/music 都可能共享一些低层声学特征,因此可以作为“桥”;但 speech 和 music 在时间结构、语义组织上差异更大,不适合强行塞进同一个专家。EBL 并不会消灭这种分工,而是防止少数专家过度支配,保留一定均衡。

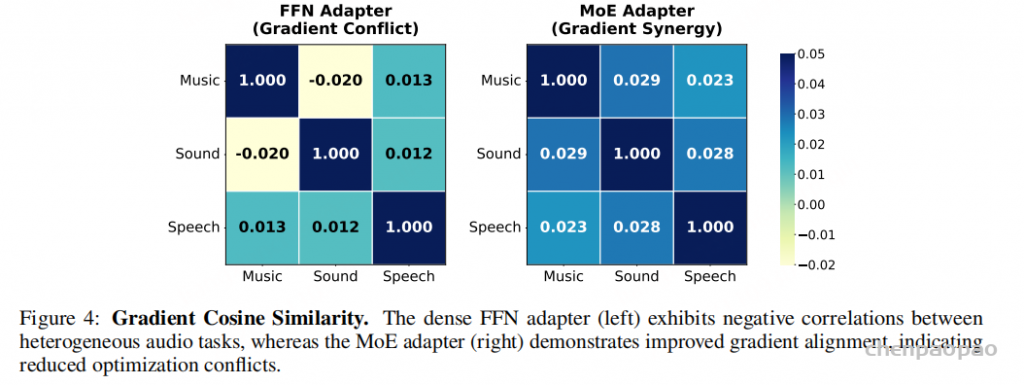
梯度冲突与缓解机制

论文用两个指标分析优化过程。第一个是不同音频类别梯度之间的 cosine similarity。dense adapter 中,不同类别的梯度经常出现负相似度,意味着一个类别的更新方向可能伤害另一个类别。MoE-Adapter 则把这些相似度推向更正的方向,说明专家路由减少了破坏性干扰。

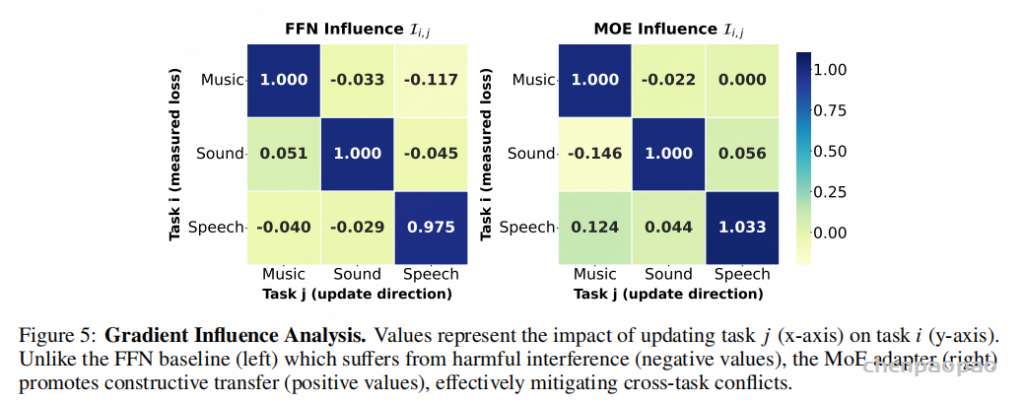
第二个是 gradient influence score,用来衡量基于某一任务梯度做更新后,对另一个任务损失是帮助还是伤害。dense adapter 中,speech 的更新会明显伤害 music 和 sound;MoE-Adapter 中,影响分数更多为正,说明它不是简单隔离任务,还能通过共享专家保留有益迁移。例如 speech 对 sound 的更新可以产生正向帮助,而 music 的冲突被更好地隔开。

结论

这篇论文把 MoE-Adapter 定位为解决 LALM 音频异质性的结构工具。相比 dense adapter,它用动态专家分工缓解语音、音乐、环境声之间的梯度冲突,在相近参数预算下提升音频知识推理、副语言理解和跨模态对齐表现。更重要的是,论文不仅给出指标提升,也通过路由热力图、梯度相似度和影响分数解释了为什么 MoE 有效。

局限性

作者也明确指出了几个限制。第一,实验目前只在 Qwen3-1.7B 骨干上验证,方法是否适用于其他 LLM 家族或更大规模模型,例如 70B,还需要实验。第二,论文没有系统研究稀疏路由随训练数据规模增长的 scaling law。第三,当前任务集中在音频理解与推理,没有扩展到生成式音频任务。

附录:超参数和工程含义

附录强调,dense baseline 与 MoE-Adapter 在总参数预算上被严格对齐,约为 94.4M。MoE-Adapter 的活跃参数约为 70.8M,大约是 dense baseline 的 75%。共同音频前端包含 speech encoder、audio hidden projection 和 feature fusion;MoE 端则包含专家集合、gate network 和 aggregation block。

从工程角度看,这个设置很关键。它把论文的结论从“MoE 参数更多所以更强”拉回到“在可比预算下,稀疏专家分工更适合异质音频”。如果未来大音频语言模型要同时处理语音问答、环境声推理、音乐理解和情绪韵律,adapter 层可能不该再是一个单体投影器,而应该具备更细粒度的路由和分工能力。
Mega-ASR 面向“全场景复杂环境”高噪语音识别

Mega-ASR 是一个专门解决”真实世界语音识别翻车”问题的开源框架——它用涵盖54种噪声、回声、丢帧等复合场景的240万条数据训练,让模型在嘈杂现实环境下的词错误率降低30%+,同时大幅减少”听没了”和”乱编内容”这两种高频故障。解决的核心问题是:在各种嘈杂、失真、回声、断连的现实场景下,尽可能准确地把语音转成文字。模型基于 Qwen3-ASR-1.7B进行后训练,通过一套专门设计的数据集和训练方法来强化”恶劣环境下的识别能力”。

一、ASR 在「现实世界环境」为什么不行?

  • 场景覆盖太窄:只解决噪音 / 远场单一问题,真实环境是复合干扰(噪音 + 混响 + 丢包一起上)。
  • 复合鲁棒性缺失: 缺乏对复杂环境的适应性,现实世界中的环境往往是多种因素共同作用的结果,很少模型能同时扛住多种失真叠加。
  • 训练与真实不匹配:训练数据太简单(WER 4%–10%),遇到高难度场景(WER>30%)直接崩

二、数据:Voices-in-the-Wild-2M

大规模、高难度、物理合理的复合声学仿真数据集

现有语音数据集的 3 大致命问题:

  1. 只覆盖单一干扰:噪音 / 混响 / 远场分开做,不模拟真实复合环境
  2. 难度太 “温柔”:平均 WER 只有 4%–10%,训练不出强鲁棒模型
  3. 真实录音太少太贵:收集覆盖所有场景的真实录音成本极高、不可扩

为了推动这一更具挑战性场景下的研究,提出了 Voices-in-the-Wild-2M,一个基于频谱级代码驱动仿真(spectrogram-level code-based simulation)构建的大规模数据集。这种设计使得超大规模数据生成成为可能。

首先识别并定义了 7 类经典的现实声学效应,这些基础效应用于模拟各种物理环境或设备引起的退化现象:

真实退化现象对应 Primitive
背景噪声Additive Noise
延迟反射Echo Delay
房间混响Reverberation
削波失真Nonlinear Distortion
带宽受限Resampling
高频衰减Spectral Filtering
音量不一致Loudness Transformation
丢包/卡顿Frame-level Stutter

设计了专门的频谱处理流水线,持续调整仿真参数,并利用 Qwen3-ASR 的监督微调(SFT)结果进行验证,直到模拟器在真实数据上的表现达到最佳拟合效果。

将这些原子效应组合成 54 种经过 Agent 验证的复杂声学配置,最终生成了 240 万条(2.4M)合成语音样本。

与直接枚举各种复杂真实环境不同,将野外环境(in-the-wild)中的语音退化过程划分为三个层级:

  • Primitive Acoustic Effects(基础声学效应)
  • Atomic Acoustic Effects(原子声学效应)
  • Compound Acoustic Scenarios(复合声学场景)

第一层:Primitive Acoustic Effects(基础声学效应)

用 DSP 手段实现最基本的声学退化组件

原子效应核心基元组合模拟真实场景
噪声(Noise)加性噪声 + 响度归一街道、咖啡馆、车内、人群
远场(Far-field)混响 + 低通滤波 + 响度衰减远距离说话、智能音箱远场
遮挡(Obstructed)低通滤波 + 混响 + 衰减隔门、隔窗、口罩、墙后说话
回声 + 混响(Echo&Reverb)强混响 + 回声 + 高通大厅、车库、体育馆、空旷房间
录制染色(Recording)重采样 + 噪声 + 双带通滤波手机外放再录制、设备串音
电子失真(Electronic Distortion)非线性失真 + 低通麦克风过载、削波、劣质录音
传输丢包(Transmission Dropout)帧卡顿 + 响度归一网络丢包、蓝牙不稳、流媒体卡顿

第二层:Atomic Acoustic Effects(原子声学效应)

在中间层,我们利用上述 Primitive Effects 构建了 7 种原子声学效应:

Atomic Effect中文
Noise噪声环境
Far-field远场录音
Obstructed遮挡语音
Echo & Reverb回声与混响
Recording录音链路效应
Electronic Distortion电子失真
Transmission Dropout传输丢失

一个 Atomic Effect 并不一定只对应一个 Primitive Effect。而是一个主导 Primitive + 若干辅助 Primitive。

比如:Far-field(远场)真实远场录音不仅仅是声音变小。通常同时具有:

  • 声压衰减(Loudness)
  • 高频损失(Spectral Filtering)
  • 房间混响(Reverb)

第三层:Compound Acoustic Scenarios(复合声学场景)

最高层将多个 Atomic Effects 进行组合,比如视频会议

Far-field + Echo&Reverb + Recording

无论构建 Atomic Effect 还是 Compound Scenario,都保持 Primitive Effect 的固定执行顺序。为的是避免物理上不合理的处理链

关键创新:不是随机乱组合,而是按物理规则合成。

组合规则(保证真实不违和)

  • 锚点效应(3 种):远场 / 回声混响 / 遮挡(互斥,不同时出现)
  • 修饰效应(4 种):噪声 / 录制染色 / 电子失真 / 丢包(可叠加)

为了让难度 “均匀且可学习”,团队设计了全局 severity 参数 m ∈ [0,1]:

  • 同一个音频里,所有失真共用一个 m
  • 保证:要么整体简单,要么整体难,不会出现 “强混响 + 零噪音” 这种不自然组合

最终选用 Linear 线性分布:

  • 简单、中等、困难样本均匀覆盖
  • 训练最稳定、泛化最强

严格过滤保证可学习

  • 剔除 WER > 70% 的样本(太难学不动)
  • 保留物理合理组合
  • 统一响度、统一格式、对齐标注

三、Mega-ASR

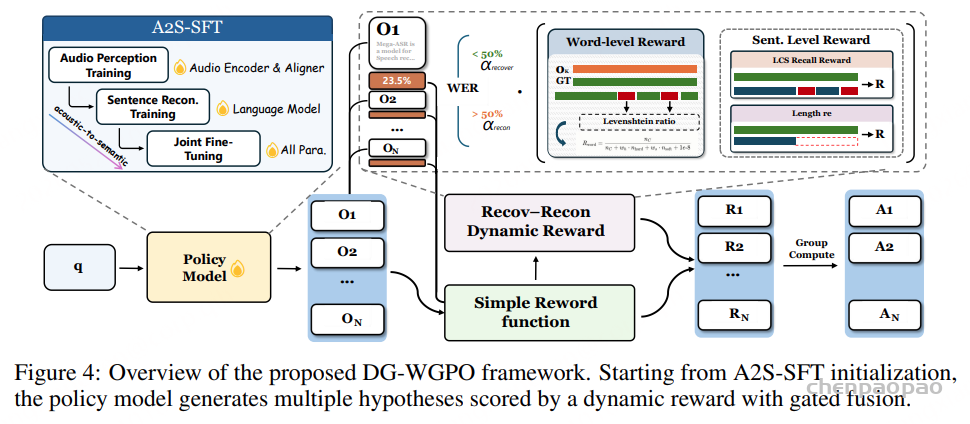
 Qwen3-ASR 的基础上开发了 Mega-ASR-Base 模型

1. A2S-SFT:从声学 → 语义递进微调

解决:高失真下「听不清 → 猜不对」的连锁崩溃。分三阶段训练:

  1. 声学感知阶段:编码器 + 对齐器,按难度递进(WER<30% → <50% → <70%)
  2. 语义恢复阶段:冻结声学,只微调 LLM,学会从残缺信号还原语义
  3. 联合对齐阶段:全模块一起微调,声学与语义对齐

2. DG-WGPO:双粒度 WER 门控策略优化

解决:普通 WER 奖励在高失真下失效(只看词错,不管语义崩没崩)。设计两套奖励,按 WER 动态切换:

  • 低 WER(<30%):侧重词级别精细修正(软错误 / 硬错误区分)
  • 高 WER(≥30%):侧重句子级结构恢复(主干语义、长度、最长公共子串)

最终奖励 = 基础规则奖励 + 双粒度动态奖励

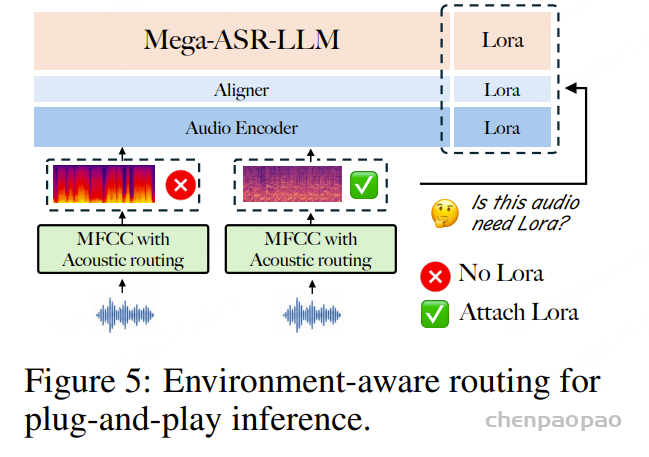
3. 环境感知路由(Router)

解决:鲁棒模型在干净音频上略有下降。

  • 训练一个轻量二分类器,判断音频是否恶劣
  • 恶劣 → 走 Mega-ASR
  • 干净 → 走原生 Qwen3-ASR
  • 推理开销 <1%,几乎无感

三、Experiments

Main results 

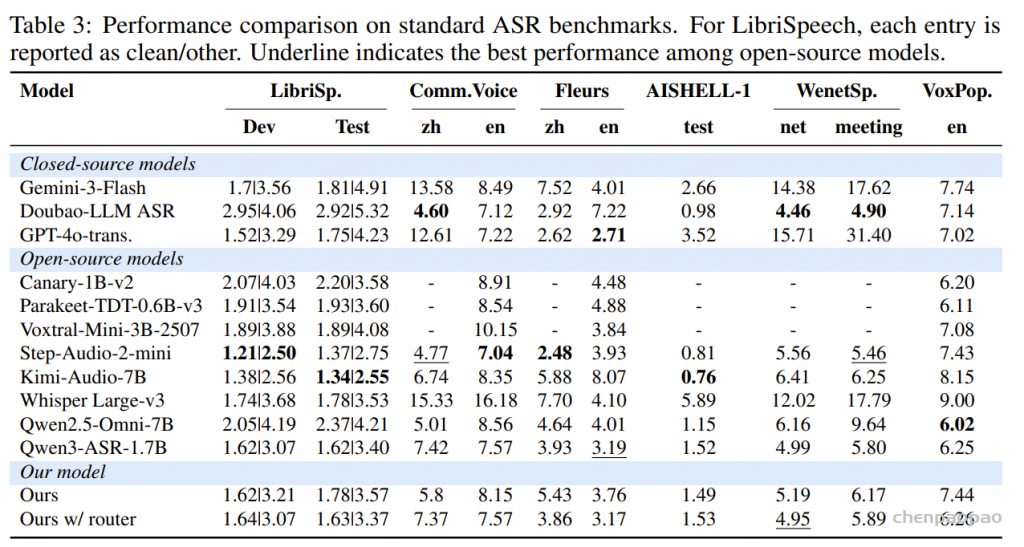
采用自适应路由的通用 ASR 性能具有竞争力:MEGA-ASR 在干净语音和多语言基准测试上,相较于 Qwen3-ASR、Seed-ASR 和 Kimi-Audio 仍保持极强的竞争力。
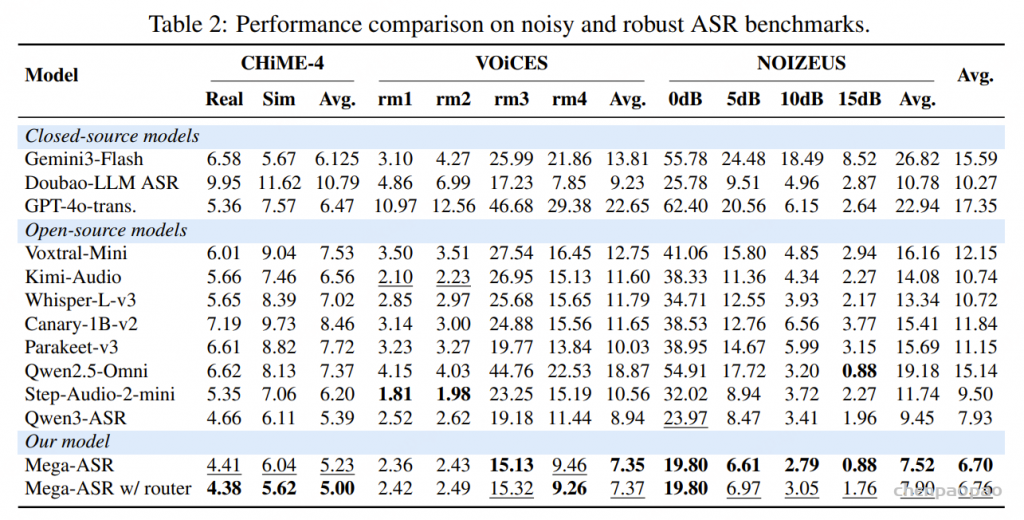
声学扰动条件下达到当前最佳鲁棒性:相较于最强基线 Qwen3-ASR,MEGA-ASR 的错误率进一步降低了 17.4%;相较于 Gemini-3-Flash,则降低了 64.5%。
在组合式真实环境中的鲁棒性表现更优

在 Voices-in-the-Wild-Bench 基准测试中,MEGA-ASR 在多种真实世界退化条件下均取得了最佳性能,包括:

  • 混合退化(mixed degradations)
  • 远场语音(far-field speech)
  • 录音伪影与设备缺陷(recording artifacts)

Analysis

通过消融实验,我们总结出五个关键观察([Obs.1]–[Obs.5]),涵盖了语义层面收益、训练策略、奖励函数设计以及超参数敏感性等方面。相关证据分别来自表 5–9。下面对各项发现进行详细说明。

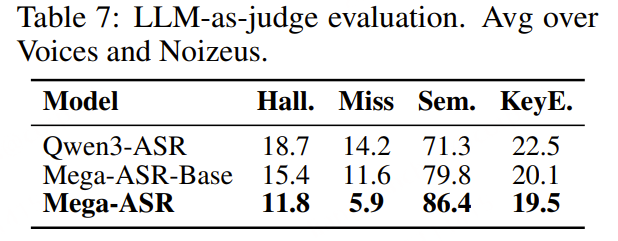
[Obs.1] MEGA-ASR 的收益不仅体现在 WER 上,也体现在语义层面指标上

表 7 显示,相比 Qwen3-ASR,MEGA-ASR 在语义层面指标上也取得了持续提升:

  • 漏识内容(Missed Content)从 14.2 降低到 5.9。

这表明,MEGA-ASR 的改进不仅仅是降低词错误率(WER),还带来了更高层次的语义和整体理解能力提升,例如:

  • 减少幻觉(Hallucination);
  • 减少整句或整段语音遗漏(Dropped Utterances);

因此,MEGA-ASR 实现的是语义层面和整体层面的质量提升,而不仅是字词级别的识别优化。

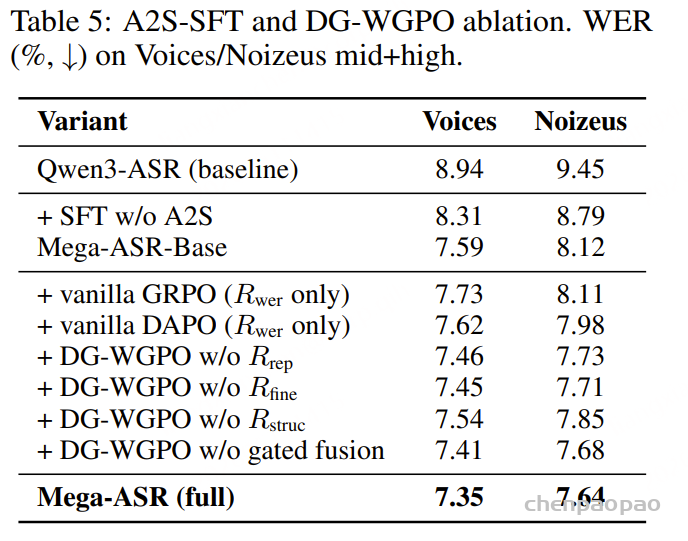
[Obs.2] A2S-SFT 与 DG-WGPO 组件的消融分析

在 Voices 和 Noizeus 数据集上,对 A2S-SFT 各阶段以及 DG-WGPO 各组成部分进行了消融实验(表 5)。

  • 分阶段的“声学到语义(Acoustic-to-Semantic)适配”过程是有效且必要的。
  • DAPO 作为强化学习阶段的基础优化框架。
  • 句子级重构奖励对于中高错误率样本尤为关键。

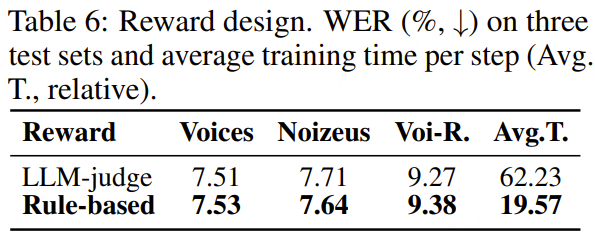
[Obs.3] 基于规则的奖励函数与 LLM Judge 效果相当,但训练成本降低 3.2 倍

规则奖励已经能够充分捕获 LLM Judge 所提供的监督信号。

[Obs.4] 超参数消融实验

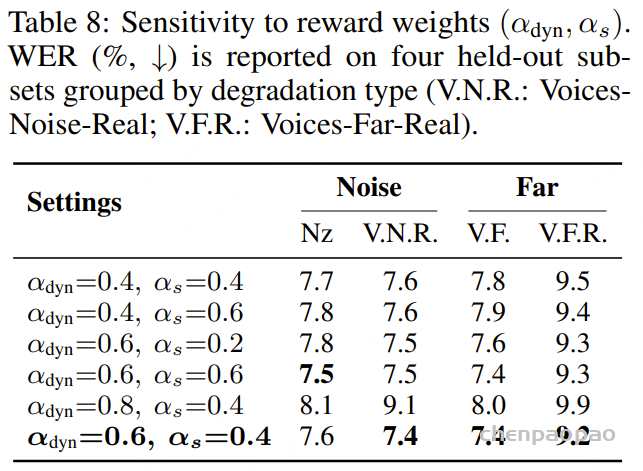
动态门控权重 αdyn 语义奖励权重 αs对模型性能的影响(表 8)

αdyn 所控制的权衡关系远比 αs 更敏感。

最终采用:

(αdyn, αs) = (0.6, 0.4)

因为它在所有测试子集上都达到最佳或接近最佳表现。

[Obs.5] 门控阈值 τ 的影响

过高的门控阈值会使门控机制过于严格(over-restrictive gating),从而限制奖励信号的有效传播,最终导致识别性能下降。

通过消融实验,得到以下核心结论:

  1. MEGA-ASR 的收益不仅体现在 WER,还体现在语义完整性与内容保真度上。
  2. A2S-SFT 的渐进式声学→语义适配以及 DG-WGPO 的各奖励组件均对性能提升至关重要。
  3. 规则奖励能够以接近 LLM Judge 的效果实现训练,同时将计算成本降低 3.2 倍。
  4. 动态门控权重 αdyn 是最敏感的超参数,最佳设置为 0.6。
  5. 门控阈值 τ=0.3 能在不同场景下取得最均衡的鲁棒性表现。

NIM4-ASR: 高效鲁棒可定制的实时LLM语音识别

paper: https://arxiv.org/abs/2604.18105

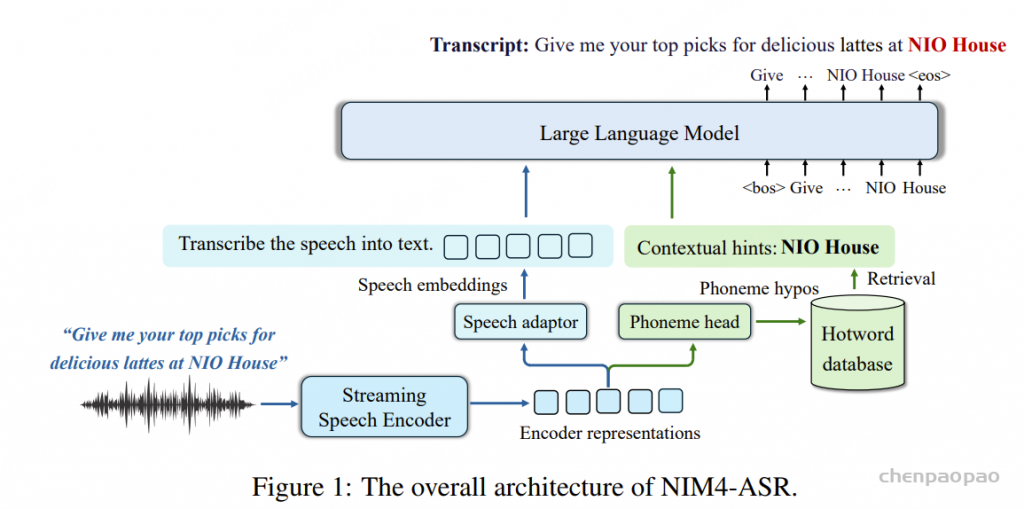
面向生产部署的 LLM-ASR 框架,系统解决轻量化、幻觉抑制、热词定制三大痛点。基于 phoneme-level encoder 预训练减少模态差距,引入 Iterative Asynchronous SFT(IA-SFT)防止 representation drift,设计 ASR 专用 RL 提升识别质量,并以 phoneme RAG 实现百万量级热词定制。

音频 → 600M Conformer Encoder(phoneme CTC 预训练,CKA 监控 drift)
                    ├── 流式:dynamic-chunk mechanism(预训练期内嵌)
                    └── phoneme CTC head → 音素假设
         MLP Adapter(4x 下采样,160ms/token)
                    ↓
              Qwen3-1.7B(LLM 解码器)
                    ↑
         Phoneme RAG:音素假设 → 检索热词数据库(<1ms)→ Prompt 注入

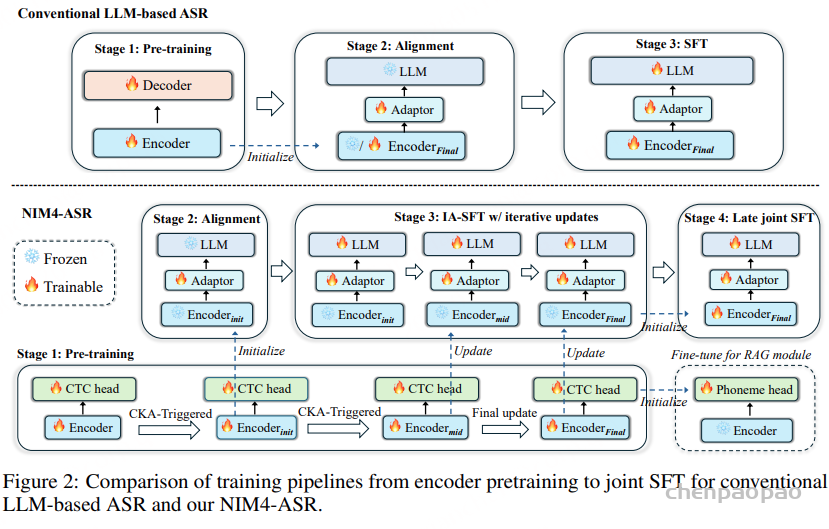
训练 pipeline:
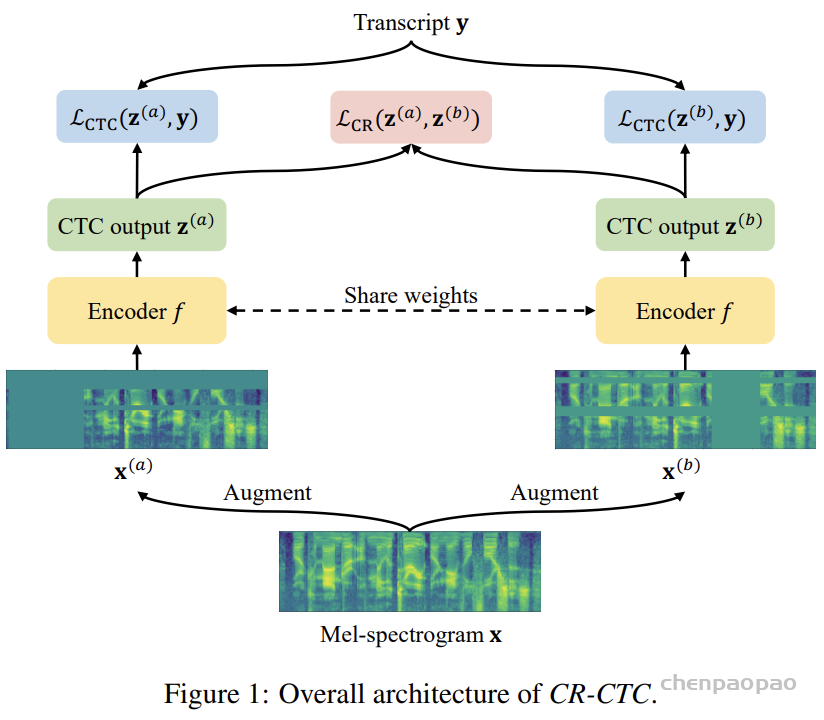
    Stage1: Encoder 预训练(phoneme CTC,CR-CTC)
    Stage2: Alignment(仅训练 Adapter,冻结其余)
    Stage3: IA-SFT(异步并行,CKA 监控 encoder 稳定性)
    Stage4+5: Late Joint SFT + Context SFT + ASR-RL

Challenge

1、Limited downward scalability

在实际部署中,尤其是实时语音交互场景下,轻量级 ASR 模型由于推理延迟更低、计算成本更小因此更受青睐。然而,基于 LLM 的 ASR 在模型缩小后的性能表现并不理想:比如Qwen3-ASR-0.6B、Fun-ASR-nano这类轻量版本相比完整大模型存在明显性能差距。除了模型缩小本身带来的性能下降外,LLM-ASR 还额外承担了一种:模态税(modality tax),

即:模型中有相当一部分参数并不是直接用于 ASR 任务,而是用于跨模态对齐(cross-modal alignment)。这种结构性开销会导致轻量 LLM 真正可用于 ASR 的有效容量更少,从而带来不成比例的性能下降。

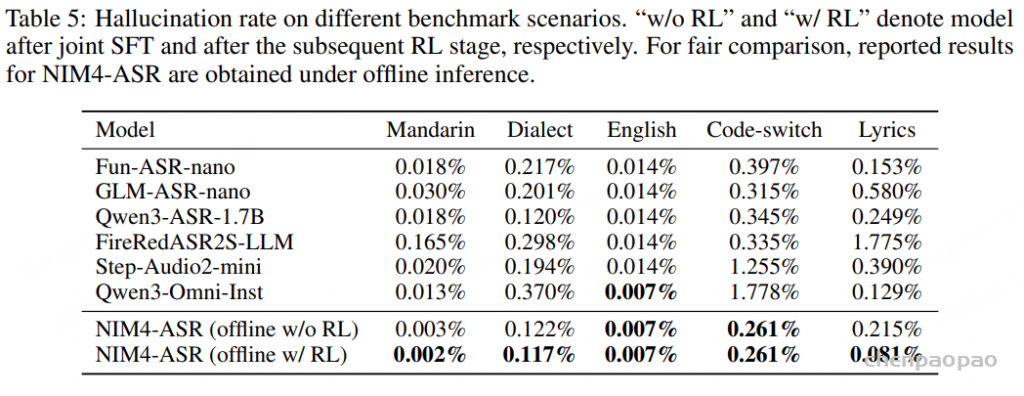
2、幻觉问题(Hallucination)

除了自回归 LLM 天生存在的 hallucination(幻觉)问题之外,encoder–adaptor–LLM 联合训练范式还会引入额外风险。

在联合优化过程中由于:LLM 梯度更强、LLM 语言先验更强。 encoder 会逐渐被拉向LLM 的优化目标,导致 encoder 的表示逐渐偏移到 LLM 的文本特征空间,称之为representation drift(表示漂移),导致encoder 会越来越依赖语言捷径(linguistic shortcuts)而不是精细声学信息(fine-grained acoustic fidelity)。在噪声、发音模糊、音频不清晰的声学歧义场景下会加重幻觉问题。

3、缺乏工业级热词定制能力(Lack of production-ready hotword customization)

为了解决上述问题,提出了面向工业部署的 LLM-ASR 框架 NIM4-ASR,重点优化推理效率和系统鲁棒性。

  • 提出了一种基于原则的多阶段训练范式
  • 优化了流式处理支持
  • 音素级 RAG 用于热词定制

Methodology

Model

encoder–adaptor–LLM 架构

1、音频特征提取

80 维 log-Mel 频谱,窗长(window):25 ms 帧移(frame shift):10 ms,全局均值方差归一化

2、Streaming speech encoder

编码器采用FireRedASR-AED Conformer,一个 4 倍下采样卷积模块 多层 Conformer Block 堆叠,输出帧率 25Hz,为了支持流式推理,训练阶段会模拟streaming 约束,将其改造成chunk-based streaming encoder

3、Speech adaptor

两层 MLP,将 encoder 输出映射到 LLM 的 embedding 空间,4倍下采样,将连续 4 帧特征进行拼接,帧率从 25 Hz 降到 6.25 Hz,每个 token 160ms。

4、Phoneme-level CTC head and RAG module

三层 MLP,将 encoder 表示解码为 phoneme hypothesis(音素假设),greedy decoding。RAG 模块会根据这些音素序列检索 hotword 数据库,将热词作为上下文提示注入 prompt

5、LLM decoder: Qwen3-1.7B

Training Recipe

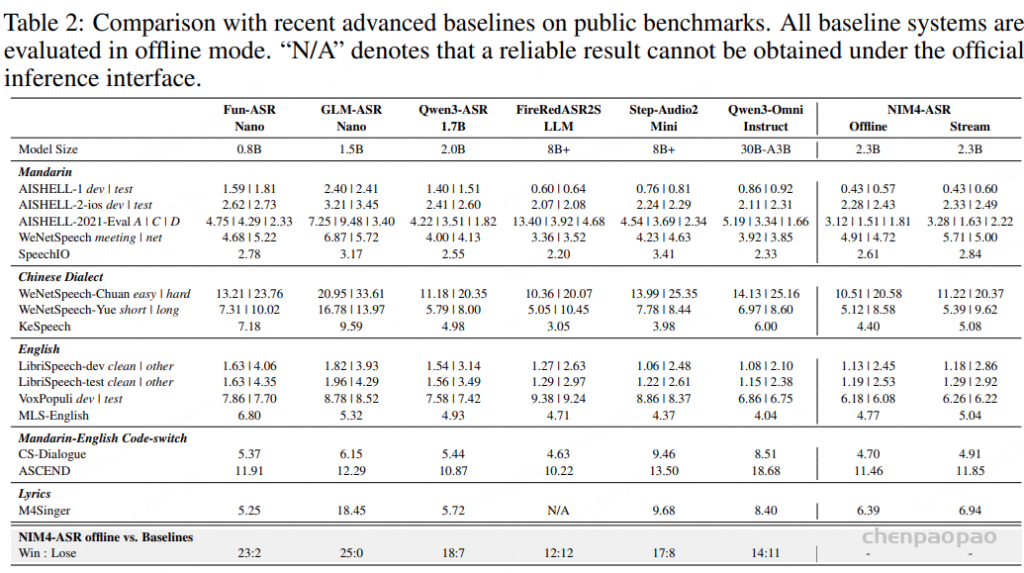
与以往主要依赖经验微调的工作不同,首先对当前基于 LLM 的 ASR 系统的实际局限性及其根本原因进行了系统性的分析  ,结果表明跨模态差距和表征漂移问题仍未得到充分解决。基于这些见解,我们对训练流程进行了全面重新设计。如图 2 所示,NIM4-ASR 的方法论改进主要体现在四个核心训练阶段:编码器预训练、对齐、IA-SFT 和后期联合 SFT。除了这四个阶段的流程之外,我们在后期联合 SFT 之后进一步加入了上下文 SFT 和强化学习(RL),以增强上下文建模和鲁棒性。具体步骤如下所述。

 第一阶段:编码器预训练

为了缩小编码器表征与 LLM 嵌入空间之间的模态差异,采用了一种改进的连接主义时间分类(CTC)变体  ——即 CR-CTC 作为预训练目标。如图 2 所示,预训练期间的模型架构由编码器和 CTC 头组成。与先前工作中常用的基于注意力机制的编码器-解码器(AED) 相比,CTC 鼓励编码器生成低熵、音素区分性强的表征,使其与 LLM 的嵌入空间更自然地对齐,从而减少跨模态对齐的开销,并为自动语音识别(ASR)任务保留更多模型容量

将监督标签从字符级转移到音素级 ,明确地将编码器的容量用于声学到音素的映射,而不是过早地进行语义锚定,同时鼓励语言学习模型(LLM)更多地关注语义推理。这种设计实现了声学建模与语义推理的更清晰解耦,提高了两个模块的角色专业化程度。此外,采用音素预测作为预训练目标,鼓励编码器学习语言依赖性较弱的底层声学表征,从而为扩展到新的语言和方言提供更大的潜力。

为了赋予编码器原生流媒体处理能力,在预训练阶段引入了动态分块机制。具体来说,编码器在分块流媒体约束下处理完整的语音,其中每个批次的块大小和可见左侧上下文块的数量都是动态采样的。这使得编码器能够适应各种流媒体配置,从而实现灵活操作,以适应不同部署场景下不同的延迟预算。

Stage 2: Alignment & Stage 3: IA-SFT

在传统的训练范式中,对齐和联合 SFT 是在预训练完全完成后依次执行的。如图 2 所示,我们为 NIM4-ASR 提出了一种编码器迭代机制,该机制允许在预训练完成之前开始对齐,而 IA-SFT 在对齐完成后启动,并与剩余的预训练过程异步进行。为了确定何时初始化或更新对齐和 IA-SFT 使用的编码器,我们使用中心核对齐(CKA) 跟踪编码器表示的动态变化。CKA 将不断演化的编码器与在整个预训练过程中初始化并定期更新的参考检查点进行比较。给定从同一评估集中提取的两组编码器表示 E(a),E(b) ,CKA 定义为

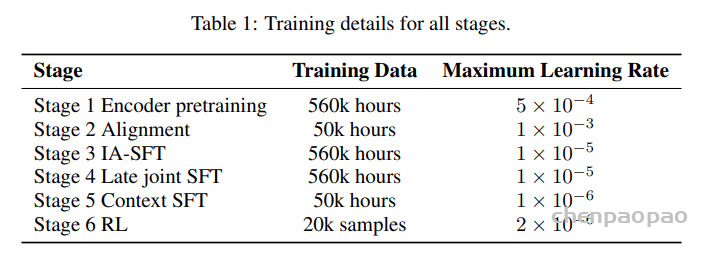
第二阶段:对齐。 预训练达到 50 万步后,我们开始监测编码器,此时编码器开始呈现相对稳定的优化趋势。我们将 50 万步时的编码器快照作为初始参考检查点,之后每隔 1 万步预训练评估一次 CKA。当演化中的编码器与当前参考检查点之间的 CKA 分数首次低于预定义阈值.在对齐过程中,编码器和 LLM 均被冻结,仅训练适配器。在我们的设置中,首次触发发生在预训练约 101 万步时,对齐阶段持续 130 万步

第三阶段:IA-SFT。 对齐完成后,我们在联合 SFT 之前执行 IA-SFT 作为中间阶段。IA-SFT 保持编码器冻结,并基于异步预训练过程生成的编码器快照序列训练适配器-LLM 堆栈。具体步骤如下:

(i)初始化与监控。IA -SFT 在对齐完成后开始,使用从对齐过程中继承的编码器进行 100 万步的训练,同时编码器预训练并行进行。CKA 评估从之前更新的参考检查点恢复,并每隔 1 万步预训练步骤重复进行一次,监控表征偏移。

(ii)CKA 触发更新。 每当 CKA 分数低于预定义阈值时,当前预训练编码器的快照就会热插拔到 IA-SFT 分支中,并相应地更新参考检查点。

(iii)最终更新。 更新周期(ii)重复进行,直到预训练达到其 200 万步的​​最大值。预训练完成后,无论 CKA 得分如何,都将应用最终编码器更新,并且 IA-SFT 运行最后 200 万步。

在我们的实现中,IA-SFT 使用 101 万步预训练时的编码器检查点进行 100 万步训练,再使用 132 万步预训练时的编码器检查点进行 100 万步训练,最后使用完全预训练的编码器进行 200 万步训练——总共在三个编码器版本上进行了 400 万步训练。在 IA-SFT 过程中,编码器保持冻结状态,但会定期从异步预训练过程中更新,从而保持声学基础。这使得模型能够在不出现表征漂移风险的情况下加深跨模态对齐。从课程学习的角度来看,IA-SFT 逐步将 LLM 暴露于更精细的编码器表征中,使其能够学习不变模式并提高对声学扰动的鲁棒性。此外,由于对齐和 IA-SFT 与预训练异步运行,因此整个训练流程仍然保持高效。

Stage 4: Late Joint SFT

在编码器预训练和 IA-SFT 完成后,语音表征与 LLM 嵌入空间之间建立了稳健的初始跨模态映射。随后,我们执行后期联合 SFT,其中编码器、适配器和 LLM 以端到端的方式联合优化。与传统的联合训练相比,由于前期阶段已经最小化了模态差异,LLM 梯度引起的表征漂移风险显著降低。因此,这些梯度主要作为微调信号,无缝地优化声学到音素的映射以及音素到语义的关联。从几何角度来看,前期的对齐阶段建立了一个稳定的跨模态流形,使后续优化处于损失函数曲面的低曲率区域。在该区域内,梯度更新是对决策边界和流形几何结构的局部优化,而不是引起大规模的拓扑重构。

Stage 5: Context SFT

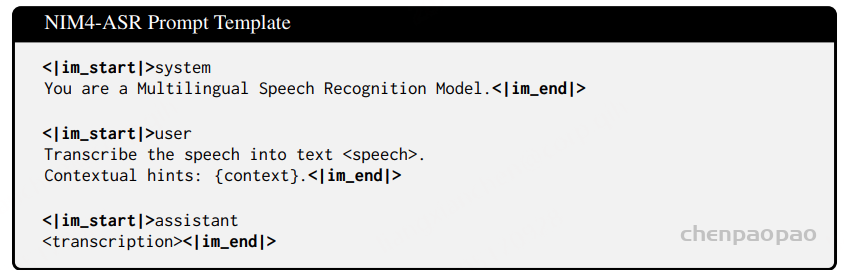
首先从训练语料库构建关键词集 S 。所有转录文本均被解析以提取候选短语,然后使用 Qwen3-30B-A3B-Instruct进行过滤,以保留命名实体,例如人名、兴趣点(POI)、媒体名称和专有名词。在训练过程中,我们提高长时长话语的采样比例,并按照以下模板,将从 S 中采样的关键词以概率方式注入到提示中作为上下文提示:

每个训练实例,我们首先从转录文本中存在的 S 中提取相关关键词。此外,对于每个关键词,我们以一定的概率从 S 中提取发音相同或高度相似的另一个关键词作为干扰项。相关关键词和干扰项被连接起来,然后添加到 {context} 字段中。干扰项的加入可以防止语言学习模型 (LLM) 过度依赖上下文线索而牺牲语义合理性。在此阶段,编码器、适配器和 LLM 会进行联合训练。

此阶段的设计目的在于实现热词定制,而非跨回合对话的一致性。对于多回合场景,还可以将从对话历史中提取的关键词添加到当前提示中。这种策略以紧凑的形式保留了关键的上下文信息,同时保持了比句子层面方法更低的推理延迟。

Stage 6: ASR Specialized RL

GRPO,奖励函数:

  • Accuracy reward
  • Hallucination reward
  • Context reward

Additional Stage: Phoneme Head Training for RAG

完成强化学习(RL)阶段后,主训练流程结束。接下来,我们引入一个额外的阶段来训练图 1 所示的 RAG 模块所需的音素头。在该阶段,编码器继承强化学习后检查点的结构和权重并保持冻结状态,而音素头则从预训练的 CTC 头初始化并保持可训练状态。训练目标和配置与预训练阶段一致。经过微调后,音素头可以将编码器表示转换为音素假设,供后续检索模块使用。

Training Setup

Robustness enhancement under noisy and silent conditions。应用了多种数据增强技巧来提高模型的鲁棒性。除了标准的 SpecAugmentation  和速度扰动之外,我们还随机地将一些真实的声学干扰(例如人声、车辆噪声和背景音乐)注入到 20%的干净训练样本中,以模拟具有挑战性的真实世界环境。这些噪声注入的信噪比(SNR)是从均值为 10 dB、标准差为 5 dB 的正态分布中随机抽取的。

Inference

优化流式推理

Encoder 与 LLM 解耦部署,Encoder 部署在 Triton,Adaptor + LLM 部署在 vLLM,CTC Head + RAG 部署在 CPU

Prompt 结构设计

[Static Prefix]
↓
[Streaming Speech Embeddings] 增量 append 到 context
↓
[Dynamic Hotword Context] 动态更新热词

两种 Streaming ASR Paradigm:

增量假设刷新(hypothesis refresh)
vs
incremental context extension(增量上下文扩展)

| 方案                  | hypothesis refresh | incremental extension |
| ------------------- | ------------------ | --------------------- |
| 历史是否重复 decode       | 是                  | 否                     |
| KV Cache 是否重建       | 经常                 | 基本不                   |
| 是否实时 partial output | 强                  | 弱                     |
| TTFT                | 更低                 | 略高                    |
| Tail latency        | 高                  | 低                     |
| 适合场景                | 长会议                | 实时语音助手                |

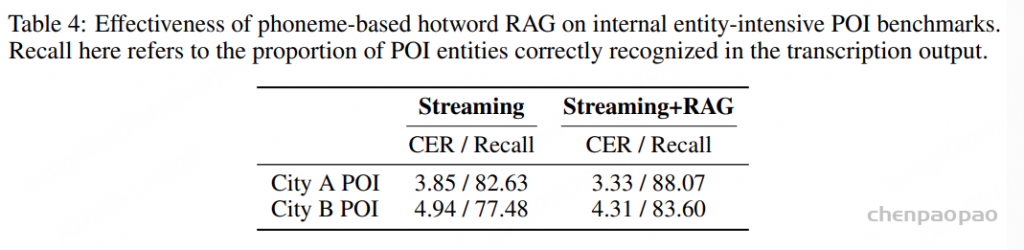
Phoneme-based RAG(音素级热词检索)

文本 -> 音素序列,使用 Aho-Corasick 自动机,采用 Hard Matching不做模糊匹配,Retrieval Error 比 Retrieval Miss 更危险。

为了实现高效的热词定制,NIM4-ASR 构建了一个基于音素的热词数据库以及相应的检索算法,如图 1 所示。将每个热词文本预先转换为音素-词元序列,并将其存储为键值对,其中键是音素序列,值是对应的热词文本。这些音素序列首先根据音素词汇表转换为离散索引,然后使用 Aho-Corasick 自动机算法重构为带有失败链接的 trie 树。在推理过程中,编码器上的音素头通过贪婪解码生成音素假设,这些假设被转换为索引序列,并由自动机在一次遍历中扫描完成。当无法扩展部分匹配时,自动机将沿着失败链接找到最长的有效后缀状态,而不是从头开始重新搜索,从而能够以假设长度的线性时间复杂度检索所有候选热词。

为了减少冗余的上下文提示,我们采用了一种最长匹配过滤策略:被较长跨度完全覆盖的较短匹配项将被丢弃,仅保留最长的实体。例如,如果热词“NIO”和“NIO House”在同一假设中同时匹配,则仅保留“NIO House”。检索到的热词文本随后被连接起来,并与语音嵌入一起作为上下文提示注入到 LLM 提示中,从而为解码提供上下文感知的偏置。由于索引级映射的存储效率以及 Aho-Corasick 自动机的线性时间复杂度(仅取决于查询长度而非数据库大小),热词数据库可以轻松扩展到数百万条记录,同时保持每次查询的亚毫秒级检索延迟。

值得注意的是,我们的热词定制旨在优化命名实体(例如地点名称和媒体标题)的识别,这类热词数据库可能非常庞大,并且可能包含大量语音相似甚至同音的条目。为了确保在这种大规模环境下的检索精度,我们在 RAG 模块中采用了硬匹配策略,仅检索精确的音素序列匹配,而非近似匹配或编辑距离最小的匹配。经验表明,检索漏检通常比检索错误危害更小,因为 LLM 仍然可以利用内部语言知识和上下文恢复正确的实体。相比之下,软匹配更容易引入相似但错误的热词,即使模型在一定程度上能够应对噪声上下文提示,这些错误热词仍然会干扰解码。

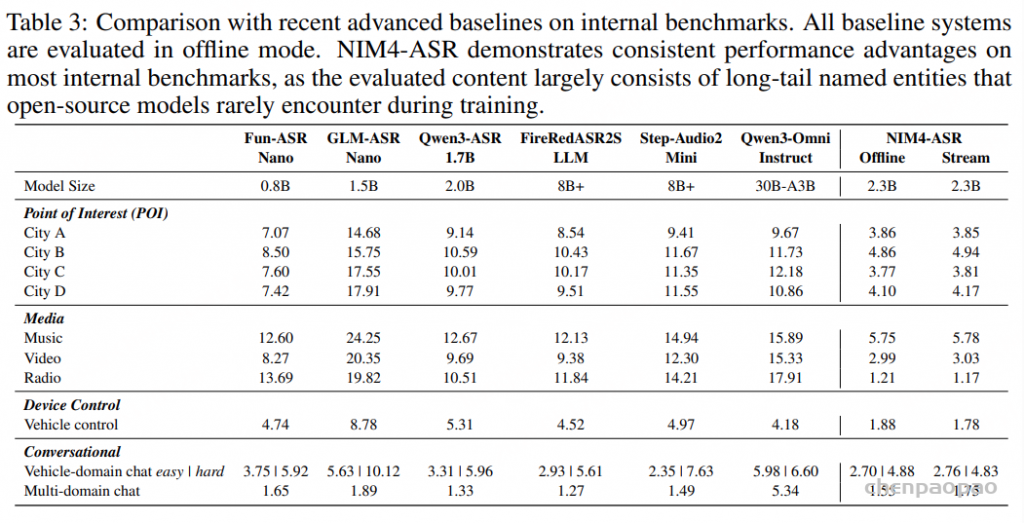
Evaluation

总结:

NIO 车载场景出发的工业论文,偏向工程落地。phoneme-level encoder 预训练、IA-SFT 防 drift、ASR-RL、百万热词 RAG——每个模块都是真实生产痛点的解法。CKA 动态监控 encoder 表示偏移这个手段很细。但核心数据不公开,学术可复现性为零;”25 个 benchmark SOTA”要打折——主要赢在内部实体密集场景;Streaming 支持是”优化了”而非”重新设计了”。热词检索口音/方言效果差。未来将对话历史作为附加上下文信息纳入多轮交互场景,以提高跨轮次转录的一致性。