一些随笔….

最近越来越不敢笃定地谈未来。

以前谈职业规划,我至少还能给自己画一条大致的路线:把基础打牢,做几个有代表性的项目,逐渐从业务实现走向模型设计,再从模型设计走向系统架构。努力也许不会立刻兑现,但大方向似乎是清楚的。

现在这条路线开始变得模糊。

AI coding agent 正在越来越熟练地写代码、改代码、查资料、跑测试、定位 bug、读仓库,甚至能够自己拆任务、自己调用工具、自己评估结果。所谓 RSI,也就是 recursive self-improvement,已经不再只是科幻小说里的概念。我们正在亲眼看着一套由人类创造的系统,开始参与改进自己的工具、流程和能力。

而身处这个时代,没有办法假装这些变化与我无关。

我们亲手造出了会替代自己的工具

我们训练模型,设计数据管道,写推理服务,搭评测体系,优化 GPU 利用率,研究 agent 的工具调用和记忆机制。我们把自己的经验拆成代码、文档、流程和规则,再把这些东西交给模型学习。我们希望它更聪明、更便宜、更稳定、更自动化。

然后有一天,我们突然发现:模型正在学习的,正是我们过去赖以谋生的那部分能力。

它会写一个函数,于是初级开发工作减少了;它会完成一个模块,于是一些执行型岗位开始减少了;它能端到端地跑完一个实验,于是过去需要几个人协作的工作变成了一个人加几个 agent。公司看见的不是“技术进步”四个字,而是交付周期缩短、人员数量下降和成本表上的数字变小。

人类创造了 AI,却首先用它来压缩自己的劳动价值。这听起来像背刺,但如果站在企业的财务表上,它又可能被包装成效率提升、组织升级和结构优化。

真正残酷的是,背刺并不来自某个恶意的 AI。它来自我们共同参与建立的激励机制:谁能用更少的人做出更多的事,谁就更有竞争力;谁拒绝使用自动化,谁就可能先被淘汰。

所以我无法背道而驰。

不能因为害怕被替代,就拒绝使用 AI coding agent;不能因为担心岗位消失,就拒绝学习新的模型和工具;不能因为不喜欢这场变化,就假装它不会发生。

只能裹挟着前进。

当下应该如何面对

面对 AI,最容易掉进两个极端:要么把它当成救世主,觉得只要学会几个工具就能解决一切;要么把它当成敌人,拒绝使用,试图用过去的工作方式守住自己的位置。

更愿意把它看成一种新的工作环境。环境已经变了,首先要做的不是表态,而是建立自己的工作方法。

让我在变化发生时更清醒、更有行动能力,而不是完全依赖某个工具或某个岗位定义自己。

“算法工程师”这个身份正在被重新拆解

我以前把算法工程师理解成一个相对完整的角色:理解问题,设计模型,处理数据,训练和调参,部署服务,跟踪指标,最后把效果交付给业务。

但 AI 正在把这个角色拆开。

数据清洗可以被自动化,baseline 可以被快速生成,训练脚本可以由 agent 编写,实验配置可以自动搜索,部署流程可以被模板化,线上日志可以交给模型分析。过去需要工程师亲自完成的许多步骤,正在变成“提出目标—监督执行—验证结果”。

这会让很多人感到失落,因为我们曾经用大量时间换来的熟练度,正在变成工具的一次调用。

但这也逼着我们重新回答一个问题:如果写代码、调参数和跑实验不再构成全部价值,那么算法工程师究竟还剩下什么?

我现在越来越相信,真正难以被替代的,不是某个具体 API,也不是某种模型结构,而是以下几种能力的组合:

第一,定义问题的能力。知道什么值得做,什么指标只是幻觉,什么需求本质上是数据问题、产品问题或组织问题。

第二,判断结果的能力。模型可以生成十个方案,但它不会自动承担错误决策的后果。知道什么时候相信结果,什么时候怀疑结果,什么时候回到原始数据和业务现场,这仍然需要人。

第三,把不确定性变成系统的能力。真正的工程不是让 demo 跑起来,而是让它在脏数据、异常输入、成本约束、延迟要求和业务变化下仍然可控。

第四,理解现实世界的能力。医疗、金融、制造、教育、能源、内容安全,每个领域都有自己的规则和代价。模型知识可以迁移,责任不能凭空迁移。

第五,和人一起做事的能力。算法最终要进入组织、产品和客户的工作流。能不能把复杂问题讲清楚,能不能推动不同角色达成共识,能不能在失败之后继续合作,决定了技术是否真的产生价值。

这些能力听起来不像过去那种容易写进简历的“硬技能”,但它们可能会成为 AI 普及后最重要的部分。

问题在于,环境不会因为这些能力重要,就自动给我们足够时间去培养。我们必须一边完成当下的工作,一边学习新工具,一边重新理解自己的专业价值。

真正身处的困境:未来需要更高阶的能力,但变化本身已经在今天发生。

我不想把“拥抱 AI”说成一句轻松的话

我不太喜欢“拥抱变化”这类过于顺滑的表达。变化不是发布会上的新功能,而是每天都会进入工作流程的新工具、新标准和新期待。说“你要积极拥抱 AI”,有时只是把系统性的压力重新交给个人,让个人为一场并非由自己决定的技术竞赛负责。

使用 AI,是因为我必须参与这场变化;但保持警惕,是因为参与不等于认同所有结果。

我希望把什么留在自己手里

想留下的不是某个项目的名字,而是对问题的理解方式;不是一次性的结果,而是如何做数据分析、如何设计实验、如何评估模型;不是某个框架的熟练度,而是能否快速进入一个陌生系统并找到关键路径。

希望把几个东西握在自己手里:对技术边界的理解,对问题价值的判断,对结果负责的习惯,以及持续学习和独立思考的能力。

这不是为了获得一种永远稳定的状态,而是为了在环境变化时,不至于完全失去方向。

我们可能需要重新定义“前进”

过去的前进,常常意味着更高的职级、更大的团队、更复杂的项目和更高的薪资。

这些当然仍然重要,但在 AI 时代,我希望“前进”还包括另一层含义:让自己的判断、作品、关系和生活,不再全部依附于一个组织的评价。

也许未来一个算法工程师不再需要亲自写完所有代码,但必须比以前更懂系统;不再需要独自完成全部实验,但必须更会设计实验;不再只是训练模型,而要决定模型应该被用来解决什么问题,以及什么时候不应该使用它。

也许我们无法阻止企业用 AI 降低人员需求,但可以尽量避免让自己只剩下可被单价比较的执行能力。

这并不意味着每个人都能轻松转型。现实没有这么公平。有人会因为家庭、年龄、地域、健康或经济压力,无法无缝进入下一个阶段。把一切归因于“学习不够努力”,只是对具体处境的忽视。

我们能做的,是尽量让自己的价值不只存在于某个岗位描述里,让自己的能力可以迁移,让自己的判断不被单一工具代替,让自己的生活仍然保留一点主动性。

我没有答案,但我不想把自己交给答案

我不知道 AI coding agent 最终会改变多少算法工作,也不知道 RSI 会把软件生产推到什么程度。我不知道“算法工程师”这个称呼会不会变成一个过渡性的历史名词。

但我不想用过度乐观来掩盖恐惧,也不想用彻底悲观来提前放弃。

我会继续学习 AI,因为我没有办法背道而驰;我会继续使用 agent,因为停在原地不会让世界停下来;我会继续怀疑这条路,因为技术进步不等于每个人都会因此获益。

人类创造了能够放大生产力的工具,但没有同时解决收益、权力和安全感如何分配的问题。

所以我们面对的,不只是“AI 会不会替代我”这个问题,还包括:当我的工作被重新定义,我希望自己成为什么样的人?当效率不再稀缺,我还能不能保留判断、责任、创造和同理心?当未来越来越不确定,我能不能为自己建立一点不依赖承诺的退路?

我暂时没有答案。

我只是决定,一边害怕,一边继续走;一边使用工具,一边观察工具正在改变什么;一边为最坏的结果做准备,一边不把最坏的结果当成唯一的结局。

这可能不是勇敢。

但至少,这是我在被裹挟着前进时,仍然能够保留的一点主动权。
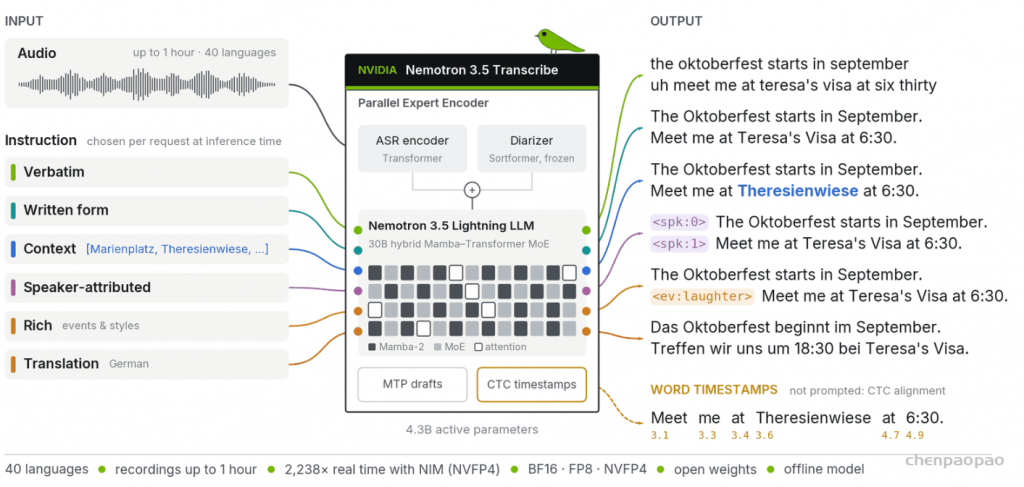
Nemotron 3.5 Transcribe 深度拆解:Cache-Aware FastConformer-RNNT 与 Granary v2 语音数据工厂

\(P(y_{1:T}\mid x)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x)\)

一、核心结论

  • Nemotron 3.5 ASR Streaming 是约 0.6B 参数的多语言流式 ASR。
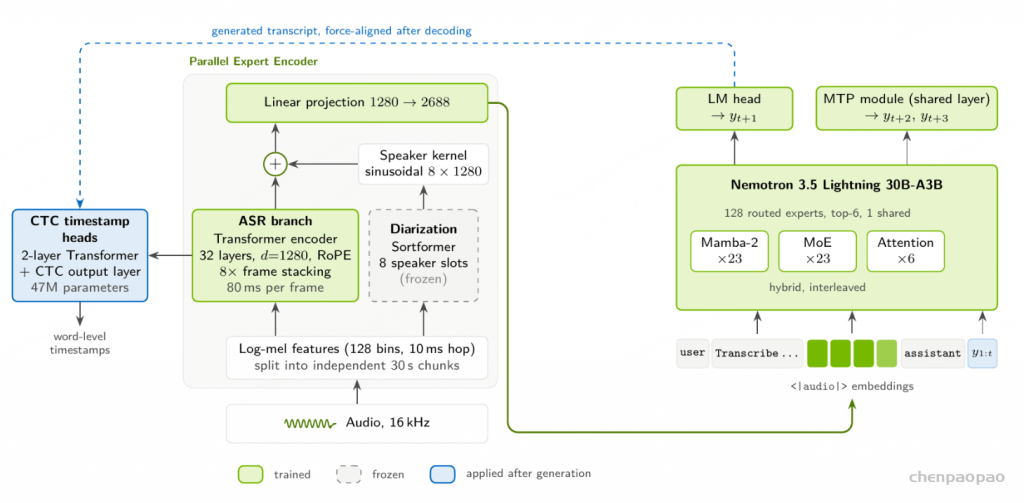
  • 核心架构是 24 层 Cache-Aware FastConformer 编码器、RNN-T 解码器和语言 ID Prompt Conditioning。
  • 声学表示维度为 1024,语言向量为 128 维;一个 checkpoint 支持 40 个 language locale。
  • 运行时支持 80 ms、160 ms、320 ms、560 ms、1.12 s 五个 chunk 配置。
  • FLEURS 上,Transcription-ready 19 个 locale 的平均 LangID WER 从 80 ms 的 10.38% 降到 1.12 s 的 8.84%;Auto-detect 从 11.14% 降到 9.21%。
  • 单张 H100 上,80 ms 时约支持 240 路并发流,Parakeet RNNT 1.1B buffered streaming 约 14 路;1.12 s 时约为 2,400 路对 400 路。

设计目标不是只追求离线 WER,而是在准确率、端到端延迟、显存和并发之间提供可调的 Pareto 点。

二、模型架构

2.1 Cache-Aware FastConformer

FastConformer 结合卷积对局部声学模式的建模能力和注意力对长程依赖的建模能力。Nemotron 3.5 使用 24 层 Cache-Aware FastConformer。缓存同时覆盖 self-attention 和 convolution 状态,因此当前 chunk 可以复用上一 chunk 的隐藏状态。

设第 k 个音频块为 x_k,上一步缓存为 C_(k-1):

\((H_k, C_k) = Encoder(x_k, C_(k-1))\)

传统 buffered streaming 会把上一段上下文与当前音频重新拼接,导致重叠帧重复计算;Cache-Aware 方案只计算新到达的帧,缓存负责保留上下文。

2.2 语言 ID Prompt Conditioning

编码器输出 H_a 的形状是 (1024,T)。语言 ID 被编码为 128 维向量 e_lang,沿时间轴广播为 H_l,二者拼接后经过投影层送入 RNNT:

\(H_a = FastConformer(x_1:T), H_a in R^(1024 x T)\) \(H_l = Broadcast(e_lang,T), e_lang in R^128\) \(H_f = Proj([H_a;H_l]), [H_a;H_l] in R^(1152 x T)\)

已知语言时可以输入 en-US、de-DE、zh-CN 等 locale;未知语言时使用 auto 模式。语言向量是每个时间帧都可见的条件信号,而不是附加在最终文本后的标签。

2.3 RNN-T

RNN-T 用 prediction network 建模已输出的 token 历史,用 joint network 融合声学状态与标签状态:

\(z_(t,u) = f_joint(h_t,g_u), P(y_(t,u)|x,y_<u) = softmax(z_(t,u))\)

它能在音频流持续到达时逐步发射 token,比必须等待整段音频的离线 encoder-decoder 更适合实时语音代理。

三、创新点

  • 缓存级流式计算,减少 buffered streaming 的重叠重算。
  • 语言提示让一个共享 checkpoint 覆盖多语言 locale。
  • chunk size 可在推理时切换,不需要重新训练。
  • 原生支持 punctuation 和 capitalization。
  • 0.6B 参数配合缓存式推理,在 H100 上获得高并发。

四、训练数据:规模、来源与标签

官方模型卡给出的训练数据范围是 10,000 到 1,000,000 小时,覆盖 40 个 language locale。来源包括 NVIDIA Riva multilingual ASR training set(专有)、NVIDIA Granary、Multilingual LibriSpeech、Mozilla Common Voice、FLEURS、VoxPopuli 和 Europarl-ASR。

训练标签包括人工标签和合成标签。合成 ASR 标签来自 Canary、Parakeet Multilingual 1.1B RNNT、Parakeet CTC 1.1B、Whisper large-v3 与 FunASR 的模型集成;标点和大小写由 Qwen3-32B 生成:

\(y_hat_i = Consensus(Canary(x_i), Parakeet(x_i), Whisper(x_i), FunASR(x_i))\) \(y_PnC_i = Qwen3-32B(y_hat_i, language_i)\)

Consensus 不能被擅自解释为简单多数投票,因为官方没有披露集成规则。工程上还应结合语言一致性、字符速率、重复检测、空输出和长度比过滤。

4.1 Granary 数量级

Granary 覆盖 25 种欧洲语言,聚合规模约 1M 小时;ASR 侧约 643,238 小时,AST 侧约 351,000 小时。

来源语言数过滤后小时数格式
YODAS-Granary23192,17216 kHz WAV
VoxPopuli24206,116FLAC
YouTube-Commons24122,475WAV
LibriLight英语约 23,500FLAC
ASR 合计25643,238混合格式

Granary 主要提供 NeMo JSONL manifest 和元数据,部分来源需要另行下载音频。典型字段包括 audio_filepath、text、source_lang、target_lang、original_source_id 和 dataset_source。

五、训练阶段

  • 阶段 A:收集和统一 manifest。保留路径、时长、采样率、语言、来源、许可证和原始 ID。
  • 阶段 B:切分、VAD、说话人和语言质检。检查时长、静音比例、字符速率、语言一致性、空文本和异常重复。
  • 阶段 C:多模型伪标注与 PnC。生成候选、做一致性筛选,再用 Qwen3-32B 统一标点和大小写。
  • 阶段 D:流式多语言 ASR 训练。使用 Cache-Aware FastConformer-RNNT、语言 ID 条件和混合多语言数据。
  • 阶段 E:多延迟点评测。以 80 ms 为基本帧,测试 80 ms、160 ms、320 ms、560 ms、1.12 s。
\(D_train = Filter(Normalize(D_public union D_private))\) \(theta* = argmin_theta E[-log P_theta(y | x, language)]\)

六、Granary v2 流水线

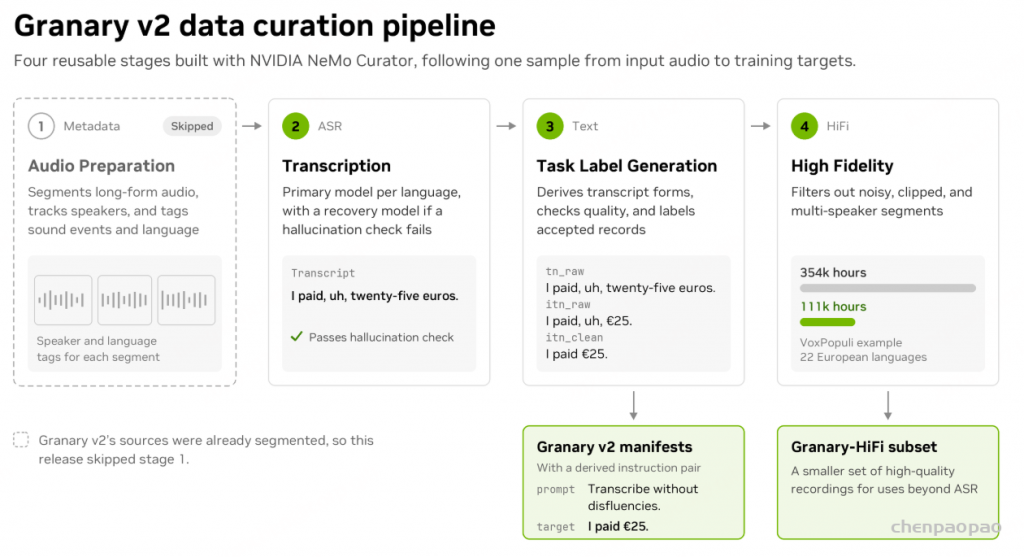
Granary v2 把原始录音加工成带元数据、可追溯、可继续处理的训练数据。官方教程包括 Metadata extraction、Indic ASR、Qwen Omni ASR 和 Text pipeline。

6.1 Metadata extraction

  • 读取 recording manifest,重采样到单声道 16 kHz WAV。
  • Sortformer 做说话人分离并输出 RTTM。
  • Silero TensorRT VAD 切分语音段。
  • CNN14 TensorRT 预测声音事件。
  • SpeechBrain、Indic Canary、Whisper 做多级语言识别。
  • 根据一致性选择 source_lang,保留拒绝原因。
  • 片段编码为 Opus,并写出 JSONL metadata。

没有语音的录音保留 vad_empty 审计行;语言意见不一致时保留 skip 标记和预测结果,避免把“无语音”和“文件缺失”混为一谈。

6.2 Indic ASR

Hindi 示例有 11 个阶段:读取 manifest;准备单声道 16 kHz 音频;Canary 主转写;主结果 hallucination 检查;Parakeet 恢复候选;恢复结果检查;选择最佳预测;正则清洗;缩写合并;计算 WER;写回 JSONL。两个 ASR 模型会对每个有效片段都运行。

示例限制 0.5 到 40 秒;最终字段包括 primary_model_prediction、fallback_model_prediction、best_prediction、cleaned_text、abbreviated_text 和 wer_pct。

6.3 Qwen Omni ASR 与 Text pipeline

Qwen3-Omni 生成主转写,已有 transcript 只作为回退文本,不发送给 Qwen。随后执行规则型 hallucination 检查、最佳预测选择、标点和空白清理、缩写合并。Text pipeline 不读取音频,负责实体恢复、PnC、语言识别与验证、逆文本规范化、captioning、code switching 和 speech QA。

6.4 Xenna 与 Ray Data 吞吐

管道基准数据XennaRay Data
Metadata30,631 录音 / 107.76357 小时472.309 audio-hours/hour166.251
Indic ASR216,164 Hindi 片段 / 531.75763 小时3,604.471387.649
Qwen Omni ASR22,710 英语片段 / 80.61259 小时406.615228.424
Text pipeline14,290 行 transcript30.283 rows/s12.217 rows/s

官方对比使用 8 张 H100 80 GB GPU、相同 cohort、镜像、模型和 stage 设置。音频管道吞吐包含模型启动时间;Text pipeline 复用了已启动的模型服务器。

七、实验对比:FLEURS 与流式延迟

分组模式80 ms160 ms320 ms560 ms1.12 s
Transcription-ready 19 localesLangID 平均 WER10.3810.009.499.128.84
Transcription-ready 19 localesAuto-detect 平均 WER11.1410.6710.059.639.21
Broad-coverage 13 localesLangID 平均 WER25.8625.1424.1123.0922.13
Broad-coverage 13 localesAuto-detect 平均 WER27.6226.6525.4124.4423.09

在 1.12 s、LangID 条件下,官方表中英语 WER 为 7.91%,西班牙语 4.11%,意大利语 4.25%,葡萄牙语 5.48%,Hindi 6.81%,德语 8.31%,法语 9.03%,俄语 9.17%,乌克兰语 13.07%。Hindi 在 80 ms 下 LangID 为 8.13%,Auto-detect 为 11.47%;1.12 s 下分别为 6.81% 和 8.23%。日语、韩语和普通话使用 CER。

chunk 增大通常带来更多右侧上下文,平均 WER 下降但等待时间上升:

\(WER(c_1) >= WER(c_2), c_1 < c_2\)

八、吞吐对比与系统意义

配置Nemotron 3.5 ASRParakeet RNNT 1.1B优势
80 ms约 240 路约 14 路约 17 倍
1.12 s约 2,400 路约 400 路约 6 倍

优势来自参数规模、缓存复用、chunk 粒度和 H100 推理实现的共同作用,而不是单纯参数更小:

\(Cost_per_stream proportional to GPU_hourly_cost / sustainable_concurrent_streams\)