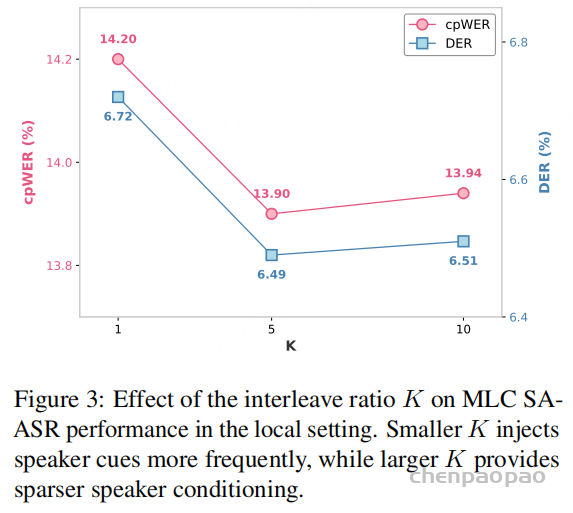
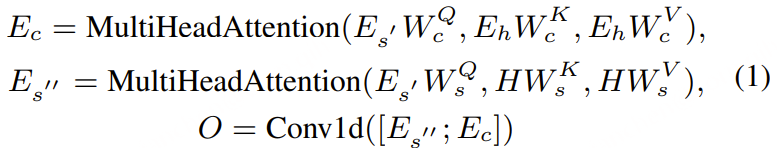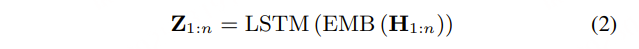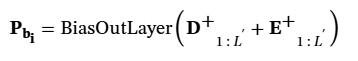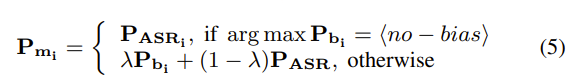第一,论文采用分块推理,但没有完整评估严格实时流式部署,尚缺少端到端延迟、缓存内存开销和在线缓存更新稳定性数据。第二,训练数据规模和多样性仍然有限,跨语言、复杂声学环境、更多说话人以及更强重叠场景的泛化能力还有提升空间。第三,从公开实验可以看到,模型对最终 cpWER 的优化非常稳定,但纯 DER 并非全面领先;如果应用只关注高精度说话人日志,专门的 diarization 系统仍可能更合适。
十、总结
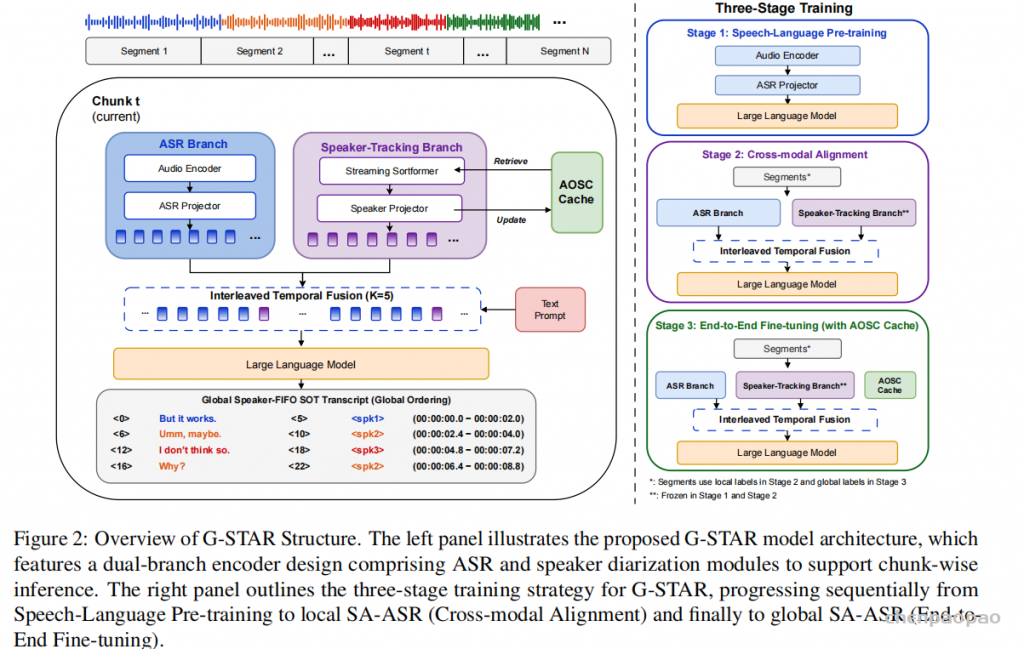
G-STAR 最值得关注的不是简单增加一个说话人编码器,而是重新定义了说话人归属在 Speech-LLM 中的位置:它不再是 ASR 后面的拼接步骤,而是影响生成过程的显式条件。AOSC 负责记住“谁已经出现过”,交错时间融合负责在合适的时间点把信息交给 LLM,全局 SOT 则把文字、时间戳和身份转换为可直接阅读的统一序列。
通常在每个单词末尾添加后缀</w>,统计每个单词出现的频率,例如,low的频率为5,那么我们将其改写为"l o w </ w>”:5 注:停止符</w>的意义在于标明subword是词后缀。举例来说:st不加</w>可以出现在词首,如st ar;加了</w>表明该子词位于词尾,如we st</w>,二者意义截然不同
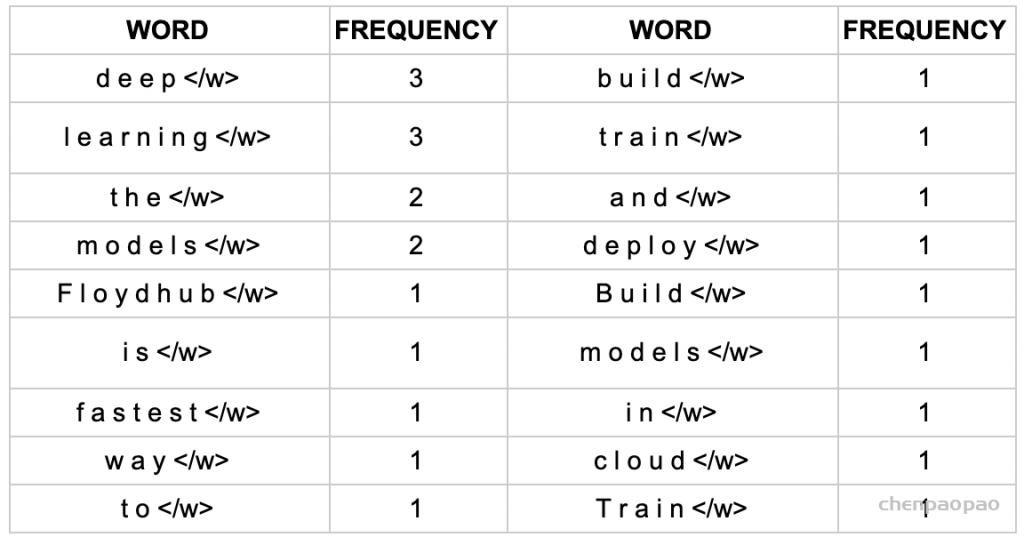
1、获取语料库,这样一段话为例:“FloydHub is the fastest way to build, train and deploy deep learning models. Build deep learning models in the cloud. Train deep learning models.”
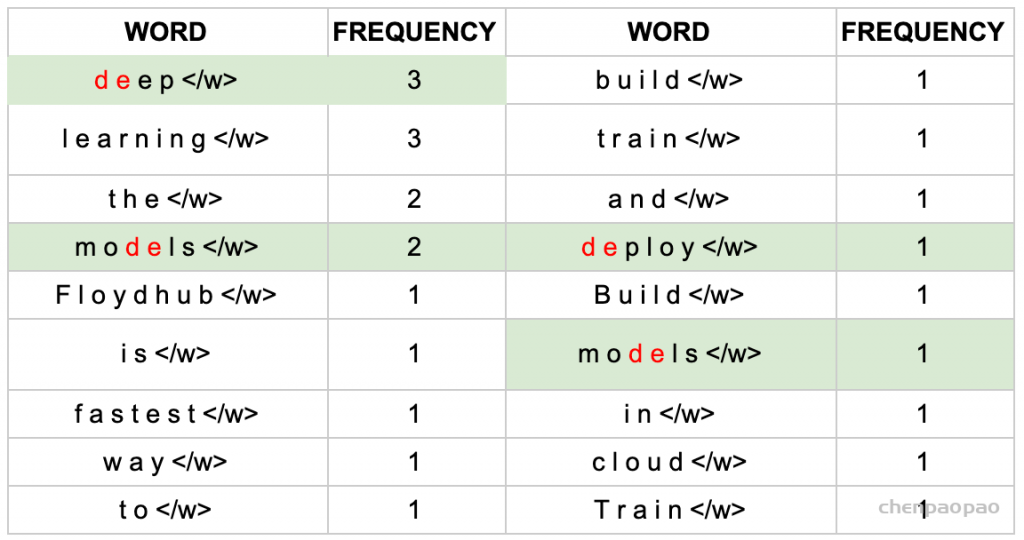
2、拆分,加后缀,统计词频:
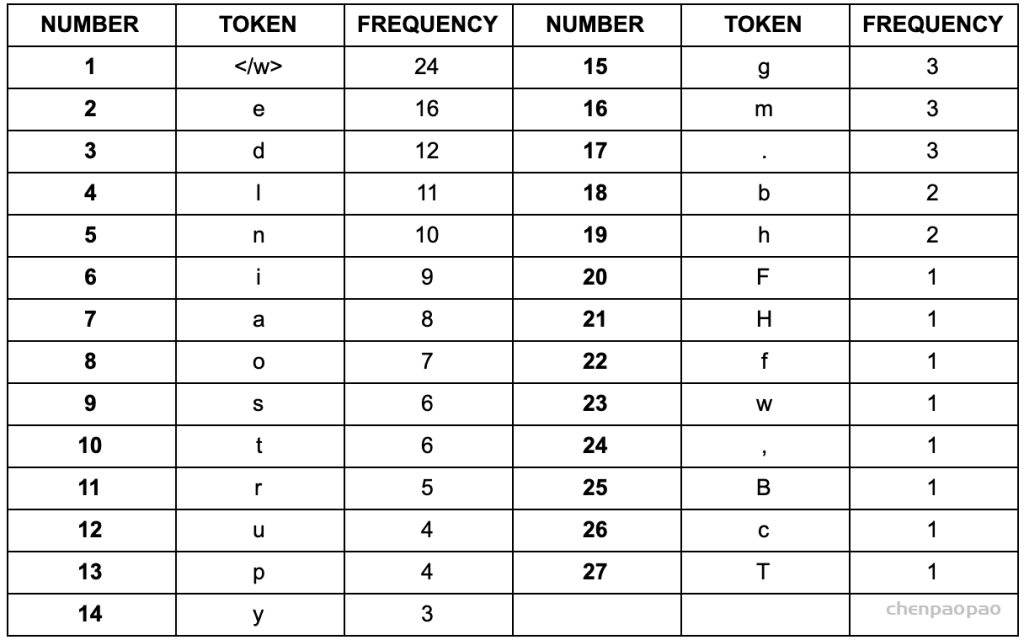
3、建立词表,统计字符频率(顺便排个序):
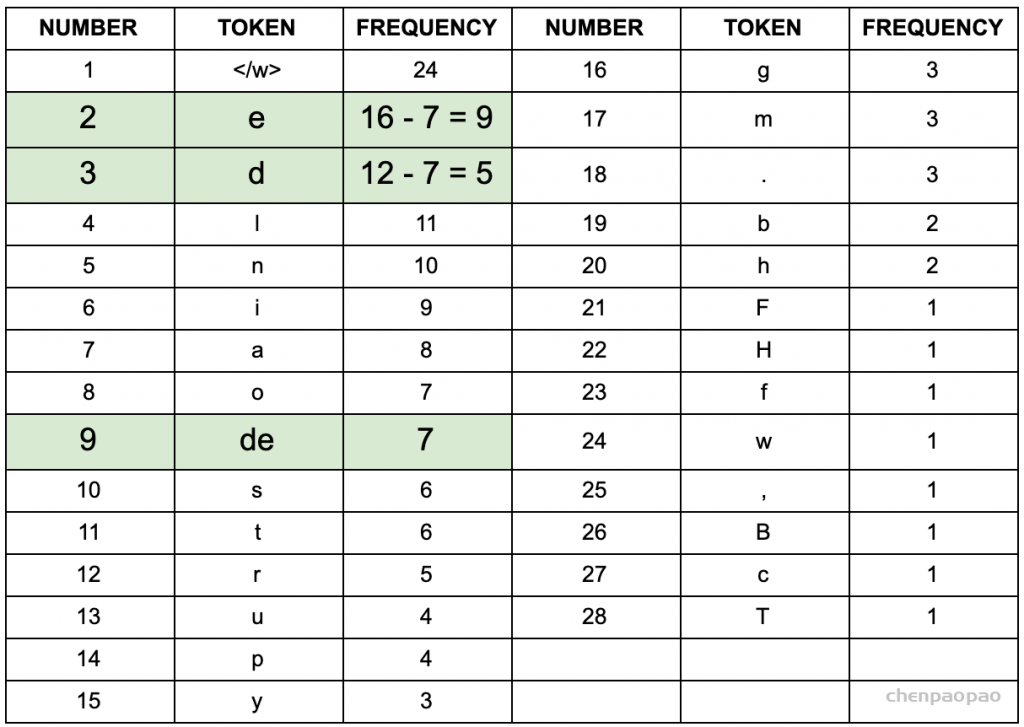
4、以第一次迭代为例,将字符频率最高的d和e替换为de,后面依次迭代:
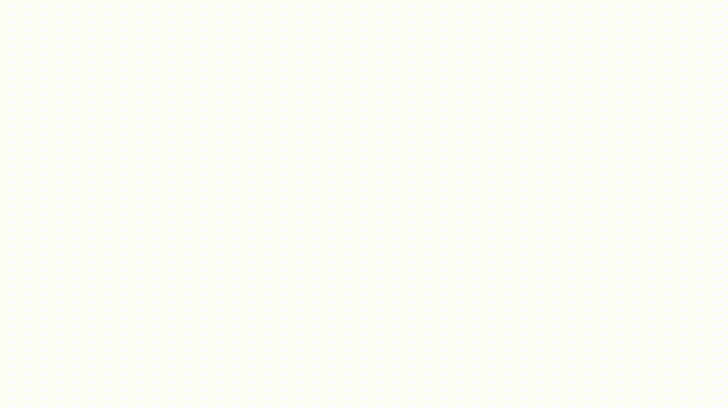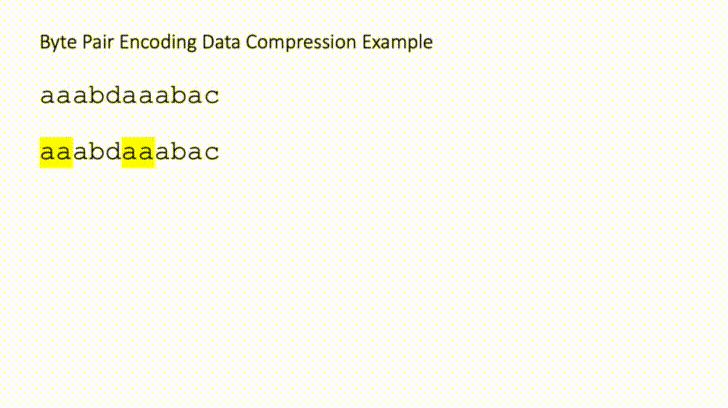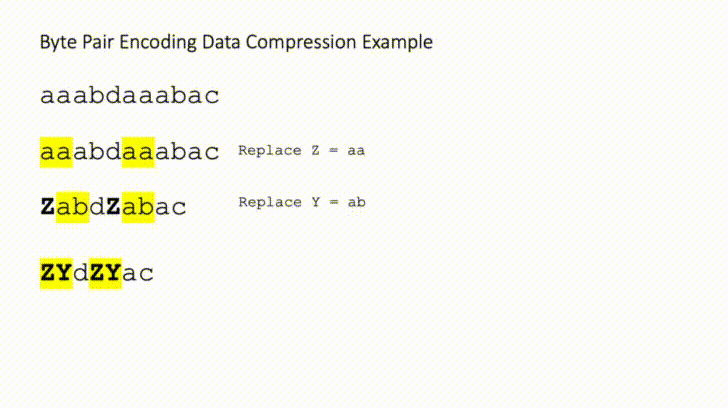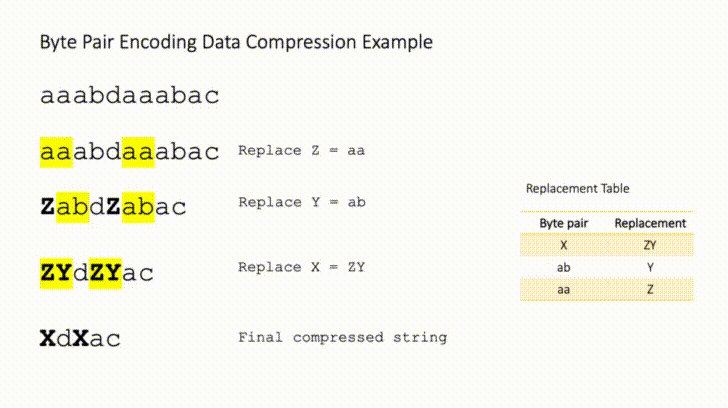
5、更新词表 继续迭代直到达到预设的subwords词表大小或下一个最高频的字节对出现频率为1。
如果将词表大小设置为10,最终的结果为:
d e
r n
rn i
rni n
rnin g</w>
o de
ode l
m odel
l o
l e
import re, collections

def get_vocab(filename):
    vocab = collections.defaultdict(int)
    with open(filename, 'r', encoding='utf-8') as fhand:
        for line in fhand:
            words = line.strip().split()
            for word in words:
                vocab[' '.join(list(word)) + ' </w>'] += 1
    return vocab

def get_stats(vocab):
    pairs = collections.defaultdict(int)
    for word, freq in vocab.items():
        symbols = word.split()
        for i in range(len(symbols)-1):
            pairs[symbols[i],symbols[i+1]] += freq
    return pairs

def merge_vocab(pair, v_in):
    v_out = {}
    bigram = re.escape(' '.join(pair))
    p = re.compile(r'(?<!\S)' + bigram + r'(?!\S)')
    for word in v_in:
        w_out = p.sub(''.join(pair), word)
        v_out[w_out] = v_in[word]
    return v_out

def get_tokens(vocab):
    tokens = collections.defaultdict(int)
    for word, freq in vocab.items():
        word_tokens = word.split()
        for token in word_tokens:
            tokens[token] += freq
    return tokens
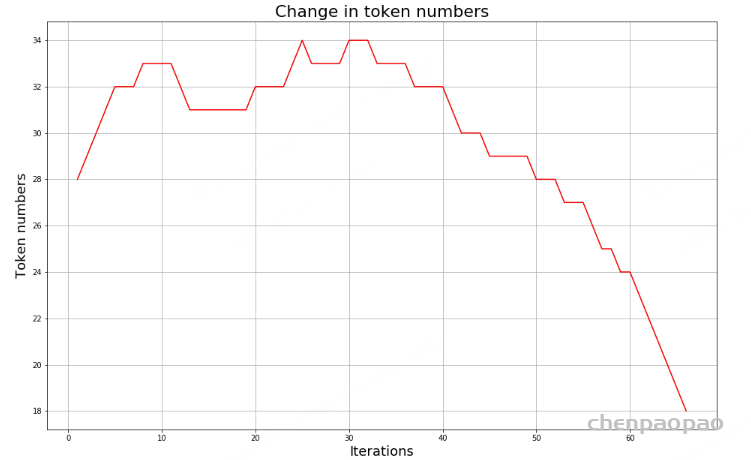
跑一个例子试一下,这里已经对原句子进行了预处理:
vocab = {'l o w </w>': 5, 'l o w e r </w>': 2, 'n e w e s t </w>': 6, 'w i d e s t </w>': 3}
print('==========')
print('Tokens Before BPE')
tokens = get_tokens(vocab)
print('Tokens: {}'.format(tokens))
print('Number of tokens: {}'.format(len(tokens)))
print('==========')

num_merges = 5
for i in range(num_merges):
    pairs = get_stats(vocab)
    if not pairs:
        break
    best = max(pairs, key=pairs.get)
    vocab = merge_vocab(best, vocab)
    print('Iter: {}'.format(i))
    print('Best pair: {}'.format(best))
    tokens = get_tokens(vocab)
    print('Tokens: {}'.format(tokens))
    print('Number of tokens: {}'.format(len(token
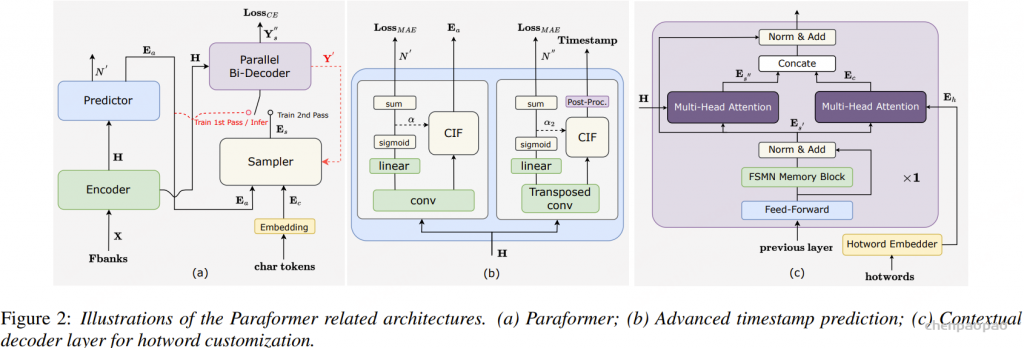
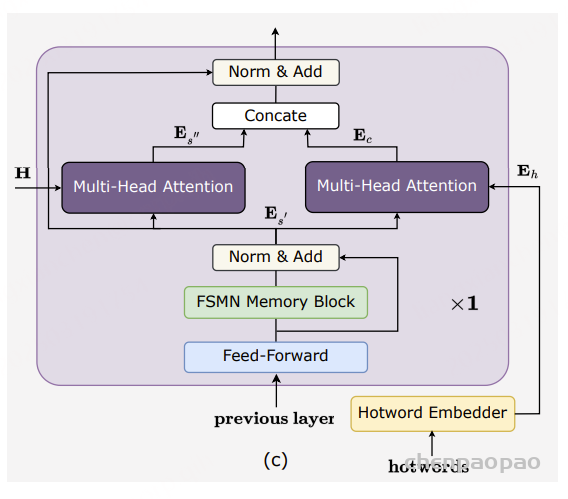
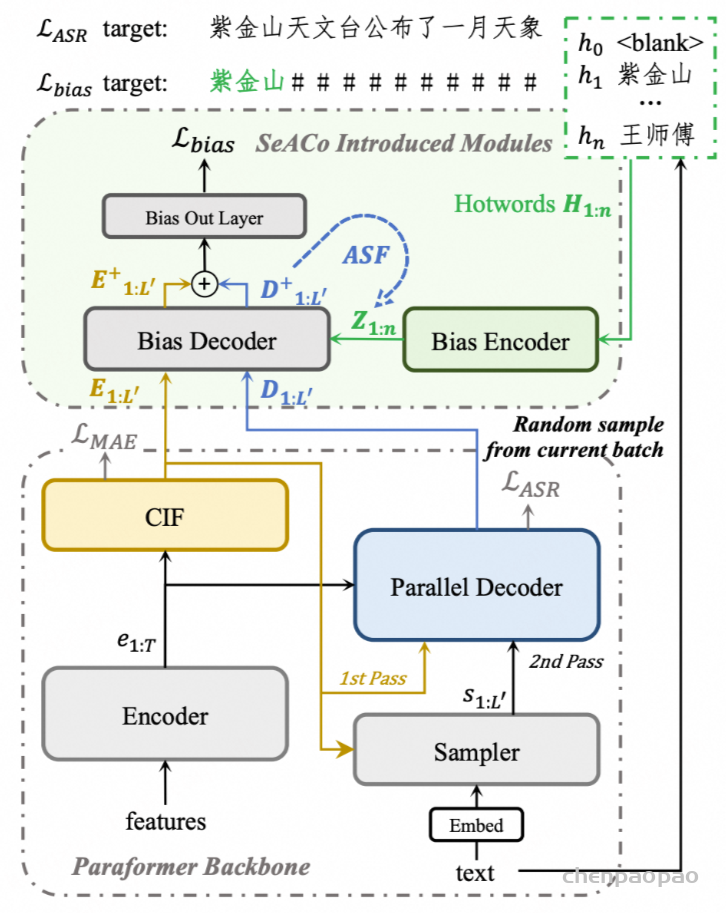
在冻结经过充分训练的 Paraformer 模型的情况下,我们通过引入偏置输出层、偏置解码器和偏置编码器,并使用随机采样的热词及其对应目标进行训练,使 ASR 系统具备热词上下文化能力。值得注意的是,偏置相关参数的训练是独立于 ASR 训练的,因此可以使用专门的热词数据(例如低频语言短语)和训练策略,而不会影响 ASR 的整体性能。
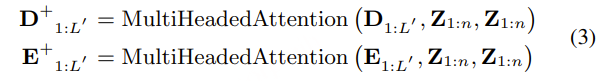
对于使用给定热词列表进行 SeACo-Paraformer 推理的第 i 步,我们得到语境化 ASR 的最终合并概率为:
在实际应用中,随着输入的热词数量的扩大,热词激活的性能会相应下降——偏见解码器内的交叉注意很难在 ASR 解码器输出 𝐃1:L′ 和大规模稀疏热词嵌入 𝐙1:n 之间建立正确的联系。为了使 SeACo-Paraformer 能够使用大规模热词列表进行热词定制,我们提出了注意分数过滤(ASF)策略。首先对全热词列表进行偏见解码器推理,得到注意分数矩阵 𝐀∈RL×n ,其中 L 是输出 token 的长度, n 是热词的数量。然后,我们将 L 中各个步骤的分数相加,得到每个热词的注意分数。根据注意分数,我们可以挑选出最活跃的 k 热词,从而进行真正有效的偏见解码器推理。与细粒度的上下文知识选择相比,我们的偏差解码器由多个交叉注意层组成,我们发现最后一层的分数对于过滤最有效。
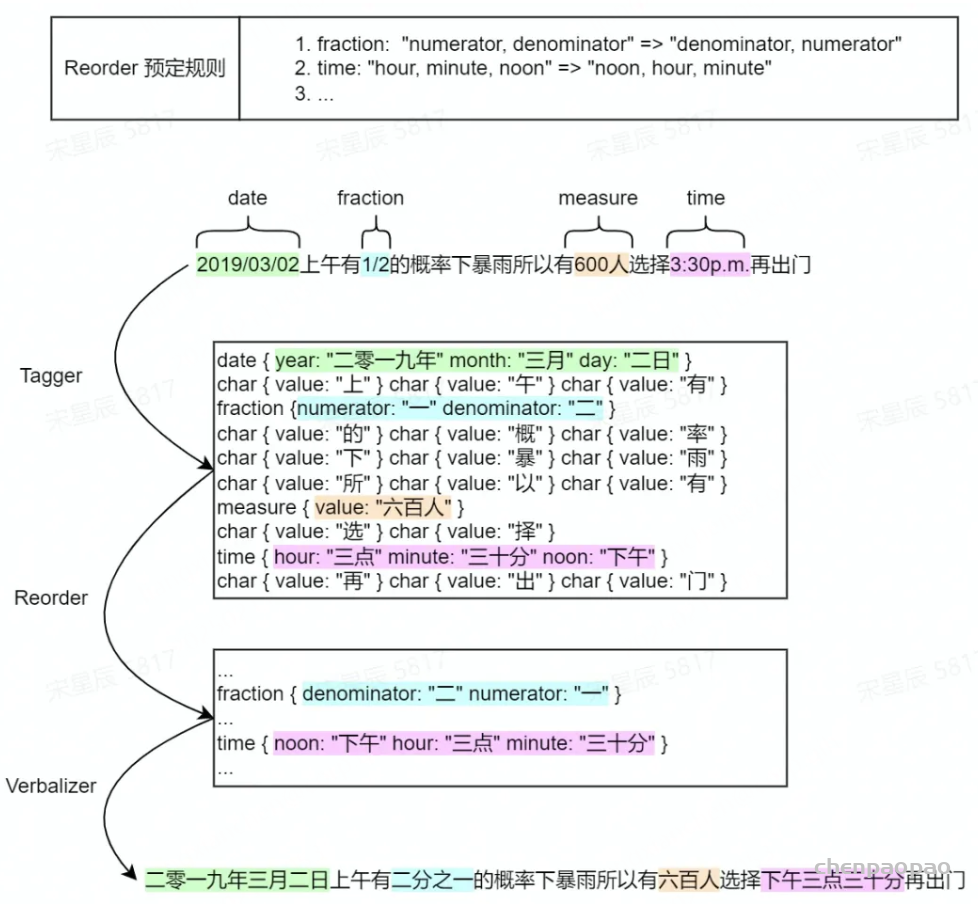
git clone https://github.com/wenet-e2e/WeTextProcessing.gitcd WeTextProcessing# `overwrite_cache` will rebuild all rules according to# your modifications on tn/chinese/rules/xx.py (itn/chinese/rules/xx.py).# After rebuild, you can find new far files at `$PWD/tn` and `$PWD/itn`.python normalize.py --text "2.5平方电线" --overwrite_cachepython inverse_normalize.py --text "二点五平方电线" --overwrite_cache
未来,WeTextProcessing 的工作将聚焦在对 Corner Case 的规则修补:相比于规则撰写,设计一套合理的测试集是一件更为困难的事情,这是因为实际生产过程中总会遇到数不清的 corner case 。WeTextProcessing 中虽然提供了一个简单的单元测试和示例测试,但其覆盖场景仍未能达到 100% 。在未来,WeTextProcessing 的重点方向之一就是越来越多地投入部署到真实的线上环境中,以身试错,case by case 分析当前规则存在的可能漏洞并加以弥补。
参考资料
[1] Peter Ebden and Richard Sproat, “The kestrel TTS text normalization system,” Nat. Lang. Eng., vol. 21, no. 3, pp. 333–353, 2015.
[2] Courtney Mansfield, Ming Sun, Yuzong Liu, Ankur Gandhe, and Björn Hoffmeister, “Neural text normalization with subword units,” in Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, NAACL-HLT 2019, Minneapolis, MN, USA, June 2-7, 2019, Volume 2 (Industry Papers), Anastassia Loukina, Michelle Morales, and Rohit Kumar, Eds. 2019, pp. 190–196, Association for Computational Linguistics.
[3] Richard Sproat and Navdeep Jaitly, “An RNN model of text normalization,” in Interspeech 2017, 18th Annual Conference of the International Speech Communication Association, Stockholm, Sweden, August 20-24, 2017, Francisco Lacerda, Ed. 2017, pp. 754–758, ISCA.
[4] Peter Ebden and Richar Sproat, “Sparrowhawk,” 2022, https://github.com/google/sparrowhawk.
[5] Yang Zhang, “nemo_text_processing,” 2022, https://github.com/NVIDIA/NeMo/tree/main/nemo_text_processing.
[6] Jiayu Du, “chinese_text_normalization,” 2022, https://github.com/speechio/chinese_text_normalization.
[7] K. Gorman. 2016. Pynini: A Python library for weighted finite-state grammar compilation. In Proceedings of the ACL Workshop on Statistical NLP and Weighted Automata, pages 75-80.



 继续迭代直到达到预设的subwords词表大小或下一个最高频的字节对出现频率为1。