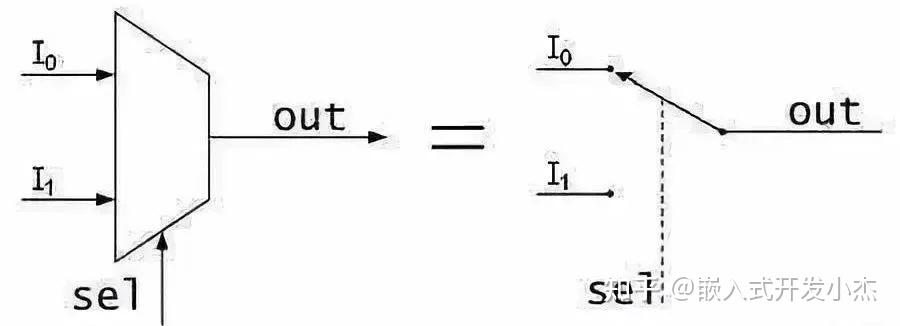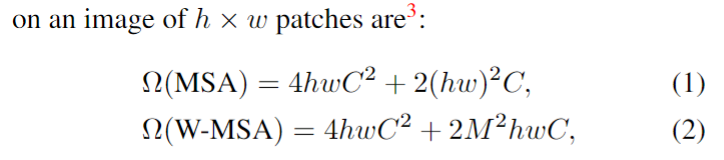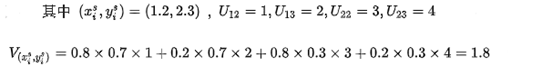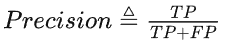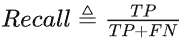pytorch如何加载不同尺寸的图片数据

如何使用dataloader加载相同维度但是不同尺寸的数据集(图片),不使用resize,crop等改变模型输入的shape。

知乎:https://www.zhihu.com/question/395888465

如果加载的数据的维度尺寸不相同的话,在迭代器中会爆出如下的错误

RuntimeError: invalid argument 0: Sizes of tensors must match except in dimension 0.

1、pytorch的dataloader默认的collate_fn会使用torch.stack合并多张图片成为batch

要么另外写一个collate_fn

要么在dataset类中对图片做padding,使得图片的size一样,可以直接stack

2、关于collate_fn:

 https://pytorch.org/docs/stable/data.html#working-with-collate-fn

The use of collate_fn is slightly different when automatic batching is enabled or disabled.

  • When automatic batching is disabledcollate_fn is called with each individual data sample, and the output is yielded from the data loader iterator. In this case, the default collate_fn simply converts NumPy arrays in PyTorch tensors.
  • When automatic batching is enabledcollate_fn is called with a list of data samples at each time. It is expected to collate the input samples into a batch for yielding from the data loader iterator. The rest of this section describes behavior of the default collate_fn in this case.

可以看到,你可以考虑关闭自动打包,这样collate_fn处理的就是独立的样本。也可以打开自动打包,这样这个函数就会被输入一个batch列表的数据。注意,这个列表的数据可以不同大小哦,知识这样你就没办法将其stack成一个完整的batch。所以,实际上你的报错,应该是这个位置出的问题。

所以可以考虑以下几种策略:

  • 单个样本输入,这样同一个batch组合的时候就不需要担心了
  • 对输入样本padding成最大的形状,组合成batch,之后送入网络的时候,你可以把数据拆分开,按你想要的将其去掉padding或者其他操作
  • 正常读取,之后再自定义的collate_fn中将数据拆开返回,这样可以返回相同结构的数据

对于最后一点,给个小demo:

class OurDataset(Dataset):
    def __init__(self, *tensors):
        self.tensors = tensors
    def __getitem__(self, index):
        return self.tensors[index]
    def __len__(self):
        return len(self.tensors)

def collate_wrapper(batch):
#函数就会输入一个batch的列表的数据(注意是batch是一个列表,所以里面的数据可以不同大小)
    a, b = batch
    return a, b

a = torch.randn(3, 2, 3)
b = torch.randn(3, 3, 4)
dataset = OurDataset(a, b)

loader = DataLoader(dataset, batch_size=2, collate_fn=collate_wrapper)

for sample in loader:
    print([x.size() for x in sample])

# Out: [torch.Size([1, 3, 2, 3]), torch.Size([1, 3, 3, 4])]

Swin Transformer 代码详解

code:https://github.com/microsoft/Swin-Transformer

代码详解: https://zhuanlan.zhihu.com/p/367111046

预处理:

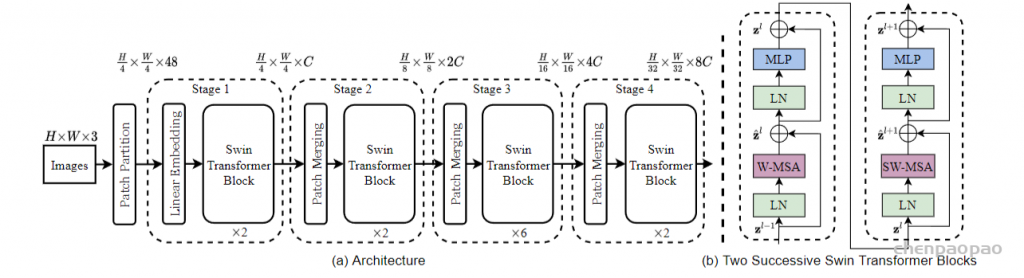
对于分类模型,输入图像尺寸为 224×224×3 ,即 H=W=224 。按照原文描述,模型先将图像分割成每块大小为 4×4 的patch,那么就会有 56×56 个patch,这就是初始resolution,也是后面每个stage会降采样的维度。后面每个stage都会降采样时长宽降到一半,特征数加倍。按照原文及原图描述,划分的每个patch具有 4×4×3=48 维特征。

  • 实际在代码中,首先使用了PatchEmbed模块(这里的PatchEmbed包括上图中的Linear Embedding 和 patch partition层),定义如下:
class PatchEmbed(nn.Module):
    def __init__(self, img_size=224, patch_size=4, in_chans=3, embed_dim=96, norm_layer=None): # embed_dim就是上图中的C超参数
        super().__init__()
        img_size = to_2tuple(img_size)
        patch_size = to_2tuple(patch_size)
        patches_resolution = [img_size[0] // patch_size[0], img_size[1] // patch_size[1]]
        self.img_size = img_size
        self.patch_size = patch_size
        self.patches_resolution = patches_resolution
        self.num_patches = patches_resolution[0] * patches_resolution[1]

        self.in_chans = in_chans
        self.embed_dim = embed_dim

        self.proj = nn.Conv2d(in_chans, embed_dim, kernel_size=patch_size, stride=patch_size)
        if norm_layer is not None:
            self.norm = norm_layer(embed_dim)
        else:
            self.norm = None

    def forward(self, x):
        B, C, H, W = x.shape
        # FIXME look at relaxing size constraints
        assert H == self.img_size[0] and W == self.img_size[1], \
            f"Input image size ({H}*{W}) doesn't match model ({self.img_size[0]}*{self.img_size[1]})."
        x = self.proj(x).flatten(2).transpose(1, 2)  # B Ph*Pw C
        if self.norm is not None:
            x = self.norm(x)
        return x

可以看到,实际操作使用了一个卷积层conv2d(3, 96, 4, 4),直接就做了划分patch和编码初始特征的工作,对于输入 x:B×3×224×224 ,经过一层conv2d和LayerNorm得到 x:B×562×96 。然后作为对比,可以选择性地加上每个patch的绝对位置编码,原文实验表示这种做法不好,因此不会采用(ape=false)。最后经过一层dropout,至此,预处理完成。另外,要注意的是,代码和上面流程图并不符,其实在stage 1之前,即预处理完成后,维度已经是 H/4×W/4×C ,stage 1之后已经是 H/8×W/8×2C ,不过在stage 4后不再降采样,得到的还是 H/32×W/32×8C 。

stage处理

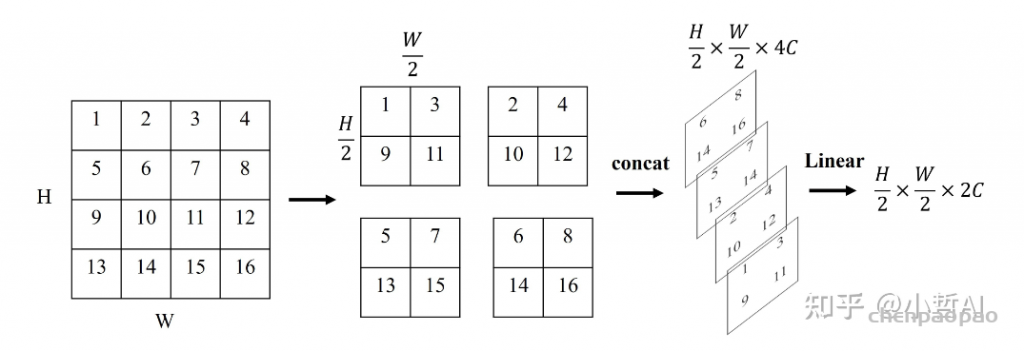
我们先梳理整个stage的大体过程,把简单的部分先说了,再深入到复杂得的细节。每个stage,即代码中的BasicLayer,由若干个block组成,而block的数目由depth列表中的元素决定。每个block就是W-MSA(window-multihead self attention)或者SW-MSA(shift window multihead self attention),一般有偶数个block,两种SA交替出现,比如6个block,0,2,4是W-MSA,1,3,5是SW-MSA。在经历完一个stage后,会进行下采样,定义的下采样比较有意思。比如还是 56×56 个patch,四个为一组,分别取每组中的左上,右上、左下、右下堆叠一起,经过一个layernorm,linear层,实现维度下采样、特征加倍的效果。实际上它可以看成一种加权池化的过程。代码如下:

class PatchMerging(nn.Module):
    def __init__(self, input_resolution, dim, norm_layer=nn.LayerNorm):
        super().__init__()
        self.input_resolution = input_resolution
        self.dim = dim
        self.reduction = nn.Linear(4 * dim, 2 * dim, bias=False)
        self.norm = norm_layer(4 * dim)

    def forward(self, x):
        """
        x: B, H*W, C
        """
        H, W = self.input_resolution
        B, L, C = x.shape
        assert L == H * W, "input feature has wrong size"
        assert H % 2 == 0 and W % 2 == 0, f"x size ({H}*{W}) are not even."

        x = x.view(B, H, W, C)

        x0 = x[:, 0::2, 0::2, :]  # B H/2 W/2 C
        x1 = x[:, 1::2, 0::2, :]  # B H/2 W/2 C
        x2 = x[:, 0::2, 1::2, :]  # B H/2 W/2 C
        x3 = x[:, 1::2, 1::2, :]  # B H/2 W/2 C
        x = torch.cat([x0, x1, x2, x3], -1)  # B H/2 W/2 4*C
        x = x.view(B, -1, 4 * C)  # B H/2*W/2 4*C

        x = self.norm(x)
        x = self.reduction(x)

        return x

在经历完4个stage后,得到的是 (H/32×W/32)×8C 的特征,将其转到 8C×(H/32×W/32) 后,接一个AdaptiveAvgPool1d(1),全局平均池化,得到 8C 特征,最后接一个分类器。

PatchMerging

Block处理

SwinTransformerBlock的结构,由LayerNorm层、windowAttention层(Window MultiHead self -attention, W-MSA)、MLP层以及shiftWindowAttention层(SW-MSA)组成。

上面说到有两种block,block的代码如下:

class SwinTransformerBlock(nn.Module):
    r""" Swin Transformer Block.

    Args:
        dim (int): Number of input channels.
        input_resolution (tuple[int]): Input resulotion.
        num_heads (int): Number of attention heads.
        window_size (int): Window size.
        shift_size (int): Shift size for SW-MSA.
        mlp_ratio (float): Ratio of mlp hidden dim to embedding dim.
        qkv_bias (bool, optional): If True, add a learnable bias to query, key, value. Default: True
        qk_scale (float | None, optional): Override default qk scale of head_dim ** -0.5 if set.
        drop (float, optional): Dropout rate. Default: 0.0
        attn_drop (float, optional): Attention dropout rate. Default: 0.0
        drop_path (float, optional): Stochastic depth rate. Default: 0.0
        act_layer (nn.Module, optional): Activation layer. Default: nn.GELU
        norm_layer (nn.Module, optional): Normalization layer.  Default: nn.LayerNorm
    """

    def __init__(self, dim, input_resolution, num_heads, window_size=7, shift_size=0,
                 mlp_ratio=4., qkv_bias=True, qk_scale=None, drop=0., attn_drop=0., drop_path=0.,
                 act_layer=nn.GELU, norm_layer=nn.LayerNorm):
        super().__init__()
        self.dim = dim
        self.input_resolution = input_resolution
        self.num_heads = num_heads
        self.window_size = window_size
        self.shift_size = shift_size
        self.mlp_ratio = mlp_ratio
        if min(self.input_resolution) <= self.window_size:
            # if window size is larger than input resolution, we don't partition windows
            self.shift_size = 0
            self.window_size = min(self.input_resolution)
        assert 0 <= self.shift_size < self.window_size, "shift_size must in 0-window_size"

        # 左图中最下边的LN层layerNorm层
        self.norm1 = norm_layer(dim)
        # W_MSA层或者SW-MSA层,详细的介绍看WindowAttention部分的代码
        self.attn = WindowAttention(
            dim, window_size=to_2tuple(self.window_size), num_heads=num_heads,
            qkv_bias=qkv_bias, qk_scale=qk_scale, attn_drop=attn_drop, proj_drop=drop)

        self.drop_path = DropPath(drop_path) if drop_path > 0. else nn.Identity()
        # 左图中间部分的LN层
        self.norm2 = norm_layer(dim)
        mlp_hidden_dim = int(dim * mlp_ratio)
        # 左图最上边的MLP层
        self.mlp = Mlp(in_features=dim, hidden_features=mlp_hidden_dim, act_layer=act_layer, drop=drop)

        # 这里利用shift_size控制是否执行shift window操作
        # 当shift_size为0时,不执行shift操作,对应W-MSA,也就是在每个stage中,W-MSA与SW-MSA交替出现
        # 例如第一个stage中存在两个block,那么第一个shift_size=0就是W-MSA,第二个shift_size不为0
        # 就是SW-MSA
        if self.shift_size > 0:
            # calculate attention mask for SW-MSA
            H, W = self.input_resolution
            img_mask = torch.zeros((1, H, W, 1))  # 1 H W 1
#slice() 函数实现切片对象,主要用在切片操作函数里的参数传递。class slice(start, stop[, step])
            h_slices = (slice(0, -self.window_size),
                        slice(-self.window_size, -self.shift_size),
                        slice(-self.shift_size, None))
            w_slices = (slice(0, -self.window_size),
                        slice(-self.window_size, -self.shift_size),
                        slice(-self.shift_size, None))
            cnt = 0
            for h in h_slices:
                for w in w_slices:
                    img_mask[:, h, w, :] = cnt
                    cnt += 1
## 上述操作是为了给每个窗口给上索引

            mask_windows = window_partition(img_mask, self.window_size)  # nW, window_size, window_size, 1
            mask_windows = mask_windows.view(-1, self.window_size * self.window_size)
            attn_mask = mask_windows.unsqueeze(1) - mask_windows.unsqueeze(2)
            attn_mask = attn_mask.masked_fill(attn_mask != 0, float(-100.0)).masked_fill(attn_mask == 0, float(0.0))
        else:
            attn_mask = None

        self.register_buffer("attn_mask", attn_mask)

    def forward(self, x):
        H, W = self.input_resolution
        B, L, C = x.shape
        assert L == H * W, "input feature has wrong size"

        shortcut = x
        x = self.norm1(x)
        x = x.view(B, H, W, C)

        # cyclic shift
        # 如果需要计算 SW-MSA就需要进行循环移位。
        if self.shift_size > 0:
            shifted_x = torch.roll(x, shifts=(-self.shift_size, -self.shift_size), dims=(1, 2))
        else:
            shifted_x = x

        # partition windows
        x_windows = window_partition(shifted_x, self.window_size)  # nW*B, window_size, window_size, C
        x_windows = x_windows.view(-1, self.window_size * self.window_size, C)  # nW*B, window_size*window_size, C

        # W-MSA/SW-MSA
        attn_windows = self.attn(x_windows, mask=self.attn_mask)  # nW*B, window_size*window_size, C

        # merge windows
        attn_windows = attn_windows.view(-1, self.window_size, self.window_size, C)
        shifted_x = window_reverse(attn_windows, self.window_size, H, W)  # B H' W' C

        # reverse cyclic shift
        if self.shift_size > 0:
#shifts (python:int 或 tuple of python:int) —— 张量元素移位的位数。如果该参数是一个元组(例如shifts=(x,y)),dims必须是一个相同大小的元组(例如dims=(a,b)),相当于在第a维度移x位,在b维度移y位
            x = torch.roll(shifted_x, shifts=(self.shift_size, self.shift_size), dims=(1, 2))
        else:
            x = shifted_x
        x = x.view(B, H * W, C)

        # FFN
        x = shortcut + self.drop_path(x)
        x = x + self.drop_path(self.mlp(self.norm2(x)))

        return x

    def extra_repr(self) -> str:
        return f"dim={self.dim}, input_resolution={self.input_resolution}, num_heads={self.num_heads}, " \
               f"window_size={self.window_size}, shift_size={self.shift_size}, mlp_ratio={self.mlp_ratio}"

    def flops(self):
        flops = 0
        H, W = self.input_resolution
        # norm1
        flops += self.dim * H * W
        # W-MSA/SW-MSA
        nW = H * W / self.window_size / self.window_size
        flops += nW * self.attn.flops(self.window_size * self.window_size)
        # mlp
        flops += 2 * H * W * self.dim * self.dim * self.mlp_ratio
        # norm2
        flops += self.dim * H * W
        return flops

W-MSA

W-MSA比较简单,只要其中shift_size设置为0就是W-MSA。下面跟着代码走一遍过程。

  • 输入: x:B×562×96 , H,W=56
  • 经过一层layerNorm
  • 变形: x:B×56×56×96
  • 直接赋值给shifted_x
  • 调用window_partition函数,输入shifted_xwindow_size=7
  • 注意窗口大小以patch为单位,比如7就是7个patch,如果56的分辨率就会有8个窗口。
  • 这个函数对shifted_x做一系列变形,最终变成 82B×7×7×96
  • 返回赋值给x_windows,再变形成 82B×72×96 ,这表示所有图片,每个图片的64个window,每个window内有49个patch。
  • 调用WindowAttention层,这里以它的num_head为3为例。输入参数为x_windowsself.attn_mask,对于W-MSA,attn_mask为None,可以不用管。

WindowAttention代码如下:

代码中使用7×7的windowsize,将feature map分割为不同的window,在每个window中计算自注意力。

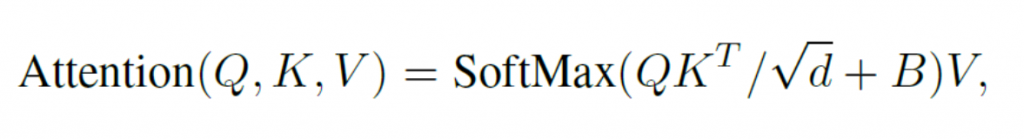
Self-attention的计算公式(B为相对位置编码)

绝对位置编码是在进行self-attention计算之前为每一个token添加一个可学习的参数,相对位置编码如上式所示,是在进行self-attention计算时,在计算过程中添加一个可学习的相对位置参数。

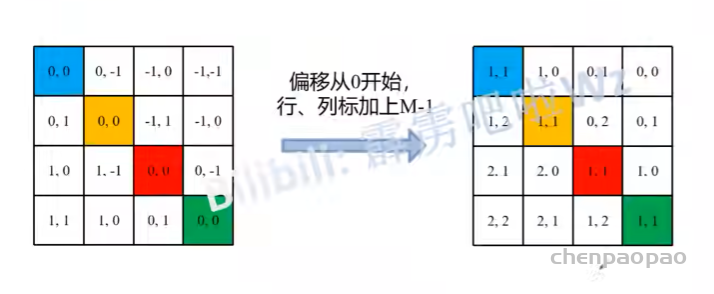
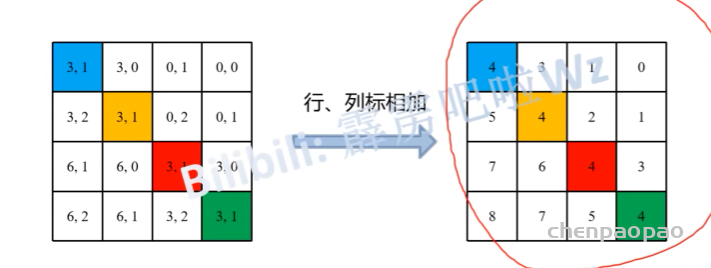
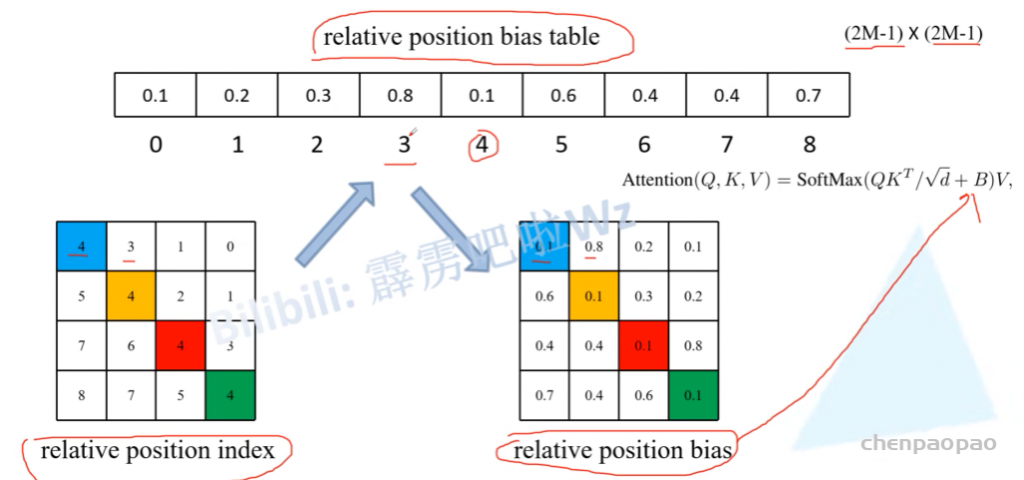
假设window_size = 2*2即每个窗口有4个token (M=2) ,如图1所示,在计算self-attention时,每个token都要与所有的token计算QK值,如图6所示,当位置1的token计算self-attention时,要计算位置1与位置(1,2,3,4)的QK值,即以位置1的token为中心点,中心点位置坐标(0,0),其他位置计算与当前位置坐标的偏移量。

坐标变换
坐标变换
相对位置索引求解流程图

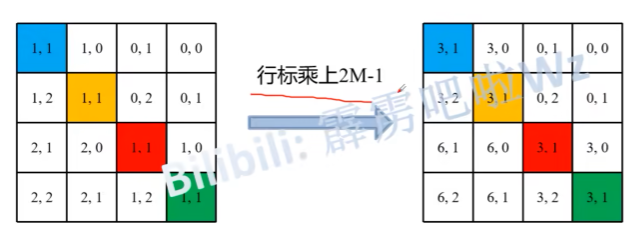
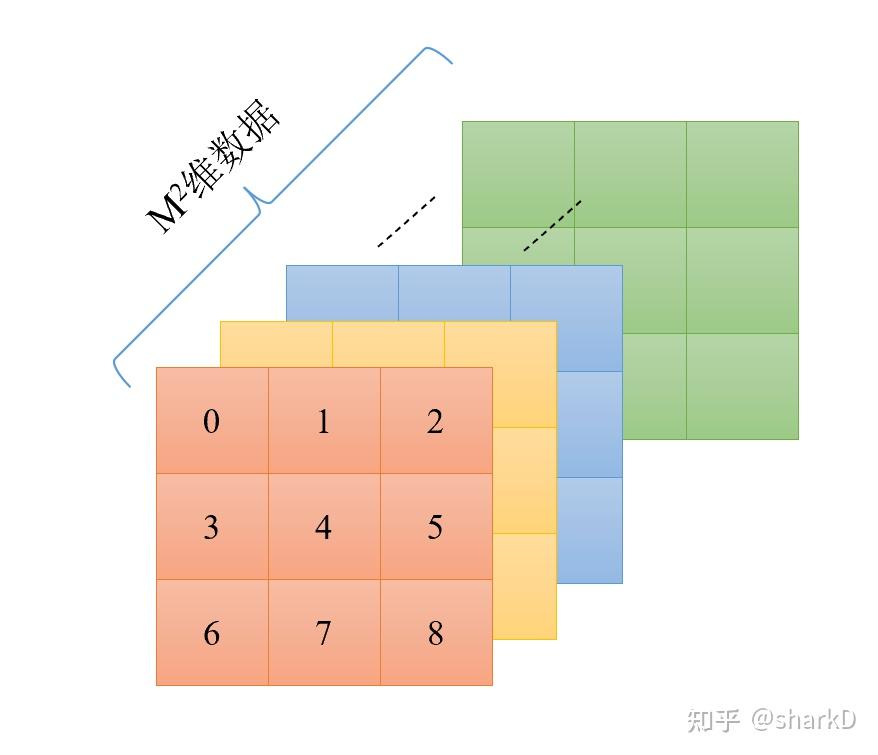
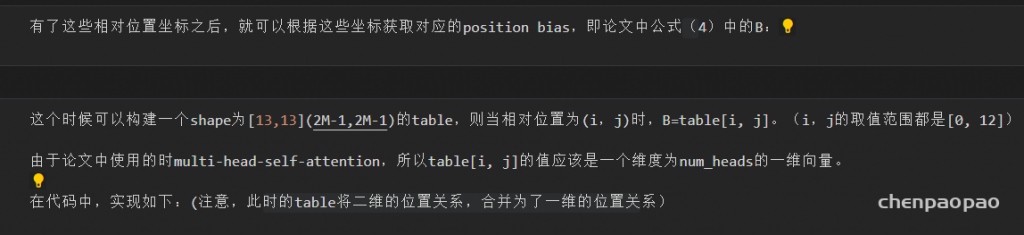
最后生成的是相对位置索引,relative_position_index.shape = (M2,M2) ,在网络中注册成为一个不可学习的变量,relative_position_index的作用就是根据最终的索引值找到对应的可学习的相对位置编码。relative_position_index的数值范围(0~8),即 (2M−1)∗(2M−1) ,所以相对位置编码(relative position bias table)可以由一个3*3的矩阵表示,如图7所示:这样就根据index对应位置的索引找到table对应位置的值作为相对位置编码。

图7 相对位置编码

图7中的0-8为索引值,每个索引值都对应了 M2 维可学习数据(每个token都要计算 M2 个QK值,每个QK值都要加上对应的相对位置编码)

继续以图6中 M=2 的窗口为例,当计算位置1对应的 M2 个QK值时,应用的relative_position_index = [ 4, 5, 7, 8] (M2)个 ,对应的数据就是图7中位置索引4,5,7,8位置对应的 M2 维数据,即relative_position.shape = (M2∗M2)

相对位置编码在源码WindowAttention中应用,了解原理之后就很容易能够读懂程序:

class WindowAttention(nn.Module):
    r""" Window based multi-head self attention (W-MSA) module with relative position bias.
    It supports both of shifted and non-shifted window.

    Args:
        dim (int): Number of input channels.
        window_size (tuple[int]): The height and width of the window.
        num_heads (int): Number of attention heads.
        qkv_bias (bool, optional):  If True, add a learnable bias to query, key, value. Default: True
        qk_scale (float | None, optional): Override default qk scale of head_dim ** -0.5 if set
        attn_drop (float, optional): Dropout ratio of attention weight. Default: 0.0
        proj_drop (float, optional): Dropout ratio of output. Default: 0.0
    """

    def __init__(self, dim, window_size, num_heads, qkv_bias=True, qk_scale=None, attn_drop=0., proj_drop=0.):

        super().__init__()
        self.dim = dim # 输入通道的数量
        self.window_size = window_size  # Wh, Ww
        self.num_heads = num_heads
        head_dim = dim // num_heads
        self.scale = qk_scale or head_dim ** -0.5

        # define a parameter table of relative position bias
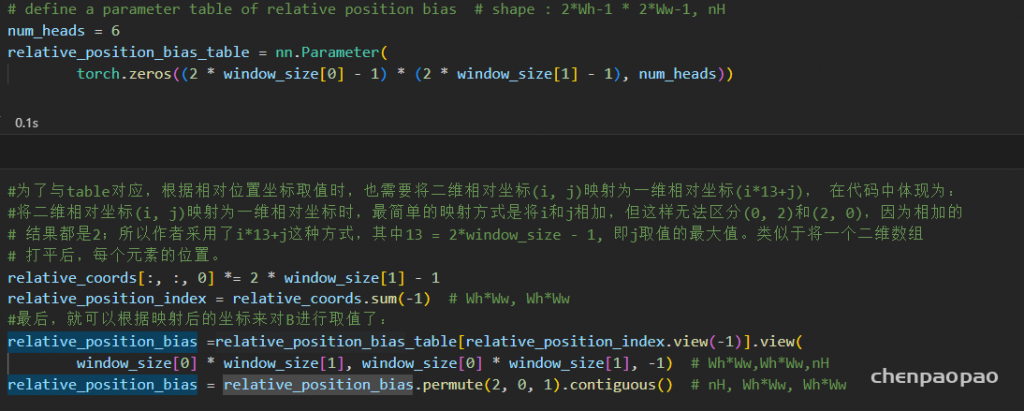
        self.relative_position_bias_table = nn.Parameter(
            torch.zeros((2 * window_size[0] - 1) * (2 * window_size[1] - 1), num_heads))  # 2*Wh-1 * 2*Ww-1, nH  初始化表

        # get pair-wise relative position index for each token inside the window
        coords_h = torch.arange(self.window_size[0]) # coords_h = tensor([0,1,2,...,self.window_size[0]-1])  维度=Wh
        coords_w = torch.arange(self.window_size[1]) # coords_w = tensor([0,1,2,...,self.window_size[1]-1])  维度=Ww

        coords = torch.stack(torch.meshgrid([coords_h, coords_w]))  # 2, Wh, Ww
        coords_flatten = torch.flatten(coords, 1)  # 2, Wh*Ww


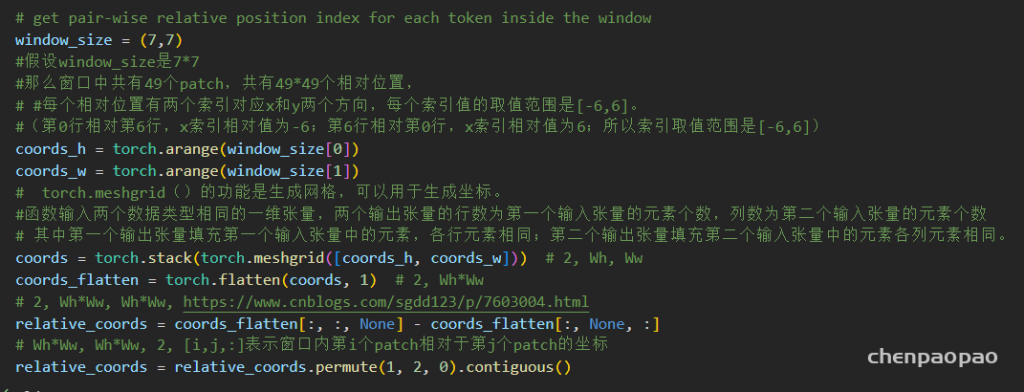
        relative_coords = coords_flatten[:, :, None] - coords_flatten[:, None, :]  # 2, Wh*Ww, Wh*Ww
        relative_coords = relative_coords.permute(1, 2, 0).contiguous()  # Wh*Ww, Wh*Ww, 2
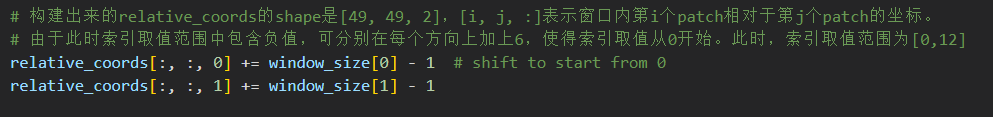
        relative_coords[:, :, 0] += self.window_size[0] - 1  # shift to start from 0
        relative_coords[:, :, 1] += self.window_size[1] - 1

        '''
        后面我们需要将其展开成一维偏移量。而对于(2,1)和(1,2)这两个坐标,在二维上是不同的,但是通过将x\y坐标相加转换为一维偏移的时候
        他们的偏移量是相等的,所以需要对其做乘法操作,进行区分
        '''

        relative_coords[:, :, 0] *= 2 * self.window_size[1] - 1
        # 计算得到相对位置索引
        # relative_position_index.shape = (M2, M2) 意思是一共有这么多个位置
        relative_position_index = relative_coords.sum(-1)  # Wh*Ww, Wh*Ww 

        '''
        relative_position_index注册为一个不参与网络学习的变量
        '''
        self.register_buffer("relative_position_index", relative_position_index)

        self.qkv = nn.Linear(dim, dim * 3, bias=qkv_bias)
        self.attn_drop = nn.Dropout(attn_drop)
        self.proj = nn.Linear(dim, dim)
        self.proj_drop = nn.Dropout(proj_drop)

        '''
        使用从截断正态分布中提取的值填充输入张量
        self.relative_position_bias_table 是全0张量,通过trunc_normal_ 进行数值填充
        '''
        trunc_normal_(self.relative_position_bias_table, std=.02)
        self.softmax = nn.Softmax(dim=-1)

    def forward(self, x, mask=None):
        """
        Args:
            x: input features with shape of (num_windows*B, N, C)
            N: number of all patches in the window
            C: 输入通过线性层转化得到的维度C
            mask: (0/-inf) mask with shape of (num_windows, Wh*Ww, Wh*Ww) or None
        """
        B_, N, C = x.shape
        '''
        x.shape = (num_windows*B, N, C)
        self.qkv(x).shape = (num_windows*B, N, 3C)
        self.qkv(x).reshape(B_, N, 3, self.num_heads, C // self.num_heads).shape = (num_windows*B, N, 3, num_heads, C//num_heads)
        self.qkv(x).reshape(B_, N, 3, self.num_heads, C // self.num_heads).permute(2, 0, 3, 1, 4).shape = (3, num_windows*B, num_heads, N, C//num_heads)
        '''
        qkv = self.qkv(x).reshape(B_, N, 3, self.num_heads, C // self.num_heads).permute(2, 0, 3, 1, 4)
        '''
        q.shape = k.shape = v.shape = (num_windows*B, num_heads, N, C//num_heads)
        N = M2 代表patches的数量
        C//num_heads代表Q,K,V的维数
        '''
        q, k, v = qkv[0], qkv[1], qkv[2]  # make torchscript happy (cannot use tensor as tuple)

        # q乘上一个放缩系数,对应公式中的sqrt(d)
        q = q * self.scale

        # attn.shape = (num_windows*B, num_heads, N, N)  N = M2 代表patches的数量
        attn = (q @ k.transpose(-2, -1))

        '''
        self.relative_position_bias_table.shape = (2*Wh-1 * 2*Ww-1, nH)
        self.relative_position_index.shape = (Wh*Ww, Wh*Ww)
        self.relative_position_index矩阵中的所有值都是从self.relative_position_bias_table中取的
        self.relative_position_index是计算出来不可学习的量
        '''
        relative_position_bias = self.relative_position_bias_table[self.relative_position_index.view(-1)].view(
            self.window_size[0] * self.window_size[1], self.window_size[0] * self.window_size[1], -1)  # Wh*Ww,Wh*Ww,nH
        relative_position_bias = relative_position_bias.permute(2, 0, 1).contiguous()  # nH, Wh*Ww, Wh*Ww

        '''
        attn.shape = (num_windows*B, num_heads, M2, M2)  N = M2 代表patches的数量
        .unsqueeze(0):扩张维度,在0对应的位置插入维度1
        relative_position_bias.unsqueeze(0).shape = (1, num_heads, M2, M2)
        num_windows*B 通过广播机制传播,relative_position_bias.unsqueeze(0).shape = (1, nH, M2, M2) 的维度1会broadcast到数量num_windows*B
        表示所有batch通用一个索引矩阵和相对位置矩阵
        '''
        attn = attn + relative_position_bias.unsqueeze(0)

        # mask.shape = (num_windows, M2, M2)
        # attn.shape = (num_windows*B, num_heads, M2, M2)
        if mask is not None:
            nW = mask.shape[0]
            # attn.view(B_ // nW, nW, self.num_heads, N, N).shape = (B, num_windows, num_heads, M2, M2) 第一个M2代表有M2个token,第二个M2代表每个token要计算M2次QKT的值
            # mask.unsqueeze(1).unsqueeze(0).shape =                (1, num_windows, 1,         M2, M2) 第一个M2代表有M2个token,第二个M2代表每个token要计算M2次QKT的值
            # broadcast相加
            attn = attn.view(B_ // nW, nW, self.num_heads, N, N) + mask.unsqueeze(1).unsqueeze(0)
            # attn.shape = (B, num_windows, num_heads, M2, M2)
            attn = attn.view(-1, self.num_heads, N, N)
            attn = self.softmax(attn)
        else:
            attn = self.softmax(attn)

        attn = self.attn_drop(attn)

        '''
        v.shape = (num_windows*B, num_heads, M2, C//num_heads)  N=M2 代表patches的数量, C//num_heads代表输入的维度
        attn.shape = (num_windows*B, num_heads, M2, M2)
        attn@v .shape = (num_windows*B, num_heads, M2, C//num_heads)
        '''
        x = (attn @ v).transpose(1, 2).reshape(B_, N, C)   # B_:num_windows*B  N:M2  C=num_heads*C//num_heads

        #   self.proj = nn.Linear(dim, dim)  dim = C
        #   self.proj_drop = nn.Dropout(proj_drop)
        x = self.proj(x)
        x = self.proj_drop(x)
        return x  # x.shape = (num_windows*B, N, C)  N:窗口中所有patches的数量

    def extra_repr(self) -> str:
        return f'dim={self.dim}, window_size={self.window_size}, num_heads={self.num_heads}'

    def flops(self, N):
        # calculate flops for 1 window with token length of N
        flops = 0
        # qkv = self.qkv(x)
        flops += N * self.dim * 3 * self.dim
        # attn = (q @ k.transpose(-2, -1))
        flops += self.num_heads * N * (self.dim // self.num_heads) * N
        #  x = (attn @ v)
        flops += self.num_heads * N * N * (self.dim // self.num_heads)
        # x = self.proj(x)
        flops += N * self.dim * self.dim
        return flops

在上述程序中有一段mask相关程序:

if mask is not None:
            nW = mask.shape[0]
            # attn.view(B_ // nW, nW, self.num_heads, N, N).shape = (B, num_windows, num_heads, M2, M2) 第一个M2代表有M2个token,第二个M2代表每个token要计算M2次QKT的值
            # mask.unsqueeze(1).unsqueeze(0).shape =                (1, num_windows, 1,         M2, M2) 第一个M2代表有M2个token,第二个M2代表每个token要计算M2次QKT的值
            # broadcast相加
            attn = attn.view(B_ // nW, nW, self.num_heads, N, N) + mask.unsqueeze(1).unsqueeze(0)
            # attn.shape = (B, num_windows, num_heads, M2, M2)
            attn = attn.view(-1, self.num_heads, N, N)
            attn = self.softmax(attn)
        else:
            attn = self.softmax(attn)

这个部分对应的是Swin Transformer Block 中的SW-MSA

  • 输入 x:82B×72×96 。
  • 产生 QKV ,调用线性层后,得到 82B×72×(96×3) ,拆分给不同的head,得到 82B×72×3×3×32 ,第一个3是 QKV 的3,第二个3是3个head。再permute成 3×82B×3×72×32 ,再拆解成 q,k,v ,每个都是 82B×3×72×32 。表示所有图片的每个图片64个window,每个window对应到3个不同的head,都有一套49个patch、32维的特征。
  • q 归一化
  • qk 矩阵相乘求特征内积,得到 attn:82B×3×72×72
  • 得到相对位置的编码信息relative_position_bias
    • 代码如下:
self.relative_position_bias_table = nn.Parameter(
            torch.zeros((2 * window_size[0] - 1) * (2 * window_size[1] - 1), num_heads))  # 2*Wh-1 * 2*Ww-1, nH

# get pair-wise relative position index for each token inside the window
coords_h = torch.arange(self.window_size[0])
coords_w = torch.arange(self.window_size[1])
coords = torch.stack(torch.meshgrid([coords_h, coords_w]))  # 2, Wh, Ww
coords_flatten = torch.flatten(coords, 1)  # 2, Wh*Ww
relative_coords = coords_flatten[:, :, None] - coords_flatten[:, None, :]  # 2, Wh*Ww, Wh*Ww
relative_coords = relative_coords.permute(1, 2, 0).contiguous()  # Wh*Ww, Wh*Ww, 2
relative_coords[:, :, 0] += self.window_size[0] - 1  # shift to start from 0
relative_coords[:, :, 1] += self.window_size[1] - 1
relative_coords[:, :, 0] *= 2 * self.window_size[1] - 1
relative_position_index = relative_coords.sum(-1)  # Wh*Ww, Wh*Ww
self.register_buffer("relative_position_index", relative_position_index)
  • 这里以window_size=3为例,解释以下过程:首先生成 coords:2×3×3 ,就是在一个 3×3 的窗口内,每个位置的 y,x 坐标,而relative_coords为 2×9×9 ,就是9个点中,每个点的 y 或 x 与其他所有点的差值,比如 [0][3][1] 表示3号点(第二行第一个点)与1号点(第一行第二个点)的 y 坐标的差值。然后变形,并让两个坐标分别加上 3−1=2 ,是因为这些坐标值范围 [0,2] ,因此差值的最小值为-2,加上2后从0开始。最后让 y 坐标乘上 2×3−1=5 ,应该是一个trick,调整差值范围。最后将两个维度的差值相加,得到relative_position_index, 32×32 ,为9个点之间两两之间的相对位置编码值,最后用来到self.relative_position_bias_table中寻址,注意相对位置的最大值为 (2M−2)(2M−1) ,而这个table最多有 (2M−1)(2M−1) 行,因此保证可以寻址,得到了一组给多个head使用的相对位置编码信息,这个table是可训练的参数。
  • 回到代码中,得到的relative_position_bias为 3×72×72
  • 将其加到attn上,最后一个维度softmax,dropout
  • 与 v 矩阵相乘,并转置,合并多个头的信息,得到 82B×72×96
  • 经过一层线性层,dropout,返回
  • 返回赋值给attn_windows,变形为 82B×7×7×96
  • 调用window_reverse,打回原状: B×56×56×96
  • 返回给 x ,经过FFN:先加上原来的输入 x 作为residue结构,注意这里用到timmDropPath,并且drop的概率是整个网络结构线性增长的。然后再加上两层mlp的结果。
  • 返回结果 x 。

这样,整个过程就完成了,剩下的就是SW-MSA的一些不同的操作。

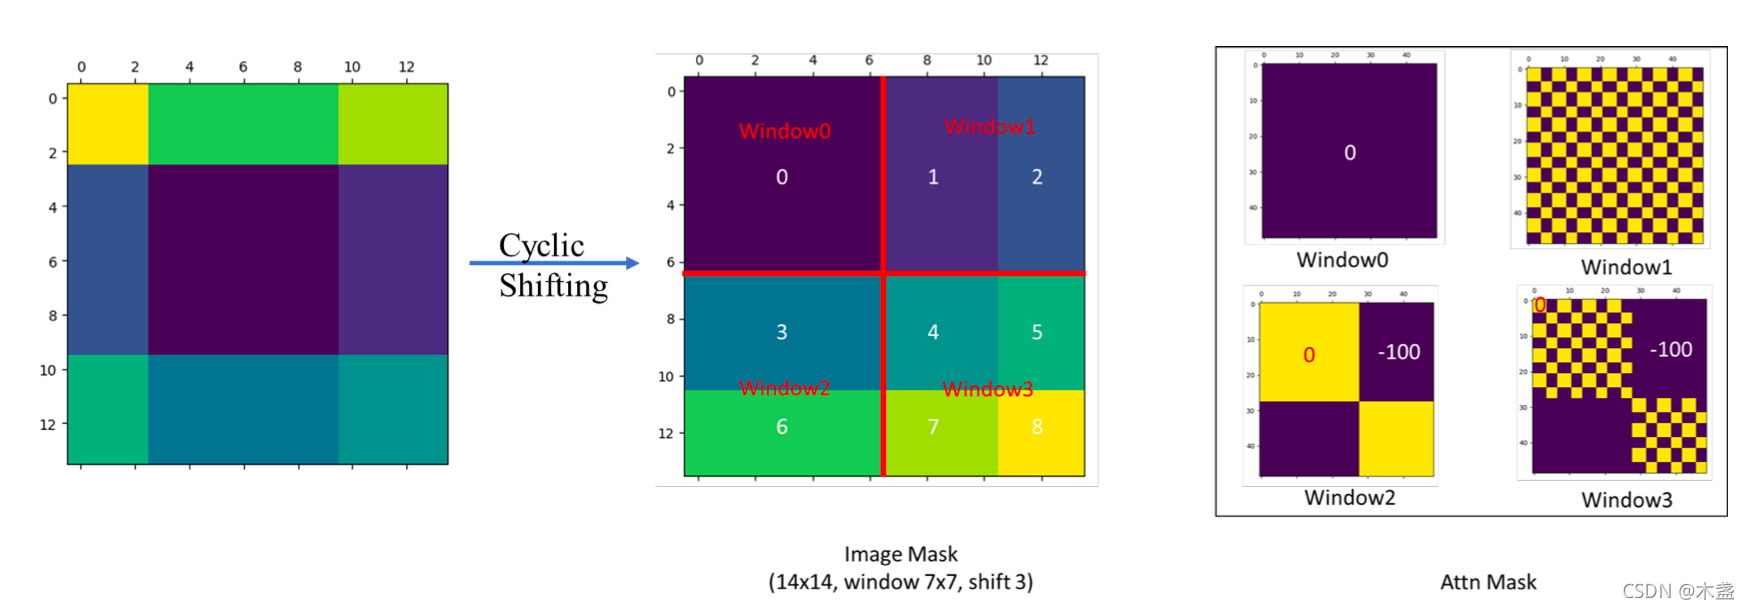
  1. 首先将windows进行半个窗口的循环移位,上图中的1, 2步骤,使用torch.roll实现。
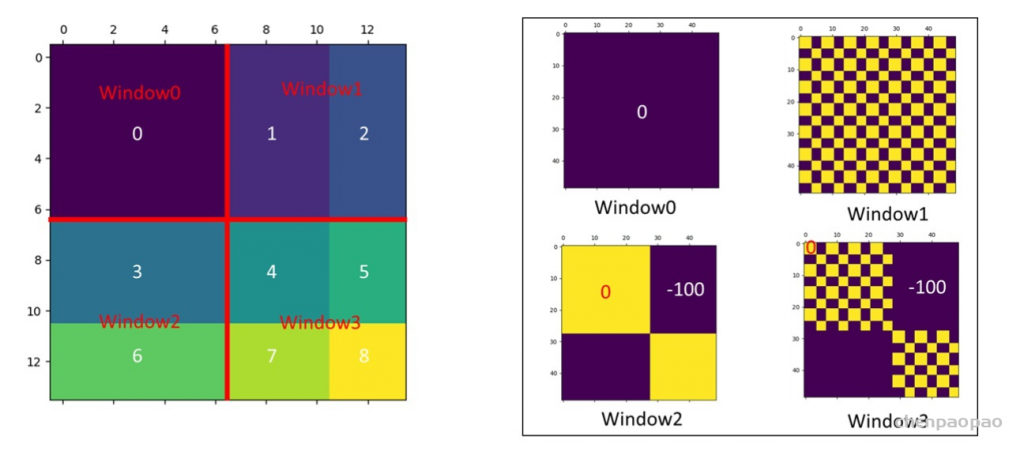
  2. 在相同的窗口中计算自注意力,计算结果如下右图所示,window0的结构保存,但是针对window2的计算,其中3与3、6与6的计算生成了attn mask 中window2中的黄色区域,针对windows2中3与6、6与3之间不应该计算自注意力(attn mask中window2的蓝色区域),将蓝色区域mask赋值为-100,经过softmax之后,起作用可以忽略不计。同理window1与window3的计算一致。
  3. 最后再进行循环移位,恢复原来的位置。

原论文图中的Stage和程序中的一个Stage不同:

程序中的BasicLayer为一个Stage,在BasicLayer中调用了上面讲到的SwinTransformerBlock和PatchMerging模块:

class BasicLayer(nn.Module):  # 论文图中每个stage里对应的若干个SwinTransformerBlock
    """ A basic Swin Transformer layer for one stage.

    Args:
        dim (int): Number of input channels.
        input_resolution (tuple[int]): Input resolution.
        depth (int): Number of blocks.
        num_heads (int): Number of attention heads.
        window_size (int): Local window size.
        mlp_ratio (float): Ratio of mlp hidden dim to embedding dim.
        qkv_bias (bool, optional): If True, add a learnable bias to query, key, value. Default: True
        qk_scale (float | None, optional): Override default qk scale of head_dim ** -0.5 if set.
        drop (float, optional): Dropout rate. Default: 0.0
        attn_drop (float, optional): Attention dropout rate. Default: 0.0
        drop_path (float | tuple[float], optional): Stochastic depth rate. Default: 0.0
        norm_layer (nn.Module, optional): Normalization layer. Default: nn.LayerNorm
        downsample (nn.Module | None, optional): Downsample layer at the end of the layer. Default: None
        use_checkpoint (bool): Whether to use checkpointing to save memory. Default: False.
    """

    def __init__(self, dim, input_resolution, depth, num_heads, window_size,
                 mlp_ratio=4., qkv_bias=True, qk_scale=None, drop=0., attn_drop=0.,
                 drop_path=0., norm_layer=nn.LayerNorm, downsample=None, use_checkpoint=False):

        super().__init__()
        self.dim = dim
        self.input_resolution = input_resolution
        self.depth = depth # swin_transformer blocks的个数
        self.use_checkpoint = use_checkpoint

        # build blocks  从0开始的偶数位置的SwinTransformerBlock计算的是W-MSA,奇数位置的Block计算的是SW-MSA,且shift_size = window_size//2
        self.blocks = nn.ModuleList([
            SwinTransformerBlock(dim=dim, input_resolution=input_resolution,
                                 num_heads=num_heads, window_size=window_size,
                                 shift_size=0 if (i % 2 == 0) else window_size // 2,
                                 mlp_ratio=mlp_ratio,
                                 qkv_bias=qkv_bias, qk_scale=qk_scale,
                                 drop=drop, attn_drop=attn_drop,
                                 drop_path=drop_path[i] if isinstance(drop_path, list) else drop_path,
                                 norm_layer=norm_layer)
            for i in range(depth)])

        # patch merging layer
        if downsample is not None:
            self.downsample = downsample(input_resolution, dim=dim, norm_layer=norm_layer)
        else:
            self.downsample = None

    def forward(self, x):
        for blk in self.blocks:
            if self.use_checkpoint:
                x = checkpoint.checkpoint(blk, x)
            else:
                x = blk(x)  # blk = SwinTransformerBlock
        if self.downsample is not None:
            x = self.downsample(x)
        return x

    def extra_repr(self) -> str:
        return f"dim={self.dim}, input_resolution={self.input_resolution}, depth={self.depth}"

    def flops(self):
        flops = 0
        for blk in self.blocks:
            flops += blk.flops()
        if self.downsample is not None:
            flops += self.downsample.flops()
        return flops

Part 3 : 不同视觉任务输出

程序中对应的是图片分类任务,经过Part 2 之后的数据通过 norm/avgpool/flatten:

 x = self.norm(x)  # B L C
 x = self.avgpool(x.transpose(1, 2))  # B C 1
 x = torch.flatten(x, 1) # B C

之后通过nn.Linear将特征转化为对应的类别:

self.head = nn.Linear(self.num_features, num_classes) if num_classes > 0 else nn.Identity()

应用于其他不同的视觉任务时,只需要将输出进行特定的修改即可。

完整的SwinTransformer程序如下:

class SwinTransformer(nn.Module):
    r""" Swin Transformer
        A PyTorch impl of : `Swin Transformer: Hierarchical Vision Transformer using Shifted Windows`  -
          https://arxiv.org/pdf/2103.14030

    Args:
        img_size (int | tuple(int)): Input image size. Default 224
        patch_size (int | tuple(int)): Patch size. Default: 4
        in_chans (int): Number of input image channels. Default: 3
        num_classes (int): Number of classes for classification head. Default: 1000
        embed_dim (int): Patch embedding dimension. Default: 96
        depths (tuple(int)): Depth of each Swin Transformer layer.
        num_heads (tuple(int)): Number of attention heads in different layers.
        window_size (int): Window size. Default: 7
        mlp_ratio (float): Ratio of mlp hidden dim to embedding dim. Default: 4
        qkv_bias (bool): If True, add a learnable bias to query, key, value. Default: True
        qk_scale (float): Override default qk scale of head_dim ** -0.5 if set. Default: None
        drop_rate (float): Dropout rate. Default: 0
        attn_drop_rate (float): Attention dropout rate. Default: 0
        drop_path_rate (float): Stochastic depth rate. Default: 0.1
        norm_layer (nn.Module): Normalization layer. Default: nn.LayerNorm.
        ape (bool): If True, add absolute position embedding to the patch embedding. Default: False
        patch_norm (bool): If True, add normalization after patch embedding. Default: True
        use_checkpoint (bool): Whether to use checkpointing to save memory. Default: False
    """

    def __init__(self, img_size=224, patch_size=4, in_chans=3, num_classes=1000,
                 embed_dim=96, depths=[2, 2, 6, 2], num_heads=[3, 6, 12, 24],
                 window_size=7, mlp_ratio=4., qkv_bias=True, qk_scale=None,
                 drop_rate=0., attn_drop_rate=0., drop_path_rate=0.1,
                 norm_layer=nn.LayerNorm, ape=False, patch_norm=True,
                 use_checkpoint=False, **kwargs):
        super().__init__()

        self.num_classes = num_classes # 1000
        self.num_layers = len(depths) # [2, 2, 6, 2]  Swin_T 的配置
        self.embed_dim = embed_dim # 96
        self.ape = ape # False
        self.patch_norm = patch_norm # True
        self.num_features = int(embed_dim * 2 ** (self.num_layers - 1))  # 96*2^3
        self.mlp_ratio = mlp_ratio # 4

        # split image into non-overlapping patches
        self.patch_embed = PatchEmbed(
            img_size=img_size, patch_size=patch_size, in_chans=in_chans, embed_dim=embed_dim,
            norm_layer=norm_layer if self.patch_norm else None)
        num_patches = self.patch_embed.num_patches
        patches_resolution = self.patch_embed.patches_resolution
        self.patches_resolution = patches_resolution

        # absolute position embedding
        if self.ape:
            self.absolute_pos_embed = nn.Parameter(torch.zeros(1, num_patches, embed_dim))
            trunc_normal_(self.absolute_pos_embed, std=.02)

        self.pos_drop = nn.Dropout(p=drop_rate)

        # stochastic depth
        dpr = [x.item() for x in torch.linspace(0, drop_path_rate, sum(depths))]  # stochastic depth decay rule

        # build layers
        self.layers = nn.ModuleList()
        for i_layer in range(self.num_layers):
            layer = BasicLayer(dim=int(embed_dim * 2 ** i_layer),
                               input_resolution=(patches_resolution[0] // (2 ** i_layer),
                                                 patches_resolution[1] // (2 ** i_layer)),
                               depth=depths[i_layer],
                               num_heads=num_heads[i_layer],
                               window_size=window_size,
                               mlp_ratio=self.mlp_ratio,
                               qkv_bias=qkv_bias, qk_scale=qk_scale,
                               drop=drop_rate, attn_drop=attn_drop_rate,
                               drop_path=dpr[sum(depths[:i_layer]):sum(depths[:i_layer + 1])],
                               norm_layer=norm_layer,
                               downsample=PatchMerging if (i_layer < self.num_layers - 1) else None,
                               use_checkpoint=use_checkpoint)
            self.layers.append(layer)

        self.norm = norm_layer(self.num_features) # norm_layer = nn.LayerNorm
        self.avgpool = nn.AdaptiveAvgPool1d(1)
        self.head = nn.Linear(self.num_features, num_classes) if num_classes > 0 else nn.Identity()

        self.apply(self._init_weights)  # 使用self.apply 初始化参数

    def _init_weights(self, m):
        # is_instance 判断对象是否为已知类型
        if isinstance(m, nn.Linear):
            trunc_normal_(m.weight, std=.02)
            if isinstance(m, nn.Linear) and m.bias is not None:
                nn.init.constant_(m.bias, 0)
        elif isinstance(m, nn.LayerNorm):
            nn.init.constant_(m.bias, 0)
            nn.init.constant_(m.weight, 1.0)

    @torch.jit.ignore
    def no_weight_decay(self):
        return {'absolute_pos_embed'}

    @torch.jit.ignore
    def no_weight_decay_keywords(self):
        return {'relative_position_bias_table'}

    def forward_features(self, x):
        x = self.patch_embed(x)  # x.shape = (H//4, W//4, C)
        if self.ape:
            x = x + self.absolute_pos_embed
        x = self.pos_drop(x)  # self.pos_drop = nn.Dropout(p=drop_rate)

        for layer in self.layers:
            x = layer(x)

        x = self.norm(x)  # B L C
        x = self.avgpool(x.transpose(1, 2))  # B C 1
        x = torch.flatten(x, 1) # B C
        return x

    def forward(self, x):
        x = self.forward_features(x)  # x是论文图中Figure 3 a图中最后的输出
        #  self.head = nn.Linear(self.num_features, num_classes) if num_classes > 0 else nn.Identity()
        x = self.head(x) # x.shape = (B, num_classes)
        return x

    def flops(self):
        flops = 0
        flops += self.patch_embed.flops()
        for i, layer in enumerate(self.layers):
            flops += layer.flops()
        flops += self.num_features * self.patches_resolution[0] * self.patches_resolution[1] // (2 ** self.num_layers)
        flops += self.num_features * self.num_classes
        return flops

补充:有关swin transformer相对位置编码:
torch.roll 函数

The Question about the mask of window attention:
https://github.com/microsoft/Swin-Transformer/issues/38

torch.roll(inputshiftsdims=None) → Tensor

Roll the tensor input along the given dimension(s). Elements that are shifted beyond the last position are re-introduced at the first position. If dims is None, the tensor will be flattened before rolling and then restored to the original shape.Parameters

  • input (Tensor) – the input tensor.
  • shifts (int or tuple of python:ints) – The number of places by which the elements of the tensor are shifted. If shifts is a tuple, dims must be a tuple of the same size, and each dimension will be rolled by the corresponding value
  • dims (int or tuple of python:ints) – Axis along which to roll

沿给定维数滚动张量,移动到最后一个位置以外的元素将在第一个位置重新引入。如果没有指定尺寸,张量将在轧制前被压平,然后恢复到原始形状。

简单理解:shifts的值为正数相当于向下挤牙膏,挤出的牙膏又从顶部塞回牙膏里面;shifts的值为负数相当于向上挤牙膏,挤出的牙膏又从底部塞回牙膏里面

  • input (Tensor) —— 输入张量。
  • shifts (python:int 或 tuple of python:int) —— 张量元素移位的位数。如果该参数是一个元组(例如shifts=(x,y)),dims必须是一个相同大小的元组(例如dims=(a,b)),相当于在第a维度移x位,在b维度移y位
  • dims (int 或 tuple of python:int) 确定的维度。

Example:

>>> x = torch.tensor([1, 2, 3, 4, 5, 6, 7, 8]).view(4, 2)
>>> x
tensor([[1, 2],
        [3, 4],
        [5, 6],
        [7, 8]])
>>> torch.roll(x, 1)
tensor([[8, 1],
        [2, 3],
        [4, 5],
        [6, 7]])

'''第0维度向下移1位,多出的[7,8]补充到顶部'''
>>> torch.roll(x, 1, 0)
tensor([[7, 8],
        [1, 2],
        [3, 4],
        [5, 6]])

'''第0维度向上移1位,多出的[1,2]补充到底部'''
>>> torch.roll(x, -1, 0)
tensor([[3, 4],
        [5, 6],
        [7, 8],
        [1, 2]])

'''tuple元祖,维度一一对应:
第0维度向下移2位,多出的[5,6][7,8]补充到顶部,
第1维向右移1位,多出的[6,8,2,4]补充到最左边'''
>>> torch.roll(x, shifts=(2, 1), dims=(0, 1))
tensor([[6, 5],
        [8, 7],
        [2, 1],
        [4, 3]])

CPU怎么识别我们写的代码?

文章来源 图灵人工智能   转自STM32嵌入式开发,版权属于原作者,仅学术分享

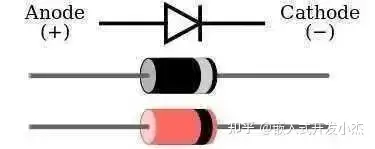
先说一下半导体,啥叫半导体?就是介于导体和绝缘体中间的一种东西,比如二极管。相关文章:关于二极管的基础知识

电流可以从A端流向C端,但反过来则不行。你可以把它理解成一种防止电流逆流的东西。

当C端10V,A端0V,二极管可以视为断开。

当C端0V,A端10V,二极管可以视为导线,结果就是A端的电流源源不断的流向C端,导致最后的结果就是A端=C端=10V。

等等,不是说好的C端0V,A端10V么?咋就变成结果是A端=C端=10V了?你可以把这个理解成初始状态,当最后稳定下来之后就会变成A端=C端=10V。

文科的童鞋们对不住了,实在不懂问高中物理老师吧。反正你不能理解的话就记住这种情况下它相当于导线就行了。

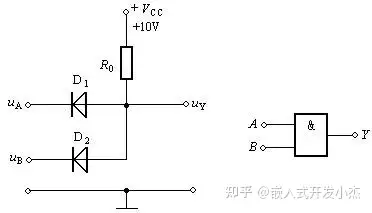
利用半导体的这个特性,我们可以制作一些有趣的电路,比如【与门】。

我们把这个装置成为【与门】,把有电压的地方计为1,0电压的地方计为0。至于具体几V电压,那不重要。也就是AB必须同时输入1,输出端Y才是1;AB有一个是0,输出端Y就是0。

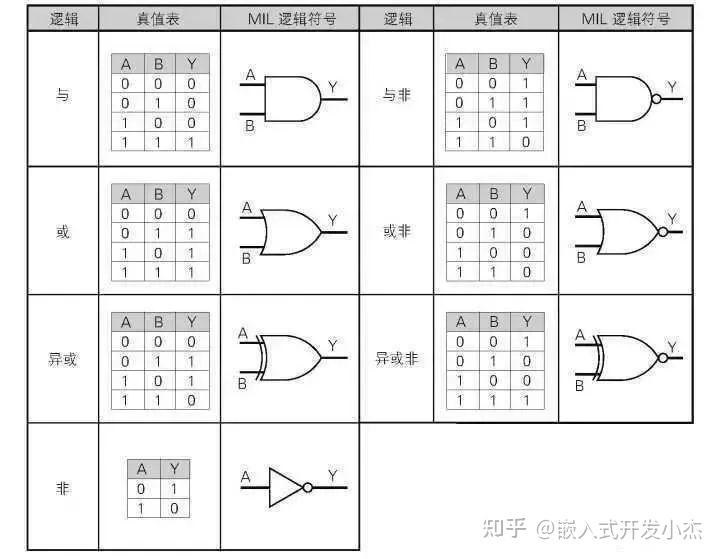
其他还有【或门】【非门】和【异或门】,跟这个都差不多,或门就是输入有一个是1输出就是1,输入00则输入0。

非门也好理解,就是输入1输出0,输入0输出1。

异或门难理解一些,不过也就那么回事,输入01或者10则输出1,输入00或者11则输出0。(即输入两个一样的值则输出0,输入两个不一样的值则输出1)。

这几种门都可以用二极管或者三极管做出来,具体怎么做就不演示了,有兴趣的童鞋可以自己试试。当然实际并不是用二极管三极管做的,因为它们太费电了。实际是用场效应管(也叫MOS管)做的。

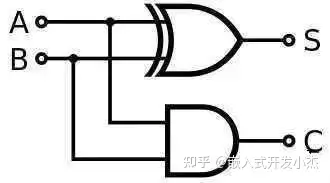
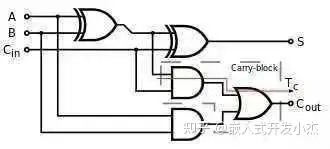
然后我们就可以用门电路来做CPU了。当然做CPU还是挺难的,我们先从简单的开始:加法器。相关文章:CPU如何进行数字加法。加法器顾名思义,就是一种用来算加法的电路,最简单的就是下面这种。

AB只能输入0或者1,也就是这个加法器能算0+0,1+0或者1+1。

输出端S是结果,而C则代表是不是发生进位了,二进制1+1=10嘛。这个时候C=1,S=0。

费了大半天的力气,算个1+1是不是特别有成就感?

那再进一步算个1+2吧(二进制01+10),然后我们就发现了一个新的问题:第二位需要处理第一位有可能进位的问题,所以我们还得设计一个全加法器。

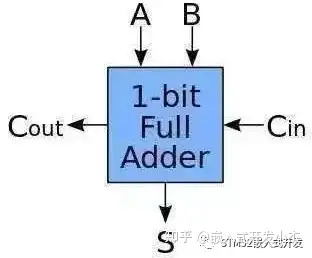
每次都这么画实在太麻烦了,我们简化一下。

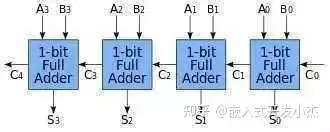
也就是有3个输入2个输出,分别输入要相加的两个数和上一位的进位,然后输入结果和是否进位。然后我们把这个全加法器串起来:

我们就有了一个4位加法器,可以计算4位数的加法也就是15+15,已经达到了幼儿园中班水平,是不是特别给力?

做完加法器我们再做个乘法器吧,当然乘任意10进制数是有点麻烦的,我们先做个乘2的吧。

乘2就很简单了,对于一个2进制数数我们在后面加个0就算是乘2了。比如:

5=101(2)

10=1010(2)

以我们只要把输入都往前移动一位,再在最低位上补个零就算是乘2了。具体逻辑电路图我就不画,你们知道咋回事就行了。

那乘3呢?简单,先位移一次(乘2)再加一次。乘5呢?先位移两次(乘4)再加一次。

所以一般简单的CPU是没有乘法的,而乘法则是通过位移和加算的组合来通过软件来实现的。这说的有点远了,我们还是继续做CPU吧。

现在假设你有8位加法器了,也有一个位移1位的模块了。串起来你就能算(A+B)×2了!激动人心,已经差不多到了准小学生水平。

那我要是想算A×2+B呢?简单,你把加法器模块和位移模块的接线改一下就行了,改成输入A先过位移模块,再进加法器就可以了。

你的意思是我改个程序还得重新接线?

所以你以为呢?

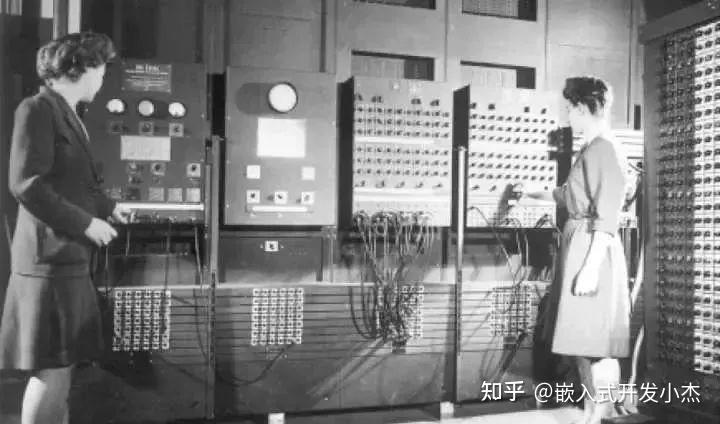
实际上,编程就是把线来回插啊。惊喜不惊喜?意外不意外?

早期的计算机就是这样编程的,几分钟就算完了但插线好几天。关于插线编程的相关文章推荐看着篇:国内大神手工焊接,制作了一个CPU。而且插线是个细致且需要耐心的工作,所以那个时候的程序员都是清一色的漂亮女孩子,穿制服的那种,就像照片上这样。是不是有种生不逢时的感觉?

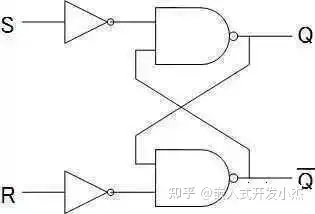
插线也是个累死人的工作。所以我们需要改进一下,让CPU可以根据指令来相加或者乘2。这里再引入两个模块,一个叫flip-flop,简称FF,中文好像叫触发器,如下图这样。

这个模块的作用是存储1bit数据。比如上面这个RS型的FF,R是Reset,输入1则清零。S是Set,输入1则保存1。RS都输入0的时候,会一直输出刚才保存的内容。

我们用FF来保存计算的中间数据(也可以是中间状态或者别的什么),1bit肯定是不够的,不过我们可以并联嘛,用4个或者8个来保存4位或者8位数据。这种我们称之为寄存器(Register)。另外一个叫MUX,中文叫选择器,如下图就是一个选择器。

这个就简单了,sel输入0则输出i0的数据,i0是什么就输出什么,01皆可。同理sel如果输入1则输出i1的数据。当然选择器可以做的很长,比如这种四进一出的具体原理不细说了,其实看看逻辑图琢磨一下就懂了,知道有这个东西就行了。下图是一个四进一出-选择器。

有这个东西我们就可以给加法器和乘2模块(位移)设计一个激活针脚。

这个激活针脚输入1则激活这个模块,输入0则不激活。这样我们就可以控制数据是流入加法器还是位移模块了。

于是我们给CPU先设计8个输入针脚,4位指令,4位数据。

我们再设计3个指令:

  • 0100,数据读入寄存器
  • 0001,数据与寄存器相加,结果保存到寄存器
  • 0010,寄存器数据向左位移一位(乘2)

为什么这么设计呢,刚才也说了,我们可以为每个模块设计一个激活针脚。然后我们可以分别用指令输入的第二第三第四个针脚连接寄存器,加法器和位移器的激活针脚。

这样我们输入0100这个指令的时候,寄存器输入被激活,其他模块都是0没有激活,数据就存入寄存器了。同理,如果我们输入0001这个指令,则加法器开始工作,我们就可以执行相加这个操作了。

这里就可以简单回答这个问题的第一个小问题了:CPU是为什么能看懂这些二级制的数呢?

为什么CPU能看懂,因为CPU里面的线就是这么接的呗。你输入一个二进制数,就像开关一样激活CPU里面若干个指定的模块以及改变这些模块的连同方式,最终得出结果。

几个可能会被问的问题

Q:CPU里面可能有成千上万个小模块,一个32位/64位的指令能控制那么多吗?

A:我们举例子的CPU里面只有3个模块,就直接接了。真正的CPU里会有一个解码器(decoder),把指令翻译成需要的形式。

Q:你举例子的简单CPU,如果我输入指令0011会怎么样?

A:当然是同时激活了加法器和位移器从而产生不可预料的后果,简单的说因为你使用了没有设计的指令,所以后果自负呗。在真正的CPU上这么干大概率就是崩溃呗,不过肯定会有各种保护性的设计。

细心的小伙伴可能发现一个问题:你设计的指令【0001,数据与寄存器相加,结果保存到寄存器】这个一步做不出来吧?

毕竟还有一个回写的过程,实际上确实是这样。我们设计的简易CPU执行一个指令差不多得三步,读取指令,执行指令,写寄存器。

经典的RISC设计则是分5步:读取指令(IF),解码指令(ID),执行指令(EX),内存操作(MEM),写寄存器(WB)。我们平常用的x86的CPU有的指令可能要分将近20个步骤。

你可以理解有这么一个开关,我们啪的按一下,CPU就走一步,你按的越快CPU就走的越快。咦?听说你有个想法?少年,你这个想法很危险啊,姑且不说你能不能按那么快。拿现代的CPU来说,也就2GHz多吧,大概一秒也就按个20亿下吧。

就算你能按那么快,虽然速度是上去了,但功耗会大大增加,发热上升稳定性下降。江湖上确实有这种玩法,名曰超频,不过新手不推荐你尝试哈。

那CPU怎么知道自己走到哪一步了呢?前面不是介绍了FF么,这个不光可以用来存中间数据,也可以用来存中间状态,也就是走到哪了。

具体的设计涉及到FSM(finite-state machine),也就是有限状态机理论,以及怎么用FF实装。这个也是很重要的一块,考试必考哈,只不过跟题目关系不大,这里就不展开讲了。

我们再继续刚才的讲,现在我们有3个指令了。我们来试试算个(1+4)X2+3吧。

0100 0001 ;寄存器存入1

0001 0100 ;寄存器的数字加4

0010 0000 ;乘2

0001 0011 ;再加三

太棒了,靠这台计算机我们应该可以打败所有的幼儿园小朋友,称霸大班了。而且现在我们用的是4位的,如果换成8位的CPU完全可以吊打低年级小学生了!

实际上用程序控制CPU是个挺高级的想法,再此之前计算机(器)的CPU都是单独设计的。

1969年一家日本公司BUSICOM想搞程控的计算器,而负责设计CPU的美国公司也觉得每次都重新设计CPU是个挺傻X的事,于是双方一拍即合,于1970年推出一种划时代的产品,世界上第一款微处理器4004。

这个架构改变了世界,那家负责设计CPU的美国公司也一步一步成为了业界巨头。哦对了,它叫Intel,对,就是噔噔噔噔的那个。

我们把刚才的程序整理一下:

“01000001000101000010000000010011”

你来把它输入CPU,我去准备一下去幼儿园大班踢馆的工作。

什么!?等我们输完了人家小朋友掰手指都能算出来了?

没办法机器语言就是这么反人类。哦,忘记说了,这种只有01组成的语言被称之为机器语言(机器码),是CPU唯一可以理解的语言。不过你把机器语言让人读,绝对一秒变典韦,这谁也受不了。

所以我们还是改进一下吧。不过话虽这么讲,也就往前个30年,直接输入01也是个挺普遍的事情。

于是我们把我们机器语言写成的程序:

0100 0001 ;寄存器存入1

0001 0100 ;寄存器的数字加4

0010 0000 ;乘2

0001 0011 ;再加三

改写成:

MOV 1 ;寄存器存入1

ADD 4 ;寄存器的数字加4

SHL 0 ;乘2(介于我们设计的乘法器暂时只能乘2,这个0是占位的)

ADD 3 ;再加三

是不是容易读多了?这就叫汇编语言。

汇编语言的好处在于它和机器语言一一对应。

也就是我们写的汇编可以完美的改写成机器语言,直接指挥cpu,进行底层开发;我们也可以把内存中的数据dump出来,以汇编语言的形式展示出来,方便调试和debug。

汇编语言极大的增强了机器语言的可读性和开发效率,但对于人类来说也依然是太晦涩了,于是我们又发明了高级语言,以近似于人类的语法来表现数据结构和算法。

比如很多语言都可以这么写:

a=(1+4)*2+3;

当然这样计算机是不认识的,我们要把它翻译成计算机认识的形式,这个过程叫编译,用来做这个事的东西叫编译器。

具体怎么把高级语言弄成汇编语言/机器语言的,一本书都写不完,我们就举个简单的例子。

我们把:

(1+4)*2+3

转换成:

1,4,+,2,*,3,+

这种写法叫后缀表示法,也成为逆波兰表示法。相对的,我们平常用的表示法叫中缀表示法,也就是符号方中间,比如1+4。而后缀表示法则写成1,4,+。

转换成这种写法的好处是没有先乘除后加减的影响,也没有括号了,直接算就行了。

具体怎么转换的可以找本讲编译原理的书看看,这里不展开讲了。

转换成这种形式之后我们就可以把它改成成汇编语言了。

从头开始处理,最开始是1,一个数字,那就存入寄存器:

MOV 1

之后是4,+,那就加一下:

ADD 4

然后是2,*,那就乘一下(介于我们设计的乘法器暂时只能乘2,这个0是占位的):

SHL 0

最后是3,+,那再加一下:

ADD 3

最后我们把翻译好的汇编整理一下:

MOV 1

ADD 4

SHL 0

ADD 3

再简单的转换成机器语言,就可以拿到我们设计的简单CPU上运行了。

其实到了这一步,应该把这个问题都讲清楚了:C语言写出来的东西是怎么翻译成二进制的,电脑又是怎么运行这个二进制的。

只不过题主最后还提到栈和硬件的关系,这里就再多说几句。

其实栈是一种数据结构,跟CPU无关。只不过栈这个数据结构实在太常用了,以至于CPU会针对性的进行优化。为了能让我们的CPU也能用栈,我们给它增加几个组件。

第一,增加一组寄存器。现在有两组寄存器了,我们分别成为A和B。

第二,增加两个指令,RDA/RDB和WRA/WRB,分别为把指定内存地址的数据读到寄存器A/B,和把寄存器A/B的内容写到指定地址。

顺便再说下内存,内存有个地址总线,有个数据总线。比如你要把1100这个数字存到0011这个地址,就把1100接到数据总线,0011接到地址总线,都准备好了啪嚓一按开关(对,就是我们前面提到的那个开关),就算是存进去了。

什么叫DDR内存呢,就是你按这个开关的时候存进去一个数字,抬起来之前你把地址和数据都更新一下,然后一松手,啪!又进去一个。也就是正常的内存你按一下进去1个数据,现在你按一下进去俩数据,这就叫双倍速率(Double Data Rate,简称DDR)

加了这几个命令之后我们发现按原来的设计,CPU每个指令针脚控制一个模块的方式的话针脚不够用了。所以我们就需要加一个解码器了(decoder)。

于是我们选择用第二个位作为是否选择寄存器的针脚。如果为0,则第三第四位可以正常激活位移器和加法器;如果为1则只激活寄存器而不激活位移和加法器,然后用第四位来决定是寄存器A还是B。这样变成了:

  • 0100,数据读入寄存器A
  • 0101,数据读入寄存器B (我们把汇编指令定义为MOVB)
  • 0001,数据与寄存器A相加,结果保存到寄存器A
  • 0011,数据与寄存器B相加,结果保存到寄存器B(我们把汇编指令定义为ADDB)
  • 0010,寄存器A数据向左位移一位(乘2)

最后我们可以用第一位来控制是不是进行内存操作。如果第一位为1则也不激活位移和加法器模块,然后用第三个针脚来控制是读还是写。这样就有了:

  • 1100,把寄存器B的地址数据读入寄存器A(我们把汇编指令定义为RD)
  • 1110,寄存器A的数据写到寄存器B指定的地址(我们把汇编指令定义为WR)

我们加了个解码器之后,加法器的激活条件从p4变成了(NOT (p1 OR p2)) AND p4。

加法器的输入则由第三个针脚判断,0则为寄存器A,1为寄存器B。这就是简单的指令解码啦。

当然我们也可以选择不向下兼容,另外设计一套指令。不过放到现实世界恐怕就要出大乱子了,所以你也可以想象我们平常用的x86背了个多大的历史包袱。

这个时候我们用栈的话,先栈地址初始化:

0101 1000 ; MOVB 16; 把栈底地址定义为1000

之后入栈的话,比如把数字3,4入栈:

1111 0011 ; WR 03; 把3写到内存,地址为1000

0011 0001 ; ADDB 01; 栈地址+1

1111 0100 ; WR 04; 把3写到内存,地址为1001

0011 0001 ; ADDB 01; 栈地址+1

这样就把3,4都保存到栈里了。

出栈的话反过来:

0011 1111 ; ADDB -1; 栈地址-1

1101 0000 ; RD 00; 把内容读入寄存器A,00是占位

0011 1111 ; ADDB -1; 栈地址-1

1101 0000 ; RD 00; 把内容读入寄存器A,00是占位

这样就依次得到4,3两个值。

所以,入栈出栈其实就是把数据写道指定的内存位置,CPU其实不知道你是在干啥。相关文章:关于C语言堆栈的经典讲解。当然我们也可以让CPU知道。

接下来我们再改进一下,给CPU再加一个寄存器SP,并定义两个指令:一个PUSH,一个POP。动作分别是把数据写入SP的地址,然后SP=SP+1,POP的话反过来。

这样有什么好处呢?好处在于PUSH/POP这样的指令消耗特别少,速度特别快。而栈这种数据结构在各种程序里用的又特别频繁,设计成专用的指令则可以很大程度上提升效率。

当然前提是编译器知道这个指令,并且做了优化,所以同样的程序(c语言写的),编译参数不一样(打开/关闭某些特性),编译出来的东西也就不一样,在不同硬件上的运行的效率也就会不一样。

比如上古时代的mmx,今天的SSE4.2,AVX-512,给力不给力?特别给力,但你平常用的程序支不支持是另一码事,要支持怎么办?重新编译呗。

这个时候开源的优势就显示出来了,重新编译很方便。闭源的话你就要指望作者开恩啦。

对于大多数人来说,电脑就是个黑箱,我们很难理解它到底是怎用工作的。这个问题又很难一句两句解释清楚,因为它是一环扣一环的,每一环都很抽象,每一环都是基础值俩个学分,展开了讲没上限的那种。

这就导致了即使是系统学过计算机的人也不见得就有一个明确而清晰的思路。想用尽量短的篇幅和尽量简单的语言把这个事从头到位解释了一下,希望能给大家解答一些疑惑。关于软硬件结合,另外也推荐下这篇文章:代码是如何控制硬件的?

空洞卷积

Multi-Scale Context Aggregation by Dilated Convolutions

一个简单的例子,[动态图来源:vdumoulin/conv_arithmetic]:

动图
Standard Convolution with a 3 x 3 kernel (and padding)
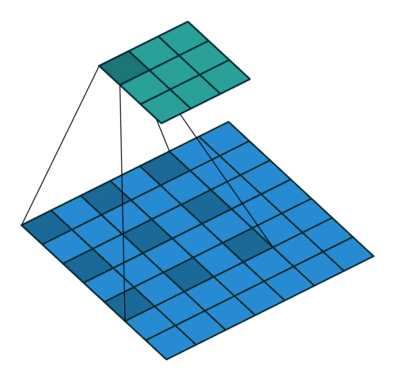
动图封面
Dilated Convolution with a 3 x 3 kernel and dilation rate 2

对于 dilated convolution, 我们已经可以发现他的优点,即内部数据结构的保留和避免使用 down-sampling 这样的特性。但是完全基于 dilated convolution 的结构如何设计则是一个新的问题。

潜在问题 1:The Gridding Effect

假设我们仅仅多次叠加 dilation rate 2 的 3 x 3 kernel 的话,则会出现这个问题:

我们发现我们的 kernel 并不连续,也就是并不是所有的 pixel 都用来计算了,因此这里将信息看做 checker-board 的方式会损失信息的连续性。这对 pixel-level dense prediction 的任务来说是致命的。

潜在问题 2:Long-ranged information might be not relevant.

我们从 dilated convolution 的设计背景来看就能推测出这样的设计是用来获取 long-ranged information。然而光采用大 dilation rate 的信息或许只对一些大物体分割有效果,而对小物体来说可能则有弊无利了。如何同时处理不同大小的物体的关系,则是设计好 dilated convolution 网络的关键。

通向标准化设计:Hybrid Dilated Convolution (HDC)

对于上个 section 里提到的几个问题,图森组的文章对其提出了较好的解决的方法。他们设计了一个称之为 HDC 的设计结构。

第一个特性是,叠加卷积的 dilation rate 不能有大于1的公约数。比如 [2, 4, 6] 则不是一个好的三层卷积,依然会出现 gridding effect。

第二个特性是,我们将 dilation rate 设计成 锯齿状结构,例如 [1, 2, 5, 1, 2, 5] 循环结构。

第三个特性是,我们需要满足一下这个式子: Mi=max[Mi+1−2ri,Mi+1−2(Mi+1−ri),ri]

其中 ri 是 i 层的 dilation rate 而 Mi 是指在 i 层的最大dilation rate,那么假设总共有n层的话,默认 Mn=rn 。假设我们应用于 kernel 为 k x k 的话,我们的目标则是 M2≤k ,这样我们至少可以用 dilation rate 1 即 standard convolution 的方式来覆盖掉所有洞。

一个简单的例子: dilation rate [1, 2, 5] with 3 x 3 kernel (可行的方案)

而这样的锯齿状本身的性质就比较好的来同时满足小物体大物体的分割要求(小 dilation rate 来关心近距离信息,大 dilation rate 来关心远距离信息)。

这样我们的卷积依然是连续的也就依然能满足VGG组观察的结论,大卷积是由小卷积的 regularisation 的 叠加。

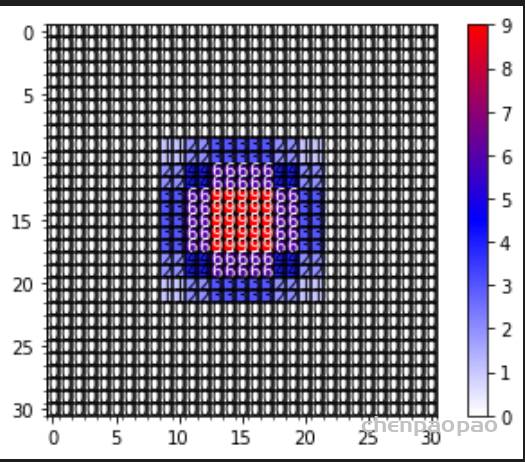
代码:(绘制空洞卷积)

import numpy as np
import matplotlib.pyplot as plt
from matplotlib.colors import LinearSegmentedColormap


def dilated_conv_one_pixel(center: (int, int),feature_map: np.ndarray,k: int = 3,r: int = 1,v: int = 1):
    """
    膨胀卷积核中心在指定坐标center处时,统计哪些像素被利用到,
    并在利用到的像素位置处加上增量v
    Args:
        center: 膨胀卷积核中心的坐标
        feature_map: 记录每个像素使用次数的特征图
        k: 膨胀卷积核的kernel大小
        r: 膨胀卷积的dilation rate
        v: 使用次数增量
    """
    assert divmod(3, 2)[1] == 1

    # left-top: (x, y)
    left_top = (center[0] - ((k - 1) // 2) * r, center[1] - ((k - 1) // 2) * r)
    for i in range(k):
        for j in range(k):
            feature_map[left_top[1] + i * r][left_top[0] + j * r] += v


def dilated_conv_all_map(dilated_map: np.ndarray,
                         k: int = 3,
                         r: int = 1):
    """
    根据输出特征矩阵中哪些像素被使用以及使用次数,
    配合膨胀卷积k和r计算输入特征矩阵哪些像素被使用以及使用次数
    Args:
        dilated_map: 记录输出特征矩阵中每个像素被使用次数的特征图
        k: 膨胀卷积核的kernel大小
        r: 膨胀卷积的dilation rate
    """
    new_map = np.zeros_like(dilated_map)
    for i in range(dilated_map.shape[0]):
        for j in range(dilated_map.shape[1]):
            if dilated_map[i][j] > 0:
                dilated_conv_one_pixel((j, i), new_map, k=k, r=r, v=dilated_map[i][j])

    return new_map


def plot_map(matrix: np.ndarray):
    plt.figure()

    c_list = ['white', 'blue', 'red']
    new_cmp = LinearSegmentedColormap.from_list('chaos', c_list)
    plt.imshow(matrix, cmap=new_cmp)

    ax = plt.gca()
    ax.set_xticks(np.arange(-0.5, matrix.shape[1], 1), minor=True)
    ax.set_yticks(np.arange(-0.5, matrix.shape[0], 1), minor=True)

    # 显示color bar
    plt.colorbar()

    # 在图中标注数量
    thresh = 5
    for x in range(matrix.shape[1]):
        for y in range(matrix.shape[0]):
            # 注意这里的matrix[y, x]不是matrix[x, y]
            info = int(matrix[y, x])
            ax.text(x, y, info,
                    verticalalignment='center',
                    horizontalalignment='center',
                    color="white" if info > thresh else "black")
    ax.grid(which='minor', color='black', linestyle='-', linewidth=1.5)
    plt.show()
    plt.close()


def main():
    # bottom to top
    dilated_rates = [1, 2, 3]
    # init feature map
    size = 31
    m = np.zeros(shape=(size, size), dtype=np.int32)
    center = size // 2
    m[center][center] = 1
    # print(m)
    # plot_map(m)

    for index, dilated_r in enumerate(dilated_rates[::-1]):
        new_map = dilated_conv_all_map(m, r=dilated_r)
        m = new_map
    print(m)
    plot_map(m)

绘制结果:

VIT

Dosovitskiy et al. An image is worth 16×16 words: transformers for image recognition at scale. In ICLR, 2021

step1 :分割图片

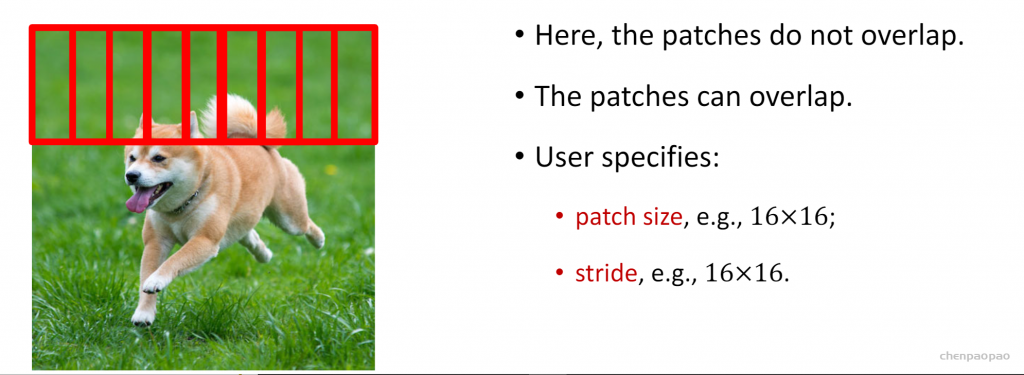
step2 向量化:从九个快变成九个向量

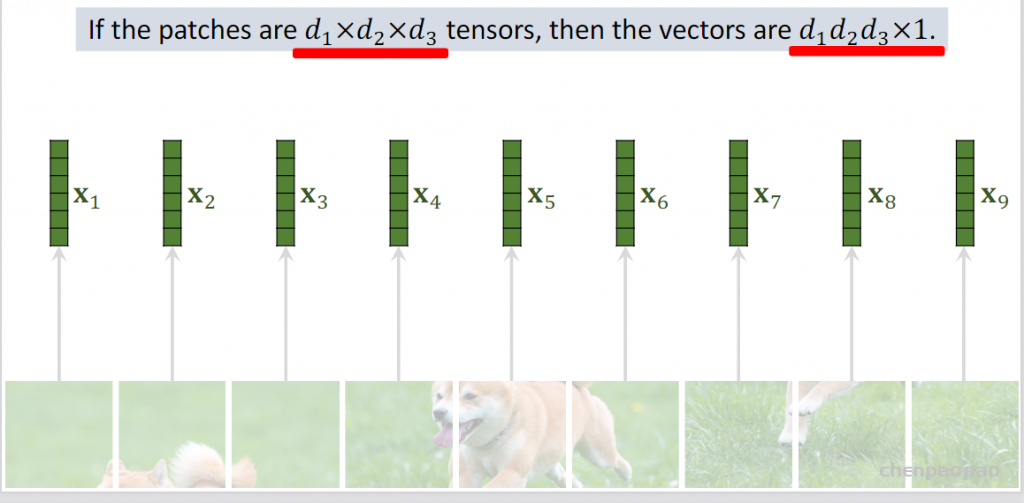
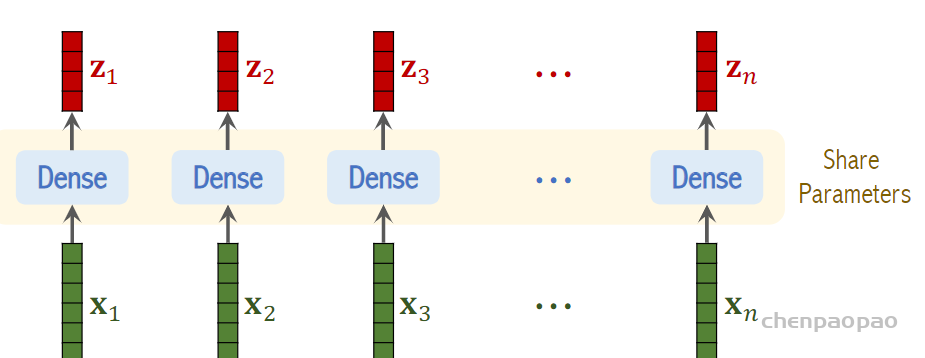
step3:向量线性变换:(linear embedding线性嵌入层)

step4:将位置编码添加到z上:

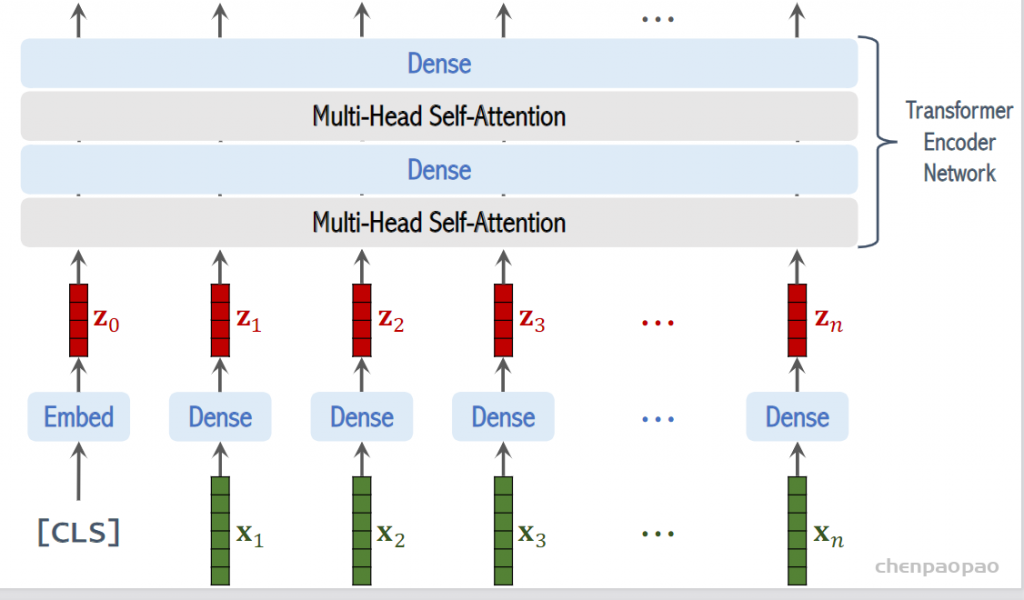
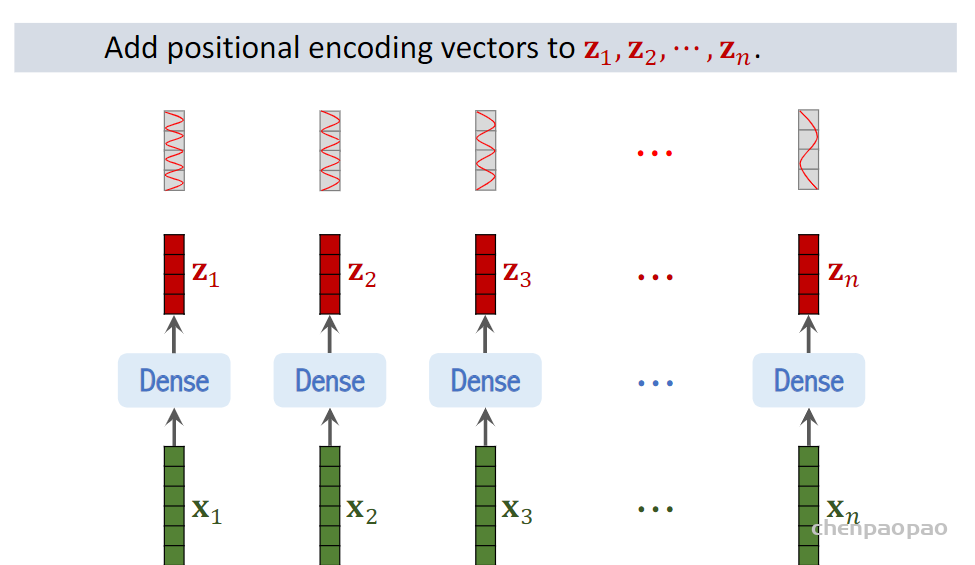
step4:添加一个cls向量:

step5:只利用cls的输出

按照上面的流程图,一个ViT block可以分为以下几个步骤

(1) patch embedding:例如输入图片大小为224×224,将图片分为固定大小的patch,patch大小为16×16,则每张图像会生成224×224/16×16=196个patch,即输入序列长度为196,每个patch维度16x16x3=768,线性投射层的维度为768xN (N=768),因此输入通过线性投射层之后的维度依然为196×768,即一共有196个token,每个token的维度是768。这里还需要加上一个特殊字符cls,因此最终的维度是197×768。到目前为止,已经通过patch embedding将一个视觉问题转化为了一个seq2seq问题

(2) positional encoding(standard learnable 1D position embeddings):ViT同样需要加入位置编码,位置编码可以理解为一张表,表一共有N行,N的大小和输入序列长度相同,每一行代表一个向量,向量的维度和输入序列embedding的维度相同(768)。注意位置编码的操作是sum,而不是concat。加入位置编码信息之后,维度依然是197×768

(3) LN/multi-head attention/LN:LN输出维度依然是197×768。多头自注意力时,先将输入映射到q,k,v,如果只有一个头,qkv的维度都是197×768,如果有12个头(768/12=64),则qkv的维度是197×64,一共有12组qkv,最后再将12组qkv的输出拼接起来,输出维度是197×768,然后在过一层LN,维度依然是197×768

(4) MLP:将维度放大再缩小回去,197×768放大为197×3072,再缩小变为197×768

一个block之后维度依然和输入相同,都是197×768,因此可以堆叠多个block。最后会将特殊字符cls对应的输出 zL0 作为encoder的最终输出 ,代表最终的image presentation(另一种做法是不加cls字符,对所有的tokens的输出做一个平均),如下图公式(4),后面接一个MLP进行图片分类

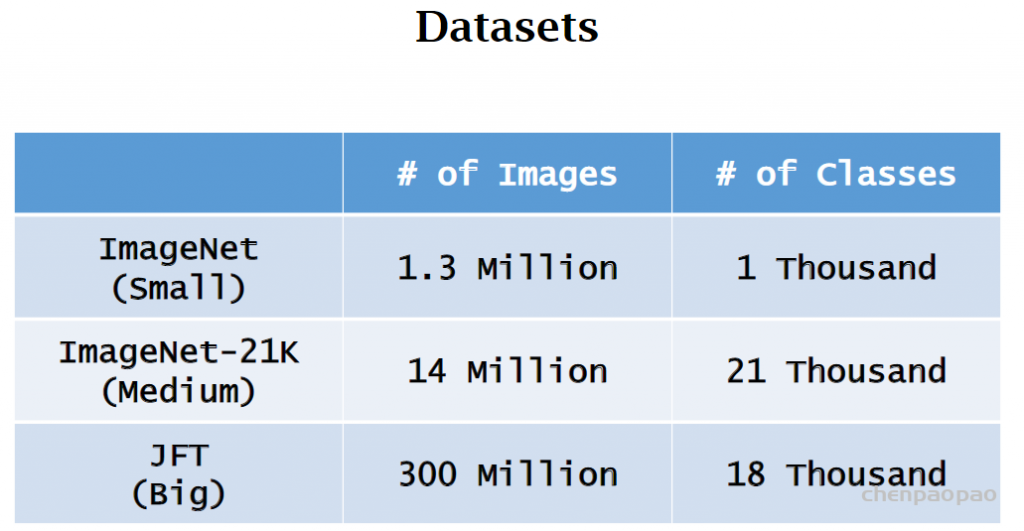
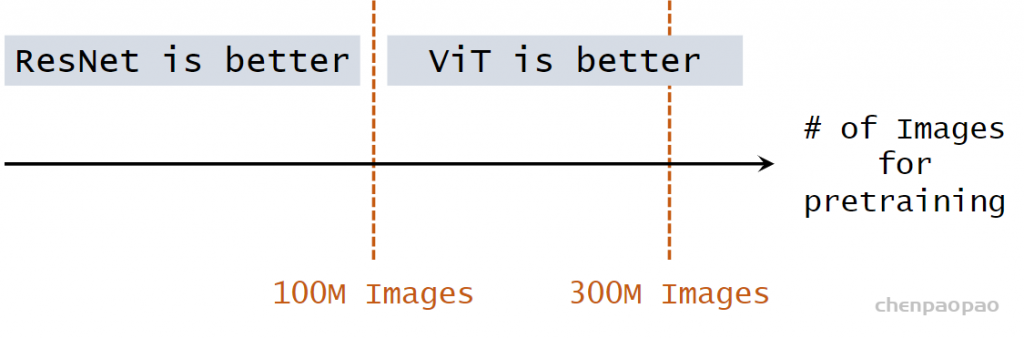
vit需要预训练+微调

• Pretrain the model on Dataset A, fine-tune the model on Dataset B,
and evaluate the model on Dataset B.
• Pretrained on ImageNet (small), ViT is slightly worse than ResNet.
• Pretrained on ImageNet-21K (medium), ViT is comparable to ResNet.
• Pretrained on JFT (large), ViT is slightly better than ResNet.

效果:

Swin Transformer论文解读与思考

论文: https://arxiv.org/abs/2103.14030

github:https://github.com/microsoft/Swin-Transformer

代码详解 https://zhuanlan.zhihu.com/p/384514268

Vision Transformer , Vision MLP 超详细解读 (原理分析+代码解读) (目录)

论文详解:https://space.bilibili.com/1567748478/channel/collectiondetail?sid=32744

Swin Transformer视频讲解:

https://github.com/WZMIAOMIAO/deep-learning-for-image-processing

摘要 :目前transformer应用于CV领域的挑战主要有两个,一个是图片多尺度语义信息的问题,同一个物体在不同图片中的大小尺度变化很大,另外就是难以处理高分辨的图片,如果以pix像素作为序列元素,那么计算成本太大,因此一部分方法是将CNN提取图片特征在送进transformer中 ,或者通过patch,将图片变成一个个的patch。作者提出Swin Transformer 目标是希望作为一种计算机视觉的通用主干网络(因为VIT的提出已经证明了Transformer在CV的可行性),这是一种层级的架构。通过窗口注意力以及转移窗口注意力,不仅降低了计算量,同时层级架构对于不同尺度的信息处理都十分灵活,该架构在图像分类、目标检测、语义分割等任务中表现出色。(对于图像分类、目标检测、语义分割等下游任务,尤其是密集预测任务,多尺度特征是十分必要的)

引言

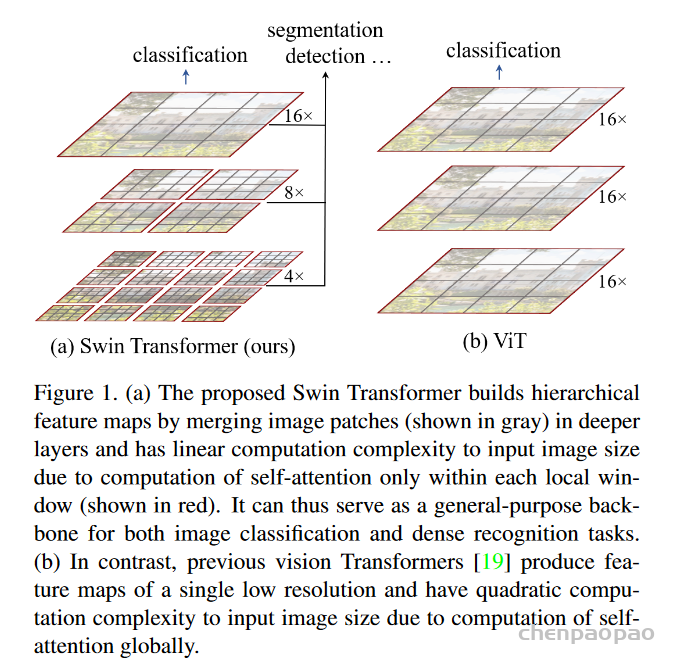
首先来看作者给出的Swin Transformer 和 VIT结构对比:

VIT的patch固定16*16(可以认为是16倍下采样),多尺度特征处理不好,因为整个过程都是在同一尺度下操作的,出来的特征是单尺度的,优点是全局的特征处理比较强,因为是在全局的尺度进行操作的,但因此他的复杂度跟图像尺寸成平方倍的增长,很难处理目前图像分割检测。再来看 Swin Transformer ,通过图可以看出作者借鉴了CNN的很多设计思路,为了减少序列长度,减低计算量,仅在上面的红框中进行自注意力计算,计算复杂度会跟整张图片的大小成线性关系。另外作者使用基于窗口的注意力的也可以很好的把握物体的全局信息(因为在CV中,一个物体的绝大部分都存在单个windows窗口中,很少会横跨多个窗口),另外CNN网络的如何抓住物体的多尺度特征?是因为pool池化层的存在,每次池化能够增大卷积核看到的感受野。因此作者提出了patch merging,将相邻的四个patch合并成一个大patch(可以认为是加权池化),这样合并出来的一个 大patch就可以看到四个小patch内容感受野增大。有了多尺度特征(4*,8*,16*多尺度特征图)以后,可以接一个FPN头,由于做检测任务,也可以放在unet做分割任务,这就是作者所说的, Swin Transformer 是可以做一个通用骨干网络。

    Transformer的初衷就是更好的理解上下文,如果窗口都是不重叠的,那自注意力真的就变成孤立自注意力,就没有全局建模的能力   
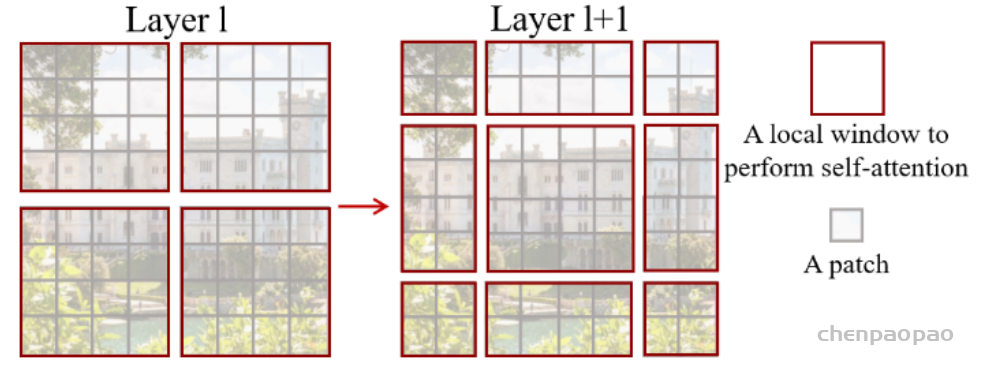
    Swin Transformer 的一个关键设计因素:移动窗口操作。在第l层,通过划分不同的小窗口(实际中是一个窗口有7*7个patch(最小单位),这里示意图以4*4的patch作为一个窗口),自注意力只在窗口中计算 ,就可以有效降低序列长度,从而减少计算复杂度。shift操作可以认为是将l层的窗口整体向右下加移动两个patch所形成的新的窗口,新的特征图进行分割windws以后就有l+1层所示的这些窗口(如下图共九个)了。如果没有shift,那么所有窗口不重叠,在窗口进行自注意力时候,窗口之间无法交互,就无法达到transformer的初衷了(更好的理解上下文),shift后不同窗口的patch就可以进行交互了。再加上一个patch merging操作,不断扩大感受野,到最后几层的时候,每个patch的感受野已经很大了,实际上就可以看到大部分图片了,shift操作以后,就可以看成是全局注意力操作,这样即省内存效果也好。

引言的最后,作者坚信,一个CV和NLP大一统的框架是可以促进两个领域共同发展的,但实际上 Swin Transformer 更多的是利用了CNN的先验知识,从而在计算机视觉领域大杀四方。但是在模型大一统上,也就是 unified architecture 上来说,其实 ViT 还是做的更好的,因为它真的可以什么都不改,什么先验信息都不加,就能让Transformer在两个领域都能用的很好,这样模型不仅可以共享参数,而且甚至可以把所有模态的输入直接就拼接起来,当成一个很长的输入,直接扔给Transformer去做,而不用考虑每个模态的特性

先看结论:

这篇论文提出了 Swin Transformer,它是一个层级式的Transformer,而且它的计算复杂度是跟输入图像的大小呈线性增长的。Swin Transformerr 在 COCO 和 ADE20K上的效果都非常的好,远远超越了之前最好的方法,所以作者说基于此,希望 Swin Transformer 能够激发出更多更好的工作,尤其是在多模态方面。

因为在Swin Transformer 这篇论文里最关键的一个贡献就是基于 Shifted Window 的自注意力,它对很多视觉的任务,尤其是对下游密集预测型的任务是非常有帮助的,但是如果 Shifted Window 操作不能用到 NLP 领域里,其实在模型大一统上论据就不是那么强了,所以作者说接下来他们的未来工作就是要把 Shifted Windows用到 NLP 里面,而且如果真的能做到这一点,那 Swin Transformer真的就是一个里程碑式的工作了,而且模型大一统的故事也就讲的圆满了

方法

主要分为两大块

  • 大概把整体的流程讲了一下,主要就是过了一下前向过程,以及提出的 patch merging 操作是怎么做的
  • 基于 Shifted Window 的自注意力,Swin Transformer怎么把它变成一个transformer block 进行计算

前向过程

  • 假设说有一张224*224*3(ImageNet 标准尺寸)的输入图片
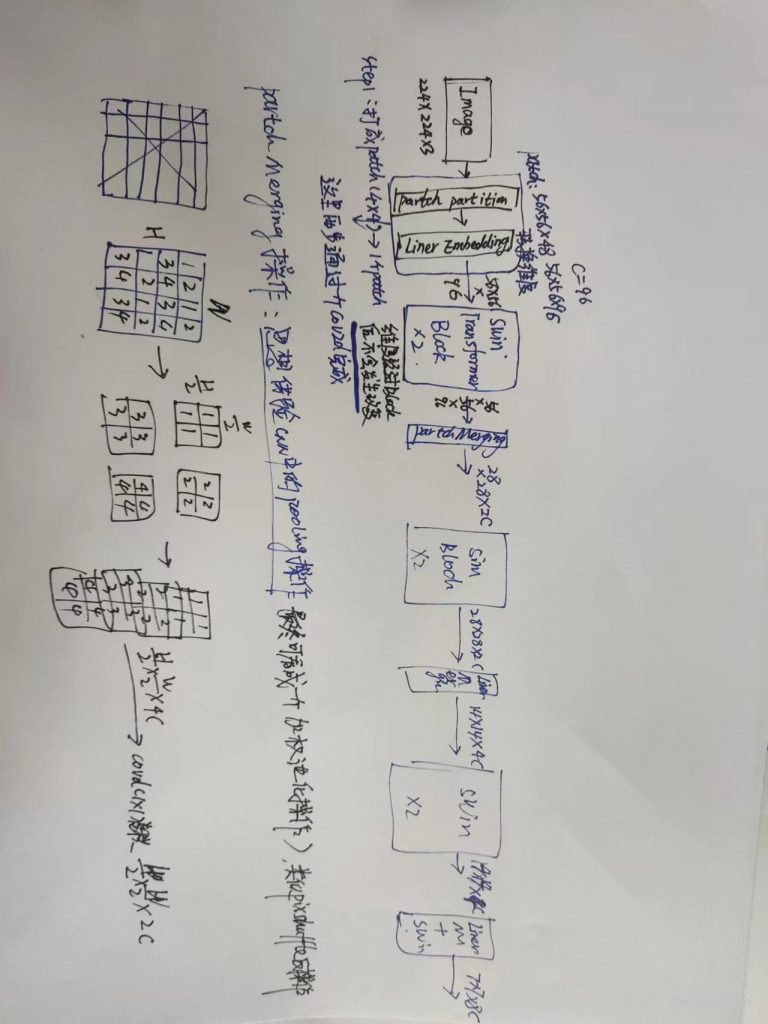
  • 第一步就是像 ViT 那样把图片打成 patch,在 Swin Transformer 这篇论文里,它的 patch size 是4*4,而不是像 ViT 一样16*16,所以说它经过 patch partition 打成 patch 之后,得到图片的尺寸是56*56*48,56就是224/4,因为 patch size 是4,向量的维度48,因为4*4*3,3 是图片的 RGB 通道
  • 打完了 patch ,接下来就要做 Linear Embedding,也就是说要把向量的维度变成一个预先设置好的值,就是 Transformer 能够接受的值,在 Swin Transformer 的论文里把这个超参数设为 c,对于 Swin tiny 网络来说,也就是上图中画的网络总览图,它的 c 是96,所以经历完 Linear Embedding 之后,输入的尺寸就变成了56*56*96,前面的56*56就会拉直变成3136,变成了序列长度,后面的96就变成了每一个token向量的维度,其实 Patch Partition 和 Linear Embedding 就相当于是 ViT 里的Patch Projection 操作,而在代码里也是用一次卷积操作就完成了,
  • 第一部分跟 ViT 其实还是没有区别的,但紧接着区别就来了
  • 首先序列长度是3136,对于 ViT 来说,用 patch size 16*16,它的序列长度就只有196,是相对短很多的,这里的3136就太长了,是目前来说Transformer不能接受的序列长度,所以 Swin Transformer 就引入了基于窗口的自注意力计算,每个窗口按照默认来说,都只有七七四十九个 patch,所以说序列长度就只有49就相当小了,这样就解决了计算复杂度的问题
  • 所以也就是说, stage1中的swin transformer block 是基于窗口计算自注意力的,现在暂时先把 transformer block当成是一个黑盒,只关注输入和输出的维度,对于 Transformer 来说,如果不对它做更多约束的话,Transformer输入的序列长度是多少,输出的序列长度也是多少,它的输入输出的尺寸是不变的,所以说在 stage1 中经过两层Swin Transformer block 之后,输出还是56*56*96
  • 到这其实 Swin Transformer的第一个阶段就走完了,也就是先过一个 Patch Projection 层,然后再过一些 Swin Transformer block,接下来如果想要有多尺寸的特征信息,就要构建一个层级式的 transformer,也就是说需要一个像卷积神经网络里一样,有一个类似于池化的操作

Patch Merging

Patch Merging 其实在之前一些工作里也有用到,它很像 Pixel Shuffle 的上采样的一个反过程,Pixel Shuffle 是 lower level 任务中很常用的一个上采样方式

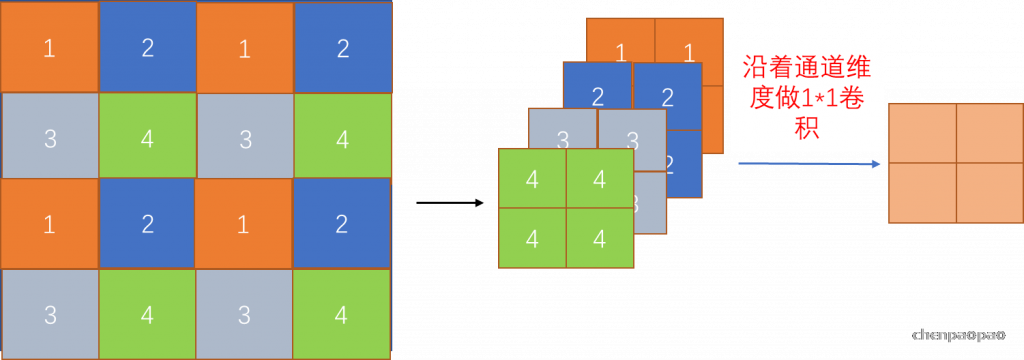
  • 假如有一个张量, Patch Merging 顾名思义就是把临近的小 patch 合并成一个大 patch,这样就可以起到下采样一个特征图的效果了
  • 这里因为是想下采样两倍,所以说在选点的时候是每隔一个点选一个,也就意味着说对于这个张量来说,每次选的点是1、1、1、1
  • 其实在这里的1、2、3、4并不是矩阵里有的值,而是给它的一个序号,同样序号位置上的 patch 就会被 merge 到一起,这个序号只是为了帮助理解
  • 经过隔一个点采一个样之后,原来的这个张量就变成了四个张量,也就是说所有的1都在一起了,2在一起,3在一起,4在一起,如果原张量的维度是 h * w * c ,当然这里 c 没有画出来,经过这次采样之后就得到了4个张量,每个张量的大小是 h/2、w/2,它的尺寸都缩小了一倍
  • 现在把这四个张量在 c 的维度上拼接起来,也就变成了下图中所画出来的形式,张量的大小就变成了 h/2 * w/2 * 4c,相当于用空间上的维度换了更多的通道数
  • 通过这个操作,就把原来一个大的张量变小了,就像卷积神经网络里的池化操作一样,为了跟卷积神经网络那边保持一致(不论是 VGGNet 还是 ResNet,一般在池化操作降维之后,通道数都会翻倍,从128变成256,从256再变成512),所以这里也只想让他翻倍,而不是变成4倍,所以紧接着又再做了一次操作,就是在 c 的维度上用一个1乘1的卷积,把通道数降下来变成2c,通过这个操作就能把原来一个大小为 h*w*c 的张量变成 h/2 * w/2 *2c 的一个张量,也就是说空间大小减半,但是通道数乘2,这样就跟卷积神经网络完全对等起来了

这里其实会发现,特征图的维度真的跟卷积神经网络好像,因为如果回想残差网络的多尺寸的特征,就是经过每个残差阶段之后的特征图大小也是56*56、28*28、14*14,最后是7*7

而且为了和卷积神经网络保持一致,Swin Transformer这篇论文并没有像 ViT 一样使用 CLS token,ViT 是给刚开始的输入序列又加了一个 CLS token,所以这个长度就从196变成了197,最后拿 CLS token 的特征直接去做分类,但 Swin Transformer 没有用这个 token,它是像卷积神经网络一样,在得到最后的特征图之后用global average polling,就是全局池化的操作,直接把7*7就取平均拉直变成1了

作者这个图里并没有画,因为 Swin Transformer的本意并不是只做分类,它还会去做检测和分割,所以说它只画了骨干网络的部分,没有去画最后的分类头或者检测头,但是如果是做分类的话,最后就变成了1*768,然后又变成了1*1,000

所以看完整个前向过程之后,就会发现 Swin Transformer 有四个 stage,还有类似于池化的 patch merging 操作,自注意力还是在小窗口之内做的以及最后还用的是 global average polling,所以说 Swin Transformer 这篇论文真的是把卷积神经网络和 Transformer 这两系列的工作完美的结合到了一起,也可以说它是披着Transformer皮的卷积神经网络

主要贡献

这篇论文的主要贡献就是基于窗口或者移动窗口的自注意力,这里作者又写了一段研究动机,就是为什么要引入窗口的自注意力,其实跟之前引言里说的都是一个事情,就是说全局自注意力的计算会导致平方倍的复杂度,同样当去做视觉里的下游任务,尤其是密集预测型的任务,或者说遇到非常大尺寸的图片时候,这种全局算自注意力的计算复杂度就非常贵了,所以就用窗口的方式去做自注意力

重点:窗口注意力

原图片会被平均的分成一些没有重叠的窗口,拿第一层之前的输入来举例,它的尺寸就是56*56*96,也就说有一个维度是56*56张量,然后把它切成一些不重叠的方格(论文中使用7*7的patch作为一个window窗口)

  • 现在所有自注意力的计算都是在这些小窗口里完成的,就是说序列长度永远都是7*7=49
  • 原来大的整体特征图到底里面会有多少个窗口呢?其实也就是每条边56/7就8个窗口,也就是说一共会有8*8等于64个窗口,就是说会在这64个窗口里分别去算它们的自注意力

基于窗口的自注意力模式的计算复杂度计算:

  • 如果现在有一个输入,自注意力首先把它变成 q k v 三个向量,这个过程其实就是原来的向量分别乘了三个系数矩阵
  • 一旦得到 query 和 k 之后,它们就会相乘,最后得到 attention,也就是自注意力的矩阵
  • 有了自注意力之后,就会和 value 做一次乘法,也就相当于是做了一次加权
  • 最后因为是多头自注意力,所以最后还会有一个 projection layer,这个投射层会把向量的维度投射到我们想要的维度

如果这些向量都加上它们该有的维度,也就是说刚开始输入是 h*w*c

  • 公式(1)对应的是标准的多头自注意力的计算复杂度
  • 每一个图片大概会有 h*w 个 patch,在刚才的例子里,h 和 w 分别都是56,c 是特征的维度
  • 公式(2)对应的是基于窗口的自注意力计算的复杂度,这里的 M 就是刚才的7,也就是说一个窗口的某条边上有多少个patch

基于窗口的自注意力计算复杂度又是如何得到的呢?

  • 因为在每个窗口里算的还是多头自注意力,所以可以直接套用公式(1),只不过高度和宽度变化了,现在高度和宽度不再是 h * w,而是变成窗口有多大了,也就是 M*M,也就是说现在 h 变成了 M,w 也是 M,它的序列长度只有 M * M 这么大
  • 所以当把 M 值带入到公式(1)之后,就得到计算复杂度是4 * M^2 * c^2 + 2 * M^4 * c,这个就是在一个窗口里算多头自注意力所需要的计算复杂度
  • 那我们现在一共有 h/M * w/M 个窗口,现在用这么多个窗口乘以每个窗口所需要的计算复杂度就能得到公式(2)了

对比公式(1)和公式(2),虽然这两个公式前面这两项是一样的,只有后面从 (h*w)^2变成了 M^2 * h * w,看起来好像差别不大,但其实如果仔细带入数字进去计算就会发现,计算复杂的差距是相当巨大的,因为这里的 h*w 如果是56*56的话, M^2 其实只有49,所以是相差了几十甚至上百倍的

这种基于窗口计算自注意力的方式虽然很好地解决了内存和计算量的问题,但是窗口和窗口之间没有通信,这样就达不到全局建模了,也就文章里说的会限制模型的能力,所以最好还是要有一种方式能让窗口和窗口之间互相通信起来,这样效果应该会更好,因为具有上下文的信息,所以作者就提出移动窗口的方式

移动窗口:

移动窗口就是把原来的窗口往右下角移动一半窗口的距离,如果Transformer是上下两层连着做这种操作,先是 window再是 shifted window 的话,就能起到窗口和窗口之间互相通信的目的了

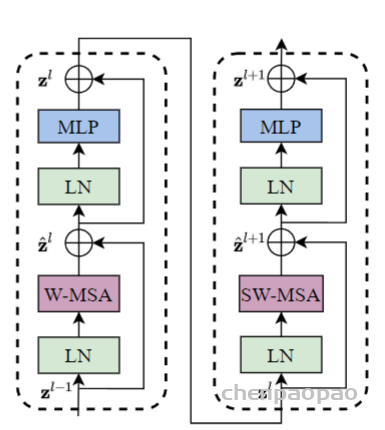
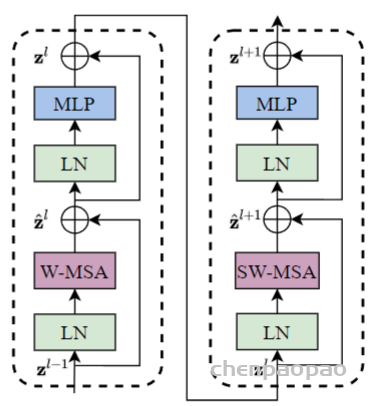
所以说在 Swin Transformer里, transformer block 的安排是有讲究的,每次都是先要做一次基于窗口的多头自注意力,然后再做一次基于移动窗口的多头自注意力,这样就达到了窗口和窗口之间的互相通信。如下图所示

  • 每次输入先进来之后先做一次 Layernorm,然后做窗口的多头自注意力,然后再过 Layernorm 过 MLP,第一个 block 就结束了
  • 这个 block 结束以后,紧接着做一次Shifted window,也就是基于移动窗口的多头自注意力,然后再过 MLP 得到输出
  • 这两个 block 加起来其实才算是 Swin Transformer 一个基本的计算单元,这也就是为什么stage1、2、3、4中的 swin transformer block 为什么是 *2、*2、*6、*2,也就是一共有多少层 Swin Transformer block 的数字总是偶数,因为它始终都需要两层 block连在一起作为一个基本单元,所以一定是2的倍数

到此,Swin Transformer整体的故事和结构就已经讲完了,主要的研究动机就是想要有一个层级式的 Transformer,为了这个层级式,所以介绍了 Patch Merging 的操作,从而能像卷积神经网络一样把 Transformer 分成几个阶段,为了减少计算复杂度,争取能做视觉里密集预测的任务,所以又提出了基于窗口和移动窗口的自注意力方式,也就是连在一起的两个Transformer block,最后把这些部分加在一起,就是 Swin Transformer 的结构

提高移动窗口的计算效率:

  • 一个是怎样提高移动窗口的计算效率,他们采取了一种非常巧妙的 masking(掩码)的方式
  • 另外一个点就是这篇论文里没有用绝对的位置编码,而是用相对的位置编码

masking(掩码)的方式计算移动窗口自注意力:为什么需要使用?

为了提高计算效率,因为如果直接计算右下图的九个窗口的自注意力,不同大小的窗口无法合并成一个batch进行计算。

  • 上图是一个基础版本的移动窗口,就是把左边的窗口模式变成了右边的窗口方式
  • 虽然这种方式已经能够达到窗口和窗口之间的互相通信了,但是会发现一个问题,就是原来计算的时候,特征图上只有四个窗口,但是做完移动窗口操作之后得到了9个窗口,窗口的数量增加了,而且每个窗口里的元素大小不一,比如说中间的窗口还是4*4,有16个 patch,但是别的窗口有的有4个 patch,有的有8个 patch,都不一样了,如果想做快速运算,就是把这些窗口全都压成一个 patch直接去算自注意力,就做不到了,因为窗口的大小不一样
  • 有一个简单粗暴的解决方式就是把这些小窗口周围再 pad 上0 ,把它照样pad成和中间窗口一样大的窗口,这样就有9个完全一样大的窗口,这样就还能把它们压成一个batch,就会快很多
  • 但是这样的话,无形之中计算复杂度就提升了,因为原来如果算基于窗口的自注意力只用算4个窗口,但是现在需要去算9个窗口,复杂度一下提升了两倍多,所以还是相当可观的
  • 那怎么能让第二次移位完的窗口数量还是保持4个,而且每个窗口里的patch数量也还保持一致呢?作者提出了一个非常巧妙的掩码方式,如下图所示

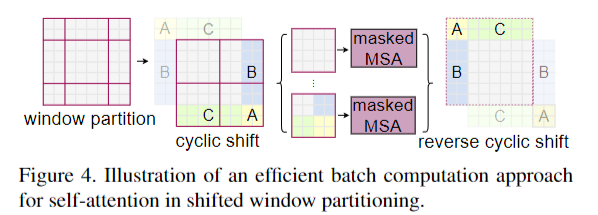
上图是说,当通过普通的移动窗口方式,得到9个窗口之后,现在不在这9个窗口上算自注意力,先再做一次循环移位( cyclic shift )

  • 经过这次循环移位之后,原来的窗口(虚线)就变成了现在窗口(实线)的样子,那如果在大的特征图上再把它分成四宫格的话,我在就又得到了四个窗口,意思就是说移位之前的窗口数也是4个,移完位之后再做一次循环移位得到窗口数还是4个,这样窗口的数量就固定了,也就说计算复杂度就固定了
  • 但是新的问题就来了,虽然对于移位后左上角的窗口(也就是移位前最中间的窗口)来说,里面的元素都是互相紧挨着的,他们之间可以互相两两做自注意力,但是对于剩下几个窗口来说,它们里面的元素是从别的很远的地方搬过来的,所以他们之间,按道理来说是不应该去做自注意力,也就是说他们之间不应该有什么太大的联系
  • 解决这个问题就需要一个很常规的操作,也就是掩码操作,这在Transformer过去的工作里是层出不穷,很多工作里都有各式各样的掩码操作
  • 在 Swin Transformer这篇论文里,作者也巧妙的设计了几种掩码的方式,从而能让一个窗口之中不同的区域之间也能用一次前向过程,就能把自注意力算出来,但是互相之间都不干扰,也就是后面的 masked Multi-head Self Attention(MSA)
  • 算完了多头自注意力之后,还有最后一步就是需要把循环位移再还原回去,也就是说需要把A、B、C再还原到原来的位置上去,原因是还需要保持原来图片的相对位置大概是不变的,整体图片的语义信息也是不变的,如果不把循环位移还原的话,那相当于在做Transformer的操作之中,一直在把图片往右下角移,不停的往右下角移,这样图片的语义信息很有可能就被破坏掉了
  • 所以说整体而言,上图介绍了一种高效的、批次的计算方式比如说本来移动窗口之后得到了9个窗口,而且窗口之间的patch数量每个都不一样,为了达到高效性,为了能够进行批次处理,先进行一次循环位移,把9个窗口变成4个窗口,然后用巧妙的掩码方式让每个窗口之间能够合理地计算自注意力,最后再把算好的自注意力还原,就完成了基于移动窗口的自注意力计算

掩码操作如何实现 :

作者通过这种巧妙的循环位移的方式和巧妙设计的掩码模板,从而实现了只需要一次前向过程,就能把所有需要的自注意力值都算出来,而且只需要计算4个窗口,也就是说窗口的数量没有增加,计算复杂度也没有增加,非常高效的完成了这个任务

作者给出了不同窗口的不同掩码矩阵:

上图示例的Cyclic Shifting方法,可以保持面向计算的window数量保持不变(还是2X2),在window内部通过attention mask来计算子window中的自注意力。

Swin Transformer的几个变体

  • Swin Tiny
  • Swin Small
  • Swin Base
  • Swin Large

Swin Tiny的计算复杂度跟 ResNet-50 差不多,Swin Small 的复杂度跟 ResNet-101 是差不多的,这样主要是想去做一个比较公平的对比

这些变体之间有哪些不一样呢?,其实主要不一样的就是两个超参数

  • 一个是向量维度的大小 c
  • 另一个是每个 stage 里到底有多少个 transform block

这里其实就跟残差网络就非常像了,残差网络也是分成了四个 stage,每个 stage 有不同数量的残差块

实验

分类

首先是分类上的实验,这里一共说了两种预训练的方式

  • 第一种就是在正规的ImageNet-1K(128万张图片、1000个类)上做预训练
  • 第二种方式是在更大的ImageNet-22K(1,400万张图片、2万多个类别)上做预训练

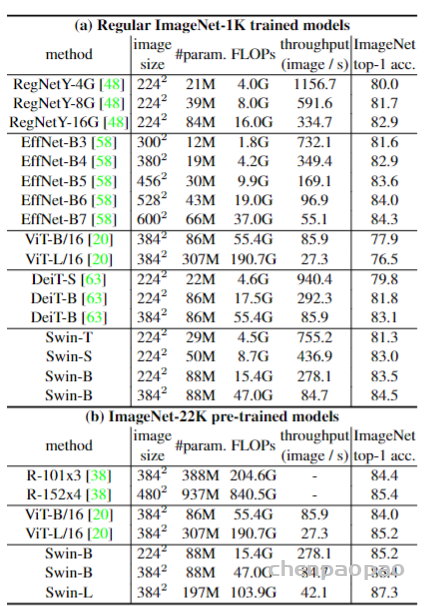
当然不论是用ImageNet-1K去做预训练,还是用ImageNet-22K去做预训练,最后测试的结果都是在ImageNet-1K的测试集上去做的,结果如下表所示

  • 上半部分是ImageNet-1K预训练的模型结果
  • 下半部分是先用ImageNet-22K去预训练,然后又在ImageNet-1K上做微调,最后得到的结果
  • 在表格的上半部分,作者先是跟之前最好的卷积神经网络做了一下对比,RegNet 是之前 facebook 用 NASA 搜出来的模型,EfficientNet 是 google 用NASA 搜出来的模型,这两个都算之前表现非常好的模型了,他们的性能最高会到 84.3
  • 接下来作者就写了一下之前的 Vision Transformer 会达到什么效果,对于 ViT 来说,因为它没有用很好的数据增强,而且缺少偏置归纳,所以说它的结果是比较差的,只有70多
  • 换上 DeiT 之后,因为用了更好的数据增强和模型蒸馏,所以说 DeiT Base 模型也能取得相当不错的结果,能到83.1
  • 当然 Swin Transformer 能更高一些,Swin Base 最高能到84.5,稍微比之前最好的卷积神经网络高那么一点点,就比84.3高了0.2
  • 虽然之前表现最好的 EfficientNet 的模型是在 600*600 的图片上做的,而 Swin Base 是在 384*384 的图片上做的,所以说 EfficientNet 有一些优势,但是从模型的参数和计算的 FLOPs 上来说 EfficientNet 只有66M,而且只用了 37G 的 FLOPs,但是 Swin Transformer 用了 88M 的模型参数,而且用了 47G 的 FLOPs,所以总体而言是伯仲之间
  • 表格的下半部分是用 ImageNet-22k 去做预训练,然后再在ImageNet-1k上微调最后得到的结果
  • 这里可以看到,一旦使用了更大规模的数据集,原始标准的 ViT 的性能也就已经上来了,对于 ViT large 来说它已经能得到 85.2 的准确度了,已经相当高了
  • 但是 Swin Large 更高,Swin Large 最后能到87.3,这个是在不使用JFT-300M,就是特别大规模数据集上得到的结果,所以还是相当高的

目标检测

  • 表2(a)中测试了在不同的算法框架下,Swin Transformer 到底比卷积神经网络要好多少,主要是想证明 Swin Transformer 是可以当做一个通用的骨干网络来使用的,所以用了 Mask R-CNN、ATSS、RepPointsV2 和SparseR-CNN,这些都是表现非常好的一些算法,在这些算法里,过去的骨干网络选用的都是 ResNet-50,现在替换成了 Swin Tiny
  • Swin Tiny 的参数量和 FLOPs 跟 ResNet-50 是比较一致的,从后面的对比里也可以看出来,所以他们之间的比较是相对比较公平的
  • 可以看到,Swin Tiny 对 ResNet-50 是全方位的碾压,在四个算法上都超过了它,而且超过的幅度也是比较大的
  • 接下来作者又换了一个方式做测试,现在是选定一个算法,选定了Cascade Mask R-CNN 这个算法,然后换更多的不同的骨干网络,比如 DeiT-S、ResNet-50 和 ResNet-101,也分了几组,结果如上图中表2(b)所示
  • 可以看出,在相似的模型参数和相似的 Flops 之下,Swin Transformer 都是比之前的骨干网络要表现好的
  • 接下来作者又做了第三种测试的方式,如上图中的表2(c)所示,就是系统层面的比较,这个层面的比较就比较狂野了,就是现在追求的不是公平比较,什么方法都可以上,可以使用更多的数据,可以使用更多的数据增强,甚至可以在测试的使用 test time augmentation(TTA)的方式
  • 可以看到,之前最好的方法 Copy-paste 在 COCO Validation Set上的结果是55.9,在 Test Set 上的结果是56,而这里如果跟最大的 Swin Transformer–Swin Large 比,它的结果分别能达到58和58.7,这都比之前高了两到三个点

语义分割

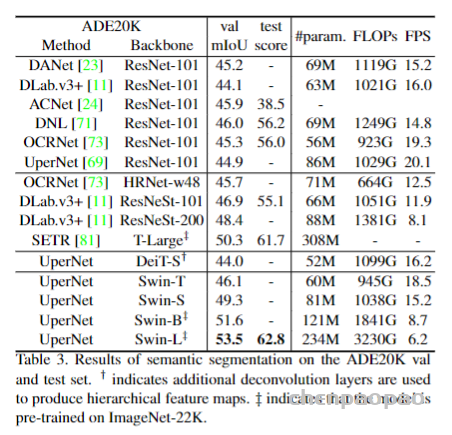
  • 上图表3里可以看到之前的方法,一直到 DeepLab V3、ResNet 其实都用的是卷积神经网络,之前的这些方法其实都在44、45左右徘徊
  • 但是紧接着 Vision Transformer 就来了,那首先就是 SETR 这篇论文,他们用了 ViT Large,所以就取得了50.3的这个结果
  • Swin Transformer Large也取得了53.5的结果,就刷的更高了
  • 其实作者这里也有标注,就是有两个“+”号的,意思是说这些模型是在ImageNet-22K 数据集上做预训练,所以结果才这么好

消融实验

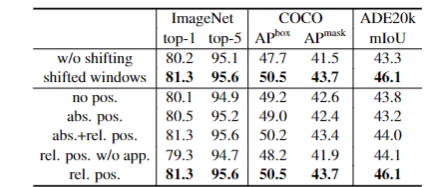
实验结果如下图所示

  • 上图中表4主要就是想说一下移动窗口以及相对位置编码到底对 Swin Transformer 有多有用
  • 可以看到,如果光分类任务的话,其实不论是移动窗口,还是相对位置编码,它的提升相对于基线来说,也没有特别明显,当然在ImageNet的这个数据集上提升一个点也算是很显着了
  • 但是他们更大的帮助,主要是出现在下游任务里,就是 COCO 和 ADE20K 这两个数据集上,也就是目标检测和语义分割这两个任务上
  • 可以看到,用了移动窗口和相对位置编码以后,都会比之前大概高了3个点左右,提升是非常显着的,这也是合理的,因为如果现在去做这种密集型预测任务的话,就需要特征对位置信息更敏感,而且更需要周围的上下文关系,所以说通过移动窗口提供的窗口和窗口之间的互相通信,以及在每个 Transformer block都做更准确的相对位置编码,肯定是会对这类型的下游任务大有帮助的

总结

虽然前面已经说了很多 Swin Transformer 的影响力啊已经这么巨大了,但其实他的影响力远远不止于此,论文里这种对卷积神经网络,对 Transformer,还有对 MLP 这几种架构深入的理解和分析是可以给更多的研究者带来思考的,从而不仅可以在视觉领域里激发出更好的工作,而且在多模态领域里,相信它也能激发出更多更好的工作

torch grid_sample() 函数

grid_sample底层是应用双线性插值,把输入的tensor转换为指定大小。那它和interpolate有啥区别呢?
interpolate是规则采样(uniform),但是grid_sample的转换方式,内部采点的方式并不是规则的,是一种更为灵活的方式。可以认为采样点根据 grid 矩阵来决定。

Pytorch中grid_sample函数的接口声明如下:

torch.nn.functional.grid_sample(input, grid, mode='bilinear', padding_mode='zeros', align_corners=None)

在官方文档里面关于该函数的作用是这样描述的:

Given an input and a flow-field grid, computes the output using input values and pixel locations from grid.

简单来说就是,提供一个input的Tensor以及一个对应的flow-field网格(比如光流,体素流等),然后根据网格(grid)中每个位置提供的坐标信息(这里指input中pixel的坐标),将input中对应位置的像素值填充到grid指定的位置,得到最终的输出。

关于input、grid以及output的尺寸如下所示:(input也可以是5D的Tensor,这里我们只考虑4D的情况) 注意output的尺寸可以大于input,所以 grid_sample 可以用来上采样

input:(N,C,Hin,Win)
grid:(N,Hout,Wout​,2)
output:(N,C,Hout,Wout​)

这里的input和output就是输入的图片,或者是网络中的feature map。关键的处理过程在于grid,grid的最后一维的大小为2,即表示input中pixel的位置信息 (x,y) ,这里一般会将x和y的取值范围归一化到 [−1,1] 之间, (−1,−1) 表示input左上角的像素的坐标,(1,1) 表示input右下角的像素的坐标,对于超出这个范围的坐标(x,y),函数将会根据参数padding_mode的设定进行不同的处理。

  • padding_mode=’zeros’:对于越界的位置在网格中采用pixel value=0进行填充。
  • padding_mode=’border’:对于越界的位置在网格中采用边界的pixel value进行填充。
  • padding_mode=’reflection’:对于越界的位置在网格中采用关于边界的对称值进行填充。

对于mode=’bilinear’参数,则定义了在input中指定位置的pixel value中进行插值的方法,为什么需要插值呢?因为前面我们说了,grid中表示的位置信息x和y的取值范围在 [−1,1] 之间,这就意味着我们要根据一个浮点型的坐标值在input中对pixel value进行采样,mode有'bilinear' | 'nearest' | 'bicubic'(双三次插值)三种模式。 nearest就是直接采用与 (x,y) 距离最近处的像素值来填充grid,而bilinear则是采用双线性插值的方法来进行填充,mode=’bicubic’仅支持四维输入,总之其与nearest的区别就是nearest只考虑最近点的pixel value,而bilinear则采用(x,y)周围的四个pixel value进行加权平均值来填充grid。

双线性插值:双线性插值是用原图像中4(2*2)个点计算新图像中1个点

双三次插值(Bicubic interpolation):双三次插值是用原图像中16(4*4)个点计算新图像中1个点,效果比较好,但是计算代价过大

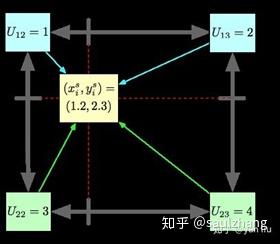
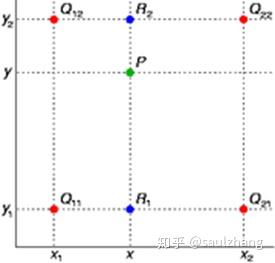
上面讲到双线性插值会对 (x,y) 周围的四个pixel value进行加权平均,那么每个位置的权重是多少呢?可以简单参考下图中双线性插值的例子:

其双线性插值的结果为:

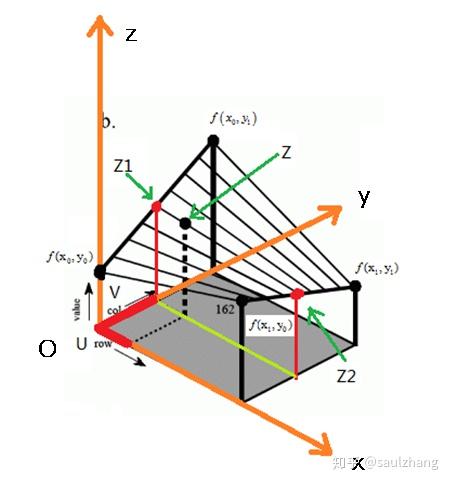
采用下图我们可以对双线性插值有个更为直观的认识:

从上图中可以看到双线性插值就是首先在平面 zoy 内,对 f(x0,y0) 和 f(x0,y1) 进行插值得到 z1 ,对 f(x1,y0) 和 f(x1,y1) 进行插值得到 z2 ,随后在平面 zox 内进行插值得到最终的 z 点的值就是最终所求的结果,这里的平面内插值其实就是采用我们高中学的,直线的两点式求出直线表达是,再带入自变量(x或y)的坐标得到插值的结果。联立两次直线的两点式就能得到双线性插值的结果,说到这里“双线性”也顾名思义了。

下面给出正式的推导:

已知四点的坐标如下所示:

Q11=(x1,y1,f(x1,y1)), Q21=(x2,y1,f(x2,y2)), Q12=(x1,y2,f(x3,y3)), Q22=(x2,y2,f(x4,y4))

其中有z=f(x,y):

先在x方向上进行插值有:

以上式子便是最终双线性插值的最终表达式,由于4个点的权重部分中分母是相同的可以忽略不计,现在再回去看上面的例子是不是就一目了然了。

例子:

import torch
from torch.nn import functional as F

inp = torch.ones(1, 1, 4, 4)
print(inp)
# 目的是得到一个 长宽为20的tensor
out_h = 20
out_w = 20
 # grid的生成方式等价于用mesh_grid
new_h = torch.linspace(-1, 1, out_h).view(-1, 1).repeat(1, out_w)
new_w = torch.linspace(-1, 1, out_w).repeat(out_h, 1)
grid = torch.cat((new_h.unsqueeze(2), new_w.unsqueeze(2)), dim=2)
grid = grid.unsqueeze(0) #返回一个新的张量,对输入的既定位置插入维度 1
print(grid.shape)
outp = F.grid_sample(inp, grid=grid, mode='bilinear')
print(outp.shape)  #torch.Size([1, 1, 20, 20])

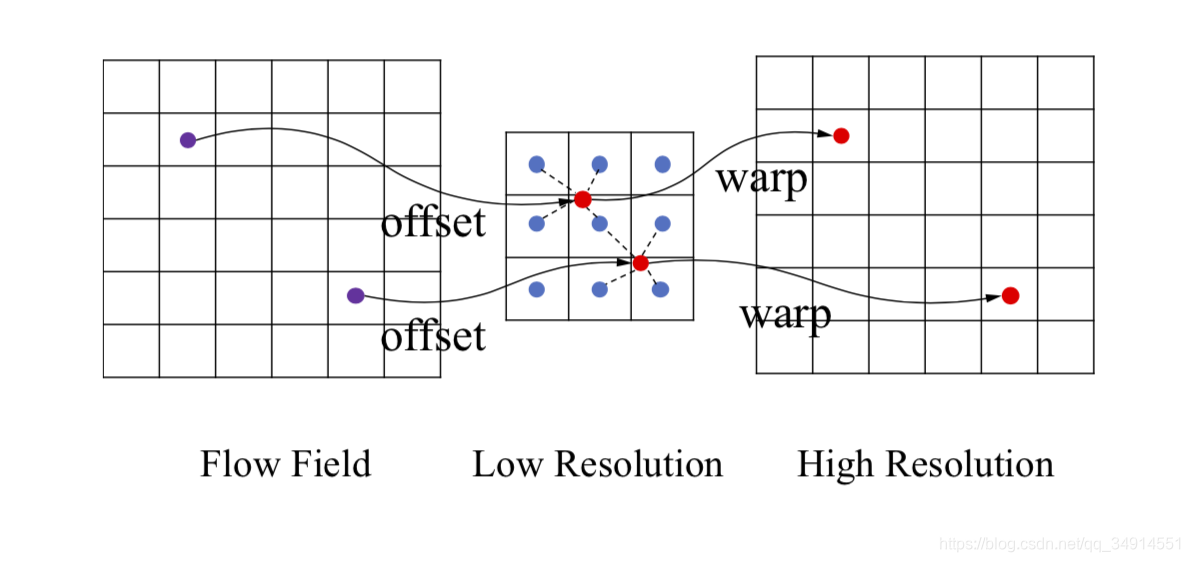
在上面的例子中,我们将一个大小为4×4的tensor 转换为了一个20×20的。grid的大小指定了输出大小,每个grid的位置是一个(x,y)坐标,其值来自于:输入input的(x,y)中 的四邻域插值得到的。

在这里插入图片描述
图片来自于SFnet(eccv2020)。flow field是grid, low_resolution是input, high resolution是output。

BPR:用于实例分割的边界Patch优化(CVPR2021)


Look Closer to Segment Better: Boundary Patch Refinement for Instance Segmentation

代码链接:https://github.com/tinyalpha/BPR

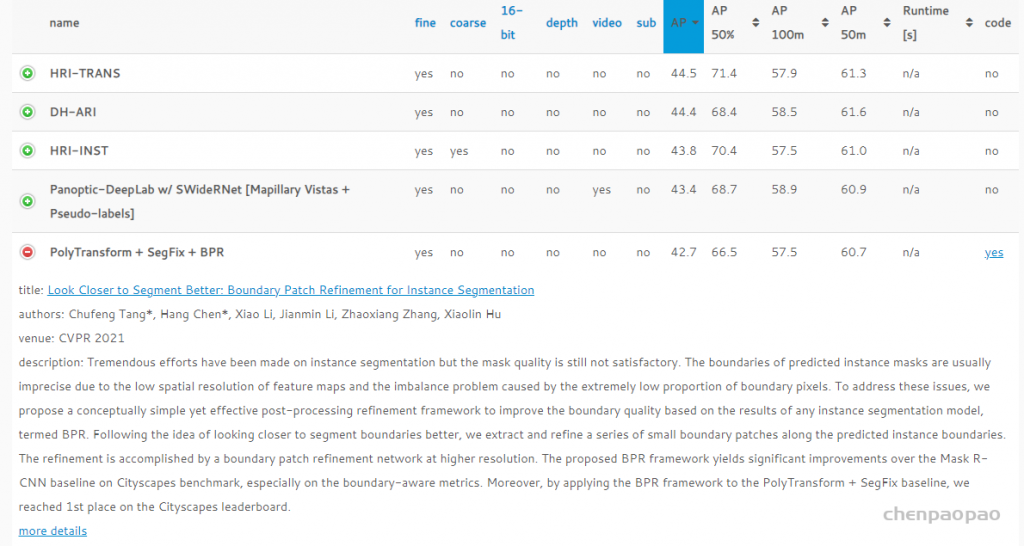
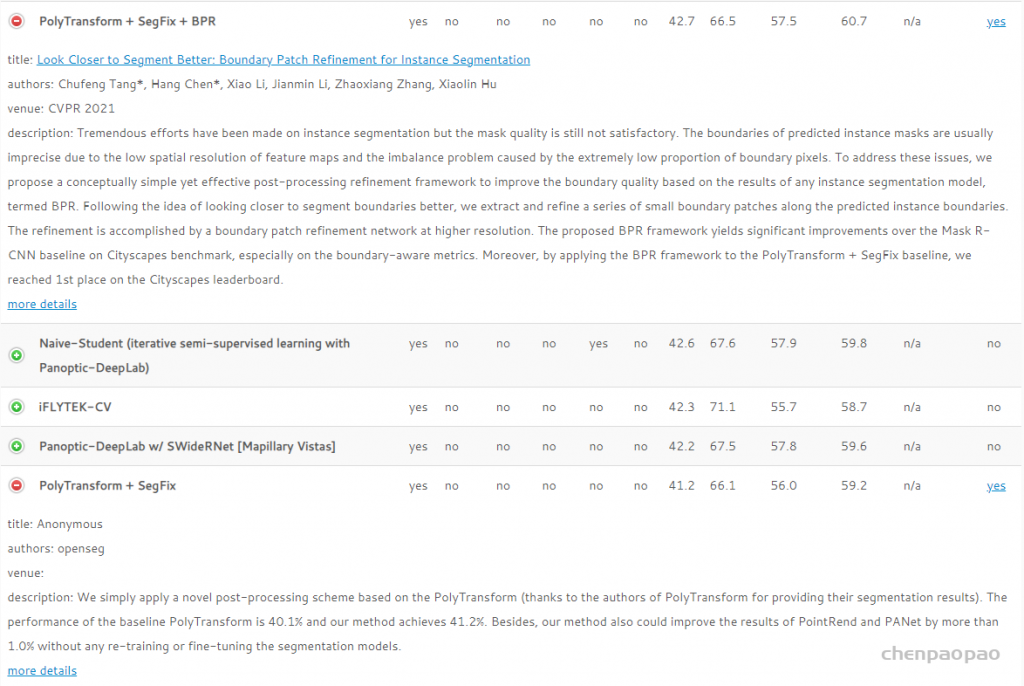
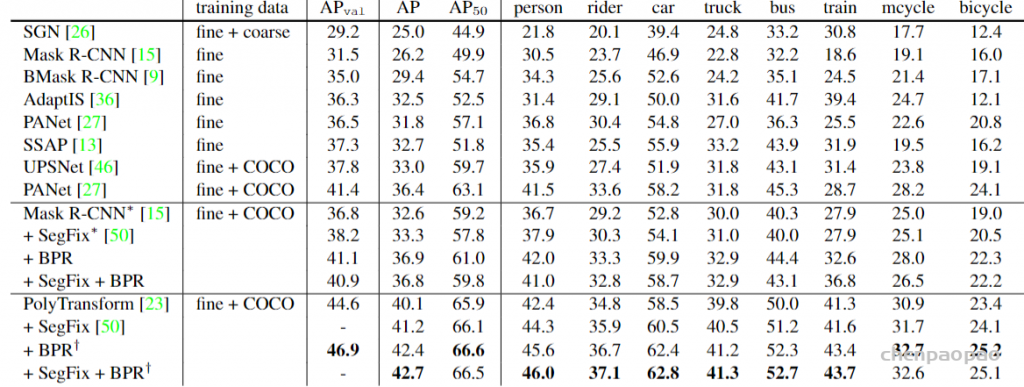
后处理分割结果,效果是即插即用后处理模块当年的sota通过将 BPR 框架应用于 PolyTransform + SegFix 基线,我们在 Cityscapes 排行榜上排名第一。

从目前的排名来说(22.09.23),排名第五,与top1相差不到2个百分点,而 BPR后处理使得PolyTransform + SegFix的效果提升了1.5个百分点。 相比于MASK-RCNN提升了4.2个百分点。

CVPR21上一篇关于实例分割的文章。对于Mask RCNN来说,其最终得到的mask分辨率太低,因此还原到原尺寸的时候,一些boundary信息就显得非常粗糙,导致预测生成的mask效果不尽如人意。而且处于boundary的pixel本身数量相比于整张image来说很少,同时本身难以做分类。现有的一些方法试图提升boundary quality,但预测mask边界这个task本身的复杂度和segmentation很接近了,因此开销较大。

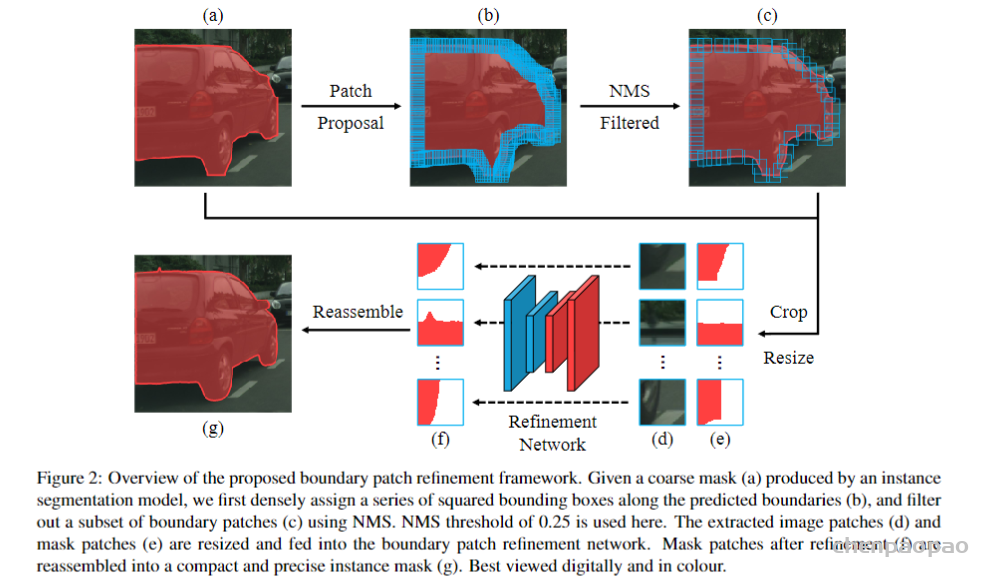
因此本文作者提出了一种crop-and-refine的策略。首先通过经典的实例分割网络(如Mask RCNN)得到coarse mask。随后在mask的boundary出提取出一系列的patch,随后将这些patch送入一个Refinement Network,这个Refinement Network负责做二分类的语义分割,进而对boundary处的patch进行优化,整个后处理的优化网络称为BPR(Boundary Patch Refinement)。该网络可以解决传统Mask RCNN预测的mask的边界粗糙的问题。

本文的核心就是在Mask RCNN一类的网络给出coarse mask后,如何设计Refine Network来对这个粗糙 mask 的边界进行优化,进而得到resolution更高,boundary quality更好的mask。

给定一个coarse mask(上图a),首先需要决定这个mask的哪些部分要做refine。这里作者提出了一种sliding-window式的方法提取到boundary处的一系列patch(上图b)。具体来说,就是在mask边界处密集assign正方形的bounding box,这些box内部囊括了boundary pixel。随后,由于这些box有的overlap太大导致redundant(冗余),这里采用NMS进行过滤(上图c),以实现速度和精度的trade-off(平衡)。

随后这些survive下来的image patch(上图d)和mask patch(上图e)都resize到同一尺寸,一起喂入Refinement Network。这里作者argue说一定要喂入mask patch,因为一旦拥有mask patch的location和semantic信息,这个refinement network就不再需要学习instance-level semantic(实例类别信息,比如这个image patch属于哪个类别)了。所以,refinement network只需要学习boundary处的hard pixel,并把它们正确分类。

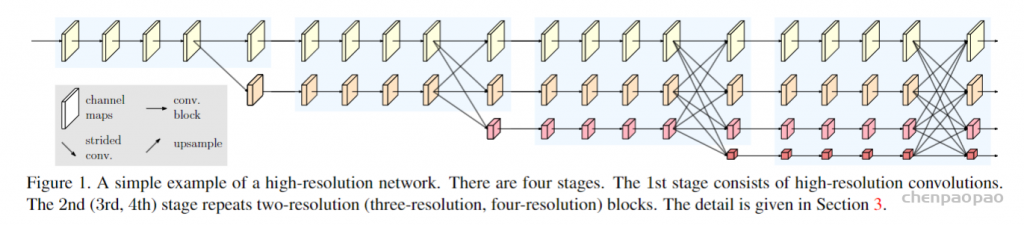
关于Refinement Network,其任务是为每一个提取出来的boundary patch独立地做二分类语义分割,任何的语义分割模型都可以搬过来做这个task。输入的通道数为4(RGB+mask),输出通道数为2(BG or FG),这里作者采用了HRNetV2(CVPR 2019),这种各种level feature不断做融合的网络可以maintain高分辨率的representation。通过合理的增加input size,boundary batch就可以得到比之前方法更高的resolution。

HRNetV2 网络结构

在对每个patch独立地refine以后,需要将它们reassemble(组装)到coarse mask上面。有的相邻的patch可能存在overlap的情况,最终的结果是取平均,以0.5作为阈值判断某个pixel属于前景或是背景。

Experiment

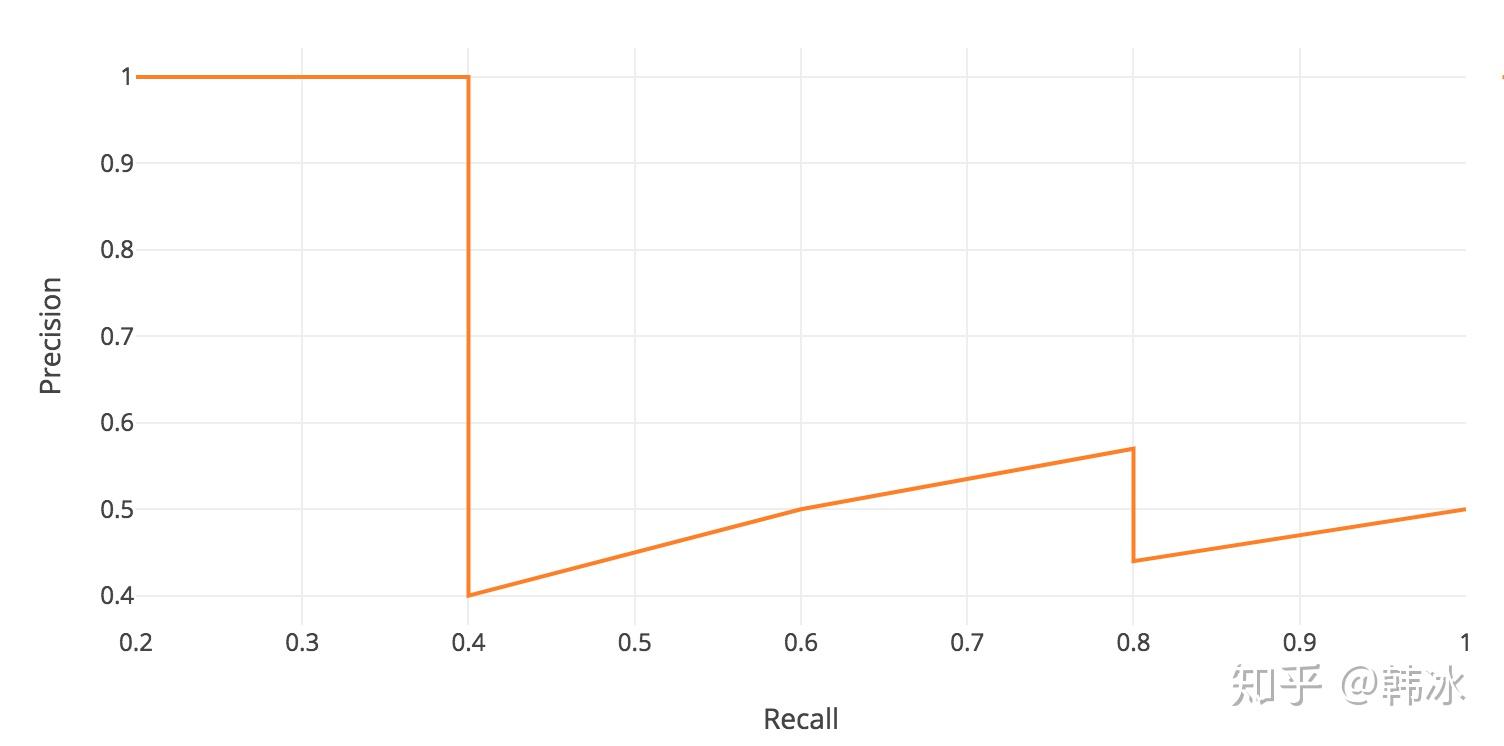
这里的指标是AP (Average precision):指的是PR曲线的面积(AP就是平均精准度,简单来说就是对PR曲线上的Precision值求均值。)对于实例分割的评价指标:使用AP评价指标

实例分割和目标检测mAP计算时除了IOU计算方式(实例分割是mask间的IOU)不同,其他都是一样的.

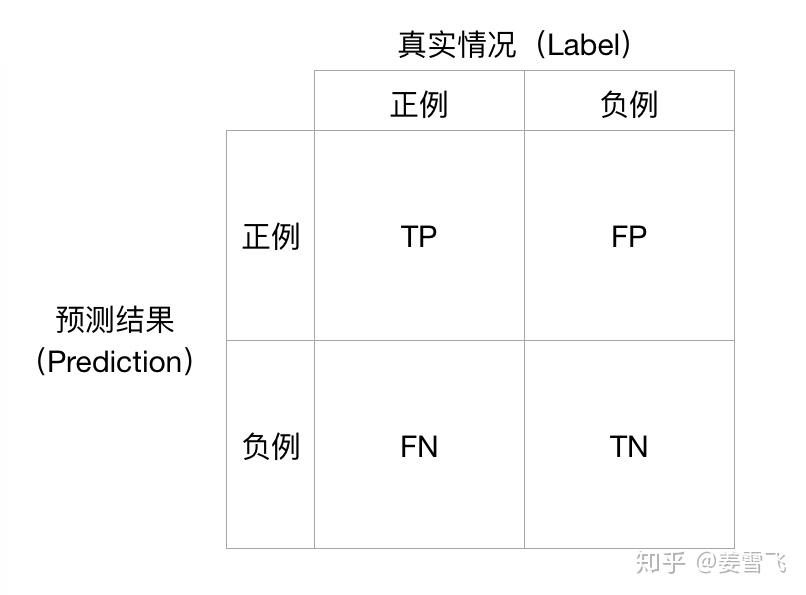
对于一个二分类任务,二分类器的预测结果可分为以下4类:

二分类器的结果可分为4类

Precision的定义为:

Recall的定义为: 

Precision从预测结果角度出发,描述了二分类器预测出来的正例结果中有多少是真实正例,即该二分类器预测的正例有多少是准确的;Recall从真实结果角度出发,描述了测试集中的真实正例有多少被二分类器挑选了出来,即真实的正例有多少被该二分类器召回。

逐步降低二分类器预测正例的门槛,则每次可以计算得到当前的Precision和Recall。以Recall作为横轴,Precision作为纵轴可以得到Precision-Recall曲线图,简称为P-R图。

详细解释:目标检测/实例分割中 AP 和 mAP 的混淆指标

preview

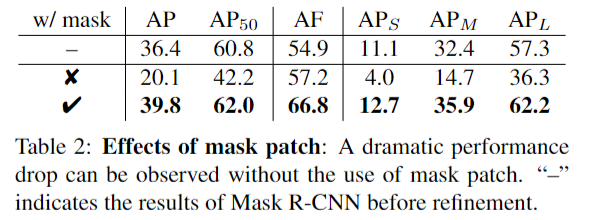
首先通过实验证明了将mask patch一并作为输入的重要性:

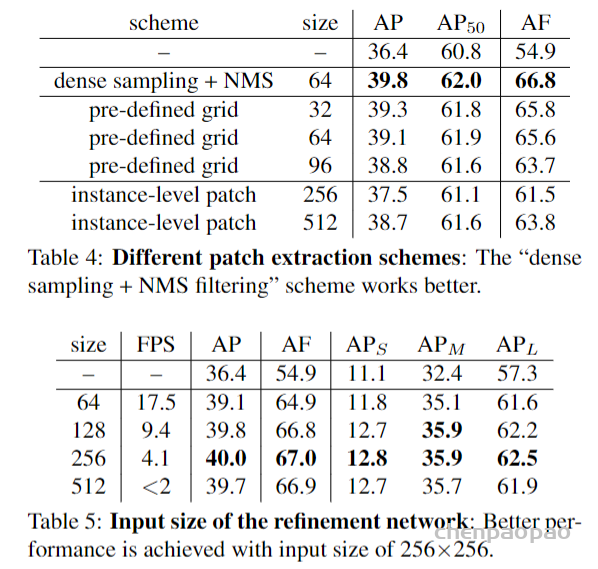
patch size、不同的patch extraction策略,input size对结果的影响:

RefineNet的选取,NMS的阈值:

Cityscape上与其他方法的比较:PolyTransform + SegFix baseline,达到最高的AP。

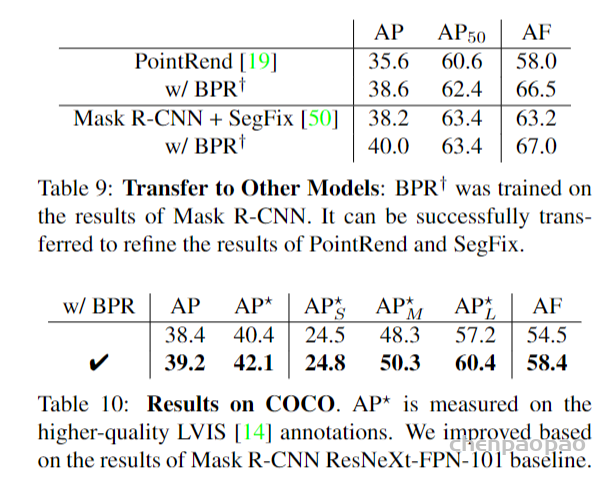
迁移到其他model上面的结果 and coco数据集上的结果