- paper: https://arxiv.org/abs/2609.36834
- code: https://github.com/ASLP-lab/WenetSpeech-Min-Repo
WenetSpeech-Min 是一个开源的大规模闽南语语音语料库,来自不同的在线媒体来源。该语料库包含约 10,000 小时的真实语音数据。每一条语音记录都配有闽南语和普通话的转录文本,这使得系统能够同时实现保留方言特征的识别功能,以及输出清晰的普通话文本功能。
- 在现实世界中,语音数据来自多个来源,涵盖了各种说话风格、应用场景以及声音条件。
- 双重转录方式:闽南方言保留了当地的口语表达形式;而普通话则提供了与闽南方言相对应的书面表达形式。
- 公开基准数据:包括人工验证的闽南语语音识别、普通话语音识别以及闽南语语音合成评估数据。
数据构建流程
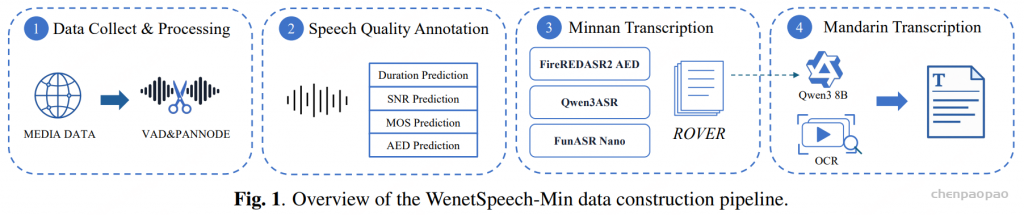
该流程由两个主要部分组成:音频处理和配对转写生成。第一部分对音频进行分段,并依据语音内容和声学质量对所得片段进行过滤。第二部分结合多个闽南语 ASR 系统获得方言转写,然后生成对应的普通话转写。
音频处理: 从各种在线媒体来源收集闽南语语音,VAD切分,计算信噪比(SNR)和时长,计算WV-MOS来描述片段的声学质量,预测AED (声学事件检测) , 估计片段包含语音的置信度,并移除低于预定义阈值的片段,最后使用 pyannote 估计每个保留片段中的说话人数;
文本标注工具:使用人工转写的闽南语语音构建专用标注模型,使用 1,600 小时带有人工核验闽南语转写的语音,对 Qwen3-ASR、FireRedASR2-AED 和 Fun-ASR-Nano进行微调,用于生成方言转写候选结果。对一个 600 小时的子集进行标注,并人工核验配对的闽南语和普通话转写,使用 LoRA 对 Qwen3-8B进行微调,从而得到专用的闽南语到普通话翻译模型,用于生成普通话转写。
配对转写生成:三个 ASR 标注模型产生互补的候选结果;随后使用ROVER 对这些结果进行对齐和组合。组合结果被保留为方言转写。普通话转写通过两条路径之一获得。对于带有内嵌字幕的媒体,用 OCR提取字幕文本,并直接使用归一化后的字幕文本。对于其他媒体,则由微调后的 Qwen3-8B 翻译模型将 ROVER 组合得到的方言转写转换为书面普通话。随后对候选转写进行归一化,并对每个音频—文本对执行一致性检查。对于分段不可靠或内容置信度较低的样本,会将其删除或退回修正。
Dataset
WenetSpeech-Min 涵盖了大约 10,000 小时的语音数据。平均语音持续时间为 7.24 秒;中位数则在 5 到 7.5 秒之间,语料库以短话语为主,同时包含少量更长的连续语音片段。其中,约 8,500 小时的语音数据来源于不同来源:戏剧类内容占 54.7%,有声书占 19.8%,而娱乐类内容占 13.9%。
该语料库特意包含了相对清晰的语音记录以及具有挑战性的档案式电视素材。这样可以保留自然的多语言交互场景、富有情感的表达方式,以及多种多样的真实录音环境。
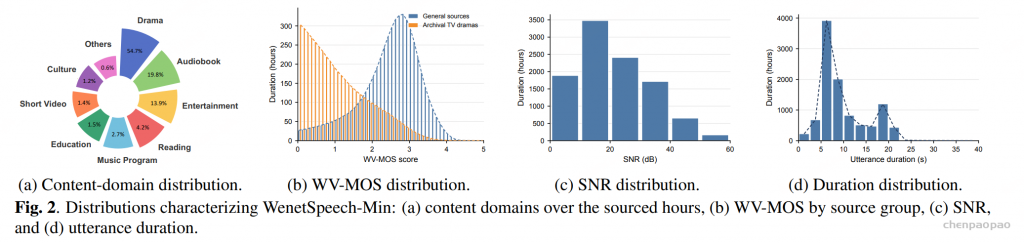
SNR 分布分布主要集中在 10 至 40 dB 之间,占总时长的 73.8%。按时长加权的平均 SNR 为 21.3 dB,中位数落在 19–20 dB 区间,表明所发布的语料库总体具有中等到较高的声学质量,同时保留了相当范围的录音条件
基准
ASR 基准:WS-Min-Eval-ASR,每个话语都配有两份人工核验的参考文本:一份闽南语转写和一份普通话转写。这种配对设计使得两种转写目标能够使用相同的音频片段和标注协议进行评估。所有系统都遵循统一的文本归一化和评分流程。对于闽南语转写,我们针对闽南语参考文本报告方言字符错误率(D-CER)。对于普通话转写,我们针对普通话参考文本报告普通话双语评估替补(M-BLEU)和普通话字符错误率(M-CER)。当有效的普通话表达在措辞上可能不同时,M-BLEU 作为 n-gram 重叠的补充度量;M-CER 则衡量字符级准确率。
TTS 基准:由 LLM 生成、并经过自然度和方言真实性优化的专家核验闽南语文本组成。Easy 子集包含 500 条日常话语,Hard 子集包含 250 条具有挑战性的文本:其中 46 条为 161–270 字的长文本,189 条为包含五至七次重复的高重复文本,15 条为绕口令。我们根据声学质量和方言真实性,从内部闽南语语料库中选取 9 名参考说话人。对于客观评估,使用 Qwen3-ASR-WSM-Min 模型生成的转写,通过 CER 衡量可懂度;说话人相似度(SIM)则计算合成语音与参考语音的 WavLM [2] 嵌入之间的余弦相似度。对于主观评估,23 名以闽南语为母语的听众对 40 个随机选取的测试案例进行评估,指标包括可懂度(I-MOS)、说话人相似度(S-MOS)和口音真实性(A-MOS);其中每个子集抽取 20 个案例。
ASR Leaderboard
D-CER 和 M-CER 来说,数值越低越好;而对于 M-BLEU 则相反,数值越高越好。†符号表示使用的是商业 API。
闽南语:
| Model | D-CER (%) ↓ |
|---|---|
| Hy-ASR-3.0-Preview† | 32.78 |
| CN-MultiDialect-ASR | 18.59 |
| Qwen3-ASR | 34.61 |
| Qwen3-ASR-WSM-Min | 17.59 |
| Qwen3-ASR-WSM-Min + internal data | 15.21 |
| FireRedASR2-AED | 43.39 |
| FireRedASR2-AED-WSM | 18.95 |
普通话转录:
Each entry reports M-BLEU ↑ / M-CER ↓; GigaSpeech denotes GigaSpeechBench.
| Model | WS-Min | GigaSpeech | MinSpeech | Avg. |
|---|---|---|---|---|
| FunASR-Realtime† | 39.09/45.41 | 53.37/32.62 | 28.22/63.23 | 40.23/47.09 |
| SeedASR2.0† | 38.91/47.58 | 55.32/32.50 | 68.53/26.21 | 54.25/35.43 |
| Qwen3-ASR-MinSpeech | 20.34/60.57 | 12.39/71.26 | 67.94/23.93 | 33.56/51.92 |
| Qwen3-ASR-WSM-Mandarin | 42.93/42.56 | 51.20/34.01 | 59.82/29.42 | 51.32/35.33 |
| Qwen3-ASR-WSM-Mandarin + internal data | 49.39/36.81 | 47.65/36.66 | 65.69/26.21 | 54.24/33.05 |
| FireRedASR2-AED | 18.05/64.40 | 36.91/49.35 | 13.60/85.02 | 22.85/66.26 |
| FireRedASR2-AED-WSM | 46.06/39.53 | 57.73/28.61 | 57.73/31.85 | 53.73/33.33 |
TTS Leaderboard
Lower CER is better; higher is better for all other metrics. † indicates a commercial API. ‡ denotes a single-fixed-speaker API, for which SIM and S-MOS are not evaluated.
| Model | CER (%) ↓ | SIM ↑ | I-MOS ↑ | S-MOS ↑ | A-MOS ↑ |
|---|---|---|---|---|---|
| QwenAudio-3.0-TTS† | 19.90 | 0.672 | 3.88 | 3.85 | 3.62 |
| Qwen3TTS-Flash†‡ | 24.44 | – | 3.93 | – | 3.93 |
| FireRedTTS3 | 33.76 | 0.747 | 3.30 | 3.32 | 3.13 |
| VoxCPM2 | 28.16 | 0.707 | 3.45 | 3.54 | 3.38 |
| MERaLiON-TTS | 21.25 | 0.622 | 3.83 | 3.73 | 3.65 |
| CosyVoice3 | 63.69 | 0.654 | 2.13 | 2.13 | 1.49 |
| CosyVoice3-WSM | 20.26 | 0.678 | 3.85 | 3.75 | 3.65 |
| Model | CER (%) ↓ | SIM ↑ | I-MOS ↑ | S-MOS ↑ | A-MOS ↑ |
|---|---|---|---|---|---|
| QwenAudio-3.0-TTS† | 35.09 | 0.685 | 3.75 | 3.73 | 3.70 |
| Qwen3TTS-Flash†‡ | 38.02 | – | 3.75 | – | 3.73 |
| FireRedTTS3 | 55.33 | 0.731 | 3.15 | 3.39 | 3.04 |
| VoxCPM2 | 40.50 | 0.681 | 3.17 | 3.48 | 3.36 |
| MERaLiON-TTS | 37.28 | 0.622 | 3.58 | 3.73 | 3.63 |
| CosyVoice3 | 60.35 | 0.610 | 2.00 | 2.40 | 1.43 |
| CosyVoice3-WSM | 35.98 | 0.669 | 3.65 | 3.85 | 3.70 |