YODAS v3 论文拆解:110 万小时高带宽立体声多语言语料,如何从检索到训练落地

一、论文到底贡献了什么

YODAS v3 的核心贡献不是提出一个新的 ASR 网络,而是提出一套面向大规模、多语言、宽带和立体声语音的数据构建方法,并用两个基线任务验证数据是否可用。论文将开源语音数据的瓶颈概括为三点:大量语料仍是 16 kHz 或 24 kHz 单声道;中低资源语言在通用网页检索中容易被高资源语言挤压;仅有音频时长而没有字幕、翻译和时间戳,难以直接用于监督训练。

二、和已有开源语音语料相比,YODAS v3 的位置

论文 Table 1 使用论文撰写时的统一口径比较规模、采样率、立体声、标注与许可证。下面完整保留该表的关键数字;“Stereo”表示数据集是否以立体声或多声道为主要发布形态,而不是说每一个文件都一定有两个互不相同的声道。

数据集语言数规模(小时)采样率立体声有标注许可证
Common Voice13733k48 kHz否是CC0
MLS851k16 kHz否是CC BY 4
FLEURS1021k16 kHz否是CC BY 2.5
VoxLingua1071077k16 kHz否是CC BY 4
LibriLight160k16 kHz否否CC BY 4
VoxPopuli23400k16 kHz否否CC0
Emilia6100k24 kHz否是CC BY-NC 4
Unsupervised People’s Speech89740k48 kHz是否CC BY-SA 4
YODAS v2140550k24 kHz否是CC BY 3
YODAS v31471100k48 kHz是弱标注CC BY 3
表 1:论文中的开源大规模语音数据集比较。

这里的“147 languages”需要谨慎理解。论文分析章节按 YouTube 上传者提供的 locale 统计,locale 是语言分布的代理字段,不是对每段音频进行人工或模型语音识别后的金标准语言标签。当前 Hugging Face 数据卡又提供了 transcript_lang 目录,因此会出现 103 个目录(102 个语言码加 unk)与论文 147 个 locale 代码并存的情况;二者是不同字段、不同统计问题,并不矛盾。

从 Table 1 看,v3 相比 v2 的名义时长约翻倍,并保留更高采样率与多声道;相比 Unsupervised People’s Speech,则额外提供可用于监督训练的字幕。但表中的“有标注”只表示存在标注机制,不能解释为全部音频都有人工标注。

三、数据采集流水线:从 Wikipedia 关键词到 Creative Commons 视频

3.1 关键词生成:解决“用英文搜全世界”的偏置

YODAS v2 复用共享的多语言 Wiki 关键词列表,容易出现两类错误:低资源语言没有足够查询词,以及查询词实际上是英语或其他语言。v3 改成“每种语言单独生成关键词”。作者下载每种语言的 Wikipedia dump,先按规则过滤候选词:不能只有数字或标点;首字符不能是数字或标点;长度限制为 3 至 30 个字符;排除文件名、DOI、Wikipedia Template 和 Request 页面。

接着,作者在每种语言的候选词上训练 unigram subword tokenizer。词表有预设大小;如果候选语料太小,便逐步减半词表直到 tokenizer 能够训练。对候选关键词分词后,用 unigram 语言模型概率排序,保留似然较高且不太罕见的词。论文没有公开固定的词表大小、最终 top-K 数量或每种语言的搜索预算,因此复现时应把这几个量视为需要自行设定的工程超参数。

\(\log P(w)=\sum_{i=1}^{m}\log p(s_i),\quad w=(s_1,s_2,\ldots,s_m)\)

上式是对论文步骤的工程化表达:将关键词 w 切成若干 subword 后累加 unigram 对数概率。它帮助筛掉模板词、极罕见实体和无法代表自然语言内容的条目,但不是论文单独编号的理论创新公式。

3.2 视频搜索:按语言分治,并使用两轮检索
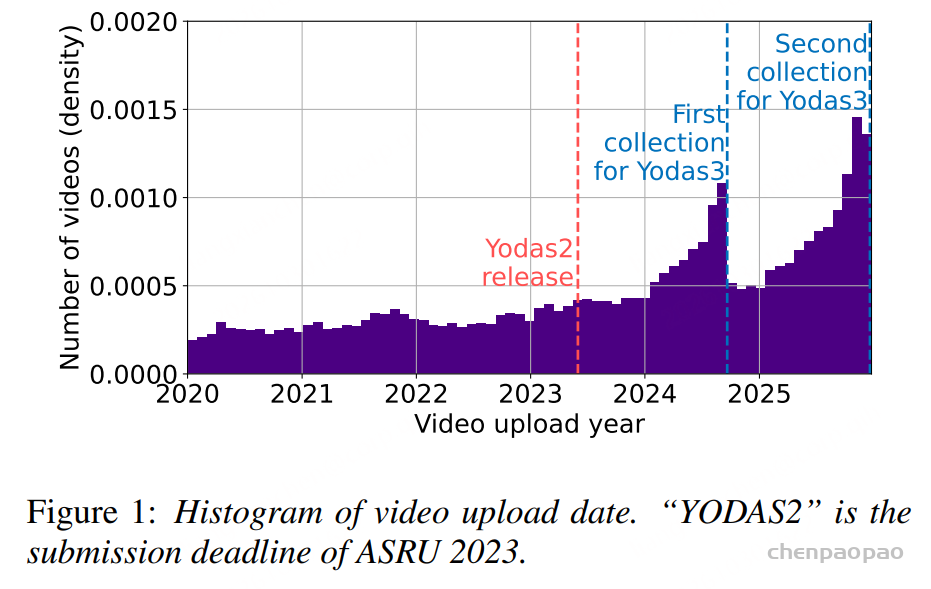
3.3 下载与弱标注

下载时优先使用视频原始语言的人工字幕;没有人工字幕时使用 YouTube 自动字幕。如果存在非英语字幕,还保存英文字幕。每个字幕条目保留开始时间和持续时间,并与音频文件建立 ID 级关联。视频 description 也被保存,论文把它视为未来检索、摘要和多模态任务的潜在信号,而没有在本文实验中单独证明其收益。

v3 中人工字幕占比约 3.7%,低于 v2 的约 20%。作者推测 YouTube 自动字幕质量提升,降低了上传者制作人工字幕的必要性;论文没有提供人工转写对照集、字幕字符错误率或显著性检验,因此不能把“自动字幕质量提升”写成已验证的定量结论。

“3.7%”的分母在论文中没有进一步细分为视频数、句子数还是小时数,因此本文保留原文的占比表述,不据此推算人工字幕小时数。另外,原始视频音轨可以包含音乐、背景噪声和多个声源,110 万小时是抓取音轨时长,并非经过 VAD 验证后的纯语音时长。

阶段输入主要操作输出
关键词各语言 Wikipedia dump规则过滤、unigram tokenizer、似然排序每种语言的查询词
检索语言查询词、YouTubeCreative Commons、两轮搜索、优先新上传、去除 v2 ID候选视频 ID
字幕人工字幕或自动字幕优先原语言,补充英文字幕,保存时间戳弱监督 transcript/translation
音频最高质量视频流下载 48 kHz 多声道 Opus/WebM原始宽带音频
分析音频和字幕元数据语言、时长、带宽、声道、质量过滤数据卡和实验子集
YODAS v3 采集流程的工程化摘要。
论文 Table 2 元数据示例或含义
Channels / Effective channels容器声道数与去除重复后的有效声道数,例:2 / 2
Sampling rate / Max bandwidth解码采样率与最高有效频率,例:48 kHz / 20 kHz
Views / Language观看次数、语言代理标签,例:67 / French
Transcript / Translation原语言字幕与英文翻译
Description视频描述,可为检索或摘要提供上下文
表 2:论文给出的元数据示例。其字段集合不等于当前 Parquet 的完整 schema。

四、数据组成与 Hugging Face 发布结构

数据卡中的 id 是 32 位十六进制字符串,shard 是四位编号。音频文件、JSON 和 Parquet 行应通过同一 id 与 shard 关联,不要假设 tar 内文件顺序与 Parquet 行号一致。transcript 字段通常是 JSON 字符串或 null;解析后可得到 segment 的 start/duration,以及相对于 segment 起点的 word 时间偏移。音频 length 以秒计,字幕时间戳以毫秒记录。

当前默认 preview 配置只是预览集,不代表完整的一百多万小时。完整数据应按语言和 shard 流式处理。论文的下载流水线与 Hugging Face 的打包流水线也不是一回事:前者解释数据如何被发现和筛选,后者解释已经发布的文件如何组织。

data/
  <lang>/
    audio/0000.tar
    audio/0001.tar
    metadata/0000.parquet
    metadata/0001.parquet
  unk/  # 没有字幕语言可用于分组的音频
当前数据卡字段单位 / 解释使用注意
id、shard样本标识、四位分片号以 ID 关联音频与元数据
transcriptJSON 字符串或 nullsegment 时间为毫秒,words.t 是相对 segment.start 的偏移
translation_en英文翻译 JSON 或 null只有句级时间戳;卡片报告约 107 万个视频有该字段
transcript_lang、locale_lang字幕轨语言、上传者 locale文件级字段不代表每一句都使用同一种语言
length秒卡片范围 1–153284,均值约 952;长视频宜分段解码
audio_bitratekbit/s容器码率约 3.6–569,中位数约 122;1461 个视频缺失
max_freq_hzHz,约 35–24000约 28.3 万条缺失,不能直接当作低带宽
estimated_bandwidth_hz等效采样率分档8000、16000、22050、24000、32000、44100 或 null
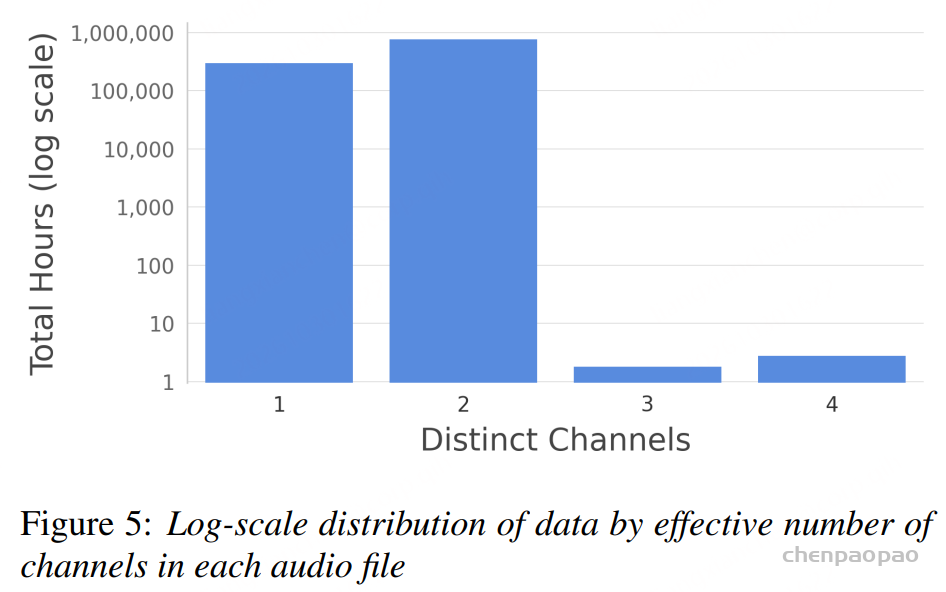
channels容器声道数1、2、4、6;约 99.8% 为 2
n_distinct_channels实测有效声道数1–5 或 null;581 条分析失败,不能当作单声道
当前 Hugging Face 数据卡的发布字段与统计,不是论文 Table 2 的逐列复制。

75%、60%、95% 分别针对是否有字幕、非英语数据是否有翻译、已有字幕是否包含词时间戳,条件集合不同。尤其不要将“60% 非英语数据有翻译”直接换算为“总量的 60% 都是可训练翻译对”。没有字幕的 unk 数据仍可用于无监督音频建模;带字幕的数据也需要检查原语言与翻译是否覆盖同一时间段。

五、规模与音频属性分析

5.1 语言分布:更均衡,但不是严格均衡

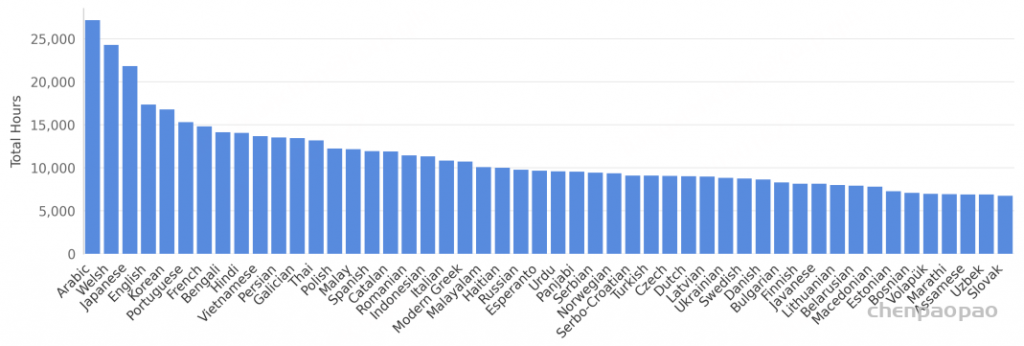
论文统计中,阿拉伯语和威尔士语约 2.5 万小时,日本语约 2.1 万小时,英语约 1.7 万小时且低于总量的 2%;共有 22 种语言超过 1 万小时、73 种语言超过 5000 小时。平均数约 7400 小时而中位数约 5180 小时,说明分布仍然长尾,只是比单纯依靠全球热门查询词更平衡。
5.2 视频时长与有效样本量
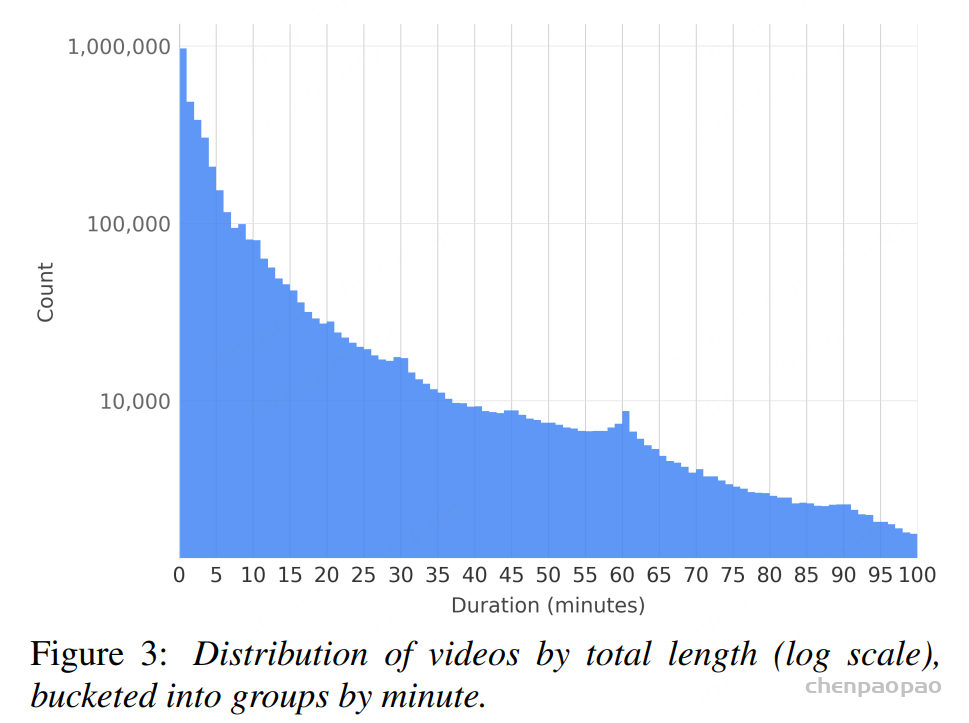
约 400 万个视频中,超过 24% 的视频短于 1 分钟,作者将其与 Shorts 生态联系起来。约 170 万个视频长于 5 分钟,总时长约 100 万小时;约 120 万个视频长于 10 分钟,总时长约 95 万小时。后两个集合是嵌套关系,不能相加。同时数据呈明显长尾分布。约有 400 万个视频(占 24%)少于 1 分钟,作者认为这可能和 YouTube Shorts 的流行有关。论文还指出存在大量超过 60 分钟的直播类视频,但没有给出一个可直接复核的精确小时数。

这组统计提醒我们:总小时数很大,并不意味着每个训练样本都长、都干净或都包含完整对话。做 ASR 时需要按 utterance 切片;做编解码器或空间音频任务时,可能需要重新设计长音频采样和直播片段去重策略。

5.3 48 kHz 不等于每个文件都包含完整 24 kHz 频谱

Opus 解码后可以得到 48 kHz PCM,但上传者的麦克风、混音和编码模式可能只保留较窄频带。论文用 8192 点 Hann 窗、50% 重叠的 STFT 估计最高有效频率:跳过 RMS 不超过 10^-6 的静音帧,找出幅度超过该帧最大幅度 0.5% 的最高频率,再在短视频全程或长视频随机抽取的五个 60 秒片段中取最大值。

\(X_{t,k}=\sum_{n=0}^{N-1}x[n+tH]w[n]e^{-j2\pi kn/N},\quad N=8192,\;H=4096\) \(f_{\mathrm{max}}=\max_{t,k}\{f_k:\lvert X_{t,k}\rvert>0.005\cdot\max_j\lvert X_{t,j}\rvert\}\)

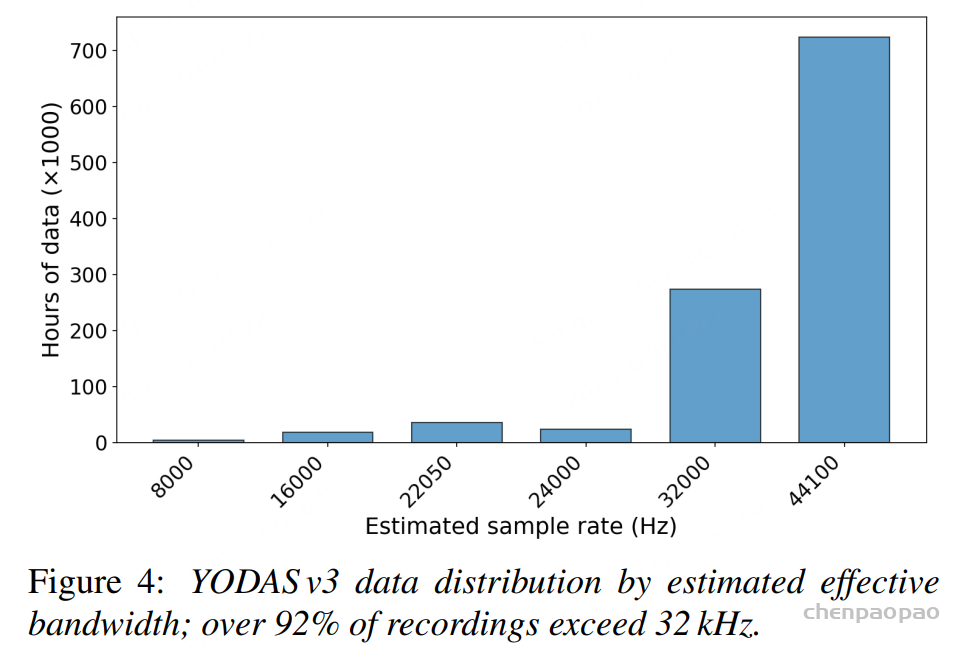
作者把 fmax 映射到候选等效采样率集合 {8, 16, 22.05, 24, 32, 44.1 kHz},选择满足 Nyquist 条件的最小采样率。这里的“44.1 kHz 类”是等效采样率类别,不是说频谱真的延伸到 44.1 kHz;48 kHz PCM 的 Nyquist 频率约为 24 kHz。

结果是:约 67.3% 的数据属于 44.1 kHz 等效带宽类别,论文报告约 92.5% 的数据达到 32 kHz 及以上类别。Figure 4 建议放在本节。这个指标是“检测到的最高频率”而不是对每个片段的主观听感或音乐保真度承诺,噪声、响度和编码伪影都会影响阈值结果。
5.4 多声道与有效声道数

对每个音频文件,论文计算每一对声道的残差 RMS,并用两声道平均 RMS 归一化。若归一化残差低于 10^-3,则将两声道视为有效相同。

\(d_{ij}=\frac{\mathrm{RMS}(x_i-x_j)}{(\mathrm{RMS}(x_i)+\mathrm{RMS}(x_j))/2}\)

超过 71% 的音频文件、约 78 万小时,被判定为真正的多声道;绝大多数是双声道,少量 3 至 4 个有效声道主要来自 5.1 等容器。数据卡还报告约 25% 的视频属于双声道封装但有效单声道的 dual-mono,不能把“容器有两个声道”直接等同于“有空间差异”。不同声道也可能来自音乐混音或编辑后的左右声道,而不是规范的麦克风阵列几何。
六、实验一:ASR 的过滤阈值实验

6.1 实验设置

论文没有训练一个百万小时级的新型语音基础模型,而是使用 OWSM v4 base(约 102M 参数)和 ESPnet,训练 40k steps,验证数据能否支撑多语言 ASR。随机抽取 7 种语言:英语约 4500 小时,德语、法语、日语、葡萄牙语、俄语、越南语各约 100 小时。处理流程固定包含 CTC segmentation 和语言过滤,然后对 CTC 置信分数做分位数过滤。阈值 0.00 表示不做 CTC 分数过滤,但仍然做前面的分段与语言过滤。

Common Voice 作为七种语言的测试集;英语、德语、法语、葡萄牙语、俄语和越南语使用 WER,日语使用 CER。

\(\mathrm{WER}=\frac{S+D+I}{N}\times 100\%,\qquad\mathrm{CER}=\frac{S_c+D_c+I_c}{N_c}\times 100\%\)

这里补充标准指标定义,方便理解表格:S、D、I 分别是替换、删除和插入数,N 是参考词数;CER 改为字符级计数。这不是论文提出的新指标。由于词与字符粒度不同,不能直接拿日语的 27.7 和英语的 15.9 排名判断哪种语言更难。

CTC 分数分位阈值英 WER德 WER法 WER日 CER葡 WER俄 WER越 WER
0.0015.914.417.227.711.115.320.6
0.1015.314.617.829.211.515.421.1
0.2015.315.418.830.912.216.020.8
0.3015.616.321.834.513.416.723.1
表 3:不同 CTC 过滤阈值下的 ASR 结果,数值越低越好。

6.2 如何理解这项“消融”

阈值是 CTC 分数的分位位置,不是一个可以跨模型、跨语言直接比较的绝对置信度分数。将阈值从 0.10 改成 0.30 表示提高分数筛选的严格程度;若要在自己的数据上复现,还需要明确是在每种语言内部还是整个集合上统计分位数,以及 CTC 分数是否做长度归一化。论文正文没有展开这些实现细节。

这是一项围绕数据过滤强度的质量—数量实验,不是模型结构消融。随着阈值从 0.00 提高到 0.30,低分片段被删除得更多,训练数据量下降。六个非英语语言的最佳结果都出现在 0.00;英语在 0.10 和 0.20 达到 15.3,差异很小;越南语在 0.10 到 0.20 还有轻微回落,因此不能把曲线概括成“阈值越低每一种语言必然越好”。

论文将这一点与 YODAS v2 的经验对照:v2 需要较强过滤才能避免超过 100 的 WER,而 v3 即使不做 CTC 分数过滤也能取得可用结果。作者推测原因包括 YouTube 自动字幕质量提高,但没有人工转写金标准、随机种子重复或严格相同数据量控制,因此应把结论写成“观察到的过滤趋势”,而不是普适的最优阈值。

具体看数值,从阈值 0.30 放宽到 0.00,法语 WER 从 21.8 降至 17.2,改善 4.6 个百分点;日语 CER 从 34.5 降至 27.7,改善 6.8 个百分点。这个收益对应“保留更多样本与改变样本质量分布”的联合变化。论文没有报告每个阈值最终保留多少小时,所以无法进一步区分收益究竟来自新增时长、困难样本覆盖还是字幕错误分布。

七、实验二:神经音频编解码器

7.1 设置和基线

作者从 YODAS v3 随机抽取 1200 小时,分别以 16、24 和 48 kHz 训练 DAC 架构,使用 ESPnet-Codec 的官方配置。对照数据为 LibriTTS(585 小时、英语朗读)和 AMUSE(约 33k 小时、包含多语言语音、音乐和声音)。VERSA 工具包在 1000 个视频上做域内测试,并在 LibriTTS 上做域外测试,指标为 STOI 和 WavLM speaker similarity,二者均为越高越好。论文没有声称这是立体声 codec 的专门结构实验,也没有给出比特率、token 帧率和全部模型超参数。

训练数据采样率LibriTTS STOILibriTTS SPKYODAS v3 STOIYODAS v3 SPK
LibriTTS16 kHz0.950.760.740.69
LibriTTS24 kHz0.970.830.800.78
AMUSE16 kHz0.930.740.810.83
AMUSE44 kHz0.950.820.900.77
YODAS v316 kHz0.920.600.820.79
YODAS v324 kHz0.920.660.840.82
YODAS v348 kHz0.970.840.940.90
表 4:Codec 结果。论文表头写作 44 kHz,保留原表口径。

7.2 结果解读

YODAS v3 48 kHz 模型在 LibriTTS 域外测试上达到 STOI 0.97、SPK 0.84,在 YODAS v3 域内测试上达到 STOI 0.94、SPK 0.90。LibriTTS STOI 的 0.97 与 YODAS v3 48 kHz 并列最高,不应写成严格超过;但 YODAS v3 在说话人相似度上取得最高的两个数值。另一方面,较低采样率的 YODAS 模型并不是所有指标都优于基线:例如域外 STOI 仍受训练域、采样率和声音组成影响。

对所有行而言,YODAS 测试集的 STOI 低于 LibriTTS 测试集,符合嘈杂网页音频更难重建的直觉;但 SPK 并不都呈现相同趋势,因此不把“域内更难”推广为每一种指标必然下降。

这个实验支持“宽带、多样化数据有利于 48 kHz codec”的方向性结论,但不能推出所有高采样率任务都会提升,也不能把 STOI 和说话人相似度替代完整的空间听感评测。AMUSE 的数据量约为 33k 小时,远大于 YODAS 实验抽取的 1200 小时,因此表格同时混合了数据量、领域组成和采样率变量,不能单独解释为纯粹的规模定律。

八、结论:YODAS v3 真正解决的是数据形态问题

YODAS v3 的价值不只是把小时数做大,而是把开放语音数据从“单声道、窄带、单一字幕”推进到“宽带、多声道、带时间戳和翻译的弱监督样本”。

YODAS v3 发布了一个规模超过 110 万小时、覆盖 147 种语言的高带宽立体声语音数据集。核心特点可以概括成四点:

  • 第一,规模大。 达到百万小时级,是目前最大的开放语音数据集之一。
  • 第二,语言更均衡。 22 种语言超过 1 万小时,73 种语言超过 5000 小时,英语占比不到 2%。
  • 第三,真正的高带宽和多通道。 92.5% 数据有效带宽超过 32kHz,71% 以上是真正不同的多通道音频。
  • 第四,可以同时支持识别和生成任务。 ASR 实验说明自动转写质量已经比较高;Codec 实验也验证了 48kHz 高带宽数据对于高保真音频建模的价值。

YODAS v3 不只是把开放语音数据堆到 110 万小时,而是第一次把“百万小时、多语言、高带宽、真实立体声”这几个维度真正组合到了一起。

这也使它不再只是一个 ASR 数据集,而是可以进一步服务于 TTS、Audio Codec、语音增强、空间语音等下一代语音模型训练的大规模数据基础。
WenetSpeech-Min:用于方言语音处理的大规模闽南语语音语料库及双重转写

  • paper: https://arxiv.org/abs/2609.36834
  • code: https://github.com/ASLP-lab/WenetSpeech-Min-Repo

WenetSpeech-Min 是一个开源的大规模闽南语语音语料库,来自不同的在线媒体来源。该语料库包含约 10,000 小时的真实语音数据。每一条语音记录都配有闽南语和普通话的转录文本,这使得系统能够同时实现保留方言特征的识别功能,以及输出清晰的普通话文本功能。

  • 在现实世界中,语音数据来自多个来源,涵盖了各种说话风格、应用场景以及声音条件。
  • 双重转录方式:闽南方言保留了当地的口语表达形式;而普通话则提供了与闽南方言相对应的书面表达形式。
  • 公开基准数据:包括人工验证的闽南语语音识别、普通话语音识别以及闽南语语音合成评估数据。

数据构建流程

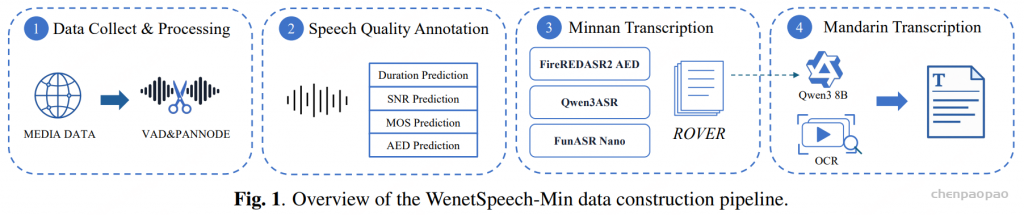
该流程由两个主要部分组成:音频处理和配对转写生成。第一部分对音频进行分段,并依据语音内容和声学质量对所得片段进行过滤。第二部分结合多个闽南语 ASR 系统获得方言转写,然后生成对应的普通话转写。

音频处理: 从各种在线媒体来源收集闽南语语音,VAD切分,计算信噪比(SNR)和时长,计算WV-MOS来描述片段的声学质量,预测AED (声学事件检测) , 估计片段包含语音的置信度,并移除低于预定义阈值的片段,最后使用 pyannote 估计每个保留片段中的说话人数;

文本标注工具:使用人工转写的闽南语语音构建专用标注模型,使用 1,600 小时带有人工核验闽南语转写的语音,对 Qwen3-ASR、FireRedASR2-AED 和 Fun-ASR-Nano进行微调,用于生成方言转写候选结果。对一个 600 小时的子集进行标注,并人工核验配对的闽南语和普通话转写,使用 LoRA 对 Qwen3-8B进行微调,从而得到专用的闽南语到普通话翻译模型,用于生成普通话转写。

配对转写生成:三个 ASR 标注模型产生互补的候选结果;随后使用ROVER 对这些结果进行对齐和组合。组合结果被保留为方言转写。普通话转写通过两条路径之一获得。对于带有内嵌字幕的媒体,用 OCR提取字幕文本,并直接使用归一化后的字幕文本。对于其他媒体,则由微调后的 Qwen3-8B 翻译模型将 ROVER 组合得到的方言转写转换为书面普通话。随后对候选转写进行归一化,并对每个音频—文本对执行一致性检查。对于分段不可靠或内容置信度较低的样本,会将其删除或退回修正。

Dataset

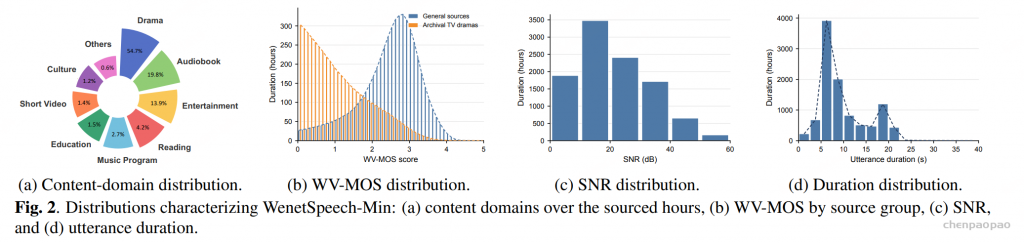
WenetSpeech-Min 涵盖了大约 10,000 小时的语音数据。平均语音持续时间为 7.24 秒;中位数则在 5 到 7.5 秒之间,语料库以短话语为主,同时包含少量更长的连续语音片段。其中,约 8,500 小时的语音数据来源于不同来源:戏剧类内容占 54.7%,有声书占 19.8%,而娱乐类内容占 13.9%。

该语料库特意包含了相对清晰的语音记录以及具有挑战性的档案式电视素材。这样可以保留自然的多语言交互场景、富有情感的表达方式,以及多种多样的真实录音环境。

SNR 分布分布主要集中在 10 至 40 dB 之间,占总时长的 73.8%。按时长加权的平均 SNR 为 21.3 dB,中位数落在 19–20 dB 区间,表明所发布的语料库总体具有中等到较高的声学质量,同时保留了相当范围的录音条件

基准

ASR 基准:WS-Min-Eval-ASR,每个话语都配有两份人工核验的参考文本:一份闽南语转写和一份普通话转写。这种配对设计使得两种转写目标能够使用相同的音频片段和标注协议进行评估。所有系统都遵循统一的文本归一化和评分流程。对于闽南语转写,我们针对闽南语参考文本报告方言字符错误率(D-CER)。对于普通话转写,我们针对普通话参考文本报告普通话双语评估替补(M-BLEU)和普通话字符错误率(M-CER)。当有效的普通话表达在措辞上可能不同时,M-BLEU 作为 n-gram 重叠的补充度量;M-CER 则衡量字符级准确率。

TTS 基准:由 LLM 生成、并经过自然度和方言真实性优化的专家核验闽南语文本组成。Easy 子集包含 500 条日常话语,Hard 子集包含 250 条具有挑战性的文本:其中 46 条为 161–270 字的长文本,189 条为包含五至七次重复的高重复文本,15 条为绕口令。我们根据声学质量和方言真实性,从内部闽南语语料库中选取 9 名参考说话人。对于客观评估,使用 Qwen3-ASR-WSM-Min 模型生成的转写,通过 CER 衡量可懂度;说话人相似度(SIM)则计算合成语音与参考语音的 WavLM [2] 嵌入之间的余弦相似度。对于主观评估,23 名以闽南语为母语的听众对 40 个随机选取的测试案例进行评估,指标包括可懂度(I-MOS)、说话人相似度(S-MOS)和口音真实性(A-MOS);其中每个子集抽取 20 个案例。

ASR Leaderboard

 D-CER 和 M-CER 来说,数值越低越好;而对于 M-BLEU 则相反,数值越高越好。†符号表示使用的是商业 API。

闽南语:

ModelD-CER (%) ↓
Hy-ASR-3.0-Preview†32.78
CN-MultiDialect-ASR18.59
Qwen3-ASR34.61
Qwen3-ASR-WSM-Min17.59
Qwen3-ASR-WSM-Min + internal data15.21
FireRedASR2-AED43.39
FireRedASR2-AED-WSM18.95

普通话转录:

Each entry reports M-BLEU ↑ / M-CER ↓; GigaSpeech denotes GigaSpeechBench.

ModelWS-MinGigaSpeechMinSpeechAvg.
FunASR-Realtime†39.09/45.4153.37/32.6228.22/63.2340.23/47.09
SeedASR2.0†38.91/47.5855.32/32.5068.53/26.2154.25/35.43
Qwen3-ASR-MinSpeech20.34/60.5712.39/71.2667.94/23.9333.56/51.92
Qwen3-ASR-WSM-Mandarin42.93/42.5651.20/34.0159.82/29.4251.32/35.33
Qwen3-ASR-WSM-Mandarin
+ internal data
49.39/36.8147.65/36.6665.69/26.2154.24/33.05
FireRedASR2-AED18.05/64.4036.91/49.3513.60/85.0222.85/66.26
FireRedASR2-AED-WSM46.06/39.5357.73/28.6157.73/31.8553.73/33.33

TTS Leaderboard

Lower CER is better; higher is better for all other metrics. † indicates a commercial API. ‡ denotes a single-fixed-speaker API, for which SIM and S-MOS are not evaluated.

WS-Min-Eval-TTS Easy

ModelCER (%) ↓SIM ↑I-MOS ↑S-MOS ↑A-MOS ↑
QwenAudio-3.0-TTS†19.900.6723.883.853.62
Qwen3TTS-Flash†‡24.44–3.93–3.93
FireRedTTS333.760.7473.303.323.13
VoxCPM228.160.7073.453.543.38
MERaLiON-TTS21.250.6223.833.733.65
CosyVoice363.690.6542.132.131.49
CosyVoice3-WSM20.260.6783.853.753.65

WS-Min-Eval-TTS Hard

ModelCER (%) ↓SIM ↑I-MOS ↑S-MOS ↑A-MOS ↑
QwenAudio-3.0-TTS†35.090.6853.753.733.70
Qwen3TTS-Flash†‡38.02–3.75–3.73
FireRedTTS355.330.7313.153.393.04
VoxCPM240.500.6813.173.483.36
MERaLiON-TTS37.280.6223.583.733.63
CosyVoice360.350.6102.002.401.43
CosyVoice3-WSM35.980.6693.653.853.70

WenetSpeech-Chuan:用于方言语音处理的大规模、注释丰富的四川话语料库

📑 Paper    |    🐙 GitHub    |    🤗 HuggingFace
🎤 Demo Page    |    💬 Contact Us

WenetSpeech-Chuan 包含10000小时大规模川渝方言语音语料,标注丰富,是目前川渝方言语音研究最大的开源资源。涵盖十大领域:短视频、娱乐、直播、纪录片、有声读物、戏剧、访谈、新闻等。开发并开源了Chuan-Pipeilne(方言语音数据处理框架), 收集了大规模的、自然界中的语音录音,涵盖故事讲述、戏剧、评论、视频博客、美食、娱乐、新闻和教育等多个领域。这些长录音通过语音音频检测 (VAD) 被分割成短片段,从而生成用于转录和质量评估的话语级数据。

Chuan-Pipeline

 WenetSpeech–Chuan 流程概览

 Chuan-Pipeline流程能系统地将原始、未标注的音频转化为一个内容丰富、标注完善的语料库,用于语音识别(ASR)和语音合成(TTS)。

Pre-Processing and Labeling

管道的初始阶段主要关注数据获取、分割,以及为语音片段添加多维副语言标签。原始数据的获取始于从在线视频平台挖掘元数据,以识别可能包含四川方言的内容。经过初步人工审核以确认目标方言的存在后,获取的音频流将进入多阶段处理流程:

  1. VAD 与分割:使用语音活动检测(VAD)将长音频流切分为 5–25 秒的片段,同时去除沉默和噪声等非语音部分。
  2. 单说话人选择与聚类:首先使用 pyannote 工具包隔离单说话人片段。随后,使用 CAM++ 模型提取说话人嵌入,并进行聚类,为同一说话人的所有语句分配一致的说话人 ID。
  3. 副语言注释:
  • 性别识别:使用预训练分类器(准确率 98.7%)确定说话人性别。
  • 年龄估计:基于 Vox-Profile 基准评测,将年龄划分为儿童、青少年、青年、中年和老年阶段。
  • 情绪标注:通过 Emotion2vec 和 SenseVoice 的预测结果进行多数表决,覆盖七类情绪:高兴、愤怒、悲伤、中性、恐惧、惊讶和厌恶。

质量评估

自动化质量评估:用时间戳对齐的语音作为输入,提取音频时长和信噪比(SNR)等指标。随后,这些特征用于计算词级虚拟主观评价分数(WVMOS),作为感知音频质量的替代指标。低质量的音频样本将被丢弃。

LLM-GER纠错处理

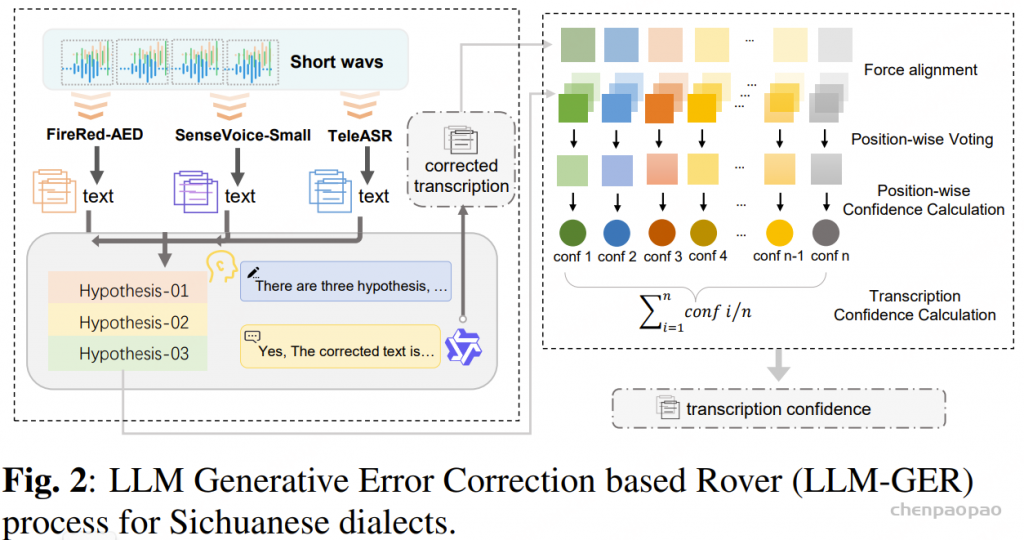
为了提高自动语音识别(ASR)转写的准确性,并在已有研究的基础上,我们提出了一套针对四川方言的鲁棒 ASR 转写框架。我们的方法被称为 基于大语言模型生成的错误纠正 ROVER(LLM Generative Error Correction based ROVER, LLM-GER),旨在将多个 ASR 系统的输出融合为单一、准确且可靠的转写结果。

首先,三套不同的 ASR 系统(FireRed-ASR、SenseVoice-Small 和 TeleASR)生成初步候选转写。随后,这些转写由 Qwen3 进行融合,利用其强大的方言理解能力,并结合我们精心设计的提示(prompt)进行错误纠正,同时保持原始语义和 token 长度不变。

通过这种方法,充分发挥了大语言模型(LLM)在规范化四川方言表达方面的能力,同时整合了多套 ASR 系统的互补优势。这样的组合为 WenetSpeech-Chuan 数据集生成了高质量的转写结果。对测试集的计算结果显示,与单一 ASR 系统的转写相比,LLM-GER 平均可将转写准确率提高约 15%。

标点符号预测

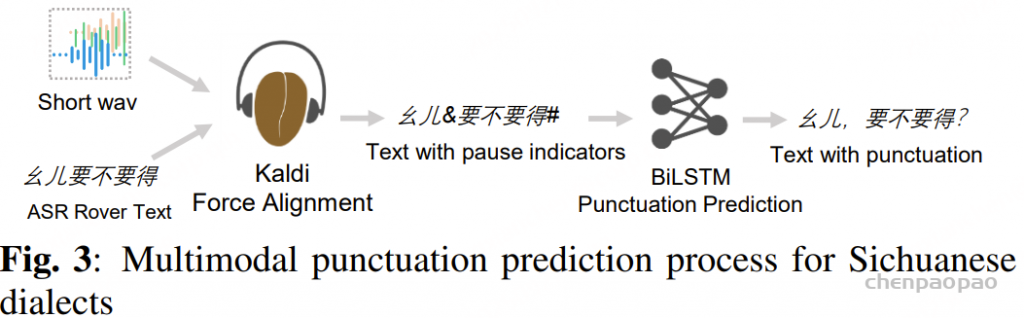
带标点的准确转写对于 TTS 训练至关重要,但仅依靠文本的标点预测往往与实际语音停顿不匹配。为此,我们提出了一种结合音频与文本模态的多模态标点预测方法。

在音频模态方面,我们使用 Kaldi 模型对音频与文本进行强制对齐,从而获得每个词的时间戳和停顿时长,并根据阈值将停顿划分为短停顿或长停顿(例如,短停顿 0.25 秒,长停顿 0.5 秒)。

在文本模态方面,我们使用 BiLSTM 标点模型在停顿候选位置预测标点:短停顿对应逗号,长停顿对应句号、问号或感叹号。阈值通过人工反馈进行迭代优化,以确保标点与实际语音停顿保持一致。

ps:该方法存在的的问题:由于不涉及语音信息,单模态模型时常无法获知说话人的情感态度,这会导致模型在一些句子末尾难以抉择以句号还是问号作为结束符。

WenetSpeech-Chuan Corpus

通过将 Chuan-Pipeline 应用于收集到的多源原始数据,我们构建了 WenetSpeech-Chuan 语料库,这是一个面向四川方言的大规模、多标签、多领域的资源。本节将详细介绍该语料库,包括其元数据、音频格式、数据多样性以及训练集和评估集的设计原则。

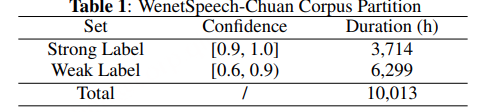
为每个音频片段分配一个置信度,用于衡量自动语音识别(ASR)转录的质量。 如表 1 所示,我们选取了 3,714 小时的强标签数据(Strong Label),其置信度大于 0.90。 6,299 小时的弱标签数据(Weak Label),置信度介于 0.60 与 0.90 之间,被保存在我们的元数据中,用于半监督训练或其他用途。 总的来说,WenetSpeech-Chuan 共包含 10,013 小时的原始音频。

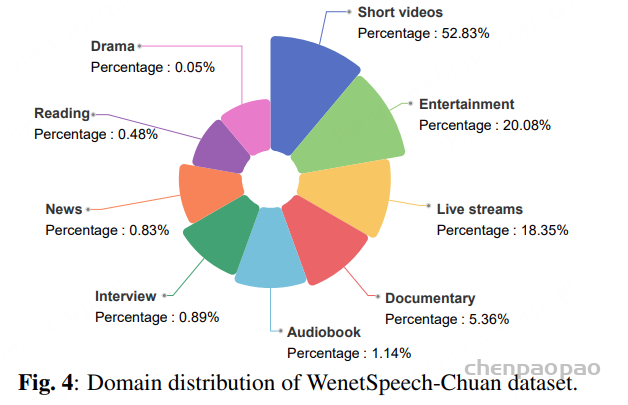
WenetSpeech-Chuan 的来源领域,共包含 9 个类别。 其中,短视频占比最大(52.83%),其次是 娱乐(20.08%) 和 直播(18.35%)。 其他领域包括纪录片、有声书、访谈、新闻、朗读和电视剧,占比较小,但提升了数据集的多样性。

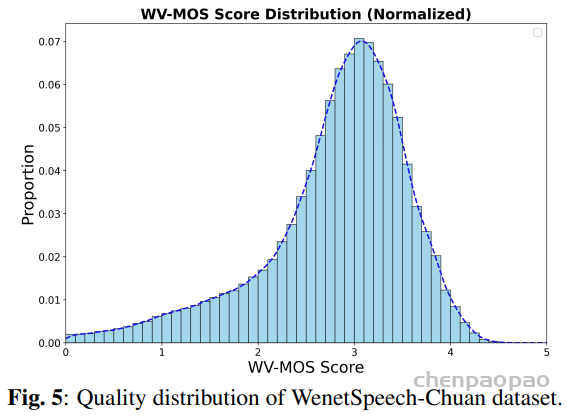
基于 WVMOS 指标 计算得到的音频质量评分主要集中在 2.5 到 4.0 区间,其中 3.0 到 3.5 之间存在一个显著峰值。 这一分布表明,语料库的大部分音频属于 中高质量语音,在干净录音与真实环境声学条件之间取得了平衡,从而使其在训练通用语音模型时具备较强的鲁棒性。

WenetSpeech-Chuan Eval Benchmark:

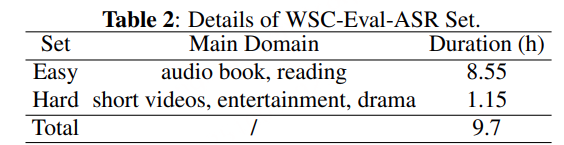
ASR 评测集:人工标注9.7 小时的评测集划分为 Easy 和 Hard 两个子集

TTS 评测集:

  • WSC-Eval-TTS-easy:包含来自多个领域的方言词句子;
  • WSC-Eval-TTS-hard:由长句子和大语言模型(LLM)生成的多样化风格句子组成,例如绕口令、俗语和情感化语音。

Experiments

ASR

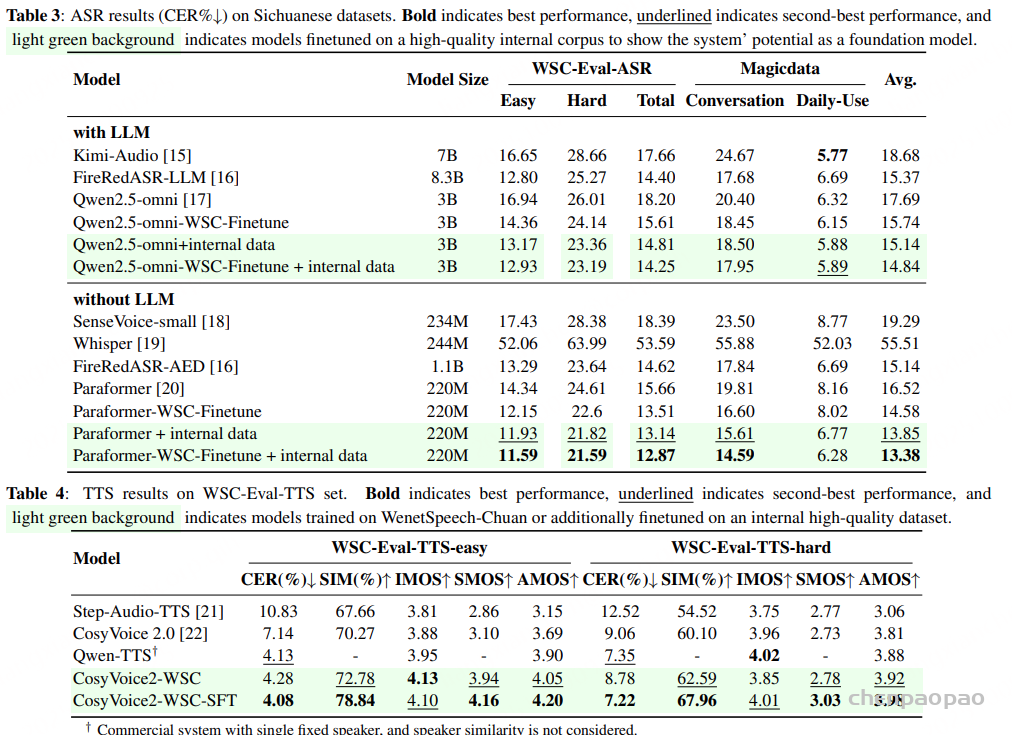
如表 3 所示,不同类型的模型在四川方言测试集上的表现存在差异。 首先,在所有开源模型中,FireRedASR 在多个评测集上表现出相对稳定的识别性能。 值得注意的是,FireRedASR-AED 在所有测试集上的平均词错误率(WER)为 15.14%,成为表现最优的开源模型。 相比之下,Qwen2.5-omni 和 kimi-audio 等模型在 MagicData-Dialogue 测试集 上的错误率显著偏高,表明其对方言语音的适应性不足。

我们经过微调的模型展现出明显的性能提升。在 WenetSpeech-Chuan 上对 Paraformer 和 Qwen2.5-omni 进行微调后,整体性能分别提升了 11.7% 和 11.02% ,彰显了 WenetSpeech-Chuan 在提升方言识别能力方面的显著效果。此外,在额外使用 1000 小时内部数据进行持续微调后,Paraformer 在所有测试集上均达到了 13.38% 的平均 CER,达到了当前最佳水平 ,这证明了 ASR 模型在使用高质量方言数据训练时具有强大的迁移能力和适应性。

综上所述,我们的评估结果清楚地表明,在保持普通话识别能力没有明显下降的同时,WenetSpeech-Chuan 大大增强了模型识别四川方言的能力。

Speech Synthesis

CosyVoice2-WSC 在客观和主观指标上均展现出极具竞争力的表现。在简单分类下,其 CER 达到 4.28%,接近 Qwen-TTS 的 4.13%,同时实现了更高的感知质量和最佳的说话人相似度。在困难分类下,其 CER 上升至 8.78%,而 Qwen-TTS 仅为 7.35%,但仍保持了更高的感知质量,SIM 高于 62%,在挑战性场景中展现出更佳的鲁棒性。

与错误率较高的 Step-Audio-TTS 和 CosyVoice2 基线相比,CosyVoice2-WSC 在准确率和感知质量之间取得了更佳的平衡。经过微调后,CosyVoice2-WSC-SFT 取得了进一步的提升。在简单划分中,其 CER 最低,为 4.08%,SIM 最高,为 78.84%,同时 MOS 家族得分也处于领先地位。在困难划分中,其 CER 降至 7.22%,并保持了最佳 AMOS 得分,这表明微调能够同时提升准确率和感知质量。

总而言之,这些结果证实了 WenetSpeech-Chuan 数据集为构建稳健、高质量的四川方言 TTS 系统奠定了坚实的基础。

结论

WenetSpeech-Chuan,这是目前中国最大的四川方言开源语料库,包含超过 10,000 小时的多维语音标注。为了构建该数据集,我们开发了 Chuan-Pipeline,这是一个功能全面的数据处理工具包,能够支持这一大规模资源的创建。

WenetSpeech-Yue:大规模粤语语音语料库

论文题目:WenetSpeech-Yue: A Large-scale Cantonese Speech Corpus with Multi-dimensional Annotation

  • 论文预印版:https://arxiv.org/abs/2509.03959
  • 仓库地址:https://github.com/ASLP-lab/WenetSpeech-Yue
  • Demo展示:https://aslp-lab.github.io/WenetSpeech-Yue/
  • WenetSpeech-Yue数据集地址:https://huggingface.co/datasets/ASLP-lab/WenetSpeech-Yue
  • WSYue-ASR-eval: https://huggingface.co/datasets/ASLP-lab/WSYue-ASR-eval
  • WSYue-TTS-eval: https://huggingface.co/datasets/ASLP-lab/WSYue-TTS-eval
  • ASR模型地址:https://huggingface.co/ASLP-lab/WSYue-ASR
  • TTS模型地址:https://huggingface.co/ASLP-lab/WSYue-TTS

背景动机

语音理解与生成的飞速发展离不开大规模高质量语音数据集的推动。其中,语音识别(ASR)和语音合成(TTS)被公认为最首要的任务。但对于拥有约 8490 万母语使用者的粤语而言,受限于标注资源匮乏,研究进展缓慢,ASR 与 TTS 的表现始终不尽如人意。现有公开的粤语语料库在规模、风格和标注维度上普遍存在不足。例如 Common Voice 和 MDCC 等项目过度依赖人工标注,仅能提供小规模数据;评测集大多局限于短句,缺乏对复杂语言现象的覆盖。同时,这些语料往往只提供语音-文本对齐信息,缺乏说话人属性或声学质量等元数据,极大限制了其在自监督学习、风格建模和多任务训练中的应用,导致主流 ASR 与 TTS 系统在粤语任务上表现欠佳,并在真实场景中泛化能力不足。

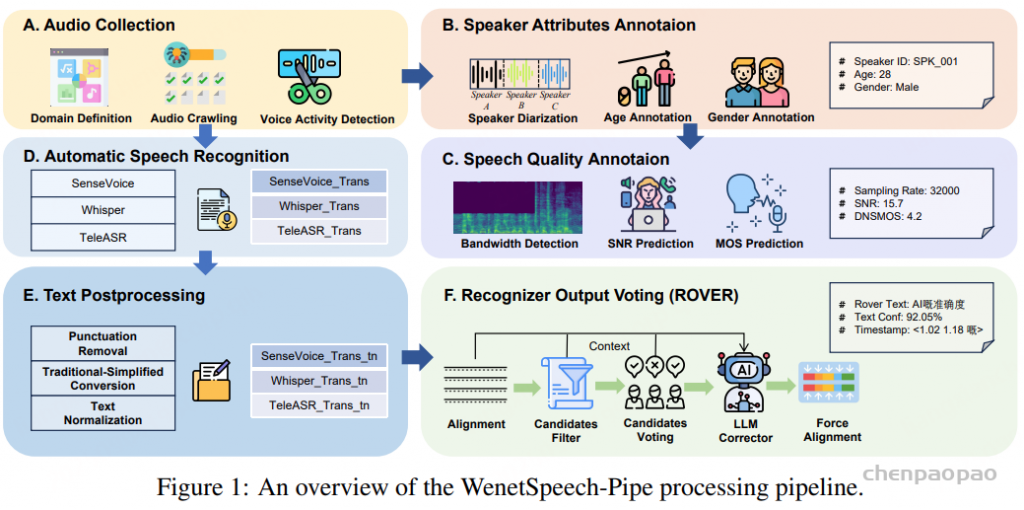
为解决上述问题,西北工业大学音频语音与语言处理研究组(ASLP@NPU)联合中国电信人工智能研究院、希尔贝壳、香港科技大学和Wenet开源社区,提出了 WenetSpeech-Pipe ——一个面向语音理解与生成、支持多维度标注的大规模语音语料构建一体化流程。该流程包含六个模块:音频采集、说话人属性标注、语音质量标注、自动语音识别、文本后处理与识别结果投票,能够生成丰富且高质量的标注。基于该流程,构建并发布了 WenetSpeech-Yue ——首个大规模粤语多维标注语音语料库,涵盖 21800 小时、10 大领域的粤语语音数据,并包含 ASR 转录、文本置信度、说话人身份、年龄、性别、语音质量评分等多种标注信息。同时,我们还发布了 WSYue-eval,这是一个全面的粤语评测基准,包含两个部分:WSYue-ASR-eval(人工标注集,用于评测短句/长句、粤英转换及多样声学条件下的 ASR 性能),以及 WSYue-TTS-eval(基础与覆盖子集,用于标准测试与泛化能力测试)。实验结果表明,基于 WenetSpeech-Yue 训练的模型在粤语 ASR 与 TTS 任务中表现优异,性能超越最先进(SOTA)的系统,并与商业系统相媲美,凸显了该数据集与流程的重要价值。

WenetSpeech-Pipe

 WenetSpeech-Pipe 框架如图 所示,由六个模块组成:(A) 音频采集,(B) 说话人属性标注,(C) 语音质量标注,(D) 自动语音识别,(E) 文本后处理,以及 (F) 识别结果投票。

音频采集: WenetSpeech-Pipe 首先从多个领域(如故事、影视、评论、Vlog、美食、娱乐、新闻和教育)大规模采集真实语音数据。由于原始录音多为几十分钟至数小时的长音频,不适合直接用于模型训练或对齐,因此系统通过语音活动检测(VAD)自动切分为短音频片段,从而生成可用于转写和质量评估的语句级数据,为后续处理奠定基础。

说话人属性标注:为了丰富数据集,使其具备多说话人建模和风格感知合成所需的说话人级别元数据,WenetSpeech-Pipe 引入了 说话人属性标注阶段。首先,利用 pyannote 工具包 进行说话人分离,为同一录音中的短片段分配局部说话人标签,实现录音内的说话人区分。
其次,利用 Vox-Profile对每个片段的说话人进行年龄和性别估计,从而生成说话人属性注释。该流程最终得到带有说话人身份、年龄和性别信息的语句级片段,形成多维度的元数据,有助于监督建模和可控风格的语音建模

语音质量标注:WenetSpeech-Pipe 在语音质量评估阶段结合三种方法:Brouhaha 计算信噪比、DNSMOS 预测主观质量分、带宽检测分析频谱特性,从而为每个片段生成包含 SNR、MOS 与频谱参考的结构化质量标注,支撑高保真语音建模。

ps:关于 Brouhaha: multi-task training for voice activity detection, speech-to-noise ratio, and C50 room acoustics estimation:
代码:https://github.com/marianne-m/brouhaha-vad
给定一个音频片段,Brouhaha 可以提取:语音/非语音片段,语音噪声比 (SNR),C50,测量环境混响程度。

DNSMOS:基于多阶段自我学习(multi-stage self-teaching) 的无参考感知客观指标:DNSMOS,用来评估噪声抑制模型的语音质量。基于 CNN;输入为语音频谱;训练以人类主观评分为目标,采用自我学习提升性能.

自动语音识别:单一 ASR 系统通常会因架构限制、训练数据不足或领域不匹配而表现出系统性偏差和错误模式。为了缓解这些问题并提升转写可靠性,WenetSpeech-Pipe 采用 多系统集成识别 方法,结合不同的识别范式。具体来说,每个音频片段会被 独立输入到三个高性能粤语 ASR 系统:开源模型 SenseVoice、Whisper,以及商用系统 TeleASR。这些系统在架构、训练数据和优化目标上各不相同,因此能够形成互补的错误分布和多样的语言假设。最终输出为每条语句的三份并行转写,作为后续融合与优化的基础输入。

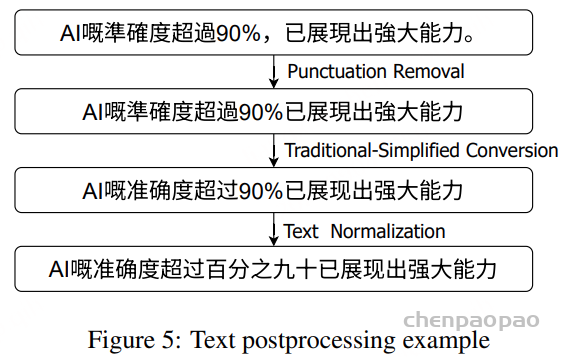
文本后处理:WenetSpeech-Pipe 通过文本后处理统一多系统转写结果:使用 OpenCC 繁转简,去除符号与标签,规范数字和日期格式,并在中英文间加空格。这样生成的规范化转写确保 ROVER 融合时不会受表层差异干扰。

  • 使用 OpenCC 将繁体字统一转换为简体字;
  • 去除所有标点和特殊符号;
  • 基于规则重写统一数字与日期表达;
  • 在粤语与英语单词之间插入空格,便于双语建模。

经过上述步骤,系统获得了跨三套 ASR 的标准化转写,作为 ROVER 模块的鲁棒输入,避免表层差异干扰语音与词汇层面对齐。

为了确保不同 ASR 系统之间的转写格式一致,我们提出了一个集成的文本后处理框架,包含四个关键操作:

  1. 标点去除:通过正则表达式匹配,删除符号类字符;
  2. 繁转简:利用 OpenCC 库实现繁体到简体的转换;
  3. 文本规范化:使用 an2cn 工具进行数字的标准化转换;
  4. 合理分词:借助 Pangu 工具实现恰当的词间空格。

这四个步骤共同作用,能够在不同 ASR 系统输出存在差异的情况下,保证生成标准化的文本格式。

识别结果投票:虽然文本后处理统一了转写表层形式,但在词汇选择、分词和音素表示上仍存在差异。为了得到统一且高精度的参考转写,WenetSpeech-Pipe 采用了 ROVER (Recognizer Output Voting Error Reduction) 框架 ,通过多系统投票提升转写精度。

在实现上,标准 ROVER 流水线被扩展以更好地适应粤语:

  • 使用动态规划对三套系统的转写结果进行对齐;
  • 引入候选过滤模块,计算某系统输出与其余两套平均转写的编辑距离,若超过阈值则剔除该系统结果;
  • 在每个对齐位置,选择最常出现的词,并将整体投票频率作为语句级置信度;
  • 并行引入 基于拼音的投票,结合字符级投票,保证音素一致性。

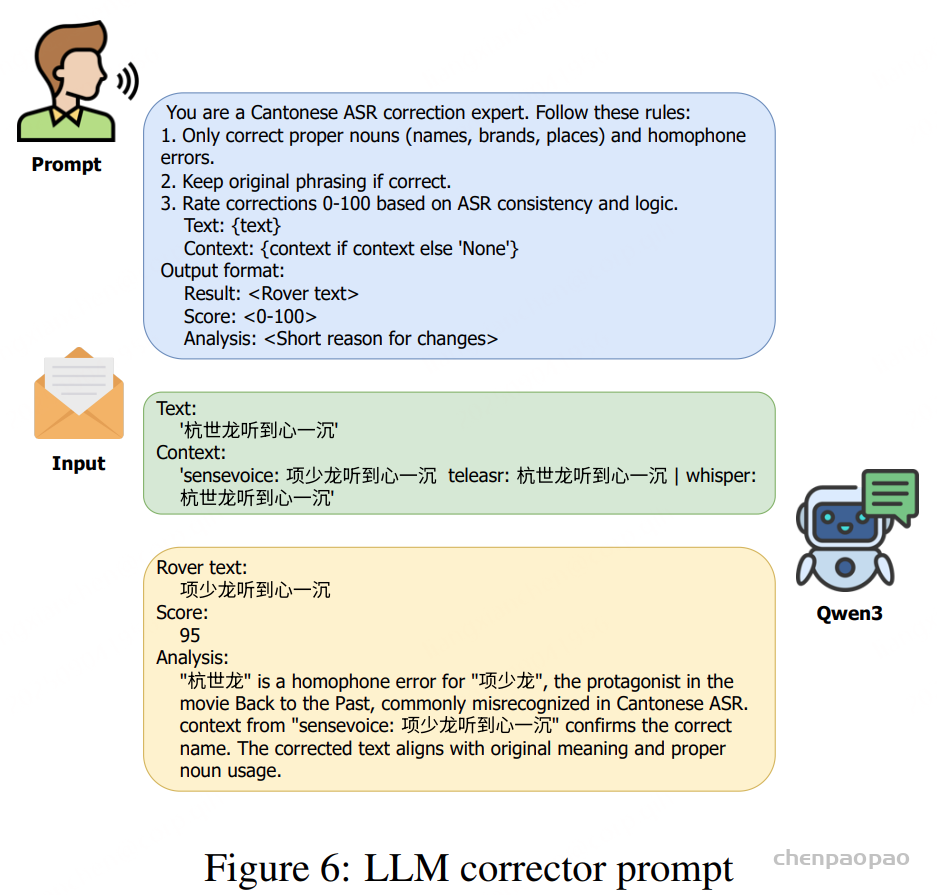
为进一步提高转写准确率,系统引入 大语言模型 Qwen3-4B,在共识输出的基础上进行最小化的上下文感知修正,仅在语法、用词或命名实体方面做必要调整,保持口语内容的完整性。

字级别时间戳对齐:最后,使用预训练声学模型在字符级别上强制对齐修正后的转写与原始音频,从而获得精确的逐字符时间戳,支持更精细的语音处理和下游任务。

Meta Data Example:

将所有音频的元数据以标准化的 JSON 格式进行存储。核心字段包括:

  • utt_id(每个音频片段的唯一标识符)、
  • rover_result(来自三个 ASR 转写结果的 ROVER 融合结果)、
  • confidence(文本转写的置信度分数)、
  • jyutping_confidence(粤语拼音转写的置信度分数)、
  • duration(音频时长)。

说话人属性(Speaker attributes)包含参数:speaker_id、性别(gender)和年龄(age)。音频质量评估指标包括专业测量项:采样率(sample_rate)、DNSMOS 和 SNR。时间戳信息(timestamp)精确记录了起始时间(start)和结束时间(end)。此外,在 meta_info 字段下还扩展了更多元数据,包括:program(节目名称)、region(地理信息)、link(原始内容链接)、以及 domain(领域分类)。

WenetSpeech-Yue

数据集分布

元数据:所有元数据存储在单一 JSON 文件中,字段包括音频路径、时长、文本置信度、说话人身份、信噪比(SNR)、DNSMOS 分数、年龄、性别以及字符级时间戳。这些字段具有可扩展性,未来可进一步加入新的标签。

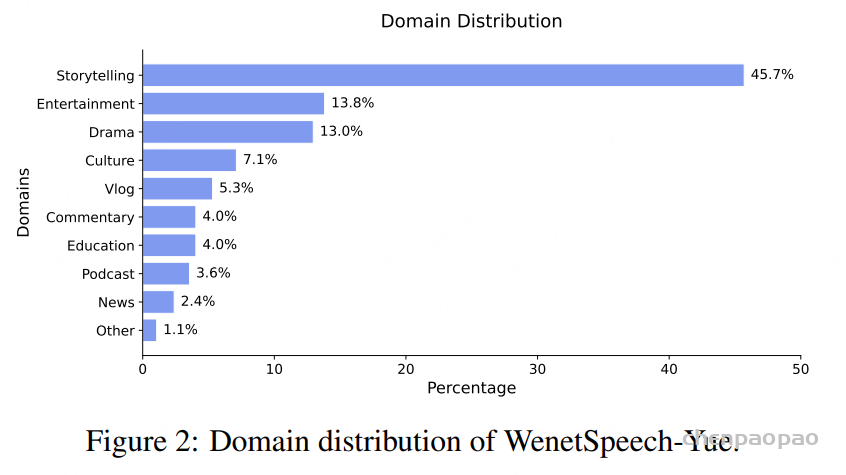
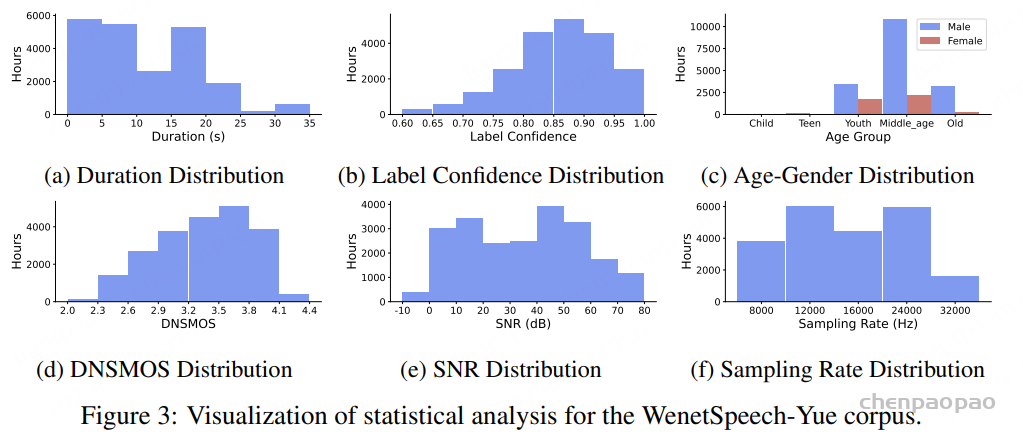
领域分布:WenetSpeech-Yue 的语料来源大致涵盖十个领域:故事、娱乐、戏剧、文化、Vlog、评论、教育、播客、新闻及其他,具体分布如图2所示。

时长分布:整个语料库共包含 21,800 小时音频,既包括长录音也包括短片段,切分后平均时长为 11.40 秒。

置信度:我们仅保留文本置信度高于 0.6 的标注,并根据confidence区间划分为三类:强标注(confidence> 0.9,6,771.43 小时)、中等标注(0.8 ~ 0.9,10,615.02 小时)和弱标注(0.6 ~ 0.8,4,488.13 小时)。

语音质量:我们评估了语料的音质:DNSMOS 分数范围为 2.0–4.4,SNR 范围为 -5–80 dB,采样率分布为 8,000–32,000 Hz。为确保生成式任务的可用性,我们过滤后仅保留 DNSMOS > 2.5 且 SNR > 25 dB 的样本,共得到约 12,000 小时高质量语音,可用于 TTS、声码器或语音转换等任务。

说话人属性:语料库在性别与年龄上分布不均,以男性为主,尤其集中在中年群体(50.6%),而女性在各年龄段中比例相对较低。

WSYue-eval

为应对粤语的语言特性,我们提出 WSYue-eval,一个同时涵盖 ASR 与 TTS 的综合评测基准,用于全面检验模型在粤语处理上的表现。

ASR 评测集(WSYue-ASR-eval):该测试集经过多轮人工标注,包含转写、情感、年龄、性别等信息,并划分为 短语音(0–10 秒,9.46 小时,2861 位说话人)和 长语音(10–30 秒,1.97 小时,838 位说话人)两个子集,覆盖粤英转换及多领域场景。

TTS 评测集(WSYue-TTS-eval):该基准专为零样本粤语 TTS 设计,包含两个子集:

  • Base:1000 条来自 CommonVoice 的提示-文本对,用于测试日常场景;
  • Coverage:由于 CommonVoice 主要包含日常对话数据,其对不同领域和语言现象的覆盖范围有限。为了解决这个问题, Coverage 子集由人工与 LLM 生成文本组成,覆盖日常、新闻、娱乐、诗歌等多领域,并包含多音字、变调、语码转换、专名、数字等复杂语言现象。

模型训练策略:

模型均采用两阶段训练策略:初始阶段使用混合的中高置信度标签实现快速收敛,之后在高置信度标签上进行微调,以最大限度地提高转录准确率。这种设置既降低了训练成本,又直接反映了数据集的质量影响。

分2阶段ASR任务训练效果

阶段 1 在混合置信度数据集上训练,已经能够取得非常具有竞争力的粤语 ASR 性能,而阶段 2 在高置信度数据上进行微调,则在 WSYue-ASR-eval 的两个测试集上都带来了显著提升。这些观察结果验证了高置信度标签是性能提升的主要驱动力。我们认为保留置信度信息至关重要,因为它能够支持灵活的训练策略:高置信度子集可用于主导微调,而低置信度片段经过谨慎利用,则可以在半监督或领域自适应场景下提高模型的鲁棒性。

模型效果:

ASR任务:

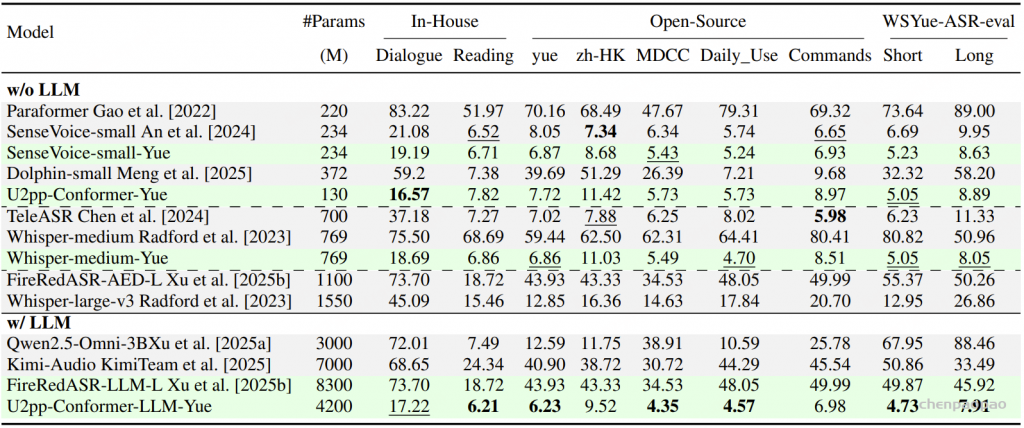
采用混合错误率(MER)作为评测指标,其中中文按字级、英文按词级计算错误,用于比较基于 WenetSpeech-Yue 训练的模型与各类基线模型的表现。表1的实验结果显示:

  1. 在所有模型规模(small、medium、w/ LLM)下,我们的模型在大多数评测集上表现最佳;
  2. 在小规模模型中,SenseVoice-small-Yue 和 U2pp-Conformer-Yue 均表现优异,其中 SenseVoice-small-Yue 尽管规模较小,却超过了所有基线模型,说明该语料库能显著提升低容量模型的效率;
  3. 在不带 LLM 的组别中,U2pp-Conformer-Yue、Whisper-medium-Yue 和 SenseVoice-small-Yue 均优于大规模基线模型;
  4. 在带 LLM 的组别中,U2pp-Conformer-LLM-Yue 始终达到当前最先进水平。

总体来看,WenetSpeech-Yue 不仅显著提升了整体性能,还能充分释放不同规模模型的潜力,验证了其在传统 ASR 和 LLM 增强型 ASR 中的广泛价值。

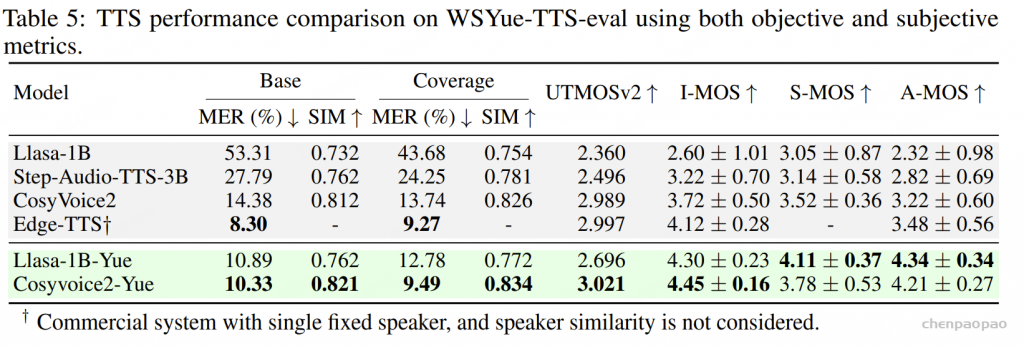
TTS任务:

表2的实验结果表明,基于 WenetSpeech-Yue 微调的 Llasa-1B-Yue 和 CosyVoice2-Yue 在客观和主观指标上均显著优于各自的预训练基线:CosyVoice2-Yue 在 MER 和自然度(UTMOSv2)上表现最佳,并取得最高的可懂度(I-MOS),而 Llasa-1B-Yue 则在说话人相似度(S-MOS)和口音自然度(A-MOS)方面领先,体现了更自然的韵律与风格。整体上,两种模型在多维度上均大幅提升了粤语 TTS 的质量,验证了 WenetSpeech-Yue 在推动粤语语音合成方面的有效性。

GigaSpeech 2:三万小时东南亚多语种语音识别开源数据集发布

下载:https://huggingface.co/datasets/speechcolab/gigaspeech2

语言:泰语、印尼语、越南语
GigaSpeech 2 raw:30,000 小时的泰语、印尼语和越南语自动转录语音。
GigaSpeech 2 精炼:泰语 10,000 小时,印尼语和越南语各 6,000 小时。
GigaSpeech 2 DEV 和 TEST:每种语言的 DEV 时间为 10 小时,TEST 时间为 10 小时,由专业人工注释员转录,富有挑战性和现实性。

“Giga”一词源于“gigantic”[“巨大”],互联网上具有海量音频资源,但语音质量良莠不齐,高质量音频文本对数据十分稀缺且标注成本高昂,特别是在小语种领域。GigaSpeech 是一个非常成功的英文开源数据集,以 YouTube 和 Podcast 为音频来源,提供了上万小时的高质量文本标注语音数据集,获得了广泛关注和应用。针对多语言领域仍存在的语音识别性能较差、可用高质量标注数据缺乏等问题,我们提出了利用 in-the-wild 无标注音频,构建高质量大规模语音识别数据集的新范式,制作出面向真实场景的大规模、多领域、多语言的语音识别数据集 GigaSpeech 2。基于Gigaspeech 2 数据集训练的语音识别模型在三个东南亚语种(泰语、印尼语、越南语)上达到了媲美商业语音识别服务的性能。我们怀揣着技术应当普惠大众的理念,致力于开源高质量语音识别数据集和模型,促进多语言文化沟通。

GigaSpeech 2 是一个持续扩展的、多领域多语言的大规模语音识别语料库,旨在促进低资源语言语音识别领域的发展和研究。GigaSpeech 2 raw拥有 30000 小时的自动转录音频,涵盖泰语、印尼语、越南语。经过多轮精炼和迭代,GigaSpeech 2 refined拥有 10000 小时泰语、6000 小时印尼语、6000 小时越南语。我们也开源了基于 GigaSpeech 2 数据训练的多语种语音识别模型,模型性能达到了商业语音识别服务水平。

数据集构建:

GigaSpeech 2 的制作流程也已同步开源,这是一个自动化构建大规模语音识别数据集的流程,面向互联网上的海量无标注音频,自动化地爬取数据、转录、对齐、精炼。这一流程包含利用 Whisper 进行初步转录,使用 TorchAudio 进行强制对齐,经过多维度过滤制作出 GigaSpeech 2 raw。随后,采用改进的 Noisy Student Training (NST) 方法,通过反复迭代精炼伪标签,持续提高标注质量,最终制作出GigaSpeech 2 refined。

GigaSpeech 2 在主题上涵盖了多样化话题领域,包括农业、艺术、商业、气候、文化、经济、教育、娱乐、健康、历史、文学、音乐、政治、两性关系、购物、社会、体育、科技和旅行。同时,在内容形式上涵盖了多种类型,包含声书、解说、讲座、独白、电影电视剧、新闻、访谈、视频博客。

GigaSpeech 2 raw: Automated Crawling and Transcription

音频收集

由于低资源语言中人工标注数据的稀缺性,我们的数据集采集策略仅关注音频内容,而不考虑是否存在或文本配对的质量。这种策略使我们能够收集更广泛范围的音频数据。考虑到低资源语言的资源稀缺性和分布不均,我们有策略地重点爬取 YouTube 频道中的视频,基于两个关键假设:

  1. 优先选择热门频道可以确保一致的领域特征和音频质量;
  2. 不同频道之间没有说话人重叠,从而简化后续的数据划分。

数据收集流程首先由人工定义感兴趣的内容类别,所选主题包括:农业、艺术、商业、气候、文化、经济、教育、娱乐、健康、历史、文学、音乐、政治、人际关系、购物、社会、体育、科技和旅游。除了多样的主题外,我们还考虑了不同的内容格式,包括:有声书、评论、讲座、独白、电影、新闻、访谈和 vlog。这种广泛的选择确保了数据集在多个领域的全面性,可支持研究与分析。

在准备好 YouTube 频道列表后,我们使用 yt-dlp 工具下载所有音频文件,格式为 WebM。随后,这些文件被转换为单声道的 WAV 格式,并重采样为 16 kHz 的采样率。


训练 / 开发 / 测试集的划分:为确保各数据集之间没有说话人重叠,我们通过人工方式验证不同频道间无重叠说话人,并将来自不同 YouTube 频道的数据分配至不同的子集。数据集被划分为三个独立的子集:训练集(TRAIN)、开发集(DEV)和测试集(TEST)。

其中,DEV 和 TEST 集各包含 10 小时内容,均由专业人员手动转录,其余部分则分配至训练集。表1展示了这三种语言的数据量分布。更详细的分析见附录B。


使用 Whisper 进行转录:我们使用 OpenAI 的 Whisper large-v3 模型自动转录音频文件。对于每段音频,从中间选择一个 30 秒的片段进行语言识别,仅对与目标语言匹配的音频进行转录。


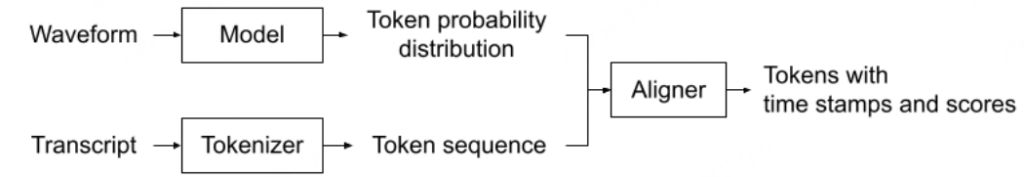
使用 TorchAudio 进行强制对齐:虽然 Whisper 可生成时间戳,但经过检验发现其精度不足。因此,我们采用了 TorchAudio 中的强制对齐模型【参考多语言数据的强制对齐 CTC 强制对齐 API 教程】,它能为嘈杂的转录文本提供可靠的对齐,支持在 GPU 上高效处理,并能更好地处理较长的音频序列。


文本标准化:对转录文本进行标准化处理,包括:

  • 应用 Unicode NFKC(兼容性分解与合成)规范;
  • 将所有字符转换为大写;
  • 去除标点符号;
  • 将阿拉伯数字映射为对应语言中的文本数字。

多维度过滤:为了排除质量较差的样本,我们在文本和音频两个模态上设计了一系列启发式的过滤规则:

  • 字符集过滤(Charset Filtering):仅保留那些只包含目标语言字符集内字符的片段。
  • 语言置信度过滤(Language Confidence Filtering):使用 fastText 提供的语言识别(LID)模型,根据语言识别的置信度分数进行过滤,仅保留那些置信度高于预设阈值的片段。该方法能有效排除无意义或重复的内容。需要注意的是,基于音频的语言识别在文本转录之前已经完成。
  • 音频时长过滤(Audio Duration Filtering):根据音频时长进行过滤,仅保留长度在预设的最短和最长时间阈值之间的片段。
  • 样本平衡(Balancing):我们对因频道特定内容造成的转录文本重复进行精细控制,同时尽可能保留自然的语言使用模式。

GigaSpeech 2 精炼:迭代标签优化(Iterative Label Refinement)

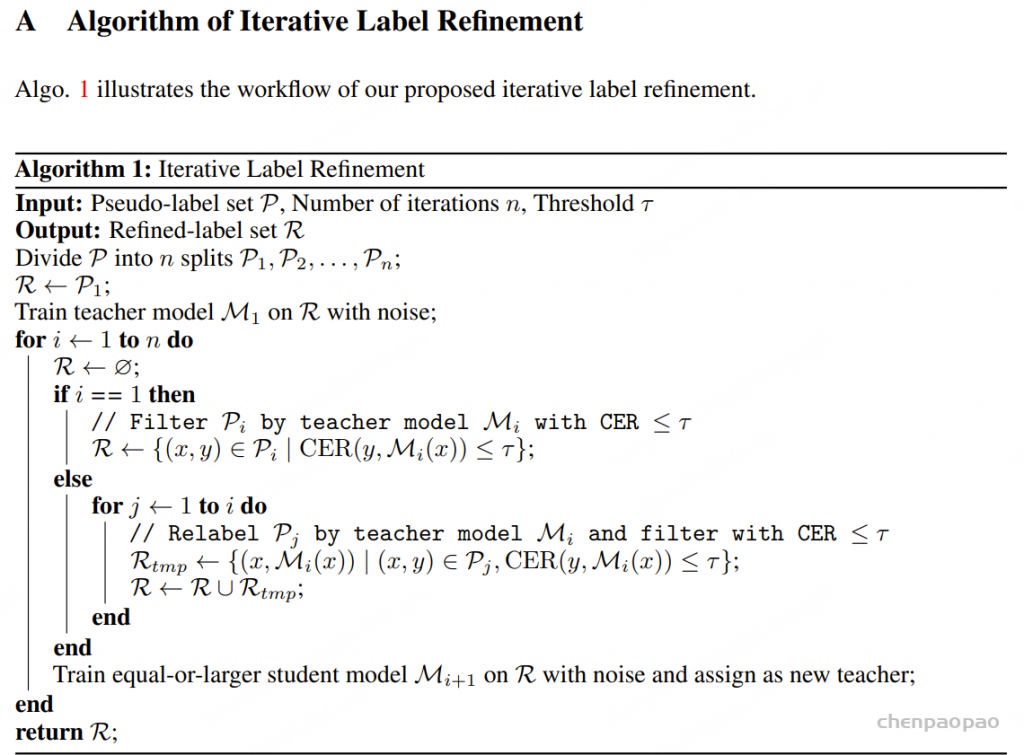
由于 Whisper 转录的不准确性以及强制对齐边界不精确,部分样本的质量仍然较低。为了解决这个问题,我们设计了一种改进的 神经自监督训练(NST) 方法。如图 1 右下角所示,该方法以一部分质量不佳的伪标签样本为起点训练一个教师模型,并通过迭代方式不断扩展训练集、生成新的伪标签,并对其进行过滤。随后训练一个与教师模型等大或更大的学生模型,使用优化后的伪标签进行训练,并将其作为新的教师模型。

在每次 NST 步骤中,我们引入了 SpecAugment、Bypass和 特征遮盖(feature mask)来注入噪声。其中:

  • Bypass 是一种随机深度机制,它通过学习通道级的标量权重,在模块输入与输出之间进行加权组合;
  • Feature mask 在前馈层和卷积层的隐藏维度上执行 Dropout,但在时间维度上保持共享。

这种有意识地加入噪声的方式,可以使学生模型学习在有噪声扰动下仍能保持与教师模型一致的行为,而教师模型在生成伪标签时则不会受到这些扰动 。

通过这样的迭代过程,数据质量将逐步得到提升。详细的算法步骤见附录 A 中的算法 1。

数据集组成:

GigaSpeech 2 提供了两个版本的数据集,分别为 raw 和 refined 版本,适用于有监督训练任务。训练集时长详情如下表所示:

GigaSpeech 2 开发集和测试集由海天瑞声的专业人员对语音数据人工标注得到,时长详情如下表所示:

主题和内容分布详情如下图所示,外圈表示主题领域,内圈表示内容形式:

实验结果:

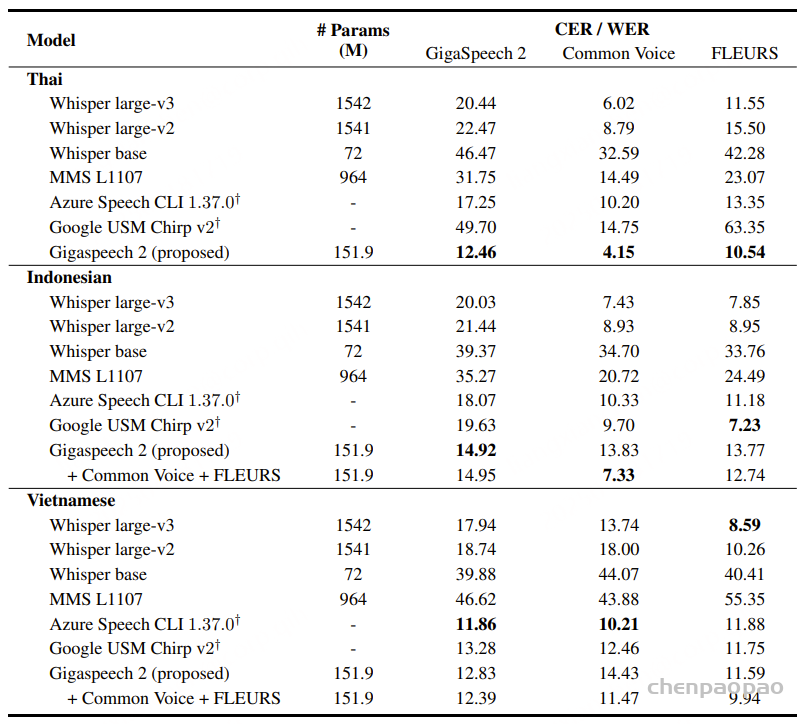
我们将使用 GigaSpeech 2 数据集训练的语音识别模型与业界领先的 OpenAI Whisper (large-v3、large-v2、base)、Meta MMS L1107、Azure Speech CLI 1.37.0 和 Google USM Chirp v2 模型在泰语、印尼语和越南语上进行比较。性能评估基于 GigaSpeech 2、Common Voice 17.0 以及 FLEURS 三个测试集,通过字符错误率(CER)或单词错误率(WER)指标进行评估。结果表明:

1)在泰语上,我们的模型展现出卓越的性能,全面超越了所有竞争对手,包括微软和谷歌商用接口。值得一提的是,我们的模型在达到这一显著成果的同时,参数量仅为 Whisper large-v3 的十分之一。

2)在印尼语和越南语上,我们的系统与现有的基线模型相比表现出具有竞争力的性能。

中文NLP资源库

https://github.com/fighting41love/funNLP

在入门到熟悉NLP的过程中,用到了很多github上的包,遂整理了一下,分享在这里。

很多包非常有趣,值得收藏,满足大家的收集癖! 如果觉得有用,请分享并star:star:,谢谢!

长期不定时更新,欢迎watch和fork!:heart::heart::heart:

🔥🔥🔥🔥🔥🔥🔥🔥🔥🔥                  
* 类ChatGPT的模型评测对比
* 类ChatGPT的资料
* 类ChatGPT的开源框架
* LLM的训练_推理_低资源_高效训练
* 提示工程
* 类ChatGPT的文档问答
* 类ChatGPT的行业应用
* 类ChatGPT的课程资料
* LLM的安全问题
* 多模态LLM
* LLM的数据集
🍆 🍒 🍐 🍊                  🌻 🍓 🍈 🍅 🍍                    
* 语料库
* 词库及词法工具
* 预训练语言模型
* 抽取
* 知识图谱
* 文本生成
* 文本摘要
* 智能问答
* 文本纠错
* 文档处理
* 表格处理
* 文本匹配
* 文本数据增强
* 文本检索
* 阅读理解
* 情感分析
* 常用正则表达式
* 语音处理
* 常用正则表达式
* 事件抽取
* 机器翻译
* 数字转换
* 指代消解
* 文本聚类
* 文本分类
* 知识推理
* 可解释NLP
* 文本对抗攻击
* 文本可视化
* 文本标注工具
* 综合工具
* 有趣搞笑工具
* 课程报告面试等
* 比赛
* 金融NLP
* 医疗NLP
* 法律NLP
* 文本生成图像
* 其他

文本语料数据平台–CnOpenData

https://www.cnopendata.com/

https://www.cnopendata.com/all-data

 CnOpenData是覆盖经济、法律、医疗、人文等多个学科维度的综合型数据平台,并持续提供个性化数据定制服务,现拥有500+个专题数据库,涵盖专利数据(1.4亿+量级)、工商注册企业数据(3.5亿+量级)、上市公司数据、土地数据、政府数据、新冠疫情数据、分地区数据、交通数据、气象数据等几十大数据系列,数值型数据和文本型数据并存,学术研究价值极高。

  本平台集灵活的数据定制服务、专业度极强的数据整合能力、强大的学术性于一体,为各领域中不同主体的研究决策提供优质、专业的数据支持。我们不仅为国内多所高校和著名学者提供持续的数据服务,在海外我们也入选了普林斯顿图书馆“来自中国的数据”系列。同时,我们与Neudata达成战略合作伙伴关系,也致力于为投资管理、私募股权、风险投资和企业领域的客户提供高质量的数据服务。目前,我们已成功入驻福建大数据交易所门户网站,与该司达成友好意向合作。

CnOpenData 是一个综合性的中文开放数据平台,致力于为学术研究、自然语言处理(NLP)和大模型训练提供丰富的文本语料资源。​该平台涵盖了多个领域的文本数据,具有广泛的应用价值。​


📚 CnOpenData 文本语料数据概览

CnOpenData 提供的文本语料数据种类繁多,主要包括以下几个方面:​

1. 法律与政策文本数据

  • 包含中国法律法规、规章、条约、五年规划等文本数据,是研究法律与政策问题的重要资源。

2. 政府工作报告数据

  • 涵盖国务院、省级、市级、县级政府的工作报告文本,时间跨度近20年,反映了国家行政发展的历程。

3. 专利文本数据

  • 提供中国专利的描述信息和权利要求信息,总量超过2300万条,时间范围从1985年到2022年12月31日。

4. 古典文学数据

  • 收录了唐诗宋词等中国古代文学作品,适用于文化研究和古文处理任务

5. 新闻与舆情数据

  • 包括CCTV新闻联播、人民日报文本数据、A股上市公司新闻舆情数据等,适用于舆情分析和新闻研究。​

6. 企业与金融文本数据

  • 涵盖A股上市公司公告、股吧评论、投资者关系管理数据等,支持金融文本分析和情感分析研究。

🔍 数据获取与使用

CnOpenData 提供在线访问和下载服务,用户可以根据研究需求选择相应的数据集。​部分数据可能需要注册或申请权限。​具体信息可参考其官方网站:CnOpenData。


CnOpenData 的丰富文本语料资源为中文自然语言处理和大模型训练提供了坚实的数据基础。​无论是法律政策研究、古典文学分析,还是金融文本挖掘,CnOpenData 都是一个值得信赖的数据来源。