Qwen-Audio-3.1-ASR 技术详解:从多语言、方言与专业词识别,到说话人日志和通用音频理解

论文:Qwen-Audio-3.1-ASR Technical Report(arXiv:2610.28711) 

一、先给结论:Qwen-Audio-3.1-ASR 做了什么

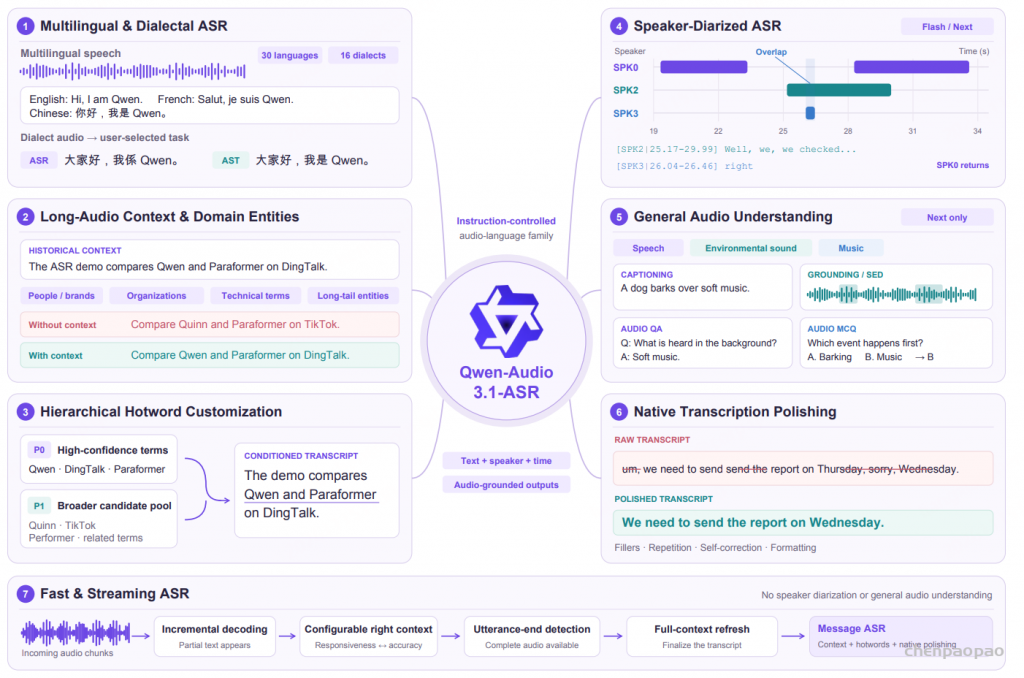
Qwen-Audio-3.1-ASR 不是只把语音转成一串文字的单一 ASR 模型,而是一组由指令控制的 Audio-Language Model。它在保留 Qwen-Audio-3.0-ASR 多语言识别、历史上下文、热词和原生润色能力的基础上,增加了两类能力:第一,输出带有说话人标签和时间戳的说话人日志;第二,Qwen-Audio-3.1-ASR-Next 能够处理声音描述、时间定位、声音事件和音频问答。

  • 支持 30 种语言,以及 16 种中文方言。
  • 中文方言可以在推理时选择“保留方言原话的 ASR”,也可以选择“翻译成普通话文字的 AST”。
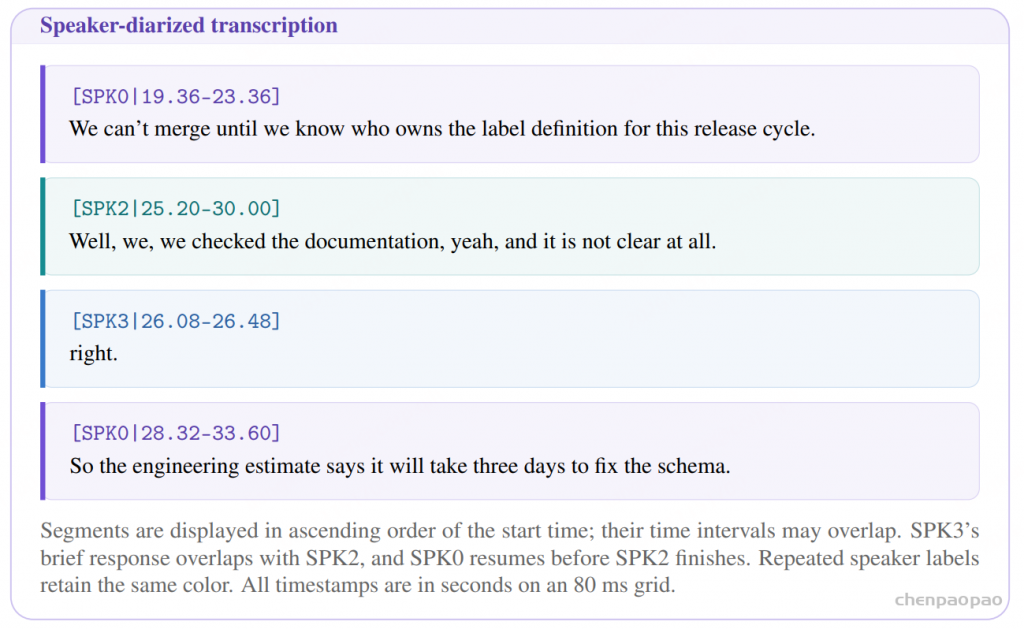
  • 非流式 Flash 和 Next 版本支持说话人日志,输出格式为 [SPK|start-end]text,支持不同说话人的时间区间重叠。
  • Message 版本采用“流式实时显示 + 句末非流式刷新”,并在同一识别流程中支持历史上下文、分层热词和原生转写润色。
  • 训练流程包含六个阶段:音频编码器预训练、Audio LLM 预训练、LLM cooldown adaptation、监督微调、强化学习和多教师在策略蒸馏(MOPD)。
二、模型家族与部署版本

版本主要场景ASR说话人日志通用音频理解上下文热词原生润色
Qwen-Audio-3.1-ASR-Flash-Filetrans异步文件转写支持不支持不支持支持支持不支持
Qwen-Audio-3.1-ASR-Flash-Streaming实时流式识别支持不支持不支持支持支持不支持
Qwen-Audio-3.1-ASR-Flash-Message交互式语音输入支持不支持不支持支持支持支持
Qwen-Audio-3.1-ASR-Flash非流式转写支持支持不支持支持支持支持
Qwen-Audio-3.1-ASR-Next非流式转写与音频分析支持支持支持支持支持支持

论文中的实验名称略有简化:实验表格中的 Qwen-Audio-3.1-ASR 通常指 Flash 基础模型的非流式接口;Qwen-Audio-3.1-ASR-Next 指带通用音频理解能力的 Next 版本;Message 延迟和行业术语召回实验使用 Qwen-Audio-3.1-ASR-Flash-Message。

三、总体架构:声音、指令和上下文共同参与解码

Qwen-Audio-3.1-ASR 的核心由三部分组成:音频编码器(audio encoder)、音频适配器(audio adapter)和基于 Qwen 的 LLM 解码器。音频编码器从波形中提取声学表示;适配器把声学表示映射到语言模型可以接收的表示空间;LLM 解码器根据声音、任务指令、可选文本条件和已经生成的前缀逐 token 产生结果。

对于音频输入 x、任务指令 q 和可选文本条件 c,可以把模型抽象为:

\(H=A(E(x)),\qquad p_{\theta}(y\mid x,q,c)=\prod_{t=1}^{T}p_{\theta}(y_t\mid y_{<t},H,q,c)\)

其中,E 是音频编码器,A 是音频适配器,H 是音频 embedding 序列,y 是输出 token 序列。c 可以包含目标语言、历史转写、P0/P1 热词或润色指令。由于解码器仍然直接接收音频表示,因此上下文提示是辅助证据,不能简单替代声学证据。

模型还保留一条辅助 CTC 路径。CTC 分支从音频编码器表示中生成初步识别假设和粗粒度位置,用于帮助热词定制与长音频上下文注入;最终输出仍由音频、指令、上下文和自回归解码共同决定,不能把 CTC 初稿当作最终答案。
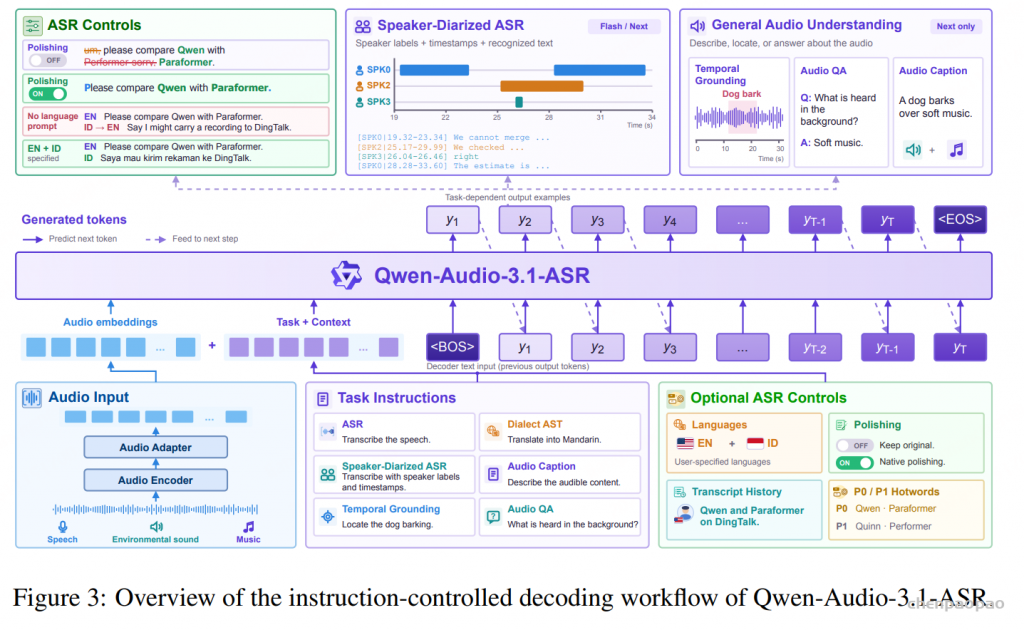
3.1 说话人日志的结构化输出

说话人日志不再是单一文本串,而是多个带结构字段的片段。可以抽象为:

\(\mathcal{S}=\{(b_i,e_i,k_i,w_i)\}_{i=1}^{M}\)

b_i 和 e_i 是片段起止时间,k_i 是录音内部的说话人标签,w_i 是对应文字。实际序列化格式为 [SPK|start-end]text,例如 [SPK2|25.20-30.00]Well, we checked the documentation.。同一录音中同一说话人会重复使用相同标签;不同说话人的时间区间可以重叠,因此可以表示插话、短响应和同时说话。标签只表示录音内部的参与者,不等于现实世界身份识别。

四、六阶段训练流程

4.1 第一阶段:音频编码器预训练

音频编码器预训练分为 BEST-RQ 自监督预训练和 AED 监督训练两步,论文称两阶段合计使用了数千万小时、覆盖多种真实场景的音频。音频来自人工智能、生物技术、电商、教育、娱乐、金融、出行等领域,但论文没有公开每个领域的具体时长。

  • Qwen3 初始化:从预训练 Qwen3 LLM 中初始化结构兼容的 Transformer 层。非流式编码器使用双向注意力,以便同时查看语音前后文;声学前端单独初始化。
  • BEST-RQ:随机遮挡声学帧,使用未遮挡特征经过固定随机投影和冻结 codebook 得到的离散目标,训练编码器预测被遮挡位置的目标。这样可以利用大量无转写语音学习上下文声学表示。
  • AED 监督训练:把编码器接入 attention-based encoder-decoder,用配对的音频和文字逐 token 预测转写。标注数据经过 VAD、Paraformer-V2、Whisper-large-v3、SenseVoice 等多系统伪标签生成和 ITN 处理。完成后丢弃 AED 解码器,只保留训练好的编码器初始化主模型。
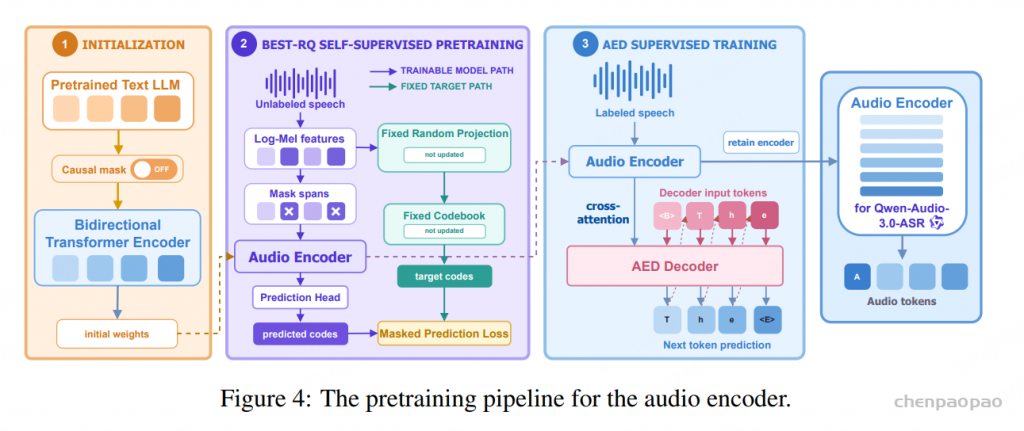
4.2 第二阶段:Audio LLM 预训练

Audio LLM 解码器从 Qwen 的语言模型部分初始化,采用 Mixture-of-Experts(MoE)骨干。论文给出的预训练规模约为 2,000 万小时多语言数据,主要包括 ASR 数据和文字-音频交错数据。此阶段冻结音频编码器,只联合训练音频适配器和 LLM 解码器,并使用目标文字上的交叉熵损失建立音频表示与语言表示之间的对齐。

这一阶段带来的不仅是发音到文字的映射,也包括多语言知识、世界知识和语义消歧能力。例如,当声音在同音词之间存在歧义时,语言模型可以利用话题、实体和常识进行候选排序,但最终仍需要以音频为主要证据。

4.3 第三阶段:LLM Cooldown Adaptation

Cooldown 阶段使用约 100 万小时的更高质量音频-文字数据,重点不是继续简单扩大数据量,而是重新平衡语言和中文方言比例、提高转写质量并增加任务多样性。混合数据包括常规 ASR、音频理解、说话人日志、语音问答和对话数据。

质量过滤方面,团队使用 VibeVoice 对 ASR 音频重新识别,再与已有参考文本比较;词错误率大于 0.3 的样本被移除。重要的是,这个过程只是筛选数据,不是用 VibeVoice 输出替换原参考文本。

4.4 第四阶段:监督微调(SFT)

SFT 把模型变成真正的指令控制 Audio-Language Model。每个样本由用户指令、音频和 assistant 目标回答构成,覆盖多语言、方言、代码切换、噪声、远场、行业术语、说话人日志和通用音频理解。

SFT 时联合更新音频编码器和音频适配器;基础 LLM 参数冻结,只通过 LoRA 适配解码器。训练目标仍是目标回答的自回归交叉熵。语言控制样本会明确要求“按指定语言转写”“保留多语言原有书写系统”,避免模型把较低资源语言擅自替换成更熟悉的语言。

4.4.1 行业实体数据合成

团队从人工智能、金融、医疗、IT 等领域挖掘稀有实体和长尾词,结合检索到的事实背景让 LLM 生成包含实体的多样短句,再用 CosyVoice3 合成语音;对难以稳定合成的术语补充人工录音。随后用当前 ASR 模型重新识别,并过滤实体明显不一致的样本。这样可以让模型在训练中同时“看到”和“听到”不常见的名称,而不是只在词表中加入文字。

4.4.2 原生转写润色

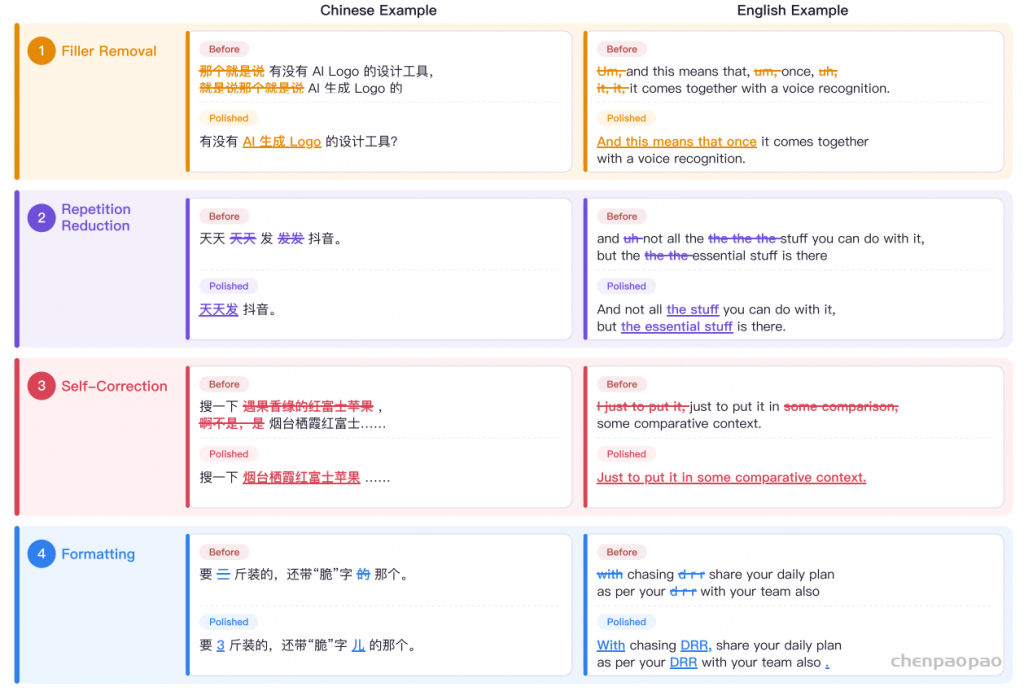
通过一个二值润色指令控制输出是逐字稿还是清洁稿。润色样本教模型删除非语义填充词、合并口吃和不必要重复、处理说话人的自我纠正,并规范标点和格式。真实语音保留原始音频,再用文本 LLM 生成润色监督,并用保真度过滤去除语义损失或无依据添加;合成数据则在标准文本中注入填充词、重复和自我修正,再通过 TTS、发音过滤和噪声增强生成音频。

4.4.3 历史上下文与同音词消歧

上下文训练把同一会话前面已经出现的转写或交互记录作为参考。指令明确告诉模型:历史上下文可能不完整、无关甚至错误,当前音频仍是首要证据。真实数据按照音频 ID 找回原会话,恢复时间顺序,只使用当前语音之前的轮次,不对历史文本做 LLM 改写;合成数据则专门构造正确、冲突、噪声和空白上下文,用来训练模型既会利用有效提示,也不会无条件复制提示。

这解释了“没有外部知识时如何利用同一句话内部线索”的基本机制:音频编码器提供发音证据,当前句子已生成的前缀、指令和历史片段提供语义约束;如果目标词是专名或同音词,模型可以通过同一句中的动作、对象、数量、主题和显式拼字说明来提高候选概率。训练时还要加入冲突提示和无关提示,避免模型形成“提示了什么就一定输出什么”的捷径。

4.4.4 分层热词 P0/P1

P0 是高置信度、高优先级候选,例如关键人名和上下文中确定出现的实体;P1 是更宽的候选池。LLM 根据候选与参考转写的语义匹配把词分层。推理时 P0 获得更强条件,但模型仍需同时满足声学和上下文证据;P1 用于扩大覆盖而不是强制替换。

4.4.5 说话人日志 SFT、speaker loss 与时间量化

说话人日志训练数据由人工转写和模型生成监督组成。影视数据使用原始字幕,并结合语言识别、声音事件检测和说话人日志模型交叉校验;另外用 LLM 生成会议话题,模拟多人会议,并加入不同混响和噪声。

输出按时间顺序序列化为 [SPK|start-end]text。同一说话人保持一致标签,区间允许重叠。训练语料中,speaker-ID 数字 token 占全部监督 token 的 2.90%,但只贡献未加权交叉熵损失的 1.97%;时间戳 token 占 33.44%,贡献 49.51%;格式 token 占 14.48%,损失约 0.23%;转写 token 占 46.50%,损失 47.74%。因此只对 speaker-ID 数字 token 施加 10 倍损失权重,其余 token 保持 1 倍。
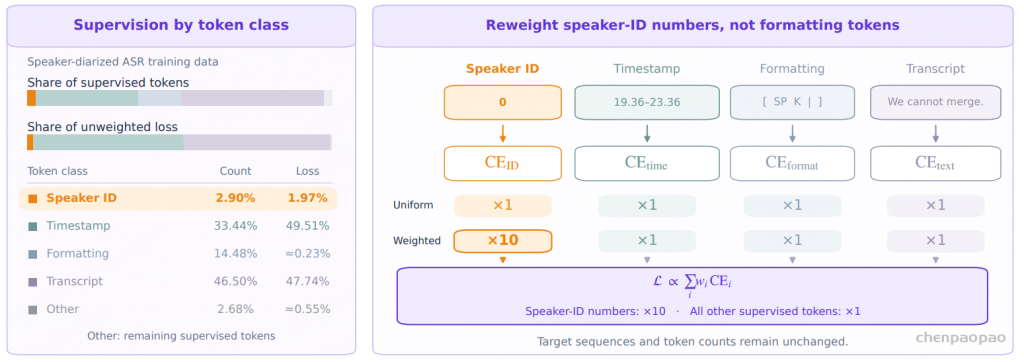
在说话人日志训练中,不同类型的输出 token 对训练损失的贡献并不均衡。模型可能花了大量训练资源学习时间戳和转写文字,但真正决定“谁在说话”的 Speaker-ID token 获得的有效监督相对不足。只提高 Speaker-ID 数字 token 的损失权重,其他 token 的权重保持不变。

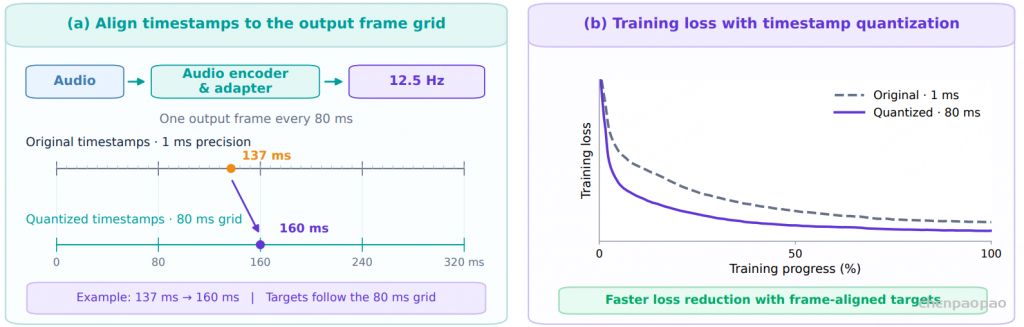
时间戳从原始 1 ms 精度量化到 80 ms 网格,与编码器和适配器的 12.5 Hz 表示帧率对齐。论文报告,相比 1 ms 目标,80 ms 量化能带来更快的损失、DER 和 cpWER 收敛,并在相同数据混合下取得更好的 DER 和 cpWER。
\(L=\sum_i w_i\,\mathrm{CE}_i,\qquad w_i=\begin{cases}10,&i\text{ 为 speaker-ID 数字 token}\\1,&\text{其他 token}\end{cases}\)

4.5 第五阶段:强化学习(RL)

RL 数据集聚焦真实困难样本,包括多个 ASR 系统(Whisper、FireRed-ASR、SenseVoice)意见不一致的样本、超过 20 秒的长语音、幻觉与长重复、关键词/热词样本,以及用于防止灾难性遗忘的常规 ASR 数据。上下文样本保留原有历史文本和指令,以便奖励真正反映指定任务。

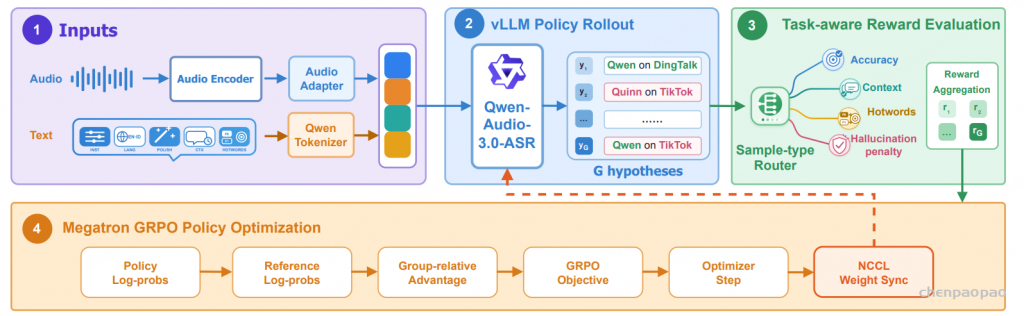
团队实现了异步音频强化学习框架 FunVerl:音频处理器提取 Mel 特征并 token 化文本;vLLM 生成一组候选答案;奖励模块按任务计算分数;Megatron trainer 使用张量、流水线和专家并行更新策略。轨迹队列把生成和优化解耦,NCCL 同步更新后的权重,并通过策略版本阈值过滤过旧轨迹。

对每个输入 q,旧策略生成 G 个回答,组内标准化奖励得到共享优势:

\(\hat A_{i,t}=\frac{R_i-\operatorname{mean}(\{R_j\}_{j=1}^{G})}{\operatorname{std}(\{R_j\}_{j=1}^{G})+\delta}\)

GRPO 的裁剪目标为:

\(J_{\mathrm{GRPO}}(\theta)=\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_t\left[\min\left(r_{i,t}\hat A_{i,t},\operatorname{clip}(r_{i,t},1-\varepsilon,1+\varepsilon)\hat A_{i,t}\right)-\beta D_{\mathrm{KL}}(\pi_\theta\|\pi_{\mathrm{ref}})\right]\)
  • 普通 ASR 奖励:1-WER 为主,结合关键词召回、关键词准确率、P0/P1 热词奖励、上下文实体命中与误插入惩罚。
  • 幻觉抑制:通过模式匹配检测幻觉片段,并按幻觉长度惩罚。
  • 说话人日志奖励:使用 DER、cpWER 和 tcpWER,分别关注说话人活动/混淆、按说话人拼接后的识别、以及带时间约束的词对齐。
4.6 第六阶段:多教师在策略蒸馏(MOPD/OPD)

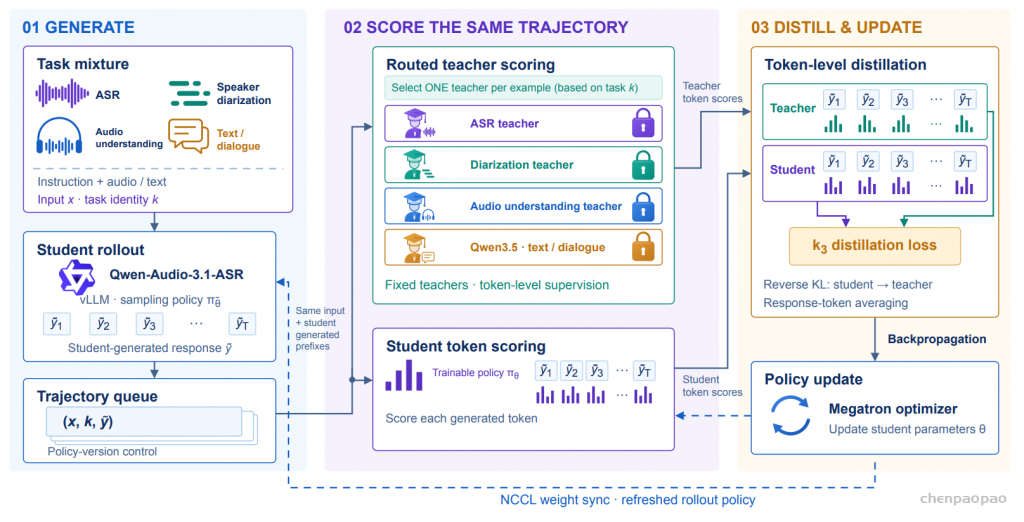
多教师在策略蒸馏的通俗理解是:不是让学生只背固定标准答案,而是先让学生按当前能力自己生成,再让最适合该任务的教师在学生实际走到的前缀上给出 token 级指导。这样,学生前面即使已经犯错,教师仍能在学生真实访问到的状态上纠偏,减轻训练分布与推理分布不一致的问题。

任务路由使用四类教师:ASR 教师负责语音转写;说话人日志教师负责 speaker、时间和文字结构;音频理解教师负责声音描述、时间定位和音频问答;Qwen3.5 文本/对话教师负责保留语言模型和对话能力。

设学生采样回答为 \tilde y,输入为 x,任务对应教师为 p_{\phi_k}。对学生生成的第 t 个 token,使用 k3 估计器:

\(\rho_t(\theta)=\frac{p_{\phi_k}(\tilde y_t\mid x,\tilde y_{<t})}{\pi_\theta(\tilde y_t\mid x,\tilde y_{<t})},\qquad d_t^{(k_3)}=\rho_t-\log\rho_t-1\)

完整蒸馏损失为:

\(\mathcal L_{\mathrm{OPD}}(\theta)=\mathbb E_{(x,k),\tilde y\sim\pi_{\bar\theta}}\left[\frac{1}{|\tilde y|}\sum_{t=1}^{|\tilde y|}d_t^{(k_3)}(\theta)\right]\)

蒸馏数据混合 ASR、speaker diarization、audio understanding,以及文本和对话数据。论文没有给出各教师、各任务的具体采样比例,也没有公开单独的 MOPD 增益表,因此可以确认其设计目标是能力合并和稳定化,但不能把最终成绩定量归因于 MOPD 单一步骤。
五、推理与部署:流式、上下文和方言任务

5.1 多语言和代码切换

推理时可以指定目标语言列表,模型在同一个 checkpoint 中处理多语言和代码切换,并保留各语言原有书写系统。例如日语保留汉字与假名,韩语保留韩文。公众号给出的韩语金融口述和日语求职咨询样例,强调专业词、语气和关键信息的保留,而不是把所有语言统一翻译成中文。

5.2 方言 ASR 与方言到普通话 AST

同一段方言有两种合法目标:ASR 要求保留方言原话;AST 要求把方言意思翻译成书面普通话。比如“大家好,我係 Qwen。”在方言 ASR 中保留“我係”,在方言到普通话 AST 中输出“我是”。这两个任务必须分开评测,不能把方言原文 CER 和普通话翻译的语义准确率混为一谈。

5.3 流式识别与 Message ASR

Streaming 版本把音频切成短 chunk,并配置有限的 right context,以在延迟和准确率之间折中。短 right context 更快,长 right context 能看到更多声学证据;随着更多音频到达,部分假设可以被修订。句末检测后,完整 utterance 会被重新解码并刷新最终文本。

Message ASR 在此基础上叠加历史转写、P0/P1 热词和原生润色。它的设计重点是“先让用户看到字,再在句末用完整上下文刷新”,而不是要求流式阶段立即输出最终完美结果。
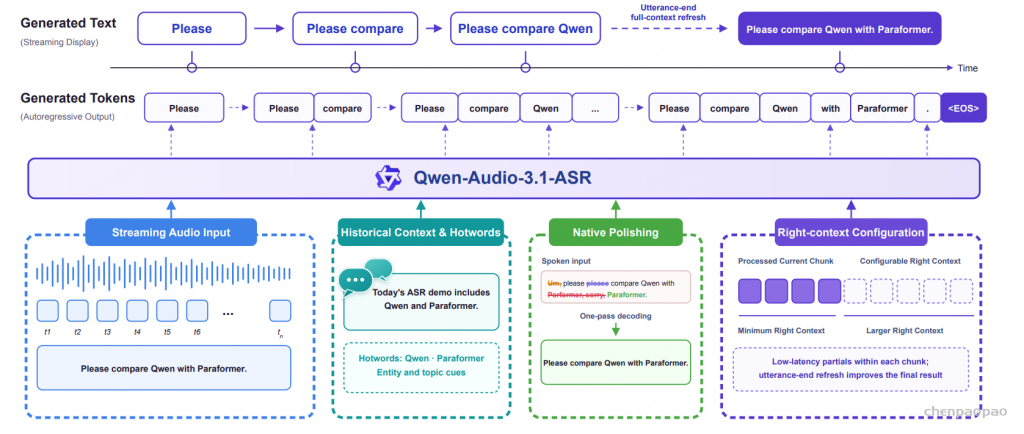
Overview of the Message ASR workflow used in Qwen-Audio-3.1-ASR
连续音频输入
      ↓
音频切成短 chunk
      ↓
加入有限的未来音频 right context
      ↓
流式编码与增量解码
      ↓
输出临时文本
      ↓
继续接收新的音频
      ↓
修订尚未稳定的文本尾部
      ↓
检测到 utterance 结束
      ↓
取完整语句音频
      ↓
使用完整上下文重新解码
      ↓
刷新最终转写文本

六、实验设置与指标

论文覆盖公开 ASR、多语言、方言、行业实体、热词、长音频上下文、原生润色、Message 延迟、说话人日志和通用音频理解。公开数据集包括 AISHELL-1、AISHELL-2、FLEURS、LibriSpeech、WeNetSpeech、GigaSpeechBench、Common Voice 15、KeSpeech、WSYue、AISHELL-4、AliMeeting-test、MLC-SLM、MagicData-RAMC、MMAU、MMSU、CochlScene、Nonspeech7k、MELD、NSynth、DiDiSpeech、Clotho-Moment 和 DESED。

常用指标定义如下:

  • CER:中文或逐字评价中的字符错误率,越低越好。
  • WER:英文等按词评价的词错误率,越低越好。
  • DER:说话人日志错误率,反映漏检、误报和说话人混淆。
  • cpWER:按说话人拼接后,在最佳说话人置换下计算的词错误率,降低了 SPK0/SPK1 名称任意性的影响。
  • tcpWER:带时间约束的 cpWER,要求词与时间区间兼容。
  • 实体召回率:参考文本中关键名称和术语被正确识别的比例。
  • 语义句准确率:方言 AST 中输出是否保留人名、数量、否定、动作、对象、时间、地点等关键意义。
  • mIoU:时间定位预测区间与标注区间的平均交并比。

内部方言 AST 的语义句准确率为:

\(\mathrm{Semantic\ Sentence\ Accuracy}(\%)=\frac{100}{N}\sum_{i=1}^{N}\mathbf 1[z_i=0]\)

其中 z_i=1 表示第 i 个输出存在语义错误,z_i=0 表示没有语义错误。人工标注子集与 Qwen3.7-Max 判断的一致率为 95.35%,这 95.35% 是评估器一致率,不是方言翻译准确率。

七、主要实验结果

7.1 中文和英文公开 ASR

测试集指标Qwen-Audio-3.0-ASRQwen-Audio-3.1-ASR3.1 观察
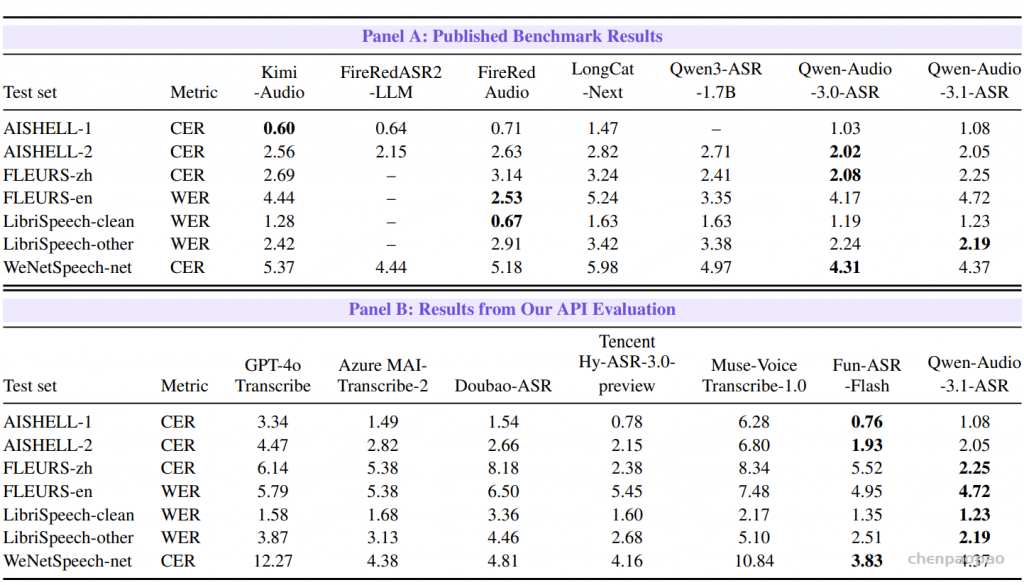
AISHELL-1CER1.03%1.08%略高于上一代;统一 API 评测中 Fun-ASR-Flash 为 0.76%
AISHELL-2CER2.02%2.05%与上一代接近
FLEURS-zhCER2.08%2.25%统一 API 评测中为参评系统最低
FLEURS-enWER4.17%4.72%统一 API 评测中为参评系统最低
LibriSpeech-cleanWER1.19%1.23%统一 API 评测中为参评系统最低
LibriSpeech-otherWER2.24%2.19%论文公开结果中达到最低值
WeNetSpeech-netCER4.31%4.37%统一 API 评测中 Fun-ASR-Flash 为 3.83%

论文特别区分了“公开来源结果”和“统一 API 评测”。由于公开结果可能使用不同预处理和打分协议,直接比较应优先看 Panel B。统一 API 评测中,Qwen-Audio-3.1-ASR 在七个测试集中的四个取得最低错误率:FLEURS-zh 相对最强基线降低 0.13 个百分点,FLEURS-en 降低 0.23 个百分点,LibriSpeech-clean 降低 0.12 个百分点,LibriSpeech-other 降低 0.32 个百分点;AISHELL-1、AISHELL-2 和 WeNetSpeech-net 则由 Fun-ASR-Flash 最低。

7.2 多语言 ASR

测试组Qwen-Audio-3.0-ASR 宏平均Qwen-Audio-3.1-ASR 宏平均结论
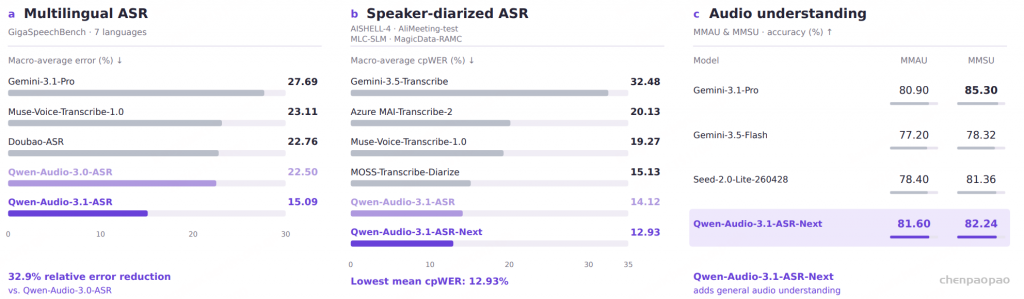
GigaSpeechBench(印尼、日、泰、菲、越、韩、马来)22.50%15.09%相对降低 32.9%,七种语言均低于上一代
Common Voice 15(8 种语言)未提供完整上一代结果3.74%有完整结果的参评系统中最低
FLEURS(9 种语言)4.94%3.85%低于上一代,但 Azure MAI-Transcribe-2 为 3.25%

GigaSpeechBench 中,日语 CER 从 28.48% 降到 18.47%,泰语 CER 从 16.22% 降到 7.75%,马来语 WER 从 34.65% 降到 25.04%。FLEURS 中,Qwen-Audio-3.1-ASR 在印尼语、日语和韩语取得该表最低错误率;但泰语、菲律宾语、越南语和马来语的最佳值由 Azure MAI-Transcribe-2 获得,说明不同语言和录音条件下仍存在系统差异。
7.3 中文方言 ASR 与 AST

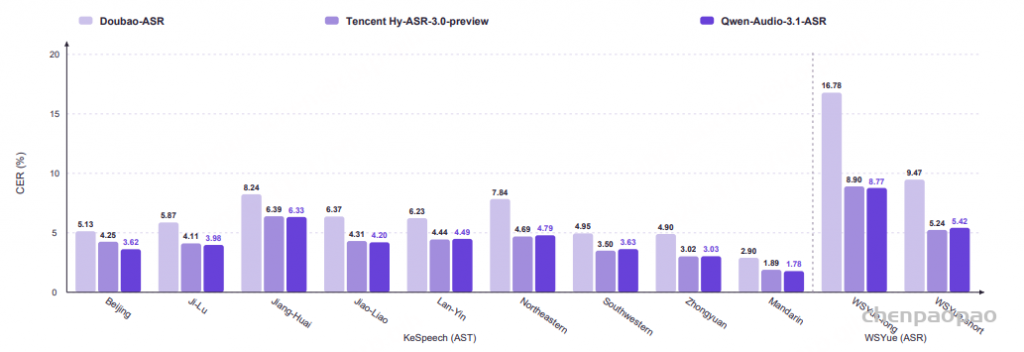
公开方言基准包含 9 个 KeSpeech AST 子集和 WSYue 粤语长/短语音 ASR 子集。Qwen-Audio-3.1-ASR 的宏平均 CER 为 4.55%,Doubao-ASR 为 7.15%,Tencent Hy-ASR-3.0-preview 为 4.61%,并在 6 个子集取得最低 CER。

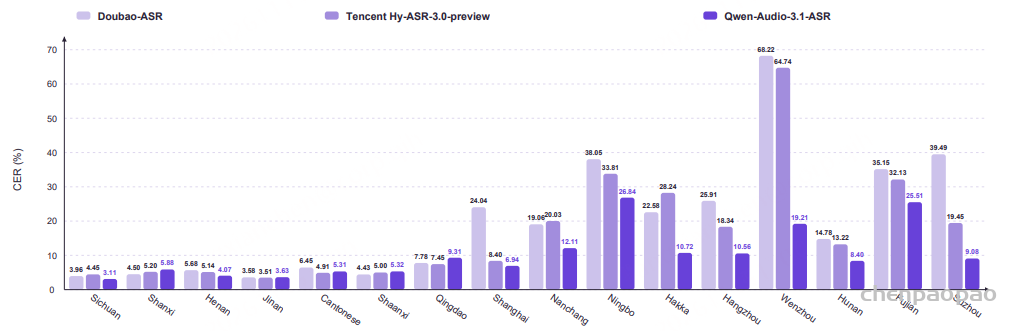
内部 16 方言 ASR 测试中,Qwen-Audio-3.1-ASR 在 11 个子集取得最低 CER,宏平均为 10.38%,低于 Doubao-ASR 的 20.23% 和 Tencent Hy-ASR-3.0-preview 的 17.13%。温州话 CER 为 19.21%,对应两个基线分别为 68.22% 和 64.74%。

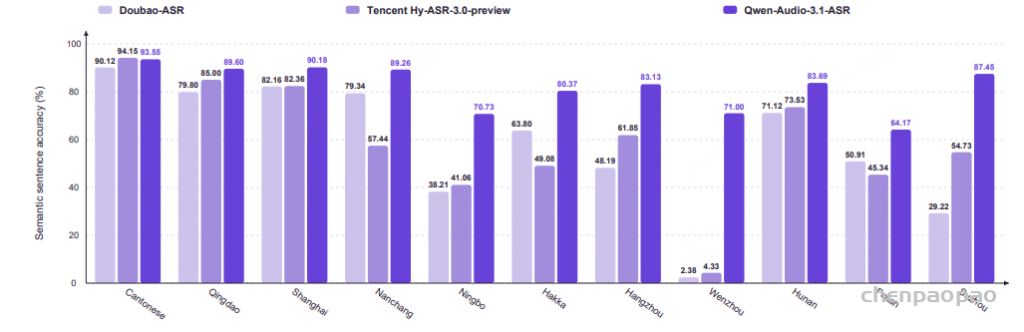
内部 11 方言 AST 测试中,对 Doubao-ASR 可比的上海、客家和粤语子集,Qwen-Audio-3.1-ASR 语义句准确率宏平均为 88.03%,Doubao-ASR 为 78.69%;对 Tencent Hy-ASR-3.0-preview 可比的南昌、湖南、粤语和青岛子集,宏平均为 89.03%,基线为 77.53%。这些结果评估的是意义是否保留,不等于普通话表达是否最自然。
7.4 行业实体与热词

15 个行业的内部实体识别测试中,Qwen-Audio-3.1-ASR 在 9 个领域取得最高实体召回率,并在建筑与家居、制造业两个领域并列最高;召回率范围为 94.9%–99.5%。相较更强竞争系统,人工智能、农业、商业与物流的提升分别为 2.3、2.2 和 2.1 个百分点。论文也明确提醒:该结果不能单独证明实体合成流水线的因果增益,因为它与其他改进一起加入了最终模型。

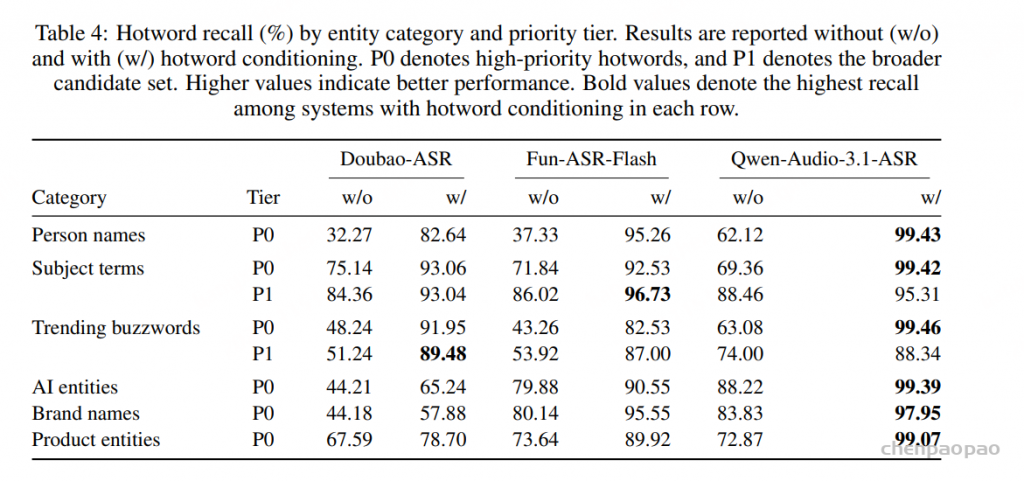
热词类别层级无热词有热词说明
人名P062.12%99.43%高优先级人名提升显著
主题词P069.36%99.42%P0 强条件
主题词P188.46%95.31%P1 提升较温和
趋势词P063.08%99.46%P0 强条件
AI 实体P088.22%99.39%长尾实体召回
品牌名P083.83%97.95%有热词时明显改善
产品实体P072.87%99.07%有热词时明显改善

7.5 长音频上下文

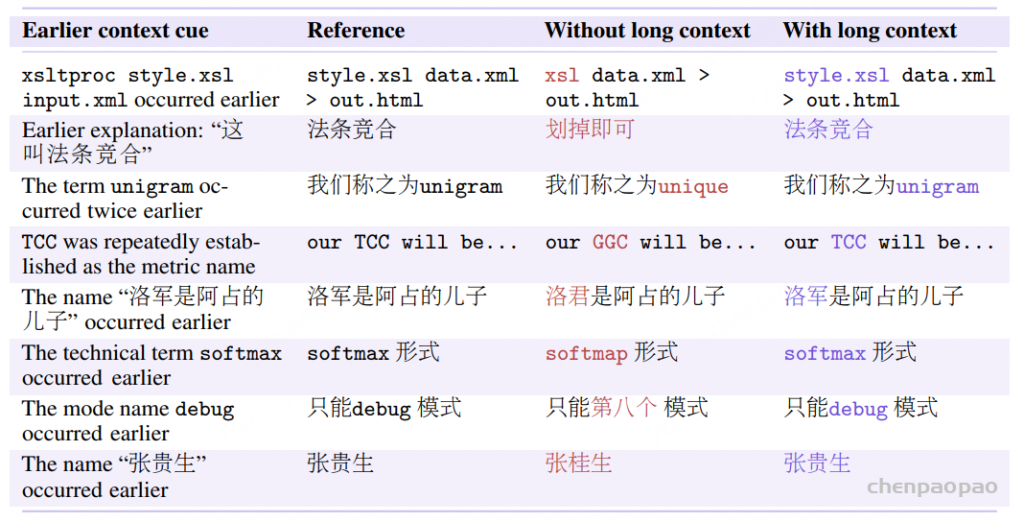
论文给出的定性案例显示,前面出现过的代码文件名、法条名称、unigram、TCC、softmax、debug 模式和人名,可以帮助后续片段纠正音近但错误的结果。例如前文出现 style.xsl,后文不带上下文时识别为 xsl,加入历史上下文后恢复为 style.xsl;“张贵生”也能从“张桂生”纠正回来。这里的上下文来自同一会话的此前转写,不是外部知识库。

这些例子是定性展示,不是受控的上下文消融实验。论文没有公开一个统一的“有上下文/无上下文”总体 CER 降幅,因此应把它们理解为机制示例,而非单独的性能承诺。
7.6 原生转写润色

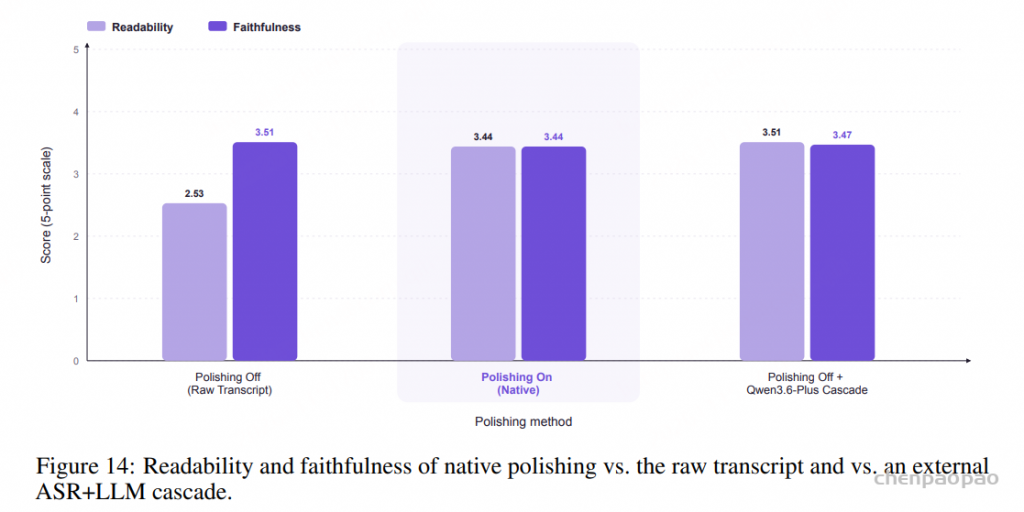
在五分制内部评分中,原始转写可读性为 2.53,原生润色提高到 3.44,外部 ASR+Qwen3.6-Plus 串联为 3.51;原生润色的忠实度为 3.44,串联为 3.47,原始转写为 3.51。也就是说,原生润色显著改善可读性,只带来有限的忠实度下降,并省掉额外的文本 LLM 调用。

公众号和论文示例包括删除 um/uh、合并 the the the、处理 false start、吸收说话人的最终自我修正,以及把口述字母 d r r 规范成 DRR。
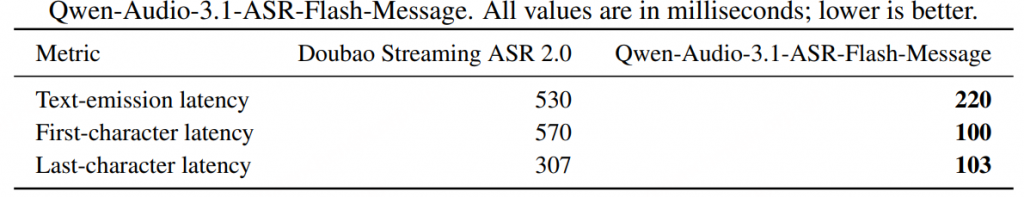
7.7 Message ASR 延迟与行业词召回

指标(毫秒)Doubao Streaming ASR 2.0Qwen-Audio-3.1-ASR-Flash-Message
文本输出延迟530220
首字符延迟570100
末字符延迟307103

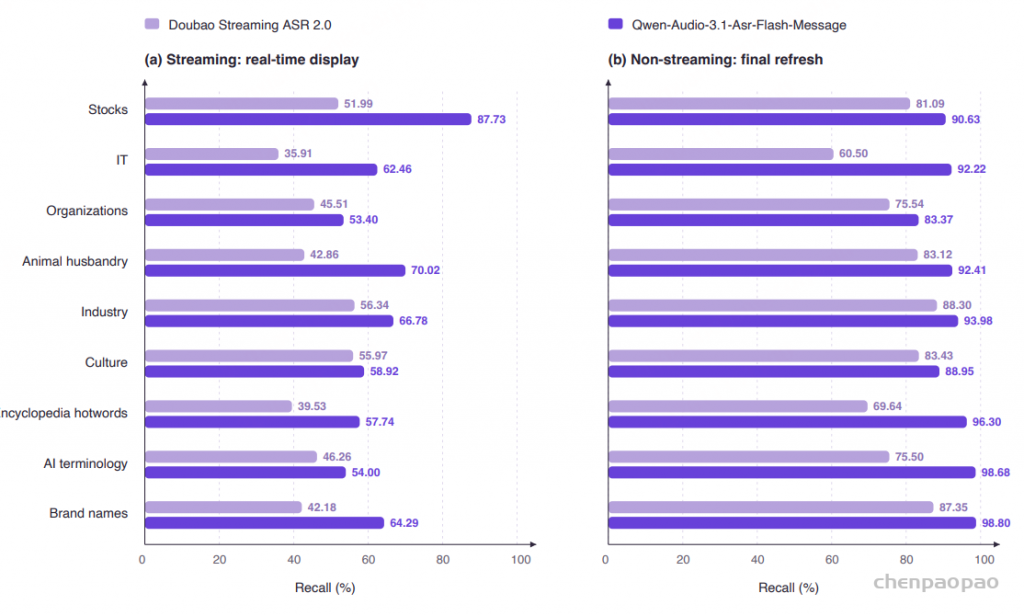
测试使用 10 路并发音频流,Qwen 服务运行在 NVIDIA H100,自建服务;网络延迟假设相近。九个行业测试集上,Qwen 流式显示阶段平均实体召回率为 63.93%,Doubao 为 46.28%;句末非流式刷新阶段为 92.82%,Doubao 为 78.27%。因此流式输出负责即时反馈,句末刷新负责更高质量的最终文本。
7.8 说话人日志 ASR

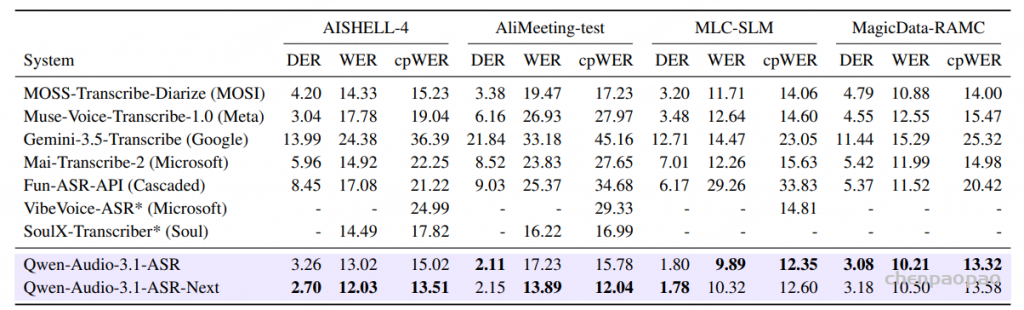
测试集Qwen 3.1 ASR DERQwen 3.1 ASR cpWERQwen 3.1 ASR-Next DERQwen 3.1 ASR-Next cpWER
AISHELL-43.26%15.02%2.70%13.51%
AliMeeting-test2.11%15.78%2.15%12.04%
MLC-SLM1.80%12.35%1.78%12.60%
MagicData-RAMC3.08%13.32%3.18%13.58%

两种 Qwen 版本合计在四个数据集的 12 个数据集-指标组合中都取得最低错误率;两者各有优势。Next 在 AISHELL-4 的 DER/WER/cpWER、AliMeeting-test 的 WER/cpWER 等项目更强;基础 ASR 在 AliMeeting-test DER、MLC-SLM WER/cpWER 和 MagicData-RAMC 三项指标更强。所有 Qwen 版本都在四个数据集上同时优于级联 Fun-ASR 的 DER 和 cpWER。为公平比较,长音频测试统一切成约 4 分钟片段,论文提供了 SDR Evaluation Toolkit。
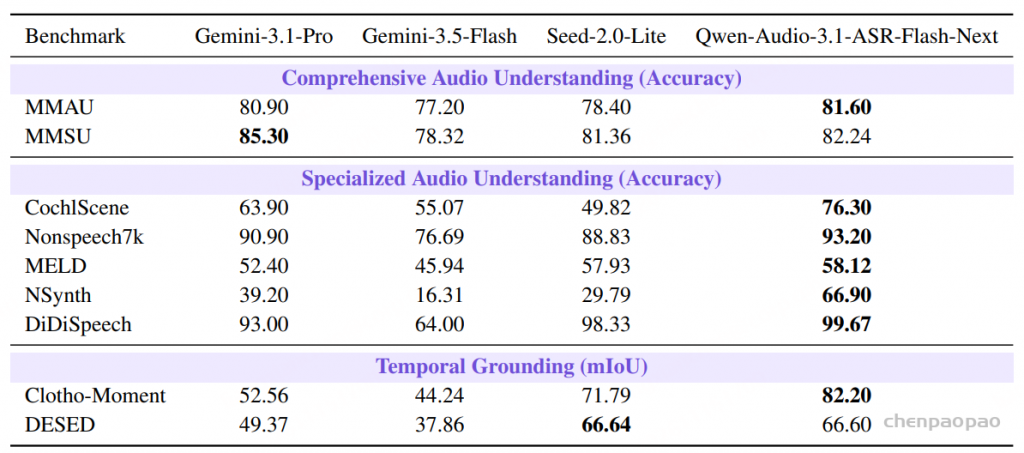
7.9 通用音频理解与时间定位

基准任务/指标Qwen-Audio-3.1-ASR-Flash-Next结果解读
MMAU综合音频理解准确率81.60%高于 Gemini-3.1-Pro 0.70 个百分点
MMSU细粒度语音理解准确率82.24%低于最佳结果 3.06 个百分点
CochlScene声学场景准确率76.30%领先次优 12.40 个百分点
Nonspeech7k非语音声音准确率93.20%该任务最佳
MELD情绪识别准确率58.12%该任务最佳
NSynth乐器识别准确率66.90%领先次优 27.70 个百分点
DiDiSpeech说话人性别准确率99.67%该任务最佳
Clotho-Moment单区间时间定位 mIoU82.20%领先次优 10.41 个百分点
DESED多区间事件检索 mIoU66.60%仅低于最佳 0.04 个百分点

Next 在 9 个基准中的 7 个取得最佳结果。它把 ASR 扩展为对语音、环境声和音乐的统一音频理解,但这类能力只在 Next 非流式接口提供,不能与 Streaming 或 Message 版本混用。
八、论文中真正的创新点

  • 从平面 ASR 到结构化音频输出:同一个指令控制框架覆盖普通转写、说话人+时间戳转写和音频理解。
  • 说话人日志直接生成:把 speaker、时间和文字序列化为统一自回归目标,并支持重叠语音,避免单独 diarization、ASR、对齐模块之间的级联误差。
  • 面向长尾实体的训练闭环:行业词挖掘、事实驱动句子生成、TTS/人工录音、重新识别过滤,形成专门的实体数据合成流水线。
  • 上下文与热词的分层控制:历史转写提供话题线索,P0/P1 把高置信度候选和宽候选分开,同时用冲突/无关上下文训练模型避免盲目复制。
  • 时间戳和 speaker token 的针对性优化:speaker-ID loss 乘 10,时间戳对齐到 80 ms 音频帧网格。
  • 异步 GRPO 与 MOPD:RL 用序列级指标直接优化;MOPD 用多个任务教师在学生实际轨迹上提供 token 级指导。
  • 流式显示与句末刷新结合:用实时性和最终准确率两个阶段分别服务用户体验和最终稿质量。
  • 原生润色:把逐字识别与清洁稿生成放进同一次音频条件解码,减少额外 ASR+LLM 串联调用。

Qwen-Audio-3.1-ASR 的关键变化不是简单堆叠更多语言,而是把 ASR 放进一个更完整的音频语言建模框架:音频编码器负责提取可对齐的声学证据,Qwen MoE 解码器负责语言和语义组织,指令决定输出任务,上下文与热词负责在有依据时解决长尾实体和同音词,RL 和 MOPD 进一步把序列级指标与任务教师反馈纳入优化。

从结果看,它在多语言、中文方言、行业术语、说话人日志和通用音频理解上形成了较完整的能力谱系;从工程上看,Flash/Streaming/Message/Next 的版本拆分说明不同能力之间存在真实的延迟、上下文和输出结构取舍。对于实际应用,最合理的使用方式不是只追求一个最低 CER,而是根据任务选择:实时输入用 Message,异步文件和说话人日志用非流式 Flash,音频描述、声音事件和时间定位用 Next;涉及关键实体时,再结合 P0/P1 热词和同一会话历史上下文。
Hy ASR 3.0 技术报告详解:LLM 语音识别、上下文利用、方言与多阶段强化学习

论文:Hy ASR 3.0 Technical Report
团队:Hy ASR team / Tencent Hy
arXiv:2611.14908v1

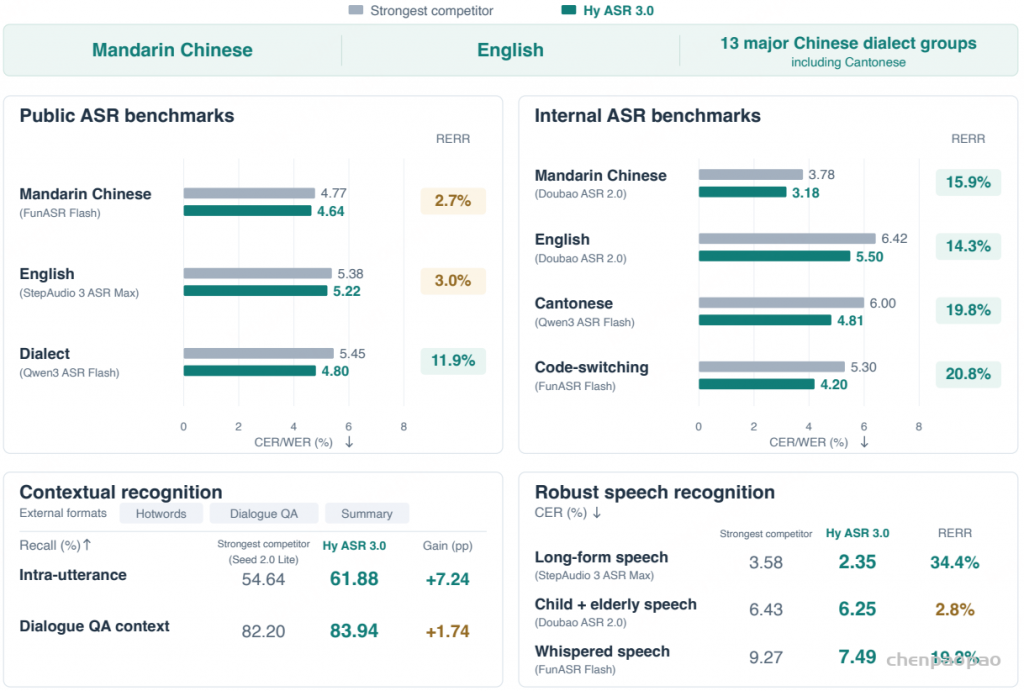
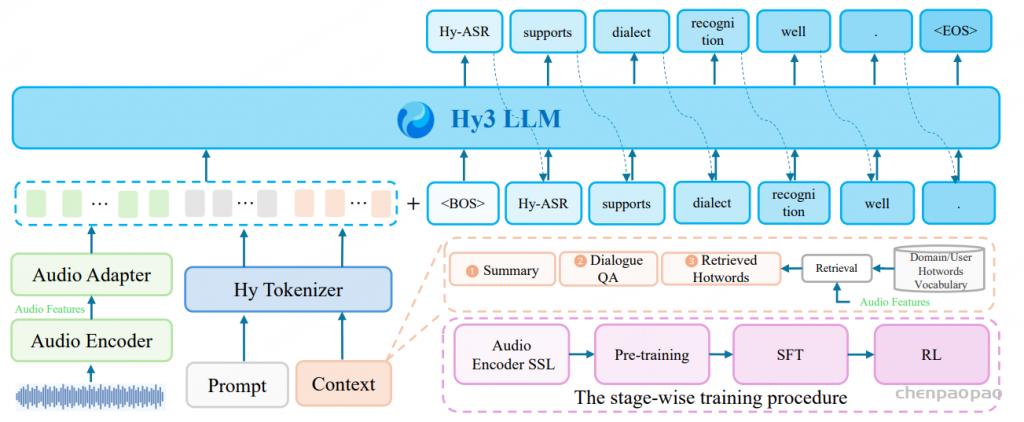
Hy ASR 3.0 是一个建立在预训练 Hy3 基座模型之上的大语言模型式自动语音识别系统。它的目标不只是降低普通话和英语的 CER/WER,还要同时处理粤语与其他中文方言、热词和对话上下文、同音词消歧、长音频、儿童与老年人语音、低音量和噪声环境。系统由音频编码器、音频适配器、Hy3 LLM 解码器和音频条件热词检索模块组成,训练流程则覆盖自监督编码器训练、大规模 ASR 预训练、定向持续预训练、SFT、领域专家 RL、多教师 on-policy 蒸馏和行为强化学习。

一、核心结论与关键贡献

  • LLM-based ASR:音频编码器提取声学表示,音频适配器将其投影到 LLM 输入空间,Hy3 LLM 自回归生成转写。
  • 多种外部上下文:支持热词列表、问答式对话历史和摘要;热词先通过音频条件检索模块筛选,再与其他上下文一起作为文本前缀。
  • 句内上下文消歧:模型能够利用同一条语音其他位置的语义或显式拼字说明,识别同音、近音和生僻词,无需额外外部上下文。
  • 大规模自监督编码器:采用 Best-RQ 启动、迭代 HuBERT 和残差向量量化,在数千万小时语音上训练。
  • 大规模伪标签:多套 ASR 系统独立生成候选转写,以 ROVER 投票融合,再经过多阶段质量过滤。
  • 数据效率:领域平衡和数据压缩后,只使用原训练数据的 50% 仍获得更好性能;持续预训练对齐 SFT 分布后,SFT 数据可压缩到原来的 1/10,同时保持模型性能。
  • 专家强化学习:分别训练通用 ASR、方言 ASR、上下文偏置 ASR 三个专家,以降低跨领域目标干扰。
  • MOPD:学生先生成 on-policy 假设,再按领域路由给相应专家做 token 级 KL 蒸馏,把三个专家合并为一个统一模型。
  • 公开基准:论文报告中文聚合错误率 4.64%、英文 5.22%、方言组合 4.80%;粤语四个子集的非加权均值为 5.06%。
  • 内部基准:普通话、英语、粤语、代码切换分别为 3.18%、5.50%、4.81%、4.20%,在论文比较的系统中均为最低。
  • 上下文与鲁棒性:句内上下文关键词召回 61.88%,对话 QA 上下文召回 83.94%;长音频 CER 2.35%,儿童+老年语音 6.25%,低音量+噪声 7.49%。
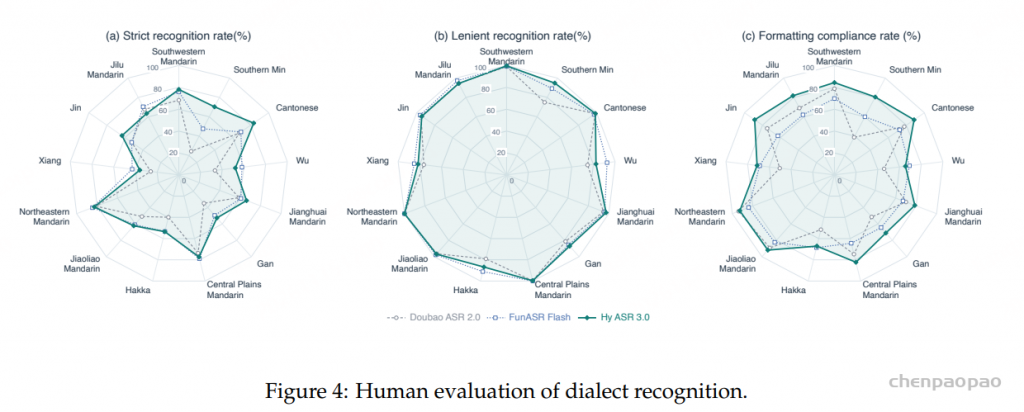
  • 方言人工评测:覆盖 13 个方言大类、91 个次区域变体,严格识别率 64.7%,格式合规率 80.3%。
Hy ASR 3.0 能力与主要基准结果总览,包括普通话、英语、方言、上下文识别和鲁棒性。

二、任务定位:

Hy ASR 3.0 的输出目标是语音内容转写,即把音频转换为文字。它关注的核心是四类问题:

  1. 普通话、英语、粤语和中文方言的识别准确率;
  2. 热词、历史问答和摘要等外部上下文如何帮助识别;
  3. 同一语句内部的语义、对比和逐字解释如何消除同音歧义;
  4. 长音频、不同年龄人群、低音量和噪声等真实业务条件下的鲁棒性。

三、模型架构

Hy ASR 3.0 模型架构与分阶段训练流程。图中包含 Audio Encoder、Audio Adapter、Hy Tokenizer、Hy3 LLM、摘要/对话 QA/检索热词前缀,以及 Encoder SSL、Pre-training、SFT、RL 四段训练链路。

3.1 音频编码器

音频编码器的训练采用迭代的 HuBERT 式自监督流程。先训练一个 Bootstrap Encoder,并用 Best-RQ 对它选定的中间表示做量化,得到离散目标;再用这些目标训练一个 Intermediate HuBERT 模型;随后对它的表示做残差向量量化,得到多级目标;最后训练最终编码器,从被掩码的语音输入预测这些目标。整个阶段的直接监督来自语音自身的量化表示,人工逐字标注留给后续需要监督的任务。

编码器在数千万小时语音上分 2 阶段训练,数据以普通话和英语为主,也包含粤语和其他汉语方言。第一阶段覆盖较广的语音混合,第二阶段继续预训练时重新平衡数据,更强调汉语方言,降低噪声录音和短句的权重,并加强掩码策略和 utterance mixing,以提高对干扰语音的鲁棒性。

Best-RQ × HuBERT 式自监督学习 × 残差向量量化: Best-RQ 先提供可训练的 bootstrap 目标和量化表示,HuBERT 式自监督学习把这些表示变成掩码预测任务,残差向量量化再把表示分成多级离散目标。三者的分工是:Best-RQ 解决起始监督,HuBERT 式流程解决从掩码语音学习语义表示,残差向量量化提供更细的多级预测目标;组合后,最终音频编码器不需要人工逐字标签,就能从大量无标注语音中学习可供 LLM 使用的表示。

PS:

  • Best-RQ 的核心思想是:不需要预训练教师模型,也不需要人工标签,通过随机投影和随机码本,就能将连续语音特征转换成离散 Token,作为模型学习的伪标签。
  • HuBERT(Hidden-Unit BERT)的核心思想是:先为语音生成离散伪标签,再遮挡输入语音的一部分,让模型根据未被遮挡的上下文预测被遮挡位置的离散标签。建模上下文中的声学和语义关联,迫使模型学习更强的上下文表示。
  • RVQ,即残差向量量化,核心思想是:不再使用一个码本对连续向量进行一次量化,而是使用多个码本逐级量化前一级未能表示的残差,从而实现多级离散编码。提高离散表示的表达容量。保留更细粒度的声学和语音信息。提供多个离散预测目标,丰富自监督训练信号。
无标注语音
   ↓
Bootstrap Encoder
   ↓
Best-RQ 量化中间表示
   ↓
离散伪标签
   ↓
Intermediate HuBERT
   ↓
残差向量量化 RVQ
   ↓
多级离散伪标签
   ↓
最终 Encoder
   ↓
遮蔽语音预测多级目标

3.2 音频适配器

音频适配器将编码器的声学表示映射到 Hy3 LLM 的输入嵌入空间,使连续音频表示能够与文本 token、提示词和上下文前缀处在同一个条件序列中。

3.3 外部上下文与音频条件热词检索

系统支持三种外部上下文:

  • Hotword list:明确给出专有名词、产品名、人名、地名等候选词。
  • Dialogue QA:先前轮次的问答历史,为当前语音提供对话语义。
  • Summary:对任务、会议或对话主题的摘要。

候选热词表可能很大,直接把所有词塞入 LLM 前缀会造成无关干扰和上下文浪费。因此热词检索模块同时观察音频表示和候选热词,只选择与当前音频相关的词,形成 retrieved hotwords。检索结果与摘要、对话 QA 一起编码成文本前缀,排在音频嵌入之前。

3.4 LLM 自回归转写

Hy3 LLM 根据外部上下文前缀、音频嵌入和此前已经生成的 token,自回归地产生转写:

\(P(y_{1:T}\mid x,c)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x,c)\)

其中 \(x\) 是音频表示,\(c\) 可以包含检索热词、摘要和历史对话。论文强调,句内上下文不是单独输入项:模型通过整段音频和已生成转写序列,自然利用语句其他位置的信息。

四、音频编码器的自监督训练

4.1 Best-RQ 启动编码器

第一步先用 Best-RQ 训练一个 bootstrap encoder。Best-RQ 通过随机投影量化产生离散目标,避免一开始就依赖高质量人工标签。训练完成后,从该编码器选定的中间层提取表示并量化,作为下一轮 HuBERT 的离散监督。

4.2 中间 HuBERT 与多级目标

用 bootstrap encoder 生成的离散标签训练中间 HuBERT 模型。然后再对这个 HuBERT 的表示应用残差向量量化(Residual Vector Quantization,RVQ),形成多级离散目标。RVQ 不只给一个 code,而是用多个残差量化层逐级逼近表示,因此最终编码器可以学习不同粒度的声学—语义结构。

4.3 最终编码器的掩码预测

最终音频编码器接收被遮蔽的语音输入,并预测 RVQ 产生的多层离散目标。这一流程与 HuBERT 的“先聚类/量化、再预测掩码位置伪标签”思想一致,但目标构建经历了 Best-RQ 启动、中间 HuBERT 和残差量化的迭代精炼。

4.4 编码器数据与两阶段配比

编码器使用数千万小时语音训练,主要为普通话和英语,也包含粤语与其他中文方言。论文没有公开精确小时数、数据集清单和各语言比例。

  1. 大规模预训练:先在宽泛的语音混合上训练,获取通用声学与语义表示。
  2. 持续预训练:重新平衡数据,提高中文方言占比,降低噪声录音和短语音的采样权重。

编码器训练还加强了掩码策略,并采用 utterance mixing,把不同语句混合,提升对干扰语音的鲁棒性。论文引用了相关混合方法,但没有给出混合概率、信噪比或具体增强参数。

五、大规模 ASR 预训练:数据如何获取与后处理

5.1 第一阶段:Web 级大规模预训练

第一阶段使用来自 Web 的数千万小时语音。如此大规模的数据不可能全部依赖人工转写,团队构建了多系统自动标注流水线:

  1. 多个不同 ASR 系统对同一音频独立生成候选转写;
  2. 使用 ROVER(Recognizer Output Voting Error Reduction)对多个候选进行对齐和投票;
  3. 对融合后的伪转写进行多阶段质量过滤,去除不可靠样本;
  4. 进行领域感知的数据平衡,避免高频领域过度占用训练容量;
  5. 进行数据压缩,删除冗余信息,把预算集中到更有信息量的样本。

ROVER 的核心思想是把多套识别结果对齐成词图/混淆网络,再根据系统投票选出更可信的 token 序列。给出了总体效果:经过平衡与压缩后,使用原始训练数据的 50% 就能获得更好的模型性能。这说明“规模”不是唯一变量,数据冗余、领域失衡和伪标签噪声同样重要。

5.2 第二阶段:定向持续预训练

第二阶段提高以下数据的比例:

  • 中文方言语音;
  • 上下文偏置/热词相关数据;
  • 困难声学条件下的语音。

这个阶段有两个目的:一是直接增强方言、上下文和噪声鲁棒性;二是让预训练分布更接近后续 SFT 数据。论文报告,经过这种分布对齐后,SFT 数据可缩减到原来的 1/10,同时保持模型性能,从而显著加快 SFT 实验迭代。

六、后训练:SFT、专家 RL、MOPD 与行为 RL

6.1 监督微调 SFT

SFT 重点提升方言、上下文偏置和困难声学场景,同时保持预训练阶段的通用 ASR 能力。训练数据也采用迭代自举:

  1. 持续改进自动转写流水线的各个标注组件;
  2. 每轮选择上一轮表现最好的 SFT 检查点作为教师;
  3. 教师为下一轮数据生成伪转写;
  4. 逐轮提高伪标签质量,并补充方言与其他困难场景的定向数据。

6.2 三个领域专家的强化学习

团队从同一个 SFT 检查点初始化三个独立专家:

  • 通用领域 ASR 专家;
  • 方言 ASR 专家;
  • 上下文偏置 ASR 专家。

分开训练可以减少通用准确率、方言行为和上下文关键词识别之间的梯度冲突。每个专家的奖励按领域特点设计,不仅考虑整体识别准确率,也考虑关键词识别和语句级转写流畅度。报告没有公开奖励函数的精确公式和各项权重。

6.3 多教师 On-Policy 蒸馏(MOPD)

三个专家最终需要合并为一个服务模型。MOPD 的流程是:学生先对每条语音生成自己的 on-policy 识别假设;根据样本领域,把该学生轨迹路由给对应专家;专家在学生实际访问的 token 前缀状态上提供 token 级分布监督。

\(\mathcal{L}_{\mathrm{MOPD}}=\mathbb{E}\left[\frac{1}{T}\sum_{t=1}^{T}D_{\mathrm{KL}}\left(\pi_{\theta}(\cdot\mid\mathbf{s}_t)\Vert\pi_{\phi_d}(\cdot\mid\mathbf{s}_t)\right)\right]\) \(T=|\hat{\mathbf{y}}|,\qquad \mathbf{s}_t=(\mathbf{x},\hat{\mathbf{y}}_{<t})\)

其中 \(\pi_{\theta}\) 是学生策略,\(\pi_{\phi_d}\) 是领域 \(d\) 对应的专家,\(\mathbf{x}\) 包含声学输入和可选上下文,\(\hat{\mathbf{y}}\) 是学生自己生成的序列。采用 on-policy 轨迹的好处是:专家监督发生在学生真实会遇到的状态上,而不是只在标准答案前缀上蒸馏,可缓解训练—推理状态分布不一致。

KL 的方向是学生到教师:

\(D_{\mathrm{KL}}(\pi_{\theta}\Vert\pi_{\phi_d})=\sum_{v}\pi_{\theta}(v\mid\mathbf{s}_t)\log\frac{\pi_{\theta}(v\mid\mathbf{s}_t)}{\pi_{\phi_d}(v\mid\mathbf{s}_t)}\)

6.4 Model-Behavior RL

最后阶段针对真实使用中发现的 hard cases 做行为强化,重点是必须依赖周围语义才能正确识别的关键词。这一阶段直接奖励上下文依赖的关键词识别和整句连贯、流畅的转写。它更接近产品反馈闭环:先发现线上困难行为,再构造定向强化样本,而不是只优化平均 CER/WER。

七、数据规模、获取与处理:

阶段论文披露的数据规模获取/处理方式未披露项
音频编码器自监督训练数千万小时普通话和英语为主,含粤语与其他方言;Best-RQ、HuBERT、RVQ、掩码预测;持续预训练重平衡精确小时数、来源清单、语言比例
ASR 大规模预训练数千万小时 Web 语音多 ASR 候选、ROVER 融合、多阶段过滤、领域平衡、数据压缩教师系统、过滤阈值、原始/保留小时数
定向持续预训练未给精确规模提高方言、上下文偏置、困难声学数据比例各类占比、训练步数
SFT可压缩到原规模的 1/10迭代教师伪标签,定向补充方言与困难场景原始规模、最终规模、人工/伪标签比例
专家 RL 与 MOPD未披露通用/方言/上下文三专家,领域路由蒸馏样本量、奖励权重、采样和训练超参数
Model-Behavior RL未披露来自真实使用的 hard cases,强调上下文关键词数据收集与隐私流程、规模、奖励公式

八、评测设置、对比系统与指标

对比系统包括 Qwen3 ASR Flash、FunASR Flash、Doubao ASR 2.0、Seed 2.0 Lite、StepAudio 3 ASR Max 和 Hy ASR 3.0 Preview。论文说明,这些系统名称与服务来自其技术报告或官方服务页面,但表中的数值是本研究自己的评测结果,不是从外部文档直接摘录的排行榜分数。

  • CER/WER:客观识别错误率,越低越好。
  • Target-keyword recall:目标关键词召回率,越高越好。
  • 人工方言指标:严格识别率、宽松识别率、格式合规率,越高越好。
  • 相对错误率下降:以最强非 Hy 对手为基准。
\(\mathrm{CER}=\frac{S+D+I}{N_{\mathrm{char}}},\qquad \mathrm{WER}=\frac{S+D+I}{N_{\mathrm{word}}}\) \(\mathrm{RERR}=\frac{E_{\mathrm{comp}}-E_{\mathrm{Hy}}}{E_{\mathrm{comp}}}\times100\%\)

其中 S、D、I 分别为替换、删除和插入。召回率或人工百分比之间的差异使用“百分点”,不使用相对错误率公式。

九、公开 ASR 基准

公开测试覆盖 AISHELL-1/2、AliMeeting、WenetSpeech、FLEURS、Common Voice、SpeechIO、LibriSpeech、GigaSpeech、TED-LIUM 3、VoxPopuli、MLS、WenetSpeech-Yue 和 KeSpeech。论文声称进行了严格去污染:训练中不包含评测语音,也不包含其音频或文本近重复。

聚合组Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
中文5.734.775.555.426.984.734.64
英文6.216.027.935.565.385.285.22
方言组合5.455.467.666.736.265.234.80

相对最强外部对手,三组分别约降低 2.7%、3.0% 和 11.9%;相对 Preview 分别约降低 1.9%、1.1% 和 8.2%。这些聚合提升并不意味着每个子集都第一。

9.1 普通话子集

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
AISHELL-12.121.011.902.031.401.211.37
AISHELL-2 Android/iOS/Mix2.70/2.59/2.552.16/1.91/2.142.67/2.55/2.692.68/2.75/2.782.30/2.20/2.352.02/2.03/2.102.05/2.02/1.98
AliMeeting Near/Far7.13/23.145.94/22.025.88/26.186.27/24.817.89/34.235.84/21.275.47/21.52
WenetSpeech Net/Meeting4.96/6.163.74/3.624.11/4.544.13/4.236.63/8.523.91/4.313.74/4.16
FLEURS-zh2.952.002.402.131.851.841.84
CommonVoice-zh4.414.105.614.545.004.524.49
SpeechIO Locked/Unlocked3.62/6.475.95/2.612.52/5.525.09/2.628.50/2.945.04/2.634.63/2.36

Hy ASR 3.0 的优势集中在 AISHELL-2 Mix、AliMeeting Near、SpeechIO Unlocked,并在 WenetSpeech test-net 与 FLEURS-zh 并列最佳。但 AISHELL-1、WenetSpeech Meeting、CommonVoice-zh 和 SpeechIO Locked 并非最好,说明总体聚合提升来自跨数据集平衡,而非全面碾压。

9.2 英文子集

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
LibriSpeech Clean/Other1.33/2.601.31/2.502.87/5.851.37/2.651.17/2.251.28/2.591.19/2.31
CommonVoice-en6.326.3114.186.817.215.535.48
FLEURS-en2.663.246.382.552.952.642.53
GigaSpeech Test9.159.969.589.439.688.278.27
TED-LIUM 33.003.393.183.042.482.502.44
VoxPopuli Test/Accented5.99/20.976.06/16.849.52/12.577.40/13.287.08/11.755.98/14.755.84/15.27
MLS Test-en3.874.577.273.543.853.993.69

Hy ASR 3.0 在 Common Voice、FLEURS、TED-LIUM 3、VoxPopuli 普通测试集上最好,并在 GigaSpeech 与 Preview 持平。但 LibriSpeech 两个子集仍由 StepAudio 领先;VoxPopuli accented 上 Hy ASR 3.0 为 15.27%,不仅落后 StepAudio 的 11.75%,还比 Preview 的 14.75% 更差,论文把带口音英语列为后续改进方向。

9.3 粤语与 KeSpeech

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
FLEURS-yue2.973.246.522.643.052.762.63
CommonVoice-yue4.674.985.846.285.903.493.56
WenetSpeech-Yue Short/Long6.51/8.585.73/9.019.48/11.338.27/10.777.09/9.865.38/9.345.00/9.05
KeSpeech4.514.335.125.685.395.173.77

Table 1 的“方言 4.80%”把四个粤语子集与 KeSpeech 合并。若只计算 FLEURS-yue、CommonVoice-yue、WenetSpeech-Yue Short/Long 四个粤语子集的非加权均值,Hy ASR 3.0 为 5.06%,Qwen3 为 5.68%,相对下降约 11.0%。KeSpeech 从 Preview 的 5.17% 降到 3.77%,相对下降 27.1%。

十、内部主语言基准

内部测试集来自真实业务数据,用来补充公开数据不能覆盖的实际分布。论文未公开数据规模、领域构成和采样方法。

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
普通话4.944.153.785.565.303.353.18
英语8.767.546.428.7810.685.785.50
粤语6.0019.407.497.907.004.924.81
代码切换8.805.306.496.376.904.354.20

Hy ASR 3.0 在四类内部测试中都最低,并全面优于 Preview。相对图 1 中所列最强外部对手,普通话、英语、粤语和代码切换分别给出约 15.9%、14.3%、19.8% 和 20.8% 的相对错误率下降。

十一、上下文利用

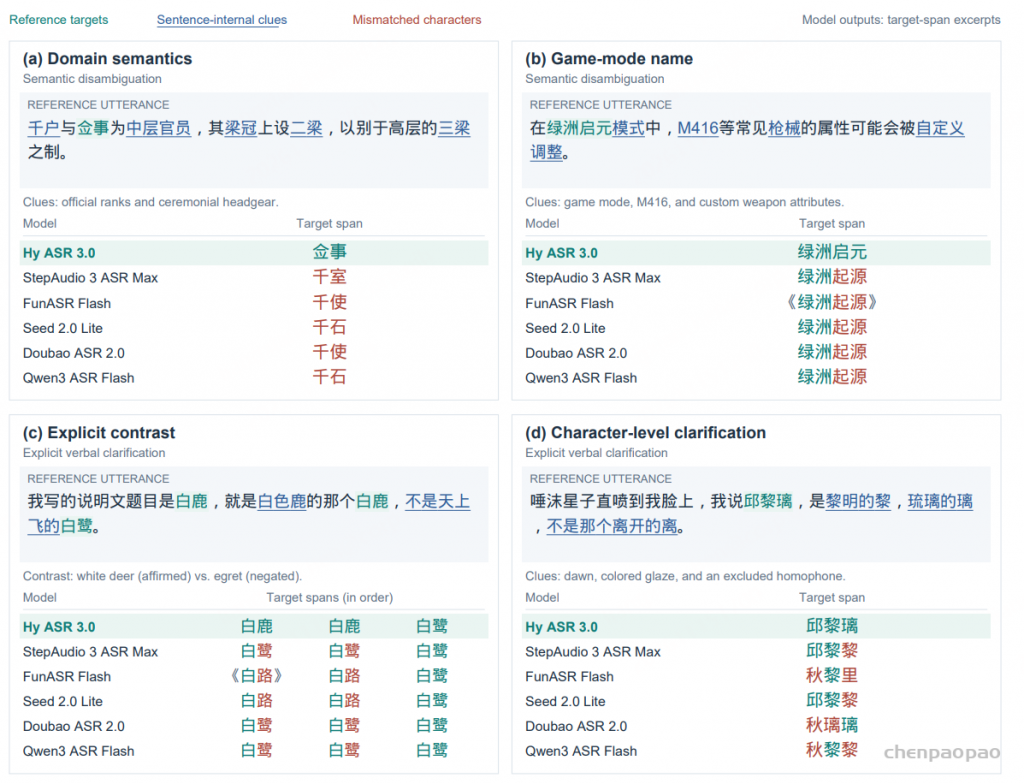
四个句内消歧案例。面板 (a)–(b) 为语义消歧,(c)–(d) 为显式口头澄清;所有线索都在当前语句内部。

11.1 四个定性案例

  • 历史官职:根据“负责太子中属官员、祭祀及礼仪”等语义,识别罕见官职名称,而其他模型输出近音常见词。
  • 游戏模式名:根据游戏、M416 和自定义调整等领域语义,选择正确的专名写法。
  • 显式对比:说话者明确说明“白鹿的鹿,不是白鹭的鹭”,模型需保留肯定项并排除否定同音词。
  • 逐字解释姓名:通过“哪个部首/哪个字”的解释区分姓名中相邻同音字;部分模型虽然转对了解释,却仍在姓名中重复同一个字。

这些案例证明输出与上下文线索一致,但它们只是定性示例,不是“关闭上下文/开启上下文”的受控消融。

11.2 关键词召回结果

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
句内上下文46.6051.1651.8654.6450.7558.1261.88
对话 QA 上下文71.6877.3378.4782.2069.3279.4483.94

相对最强非 Hy 对手 Seed 2.0 Lite,Hy ASR 3.0 分别提高 7.24 和 1.74 个百分点。需要再次强调,这是跨系统比较,不是同一模型有无上下文的消融,因此不能精确量化每种上下文模块的单独贡献。

十二、鲁棒性

测试集Qwen3FunASRDoubaoSeedStepAudioPreviewHy ASR 3.0
长音频3.863.985.604.993.582.962.35
儿童 + 老年人9.987.876.4310.499.907.186.25
低音量 + 噪声14.729.2715.7517.3143.028.487.49

相对最强非 Hy 对手,三项 CER 分别下降 34.4%、2.8% 和 19.2%。长音频和低音量/噪声的改进更明显。儿童与老年人被合并成一个测试集,因此 6.25% 不能证明模型分别在儿童和老年人子集都同样提升。

十三、方言识别与人工评测

许多方言缺乏统一书写标准,同一句口语可能有多个合理写法,传统 WER/CER 未必能公平衡量。论文对缺少标准正字法的方言采用翻译式表示,把口语内容转成更一致的书面表达。模型开发阶段使用 LLM judge 评估语义错误率和转写风格一致性,但最终以人工评测为准。

人工评测覆盖 13 个方言大类、91 个次区域变体,对比 FunASR Flash 与 Doubao ASR 2.0。指标含义如下:

  • 严格识别率:转写内容被判断为完全正确的比例。
  • 宽松识别率:允许不改变语义的措辞差异,判断语义正确的比例。
  • 格式合规率:没有标点、逆文本归一化(ITN)和流畅性问题的比例。

Hy ASR 3.0 的总体严格识别率为 64.7%,比 FunASR 高 2.8 个百分点、比 Doubao 高 12.5 个百分点;格式合规率为 80.3%,分别高 11.4 和 13.7 个百分点。宽松识别率高于 Doubao,但比 FunASR 低 1.0 个百分点。

分方言看,闽南语与粤语的严格识别率分别达到 70.3% 和 83.3%,比各自最强对手高 22.7 和 14.2 个百分点;但吴语三个指标都仍由 FunASR 领先,说明模型在不同地区变体上的能力并不均衡。

13 个方言类别在严格识别率、宽松识别率、格式合规率上的三张雷达图

十四、总结

Hy ASR 3.0 的主线不是提出一个单独的新网络层,而是构建一套大规模、分阶段的 LLM-ASR 训练体系:先用迭代 HuBERT 风格的离散目标训练强音频编码器,再用多系统 ROVER 伪标签和数据压缩做 Web 级预训练,随后用方言/上下文/困难声学数据持续预训练,通过迭代教师 SFT 提高监督质量,最后把通用、方言和上下文三个 RL 专家的能力用 MOPD 汇入一个学生,并对真实 hard cases 做行为强化。

从结果看,这套路线在聚合普通话、英语、粤语/方言、上下文关键词和实际鲁棒性上取得了较均衡的性能;真正值得关注的创新是“数据治理 + 上下文输入组织 + 领域专家 RL + on-policy 多教师蒸馏”的组合。它的主要不足则是复现信息不够完整、缺少模块级消融、内部评测不可公开验证,而且带口音英语和部分方言类别仍有明显提升空间。

Nemotron 3 Diarization 论文详解:面向 8 说话人的高精度、高吞吐流式说话人日志

论文:Nemotron 3 Diarization: Advancing the Accuracy-Efficiency Frontier in Streaming Speaker Diarization
作者:Ivan Medennikov、Taejin Park、Tatiana Timofeeva、He Huang、Alexander Polok、Sofia Kostandian、Weiqing Wang、Dongji Gao、Jagadeesh Balam、Boris Ginsburg
机构:NVIDIA、Brno University of Technology
arXiv:2611.12246v1
模型:nvidia/Nemotron-3-Diarization
官方博客:Know Who Spoke When

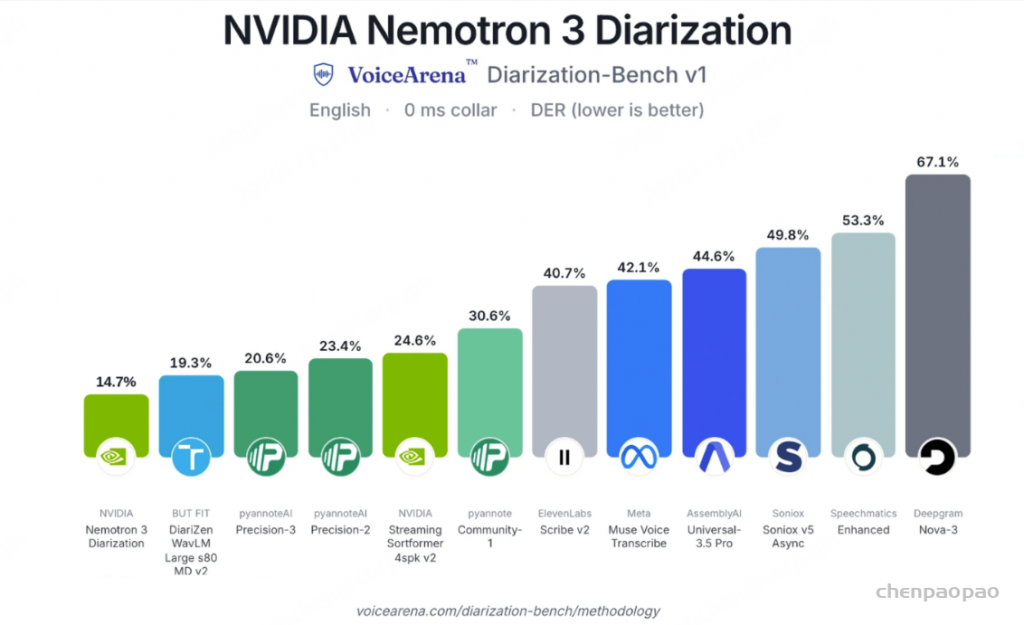
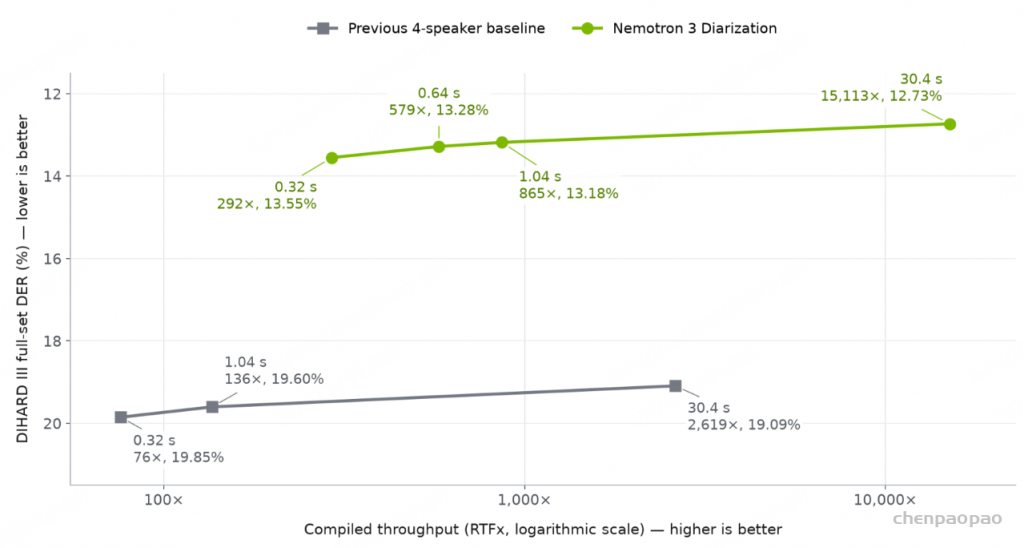
Nemotron 3 Diarization 是一个约 1 亿参数、最多支持 8 名说话人的开放权重说话人日志模型。它同时覆盖离线和流式推理:同一个检查点可以运行在 30.4 秒“离线式”输入缓冲,也可以运行在 1.04 秒、0.64 秒和 0.32 秒低延迟配置下。论文最核心的价值不只是把上一代 Streaming Sortformer 的上限从 4 人扩展到 8 人,而是在容量翻倍的同时,将参数量从 117M 降到约 99M/100M,并获得更低的 DER、更细的 10 ms 时间分辨率和最高约 6.4 倍的推理吞吐提升。需要区分的是:该任务识别的是“匿名说话人何时发言”,不是实名身份识别,也不是把重叠声源分离成独立波形。

一、先给结论:这项工作的核心贡献

  • 说话人容量:从上一代最多 4 人扩展到最多 8 个匿名说话人通道,输出通道按说话人首次出现顺序排列。
  • 骨干网络:用单一的 31 层 Transformer + RoPE,替换“17 层 FastConformer + 18 层 Transformer”的混合骨干;参数量由 117M 降至 99M 左右。
  • 高分辨率输出:编码器仍以 80 ms 步长运行,但通过宽度为 3 的一维子像素卷积,将表示学习式上采样 8 倍到 10 ms,兼顾边界精度和计算效率。
  • 流式记忆:Arrival-Order Speaker Cache(AOSC)从 188 帧扩容到 264 帧,并配合 FIFO 最近上下文,在分块处理中维持跨块说话人身份。
  • 新训练目标:增加 activity loss,学习静音、单人语音、重叠语音三类无排列活动;增加 phantom loss,抑制未使用通道中的“幽灵说话人”高置信激活。
  • 大规模数据:约 10,000 小时真实会话,加 82,611 小时模拟多说话人混合;其中约 5,000 小时为人工标注真实录音,约 5,000 小时为伪标签 YODAS-v2。
  • 两阶段训练:先只用模拟混合训练离线 Sortformer,再用真实与模拟数据联合进行流式 AOSC 微调。
  • 效果:在 DIHARD III、CALLHOME 上刷新论文所比较系统中的 DER;作为 DiCoW 的条件输入时,在 AMI 与 NOTSOFAR-1 的单麦条件上取得新的 tcpWER 最优结果。
  • 效率:相对相同设置下的旧 FastConformer 编码器,训练显存降低 2.8 倍、迭代速度提升 2.2 倍;推理端在部分配置达到约 6.4 倍吞吐提升。
  • 开放性:训练代码公开,权重使用 OpenMDW-1.1 许可,可用于商业或非商业场景,但实际部署仍需针对目标领域验证。
VoiceArena Diarization-Bench 排名图,Nemotron 3 Diarization 以 14.72% DER 排名第一。

二、任务背景:说话人日志究竟解决什么问题

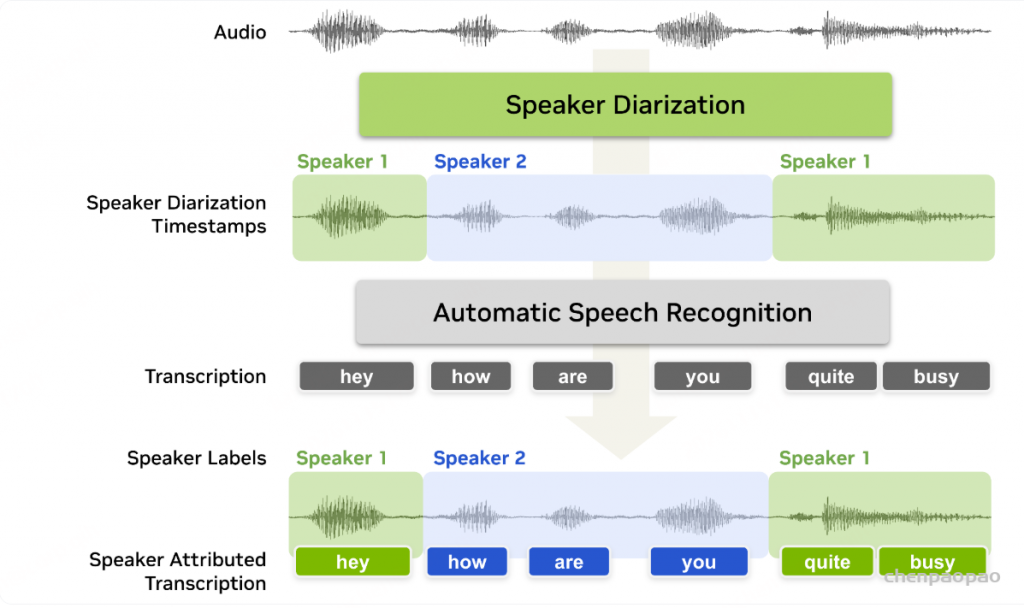
自动语音识别回答“说了什么”,说话人日志回答“谁在什么时候说话”。标准输出不是实名身份,而是一组匿名通道,例如 speaker_0、speaker_1,以及各自的起止时间。若两个人同时说话,同一时间帧可以有两个通道同时激活,因此该任务天然需要建模重叠语音。

传统流水线通常包含语音活动检测、分段、说话人嵌入、聚类和重叠处理。EEND(End-to-End Neural Diarization)则直接预测联合说话人活动。Sortformer 属于固定容量 EEND:模型提供固定数量的输出通道,并使用排列不变损失 PIL 与到达时间排序监督 ATS 解决说话人标签排列问题。Streaming Sortformer 又加入 AOSC,使说话人通道能够跨音频块保持一致。

上一代公开模型的主要限制是:最多 4 人、输出步长 80 ms、扩大缓存会增加推理成本,而且在大多数录音中,多余通道容易产生错误激活。Nemotron 3 Diarization 的设计目标因此是同时满足:更多说话人、更精细边界、低延迟、低显存、高吞吐和同一检查点覆盖多种上下文长度。

三、模型架构详解

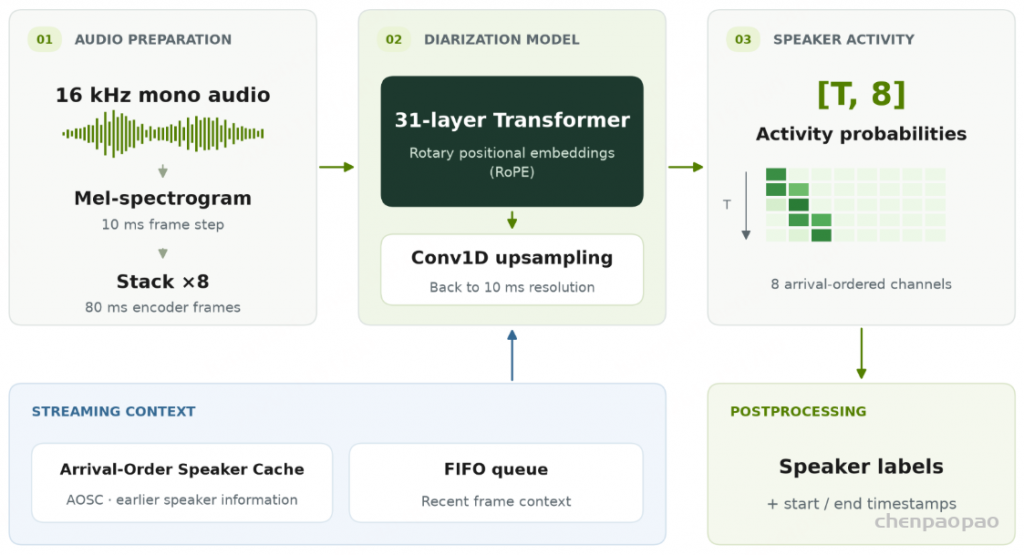
从 16 kHz 单通道音频到到达顺序说话人活动概率的整体流程,包含 10 ms Mel 特征、80 ms Transformer 编码、Conv1D 上采样、AOSC 与 FIFO。

3.1 输入与特征

  • 输入为 16 kHz、单通道音频;模型卡列出 WAV、FLAC、OPUS、MP3。
  • 音频被转换为 10 ms 步长的 Mel 频谱特征。
  • 连续 8 帧特征做 feature stacking,时间轴下采样 8 倍,因此编码器每帧对应 80 ms。
  • 分块推理没有固定的模型最大音频时长,但超长音频、严重噪声、强混响、远场和领域偏移仍可能造成性能下降。

3.2 31 层纯 Transformer 编码器

旧模型使用 17 层 FastConformer 后接 18 层 Transformer。新模型改为单一的 31 层 Transformer,并使用旋转位置编码 RoPE。论文给出两个动机:第一,纯 Transformer 的计算效率与扩展性更好;第二,AOSC 中缓存的说话人块不一定是连续时间序列,局部卷积可能跨“人工拼接的块边界”混合本不相邻的状态,而纯注意力骨干更适合这种缓存结构。参数量从 117M 降至 99M;

3.3 80 ms 编码、10 ms 输出:学习式子像素上采样

如果直接让 Transformer 在 10 ms 序列上运行,序列长度会增大 8 倍,注意力成本显著上升。论文的解决方案是在编码器之后添加一维子像素卷积:宽度为 3 的 Conv1D 将每个 H 维状态映射为 8H 个通道,再重排为 8 个连续的 H 维状态。

\(Z=\mathrm{Conv1D}_{k=3}(H_{80\mathrm{ms}}),\qquad Z\in\mathbb{R}^{T\times 8H}\) \(\mathrm{PixelShuffle}_{1D}:\mathbb{R}^{T\times 8H}\rightarrow\mathbb{R}^{8T\times H}\)

这样,重计算昂贵的编码器仍维持 80 ms 步长,输出头却能在 10 ms 分辨率下预测短说话轮次和精细边界。消融实验还表明,收益不仅来自评分时更细的时间网格:把 10 ms 预测下采样为 80 ms 后再评分,只损失约 0.61–0.67 DER;完全不使用上采样、直接以 80 ms 训练与预测,则损失约 2.03–2.27 DER。

3.4 到达顺序输出、AOSC 与 FIFO

模型的 8 个通道不是固定人物身份,而是按首次到达顺序编号:第一个出现的新声音进入 speaker_0,第二个进入 speaker_1,依次类推。该约束减少了每个音频块重新求解通道排列的需要。

  • AOSC:保存较早音频块中的说话人证据,并按到达顺序组织,负责长期身份一致性。
  • FIFO:保存当前块之前的最近帧,提供短期上下文。
  • Right context:当前块之后的一小段未来音频,有助于判断边界,但会增加输入缓冲延迟。
  • 缓存扩容:AOSC 容量由 188 帧增加到 264 帧,以支持 8 个说话人。
  • 可学习分隔:旧方案用平均静音嵌入分隔缓存中的说话人,新方案改为可学习嵌入。

模型默认输出形状为 [T, 8],每个值是相应说话人在该帧处于活动状态的概率。两个或更多通道可以同时为高概率,因此能够表示重叠语音。

\(P\in[0,1]^{T\times 8},\qquad P_{t,s}=P(\text{speaker }s\text{ active at frame }t\mid x)\)

四、训练数据:规模、来源与处理

4.1 总体规模

数据类别规模说明
人工标注真实录音约 5,000 小时多领域、多语言真实会话
伪标签真实录音约 5,000 小时YODAS-v2 多说话人子集
真实会话合计约 10,000 小时论文与模型卡一致
模拟多说话人混合82,611 小时(论文约写 82,600)1–8 人,每条 180–200 秒
用于生成模拟混合的单说话人源音频约 28,000 小时模型卡披露的原始源音频规模
NEST 自监督初始化900,000 小时Granary-v2 子集,用于预训练编码器初始化,不是日志监督数据

4.2 真实会话数据

公开语料包括 AISHELL-4、AliMeeting、AMI、CALLHOME Part 1、DIHARD III Development、DiPCo、DISPLACE-2024、DISPLACE-M、Fisher English、ICSI、NOTSOFAR-1 和 VoxConverse-v0.3。模型卡进一步明确了主要 split,例如 Fisher Training Part 1/2、AMI train/dev、AISHELL-4 train、AliMeeting train、NOTSOFAR-1 train/dev 等。

  • David AI:约 1,000 小时、3–4 名说话人的英文会话,授权使用。
  • YODAS-v2:5,000 小时多说话人子集;由 9 个 Sortformer 组成的集成系统生成伪标签,再用 DOVER-Lap 合并重叠感知的日志输出。
  • 语言范围:公开与授权数据覆盖英语、普通话、印地语、卡纳达语、泰卢固语、孟加拉语及其他多语言来源。

4.3 模拟混合数据与后处理

模拟数据使用 FastMSS 工具和论文所称的 “Mind the Gap” 协议生成。每条混合包含 1–8 名说话人,时长 180–200 秒。关键不是简单叠加音频,而是要控制说话轮次、停顿、重叠和声学增强,使合成会话更接近真实交互。

混合来源生成后的多说话人小时数
LibriSpeech6,694
AMI 头戴麦克风6,743
AliMeeting 头戴麦克风6,745
Fisher English6,755
David AI 英语36,458
David AI 多语言(21 种语言)19,216
合计82,611

David AI 英语模拟源来自约 22,000 小时授权音频;多语言模拟源来自约 2,000 小时、21 种语言的授权音频。模拟前使用 Montreal Forced Aligner 获得紧致的说话人活动区域,避免把转写片段内部的大段静音错误标成语音。模型卡还列出 MUSAN 噪声作为增强来源。

五、训练目标:PIL、ATS、Activity Loss 与 Phantom Loss

PIL 使用最佳目标说话人排列进行监督;ATS 则把目标通道按说话人首次出现时间排序。Nemotron 3 在这两个标准 Sortformer 目标之外增加两项辅助损失。

5.1 Activity Loss

一个独立辅助头从编码器表示预测三类无排列帧状态:静音、单说话人语音、重叠语音。该任务不需要知道具体是哪位说话人,因此能以更稳定的方式监督总体语音活动,并作为正则项改善主任务。

\(\mathcal{L}_{\mathrm{act}}=-\frac{1}{BT}\sum_{b=1}^{B}\sum_{t=1}^{T}\log q_{bt,c_{bt}},\qquad c_{bt}\in\{\text{silence},\text{single},\text{overlap}\}\)

5.2 Phantom Loss

当实际录音只有少数说话人时,8 个输出通道中的空通道可能出现高置信激活,形成“幽灵说话人”。对 PIL 与 ATS 对齐后都为空的通道,论文选出后验概率高于阈值的有效帧:

\(\mathcal{I}_{bs}=\{t:\operatorname{sg}(p_{bts})>\theta\}\)

其中 sg 表示 stop-gradient。每个被选中帧的非活动标签负对数似然为:

\(\ell_{bts}=-\log(1-p_{bts})\)

最终使用归一化 log-mean-exp 聚合:

\(\mathcal{L}_{\mathrm{ph}}=\frac{\tau}{BS}\sum_{b=1}^{B}\sum_{s=1}^{S}\log\left[\frac{1}{|\mathcal{I}_{bs}|}\sum_{t\in\mathcal{I}_{bs}}\exp\left(\frac{\ell_{bts}}{\tau}\right)\right]\)

论文设置 \(\theta=0.25\)、\(\tau=0.5\)、\(S=8\);若集合为空,该项贡献为 0。log-mean-exp 会更关注最大的错误激活,但不会让损失直接随选中帧数线性增长。

总目标可以按阶段写成加权和:

\(\mathcal{L}=\lambda_{\mathrm{PIL}}\mathcal{L}_{\mathrm{PIL}}+\lambda_{\mathrm{ATS}}\mathcal{L}_{\mathrm{ATS}}+\lambda_{\mathrm{act}}\mathcal{L}_{\mathrm{act}}+\lambda_{\mathrm{ph}}\mathcal{L}_{\mathrm{ph}}\)

六、两阶段训练流程

训练使用 NVIDIA NeMo Speech,在 64 张 NVIDIA A100-SXM4-80GB GPU 上完成,即 8 个节点、每节点 8 卡。精度模式为 bf16-mixed。

6.1 阶段一:离线 Sortformer 训练

  • 只使用模拟多说话人混合。
  • 编码器由 NEST Transformer 自监督检查点初始化;该检查点在 Granary-v2 的 900,000 小时子集上预训练。
  • 从完整录音中在线随机抽取 60 秒片段。
  • 损失权重:PIL=0.5、ATS=0.5、activity=0.5、phantom=0。
  • 此阶段保持原生 80 ms 输出,不使用上采样层。

6.2 阶段二:流式 AOSC 微调

  • 启用 AOSC,联合使用真实数据和模拟数据。
  • 训练样本长度为 105 秒。
  • 以 0.5 概率把同一源录音不同位置的两个片段拼接,以制造更复杂的长程说话人重新出现模式。
  • 采样偏向包含更多活跃说话人的样本。
  • 损失权重:PIL=0.75、ATS=0.25、activity=0.5、phantom=0.1。
  • 在此阶段加入上采样层,初始化为把每个编码器状态重复到 8 个输出位置,再与全模型联合训练 10 ms 目标。

6.3 Block-Causal Tail:让一个检查点覆盖多种延迟

为了防止模型在训练时过度依赖未来上下文,每个 batch 以 0.5 概率使用 block-causal tail。注意力掩码由双向前缀和随机尾部组成;尾部被切分为 1–8 帧的小块。块内双向注意,当前块可以看前缀和更早块,但不能看未来块。全上下文 batch 与这组可变掩码共同训练,使同一检查点能够适配离线和多种流式上下文长度。

6.4 SpecAugment

两个阶段都使用 SpecAugment:两条频率掩码,每条最多覆盖 24 个频率 bin。论文公开了 NeMo 的离线 8 说话人与流式 8 说话人 YAML 配置,可用于复现实验中的详细优化参数。

七、流式推理配置与延迟公式

所有流式参数都以 80 ms 编码器帧为单位。输入缓冲延迟只统计模型运行前必须等待的音频,不包含 GPU 计算、网络、ASR 和业务处理:

\(\mathrm{Latency}_{\mathrm{buffer}}=(\mathrm{CHUNK\_LEN}+\mathrm{RIGHT\_CONTEXT})\times 80\ \mathrm{ms}\)
配置输入缓冲延迟SPKCACHEFIFOCHUNKRIGHT CONTEXTUPDATE PERIOD
离线式30.4 s2644034040300
低延迟1.04 s26426494222
很低延迟0.64 s26426462222
超低延迟0.32 s26426431222

模型技术上可使用 80 ms 输入缓冲,但官方建议的最低配置是 0.32 秒。降低延迟通常会同时降低准确率和吞吐,因此产品选型不能只看缓冲长度。

八、评测数据、指标与可比性

评测集录音数说话人数条件边界容忍
DIHARD III Eval2591–911 个领域、多语言0 s
CALLHOME Part 22502–6电话语音、多语言0.25 s
AliMeeting Near/Far20 个会议、两种条件2–4近讲混合头戴麦、远场0 s
AMI MHM/SDM16 个会议、两种条件3–4混合头戴麦、单远场麦0 s
NOTSOFAR-1 MHM/SC160 个会议、两种条件3–7多麦混合、单通道0 s

合计为 901 个“条件特定”的录音条目。所有测试都计入重叠语音。AMI、AliMeeting 和 NOTSOFAR-1 使用强制对齐参考标签,而不是原始为转写设计的片段级标签。原因是原始片段可能把内部静音也标成语音,从而在帧级 DER 中夸大漏检。不同参考 RTTM、collar 和 overlap 设置会改变 DER,不能把不同协议下的数字直接比较。

DER 由漏检、误报和说话人混淆组成:

\(\mathrm{DER}=\frac{T_{\mathrm{Miss}}+T_{\mathrm{FA}}+T_{\mathrm{Conf}}}{T_{\mathrm{RefSpeaker}}}\)
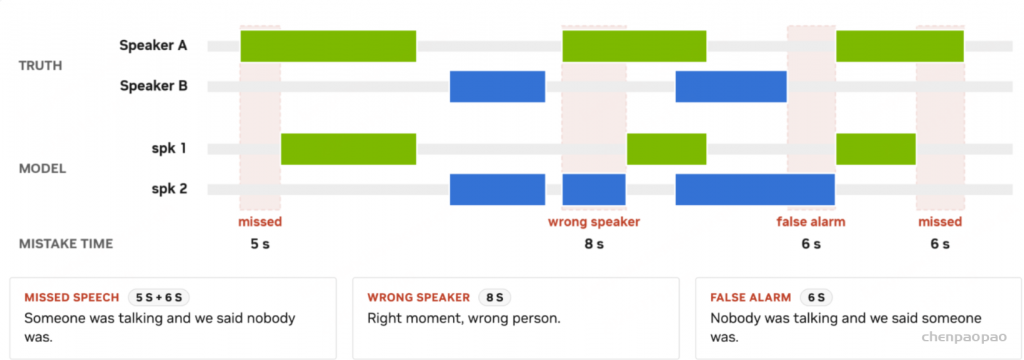
DER 中 Miss、False Alarm、Speaker Confusion 的构成示意。

九、核心 DER 结果(论文 Table 1)

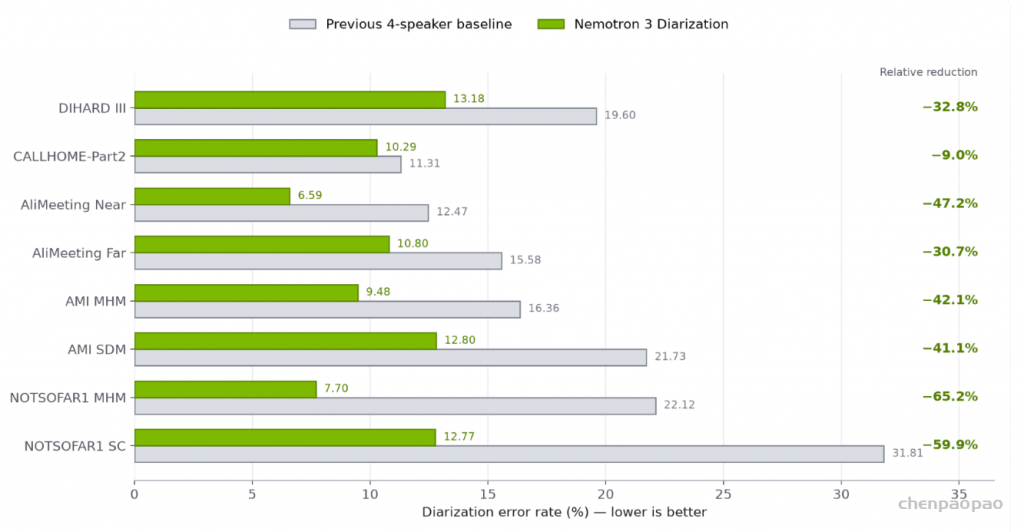
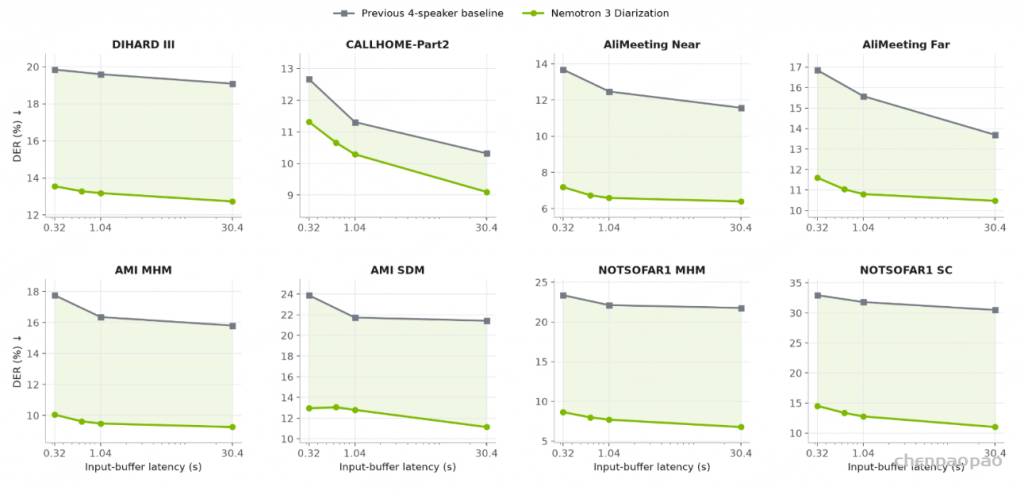
系统延迟DH3CHAli-NearAli-FarAMI-MHMAMI-SDMNSF1-MHMNSF1-SC
DiariZen离线14.5014.6816.7810.8*15.5613.9*14.2016.7*
Sortformer-v2.130.4 s19.0910.3211.5713.6915.8121.4221.7730.49
Nemotron 330.4 s12.739.106.4010.479.2511.146.7711.00
Sortformer-v2.11.04 s19.6011.3112.4715.5816.3621.7322.1231.81
Nemotron 31.04 s13.1810.296.5910.809.4812.807.7012.77
Sortformer-v2.10.32 s19.8512.6713.6816.8517.7723.8923.3732.95
Nemotron 30.32 s13.5511.327.1911.6010.0512.958.6514.53
* 使用原始/默认参考标注,而本文相应结果使用强制对齐标注,因此不能直接比较。

从 30.4 秒降到 0.32 秒,Nemotron 3 在各测试集上的 DER 只增加 0.79–3.53 个绝对百分点,表现出相对平滑的退化。所有三个共同延迟点上,它都在全部八种评测条件中优于 Sortformer-v2.1。论文据此正式宣称 DIHARD III 和 CALLHOME 达到新的 SOTA;对 AMI、AliMeeting、NOTSOFAR-1 则因参考标注协议不同而保持谨慎,没有做严格的跨论文 SOTA 声明。

图片占位

1.04 秒输入缓冲下八个条件的 DER 对比。
30.4、1.04、0.64、0.32 秒延迟下的完整 DER 曲线。
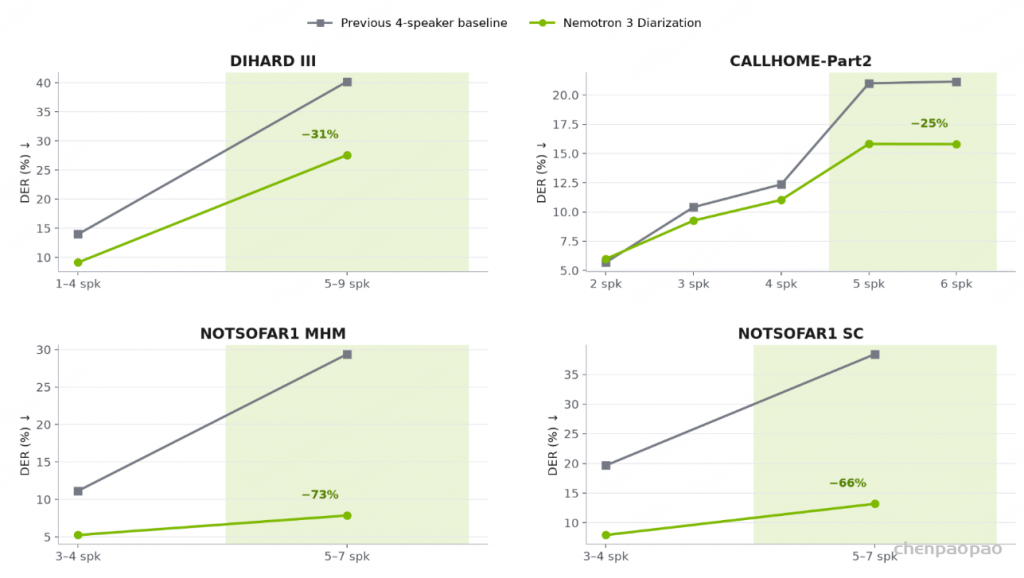
按说话人数拆分的 DER;阴影区域为超过 4 人的录音

十、训练与推理效率

训练侧,在 64 张 A100、bf16-mixed 下,纯 Transformer 相对相同设置的旧 FastConformer 编码器,显存消耗降低 2.8 倍、单步时间缩短 2.2 倍。

模型延迟Batch 1 eagerBatch 1 compiledBatch 32 eagerBatch 32 compiled
DiariZen离线20—44—
Sortformer-v2.130.4 s874146832042619
Nemotron 330.4 s134043851219615113
Sortformer-v2.11.04 s1642193136
Nemotron 31.04 s38164581865
Sortformer-v2.10.32 s82110176
Nemotron 30.32 s12.554199292
RTFx 越高越好。硬件为单张 NVIDIA RTX PRO 5000 Blackwell,BF16;compiled 使用 torch.compile,排除一次性编译和预热。

RTFx 定义为总音频时长除以总处理时间:

\(\mathrm{RTFx}=\frac{\text{total audio duration}}{\text{wall-clock processing time}}\)

30.4 秒、Batch 32 compiled 从 2619 提升到 15113,约 5.77 倍;1.04 秒从 136 提升到 865,约 6.36 倍。需要注意,这些是披露硬件上的批处理吞吐,不等于单路端到端应用延迟。

DIHARD III DER 与 Batch 32 compiled RTFx 的准确率—吞吐权衡。

十一、消融实验

系统变体30.4 s DER变化0.32 s DER变化
完整 Nemotron 310.42—12.06—
换回 FastConformer 编码器11.36+0.9413.33+1.27
无 NEST 初始化12.05+1.6314.28+2.22
10 ms 预测下采样到 80 ms 再评分11.09+0.6712.67+0.61
不使用上采样,原生 80 ms12.69+2.2714.09+2.03
无 phantom loss10.41-0.0112.15+0.09
无 activity loss11.42+1.0013.03+0.97
无 SpecAugment10.88+0.4612.47+0.41
无 block-causal tail10.50+0.0812.36+0.30
无模拟数据13.40+2.9815.21+3.15
无 David AI 数据11.19+0.7712.83+0.77
无 YODAS 数据10.81+0.3912.38+0.32
复合评测集,全局汇总、0 collar。每个消融只有一次训练运行,论文报告观察到的效应量,不声称统计显著性。

11.1 消融结论

  • 模拟数据最重要:移除后 DER 恶化 2.98/3.15,是最大退化,说明高质量合成会话对 EEND 至关重要。
  • NEST 初始化非常关键:无自监督初始化恶化 1.63/2.22,说明日志监督数据不足以从零学到同等稳健的声学表示。
  • 高分辨率训练不仅是评分优势:完全无上采样的退化远大于仅在评分前下采样,证明 10 ms 学习目标本身改善了模型。
  • Activity loss 稳定有效:两种延迟分别改善约 1.00 和 0.97 DER。
  • Phantom loss 的主收益不在 DER:移除后 DER 基本不变,但说话人数 MAE 从 0.157 升到 0.222(30.4 秒),从 0.270 升到 0.491(0.32 秒),说明它主要抑制过计数。
  • Block-causal tail 更利于极低延迟:30.4 秒只改善 0.08,但 0.32 秒改善 0.30。
  • 授权与伪标签数据都有增益:移除 David AI 在两种延迟都恶化 0.77;移除 YODAS 恶化 0.39/0.32。
  • 纯 Transformer 不只是更快:换回 FastConformer 后 DER 也明显恶化。

十二、下游多说话人 ASR

DER 高度依赖参考标注风格,因此论文进一步考察说话人日志是否真正改善带说话人归属的转写。指标使用 meeteval 的 tcpWER,默认 5 秒 collar 和 chime8 文本归一化。评测包括流式 Multitalker-Parakeet-v1(1.12 秒输入缓冲)与离线 DiCoW-v3.3-large。

ASR/日志条件AMI-MHMAMI-SDMNSF1-MHMNSF1-SC
流式 Multitalker-Parakeet-v1,1.12 s
Oracle 日志12.6617.7916.8626.34
Sortformer-v2.118.6434.1335.5951.35
Nemotron 3 hard13.8421.1818.6831.65
离线 DiCoW-v3.3-large,greedy
Oracle 日志11.7215.278.7815.45
DiariZen15.1719.3218.5725.63
Sortformer-v2.118.1730.1130.1442.56
Nemotron 3 hard12.6517.1910.4719.23
Nemotron 3 soft12.3517.0610.3018.95
此前 SOTA(09/2026)15.218.5N/A23.63

hard 表示分段级条件,soft 表示直接使用后验概率条件。Nemotron 3 的 soft 条件在四种条件下都进一步降低 tcpWER;论文称这是 DiCoW 中首次观察到一致的 soft-over-hard 增益。流式 Parakeet 结果同样显著优于旧 Sortformer,说明提升不仅是更贴合强制对齐标签,而是真正传递到了下游转写。

十三、限制、风险与正确解读

  • 最多 8 人:超过上限时,语音可能漏检或被错误合并到已有通道。DIHARD III 的 5–9 人分组甚至包含 9 人录音,已超出标称上限。
  • 匿名标签不是身份识别:speaker_2 不等于某个真实姓名。若要映射到身份,必须结合会议元数据、用户配置或说话人验证系统。
  • DER 协议敏感:参考 RTTM、collar、是否计重叠、VAD 来源都会改变结果。
  • 低延迟有代价:0.32 秒相较 30.4 秒存在稳定的准确率与吞吐下降;80 ms 虽可运行,但不是推荐配置。
  • 领域偏移:强噪声、混响、远场、极长会话和新领域会增加漏检、误报、混淆和边界错误。
  • ASR 对齐不是说话人分离:简单用单词中点匹配活跃说话人,遇到重叠时只能标为歧义,不能判断某个词究竟由哪位同时发言者说出。
  • 消融的统计限制:每个变体只有一次训练运行,小于约 0.1–0.3 的差异应谨慎解读。
  • 许可证与合规:权重使用 OpenMDW-1.1;生产系统仍需对目标数据、隐私、偏差、安全和行业要求进行完整验证。

十四、总结

Nemotron 3 Diarization 的技术路线非常清晰:通过纯 Transformer 和 80 ms 编码降低主干成本,用学习式上采样恢复 10 ms 边界精度;通过更大的 AOSC 和到达顺序监督扩展到 8 人;通过 activity loss、phantom loss、可变上下文掩码和大规模合成/伪标签数据,解决低延迟、多通道空置和真实监督不足的问题。最终,它同时改善了 DER、说话人数估计、下游 tcpWER、训练显存和推理吞吐,是一项较完整的“模型—数据—训练—系统”协同优化工作。

如果应用场景是会议、客服、播客、实时字幕或多说话人语音助手,这个模型尤其值得关注;但上线时应以目标音频重新评测,并把 0.32–30.4 秒的延迟配置视为产品级准确率—响应速度—吞吐三者之间的可调旋钮。