论文:Nemotron 3 Diarization: Advancing the Accuracy-Efficiency Frontier in Streaming Speaker Diarization
作者:Ivan Medennikov、Taejin Park、Tatiana Timofeeva、He Huang、Alexander Polok、Sofia Kostandian、Weiqing Wang、Dongji Gao、Jagadeesh Balam、Boris Ginsburg
机构:NVIDIA、Brno University of Technology
arXiv:2611.12246v1
模型:nvidia/Nemotron-3-Diarization
官方博客:Know Who Spoke When
Nemotron 3 Diarization 是一个约 1 亿参数、最多支持 8 名说话人的开放权重说话人日志模型。它同时覆盖离线和流式推理:同一个检查点可以运行在 30.4 秒“离线式”输入缓冲,也可以运行在 1.04 秒、0.64 秒和 0.32 秒低延迟配置下。论文最核心的价值不只是把上一代 Streaming Sortformer 的上限从 4 人扩展到 8 人,而是在容量翻倍的同时,将参数量从 117M 降到约 99M/100M,并获得更低的 DER、更细的 10 ms 时间分辨率和最高约 6.4 倍的推理吞吐提升。需要区分的是:该任务识别的是“匿名说话人何时发言”,不是实名身份识别,也不是把重叠声源分离成独立波形。
一、先给结论:这项工作的核心贡献
- 说话人容量:从上一代最多 4 人扩展到最多 8 个匿名说话人通道,输出通道按说话人首次出现顺序排列。
- 骨干网络:用单一的 31 层 Transformer + RoPE,替换“17 层 FastConformer + 18 层 Transformer”的混合骨干;参数量由 117M 降至 99M 左右。
- 高分辨率输出:编码器仍以 80 ms 步长运行,但通过宽度为 3 的一维子像素卷积,将表示学习式上采样 8 倍到 10 ms,兼顾边界精度和计算效率。
- 流式记忆:Arrival-Order Speaker Cache(AOSC)从 188 帧扩容到 264 帧,并配合 FIFO 最近上下文,在分块处理中维持跨块说话人身份。
- 新训练目标:增加 activity loss,学习静音、单人语音、重叠语音三类无排列活动;增加 phantom loss,抑制未使用通道中的“幽灵说话人”高置信激活。
- 大规模数据:约 10,000 小时真实会话,加 82,611 小时模拟多说话人混合;其中约 5,000 小时为人工标注真实录音,约 5,000 小时为伪标签 YODAS-v2。
- 两阶段训练:先只用模拟混合训练离线 Sortformer,再用真实与模拟数据联合进行流式 AOSC 微调。
- 效果:在 DIHARD III、CALLHOME 上刷新论文所比较系统中的 DER;作为 DiCoW 的条件输入时,在 AMI 与 NOTSOFAR-1 的单麦条件上取得新的 tcpWER 最优结果。
- 效率:相对相同设置下的旧 FastConformer 编码器,训练显存降低 2.8 倍、迭代速度提升 2.2 倍;推理端在部分配置达到约 6.4 倍吞吐提升。
- 开放性:训练代码公开,权重使用 OpenMDW-1.1 许可,可用于商业或非商业场景,但实际部署仍需针对目标领域验证。
二、任务背景:说话人日志究竟解决什么问题
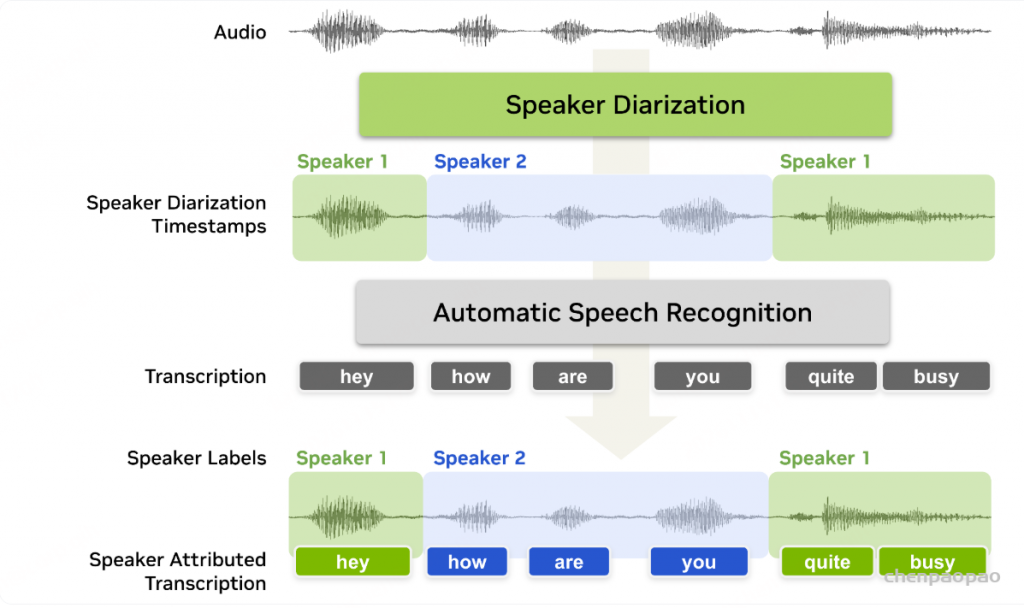
自动语音识别回答“说了什么”,说话人日志回答“谁在什么时候说话”。标准输出不是实名身份,而是一组匿名通道,例如 speaker_0、speaker_1,以及各自的起止时间。若两个人同时说话,同一时间帧可以有两个通道同时激活,因此该任务天然需要建模重叠语音。
传统流水线通常包含语音活动检测、分段、说话人嵌入、聚类和重叠处理。EEND(End-to-End Neural Diarization)则直接预测联合说话人活动。Sortformer 属于固定容量 EEND:模型提供固定数量的输出通道,并使用排列不变损失 PIL 与到达时间排序监督 ATS 解决说话人标签排列问题。Streaming Sortformer 又加入 AOSC,使说话人通道能够跨音频块保持一致。
上一代公开模型的主要限制是:最多 4 人、输出步长 80 ms、扩大缓存会增加推理成本,而且在大多数录音中,多余通道容易产生错误激活。Nemotron 3 Diarization 的设计目标因此是同时满足:更多说话人、更精细边界、低延迟、低显存、高吞吐和同一检查点覆盖多种上下文长度。
三、模型架构详解
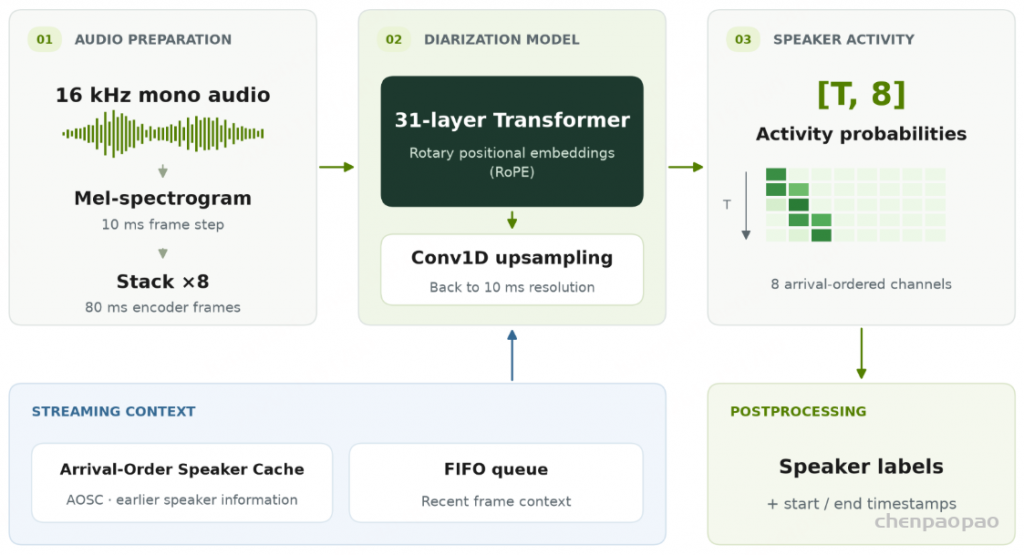
从 16 kHz 单通道音频到到达顺序说话人活动概率的整体流程,包含 10 ms Mel 特征、80 ms Transformer 编码、Conv1D 上采样、AOSC 与 FIFO。
3.1 输入与特征
- 输入为 16 kHz、单通道音频;模型卡列出 WAV、FLAC、OPUS、MP3。
- 音频被转换为 10 ms 步长的 Mel 频谱特征。
- 连续 8 帧特征做 feature stacking,时间轴下采样 8 倍,因此编码器每帧对应 80 ms。
- 分块推理没有固定的模型最大音频时长,但超长音频、严重噪声、强混响、远场和领域偏移仍可能造成性能下降。
3.2 31 层纯 Transformer 编码器
旧模型使用 17 层 FastConformer 后接 18 层 Transformer。新模型改为单一的 31 层 Transformer,并使用旋转位置编码 RoPE。论文给出两个动机:第一,纯 Transformer 的计算效率与扩展性更好;第二,AOSC 中缓存的说话人块不一定是连续时间序列,局部卷积可能跨“人工拼接的块边界”混合本不相邻的状态,而纯注意力骨干更适合这种缓存结构。参数量从 117M 降至 99M;
3.3 80 ms 编码、10 ms 输出:学习式子像素上采样
如果直接让 Transformer 在 10 ms 序列上运行,序列长度会增大 8 倍,注意力成本显著上升。论文的解决方案是在编码器之后添加一维子像素卷积:宽度为 3 的 Conv1D 将每个 H 维状态映射为 8H 个通道,再重排为 8 个连续的 H 维状态。
\(Z=\mathrm{Conv1D}_{k=3}(H_{80\mathrm{ms}}),\qquad Z\in\mathbb{R}^{T\times 8H}\) \(\mathrm{PixelShuffle}_{1D}:\mathbb{R}^{T\times 8H}\rightarrow\mathbb{R}^{8T\times H}\)这样,重计算昂贵的编码器仍维持 80 ms 步长,输出头却能在 10 ms 分辨率下预测短说话轮次和精细边界。消融实验还表明,收益不仅来自评分时更细的时间网格:把 10 ms 预测下采样为 80 ms 后再评分,只损失约 0.61–0.67 DER;完全不使用上采样、直接以 80 ms 训练与预测,则损失约 2.03–2.27 DER。
3.4 到达顺序输出、AOSC 与 FIFO
模型的 8 个通道不是固定人物身份,而是按首次到达顺序编号:第一个出现的新声音进入 speaker_0,第二个进入 speaker_1,依次类推。该约束减少了每个音频块重新求解通道排列的需要。
- AOSC:保存较早音频块中的说话人证据,并按到达顺序组织,负责长期身份一致性。
- FIFO:保存当前块之前的最近帧,提供短期上下文。
- Right context:当前块之后的一小段未来音频,有助于判断边界,但会增加输入缓冲延迟。
- 缓存扩容:AOSC 容量由 188 帧增加到 264 帧,以支持 8 个说话人。
- 可学习分隔:旧方案用平均静音嵌入分隔缓存中的说话人,新方案改为可学习嵌入。
模型默认输出形状为 [T, 8],每个值是相应说话人在该帧处于活动状态的概率。两个或更多通道可以同时为高概率,因此能够表示重叠语音。
\(P\in[0,1]^{T\times 8},\qquad P_{t,s}=P(\text{speaker }s\text{ active at frame }t\mid x)\)四、训练数据:规模、来源与处理
4.1 总体规模
| 数据类别 | 规模 | 说明 |
|---|---|---|
| 人工标注真实录音 | 约 5,000 小时 | 多领域、多语言真实会话 |
| 伪标签真实录音 | 约 5,000 小时 | YODAS-v2 多说话人子集 |
| 真实会话合计 | 约 10,000 小时 | 论文与模型卡一致 |
| 模拟多说话人混合 | 82,611 小时(论文约写 82,600) | 1–8 人,每条 180–200 秒 |
| 用于生成模拟混合的单说话人源音频 | 约 28,000 小时 | 模型卡披露的原始源音频规模 |
| NEST 自监督初始化 | 900,000 小时 | Granary-v2 子集,用于预训练编码器初始化,不是日志监督数据 |
4.2 真实会话数据
公开语料包括 AISHELL-4、AliMeeting、AMI、CALLHOME Part 1、DIHARD III Development、DiPCo、DISPLACE-2024、DISPLACE-M、Fisher English、ICSI、NOTSOFAR-1 和 VoxConverse-v0.3。模型卡进一步明确了主要 split,例如 Fisher Training Part 1/2、AMI train/dev、AISHELL-4 train、AliMeeting train、NOTSOFAR-1 train/dev 等。
- David AI:约 1,000 小时、3–4 名说话人的英文会话,授权使用。
- YODAS-v2:5,000 小时多说话人子集;由 9 个 Sortformer 组成的集成系统生成伪标签,再用 DOVER-Lap 合并重叠感知的日志输出。
- 语言范围:公开与授权数据覆盖英语、普通话、印地语、卡纳达语、泰卢固语、孟加拉语及其他多语言来源。
4.3 模拟混合数据与后处理
模拟数据使用 FastMSS 工具和论文所称的 “Mind the Gap” 协议生成。每条混合包含 1–8 名说话人,时长 180–200 秒。关键不是简单叠加音频,而是要控制说话轮次、停顿、重叠和声学增强,使合成会话更接近真实交互。
| 混合来源 | 生成后的多说话人小时数 |
|---|---|
| LibriSpeech | 6,694 |
| AMI 头戴麦克风 | 6,743 |
| AliMeeting 头戴麦克风 | 6,745 |
| Fisher English | 6,755 |
| David AI 英语 | 36,458 |
| David AI 多语言(21 种语言) | 19,216 |
| 合计 | 82,611 |
David AI 英语模拟源来自约 22,000 小时授权音频;多语言模拟源来自约 2,000 小时、21 种语言的授权音频。模拟前使用 Montreal Forced Aligner 获得紧致的说话人活动区域,避免把转写片段内部的大段静音错误标成语音。模型卡还列出 MUSAN 噪声作为增强来源。
五、训练目标:PIL、ATS、Activity Loss 与 Phantom Loss
PIL 使用最佳目标说话人排列进行监督;ATS 则把目标通道按说话人首次出现时间排序。Nemotron 3 在这两个标准 Sortformer 目标之外增加两项辅助损失。
5.1 Activity Loss
一个独立辅助头从编码器表示预测三类无排列帧状态:静音、单说话人语音、重叠语音。该任务不需要知道具体是哪位说话人,因此能以更稳定的方式监督总体语音活动,并作为正则项改善主任务。
\(\mathcal{L}_{\mathrm{act}}=-\frac{1}{BT}\sum_{b=1}^{B}\sum_{t=1}^{T}\log q_{bt,c_{bt}},\qquad c_{bt}\in\{\text{silence},\text{single},\text{overlap}\}\)5.2 Phantom Loss
当实际录音只有少数说话人时,8 个输出通道中的空通道可能出现高置信激活,形成“幽灵说话人”。对 PIL 与 ATS 对齐后都为空的通道,论文选出后验概率高于阈值的有效帧:
\(\mathcal{I}_{bs}=\{t:\operatorname{sg}(p_{bts})>\theta\}\)其中 sg 表示 stop-gradient。每个被选中帧的非活动标签负对数似然为:
\(\ell_{bts}=-\log(1-p_{bts})\)最终使用归一化 log-mean-exp 聚合:
\(\mathcal{L}_{\mathrm{ph}}=\frac{\tau}{BS}\sum_{b=1}^{B}\sum_{s=1}^{S}\log\left[\frac{1}{|\mathcal{I}_{bs}|}\sum_{t\in\mathcal{I}_{bs}}\exp\left(\frac{\ell_{bts}}{\tau}\right)\right]\)论文设置 \(\theta=0.25\)、\(\tau=0.5\)、\(S=8\);若集合为空,该项贡献为 0。log-mean-exp 会更关注最大的错误激活,但不会让损失直接随选中帧数线性增长。
总目标可以按阶段写成加权和:
\(\mathcal{L}=\lambda_{\mathrm{PIL}}\mathcal{L}_{\mathrm{PIL}}+\lambda_{\mathrm{ATS}}\mathcal{L}_{\mathrm{ATS}}+\lambda_{\mathrm{act}}\mathcal{L}_{\mathrm{act}}+\lambda_{\mathrm{ph}}\mathcal{L}_{\mathrm{ph}}\)六、两阶段训练流程
训练使用 NVIDIA NeMo Speech,在 64 张 NVIDIA A100-SXM4-80GB GPU 上完成,即 8 个节点、每节点 8 卡。精度模式为 bf16-mixed。
6.1 阶段一:离线 Sortformer 训练
- 只使用模拟多说话人混合。
- 编码器由 NEST Transformer 自监督检查点初始化;该检查点在 Granary-v2 的 900,000 小时子集上预训练。
- 从完整录音中在线随机抽取 60 秒片段。
- 损失权重:PIL=0.5、ATS=0.5、activity=0.5、phantom=0。
- 此阶段保持原生 80 ms 输出,不使用上采样层。
6.2 阶段二:流式 AOSC 微调
- 启用 AOSC,联合使用真实数据和模拟数据。
- 训练样本长度为 105 秒。
- 以 0.5 概率把同一源录音不同位置的两个片段拼接,以制造更复杂的长程说话人重新出现模式。
- 采样偏向包含更多活跃说话人的样本。
- 损失权重:PIL=0.75、ATS=0.25、activity=0.5、phantom=0.1。
- 在此阶段加入上采样层,初始化为把每个编码器状态重复到 8 个输出位置,再与全模型联合训练 10 ms 目标。
6.3 Block-Causal Tail:让一个检查点覆盖多种延迟
为了防止模型在训练时过度依赖未来上下文,每个 batch 以 0.5 概率使用 block-causal tail。注意力掩码由双向前缀和随机尾部组成;尾部被切分为 1–8 帧的小块。块内双向注意,当前块可以看前缀和更早块,但不能看未来块。全上下文 batch 与这组可变掩码共同训练,使同一检查点能够适配离线和多种流式上下文长度。
6.4 SpecAugment
两个阶段都使用 SpecAugment:两条频率掩码,每条最多覆盖 24 个频率 bin。论文公开了 NeMo 的离线 8 说话人与流式 8 说话人 YAML 配置,可用于复现实验中的详细优化参数。
七、流式推理配置与延迟公式
所有流式参数都以 80 ms 编码器帧为单位。输入缓冲延迟只统计模型运行前必须等待的音频,不包含 GPU 计算、网络、ASR 和业务处理:
\(\mathrm{Latency}_{\mathrm{buffer}}=(\mathrm{CHUNK\_LEN}+\mathrm{RIGHT\_CONTEXT})\times 80\ \mathrm{ms}\)| 配置 | 输入缓冲延迟 | SPKCACHE | FIFO | CHUNK | RIGHT CONTEXT | UPDATE PERIOD |
|---|---|---|---|---|---|---|
| 离线式 | 30.4 s | 264 | 40 | 340 | 40 | 300 |
| 低延迟 | 1.04 s | 264 | 264 | 9 | 4 | 222 |
| 很低延迟 | 0.64 s | 264 | 264 | 6 | 2 | 222 |
| 超低延迟 | 0.32 s | 264 | 264 | 3 | 1 | 222 |
模型技术上可使用 80 ms 输入缓冲,但官方建议的最低配置是 0.32 秒。降低延迟通常会同时降低准确率和吞吐,因此产品选型不能只看缓冲长度。
八、评测数据、指标与可比性
| 评测集 | 录音数 | 说话人数 | 条件 | 边界容忍 |
|---|---|---|---|---|
| DIHARD III Eval | 259 | 1–9 | 11 个领域、多语言 | 0 s |
| CALLHOME Part 2 | 250 | 2–6 | 电话语音、多语言 | 0.25 s |
| AliMeeting Near/Far | 20 个会议、两种条件 | 2–4 | 近讲混合头戴麦、远场 | 0 s |
| AMI MHM/SDM | 16 个会议、两种条件 | 3–4 | 混合头戴麦、单远场麦 | 0 s |
| NOTSOFAR-1 MHM/SC | 160 个会议、两种条件 | 3–7 | 多麦混合、单通道 | 0 s |
合计为 901 个“条件特定”的录音条目。所有测试都计入重叠语音。AMI、AliMeeting 和 NOTSOFAR-1 使用强制对齐参考标签,而不是原始为转写设计的片段级标签。原因是原始片段可能把内部静音也标成语音,从而在帧级 DER 中夸大漏检。不同参考 RTTM、collar 和 overlap 设置会改变 DER,不能把不同协议下的数字直接比较。
DER 由漏检、误报和说话人混淆组成:
\(\mathrm{DER}=\frac{T_{\mathrm{Miss}}+T_{\mathrm{FA}}+T_{\mathrm{Conf}}}{T_{\mathrm{RefSpeaker}}}\)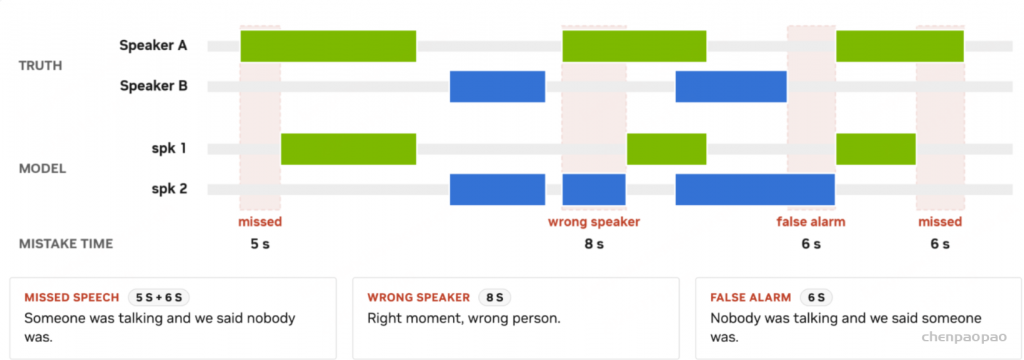
九、核心 DER 结果(论文 Table 1)
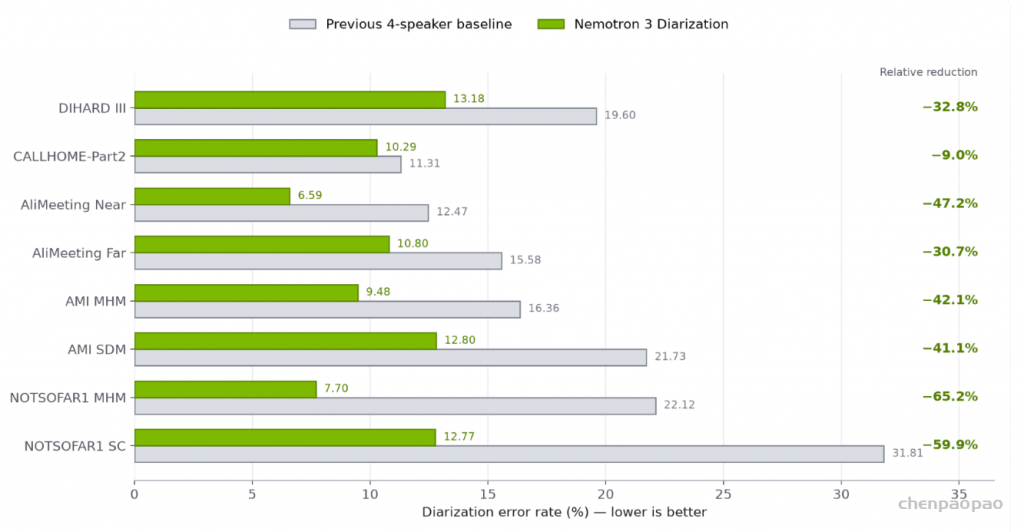
| 系统 | 延迟 | DH3 | CH | Ali-Near | Ali-Far | AMI-MHM | AMI-SDM | NSF1-MHM | NSF1-SC |
|---|---|---|---|---|---|---|---|---|---|
| DiariZen | 离线 | 14.50 | 14.68 | 16.78 | 10.8* | 15.56 | 13.9* | 14.20 | 16.7* |
| Sortformer-v2.1 | 30.4 s | 19.09 | 10.32 | 11.57 | 13.69 | 15.81 | 21.42 | 21.77 | 30.49 |
| Nemotron 3 | 30.4 s | 12.73 | 9.10 | 6.40 | 10.47 | 9.25 | 11.14 | 6.77 | 11.00 |
| Sortformer-v2.1 | 1.04 s | 19.60 | 11.31 | 12.47 | 15.58 | 16.36 | 21.73 | 22.12 | 31.81 |
| Nemotron 3 | 1.04 s | 13.18 | 10.29 | 6.59 | 10.80 | 9.48 | 12.80 | 7.70 | 12.77 |
| Sortformer-v2.1 | 0.32 s | 19.85 | 12.67 | 13.68 | 16.85 | 17.77 | 23.89 | 23.37 | 32.95 |
| Nemotron 3 | 0.32 s | 13.55 | 11.32 | 7.19 | 11.60 | 10.05 | 12.95 | 8.65 | 14.53 |
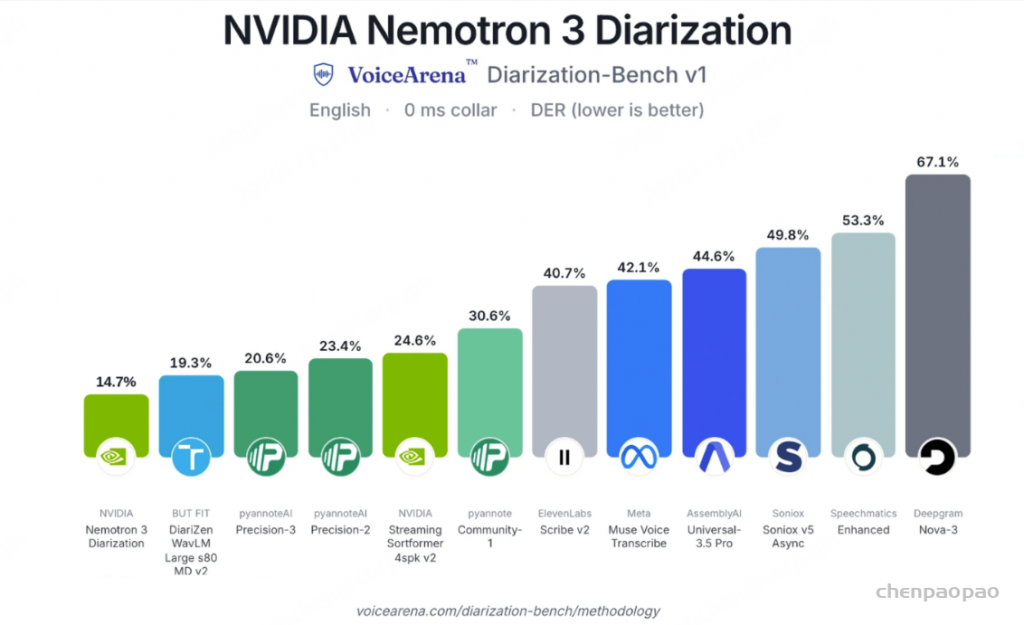
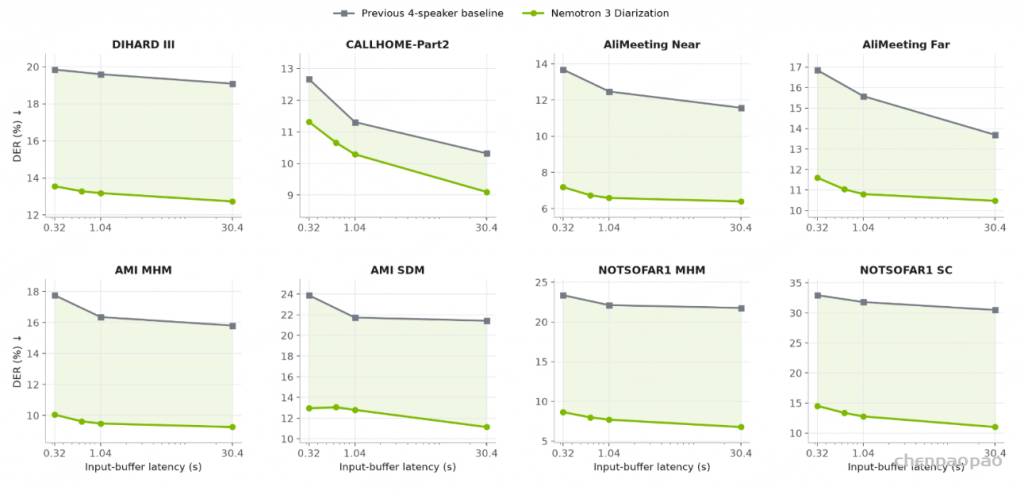
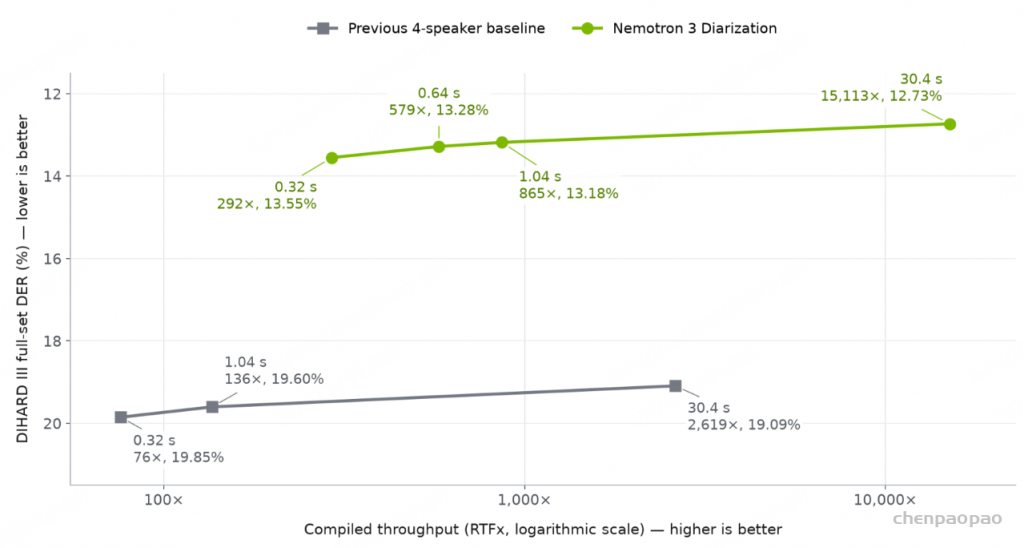
从 30.4 秒降到 0.32 秒,Nemotron 3 在各测试集上的 DER 只增加 0.79–3.53 个绝对百分点,表现出相对平滑的退化。所有三个共同延迟点上,它都在全部八种评测条件中优于 Sortformer-v2.1。论文据此正式宣称 DIHARD III 和 CALLHOME 达到新的 SOTA;对 AMI、AliMeeting、NOTSOFAR-1 则因参考标注协议不同而保持谨慎,没有做严格的跨论文 SOTA 声明。
图片占位
十、训练与推理效率
训练侧,在 64 张 A100、bf16-mixed 下,纯 Transformer 相对相同设置的旧 FastConformer 编码器,显存消耗降低 2.8 倍、单步时间缩短 2.2 倍。
| 模型 | 延迟 | Batch 1 eager | Batch 1 compiled | Batch 32 eager | Batch 32 compiled |
|---|---|---|---|---|---|
| DiariZen | 离线 | 20 | — | 44 | — |
| Sortformer-v2.1 | 30.4 s | 874 | 1468 | 3204 | 2619 |
| Nemotron 3 | 30.4 s | 1340 | 4385 | 12196 | 15113 |
| Sortformer-v2.1 | 1.04 s | 16 | 42 | 193 | 136 |
| Nemotron 3 | 1.04 s | 38 | 164 | 581 | 865 |
| Sortformer-v2.1 | 0.32 s | 8 | 21 | 101 | 76 |
| Nemotron 3 | 0.32 s | 12.5 | 54 | 199 | 292 |
RTFx 定义为总音频时长除以总处理时间:
\(\mathrm{RTFx}=\frac{\text{total audio duration}}{\text{wall-clock processing time}}\)30.4 秒、Batch 32 compiled 从 2619 提升到 15113,约 5.77 倍;1.04 秒从 136 提升到 865,约 6.36 倍。需要注意,这些是披露硬件上的批处理吞吐,不等于单路端到端应用延迟。
十一、消融实验
| 系统变体 | 30.4 s DER | 变化 | 0.32 s DER | 变化 |
|---|---|---|---|---|
| 完整 Nemotron 3 | 10.42 | — | 12.06 | — |
| 换回 FastConformer 编码器 | 11.36 | +0.94 | 13.33 | +1.27 |
| 无 NEST 初始化 | 12.05 | +1.63 | 14.28 | +2.22 |
| 10 ms 预测下采样到 80 ms 再评分 | 11.09 | +0.67 | 12.67 | +0.61 |
| 不使用上采样,原生 80 ms | 12.69 | +2.27 | 14.09 | +2.03 |
| 无 phantom loss | 10.41 | -0.01 | 12.15 | +0.09 |
| 无 activity loss | 11.42 | +1.00 | 13.03 | +0.97 |
| 无 SpecAugment | 10.88 | +0.46 | 12.47 | +0.41 |
| 无 block-causal tail | 10.50 | +0.08 | 12.36 | +0.30 |
| 无模拟数据 | 13.40 | +2.98 | 15.21 | +3.15 |
| 无 David AI 数据 | 11.19 | +0.77 | 12.83 | +0.77 |
| 无 YODAS 数据 | 10.81 | +0.39 | 12.38 | +0.32 |
11.1 消融结论
- 模拟数据最重要:移除后 DER 恶化 2.98/3.15,是最大退化,说明高质量合成会话对 EEND 至关重要。
- NEST 初始化非常关键:无自监督初始化恶化 1.63/2.22,说明日志监督数据不足以从零学到同等稳健的声学表示。
- 高分辨率训练不仅是评分优势:完全无上采样的退化远大于仅在评分前下采样,证明 10 ms 学习目标本身改善了模型。
- Activity loss 稳定有效:两种延迟分别改善约 1.00 和 0.97 DER。
- Phantom loss 的主收益不在 DER:移除后 DER 基本不变,但说话人数 MAE 从 0.157 升到 0.222(30.4 秒),从 0.270 升到 0.491(0.32 秒),说明它主要抑制过计数。
- Block-causal tail 更利于极低延迟:30.4 秒只改善 0.08,但 0.32 秒改善 0.30。
- 授权与伪标签数据都有增益:移除 David AI 在两种延迟都恶化 0.77;移除 YODAS 恶化 0.39/0.32。
- 纯 Transformer 不只是更快:换回 FastConformer 后 DER 也明显恶化。
十二、下游多说话人 ASR
DER 高度依赖参考标注风格,因此论文进一步考察说话人日志是否真正改善带说话人归属的转写。指标使用 meeteval 的 tcpWER,默认 5 秒 collar 和 chime8 文本归一化。评测包括流式 Multitalker-Parakeet-v1(1.12 秒输入缓冲)与离线 DiCoW-v3.3-large。
| ASR/日志条件 | AMI-MHM | AMI-SDM | NSF1-MHM | NSF1-SC |
|---|---|---|---|---|
| 流式 Multitalker-Parakeet-v1,1.12 s | ||||
| Oracle 日志 | 12.66 | 17.79 | 16.86 | 26.34 |
| Sortformer-v2.1 | 18.64 | 34.13 | 35.59 | 51.35 |
| Nemotron 3 hard | 13.84 | 21.18 | 18.68 | 31.65 |
| 离线 DiCoW-v3.3-large,greedy | ||||
| Oracle 日志 | 11.72 | 15.27 | 8.78 | 15.45 |
| DiariZen | 15.17 | 19.32 | 18.57 | 25.63 |
| Sortformer-v2.1 | 18.17 | 30.11 | 30.14 | 42.56 |
| Nemotron 3 hard | 12.65 | 17.19 | 10.47 | 19.23 |
| Nemotron 3 soft | 12.35 | 17.06 | 10.30 | 18.95 |
| 此前 SOTA(09/2026) | 15.2 | 18.5 | N/A | 23.63 |
hard 表示分段级条件,soft 表示直接使用后验概率条件。Nemotron 3 的 soft 条件在四种条件下都进一步降低 tcpWER;论文称这是 DiCoW 中首次观察到一致的 soft-over-hard 增益。流式 Parakeet 结果同样显著优于旧 Sortformer,说明提升不仅是更贴合强制对齐标签,而是真正传递到了下游转写。
十三、限制、风险与正确解读
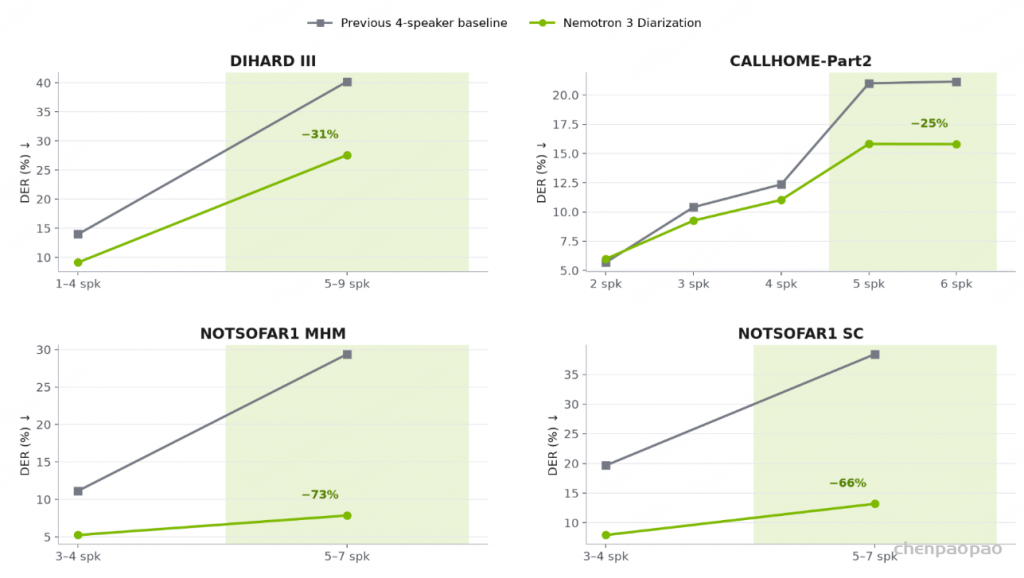
- 最多 8 人:超过上限时,语音可能漏检或被错误合并到已有通道。DIHARD III 的 5–9 人分组甚至包含 9 人录音,已超出标称上限。
- 匿名标签不是身份识别:speaker_2 不等于某个真实姓名。若要映射到身份,必须结合会议元数据、用户配置或说话人验证系统。
- DER 协议敏感:参考 RTTM、collar、是否计重叠、VAD 来源都会改变结果。
- 低延迟有代价:0.32 秒相较 30.4 秒存在稳定的准确率与吞吐下降;80 ms 虽可运行,但不是推荐配置。
- 领域偏移:强噪声、混响、远场、极长会话和新领域会增加漏检、误报、混淆和边界错误。
- ASR 对齐不是说话人分离:简单用单词中点匹配活跃说话人,遇到重叠时只能标为歧义,不能判断某个词究竟由哪位同时发言者说出。
- 消融的统计限制:每个变体只有一次训练运行,小于约 0.1–0.3 的差异应谨慎解读。
- 许可证与合规:权重使用 OpenMDW-1.1;生产系统仍需对目标数据、隐私、偏差、安全和行业要求进行完整验证。
十四、总结
Nemotron 3 Diarization 的技术路线非常清晰:通过纯 Transformer 和 80 ms 编码降低主干成本,用学习式上采样恢复 10 ms 边界精度;通过更大的 AOSC 和到达顺序监督扩展到 8 人;通过 activity loss、phantom loss、可变上下文掩码和大规模合成/伪标签数据,解决低延迟、多通道空置和真实监督不足的问题。最终,它同时改善了 DER、说话人数估计、下游 tcpWER、训练显存和推理吞吐,是一项较完整的“模型—数据—训练—系统”协同优化工作。
如果应用场景是会议、客服、播客、实时字幕或多说话人语音助手,这个模型尤其值得关注;但上线时应以目标音频重新评测,并把 0.32–30.4 秒的延迟配置视为产品级准确率—响应速度—吞吐三者之间的可调旋钮。