摘要:流式 ASR 的难点不只是“尽快识别”,还包括决定哪些文字已经足够可靠、可以提交给字幕、翻译或语音智能体,以及哪些内容应该继续等待。网易有道开源的 Confucius4-R2T2(Real Real-Time Transcription)以 Qwen3-ASR-1.7B 为基础,通过 Longest Stable Prefix(LSP,最长稳定前缀)学习和显式 Wait token,把“何时输出”变成模型训练目标。模型只追加已经提交的前缀,不回改已发布文本,同时通过 chunk size 和暂留 token 数 U 调整质量与延迟。
- Confucius4-R2T2 技术报告:https://arxiv.org/abs/2611.06043
- Confucius4-R2T2 开源项目:https://github.com/netease-youdao/Confucius4-R2T2
- Confucius4-R2T2 模型权重:https://huggingface.co/netease-youdao/Confucius4-R2T2
- Confucius4-R2T2 GGUF:https://huggingface.co/netease-youdao/Confucius4-R2T2-GGUF
一、流式 ASR 为什么会“闪烁”
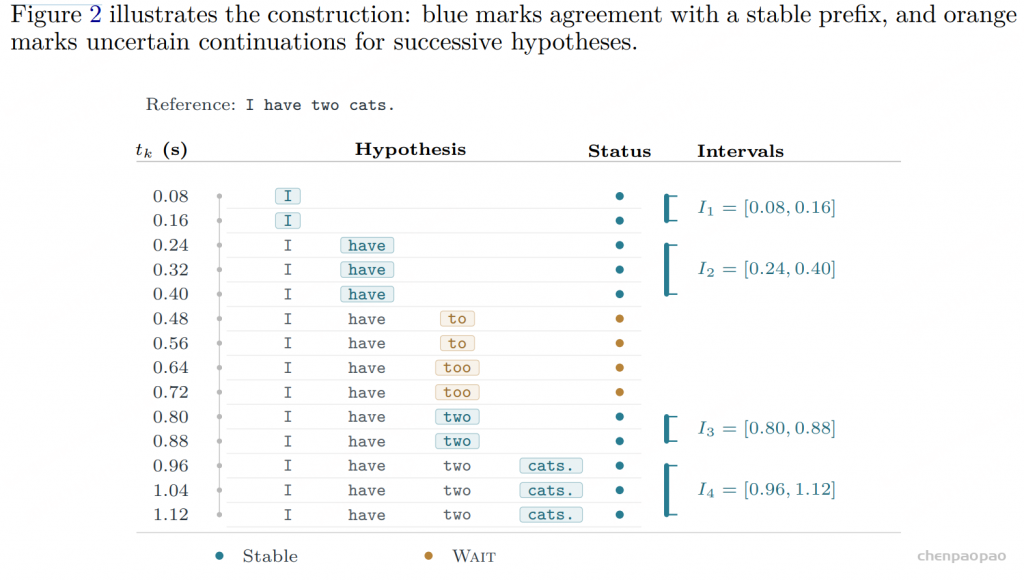
离线 ASR 可以等待完整语句,再利用完整上下文生成结果;流式 ASR 只能根据当前已经收到的声音逐步输出。比如用户说 I have two cats,系统可能先输出 I have to,随后变成 I have too,最后才确定为 I have two cats。对人类字幕来说这是文字闪烁,对下游系统来说则可能导致翻译、检索、工具调用或 LLM 推理重复执行。
R2T2 要求所有时刻的对外输出满足前缀单调性:如果 yt 是时间 t 的已发布文本,那么任意更晚时刻 t’ 都必须满足:
\(y_t\preceq y_{t’}\)也就是说,后续文本只能在末尾追加,不能修改早先已经发布的字符或 token。
二、R2T2 的核心定位
- 基础模型:Qwen3-ASR-1.7B。
- 后训练数据:约 1,500 小时中英文语音,约 600,000 条样本,中文和英文各 300,000 条。
- 训练组件:冻结音频编码器和 projector,只训练语言解码器。
- 架构变化:不增加预测头,不做因果化编码器,不使用额外的因果 attention mask。
- 流式 chunk:支持 80 ms 到 2 s;主实验使用 160 ms。
- 输出策略:稳定前缀只追加;不稳定的尾部由 Wait 或内部暂留机制处理。
- 部署形态:支持 vLLM、Transformers 离线推理、llama.cpp 和 WebSocket 流式服务。
R2T2 的思想不是把基础模型完全改造成因果 ASR,而是保留全上下文模型的声学能力,再让解码器学习在不完整音频下做“提交/等待”决策。
三、基础架构:Qwen3-ASR-1.7B 上只改解码器
Qwen3-ASR-1.7B 由 Qwen3-1.7B 语言模型、音频 projector 和 AuT 音频编码器组成。AuT 编码器约 300M 参数,隐藏维度 1,024,对 128 维 log-Mel/Fbank 特征进行 8 倍 CNN 下采样,输出约每 80 ms 一个音频位置,即 12.5 Hz。
| 模块 | R2T2 处理 | 原因 |
|---|---|---|
| 音频编码器 | 冻结 | 保留预训练的双向声学表示 |
| Projector | 冻结 | 保持声学表示到语言模型输入空间的映射 |
| 语言解码器 | 训练 | 学习 LSP 内容、Wait 和发射时机 |
| 额外预测头 | 不增加 | Wait 与文本 token 共用词表 |
| 因果化编码器 | 不做 | 保留双向注意力和全上下文识别能力 |
这种设计的代价是活动窗口在新音频到达时仍需重新编码;收益是避免重新训练因果编码器和重新建立完整的声学-文字对齐。
四、Longest Stable Prefix(LSP)是什么
常规 ASR 训练只有“音频-完整转写”配对,并没有标注模型在某个中间时刻可以提交到哪里。R2T2 先让基础模型逐步读取音频前缀,再用模型完整听完音频后的输出作为锚点。
设完整音频为 x,同一模型听完整音频得到:
\(\bar y=M(x)\)只听到时间 t 的音频前缀时,模型输出:
\(y_t=M(x_{\le t})\)LSP 定义为:在此前已经产生的完整输出中,最长的、同时也是完整输出 \bar y 的前缀:
\(L_t=\operatorname{LSP}(M,x,t)=\bar y_{1:m_t}\) \(m_t=\max_{j\le t}n_j\mathbf{1}[y_j\preceq\bar y],\qquad n_j=|y_j|\)这里的关键是“完整输出过”。如果某次模型输出 I have too,不能把它人工截成 I have 当成一条新的 LSP;只有模型此前完整输出过 I have,它才具有 model-admissible 性。
4.1 为什么 LSP 会单调增长
随着更多音频到达,已经确认的 LSP 只会保持不变或变长,不会缩短。最终完整音频时,LSP 等于模型完整输出。它的稳定性不是来自“把当前结果截掉几个词”,而是来自对模型历史输出的严格筛选。
需要特别注意,LSP 锚定的是模型自己的完整音频输出,不是人工参考文本。因此 LSP 主要负责稳定性与提交时机;模型听完整音频仍然识别错误时,LSP 也可能忠实地稳定输出错误内容,准确率必须另用 WER/CER 评估。
五、Wait 标签:把“继续输出”与“先等待”分开
研究者每隔 80 ms 把更长的音频前缀送入教师模型,记录输出等于 LSP 的稳定区间。连续稳定端点合并为:
\(I_i=[s_i,e_i]\)训练时随机选择切点 t,只保留 x≤t,模拟在线识别。如果切点位于稳定区间,则目标是稳定前缀;如果切点落在稳定区间之间,则目标是在 LSP 后面追加 Wait:
Wait 是普通词表中的一个特殊 token,不是额外的二分类头。模型因此同时学习:
| 学习目标 | 问题 | 输出 |
|---|---|---|
| 内容决策 | 现在可以提交哪些文字 | 文本 token |
| 时机决策 | 当前信息是否足够 | Wait token |
这也是 R2T2 与“把当前截断音频强行完整转写”的重要区别:R2T2 的目标是预测当前条件下最终转写的安全前缀,而不是猜测截断句子的完整尾部。
六、Streamability:选择适合流式改造的基础模型
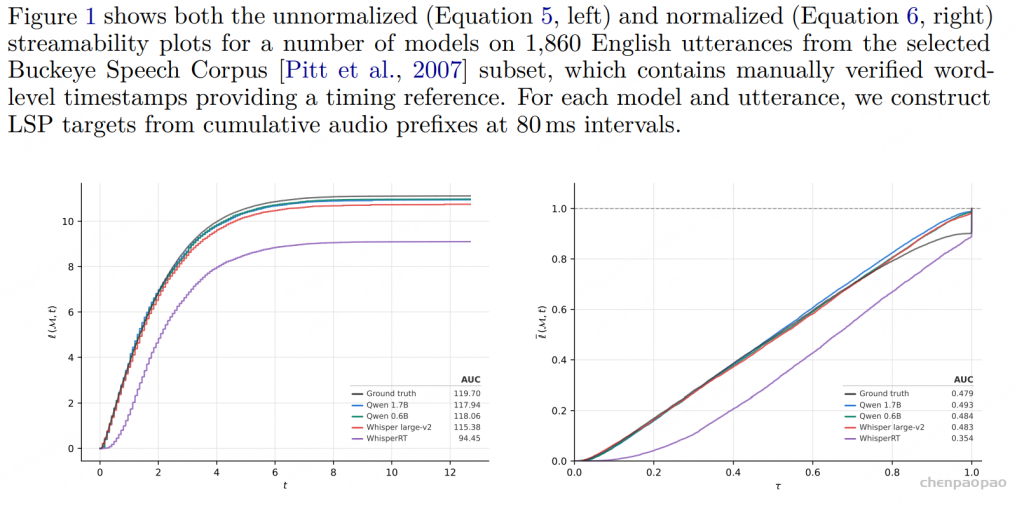
streamability 衡量模型在音频逐渐到达时,LSP 增长得有多快。对每个时刻,先统计平均 LSP 长度:
\(l(M,t)=\frac{1}{|N(t)|}\sum_{x\in N(t)}|LSP(M,x,t)|\)还可以将音频进度和 LSP 长度归一化:
\(\tau_{x,t}=\frac{t}{|x|},\qquad\bar l_{x,t}=\frac{|LSP(M,x,t)|}{|M(x)|}\)再对归一化曲线求面积:
\(s(M)=AUC(\bar l(M,\tau))\)在 1,860 条 Buckeye 英语语句上,Qwen3-ASR-1.7B 的归一化 streamability 为 0.493,在比较模型中最高。它表示这个基础模型更容易从完整上下文转换成稳定前缀流式模型,不等于真实设备上的端到端延迟。
七、训练数据与增强
| 项目 | 配置 |
|---|---|
| 数据规模 | 约 1,500 小时、600,000 条中英文语音 |
| 语言比例 | 中文 300,000 条,英文 300,000 条 |
| 公开数据 | SFT 和 GRPO 不使用公开训练数据,评测集不进入后训练 |
| 特征 | 10 ms Fbank hop,128 维 log-Mel |
| 编码器帧间隔 | 80 ms,12.5 Hz |
| 噪声 SNR | 10-35 dB |
| 纯噪声替换 | 10% |
| 混合噪声 | 30% 条件概率 |
| 混响 | 40%,其中 90% 真实 RIR、10% 模拟 RIR |
| 语言标签翻转 | 10% |
增强针对流式 ASR 的实际失败模式:纯噪声或无语音时的幻觉、噪声和混响下的识别退化、语言标签错误导致的语言跑偏,以及短音频前缀导致的过早续写。语言标签翻转让模型更依赖实际声学内容,而不是无条件相信提示。
八、两阶段后训练:SFT + GRPO
8.1 SFT
SFT 使用 LSP 转写和 Wait 目标的交叉熵。训练 1 个 epoch,Fused AdamW,初始学习率 1e-5,2% warmup 后线性衰减,有效全局 batch size 为 64;只更新语言解码器,音频编码器和 projector 冻结,LoRA 不启用。
- 10% 样本使用完整 utterance 和完整转写,保持离线识别能力。
- 90% 样本随机取音频前缀。
- 前缀切点中,50% 位于 LSP 稳定区间,学习输出稳定文字。
- 另外 50% 位于稳定区间之间,学习输出 LSP + Wait。
- 音频注意力窗口随机取 1-8 秒,窗口内保持双向注意力。
8.2 GRPO
GRPO 从 SFT 模型开始,对每个 prompt 采样多个流式轨迹,使用组内相对奖励优化质量和等待行为。轨迹可以跨越 1、2 或 4 个流式 turn,使模型接受更多音频后仍能被评估。
| 奖励项 | 权重 | 主要作用 |
|---|---|---|
| CER | 0.300 | 主要字符级识别信号 |
| Precision | 0.150 | 惩罚错误插入 |
| Length | 0.150 | 惩罚过长续写 |
| Repetition | 0.125 | 抑制重复字符和重复片段 |
| Language Consistency | 0.150 | 保持中文/拉丁字符构成与目标一致 |
| Tail | 0.050 | 惩罚稳定区间内的尾部冗余 |
| Word Accuracy | 0.050 | 评价稳定区间内局部词/字准确性 |
| Cut Marker | 0.025 | 监督 Wait 是否存在以及位置是否正确 |
加权奖励经过空输出、精确匹配和退化输出等特殊规则后,使用:
\(R(y_t,y_t^*)=\tanh(3R_{raw}(y_t,y_t^*))\)这些奖励共同抑制:没有足够声音时继续编造、重复输出、语言跑偏、把 Wait 放在文本中间、在稳定区间外输出未经支持的尾部。论文指出,单个奖励分量的独立作用仍需要受控消融,不能把全部收益归因于某一个奖励。
九、流式推理的四项优化
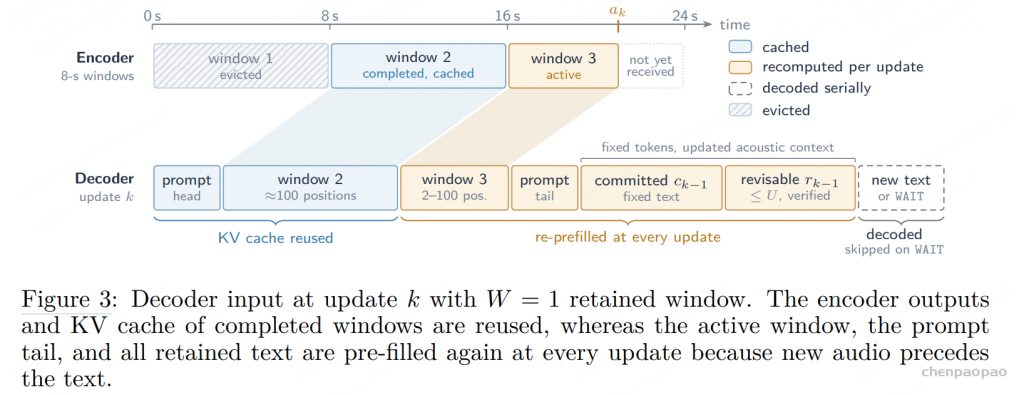
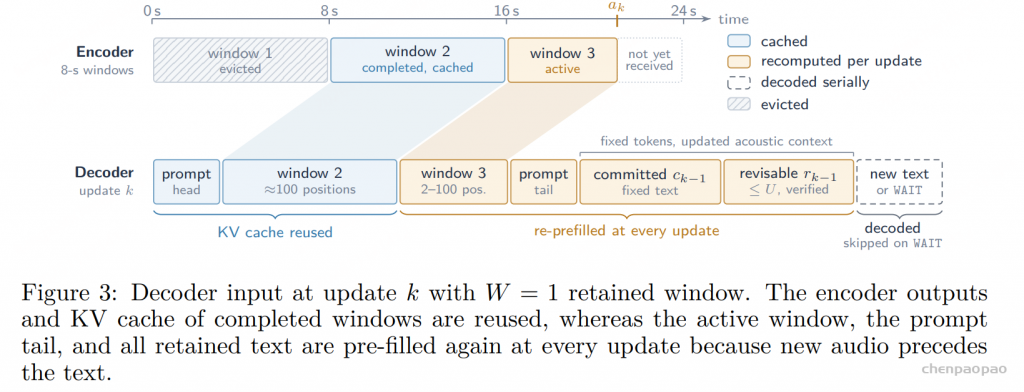
编码器每 80 ms 产生一个位置;主实验使用 160 ms chunk,因此每条流每秒约更新 6.25 次。为了让每次更新及时完成,R2T2 使用四项优化。
9.1 编码器缓存
推理时使用不重叠的 8 秒窗口。完整窗口的编码结果不再依赖未来音频,可以缓存;每次只重新编码正在增长的活动窗口。活动窗口最多约 100 个 80 ms 位置。
9.2 Wait 终止解码
每轮 pre-fill 后的第一个预测就是当前动作。如果预测为 Wait,本轮立即结束,不再执行串行 token 解码;如果不是 Wait,才继续生成,直到遇到 Wait 或 EOS。静音或信息不足的更新因此只需要一次 pre-fill。
9.3 有界上下文
只缓存完成窗口仍会让上下文不断变长。R2T2 只保留最近 W 个完成窗口和当前活动窗口,驱逐更早窗口及其之前已经提交的文本。上下文上限为:
\(8(W+1)\text{ 秒}\)主实验使用 W=1,相当于一个最近完成窗口加一个活动窗口,约 16 秒音频上下文。
9.4 Pre-fill verification
当 U>0 时,上次生成但尚未提交的最后 U 个 token 作为可变后缀。新音频到达后,pre-fill 已经计算主模型在这些位置的新预测。系统保留与新预测一致的最长前缀,在第一个分歧处截断 KV cache,用新 token 替换,再继续解码。这相当于把暂留后缀当作 draft,用主模型 pre-fill 做局部核验;已经提交的前缀永远不回改。
十、U 参数:质量优先还是延迟优先
| 配置 | 含义 | 典型取舍 |
|---|---|---|
| U=0 | 不额外暂留 token | 延迟更低,错误率略高 |
| U=1 | 最后一个 token 暂留内部 | 质量优先,等待少量更多上下文 |
| U=5 | 暂留最后五个 token | 基础模型 2 s 参考配置,延迟更高 |
U 不代表固定毫秒数。同一个 token 在不同语言、语速和 BPE 分词下对应的音频时长不同。它是“暂留 token 数”的控制旋钮,而不是严格的时间延迟参数。
十一、实验结果:流式质量接近离线模型
| 配置 | 13 个测试集宏平均错误率 | 解释 |
|---|---|---|
| 基础模型,完整音频 | 5.15% | 离线全上下文参考 |
| 基础模型,2 s,U=5 | 5.25% | 准确率参考,发射更晚 |
| 基础模型,160 ms,U=1 | 21.01% | 小 chunk 下明显退化 |
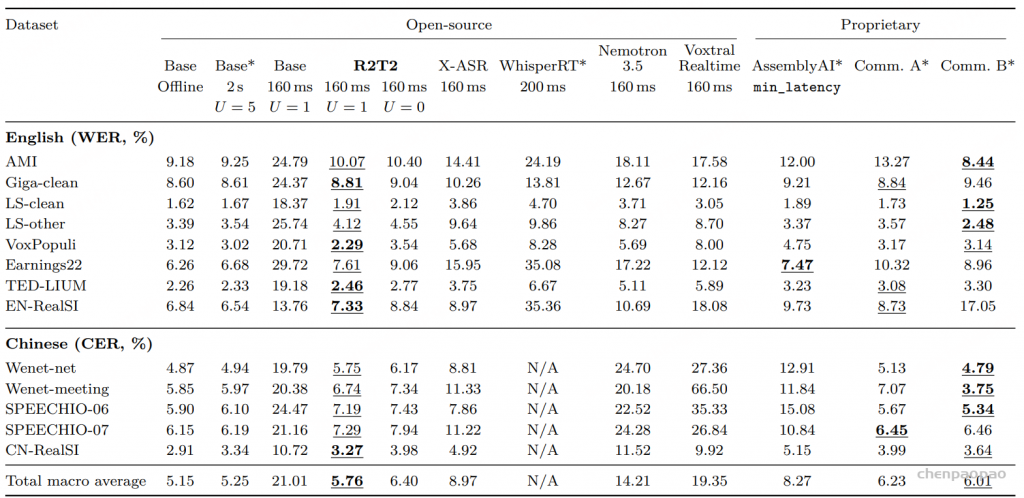
| R2T2,160 ms,U=1 | 5.76% | 质量优先 |
| R2T2,160 ms,U=0 | 6.40% | 延迟优先 |
| X-ASR,160 ms | 8.97% | 开源对比配置 |
| AssemblyAI,160 ms | 8.27% | 商业 API 对比 |
| Commercial A,160 ms | 6.23% | 商业 API 对比 |
| Commercial B,160 ms | 6.01% | 商业 API 对比 |
160 ms、U=1 时,R2T2 在表中列出的全部中英文测试集上优于基础模型同条件配置,宏平均错误率从 21.01% 降到 5.76%,相对下降约 72.6%。与基础模型完整音频的 5.15% 相比,仅差约 0.61 个百分点。R2T2 在纳入排名的流式配置中取得最低综合错误率,但并非每个单独测试集都超过所有商业系统。
评测集包含英文 AMI、Giga-clean、LibriSpeech、VoxPopuli、Earnings22、TED-LIUM、EN-RealSI,以及中文 Wenet-net、Wenet-meeting、SPEECHIO-06、SPEECHIO-07、CN-RealSI。英文使用 WER,中文使用 CER,每个数据集等权计算宏平均。
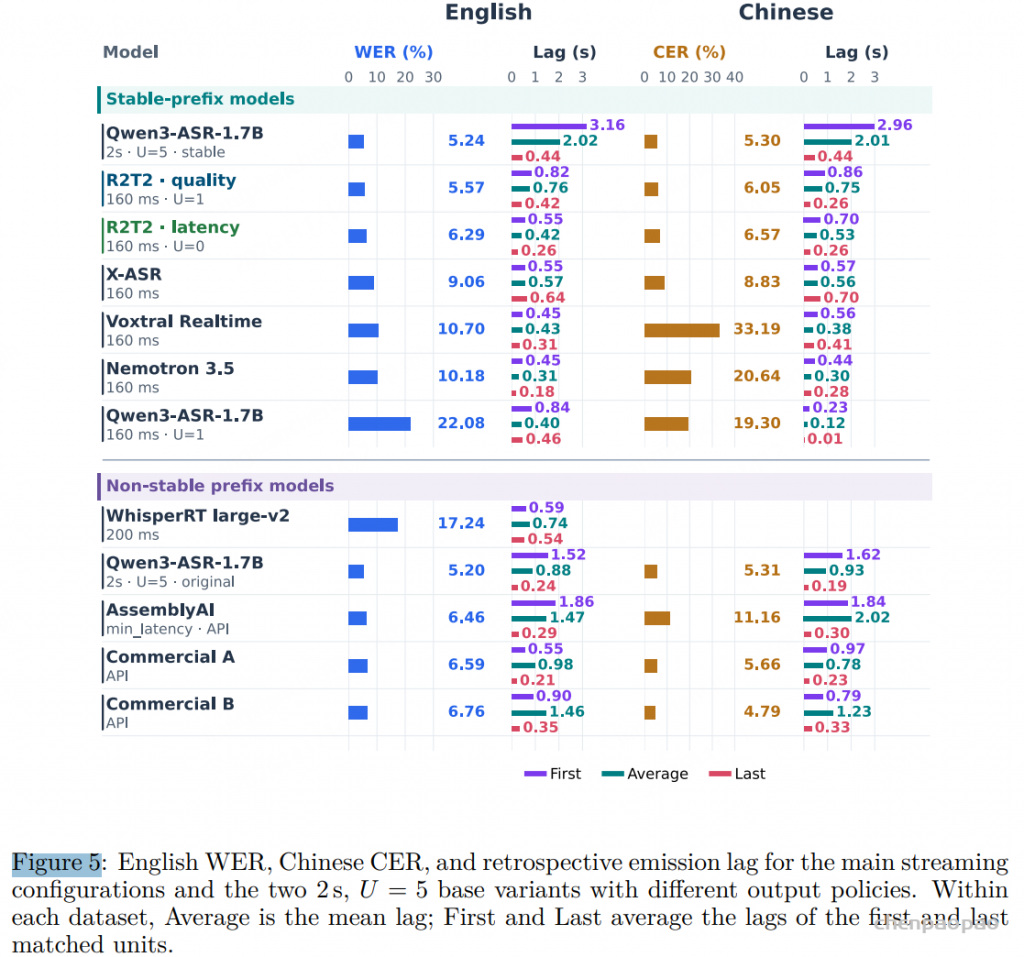
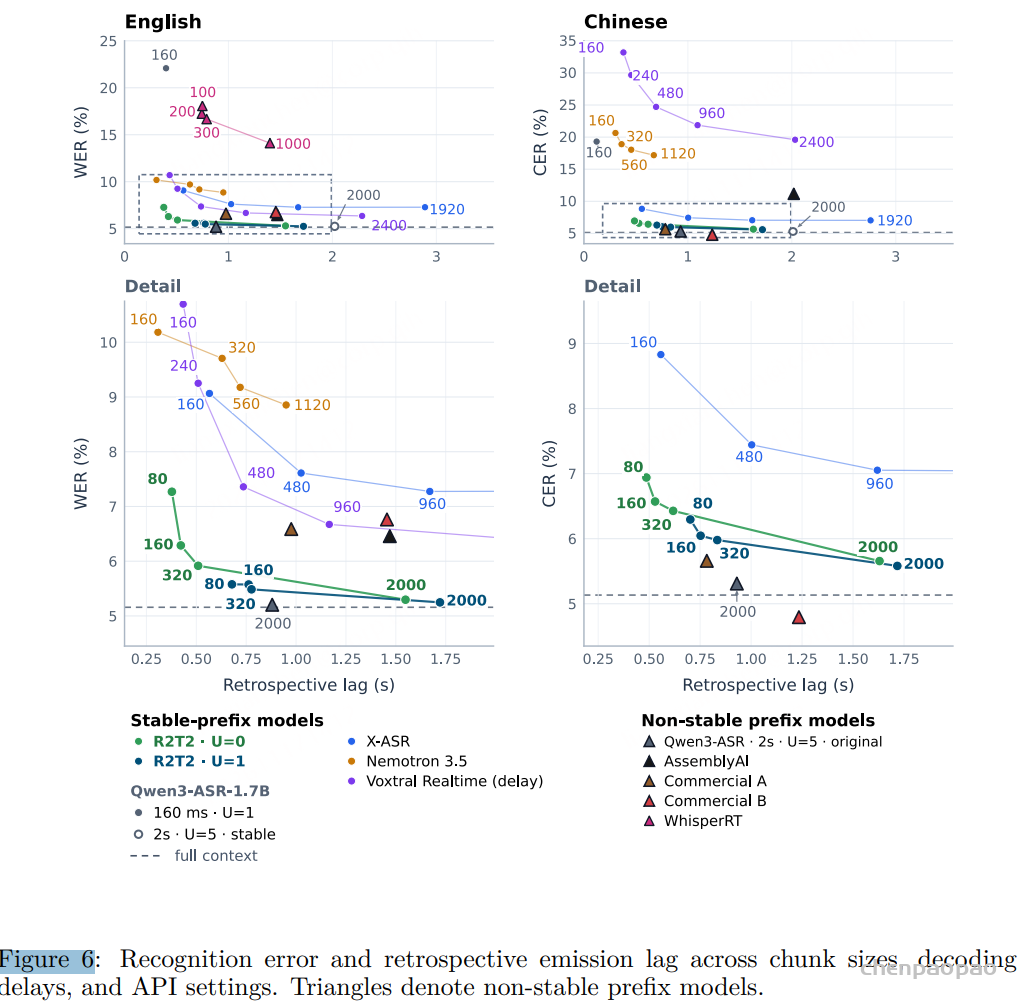
图片占位(论文 Table 3,ID:tab:main-recognition-comparison;论文 Figure 5,
11.1 跨语言迁移结果
虽然 R2T2 后训练只使用中文和英文,但在另外 10 种语言的 18 个测试集上,160 ms、U=1 的错误率都低于基础模型同条件配置,宏平均从 30.75% 降到 8.40%。这些语言包括阿拉伯语、德语、西班牙语、法语、日语、韩语、葡萄牙语、俄语、泰语和越南语。这个结果说明模型学到了一部分与“稳定前缀和等待”有关的通用能力,但不应被理解为这些语言都经过了专门后训练。
十二、发射延迟如何计算
论文使用回溯性发射延迟(retrospective emission lag)。对齐后,一个正确识别单位的延迟为:
\(\mathrm{Lag}=t_{\mathrm{first\ permanently\ stable\ output}}-t_{\mathrm{aligned\ acoustic\ end}}\)该指标只统计 Levenshtein 对齐后正确匹配的英文词或中文字符,排除高错误率语句;沿音频时间轴计算,不包含推理计算、排队、网络和界面渲染时间。因此它不是服务器端端到端响应延迟,而是“如果系统能跟上音频,正确文字多久变成永久稳定前缀”的指标。
160 ms、U=1 的平均回溯性延迟约为英文 0.76 秒、中文 0.75 秒;U=0 时英文约 0.42 秒、中文约 0.53 秒。进一步使用 80 ms、U=0 时,中英文平均延迟都可以低于 0.5 秒,但识别错误率继续上升。
十三、R2T2 与普通“不断改写”流式 ASR 的区别
| 方案 | 模型中是否学习提交时机 | 已经发布文本 | 下游系统 |
|---|---|---|---|
| 滚动重解码 | 通常没有 | 可能回改 | 需要 diff、撤销和重复处理 |
| Local Agreement/Hold-n | 主要是外部提交规则 | 提交后可不回改 | 稳定,但模型自身不一定知道何时等待 |
| R2T2 | LSP + Wait 直接训练 | 只追加、不回改 | 可直接消费 finalized prefix |
| 因果交错模型 | 通过因果结构约束 | 通常不回改 | 需要重新训练编码器和解码器 |
R2T2 的关键不是简单把输出尾部截掉,而是让模型在生成过程中学会:当前信息不足时不要猜,直接 Wait;当前前缀稳定时才提交。
十四、开源使用方式
官方仓库提供 vLLM、Transformers 离线推理、llama.cpp 和 WebSocket 服务器。模型权重位于 Hugging Face,GGUF 权重位于 Confucius4-R2T2-GGUF。
git clone https://github.com/netease-youdao/Confucius4-R2T2.git
cd Confucius4-R2T2
conda create -n confucius4-r2t2 python=3.12 -y
conda activate confucius4-r2t2
pip install -e .
./run_example.sh /path/to/audio.wav \
--model_path /path/to/Confucius4-R2T2 \
--infer_mode stream_vllm \
--language Chinese \
--chunk_size_ms 160| 参数 | 含义 |
|---|---|
| chunk_size_ms | 流式 chunk,支持 80 ms-2 s |
| unfixed_token_num | U,1 偏质量,0 偏延迟 |
| lookahead_ms | 首轮更新使用的额外音频缓存 |
| context | 主题、词汇或热词提示 |
| language | Chinese、English 等语言提示 |
14.1 Python 流式接口的关键语义
state = asr.init_streaming_state(
    context="",
    language="Chinese",
    unfixed_chunk_num=0,
    unfixed_token_num=1,
    chunk_size_sec=0.16,
)

_, committed_text = asr.streaming_transcribe(seg, state, max_new_tokens=4)
asr.finish_streaming_transcribe(state)
官方示例强调:如果下游系统要求文字不可回改,应使用 finalized prefix;当前 hypothesis 可能还包含内部暂留尾部。最终 flush 后再读取完整文本。
14.2 WebSocket 服务
仓库提供 ws_server.py 和示例客户端,端点为 /asr_stream_api_v1。客户端发送 16 kHz、单声道、int16 PCM 二进制帧,参考帧约 160 ms;结束时发送 YOUDAO_ONETIME_ASR_STREAM_EOS。服务端返回 JSON,msg.text 是相对于上一条消息的新增增量片段,客户端可将其追加获得完整转写。
十五、总结:R2T2 真正解决的是什么问题
R2T2 的核心不是让 ASR 在每个时刻都给出一个“完整猜测”,而是让模型学习当前音频已经支持到哪一个安全前缀。能够确认时输出文字,不确定时输出 Wait;已经发布的文字永远不回改。
技术路径可以概括为:
\(\text{Qwen3-ASR-1.7B}+\text{LSP labels}+\text{Wait supervision}+\text{SFT}+\text{GRPO}+\text{cache optimizations}\rightarrow\text{stable-prefix streaming ASR}\)在 160 ms chunk、U=1 的质量优先模式下,R2T2 把流式识别错误率从基础模型的 21.01% 降到 5.76%,接近基础模型完整音频的 5.15%;在 U=0 或更小 chunk 下,又可以换取更低的发射延迟。对需要持续消费文本的字幕、同传和语音智能体来说,这种“只追加输出”的接口比单纯追求最终 WER 更接近真实生产需求。