一、论文到底贡献了什么
YODAS v3 的核心贡献不是提出一个新的 ASR 网络,而是提出一套面向大规模、多语言、宽带和立体声语音的数据构建方法,并用两个基线任务验证数据是否可用。论文将开源语音数据的瓶颈概括为三点:大量语料仍是 16 kHz 或 24 kHz 单声道;中低资源语言在通用网页检索中容易被高资源语言挤压;仅有音频时长而没有字幕、翻译和时间戳,难以直接用于监督训练。
二、和已有开源语音语料相比,YODAS v3 的位置
论文 Table 1 使用论文撰写时的统一口径比较规模、采样率、立体声、标注与许可证。下面完整保留该表的关键数字;“Stereo”表示数据集是否以立体声或多声道为主要发布形态,而不是说每一个文件都一定有两个互不相同的声道。
| 数据集 | 语言数 | 规模(小时) | 采样率 | 立体声 | 有标注 | 许可证 |
|---|---|---|---|---|---|---|
| Common Voice | 137 | 33k | 48 kHz | 否 | 是 | CC0 |
| MLS | 8 | 51k | 16 kHz | 否 | 是 | CC BY 4 |
| FLEURS | 102 | 1k | 16 kHz | 否 | 是 | CC BY 2.5 |
| VoxLingua107 | 107 | 7k | 16 kHz | 否 | 是 | CC BY 4 |
| LibriLight | 1 | 60k | 16 kHz | 否 | 否 | CC BY 4 |
| VoxPopuli | 23 | 400k | 16 kHz | 否 | 否 | CC0 |
| Emilia | 6 | 100k | 24 kHz | 否 | 是 | CC BY-NC 4 |
| Unsupervised People’s Speech | 89 | 740k | 48 kHz | 是 | 否 | CC BY-SA 4 |
| YODAS v2 | 140 | 550k | 24 kHz | 否 | 是 | CC BY 3 |
| YODAS v3 | 147 | 1100k | 48 kHz | 是 | 弱标注 | CC BY 3 |
这里的“147 languages”需要谨慎理解。论文分析章节按 YouTube 上传者提供的 locale 统计,locale 是语言分布的代理字段,不是对每段音频进行人工或模型语音识别后的金标准语言标签。当前 Hugging Face 数据卡又提供了 transcript_lang 目录,因此会出现 103 个目录(102 个语言码加 unk)与论文 147 个 locale 代码并存的情况;二者是不同字段、不同统计问题,并不矛盾。
从 Table 1 看,v3 相比 v2 的名义时长约翻倍,并保留更高采样率与多声道;相比 Unsupervised People’s Speech,则额外提供可用于监督训练的字幕。但表中的“有标注”只表示存在标注机制,不能解释为全部音频都有人工标注。
三、数据采集流水线:从 Wikipedia 关键词到 Creative Commons 视频
3.1 关键词生成:解决“用英文搜全世界”的偏置
YODAS v2 复用共享的多语言 Wiki 关键词列表,容易出现两类错误:低资源语言没有足够查询词,以及查询词实际上是英语或其他语言。v3 改成“每种语言单独生成关键词”。作者下载每种语言的 Wikipedia dump,先按规则过滤候选词:不能只有数字或标点;首字符不能是数字或标点;长度限制为 3 至 30 个字符;排除文件名、DOI、Wikipedia Template 和 Request 页面。
接着,作者在每种语言的候选词上训练 unigram subword tokenizer。词表有预设大小;如果候选语料太小,便逐步减半词表直到 tokenizer 能够训练。对候选关键词分词后,用 unigram 语言模型概率排序,保留似然较高且不太罕见的词。论文没有公开固定的词表大小、最终 top-K 数量或每种语言的搜索预算,因此复现时应把这几个量视为需要自行设定的工程超参数。
\(\log P(w)=\sum_{i=1}^{m}\log p(s_i),\quad w=(s_1,s_2,\ldots,s_m)\)上式是对论文步骤的工程化表达:将关键词 w 切成若干 subword 后累加 unigram 对数概率。它帮助筛掉模板词、极罕见实体和无法代表自然语言内容的条目,但不是论文单独编号的理论创新公式。
3.2 视频搜索:按语言分治,并使用两轮检索
3.3 下载与弱标注
下载时优先使用视频原始语言的人工字幕;没有人工字幕时使用 YouTube 自动字幕。如果存在非英语字幕,还保存英文字幕。每个字幕条目保留开始时间和持续时间,并与音频文件建立 ID 级关联。视频 description 也被保存,论文把它视为未来检索、摘要和多模态任务的潜在信号,而没有在本文实验中单独证明其收益。
v3 中人工字幕占比约 3.7%,低于 v2 的约 20%。作者推测 YouTube 自动字幕质量提升,降低了上传者制作人工字幕的必要性;论文没有提供人工转写对照集、字幕字符错误率或显著性检验,因此不能把“自动字幕质量提升”写成已验证的定量结论。
“3.7%”的分母在论文中没有进一步细分为视频数、句子数还是小时数,因此本文保留原文的占比表述,不据此推算人工字幕小时数。另外,原始视频音轨可以包含音乐、背景噪声和多个声源,110 万小时是抓取音轨时长,并非经过 VAD 验证后的纯语音时长。
| 阶段 | 输入 | 主要操作 | 输出 |
|---|---|---|---|
| 关键词 | 各语言 Wikipedia dump | 规则过滤、unigram tokenizer、似然排序 | 每种语言的查询词 |
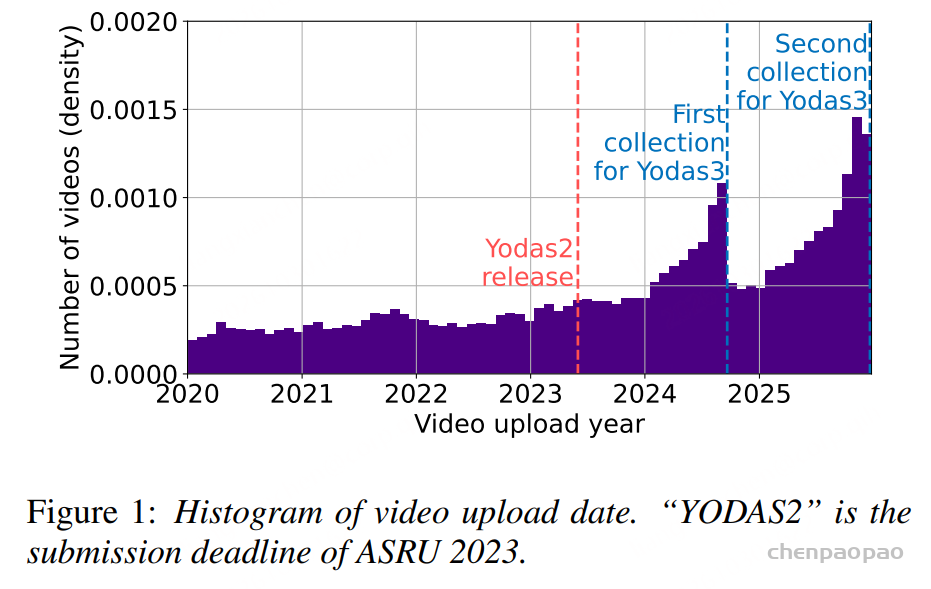
| 检索 | 语言查询词、YouTube | Creative Commons、两轮搜索、优先新上传、去除 v2 ID | 候选视频 ID |
| 字幕 | 人工字幕或自动字幕 | 优先原语言,补充英文字幕,保存时间戳 | 弱监督 transcript/translation |
| 音频 | 最高质量视频流 | 下载 48 kHz 多声道 Opus/WebM | 原始宽带音频 |
| 分析 | 音频和字幕元数据 | 语言、时长、带宽、声道、质量过滤 | 数据卡和实验子集 |
| 论文 Table 2 元数据 | 示例或含义 |
|---|---|
| Channels / Effective channels | 容器声道数与去除重复后的有效声道数,例:2 / 2 |
| Sampling rate / Max bandwidth | 解码采样率与最高有效频率,例:48 kHz / 20 kHz |
| Views / Language | 观看次数、语言代理标签,例:67 / French |
| Transcript / Translation | 原语言字幕与英文翻译 |
| Description | 视频描述,可为检索或摘要提供上下文 |
四、数据组成与 Hugging Face 发布结构
数据卡中的 id 是 32 位十六进制字符串,shard 是四位编号。音频文件、JSON 和 Parquet 行应通过同一 id 与 shard 关联,不要假设 tar 内文件顺序与 Parquet 行号一致。transcript 字段通常是 JSON 字符串或 null;解析后可得到 segment 的 start/duration,以及相对于 segment 起点的 word 时间偏移。音频 length 以秒计,字幕时间戳以毫秒记录。
当前默认 preview 配置只是预览集,不代表完整的一百多万小时。完整数据应按语言和 shard 流式处理。论文的下载流水线与 Hugging Face 的打包流水线也不是一回事:前者解释数据如何被发现和筛选,后者解释已经发布的文件如何组织。
data/
  <lang>/
    audio/0000.tar
    audio/0001.tar
    metadata/0000.parquet
    metadata/0001.parquet
unk/ # 没有字幕语言可用于分组的音频| 当前数据卡字段 | 单位 / 解释 | 使用注意 |
|---|---|---|
| id、shard | 样本标识、四位分片号 | 以 ID 关联音频与元数据 |
| transcript | JSON 字符串或 null | segment 时间为毫秒,words.t 是相对 segment.start 的偏移 |
| translation_en | 英文翻译 JSON 或 null | 只有句级时间戳;卡片报告约 107 万个视频有该字段 |
| transcript_lang、locale_lang | 字幕轨语言、上传者 locale | 文件级字段不代表每一句都使用同一种语言 |
| length | 秒 | 卡片范围 1–153284,均值约 952;长视频宜分段解码 |
| audio_bitrate | kbit/s | 容器码率约 3.6–569,中位数约 122;1461 个视频缺失 |
| max_freq_hz | Hz,约 35–24000 | 约 28.3 万条缺失,不能直接当作低带宽 |
| estimated_bandwidth_hz | 等效采样率分档 | 8000、16000、22050、24000、32000、44100 或 null |
| channels | 容器声道数 | 1、2、4、6;约 99.8% 为 2 |
| n_distinct_channels | 实测有效声道数 | 1–5 或 null;581 条分析失败,不能当作单声道 |
75%、60%、95% 分别针对是否有字幕、非英语数据是否有翻译、已有字幕是否包含词时间戳,条件集合不同。尤其不要将“60% 非英语数据有翻译”直接换算为“总量的 60% 都是可训练翻译对”。没有字幕的 unk 数据仍可用于无监督音频建模;带字幕的数据也需要检查原语言与翻译是否覆盖同一时间段。
五、规模与音频属性分析
5.1 语言分布:更均衡,但不是严格均衡
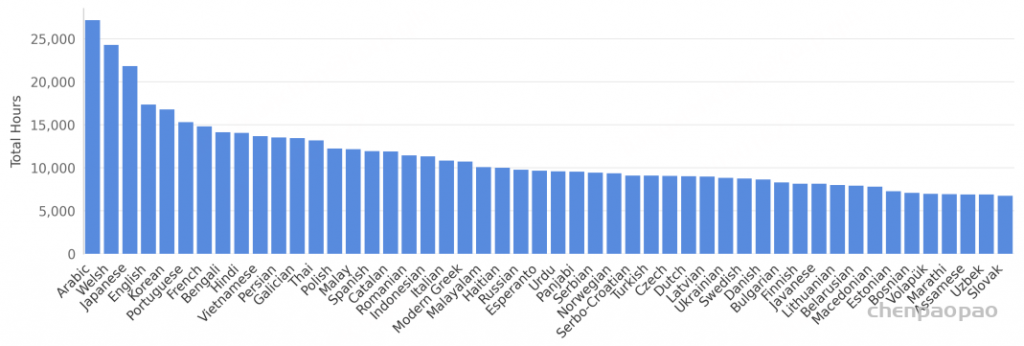
论文统计中,阿拉伯语和威尔士语约 2.5 万小时,日本语约 2.1 万小时,英语约 1.7 万小时且低于总量的 2%;共有 22 种语言超过 1 万小时、73 种语言超过 5000 小时。平均数约 7400 小时而中位数约 5180 小时,说明分布仍然长尾,只是比单纯依靠全球热门查询词更平衡。
5.2 视频时长与有效样本量
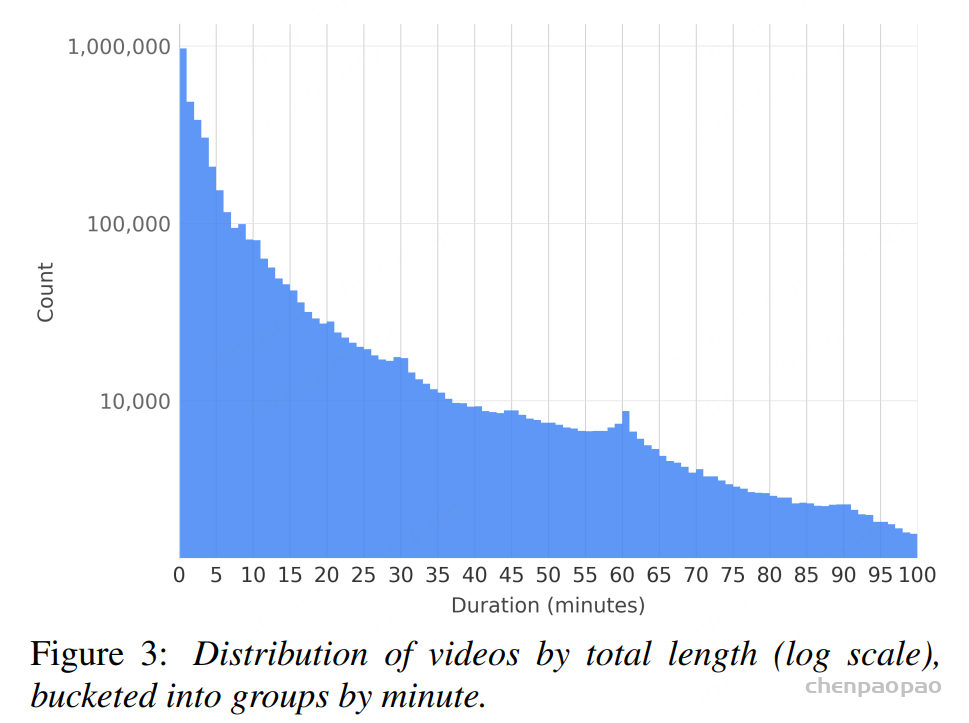
约 400 万个视频中,超过 24% 的视频短于 1 分钟,作者将其与 Shorts 生态联系起来。约 170 万个视频长于 5 分钟,总时长约 100 万小时;约 120 万个视频长于 10 分钟,总时长约 95 万小时。后两个集合是嵌套关系,不能相加。同时数据呈明显长尾分布。约有 400 万个视频(占 24%)少于 1 分钟,作者认为这可能和 YouTube Shorts 的流行有关。论文还指出存在大量超过 60 分钟的直播类视频,但没有给出一个可直接复核的精确小时数。
这组统计提醒我们:总小时数很大,并不意味着每个训练样本都长、都干净或都包含完整对话。做 ASR 时需要按 utterance 切片;做编解码器或空间音频任务时,可能需要重新设计长音频采样和直播片段去重策略。
5.3 48 kHz 不等于每个文件都包含完整 24 kHz 频谱
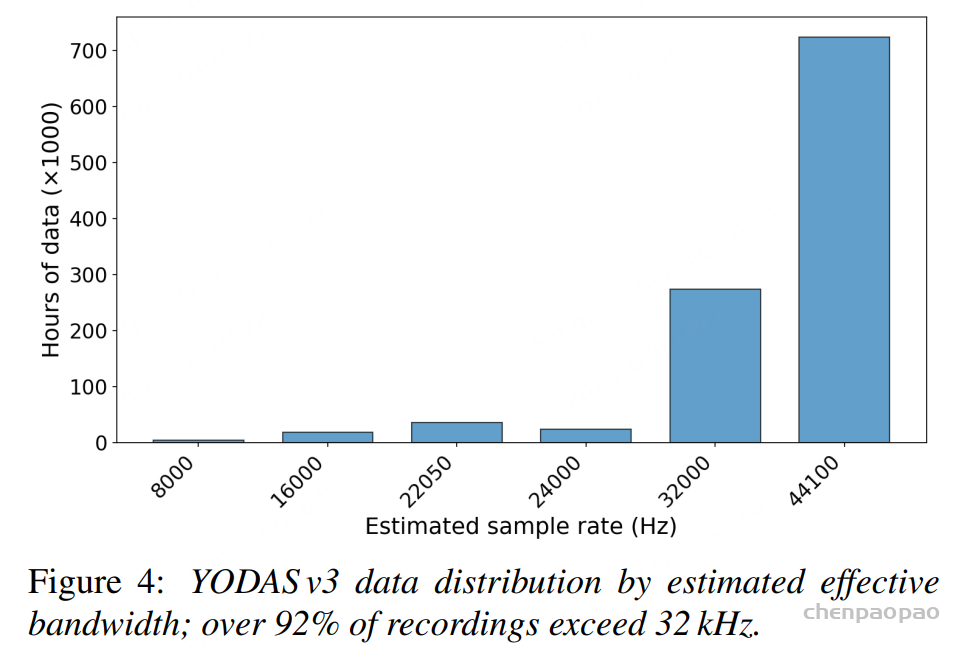
Opus 解码后可以得到 48 kHz PCM,但上传者的麦克风、混音和编码模式可能只保留较窄频带。论文用 8192 点 Hann 窗、50% 重叠的 STFT 估计最高有效频率:跳过 RMS 不超过 10^-6 的静音帧,找出幅度超过该帧最大幅度 0.5% 的最高频率,再在短视频全程或长视频随机抽取的五个 60 秒片段中取最大值。
\(X_{t,k}=\sum_{n=0}^{N-1}x[n+tH]w[n]e^{-j2\pi kn/N},\quad N=8192,\;H=4096\) \(f_{\mathrm{max}}=\max_{t,k}\{f_k:\lvert X_{t,k}\rvert>0.005\cdot\max_j\lvert X_{t,j}\rvert\}\)作者把 fmax 映射到候选等效采样率集合 {8, 16, 22.05, 24, 32, 44.1 kHz},选择满足 Nyquist 条件的最小采样率。这里的“44.1 kHz 类”是等效采样率类别,不是说频谱真的延伸到 44.1 kHz;48 kHz PCM 的 Nyquist 频率约为 24 kHz。
结果是:约 67.3% 的数据属于 44.1 kHz 等效带宽类别,论文报告约 92.5% 的数据达到 32 kHz 及以上类别。Figure 4 建议放在本节。这个指标是“检测到的最高频率”而不是对每个片段的主观听感或音乐保真度承诺,噪声、响度和编码伪影都会影响阈值结果。
5.4 多声道与有效声道数
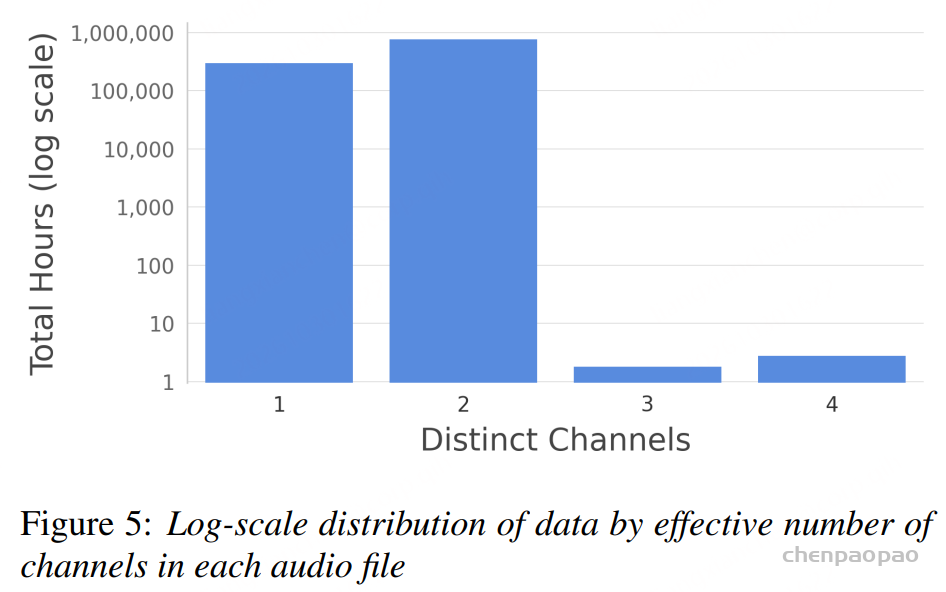
对每个音频文件,论文计算每一对声道的残差 RMS,并用两声道平均 RMS 归一化。若归一化残差低于 10^-3,则将两声道视为有效相同。
\(d_{ij}=\frac{\mathrm{RMS}(x_i-x_j)}{(\mathrm{RMS}(x_i)+\mathrm{RMS}(x_j))/2}\)超过 71% 的音频文件、约 78 万小时,被判定为真正的多声道;绝大多数是双声道,少量 3 至 4 个有效声道主要来自 5.1 等容器。数据卡还报告约 25% 的视频属于双声道封装但有效单声道的 dual-mono,不能把“容器有两个声道”直接等同于“有空间差异”。不同声道也可能来自音乐混音或编辑后的左右声道,而不是规范的麦克风阵列几何。
六、实验一:ASR 的过滤阈值实验
6.1 实验设置
论文没有训练一个百万小时级的新型语音基础模型,而是使用 OWSM v4 base(约 102M 参数)和 ESPnet,训练 40k steps,验证数据能否支撑多语言 ASR。随机抽取 7 种语言:英语约 4500 小时,德语、法语、日语、葡萄牙语、俄语、越南语各约 100 小时。处理流程固定包含 CTC segmentation 和语言过滤,然后对 CTC 置信分数做分位数过滤。阈值 0.00 表示不做 CTC 分数过滤,但仍然做前面的分段与语言过滤。
Common Voice 作为七种语言的测试集;英语、德语、法语、葡萄牙语、俄语和越南语使用 WER,日语使用 CER。
\(\mathrm{WER}=\frac{S+D+I}{N}\times 100\%,\qquad\mathrm{CER}=\frac{S_c+D_c+I_c}{N_c}\times 100\%\)这里补充标准指标定义,方便理解表格:S、D、I 分别是替换、删除和插入数,N 是参考词数;CER 改为字符级计数。这不是论文提出的新指标。由于词与字符粒度不同,不能直接拿日语的 27.7 和英语的 15.9 排名判断哪种语言更难。
| CTC 分数分位阈值 | 英 WER | 德 WER | 法 WER | 日 CER | 葡 WER | 俄 WER | 越 WER |
|---|---|---|---|---|---|---|---|
| 0.00 | 15.9 | 14.4 | 17.2 | 27.7 | 11.1 | 15.3 | 20.6 |
| 0.10 | 15.3 | 14.6 | 17.8 | 29.2 | 11.5 | 15.4 | 21.1 |
| 0.20 | 15.3 | 15.4 | 18.8 | 30.9 | 12.2 | 16.0 | 20.8 |
| 0.30 | 15.6 | 16.3 | 21.8 | 34.5 | 13.4 | 16.7 | 23.1 |
6.2 如何理解这项“消融”
阈值是 CTC 分数的分位位置,不是一个可以跨模型、跨语言直接比较的绝对置信度分数。将阈值从 0.10 改成 0.30 表示提高分数筛选的严格程度;若要在自己的数据上复现,还需要明确是在每种语言内部还是整个集合上统计分位数,以及 CTC 分数是否做长度归一化。论文正文没有展开这些实现细节。
这是一项围绕数据过滤强度的质量—数量实验,不是模型结构消融。随着阈值从 0.00 提高到 0.30,低分片段被删除得更多,训练数据量下降。六个非英语语言的最佳结果都出现在 0.00;英语在 0.10 和 0.20 达到 15.3,差异很小;越南语在 0.10 到 0.20 还有轻微回落,因此不能把曲线概括成“阈值越低每一种语言必然越好”。
论文将这一点与 YODAS v2 的经验对照:v2 需要较强过滤才能避免超过 100 的 WER,而 v3 即使不做 CTC 分数过滤也能取得可用结果。作者推测原因包括 YouTube 自动字幕质量提高,但没有人工转写金标准、随机种子重复或严格相同数据量控制,因此应把结论写成“观察到的过滤趋势”,而不是普适的最优阈值。
具体看数值,从阈值 0.30 放宽到 0.00,法语 WER 从 21.8 降至 17.2,改善 4.6 个百分点;日语 CER 从 34.5 降至 27.7,改善 6.8 个百分点。这个收益对应“保留更多样本与改变样本质量分布”的联合变化。论文没有报告每个阈值最终保留多少小时,所以无法进一步区分收益究竟来自新增时长、困难样本覆盖还是字幕错误分布。
七、实验二:神经音频编解码器
7.1 设置和基线
作者从 YODAS v3 随机抽取 1200 小时,分别以 16、24 和 48 kHz 训练 DAC 架构,使用 ESPnet-Codec 的官方配置。对照数据为 LibriTTS(585 小时、英语朗读)和 AMUSE(约 33k 小时、包含多语言语音、音乐和声音)。VERSA 工具包在 1000 个视频上做域内测试,并在 LibriTTS 上做域外测试,指标为 STOI 和 WavLM speaker similarity,二者均为越高越好。论文没有声称这是立体声 codec 的专门结构实验,也没有给出比特率、token 帧率和全部模型超参数。
| 训练数据 | 采样率 | LibriTTS STOI | LibriTTS SPK | YODAS v3 STOI | YODAS v3 SPK |
|---|---|---|---|---|---|
| LibriTTS | 16 kHz | 0.95 | 0.76 | 0.74 | 0.69 |
| LibriTTS | 24 kHz | 0.97 | 0.83 | 0.80 | 0.78 |
| AMUSE | 16 kHz | 0.93 | 0.74 | 0.81 | 0.83 |
| AMUSE | 44 kHz | 0.95 | 0.82 | 0.90 | 0.77 |
| YODAS v3 | 16 kHz | 0.92 | 0.60 | 0.82 | 0.79 |
| YODAS v3 | 24 kHz | 0.92 | 0.66 | 0.84 | 0.82 |
| YODAS v3 | 48 kHz | 0.97 | 0.84 | 0.94 | 0.90 |
7.2 结果解读
YODAS v3 48 kHz 模型在 LibriTTS 域外测试上达到 STOI 0.97、SPK 0.84,在 YODAS v3 域内测试上达到 STOI 0.94、SPK 0.90。LibriTTS STOI 的 0.97 与 YODAS v3 48 kHz 并列最高,不应写成严格超过;但 YODAS v3 在说话人相似度上取得最高的两个数值。另一方面,较低采样率的 YODAS 模型并不是所有指标都优于基线:例如域外 STOI 仍受训练域、采样率和声音组成影响。
对所有行而言,YODAS 测试集的 STOI 低于 LibriTTS 测试集,符合嘈杂网页音频更难重建的直觉;但 SPK 并不都呈现相同趋势,因此不把“域内更难”推广为每一种指标必然下降。
这个实验支持“宽带、多样化数据有利于 48 kHz codec”的方向性结论,但不能推出所有高采样率任务都会提升,也不能把 STOI 和说话人相似度替代完整的空间听感评测。AMUSE 的数据量约为 33k 小时,远大于 YODAS 实验抽取的 1200 小时,因此表格同时混合了数据量、领域组成和采样率变量,不能单独解释为纯粹的规模定律。
八、结论:YODAS v3 真正解决的是数据形态问题
YODAS v3 的价值不只是把小时数做大,而是把开放语音数据从“单声道、窄带、单一字幕”推进到“宽带、多声道、带时间戳和翻译的弱监督样本”。
YODAS v3 发布了一个规模超过 110 万小时、覆盖 147 种语言的高带宽立体声语音数据集。核心特点可以概括成四点:
- 第一,规模大。 达到百万小时级,是目前最大的开放语音数据集之一。
- 第二,语言更均衡。 22 种语言超过 1 万小时,73 种语言超过 5000 小时,英语占比不到 2%。
- 第三,真正的高带宽和多通道。 92.5% 数据有效带宽超过 32kHz,71% 以上是真正不同的多通道音频。
- 第四,可以同时支持识别和生成任务。 ASR 实验说明自动转写质量已经比较高;Codec 实验也验证了 48kHz 高带宽数据对于高保真音频建模的价值。
YODAS v3 不只是把开放语音数据堆到 110 万小时,而是第一次把“百万小时、多语言、高带宽、真实立体声”这几个维度真正组合到了一起。
这也使它不再只是一个 ASR 数据集,而是可以进一步服务于 TTS、Audio Codec、语音增强、空间语音等下一代语音模型训练的大规模数据基础。