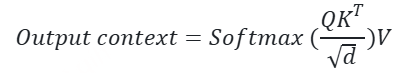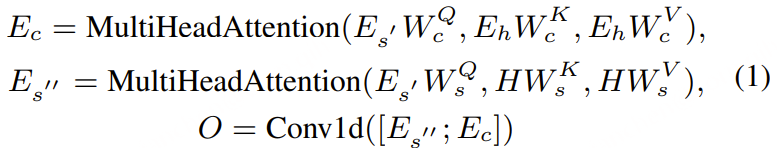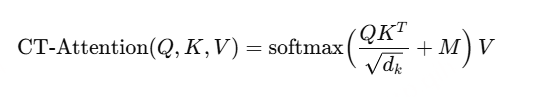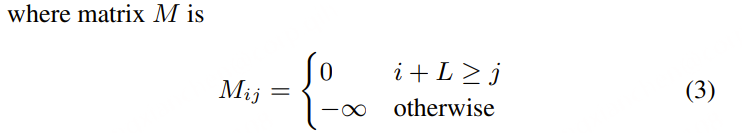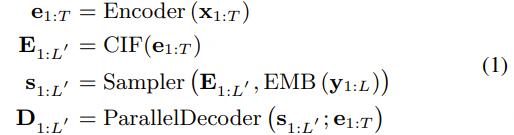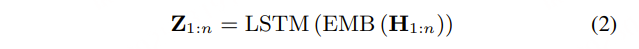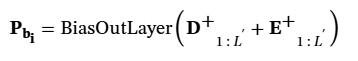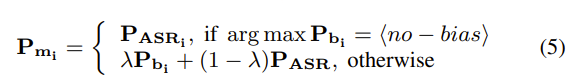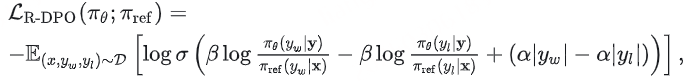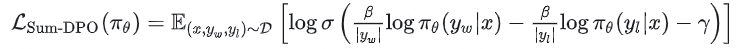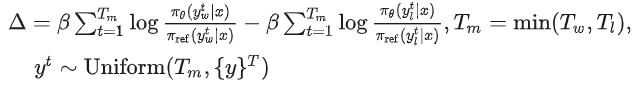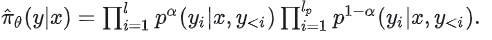DeepSpeed Ulysses: 训练极长序列Transformer模型的系统优化

从生成性AI到科研模型,长序列训练正在变得非常重要。 在生成性AI领域,会话式AI、长文档摘要和视频生成等任务都需要在空间和时间层面对长上下文进行推理。 例如,多模态基础模型,如同时处理语音、图像和波形的模型,需要对具有极长序列的高维输入进行长上下文推理。 同样,章节和书籍级别的摘要(数万甚至数十万字)在会话式AI和摘要任务中也非常重要。

对于科学AI来说,长序列同样至关重要,它为更好地理解结构生物学、医疗保健、气候和天气预测以及大分子模拟打开了大门。 例如,通过在基因序列上训练大型语言模型,我们可以创建可以使用极长序列(人类基因组有64亿个碱基对)学习基因组进化模式的语言模型。在医疗保健领域,以所有的患者护理记录为条件的诊断预测模型需要极长序列的上下文。

尽管对于生成性AI和科学AI来说,长序列长度的重要性逐渐增长,但现有的大型模型训练系统和底层的并行技术(数据、张量、流水线、序列并行)并不能支持高效的长序列训练。现有并行方法存在两个主要挑战。首先,现有的数据、张量和流水线等并行方法无法解决序列维度的扩展问题。其次,由于内存通信效率低下,现有的序列并行方法不够高效。此外,现有方法的易用性不足,需要进行侵入性和复杂易出错的代码重构。

为了解决这些问题,我们很高兴宣布推出DeepSpeed-Ulysses(或称为Ulysses,一个非常长的小说),这是一种简单、易用且高效的方法,用于支持具有极长序列长度的高效可扩展LLM训练。

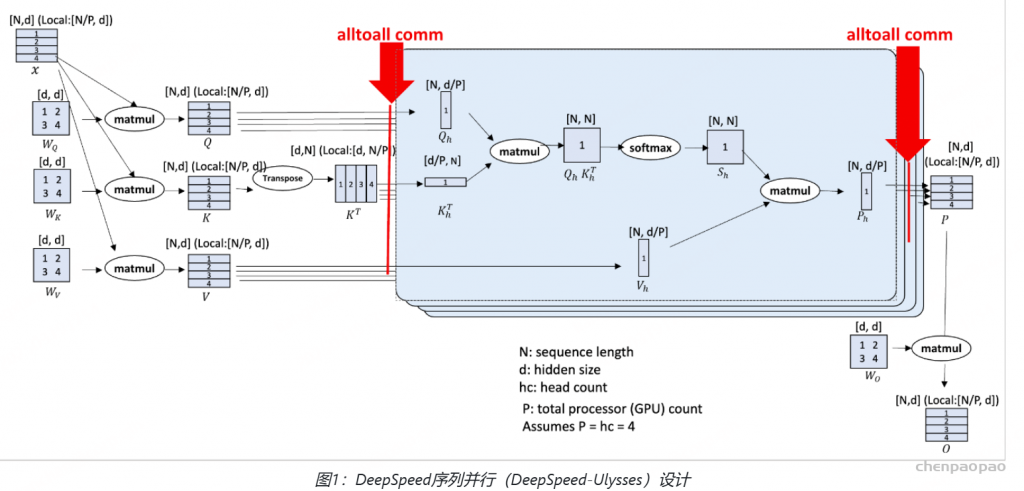
DeepSpeed-Ulysses将各个样本在序列维度上分割给参与的GPU。然后,在attention计算之前,它对已分割的查询(Q)、键(K)和值(V)执行all-to-all通信操作,以使每个GPU接收完整的序列,但仅用于注意力头的非重叠子集。这使得参与的GPU可以并行计算不同的注意力头。最后,DeepSpeed-Ulysses还使用另一个all-to-all来在注意力头上收集结果,同时重新在序列维度上进行分区。

DeepSpeed-Ulysses及其与此博客一起发布的实现的关键特性如下:

  • 与现有系统相比,序列长度增加了4倍,支持训练超过百万个token的序列。
  • 与现有系统相比,通信减少了超过10倍,导致吞吐量提高了高达2.5倍,并且每个GPU的持续吞吐量超过175 TFlops(超过硬件峰值的54%)。
  • 完全通用的attention:DeepSpeed序列并行支持密集和稀疏的注意力,并可与高效的注意力实现(如FlashAttention v2)一起工作。
  • 支持大规模模型训练:DeepSpeed序列并行不仅支持大序列长度,还可以与ZeRO-3并用支持大模型尺寸。
  • 易于使用和迁移,最小化对现有训练框架的代码更改要求。

在接下来的章节中,我们详细讨论DeepSpeed-Ulysses的核心设计、通信复杂度分析、实验评估以及与现有工作的比较,并展示其可用性和使用指南。

DeepSpeed-Ulysses的核心设计

图1显示了DeepSpeed-Ulysses的核心设计。与已知的Transformer架构一样,设计由N个输入序列在P个可用设备上分区组成。每个本地N/P分区都被投影到查询(Q)、键(K)和值(V)嵌入中。接下来,(QKV) 嵌入通过参与计算设备之间的高度优化的全对全集合(all-to-all collectives)进行全局的 QKV 收集。在全对全集合后,每个头的注意力计算形式为:

注意力计算后,另一个全对全集合将注意力计算的输出上下文张量转换为序列(N/P)并行,用于Transformer模型层的剩余模块中的后续操作(MLP MatMul、层归一化等)。

显著的通信量减少

DeepSpeed-Ulysses与其他现有的长序列方法的区别在于其更小的累积通信量以及随着序列并行度增加而更好的可扩展性,如下所示:

在具有节点内NVSwitch互连和节点间胖树IB拓扑的现代集群上,针对一个聚合消息大小为M的全对全传输,传输到P个GPU上的每个链接的通信量为M/P。 对于隐藏层大小为h、序列长度为N且并行度为P的Transformer模型,DeepSpeed序列并行会在注意计算之前对QKV投影执行聚合消息大小为3Nh的全对全操作,并在注意计算之后对输出上下文投影执行大小为Nh的另一个全对全操作。因此,DeepSpeed序列并行每个链接的聚合通信量为4Nh/P(或O(N/P)复杂度)。值得注意的是,当N和P成比例增加时,这个通信量是恒定的。

相比之下,现有的方法,如Megatron-LM,在N线性增长的情况下会导致通信量线性增加,而与P无关,从而导致O(N)的通信复杂度。例如,Megatron-LM对每个Transformer模型层都执行两个大小为Nh的all-gather操作,以及两个大小为Nh的reduce-scatter操作。然而,当P >> 1时,大小为M的每个all-gather和reduce-scatter的成本仍然是M,而不是M/P。因此,Megatron-LM序列并行会导致每个链接的通信量为4Nh,这比DeepSpeed序列并行大P倍。这使得DeepSpeed序列并行可以在实现显著更高的训练效率的同时支持极长序列训练。我们的实验评估结果与此理论分析相符。

DeepSpeed-Ulysses的其他亮点

通用的注意力解决方案

DeepSpeed分布式注意力模块的实现足够通用,以支持任何类型的注意力,例如自注意、交叉注意和因果注意,无论是它们的密集还是稀疏版本,以及支持局部注意层级上的长序列的各种优化内核,例如不同版本的FlashAttention。

DeepSpeed-Ulysses的通用性来自其核心设计的模块化性质:一个以注意力为中心的序列并行设计。在注意力计算之前,序列并行性是对N/P分区的,而注意力计算是对每个头的并行性,每个头的注意力全都保留,但头的数量较少,因此注意力计算可以用任何类型的注意力机制替代,例如密集注意力和各种形式的稀疏注意力。

通过ZeRO-3集成实现更大的模型和更长的序列训练

尽管DeepSpeed序列并行在使用更长的序列进行训练时减少了激活内存的使用,但并不影响模型状态的内存占用。因此,为了支持具有大序列长度的大语言模型训练,我们实现了DeepSpeed序列并行与ZeRO-3的集成。

ZeRO Redundancy Optimizer Stage 3 (ZeRO-3) 是一种用于训练大模型的内存优化技术。与传统的神经网络数据并行训练中,模型状态在数据并行等级上进行复制不同,ZeRO-3通过将模型状态在数据并行等级之间进行分区来优化内存使用。然而,使用序列并行时,训练数据可以在批(样本)和序列维度上考虑,相关的并行群组可以组合成一个更大的群组以实现ZeRO并行。

因此,我们将ZeRO-3分区扩展到数据并行和序列并行等级的组合。换句话说,在DeepSpeed序列并行中,ZeRO将模型状态分区在序列和数据并行组之间,并在需要时收集每个等级分区(allgather)。类似地,梯度将在数据并行和序列并行等级之间进行减少,用于参数更新。ZeRO可以在序列和数据维度上实现巨大的内存节省,并且不仅可以扩展到大序列长度,还可以扩展到大模型。

评估

我们在GPT(用于许多NLP任务的基础模型)上使用最多64个A100 GPU(40GB显存)对DeepSpeed-Ulysses进行了评估。我们的评估分为四个方面:i) 序列长度可扩展性,ii) 密集注意力的吞吐量以及与现有系统的比较,iii) 稀疏注意力的吞吐量以及与现有系统的比较,iv) DeepSpeed序列并行的收敛性研究。接下来,我们将对每个类别讨论和展示评估结果。

序列长度可扩展性

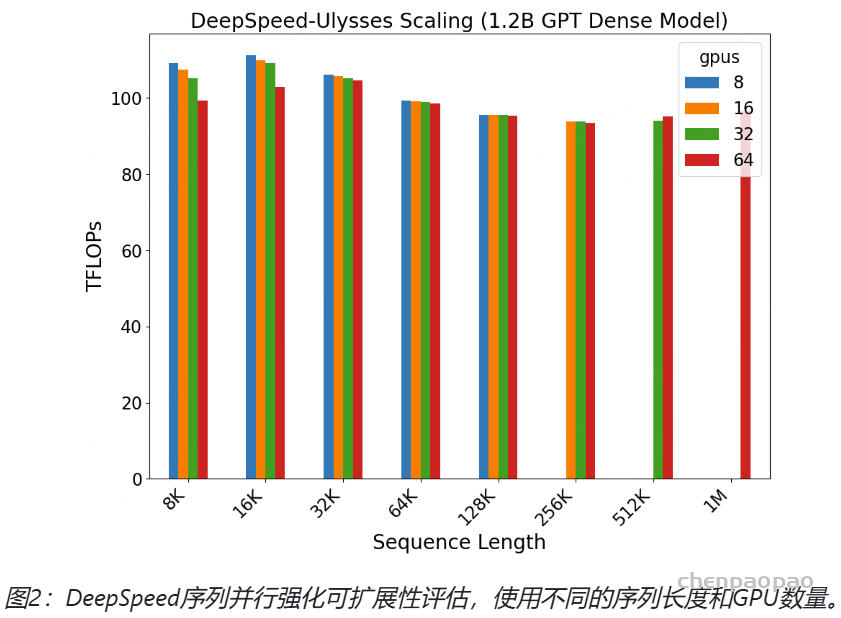
第一组实验是在12亿参数的GPT模型上将序列长度扩展到100万token。这个评估的结果如图2所示。DeepSpeed序列并行允许随着GPU数量的增加线性增加序列长度,并且序列长度与GPU数量保持线性比例关系,适当的GPU数量下保持相似的计算吞吐量。

密集注意力评估

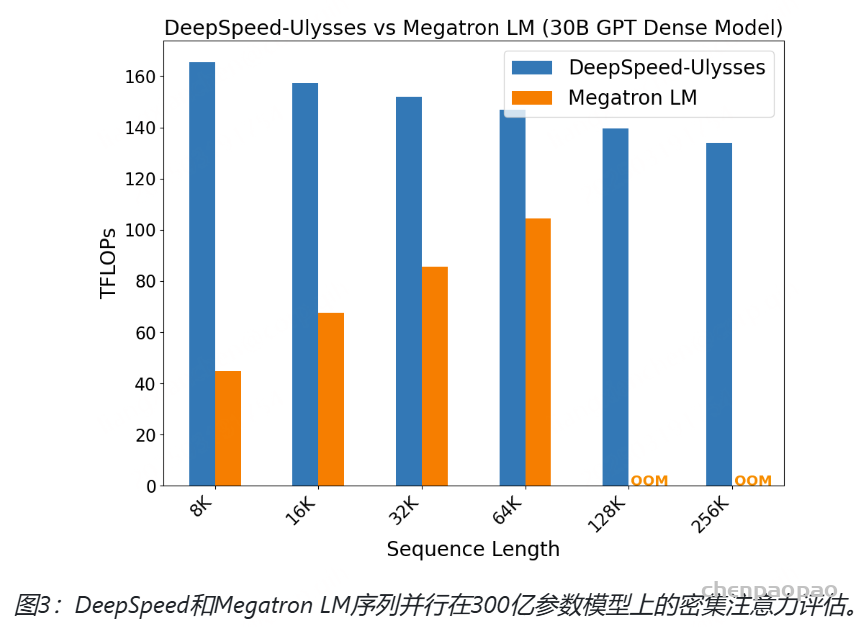
接下来,我们在300亿参数的密集注意力模型上对DeepSpeed序列并行进行了评估,并与Megatron序列并行在64个A100 GPU上进行了对比。这些评估的结果如图3所示。

我们将DeepSpeed序列并行与Megatron-LM在不同序列长度下的性能进行了比较。对于我们的评估,我们选择了能使DeepSpeed序列并行和Megatron-LM分别达到最佳性能(通过吞吐量或TFLOPs衡量)的序列长度-批大小组合,我们称之为最佳(批大小-序列长度)配置。对于DeepSpeed序列并行,我们始终使用64的ZeRO并行度。

图3显示,DeepSpeed序列并行在相同序列长度下始终优于Megatron-LM。此外,DeepSpeed序列并行可以运行比Megatron-LM更长的序列。DeepSpeed序列并行的性能优势在于两个方面:(1)DeepSpeed序列并行结合ZeRO-3的内存优化,可以容纳更多的样本,从而提高吞吐量;(2)相对于Megatron-LM序列并行中应用的all-gather通信,DeepSpeed序列并行使用更高效的全对全通信。

图3:DeepSpeed和Megatron LM序列并行在300亿参数模型上的密集注意力评估。

稀疏注意力评估

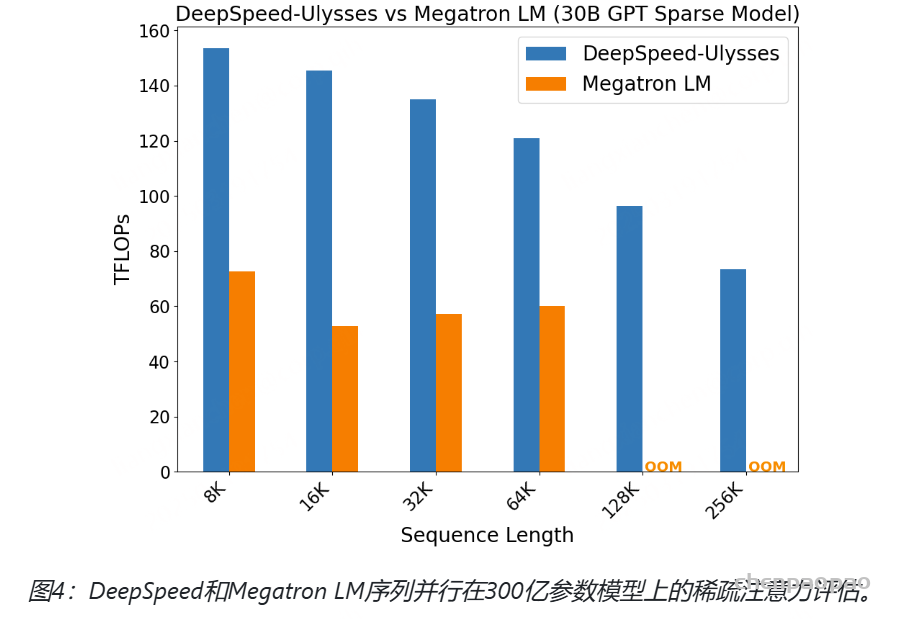
类似地,我们在300亿参数的稀疏注意力模型上对DeepSpeed序列并行进行了评估,并与Megatron序列并行进行了对比。我们的评估结果如图4所示。稀疏注意力的实验结果与密集注意力实验类似。我们观察到DeepSpeed序列并行的吞吐量性能相对于Megatron-LM提高了2倍以上。通过节省内存,DeepSpeed序列并行结合ZeRO-3可以扩展到比Megatron-LM更长4倍的序列长度。

DeepSpeed序列并行在相同序列长度下始终优于Megatron-LM。事实上,当前的DeepSpeed吞吐量受到本地稀疏注意力实现的瓶颈,因此DeepSpeed吞吐量随着序列长度的增加而降低。我们预计,随着未来局部稀疏注意力实现性能的改善,DeepSpeed与Megatron之间的性能差距将在更大的序列长度下进一步增加。

图4:DeepSpeed和Megatron LM序列并行在300亿参数模型上的稀疏注意力评估。

收敛性研究

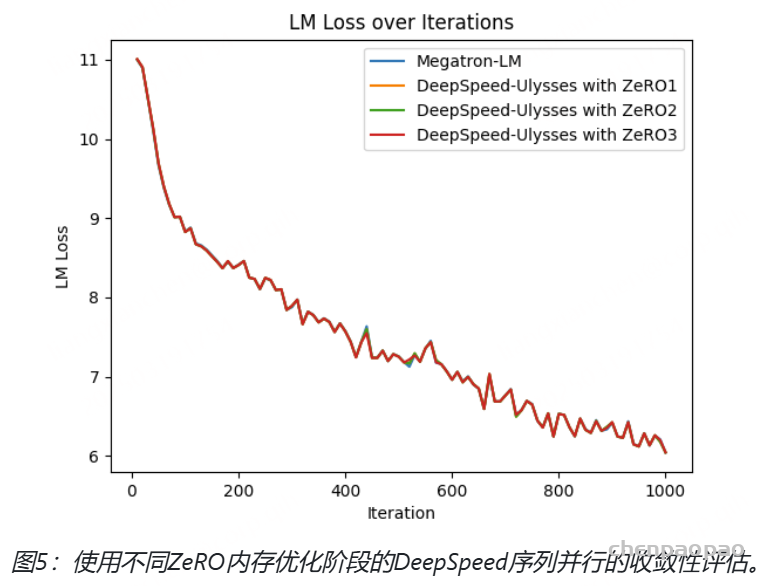
最后,图5显示了1.3亿参数GPT模型在32K序列长度下,使用序列并行度设置为4的情况下,在8个A100 GPU上的收敛性。对于DeepSpeed序列并行,我们使用不同的ZeRO阶段进行了收敛性评估。DeepSpeed序列并行是一种纯系统优化技术,用于实现长序列Transformer模型的训练,因此在训练模型质量上没有(负面)影响,并通过实验得到了验证,如图5所示。

图5:使用不同ZeRO内存优化阶段的DeepSpeed序列并行的收敛性评估。

DeepSpeed-Ulysses软件可用性

DeepSpeed-Ulysses只需进行少量简单代码更改来集成到您的代码中。下面是一个启用它的示例:

from deepspeed.sequence.layer import DistributedAttention

# 将原始的自注意(attn)替换为DeepSpeed-Ulysses的自注意

dist_attn = DistributedAttention(attn, get_sequence_parallel_group())

与其他支持序列并行的库(如Megatron-LM)相比,DeepSpeed-Ulysses不需要进行模型重构。 DeepSpeed-Ulysses已经完全与Megatron-DeepSpeed代码库集成并经过测试。这意味着如果您已经 在使用这个代码库来训练大型语言模型,您可以无缝地使用DeepSpeed-Ulysses训练具有极长序列的模型。

Paraformer-基于神经网络的热词方案

在使用语音识别服务进行语音转文字的过程中,大多数情况下模型能正确地预测高频词汇,但是对诸如人名地名、命名实体等词频较低或与用户强相关的词汇,模型往往会识别为一个发音相近的其他结果,这使得语音识别模型在日常生活中、垂直领域落地时并不完美。

contextual_paraformer模型

论文:FunASR: A Fundamental End-to-End Speech Recognition Toolkit   

NN热词定制化–CLAS

如何能够利用神经网络的建模与拟合能力,将用户自定义的热词纳入端到端语音识别模型的解码过程中,输出热词定制化的识别结果是ASR领域多年来备受关注的问题之一。在2018年,Google提出了Contextual Listen, Attend and Spell (CLAS)框架,在LAS这一经典的E2E ASR模型中进行了基于神经网络的热词定制化。CLAS主要通过两个核心思想进行热词建模:1.在训练阶段从label中随机采样文本片段模拟热词;2.在decoder的建模中引入额外的attention以建立文本隐状态与热词embedding的注意力连接;后续大量的工作证明了CLAS方案的有效性,在近几年出现了CPP-Network,NAM,Col-Dec CIF,Contextual RNN-T等等基于不同ASR基础框架的热词定制化工作,其算法核心均与上述两点一致。在对通义实验室自研的非自回归端到端语音识别模型Paraformer进行NN热词定制化支持时,我们首先采用了结合CLAS算法的方案,开源了工业级Contextual-Paraformer模型,有很强的热词召回能力。

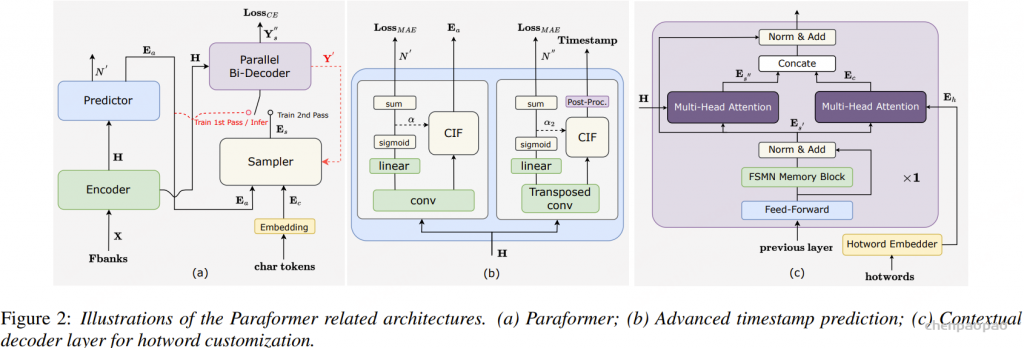
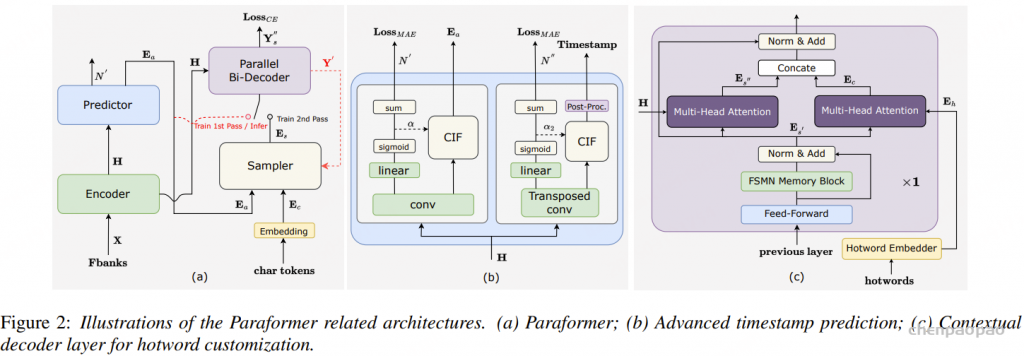
如图2(a)所示。Paraformer是一个单步非自回归(NAR)模型,结合了基于语言模型的快速采样模块,以增强NAR解码器捕捉标记之间依赖关系的能力。

Paraformer由两个核心模块组成:预测器和采样器。预测器模块用于生成声学嵌入,捕捉输入语音信号中的信息。在训练过程中,采样器模块通过随机替换标记到声学嵌入中,结合目标嵌入生成语义嵌入。这种方法使得模型能够捕捉不同标记之间的相互依赖关系,并提高模型的整体性能。然而,在推理过程中,采样器模块处于非激活状态,声学嵌入仅通过单次传递输出最终预测结果。这种方法确保了更快的推理时间和更低的延迟。

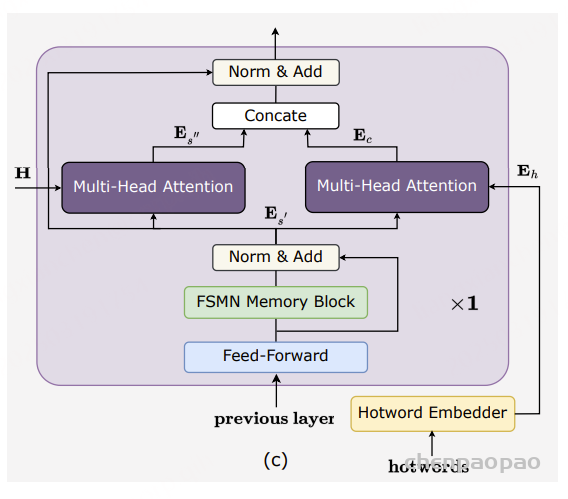
Contextual Paraformer提供了通过利用命名实体自定义热词的功能,从而增强了激励机制,并提高了召回率和准确性。为了扩展基本的Paraformer模型,增加了两个附加模块——热词嵌入器和解码器最后一层的多头注意力,如图2(c)所示。

我们将热词表示为 𝒘 = 𝒘₁, …, 𝒘ₙ,作为输入传递给我们的热词嵌入器 。热词嵌入器由一个嵌入层和一个LSTM层组成,LSTM层接受上下文热词作为输入,并通过使用LSTM的最后状态生成一个嵌入,记作 𝑬𝒉。具体来说,某个热词首先被输入到热词嵌入器中,生成一系列隐藏状态。然后,我们使用最后一个隐藏状态作为热词的嵌入,捕捉输入序列的上下文信息。

  • 步骤1:Embedding 层将每个 token 映射为一个密集向量:xi=EmbedLayer(wi)(i=1…n),输出形状:[n × dₑₘ_bₑd]
  • 步骤 2:向 LSTM 编码将整个 token 序列输入到一个单向 LSTM(或 GRU)中:hi​=LSTM(xi​,hi−1​)
  • 步骤 3:取 LSTM 的最后隐藏状态作为表示:Eh​=hn​ 这是一个固定长度向量(维度 d_h),代表整个热词含义。

为了捕捉热词嵌入 𝑬𝒉 与 FSMN 记忆块最后一层的输出 𝑬𝒔′ 之间的关系,我们采用了多头注意力模块。然后,我们将 𝑬𝒔′ 和上下文注意力 𝑬𝒄 连​​接起来。此操作在公式中形式化:

我们使用一维卷积层( C​o​n​v​1​d )来降低其维数以匹配隐藏状态 𝑬𝒔′ ,后者作为后续层的输入。值得注意的是,除了这一修改之外,我们的 Contextual Paraformer 的其他流程与标准 Paraformer 的流程相同。

在训练过程中,热词会在每个训练批次中从目标中随机生成。至于推理,我们可以通过向模型提供命名实体列表来指定热词。

CT-Transformer:

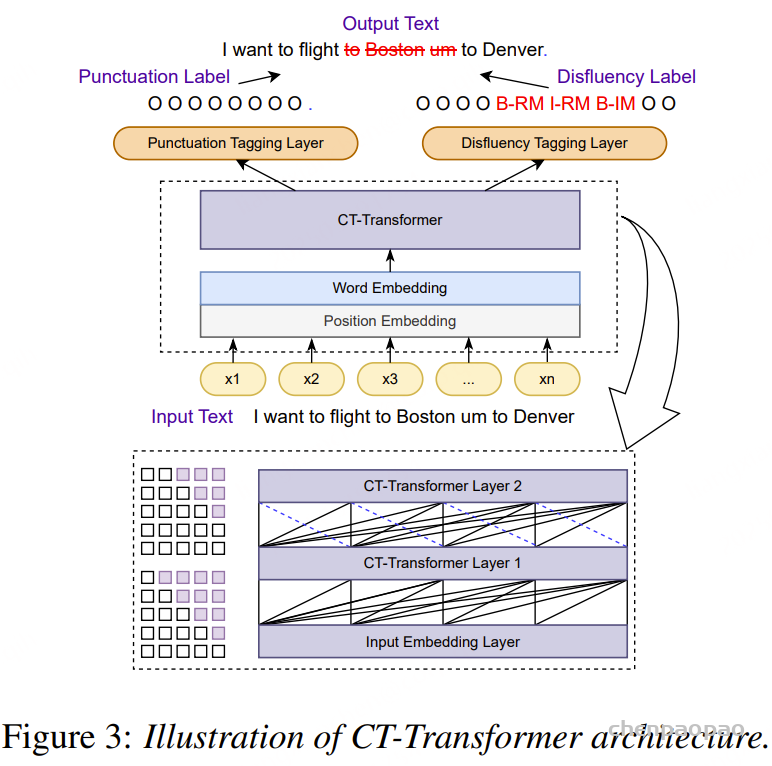
CT‑Transformer 旨在实时联合完成标点预测与非流畅语(disfluency)检测,并通过可控延迟机制确保满足流式输出约束,提升下游应用(如对话系统、翻译)对 Partial Decode 的实时性支持

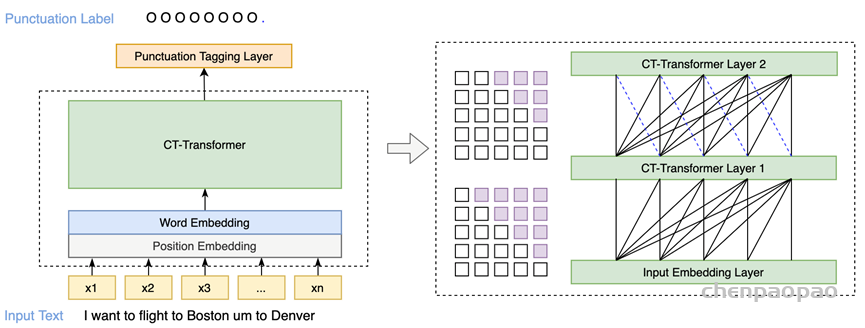
Controllable Time-delay Transformer是达摩院语音团队提出的高效后处理框架中的标点模块。本项目为中文通用标点模型,模型可以被应用于文本类输入的标点预测,也可应用于语音识别结果的后处理步骤,协助语音识别模块输出具有可读性的文本结果。

Controllable Time-delay Transformer 模型结构如上图所示,由 Embedding、Encoder 和 Predictor 三部分组成。Embedding 是词向量叠加位置向量。Encoder可以采用不同的网络结构,例如self-attention,conformer,SAN-M等。Predictor 预测每个token后的标点类型。

在模型的选择上采用了性能优越的Transformer模型。Transformer模型在获得良好性能的同时,由于模型自身序列化输入等特性,会给系统带来较大时延。常规的Transformer可以看到未来的全部信息,导致标点会依赖很远的未来信息。这会给用户带来一种标点一直在变化刷新,长时间结果不固定的不良感受。基于这一问题,我们创新性的提出了可控时延的Transformer模型(Controllable Time-Delay Transformer, CT-Transformer),在模型性能无损失的情况下,有效控制标点的延时。

CT‑Self‑Attention 的核心目标是:限定每一层可访问的未来 token 数量,从而控制模型的整体延迟。

引入一个控制 mask M,对不允许访问的位置打分为 −∞,得到:

新一代 SeACo-Paraformer 模型

热词定制化 (Hotword Customization)是针对低频偏僻词语识别而出现的语音模型研究。通过基于WFST或神经网络的热词定制化方案,模型允许用户在识别语音时预设一些已知的先验词汇,将识别结果中发音相近的词汇识别或修正为用户预期的结果。本文介绍阿里巴巴通义实验室语音团队自研的新一代基于神经网络的热词定制化模型SeACo-Paraformer(Semantic-Augmented Contextual-Paraformer),较前一代基于CLAS的Contextual-Paraformer有着生效稳定,训练灵活,召回率更高等优势。

WFST热词激励方案从解码过程入手,召回稳定,但是需要在ASR模型推理之外进行基于N-gram的解码,并且对于一些训练数据中出现较少的词,ASR模型提供的后验概率过低,导致候选路径中没有包含待激励的词,此时基于WFST的热词增强大概率失效。

在Contextual-Paraformer开源一年之后,我们进一步开源新一代的NN热词定制化模型SeACo-Paraformer,旨在解决随机初始化CLAS模型生效不稳定的问题,同时进一步提升热词召回率。

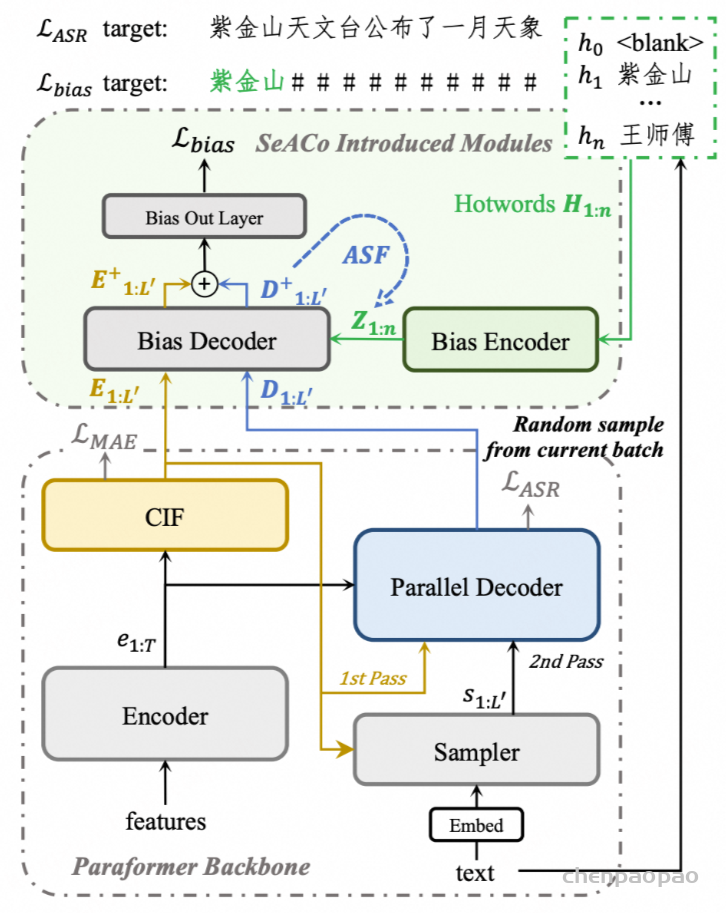
SeACo-Paraformer在Paraformer的encoder-predictor-decoder框架中引入了用于热词建模的bias decoder,通过与感知热词位置的label计算loss进行显式的热词预测训练,在解码阶段将热词后验概率与原始ASR后验概率进行加权融合,实现了更加稳定的热词召回。

NN热词方案对decoder状态与热词embedding进行attention计算以捕捉相关性,在热词数量上升时attention会由于稀疏问题导致注意力分散,SeACo-Paraformer利用了bias decoder中深层attention的score进行了注意力预计算与筛选(Attention Score Filtering,ASF),实验表明ASF能够缓解热词数量增加导致的召回性能损失。

考虑一个语音特征 x1:T​ 和对应的文本y1:L​,我们在Paraformer推理过程中保留CIF输出 E1:L′​ 和并行解码器隐藏状态(在输出层之前)D1:L′​:

然后,从大小为 bs 的 y1:L​ 批次中随机采样出 n 个热词,记作 H1:n​。我们在这里使用4个超参数来控制采样过程:rb​ 用于控制批次采样的比例,其他批次的前向传播将使用默认的热词 ⟨blank⟩;ru​ 类似于rb​,但在一个活跃批次内部的发音级别进行控制,活跃批次中平均采样的热词数量为 ru×bs+1(其中一个是默认的热词);lmin​ 和 lmax​ 用于控制采样热词的最小和最大长度。

然后,热词列表中的字符序列会通过偏置编码器进行嵌入,偏置编码器包含一个嵌入层(与ASR嵌入共享参数)和一个LSTM层。

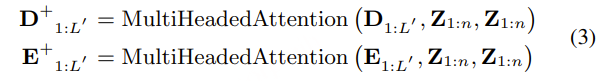
Z1:n​∈Rn×d 被去除维度并在第0维度上重复以进行批处理计算。接下来进入SeACo-Paraformer的主要部分。在偏置解码器内部,热词的偏置信息通过注意力机制引入到声学嵌入 E1:L′​ 和解码器隐藏状态 D1:L′​ 中。

偏置解码器由多个多头注意力层和前馈层组成。通过偏置声学嵌入和偏置解码器隐藏状态,可以通过输出层获得偏置概率 PASR1:L′​。需要注意的是,一个额外的标记(计为#,表示无偏)会被添加到ASR输出词汇表中,以标记非热词位置的输出。

根据偏置概率 Pb1:L′​,可以使用热词位置感知准则来更新与偏置相关的参数,其中非热词位置的标签被替换为 #(如图 1 中的 Lbias​ 所示)。

在冻结经过充分训练的 Paraformer 模型的情况下,我们通过引入偏置输出层、偏置解码器和偏置编码器,并使用随机采样的热词及其对应目标进行训练,使 ASR 系统具备热词上下文化能力。值得注意的是,偏置相关参数的训练是独立于 ASR 训练的,因此可以使用专门的热词数据(例如低频语言短语)和训练策略,而不会影响 ASR 的整体性能。

对于使用给定热词列表进行 SeACo-Paraformer 推理的第 i 步,我们得到语境化 ASR 的最终合并概率为:

当没有传入热词或未检测到热词时,SeACo-Paraformer仅使用 𝐏A⁢S⁢Ri 。 λ 是一个可调参数,用于调整信任偏差解码器输出的程度。

在实际应用中,随着输入的热词数量的扩大,热词激活的性能会相应下降——偏见解码器内的交叉注意很难在 ASR 解码器输出 𝐃1:L′ 和大规模稀疏热词嵌入 𝐙1:n 之间建立正确的联系。为了使 SeACo-Paraformer 能够使用大规模热词列表进行热词定制,我们提出了注意分数过滤(ASF)策略。首先对全热词列表进行偏见解码器推理,得到注意分数矩阵 𝐀∈RL×n ,其中 L 是输出 token 的长度, n 是热词的数量。然后,我们将 L 中各个步骤的分数相加,得到每个热词的注意分数。根据注意分数,我们可以挑选出最活跃的 k 热词,从而进行真正有效的偏见解码器推理。与细粒度的上下文知识选择相比,我们的偏差解码器由多个交叉注意层组成,我们发现最后一层的分数对于过滤最有效。

热词理论上无限制,但为了兼顾性能和效果,建议热词长度不超过10,个数不超过1k,权重1~100

Paraformer-时间戳模型

如图2(a)所示。Paraformer是一个单步非自回归(NAR)模型,结合了基于语言模型的快速采样模块,以增强NAR解码器捕捉标记之间依赖关系的能力。

Paraformer由两个核心模块组成:预测器和采样器。预测器模块用于生成声学嵌入,捕捉输入语音信号中的信息。在训练过程中,采样器模块通过随机替换标记到声学嵌入中,结合目标嵌入生成语义嵌入。这种方法使得模型能够捕捉不同标记之间的相互依赖关系,并提高模型的整体性能。然而,在推理过程中,采样器模块处于非激活状态,声学嵌入仅通过单次传递输出最终预测结果。这种方法确保了更快的推理时间和更低的延迟。

Timestamp Predictor:

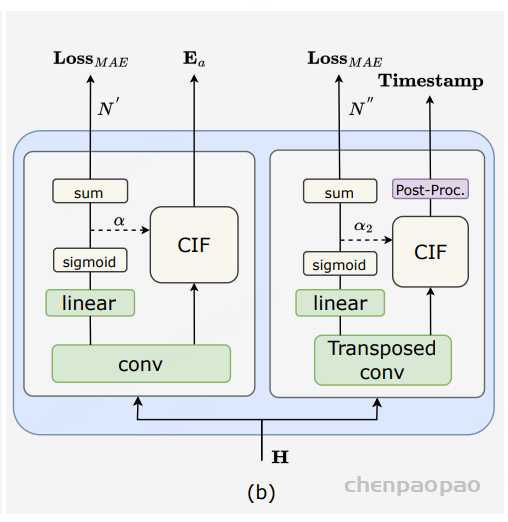
准确的时间戳预测是 ASR 系统的关键功能。然而,传统的工业 ASR 系统需要额外的混合模型来进行力对齐 (FA) 以实现时间戳预测 (TP),从而增加计算量和时间成本。FunASR 提供​​了一个端到端的 ASR 模型,通过重新设计 Paraformer 预测器的结构来实现准确的时间戳预测,如图2 (b) 所示。我们引入了一个转置卷积层和 LSTM 层来对编码器输出进行上采样,并通过后处理 CIF 权重 α2 来生成时间戳。我们将两个fireplaces 之间的帧视为前一个标记的持续时间,并根据α₂标出静音部分。此外,FunASR还发布了一个类似强制对齐的模型TP-Aligner,该模型包括一个较小的编码器和一个时间戳预测器。它接受语音和相应的转录作为输入,以生成时间戳。

我们在AISHELL和60,000小时工业数据上进行了实验,以评估时间戳预测的质量。用于衡量时间戳质量的评估指标是累积平均偏移(AAS)。我们使用了一个包含5,549个手动标记时间戳的测试集,将提供的模型与使用Kaldi训练的FA系统进行时间戳预测性能比较。结果显示,Paraformer-TP在AISHELL上优于FA系统。在工业实验中,我们发现提出的时间戳预测方法在时间戳准确性方面与混合FA系统相当(差距小于10毫秒)。此外,这种单次解决方案对于商业使用非常有价值,因为它有助于减少计算和时间开销。

1. CIF 模块的核心机制:

CIF 模块通过以下步骤实现时间戳预测:

  • 权重预测:模型为每一帧预测一个权重 α_t,表示该帧对当前词的贡献程度。
  • 累积积分:将连续帧的权重 α_t 累加,直到总和达到预设的阈值 β。
  • 触发发射:一旦累积权重达到阈值 β,模型将当前累积的帧级特征 h_t 加权求和,生成一个词级的表示 c_u。
  • 重复过程:继续上述过程,直到处理完所有帧,生成完整的词级序列。

这种机制允许模型在不依赖自回归的情况下,确定每个词的边界,实现高效的并行解码。

2. 时间戳的生成:

在 FunASR 中,时间戳的生成过程如下:

  • 上采样编码器输出:引入转置卷积层和 LSTM 层,对编码器输出进行上采样,增强时间分辨率。
  • 后处理 CIF 权重:通过对 CIF 权重 α2 进行后处理,确定每个词的起止时间。
  • 静音部分的标注:根据 α2 的值,标注出静音部分,进一步提升时间戳的准确性。

此外,FunASR 还提供了一个名为 TP-Aligner 的模型,用于在输入语音和对应转写文本的情况下,生成时间戳。

通过 CIF 权重 α 后处理确定词的起止时间

CIF 权重 α 表示每一帧对当前输出 token(如汉字或子词)的贡献程度。在推理过程中,模型会累积连续帧的权重 α_t,直到总和达到或超过一个预设的阈值 β(通常为 1)。此时,模型认为已经收集了足够的信息来生成一个输出 token。

为了确定每个词的起止时间,可以按照以下步骤进行后处理:

  1. 初始化:设置累积权重 accumulator = 0,记录当前 token 的开始帧 start_frame。
  2. 遍历帧序列:对于每一帧 t,执行以下操作:
    • 将当前帧的权重 α_t 加到 accumulator 上。
    • 如果 accumulator < β,继续累积。
    • 如果 accumulator ≥ β,记录当前帧 t 作为当前 token 的结束帧 end_frame。
    • 将 accumulator 减去 β,设置 start_frame = t + 1,开始下一个 token 的累积。
  3. 计算时间戳:根据帧率(例如,每帧 10ms),将 start_frame 和 end_frame 转换为时间戳,得到每个词的起止时间。

这种方法允许模型在不依赖自回归的情况下,确定每个词的边界,实现高效的并行解码。


🤫 标注静音部分

静音部分通常对应于 CIF 权重 α 值较低的帧。为了标注静音部分,可以采用以下策略:

  1. 设定阈值:选择一个合适的阈值(例如 0.01),用于判断帧是否为静音。
  2. 遍历帧序列:对于每一帧 t,检查其权重 α_t:
    • 如果 α_t < 阈值,标记该帧为静音。
    • 否则,标记该帧为语音。
  3. 合并连续静音帧:将连续的静音帧合并为一个静音段,记录其起止时间。

这种方法可以有效地识别语音中的静音部分,对于语音活动检测(VAD)和语音分割等任务具有重要意义。

Monotonic-Aligner 模型:FunASR发布了一个类似强制对齐的模型TP-Aligner,该模型包括一个较小的编码器和一个时间戳预测器。它接受语音和相应的转录作为输入,以生成时间戳。

模型地址:FunASR/funasr/models/monotonic_aligner/model.py

模型权重:https://modelscope.cn/models/iic/speech_timestamp_prediction-v1-16k-offline

本模型为Paraformer-large-长音频版的衍生模型,通过较小参数量的encoder与上采样cif predictor实现了时间戳预测功能,方便用户自由搭建ASR链路中的功能环节。

其核心点主要有:

  • Upsample Predictor 模块:在低帧率模型中predictor产生的帧级别权重可能存在预测不稳定的问题,表现为首尾帧出字与连续帧出字,这为基于cif权重的时间戳预测带来了困扰。本模型
    • (1) 在predictor的线性层之前引入了反卷积升采样模块与lstm模块,在多倍帧率的情况下预测权重;
    • (2) 通过scaled cif对权重进行尺度缩小与平滑,使得cif权重不表现为一个peak而是一段累积过程。通过上述两个操作得到了能用于时间戳预测的帧权重。
  • 基于约5w小时工业数据训练的时间戳预测模型,鲁棒性更强,时间戳准确率更高。

TP-Aligner 的工作流程如下:

  1. 输入处理:接收音频信号和对应的文本转录。
  2. 特征提取:通过轻量级编码器提取音频的高层次特征。
  3. 上采样处理:使用转置卷积层和 LSTM 层对编码器输出进行上采样,增强时间分辨率。
  4. 时间戳预测:结合文本转录信息,预测每个词或子词的起止时间。

DPO为什么会让大语言模型输出变长

摘自:https://zhuanlan.zhihu.com/p/5830338806

总的来说,DPO让模型输出变长主要可以分为以下几个原因:

  1. RM和模型评测的长度偏好。不管是Reward Model还是当前用与评测的模型(即便是GPT4)都会存在比较明显的长度偏好,即倾向于给更长的回答一个更高的分数。这一点已经有非常多工作给出过分析了。
  2. 训练数据本身长度分布不均衡。实战过程中往往就是用RM进行排序构造训练数据,RM的长度偏好就是会导致训练数据中容易出现chosen比rejected更长的情况。训练数据的长度差异(chosen比rejected长)就会导致训练后模型输出变长。
  3. 数据长度差异导致的reward被高估或低估。《Eliminating Biased Length Reliance of Direct Preference Optimization via Down-Sampled KL Divergence》中发现,DPO的算法本身也存在对response长度的依赖,chosen和rejected之间的长度差异可能会导致reward被高估/低估(overestimated or underestimated rewards)。即,当chosen过短时,reward会被低估,而当chosen过长时,reward会被高估。
  4. DPO算法本身的长度敏感性。《Length Desensitization in Direct Preference Optimization》中提到,response长度会影响到似然概率的大小,并且进一步影响到训练优化方向:当chosen更长时,DPO会往chosen的方向进行优化(增大chosen概率),从而使输出变长;而rejected更长时,DPO会往远离rejected的方向优化(降低rejected概率),但却未必会让输出变短。

如何解决:

  1. RM的优化:前面讲的都是对DPO进行长度控制的工作,但对RM本身的长度偏好进行优化的工作没有看到太多,如果大家有看到相关的也可以在评论区提供一下。如果将RM本身的长度偏好问题解决的话,那就可以极大程度上解决训练数据的长度分布均衡问题了。
  2. 数据的优化:有些工作会在数据构造时对长度进行综合考虑,如对RM打分进行长度归一后再排序、采样多个答案进行排序时根据均值方差限制chosen的长度等,通过这些方式可以减少长度差距过大的情况。如果数据本身的长度分布均衡了,也能一定程度上减缓这种问题。
  3. 训练算法上的优化:如果从LD-DPO的分析上看,即便数据分布比较均衡,只要存在长度差异,DPO本身的长度敏感性就是会导致模型输出变长,因此可能还是需要一些算法层面的优化,比如在DPO阶段加入SFTloss就是一种简单有效的方法,在很多公开的大模型技术报告中也都有用到该方法。另外R-DPO、SamPO和LD-DPO的长度控制效果都算是比较好的方法。

DPO面临的一个问题(准确来讲是一种现象)就是会让大模型的输出变长,且多轮DPO的话会让模型输出越来越长。本篇文章我们将结合搜集到的一些相关工作,探讨一下业界对该现象的一些分析,探究这一现象产生的根本原因,以及如何有效地解决。

首先我们需要思考一个问题,模型输出变长到底是不是一件坏事?一般来说,输出变长可能会使内容更加详细,信息量更丰富,回复质量更高,用户体验更好。但如果过度长,输出了很多冗余信息,回复质量没有明显改善,反而带来了推理成本的增加,回复变得啰嗦,用户体验反而变差了。

因此,无论是从用户体验的角度还是多轮DPO能否run下去的角度,做好长度控制都是有必要的。

相关工作

先简要介绍一些相关工作,然后后面详细总结。

1.《Disentangling Length from Quality in Direct Preference Optimization》(简称R-DPO)

在这之前的一些RL的工作也有分析过长度爆炸问题,但该文章可能是第一个提出DPO的长度爆炸问题的。

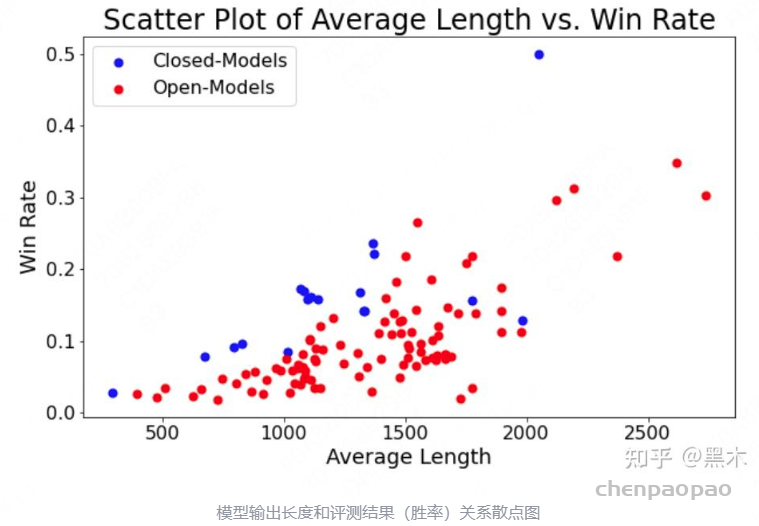
文章中发现,无论是RL训练中使用的Reward Model还是用来评测模型效果的打分模型(如GPT-4)都表现出明显的长度偏好,即会给更长的答案一个更高的分数(如下图)。且在一些公开的DPO训练数据集中,chosen的长度往往会比rejected更长,而这可能就是DPO后的模型输出长度明显比SFT模型更长的原因。

为了解决这个问题,该文章提出了一种长度正则化的策略,即在计算loss的时候添加一个长度正则项,从而避免模型对长度的过度拟合,公式如下:

其中 |yw| 表示chosen的长度, |yl| 表示rejected的长度,从公式中可以看出,当chosen与rejected的长度差距越大,正则项的值越大,从而实现对长度的“惩罚”效果。

从文章中的实验结果可以看出,该方法确实可以在尽可能减少性能损失的前提下有效解决长度增长问题。(有时还是会损失一定的性能。)

2.《SimPO: Simple Preference Optimization with a Reference-Free Reward》(简称SimPO)

陈丹琦团队的工作,直接去掉了reference model,用长度归一的方式实现长度控制。其loss如下:

文章中提到了很多输出长度相关的内容,但核心贡献并不是做长度控制,而是用一种更简单高效的方法实现偏好训练。从公式上看,和原始DPOloss相比主要有两处不同,一个是分母从reference model的logp替换成了长度,另外就是增加了一个 γ ,类似一个offset的作用。不过其中对chosen和rejected的reward做长度归一的部分,直觉上看起来应该是能起到一定的长度控制效果的。

不过从论文中的实验结果看,该方法的效果还是比较好的(当时声称训出最强8B大模型),但与标准DPO相比似乎并没有实现长度控制的效果。

3.《Eliminating Biased Length Reliance of Direct Preference Optimization via Down-Sampled KL Divergence》(简称SamPO)

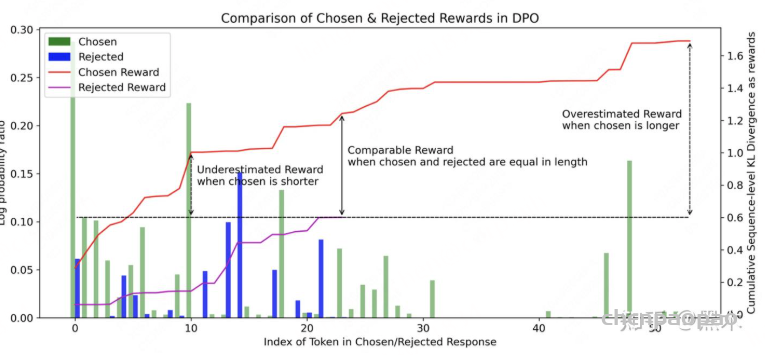
这篇论文对DPO后长度变长的问题进行了一定的分析,提出的一个核心观点是:DPO的算法本身也存在对response长度的依赖,chosen和rejected之间的长度差异可能会导致reward被高估/低估(overestimated or underestimated rewards)。即,当chosen过短时,reward会被低估,而当chosen过长时,reward会被高估。

这篇工作中提出的一种方式就是在token级别下采样的概率特征,以计算正则化的KL散度,从而减少因pair长度不同而导致的奖励偏差。其loss的计算如下:

从公式可以看出,该方法的核心就是在计算reward的时候不再是全部token的条件概率的累乘(取log后就是累加),而是随机采样公共数量的token进行累乘。这样即便chosen和rejected长度不同,参与reward计算的token数是一样的。也就是说,在SamPO训练过程中,魔都看到的chosen和rejected相当于是完全等长的。

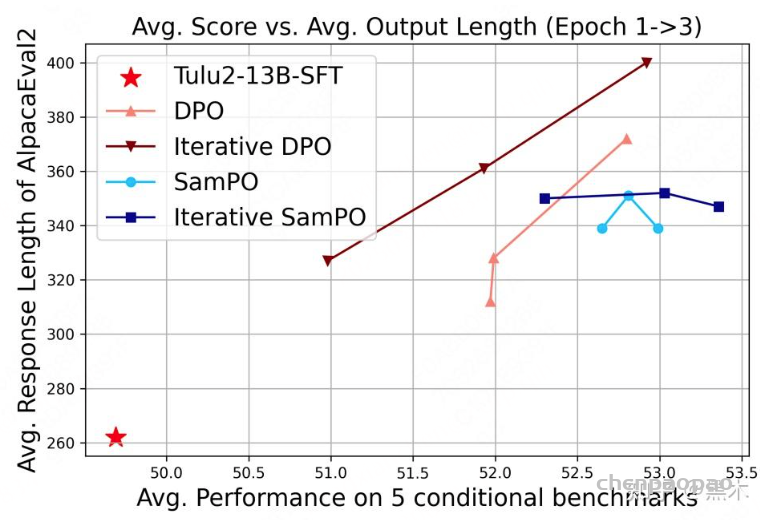
从文章中的实验结果看,该方法确实能有效控制模型输出长度的增长,甚至在多轮DPO依然能有效控制长度。但是在性能上看依然做不到碾压标准DPO的效果。

但该方法有两个风险便是:

  1. 本身DPO就存在一定的波动,随机下采样可能会导致训练的稳定性不强;
  2. 随机采样必然会导致一些信息缺失,如果采样时舍弃掉了一些非常重要的token可能会影响到训练效果。

4.《Length Desensitization in Direct Preference Optimization》(简称LD-DPO)

该论文可能是第一个从理论层面分析DPO后模型输出变长的原因的,其核心分析主要包括两方面:

  1. DPO的梯度优化方向和chosen/rejected的似然概率成反比。
  2. Response长度对似然概率的影响极大,因此长度会直接影响reward的计算,并影响到DPO的优化方向。

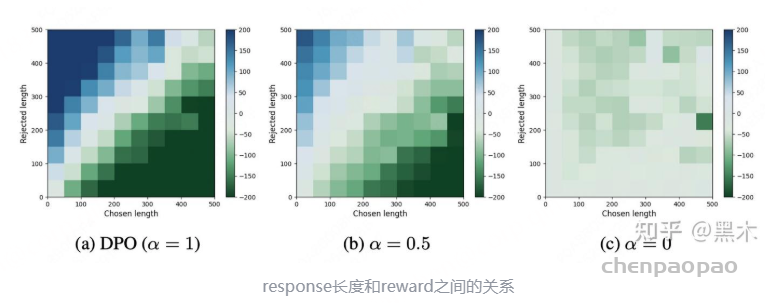
上图是一个对训练数据的统计热力图,图中,横坐标为chosen的长度,纵坐标为rejected的长度,颜色深度表示 log⁡πθ(yl|x)−log⁡πθ(yw|x) 值的大小。第一张图(a)是标准DPO,可以看出长度差距越大时,颜色越深,也就说明长度差距可能会导致reward计算产生bias,且长度差距越大这种bias越大。而这种bias会进一步影响到DPO的优化方向,使其往输出更长的方向进行优化。

该文章提出的解决方案是在计算似然概率时对长度进行解耦,将更长的答案拆成“公共长度部分”和“额外部分”,并进一步将后者拆分为真实偏好和冗余偏好,并对其中的冗余部分进行降权操作,通过一系列推导后将 πθ(y|x) 转化为如下的形式(可近似理解为完整似然概率部分与公共长度部分似然概率的加权和):

从公式上看,这种方式可以让长度更长的那个response(不管是chosen还是rejected)实现一定的缩放(),减少长度带来的似然概率的断崖式下滑,使其与另一个短response(不受影响)之间更具可比性,同时又不会像SamPO那样完全舍弃掉额外部分的信息。

从论文中的实验结果看,这种方法能够实现比较好的长度控制,且模型性能还能有一定提升,并且可以通过调整参数 α 可以实现不同程度的控制效果。另外文章还提出一个比较有意思的发现,就是过度冗余的回答可能反而会损害模型的推理能力,他们通过这种方法控制长度后,模型的推理能力也有明显提升。

其他工作

除此之外,还有一些工作直接在数据上做文章,通过控制chosen和rejected的长度差距来实现长度控制,如《Following Length Constraints in Instructions》(简称LIFT-DPO)。以及在一些开源模型的技术报告中我们也能看到一些相关的长度控制方法,如在利用RM打分排序时就综合考虑长度问题等,这些数据工作就不再详细展开了。

如何实现有效的长度控制?

  1. RM的优化:前面讲的都是对DPO进行长度控制的工作,但对RM本身的长度偏好进行优化的工作没有看到太多,如果大家有看到相关的也可以在评论区提供一下。如果将RM本身的长度偏好问题解决的话,那就可以极大程度上解决训练数据的长度分布均衡问题了。
  2. 数据的优化:有些工作会在数据构造时对长度进行综合考虑,如对RM打分进行长度归一后再排序、采样多个答案进行排序时根据均值方差限制chosen的长度等,通过这些方式可以减少长度差距过大的情况。如果数据本身的长度分布均衡了,也能一定程度上减缓这种问题。
  3. 训练算法上的优化:如果从LD-DPO的分析上看,即便数据分布比较均衡,只要存在长度差异,DPO本身的长度敏感性就是会导致模型输出变长,因此可能还是需要一些算法层面的优化,比如在DPO阶段加入SFTloss就是一种简单有效的方法,在很多公开的大模型技术报告中也都有用到该方法。另外R-DPO、SamPO和LD-DPO的长度控制效果都算是比较好的方法。

最后结合我自己的一些尝试来直接对比一下上面的四种方法:

  1. R-DPO是通过加正则项的方式实现长度控制,说是正则项,但其实只是一个常数,其原理相当于是对每条数据加上一个权重(文章中也提到了这点),即当chosen和rejected长度差距大时降低该数据的权重。也就是说,该方法其实是让模型减少对长度差距大的数据的学习权重。这种方法确实可以实现一定的长度控制效果,但必然会减少一些数据的利用率,这可能也是训练效果会有一定损失的原因。我自己尝试了一下该方案,实验下来确实可以做到长度控制效果,但大部分情况下性能都会比标准DPO差一些。
  2. SimPO是用长度归一来替换Reference Model的KL约束,理论上和长度控制其实没有太大关系,更多的是简化训练和提升性能。实验结果确实也体现了并不会比标准DPO更短。(该方法热度很高,但网络上褒贬不一,很多人表示无法复现结果。)根据我自己实验经验来看,跑出好的结果需要仔细调参,论文推荐的超参不一定适合所有情况。
  3. SamPO是直接用下采样的方式,强行将模型视角下的长答案变得和短答案一样长,该方法给人的直观感受就是长度控制效果肯定很好,但是很可能会有性能损失。但我自己实验下来,长度控制效果和R-DPO差不多,但是性能也比较不稳定,更换随机种子就会导致性能产生波动。我也尝试过将随机下采样改为top-k采样,即保留概率最大的top-k个token,但效果并不会比随机更好(这么直觉的方法可能论文作者也尝试过了)。
  4. LD-DPO的方法是只对答案过长的部分做了解耦和降权处理,通过降低过长部分的权重来实现整个条件概率的缩放,看起来是四种方法中实现最优雅的一种,既降低了长度差异带来的reward bias问题,又不会丢弃信息,相当于是用极小的代价实现了概率缩放目的。从论文中贴出的结果看,确实也是性能最强的一个,长度控制效果也是最好的。但论文代码没有开源,所以没有实验验证。但从公式上看复现难度应该不是很大,有能力的可以尝试复现一下看看效果。

transformers 的 generate() 方法实现多样化文本生成:参数含义和算法原理解读

这个类对外提供的方法是 generate(),通过调参能完成以下事情:

  • greedy decoding:当 num_beams=1 而且 do_sample=False 时,调用 greedy_search()方法,每个step生成条件概率最高的词,因此生成单条文本。贪婪搜索对于输出相对较短且创造力并非优先考虑的任务非常有效。然而,当生成较长的序列时,它会失效,因为它会开始自我重复。
  • multinomial sampling:当 num_beams=1 且 do_sample=True 时,调用 sample() 方法,对词表做一个采样,而不是选条件概率最高的词,增加多样性。
  • beam-search decoding:当 num_beams>1 且 do_sample=False 时,调用 beam_search() 方法,做一个 num_beams 的柱搜索,每次都是贪婪选择top N个柱。
  • beam-search multinomial sampling:当 num_beams>1 且 do_sample=True 时,调用 beam_sample() 方法,相当于每次不再是贪婪选择top N个柱,而是加了一些采样。
  • diverse beam-search decoding:当 num_beams>1 且 num_beam_groups>1 时,调用 group_beam_search() 方法。
  • constrained beam-search decoding:当 constraints!=None 或者 force_words_ids!=None,实现可控文本生成。

参数列表

核心代码详见:generate()入口函数定义, GenerationConfig类

1.控制生成长度的参数

参数类型缺省值含义
max_lengthint20表示 prompt + max_new_tokens 累加的最大长度,如果max_new_tokens也设置了,会覆盖这个参数
max_new_tokensint生成部分的tokens的最大长度 (忽略prompt部分的长度)
min_length0表示 prompt + min_new_tokens 累加的最小长度,如果min_new_tokens也设置了,会覆盖这个参数
min_new_tokensint生成部分的tokens的最小长度 (忽略prompt部分的长度)
early_stoppingbool, strFalse对于beam search方法的控制终止的配置。
False: 当有’num_beams’个候选生成,则终止
True: 应用一些启发式规则判断不能找到更好的生成候选,来提前终止生成
“never”: 当判断没有更好的可生成的candidate, beam search 过程终止
max_timefloat执行生成的最大时间(s秒数)
stop_stringsstr, array[str]配置模型生成的终止字符串,当模型生成参数配置的字符串,则终止生成。

2. 控制生成策略的参数

参数类型缺省值含义
do_sampleboolFalseTrue: 生成过程使用采样逻辑
False: 使用greedy做生成

若 do_sample=False(默认),系统按贪心或 beam search 策略选择 最高概率的那个 token;若 do_sample=True,在每一步生成时,会根据模型输出的概率分布随机采样下一个 token,而不是总是选择最高概率项
num_beamsint1设置beam search 束的数量。如果是1不做beam search 搜索。
num_beams = N 表示在生成过程中 同时保留 N 条候选序列(“beams”)
num_beam_groupsint1为了保证生成的多样性,将num_beams 设置成多组。参考文献: https://arxiv.org/pdf/1610.02424.pdf
penalty_alphafloatcontrastive search decoding的配置项,用于平衡生成置信度和衰减的惩罚
dola_layersstr, List[int]str :
“None”: 不使用dola
“low” : 较低的一半layers, 最多20层使用dola
“high”: 较高的一半layers, 最多20层使用dola
List[int] : 通过指定一个index数组,指定dola 层
“low”: 提升长答案的task,
“high”:提升短答案的task

3.cache配置参数

参数类型缺省值含义
use_cacheboolTrue是否使用KV cache 加速推理速度
cache_implementationstr指定cache实现的name,在调用generate()时,实例化cache。
”static”: [StaticCache]
“offloaded_static”: [OffloadedStaticCache]
”sliding_window”: [SlidingWindowCache]
“hybrid”: [HybridCache]
“mamba”: [MambaCache]
”quantized”:[QuantizedCache]
cache_configCacheConfig , dictNonecache类使用的参数
return_legacy_cacheboolTrue当DynamicCache 被使用时,是否返回历史的和新格式的cache

4.操作模型输出logit的配置参数

参数类型缺省值含义
temperaturefloat1.0这个值用于建模下一个token的概率, 这个值被设置在generation_config.json文件中
仅在 do_sample=True 时生效,控制 logits 经过 softmax 后分布的平滑/尖锐程度
top_kint50筛选最高概率的top k个词, 这个值被设置在generation_config.json文件中
top_pfloat1.0当设置<1时,筛选概率最高的token,累加概率不超过top_p的token
min_pfloat配置筛选概率最低的一批token, 累加概率不超过min_p,裁剪掉,该配置相当于top_p的反向操作
typical_pfloat1.0测量两个分布的相似性: 预测下一个目标token的概率 and 预测下一个随机Token的条件概率期望。如果设置<1,则筛选最典型的token。
epsilon_cutofffloat0.0按设置的值,卡掉低概率值的token,一般设置为:3e-4 to 9e-4
eta_cutofffloat0.0混合局部典型性采样和epsilon采样方法
diversity_penaltyfloat0.0只对group beam search方法生效,如果在某个特定时间生成的token与任何beam 组生成的token一致,则beam的score减去这个值
repetition_penaltyfloat1.01.0 默认不惩罚
encoder_repetition_penaltyfloat1.0对于不在原始输入的token,指数级的惩罚
length_penaltyfloat1.0对于beam 类的生成方法的长度惩罚,由于序列score是 log likelihood , > 0 倾向于更长的 <0 倾向于更短的
no_repeat_ngram_sizeint0如果大于0, 则对应的size的ngram只能出现1次
bad_words_idsList[List[int]]列出不允许生成的tokens_id
force_words_idsList[List[int]] or List[List[List[int]]]必须被生成的words_ids。 如果配置List[List[List[int]]] 设置对于每个token的约束
renormalize_logitsboolFalse对于所有的logits做后处理后,是否要再做下normalize
constraintsList[Constraint]通过定义一个List[Constraint] 对象数组,来确保输出是在某些限制的场景下。一般用于安全的场景
forced_bos_token_idintmodel.config.forced_bos_token_id强制跟在decoder_start_token_id之后的第一个token,对多语言模型是有用的
forced_eos_token_idint or List[int]model.config.forced_eos_token_id当生成的token达到max_length上限时,最后一位输出的token
remove_invalid_valuesboolmodel.config.remove_invalid_values是否移出可能生成的nan and inf 值,配置这个会减慢生成速度
exponential_decay_length_penaltytuple(int, float)指数级增加长度的惩罚,tuple(start_index, decay_factor) start index 指示惩罚的开始i,decay_factor 指数衰减的惩罚因子
suppress_tokensList[int]通过设置禁止的token的logit为-inf,来禁止token被sample
begin_suppress_tokensList[int]通过设置首位禁止的token的logit为-inf,来禁止首位这部分token被采样到,进而导致被生成
forced_decoder_idsList[List[int]]一个整数pair的数组,格式[生成index, token_index]指示固定位置强制生成某个token,例如[[1, 123]] 第二个位置总是生成token 123
sequence_biasDict[Tuple[int], float]token list -> bias的映射,正的bias提升几率,负的bias降低几率
token_healingboolFalse对prompt尾部的token做相似替换,以提升生成质量
guidance_scalefloat是一个缩放因子,当>1时,这个因子越高,越鼓励模型生成与prompt接近的samples 。
watermarking_configBaseWatermarkingConfig or dict对输出结果增加水印

5.输出结果配置参数

参数类型缺省值含义
num_return_sequencesint1对于batch中的每个元素,设置独立计算的返回的sequence的数量
output_attentionsboolFalse是否返回所有的attention的向量
output_hidden_statesboolFalse是否返回所有网络层的隐层状态
output_scoresboolFalse是否返回prediction scores
output_logitsbool是否返回未处理过的的logit score
return_dict_in_generateboolFalse除了返回生成序列,是否还返回a [`~utils.ModelOutput`]

6.生成时使用的特殊token的配置参数

参数类型缺省值含义
pad_token_idintpadding token ID
bos_token_idintbeginning -of – sequence token ID
eos_token_idUnion[int, List[int]]end-of-sequence token ID

6.辅助生成的配置参数(投机采样)

参数类型缺省值含义
is_assistantboolFalse指定是否模型是一个assistant(draft) model
num_assistant_tokensint20投机采样过程,每次迭代 assistant model 要输出多少个token,给到目标模型做check。配置更高的值,如果assistant model 效果好 能带来更好的加速比
num_assistant_tokens_schedulestrconstant“heuristic” : 当所有投机采样的token都正确时,将num_assistant_tokens增加2,否则减少1。
“constant”: num_assistant_tokens 保持固定不变
“heuristic_transient”: 类似于启发式方法,每次生成调用,都置成初始化的num_assistant_tokens值
assistant_confidence_thresholdfloat0.4当assistant model预估当前token的置信度 小于 阈值时,提前终止assistant model的生成
prompt_lookup_num_tokensint作为候选token 要输出的token的数量
max_matching_ngram_sizeint2match prompt的最大ngram的数量
assistant_early_exitint
assistant_lookbehindint10如果设置为正整数,则重新编码过程将额外考虑最后的assistant_lookbehind个辅助标记,以正确对齐标记。此设置仅可在推测解码中使用不同的分词器时使用。
target_lookbehindint10如果设置为正整数,则重新编码过程将额外考虑最后的target_lookbehind个辅助标记,以正确对齐标记。此设置仅可在推测解码中使用不同的分词器时使用。


如有整理错误,欢迎指正~

语音理解模型—OSUM

OSUM: Advancing Open Speech Understanding Models with Limited Resources in Academia

大型语言模型(LLMs)在各种下游任务中取得了显著进展,启发了业界对语音理解语言模型(speech understanding language models, SULMs)的研发,以期实现基于语音情感、性别等副语言的高表现力交互。然而,大多数先进的SULM是由行业头部公司开发的,消耗大规模的数据和计算资源。而这些资源在学术界并不容易获得。此外,虽然训练好的模型和推理代码被开源了,但训练框架和数据处理流程依然缺乏透明度,这也为进一步研究产生了障碍。在本研究中,我们提出了OSUM,一个开放的语音理解模型,旨在探索在有限的学术资源下训练SLUM的潜力。OSUM模型将Whisper编码器与Qwen2 LLM相结合,支持广泛的语音任务,包括语音识别(ASR)、带时间戳的语音识别(SRWT)、语音事件检测(VED)、语音情感识别(SER)、说话风格识别(SSR)、说话者性别分类(SGC)、说话者年龄预测(SAP)和语音转文本聊天(STTC)。通过采用ASR+X训练策略,OSUM通过同时优化模态对齐和目标任务,实现了高效稳定的多任务训练。除了提供强大的性能,OSUM还强调透明度,提供公开可用的代码,并详细介绍了数据处理流程,以期为学术界提供有价值的参考,旨在加速先进SULM技术的研究和创新。

方案设计 

OSUM模型将Whisper编码器与Qwen2 LLM相结合,支持广泛的语音任务,包括语音识别(ASR)、带时间戳的语音识别(SRWT)、语音事件检测(VED)、语音情感识别(SER)、说话风格识别(SSR)、说话者性别分类(SGC)、说话者年龄预测(SAP)和语音转文本聊天(STTC)。通过采用ASR+X训练策略,OSUM通过同时优化模态对齐和目标任务,实现了高效稳定的多任务训练。

模型结构

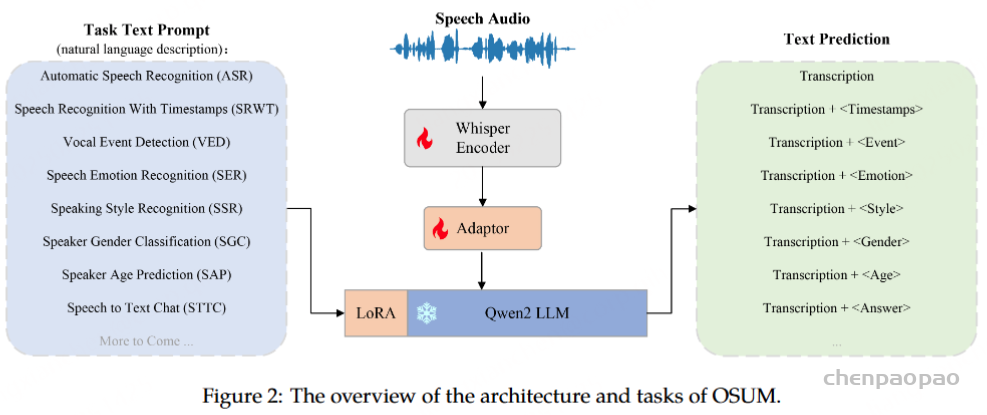
模型的输入包括语音和自然语言提示。不同于 Whisper 和Qwen-Audio 依靠指令标签,Osum采用描述性文本,将所有八个支持任务转换为图2所示。当前,我们的模型仅支持基于文本的响应,但是音频输出功能正在积极开发。

如图2所示,OSUM模型由一个Speech Encoder、一个Adaptor和一个LLM组成。在训练过程中,Speech Encoder和Adaptor中的所有参数都会更新,而大语言模型则使用LoRA方法进行微调。各部分具体配置如下:

  • Speech Encoder: Whisper-Medium (769M);
  • Adaptor: Conv1D * 3 + Transformer * 4,4倍下采样;
  • LLM: Qwen2-7B-Instruct带LoRA。LoRA hyperparameters-α, rank, and dropout ratio are set to 32, 8, and 0.1,

多任务监督训练

训练过程包括两个阶段:

首先,在没有LLM的情况下,对原始的Whisper模型进行多任务监督微调,多任务数据微调了 Whisper ,以确保OSUM模型的更快收敛。此外,此阶段使我们能够验证多任务数据的可靠性。具体来说,我们扩展了Whisper的指示标签,以适应更多的任务,每个前向推理仅执行一个任务。

其次,将微调后的Whisper编码器与Qwen2大语言模型相结合,构建出完整的OSUM系统,然后使用更大的数据集进行进一步的监督训练。

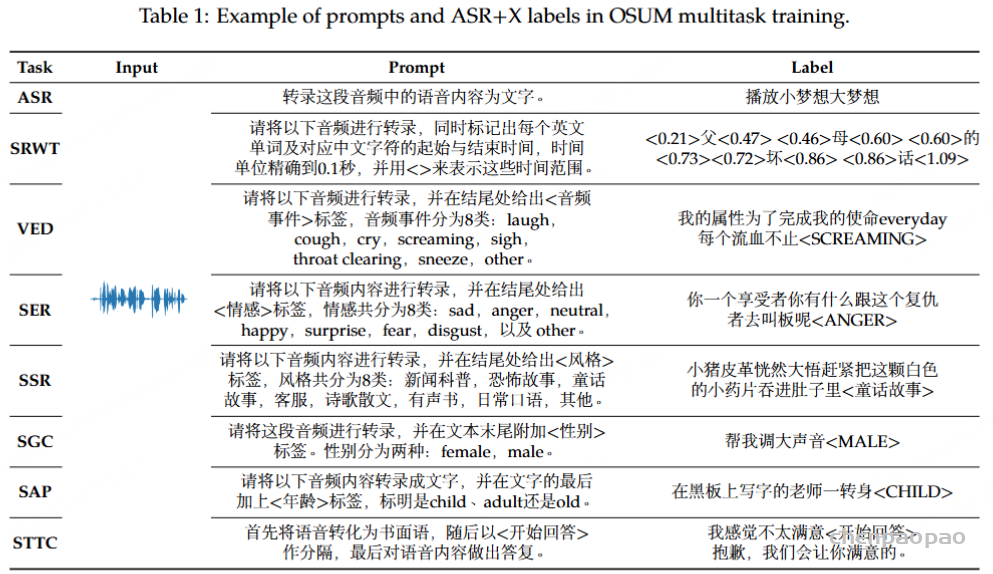
OSUM模型的输入包括一段语音和一个自然语言描述的prompt,而输出在现阶段仅支持文本回复,音频输出功能正在开发中。为节省计算资源,OSUM的多任务训练引入了一种“ASR+X”范式,即同时训练ASR任务和一个附加任务X。这在加速训练的同时,允许执行X任务时参考文本和声学两种特征,从而提升性能和训练稳定性。“ASR+X”范式是在LLM的自回归框架内通过调整预测标签来实现的,无需对模型架构或损失函数进行修改。执行不同的X任务是通过给LLM不同的自然语言prompt来实现的,每个任务有5个候选prompt,训练时随机选择一个。prompt的示例如表1所示。

训练数据

OSUM旨在使用多样化的语音数据集进行多任务训练,目标是构建一个能够在对话场景中全面理解输入语音的统一模型。多任务训练过程使各个任务能够从共享学习中获益,从而提升模型的整体性能。有关用于训练的数据集的详细信息见表2所示,本版本模型的训练数据规模大约为5万小时。

技术性能

总览

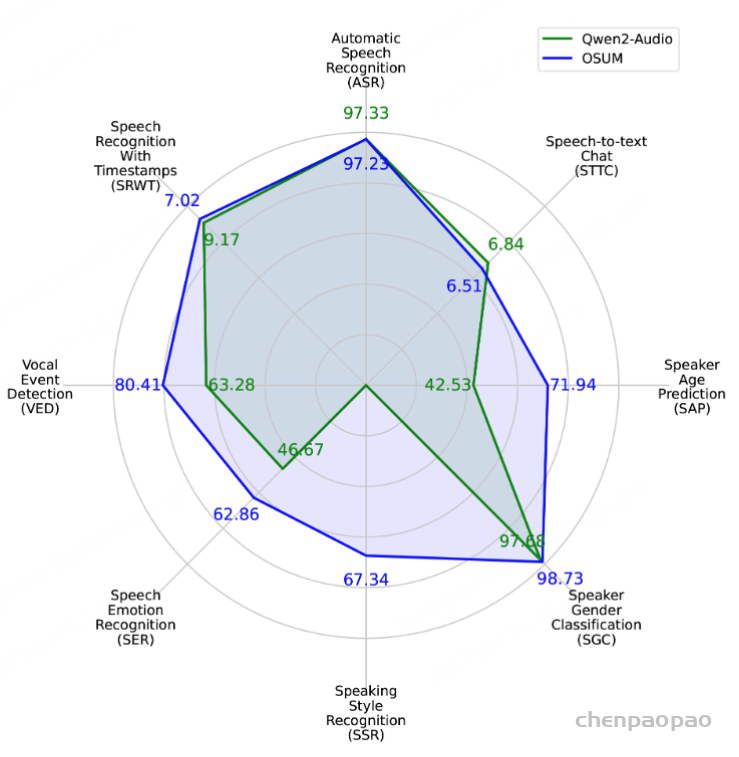
如图2所示,OSUM 模型和Qwen2-Audio 相比,在大多数任务中,尽管 OSUM 使用的计算资源和训练数据明显更少,但它的表现优于Qwen2-Audio。

图2 OSUM与Qwen2-Audio各项任务性能对比的雷达图。雷达图中每个模型各项任务的值是基于公开测试集和内部测试集的平均结果得出的

各项指标与性能演示

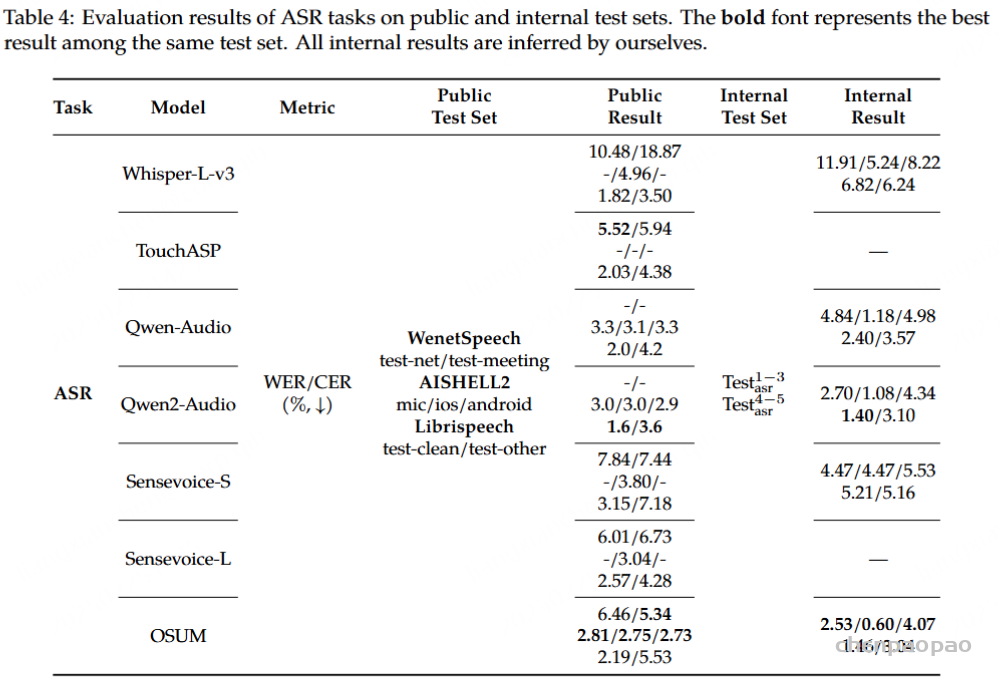
ASR(语音识别):如表4所示,OSUM在中文ASR上表现优越,具体地,在WenetSpeech test meeting、3个AISHELL-2子测试集以及4个内部使用的SpeechIO测试集上优于其他模型。OSUM在英语测试集上性能也可与SenseVoice-S相媲美。值得注意的是,这些结果是在使用少得多的训练数据的情况下取得的。此外,我们发现,即使在训练过程中未纳入中英混语料数据集,OSUM在识别中英混语音方面也展现出了令人惊讶的出色能力。

表4公开测试集和内部测试集上ASR任务的评估结果。加粗字体表示同一测试集中的最佳结果。所有内部测试结果均由我们自行推理得出

表45公开测试集和内部测试集上多任务的评估结果。每个测试集的最佳结果都用粗体突出显示。蓝色字体显示的结果以及内部测试集的结果,均是我们使用原始发布的模型自行推理得出的

SRWT(带时间戳的语音识别):如表5所示,OSUM模型在SRWT任务上的性能显著优于Whisper-Large-v3,相对优势达到了36.70%,并且也超过了Qwen-Audio。此外,OSUM的表现甚至略微超过了GMM-HMM模型,而后者在时间戳预测任务被广泛使用。另外,此功能不仅使得OSUM能够以端到端的方式预测时间戳,更重要的是,它引导OSUM模型理解了“时间”这一概念。在将来,我们将会利用这一能力继续开发更灵活的应用,例如判断音频中何时出现了语音事件,何时出现了说话人转换等。

VED(语音事件检测):我们首先在公开测试集ESC-50和VocalSound上评估OSUM的性能。ESC-50包含大量的非人声音频事件,我们将它们归类为“其他”。表45示的实验结果表明,OSUM可以成功地将这些非人声音频事件归类为“其他”。此外,在VocalSound数据集上的结果显示,OSUM与Qwen2-audio相比虽然存在一定差距,但也取得了超过80%的准确率。值得注意的是,为更加符合真实使用场景,我们的训练数据是语音和音频事件拼接而成,但公开测试集只有孤立的音频事件而没有说话语音。即便存在这一不匹配的情况,OSUM模型的在公开测试集上的结果也证明了其有效性和泛化性。与公开测试集不同,我们人工录制了同时包含语音和声学事件的内部测试集。表45结果表明,PANNs由于其仅为孤立音频事件检测而设计,在我们内部测试集中基本处于不可用状态。Qwen2-audio的表现相对较好,但也出现了性能下降。相比之下,OSUM模型在公开测试集和内部测试集上都取得了较为均衡的结果,展现出了更强的泛化能力。

SER(语音情感识别):如表45示,对于SER任务,使用公开数据集的实验中,OSUM在MER2023测试集上展现出了卓越的性能,超过了一些近期的公开基准模型。在MELD数据集上,OSUM的性能略低于SenseVoice-L模型,这很可能是因为后者在更大规模的语音情感数据集上进行了训练。此外,OSUM在内部测试集上的结果与EmoBox模型相当,显著优于其他对比方法。但是,我们也观察到,厌恶和恐惧这两种情感尤其难以识别,其归因于这两种情感的训练数据更加稀缺,也容易和其他情感混淆。

SSR(说话风格识别):表5中实验表明,OSUM所采用的声学-文本双模态风格分类方法的表现显著优于GLM-4-9B-Chat所采用的单文本模态方法,这充分证明了“ASR+X”策略的价值。现阶段OSUM能够区分八种风格:“新闻科普”,“恐怖故事”,“童话故事”,“客服”,“诗歌散文”,“有声书”,“日常口语”以及“其他”。我们详细分析了测试集上各类别的准确率,发现OSUM在对“新闻科普”、“有声书”、“童话故事”以及“客服”风格类别上表现出色;然而,在“诗歌散文”、“恐怖故事”类别上仍有提升空间。有趣的是,我们发现从实际测试的主观体验上来说,OSUM风格分类正确率是超过测试集的,总体来说可以让人满意。

SGC(说话者性别分类):在SGC公开测试集上的结果表明,OSUM在AISHELL-1测试集上达到了100%的准确率。这一结果在一定程度上表明该任务上存在说话人过拟合现象。此外,在Kaggle测试集上,我们的方法略优于Qwen2-Audio。但在我们的内部测试集上,OSUM的性能略低于Qwen2-Audio,但依然超过了95%。总之,OSUM在SGC任务上展现出了不错的性能,而且实测效果很少出现性别判断错误的情况。

SAP(说话者年龄预测):在SAP任务上,由于我们发现青少年和成年人的声学相似度非常高,这使得有效区分他们变得很复杂。因此,我们将年龄分为三类:儿童、成年人和老年人。尽管我们努力调试了prompt,但Qwen2-Audio在Kaggle测试集和我们的内部测试集上,年龄分类准确率都较低。这可能是因为这些模型对年龄的分类过于细致,从而影响了Qwen2-Audio模型的最终效果。表4中结果显示,OSUM在Kaggle测试集上显著优于Qwen2-Audio,达到了76.52%的准确率。在我们的内部测试集上OSUM分类准确率虽然略有下降,但仍然超过了Qwen2-Audio。这表明OSUM在不同的数据上表现出了很强的泛化能力。

STTC(语音转文本聊天):如表5所示,在STTC任务中,我们在所有测试集上都遵循了AirBench的评估协议。这包括提供音频查询的文本以及两个不同答案的文本,让基于文本的大语言模型(LLM)给出1到10的主观评分。这两个答案一个是真实回复,另一个是语音大语言模型(SULM)生成的答案。测试结果表明,在AirBench的官方speech子测试集上,OSUM的得分虽然低于Qwen2-Audio,但也处于一个合理范围。这主要是因为我们没有使用英语对话数据进行训练,目前的得分完全依赖于大语言模型自身的表现。反之,在我们内部的中文对话测试集上,OSUM的表现优于Qwen2-Audio,这充分证明了OSUM在中文对话任务上性能是不错的。总体而言,我们的OSUM模型在对话能力方面与Qwen2-Audio相当。

更多功能

OSUM理解大模型在将来会提供更多的功能,可作为通用语音打标工具使用。此外,我们正在开发的功能包括:

  1. 同时支持ASR+X和单X任务模式,在执行单X任务打标时推理速度更快。
  2. 同时输出ASR+X1+X2+..Xn的多任务打标模式,一次性提供几乎全部所需标签。
  3. 增加更多的理解任务。

Step-Audio: 语音大模型

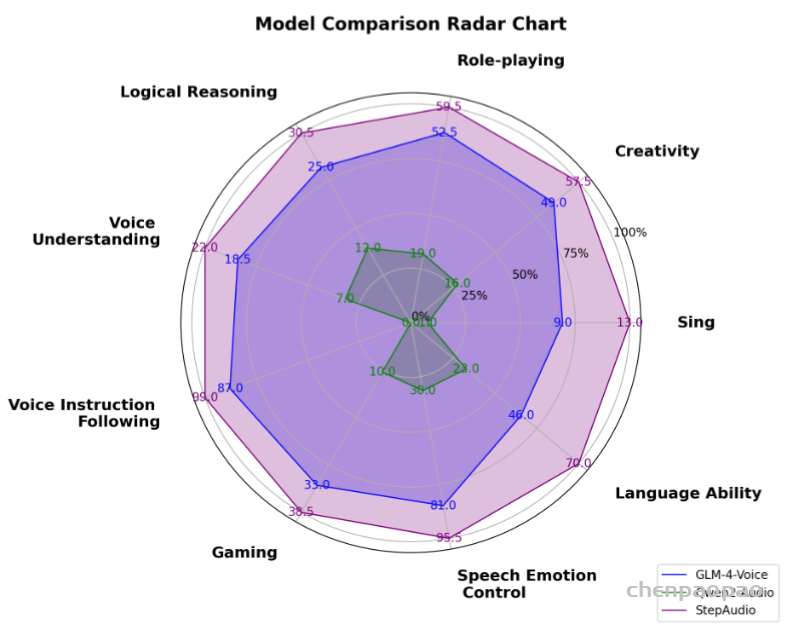
由阶跃星辰发布并开源的130B参数的语音大模型Step-Audio(跃问),具备实时对话、生成语音的风格控制(情感、方言、唱歌等),此外还具体工具调用、角色扮演的能力。

阶跃星辰:Step-Audio 是业界首个集语音理解与生成控制一体化的产品级开源实时语音对话系统,支持多语言对话(如 中文,英文,日语),语音情感(如 开心,悲伤),方言(如 粤语,四川话),可控制语速及韵律风格,支持RAP和哼唱等。其核心技术突破体现在以下四大技术亮点:

  • 1300亿多模态模型: 单模型能实现理解生成一体化完成语音识别、语义理解、对话、语音克隆、语音生成等功能,开源千亿参数多模态模型 Step-Audio-Chat。
  • 高效数据生成链路: 基于130B 突破传统 TTS 对人工采集数据的依赖,生成高质量的合成音频数据,并同步开源首个基于大规模合成数据训练,支持 RAP 和哼唱的指令加强版语音合成模型 Step-Audio-TTS-3B ,该模型具有增强的指令遵循功能以控制语音综合的能力。
  • 精细语音控制: 支持多种情绪(如生气,高兴,悲伤)、方言(包括粤语、四川话等)和唱歌(包括 RAP、干声哼唱)的精准调控,满足用户对多样化语音生成的需求。
  • 扩展工具调用: 通过 ToolCall 机制和角色扮演增强,进一步提升其在 Agents 和复杂任务中的表现。
端到端语音相互作用的人类评估。

模型组成

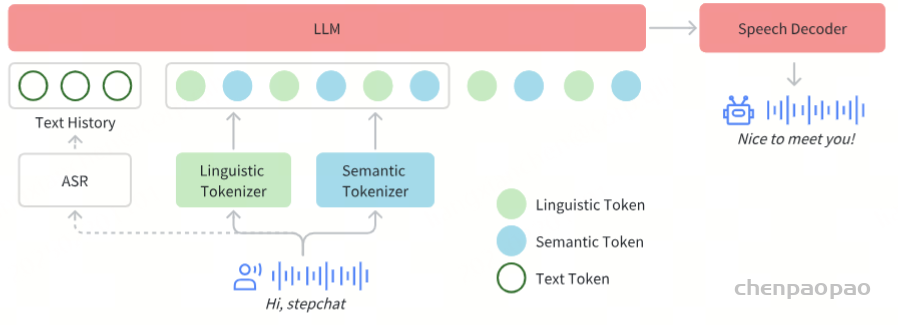
图2 采用了AQTA(音频输入,文本输出) + TTS框架 进行实时语音对话

Step-Audio的体系结构。 Step-Adio主要由三个组成部分组成:语音令牌,LLM和语音解码器。语音令牌器负责将输入语音离散到令牌中。LLM模型接收文本和语音令牌,输出文本,而语音解码器生成波形输出。

传统的语音对话系统通常采用包括ASR的级联建筑,LLM和TTS模块。但是,我们提出的模型在训练阶段进行了全面的多模式培训以及对文本和音频的一致性,已经具有端到端的语音对话功能。尽管对替代设计进行了广泛的探索,但我们最终采用了AQTA(音频输入,文本输出) + TTS框架 进行实时语音对话,如图2所示,这是由以下考虑的驱动的:

  • 高质量的纯净对话数据的稀缺性:纯净对话数据的可用性有限,再加上其受限的场景,限制了端到端语音对话模型的训练效率。
  • 输出语音的可控性和自定义:通过引入TTS模块,我们可以灵活地控制语音参数,例如音色和音调,以满足用户的个性化需求,同时不断增强模型的表现力能力。

在Step-Audio系统中,音频流采用Linguistic tokenizer【语义】(码率16.7Hz,码本大小1024)与Semantice tokenizer【声学】(码率25Hz,码本大小4096)并行的双码本编码器方案,双码本在排列上使用了2:3时序交错策略。通过音频语境化持续预训练和任务定向微调强化了130B参数量的基础模型(Step-1),最终构建了强大的跨模态语音理解能力。为了实现实时音频生成,系统采用了混合语音解码器,结合流匹配(flow matching)与神经声码技术。此外,采用语音活动检测(VAD)模块提取声段。

Tokenizer

语言分词器用于提取结构化的高级表征,包括音素和语言特征;而语义分词器则用于编码语义和粗粒度的声学特征。

我们通过token级交错方法实现Linguistic token与Semantic token的有效整合。Linguistic tokenizer的码本大小是1024,码率16.7Hz;而Semantic tokenizer则使用4096的大容量码本来捕捉更精细的声学细节,码率25Hz。鉴于两者的码率差异,我们建立了2:3的时间对齐比例——每两个Linguistic token对应三个Linguistic token形成时序配对。

linguistic tokenization 利用 Paraformer 编码器的输出,该输出以 16.7 Hz 【60ms一帧】 的token 速率量化为离散表示。对于语义标记化,采用 CosyVoice的 tokenization ,该 tokenization 专门设计用于高效编码生成自然且富有表现力的语音输出所必需的特征,以 25 Hz 的标记速率运行。

语言模型

为了提升Step-Audio有效处理语音信息的能力,并实现精准的语音-文本对齐,我们在Step-1(一个拥有1300亿参数的基于文本的大型语言模型LLM)的基础上进行了音频持续预训练。

在多轮对话系统中,音频令牌和文本令牌之间的长度差异需要有效的处理策略。为了解决这个问题,历史信息最初是在系统输入之前使用ASR模型转录为文本格式的,从而优化了计算效率。但是,应注意的是,该模型架构保留了在需要时处理和利用音频标记作为历史上下文的能力。

语音解码器

Step-Audio语音解码器主要是将包含语义和声学信息的离散标记信息转换成连续的语音信号。该解码器架构结合了一个30亿参数的语言模型、流匹配模型(flow matching model)和梅尔频谱到波形的声码器(mel-to-wave vocoder)。为优化合成语音的清晰度(intelligibility)和自然度(naturalness),语音解码器采用双码交错训练方法(dual-code interleaving),确保生成过程中语义与声学特征的无缝融合。

实时推理管线

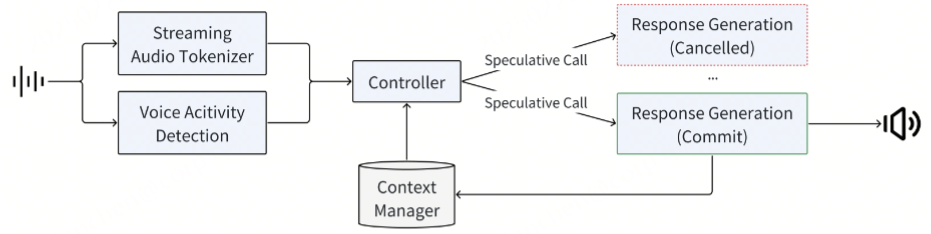
为了实现实时的语音交互,我们对推理管线进行了一系列优化。其中最核心的是控制模块(Controller),该模块负责管理状态转换、协调响应生成,并确保关键子系统间的无缝协同。这些子系统包括:

  • 语音活动检测(VAD):实时检测用户语音起止
  • 流式音频分词器(Streaming Audio Tokenizer):实时音频流处理。输入音频流是通过两个平行的令牌管道处理的,每个管道都采用固定持续分段。将所得令牌无缝合并为2:3交织比的单个序列。如果没有流音频令牌,根据音频输入的长度,推理时间将明显较慢。
  • Step-Audio语言模型与语音解码器:多模态回复生成
  • 上下文管理器(Context Manager):动态维护对话历史与状态。我们的系统利用文本转录而不是原始的音频令牌来实现历史上下文,因为它提供了更紧凑的表示(平均文本审计代币比率为1:14),提高性能,并启用更长的对话,对质量的影响最小的影响很小。 ASR异步将用户语音转录为文本,并保持准确,最新的对话历史记录。

为了减少交互延迟,系统会预先生成推测响应。这最大限度地减少了感知延迟并增强了响应速度,但代价是丢弃推测响应时偶尔会产生冗余计算。系统初始状态为 Silence ,等待用户输入。当语音激活检测 (VAD) 检测到活动语音时,系统将转换到 UserSpeaking 状态。在此状态下,流音频标记器 (Streaming Audio Tokenizer) 开始将音频转换为标记。如果用户短暂暂停,系统将进入 UserPaused 状态,并触发推测响应生成。通过预先生成响应以预期输入完成,系统可以在对话恢复时减少延迟。如果用户继续说话,则丢弃推测响应。一旦系统确信用户已结束说话,它将转换到 BotReplying 状态,提交最新的推测响应并输出其音频。如果被用户语音打断,系统将优先处理新的输入,同时保持对话的连续性。完成响应后,系统返回静默状态,准备进行下一次交互。经验分析表明,大约 40% 的推测响应能够成功提交。与非推测方法相比,此机制可将每次响应的延迟缩短约 500 毫秒。

数据集:

多模态预训练数据集整合了音频、文本、图像三大类数据资源。音频部分包含 1.1 万亿个音频连续数据(约 730 万小时)、1130 亿个 TTS(文本转语音)合成语音数据(约 70 万小时)、1050 亿个 ASR(自动语音识别)数据(约 65 万小时)和 3500 亿个音文交替数据(约 200 万小时)。文本数据总计 8000 亿个,涵盖网页文档、书籍、代码和专有资料。图像部分包含 8000 亿个图文配对/交替数据,来源于网页、书籍和专有资源。

三阶段训练

阶段 1:我们通过添加 5,120 个音频 token 来扩展预训练文本模型的词汇量,并集成预训练图像编码器,形成 Step-Omni 模型。在训练过程中,为了最大程度地降低文本模型能力的损失,文本模型主干网络的学习率始终保持在较低水平 (2e-5)。然而,嵌入和语言模型 (LM) 头的学习率设置为主干网络的五倍,以促进新添加 token 的更快收敛。同时,图像编码器在整个训练过程中保持冻结状态。在此阶段,音频、文本和图像数据的使用比例为 2:1:1,音频数据仅由纯音频延续任务组成。

Stage2:在 Stage1 阶段使用 1.2T 个 token 进行训练后,我们将音频文本交错数据纳入进一步训练,音频后续数据与音频文本交错数据的比例为 1:1。在此阶段,音频、文本和图像数据的比例仍为 2:1:1。

阶段 3:在阶段 2 阶段使用 800B token进行训练后,我们将 ASR 和 TTS 数据纳入进一步训练。音频连续数据、音文交织数据、ASR 数据和 TTS 数据的比例设置为 1:1:1:1。在此阶段,音频、文本和图像数据的比例调整为 4:3:3。此外,嵌入层和 LM 头的学习率与主干网络同步,采用余弦算法,学习率从 2e-5 递减至 5e-6。

后训练细节

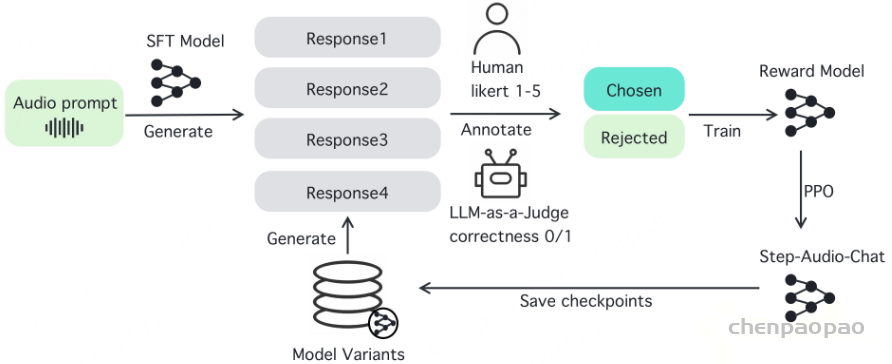
在后训练阶段,我们针对自动语音识别(ASR)与文本转语音(TTS)任务进行了专项监督微调(Supervised Fine-Tuning, SFT)。对于音频输入-文本输出(Audio Question Text Answer, AQTA)任务,我们采用多样化高质量数据集进行SFT,并采用了基于人类反馈的强化学习(RLHF)以提升响应质量,从而实现对情感表达、语速、方言及韵律的细粒度控制。

TTS模型:

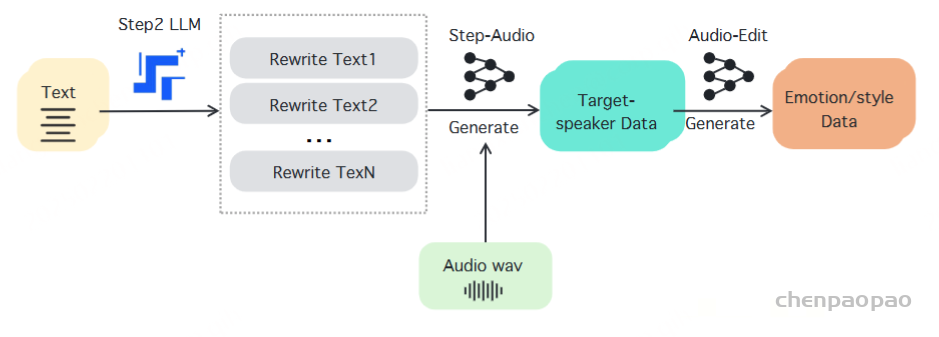
解决TTS任务中高质量语音数据的稀缺性

Training Detail:

与传统的语音合成(TTS)系统注重对说话人特征、情感表达、语言特征和风格元素的精细控制不同,我们的方法采用了基于聊天的范式和大型语言模型(LLMs)的训练方法。这一战略对齐显著增强了系统的灵活性,同时建立了一个可扩展的框架,以支持未来模型和数据的扩展,从而解决了语音合成系统在可扩展性方面的关键挑战。

监督的微调格式:

SFT格式包括三个基本组成部分:系统提示、人类输入和助手回复,采用两轮对话结构。在这种格式中,系统提示作为指定说话人属性和定义支持的指令标签的基础元素。人类输入和助手回复部分则专门用于处理文本内容和双词典表示。第一轮的文本和音频标记可以用来保持领域内说话人的音色和风格一致性,同时也支持领域外的零样本克隆。

指令标签 :

指令标签分为两种不同的类别:描述性标签和比较性标签。描述性标签用于控制语言、方言、声音和风格等方面,而比较性标签则用于情感和语速控制的层次化区分。描述性标签的数据是通过Step-Audio模型克隆生成的,支持包括日语、韩语、粤语、四川方言、可爱声音、说唱和唱歌等语言和风格。比较性标签的数据则是通过Audio Edit模型生成的,支持诸如快乐、愤怒、悲伤等情感,以及快慢等语速变化,每种变化都被分为五个层级。

我们使用第5.1.1节中概述的SFT数据,并采用一个具有30亿参数的模型,训练一个周期,初始学习率为 2×10⁻⁵。学习率采用余弦衰减策略进行调整,最低值设置为 2×10⁻⁶。

AQTA:

我们为AQTA任务应用了基于人类反馈的强化学习(RLHF),从而创建了Step-Audio-Chat模型,如图6所示。

Exploring Tokenizer for Audio Pretraining

研究了使用单码本的训练方法。在实验中,我们发现,当仅使用语义分词训练模型时,下一个分词的预测困惑度相对较低,并且生成内容与前文的语义一致性良好。然而,由于丢弃过多语义分词会导致声学信息大量丢失,后续通过声码器进行的音频恢复在音色和韵律方面会严重受损,导致听觉质量不佳。当仅使用语言分词进行训练时,声码器从模型的后续部分恢复的音频听起来不错,但下一个分词的预测困惑度非常高,并且后续部分与前文的语义一致性较差。

当使用交错的语义标记和语言标记进行训练时,语义标记确保了后续内容与前一上下文的语义一致性,而语言标记则确保了重建音频的听觉质量。由于语义标记和语言标记之间的相互参考,我们观察到当使用双码本训练时,与使用单码本相比,语义标记和语言标记的下一个标记预测困惑度都有所降低。

将语言离散标记和语义离散标记按 2:3 的比例分组交织,有助于加快训练损失的收敛速度。更重要的是,将语言标记扩展至 CosyVoice 语义标记,增强了模型理解和遵循多轮历史指令的能力,并有效缓解发音不清、吐字不清等问题,显著提升了 CosyVoice 单码性能。

说明:

用了AQTA(音频输入,文本输出) + TTS框架 情况下是如何实现多语言对话(如 中文,英文,日语),语音情感(如 开心,悲伤),方言(如 粤语,四川话),可控制语速及韵律风格,支持RAP和哼唱 ?

通过TTS【cosyvoice】代码可知,LLM的文本输出中会包含 {语言}【情感】 [语速] 这样的文本输出,然后TTS用于合成对应的音频: 使用[{}]的声音,根据这些情感标签的指示,调整你的情感、语气、语调和哼唱节奏

    self.sys_prompt_dict = {
        "sys_prompt_for_rap": "请参考对话历史里的音色,用RAP方式将文本内容大声说唱出来。",
        "sys_prompt_for_vocal": "请参考对话历史里的音色,用哼唱的方式将文本内容大声唱出来。",
        "sys_prompt_wo_spk": '作为一名卓越的声优演员,你的任务是根据文本中()或()括号内标注的情感、语种或方言、音乐哼唱、语音调整等标签,以丰富细腻的情感和自然顺畅的语调来朗读文本。\n# 情感标签涵盖了多种情绪状态,包括但不限于:\n- "高兴1"\n- "高兴2"\n- "生气1"\n- "生气2"\n- "悲伤1"\n- "撒娇1"\n\n# 语种或方言标签包含多种语言或方言,包括但不限于:\n- "中文"\n- "英文"\n- "韩语"\n- "日语"\n- "四川话"\n- "粤语"\n- "广东话"\n\n# 音乐哼唱标签包含多种类型歌曲哼唱,包括但不限于:\n- "RAP"\n- "哼唱"\n\n# 语音调整标签,包括但不限于:\n- "慢速1"\n- "慢速2"\n- "快速1"\n- "快速2"\n\n请在朗读时,根据这些情感标签的指示,调整你的情感、语气、语调和哼唱节奏,以确保文本的情感和意义得到准确而生动的传达,如果没有()或()括号,则根据文本语义内容自由演绎。',
        "sys_prompt_with_spk": '作为一名卓越的声优演员,你的任务是根据文本中()或()括号内标注的情感、语种或方言、音乐哼唱、语音调整等标签,以丰富细腻的情感和自然顺畅的语调来朗读文本。\n# 情感标签涵盖了多种情绪状态,包括但不限于:\n- "高兴1"\n- "高兴2"\n- "生气1"\n- "生气2"\n- "悲伤1"\n- "撒娇1"\n\n# 语种或方言标签包含多种语言或方言,包括但不限于:\n- "中文"\n- "英文"\n- "韩语"\n- "日语"\n- "四川话"\n- "粤语"\n- "广东话"\n\n# 音乐哼唱标签包含多种类型歌曲哼唱,包括但不限于:\n- "RAP"\n- "哼唱"\n\n# 语音调整标签,包括但不限于:\n- "慢速1"\n- "慢速2"\n- "快速1"\n- "快速2"\n\n请在朗读时,使用[{}]的声音,根据这些情感标签的指示,调整你的情感、语气、语调和哼唱节奏,以确保文本的情感和意义得到准确而生动的传达,如果没有()或()括号,则根据文本语义内容自由演绎。',
    }

VITA-1.5:GPT-4o级别的实时视觉和语音交互模型

[📖 VITA-1.5 Paper] [🤖 Basic Demo] [🍎 VITA-1.0]

[📽 VITA-1.5 Demo Show! Here We Go! 🔥]

引言

近年来,多模态大语言模型(MLLMs)在视觉和文本的结合上取得了显著进展。然而,随着人机交互需求的增加,语音在多模态对话系统中的作用变得愈发重要。语音不仅是信息传递的关键媒介,还能显著提升交互的自然性和便捷性。因此,如何将视觉和语音模态高效整合,实现高性能的多模态交互,成为了当前研究的重点。

VITA-1.5的提出正是为了解决这一挑战。通过精心设计的多阶段训练方法,VITA-1.5逐步训练大语言模型(LLM)理解视觉和语音信息,最终实现了流畅的视觉和语音交互。与现有模型相比,VITA-1.5不仅保留了强大的视觉-语言能力,还实现了高效的语音对话能力,显著加速了多模态端到端的响应速度。

VITA-1.5

模型架构

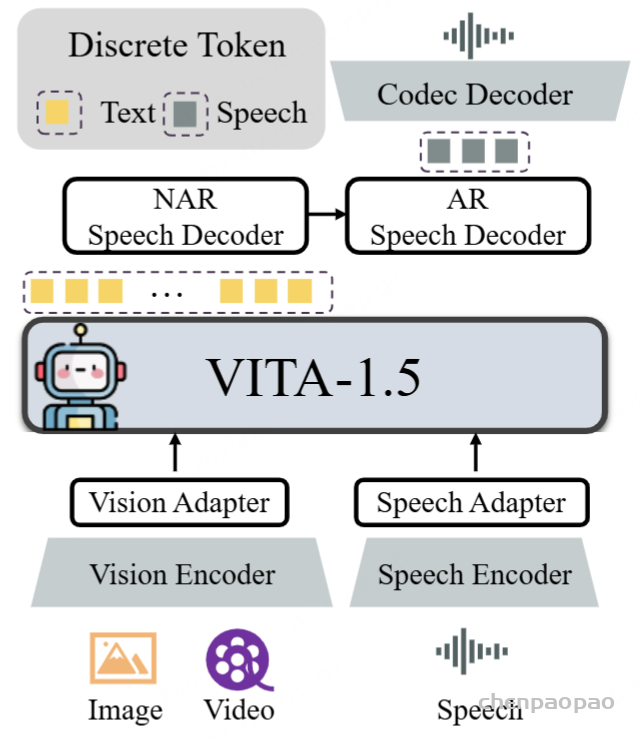
图 2:VITA-1.5 的整体架构。输入端由视觉和音频编码器及其连接到 LLM 的适配器组成。输出端有一个端到端的语音生成模块,而不是像初始 VITA-1.0 版本那样直接使用外部 TTS 模型。

VITA-1.5的整体架构如图2所示。输入侧与VITA-1.0版本相同,采用“多模态编码器-适配器-LLM”的配置。它将视觉/音频Transformer和多层连接器与LLM结合进行联合训练,旨在增强对视觉、语言和音频的统一理解。在输出侧,VITA-1.5拥有自己的端到端语音模块,而不是像原始VITA-1.0版本那样使用外部TTS模型。

视觉模态

视觉编码器:VITA-1.5采用InternViT-300M作为视觉编码器,输入图像大小为448×448像素,每张图像生成256个视觉标记。对于高分辨率图像,VITA-1.5采用动态分块策略捕捉局部细节,提高图像理解的准确性。

视频处理:视频被视为一种特殊的多图像输入。如果视频长度短于4秒,则均匀采样4帧;对于4到16秒的视频,每秒采样一帧;对于超过16秒的视频,均匀采样16帧。视频帧不应用动态分块,以避免过多的视觉标记影响处理效率。

视觉适配器:使用两层MLP将视觉特征映射到适合LLM理解的视觉标记。

音频模态

语音编码器:类似于[56],我们的音频编码模块由多个下采样卷积层(4倍下采样)和24个Transformer块(隐藏大小为1024)组成。下采样层有助于降低音频特征的帧率,提高LLM的处理速度。音频编码器约有350M参数,输出帧率为12.5Hz。使用Mel滤波器组特征作为音频编码器的输入,窗口大小为25ms,偏移为10ms。

语音适配器:由多个2倍下采样的卷积层组成。

语音解码器:使用TiCodec作为我们的编解码模型,定制了一个大小为1024的单码本。这种单码本设计简化了推理阶段的解码过程。编解码模型负责将连续语音信号编码为离散语音标记,频率为40Hz,同时能够将这些标记解码回采样率为24,000Hz的语音信号。

当前的LLM只能输出文本标记,语音生成能力要求LLM能够输出语音标记。为此,我们在文本标记后添加了两个语音解码器:1)非自回归(NAR)语音解码器,全局处理文本标记并建模语义特征,旨在生成语音标记的初始分布;2)自回归(AR)语音解码器,基于NAR解码器生成的语音信息逐步生成更高质量的语音标记。最终的语音标记序列通过编解码模型的语音解码器解码为连续语音信号流(波形)。我们为NAR和AR语音解码器采用了4个LLaMA解码层,隐藏大小为896,参数大小约为120M。

训练数据

如表1所示,多模态指令微调的训练数据涵盖了广泛的类别,如描述数据和问答数据,包括中文和英文。在不同的训练阶段,从整体数据集中选择性地采样子集以服务于不同的目标。具体来说,数据集分类如下:

  • 图像描述数据:使用ShareGPT4V、ALLaVA-Caption、SharedGPT4o-Image和合成数据等数据集训练模型生成图像的描述性语言。
  • 图像问答数据:使用LLaVA-150K、LLaVA-Mixture-sample、LVIS-Instruct、ScienceQA、ChatQA和从LLaVA-OV采样的子集(如通用图像问答和数学推理数据集)等数据集训练模型回答基于图像的问题和执行视觉推理任务。
  • OCR和图表数据:支持模型理解OCR和图表内容,使用Anyword-3M、ICDAR2019-LSVT、UReader、SynDOG、ICDAR2019-LSVT-QA和从LLaVA-OV采样的相应数据等数据集。
  • 视频数据:使用ShareGemini和合成数据等数据集训练模型处理视频输入并执行诸如描述和基于视频的问答等任务。
  • 纯文本数据:增强模型理解和生成语言的能力,促进基于文本的问答任务。

除了表1中列出的图像和视频数据外,还纳入了110,000小时的内部语音-转录配对ASR数据,涵盖中文和英文,用于训练音频编码器并将音频编码器与LLM对齐。此外,使用TTS系统生成的3,000小时文本-语音配对数据用于训练语音解码器。

三阶段训练策略

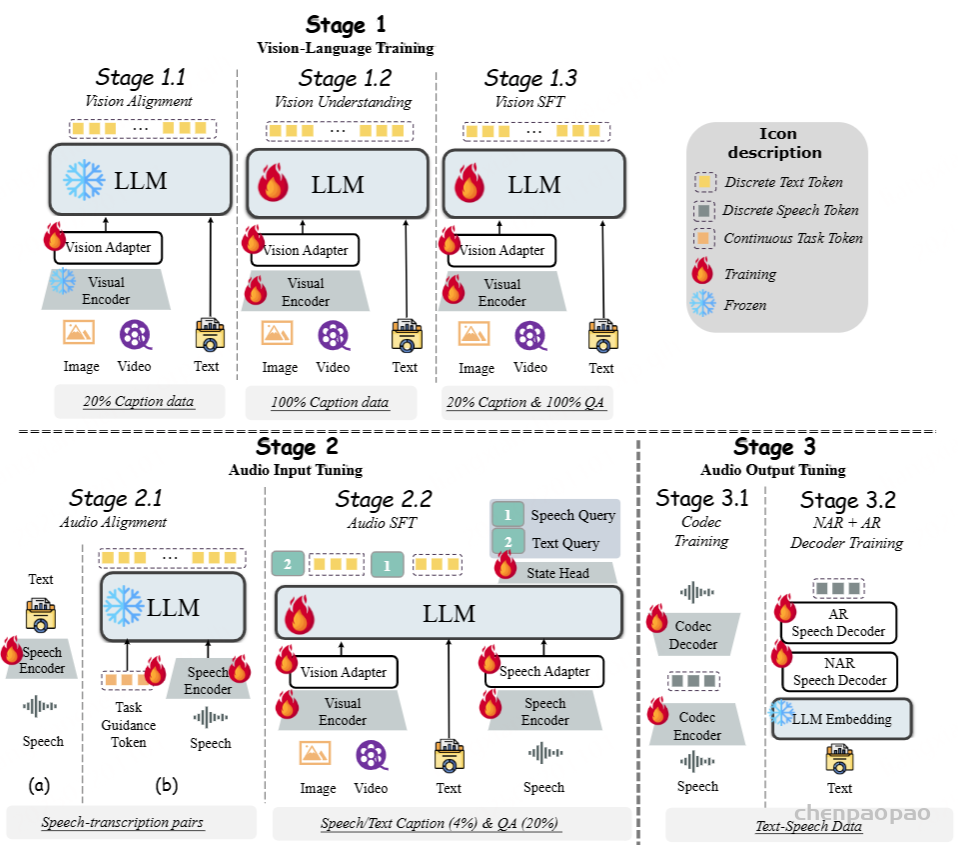
为了确保VITA-1.5在涉及视觉、语言和音频的任务中表现良好,我们必须面对一个关键挑战,即不同模态之间的训练冲突。例如,添加语音数据可能会对视觉数据的理解产生负面影响,因为语音的特征与视觉的特征显著不同,导致学习过程中的干扰。为了解决这一挑战,我们设计了一个三阶段训练策略,如图3所示。核心思想是逐步将不同模态引入模型,使其在增加新模态能力的同时保持现有模态的能力。

VITA-1.5的训练管道。训练过程分为三个阶段,以逐步将视觉和音频纳入LLM同时缓解了形态冲突。第一阶段的重点是视觉训练,包括视觉对齐(阶段1.1,使用表1中的20%字幕数据),视觉理解(阶段1.2,使用100%的字幕数据)以及用于Visual QA的指令调整(阶段1.3,使用20%字幕数据和100%QA数据)。阶段2引入音频输入调整,并具有音频对齐(阶段2.1,使用11,000小时的语音转录对)和语音质量检查的指令调整(阶段2.2,采样4%字幕数据和20%的QA数据)。最后,第3阶段的重点是音频输出调整,包括对编解码器模型的训练(使用3,000个小时的文本语音数据)和语音解码器培训(阶段3.2)。图像中显示的百分比对应于表1中指定的数据采样率。

阶段1:视觉训练

阶段1.1 视觉对齐:在此阶段,我们的目标是弥合视觉和语言之间的差距。前者的特征从预训练的视觉编码器InternViT-300M中提取,后者通过LLM引入。我们使用表1中20%的描述性描述数据进行训练,其中只有视觉适配器是可训练的,而其他模块是冻结的。这种方法允许LLM初步对齐视觉模态。

阶段1.2 视觉理解:在此阶段,我们的目标是教会LLM转录图像内容。为此,我们使用表1中所有的描述性描述数据。在此过程中,视觉模块的编码器和适配器以及LLM都是可训练的。重点是使模型通过学习关于图像的描述性文本,建立视觉和语言之间的强连接,使其能够通过生成自然语言描述来理解图像内容。

阶段1.3 视觉SFT:在阶段1.2之后,模型已经获得了对图像和视频的基本理解。然而,指令跟随能力仍然有限,难以应对视觉问答任务。为了实现这一点,我们使用表1中所有的问答数据,同时保留20%的描述性描述数据以增加数据集的多样性和任务的复杂性。

在训练过程中,视觉模块的编码器和适配器以及LLM都是可训练的。此阶段的关键目标是使模型不仅能够理解视觉内容,还能够根据指令回答问题。

阶段2:音频输入微调

阶段2.1 音频对齐:在完成阶段1的训练后,模型已经建立了强大的图像和视频理解基础。在此阶段,我们的目标是基于阶段1减少音频和语言之间的差异,使LLM能够理解音频输入。训练数据包括11,000小时的语音-转录对。我们采用两步方法:(a)语音编码器训练:我们采用常见语音识别系统中使用的训练框架,使用连接时序分类(CTC)损失函数[18]训练语音编码器。目的是使编码器从语音输入中预测转录文本。此步骤确保音频编码器能够提取语音特征并将其映射到文本表示空间。(b)语音适配器训练:在训练语音编码器后,我们将其与LLM集成,使用音频适配器将音频特征引入LLM的输入层。此阶段的训练目标是使LLM能够输出语音数据的转录文本。

此外,在步骤(b)中,我们引入了特殊的可训练输入标记来指导语音理解过程。这些标记提供了额外的上下文信息,指导用于问答任务的LLM执行ASR任务。

阶段2.2 音频SFT:此阶段的重点是引入语音问题和文本答案的问答功能。为此,我们从表1中采样4%的描述数据和20%的问答数据。在数据处理方面,大约一半的基于文本的问题被随机替换为其对应的语音版本,使用TTS系统生成。

在此阶段,视觉编码器和适配器、音频编码器和适配器以及LLM都是可训练的,旨在提高模型对多模态输入的适应性。此外,我们在LLM的输出中添加了一个分类头。该头用于区分输入是来自语音还是文本。结果,模型可以更准确地解释语音输入,并高效灵活地处理不同模态。

阶段3:音频输出微调

在前两个训练阶段,VITA-1.5模型已经有效地发展了其多模态理解能力。然而,一个关键的能力,即语音输出,仍然缺失,这对于其作为交互助手的角色至关重要。为了在不影响模型基本能力的情况下引入语音输出功能,我们借鉴了[56]的策略,使用3,000小时的文本-语音数据,并采用两步训练方法(见图3)。

阶段3.1 编解码训练:此步骤的目标是使用语音数据训练具有单码本的编解码模型。编解码模型的编码器能够将语音映射到离散标记,而解码器可以将离散标记映射回语音流。在VITA-1.5的推理阶段,仅使用解码器。

阶段3.2 NAR + AR解码器训练:此阶段的训练使用文本-语音配对数据,其中文本被输入到LLM的分词器和嵌入层以获得其嵌入向量,语音被输入到编解码模型的编码器以获得其语音标记。文本嵌入向量被发送到NAR语音解码器以获得全局语义特征,然后将这些特征发送到AR语音解码器,预测相应的语音标记。请注意,在此阶段LLM是冻结的,因此多模态性能不受影响。

评估

视觉-语言评估

基线:我们比较了一系列开源MLLMs,包括VILA-1.5、LLaVA-Next、CogVLM2、InternLM-XComposer2.5、Cambrian-1、MiniCPM-V-2.6、Ovis1.5、InternVL-Chat-1.5、InternVL-2、LLaVA-OV和Video-LLaVA、SilME和LongVA,以及5个闭源MLLMs,包括GPT-4V、GPT-4o、GPT-4o-mini、Gemini 1.5 Pro和Claude 3.5 Sonnet。

评估基准:为了评估VITA-1.5的图像感知和理解能力,我们使用了多个评估基准,包括MME、MMBench、MMStar、MMMU、MathVista、HallusionBench、AI2D、OCRBench和MMVet。这些基准涵盖了广泛的方面,包括通用多模态能力(如MME、MMBench和MMMU)、数学推理(MathVista)、幻觉检测(HallusionBench)、图表(AI2D)和OCR(OCRBench)理解,提供了全面的评估结果。对于视频理解,我们使用了代表性的评估基准,包括Video-MME、MVBench和TempCompass。

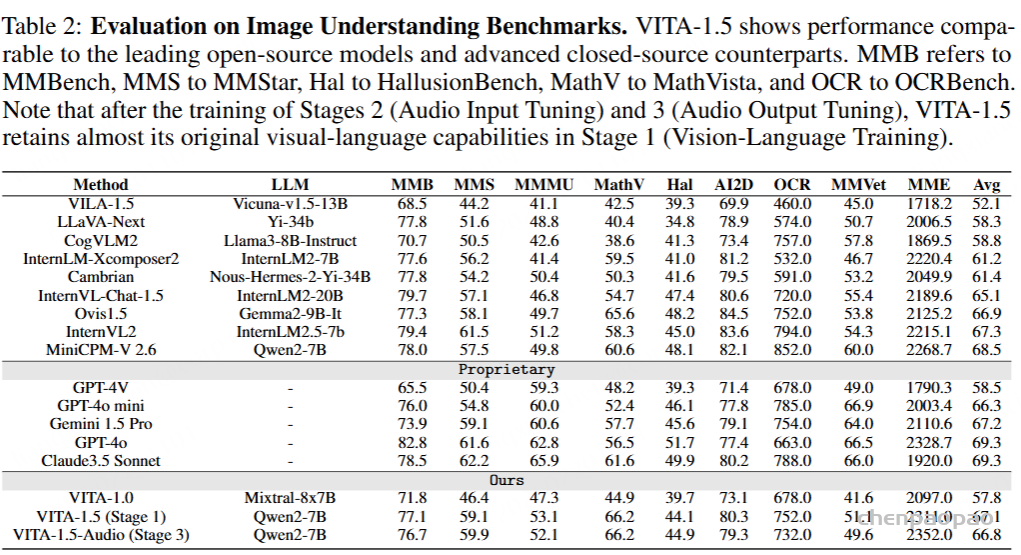
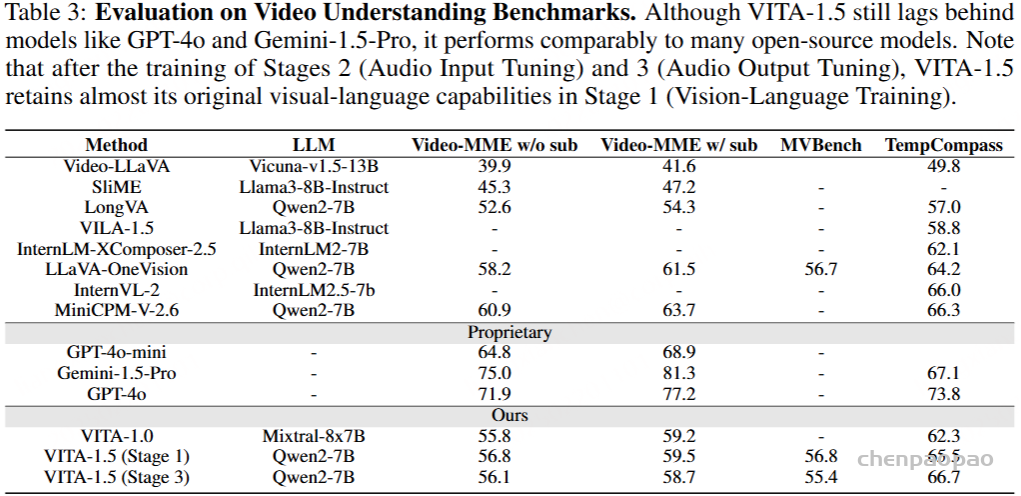
视觉-语言能力:表2展示了VITA-1.5的图像理解性能比较。在三个阶段的训练后,VITA-1.5的表现与最先进的开源模型相当,甚至超过了一些闭源模型,如GPT-4V和GPT-4o-mini。这一结果突显了VITA-1.5在图像-语言任务中的强大能力。如表3所示,VITA-1.5在视频理解评估中表现出与顶级开源模型相当的性能。与专有模型的显著差距表明,VITA-1.5在视频理解方面仍有显著的改进空间和潜力。请注意,在阶段2(音频输入微调)和阶段3(音频输出微调)的训练后,VITA-1.5几乎保留了其在阶段1(视觉-语言训练)中的原始视觉-语言能力。

语音评估

基线:以下三个基线模型用于比较:Wav2vec2-base、Mini-Omini2、Freeze-Omini和VITA-1.0。

评估基准:普通话评估集包括三个数据集:aishell-1、test net和test meeting。这些数据集用于评估模型在普通话语音上的表现。评估指标是字符错误率(CER)。英语评估集包括四个数据集:dev-clean、dev-other、test-clean和test-other,用于评估模型在英语语音上的表现。评估指标是词错误率(WER)。

ASR性能:表4中的评估结果表明,VITA-1.5在普通话和英语ASR任务中均取得了领先的准确性。这表明VITA-1.5已成功集成了先进的语音能力,以支持多模态交互。

结论

本文介绍了VITA-1.5,这是一个通过精心设计的三阶段训练策略整合视觉和语音的多模态LLM。通过缓解模态之间的固有冲突,VITA-1.5在视觉和语音理解方面实现了强大的能力,无需依赖单独的ASR或TTS模块即可实现高效的语音到语音交互。广泛的评估表明,VITA-1.5在多模态基准测试中表现出色。我们希望VITA-1.5能够接过VITA-1.0的旗帜,继续推动开源模型在实时多模态交互领域的进步。

ASR语音识别指标计算

#coding=utf-8
import os
import sys
import re
from typing import List, Union
import jiwer
import pdb


def cal_wer(path_ref, path_hyp, metric_type, output_detail, path_output):

    ref_text, hyp_text, ref_key = _read_file(path_ref, path_hyp, metric_type)
    
    cal_wer_from_list(ref_text, hyp_text, ref_key, metric_type, output_detail, path_output)


def cal_wer_from_list(
    reference: Union[str, List[str]], 
    hypothesis: Union[str, List[str]], 
    key: Union[str, List[str]], 
    metric_type: str, 
    output_detail: bool, 
    path_output: str
):
    if isinstance(reference, str):
        reference = [reference]
    if isinstance(hypothesis, str):
        hypothesis = [hypothesis]
    if isinstance(key, str):
        key = [key]

    # 根据ref是否为空, 先分别计算wer指标再汇总
    ref_normal, hyp_normal, key_normal = [], [], []
    ref_empty, hyp_empty, key_empty = [], [], []
    for i in range(len(reference)):
        if len(reference[i]) != 0:
            ref_normal.append(reference[i])
            hyp_normal.append(hypothesis[i])
            key_normal.append(key[i])
        else:
            ref_empty.append(reference[i])
            hyp_empty.append(hypothesis[i])
            key_empty.append(key[i])

    res_normal, out_normal = _cal_wer_normal(ref_normal, hyp_normal, metric_type)
    res_empty, out_empty = _cal_wer_empty(hyp_empty, metric_type)
    _summary(ref_normal, hyp_normal, res_normal, out_normal.alignments, key_normal, 
             hyp_empty, res_empty, out_empty, key_empty, 
             metric_type, output_detail, path_output)


def _read_file(path_ref, path_hyp, metric_type):
    ref_key, ref_text = _preprocess(path_ref, '\t', metric_type)
    hyp_key, hyp_text = _preprocess(path_hyp, '\t', metric_type)

    tmp_dict = {}
    tmp_text = []
    for i in range(len(hyp_key)):
        if hyp_key[i] not in tmp_dict.keys():
            tmp_dict[hyp_key[i]] = hyp_text[i]
        else:
            print ("repeated key")
    for i in range(len(ref_key)):
        if ref_key[i] in tmp_dict.keys():
            tmp_text.append(tmp_dict[ref_key[i]])
        else:
            tmp_text.append("")

    return ref_text, tmp_text, ref_key


def _preprocess(path_in, sep, metric_type):
    res_key, res_text = [], []

    with open(path_in, "r", encoding="utf-8") as f_in:
        lines = f_in.readlines()
        for line in lines:
            line = line.strip().split(sep, 1)
            if len(line) == 2:
                key, text = line
                text = re.sub("<s>", "", text)
                text = re.sub("</s>", "", text)
                text = re.sub("<unk>", "", text)
                text = re.sub("@@ ", "", text)
                text = re.sub("@ ", "", text)
                text = re.sub("@@", "", text)
                text = re.sub("@", "", text)
                #text = re.sub(" ", "", text)
                text = text.lower()
            else:
                key = line[0]
                text = ""

            text = [x for x in text]
            text_tmp = ""
            if metric_type == "wer":
                for ch in text:
                    if '\u4e00' <= ch <= '\u9fff':
                        text_tmp += " " + ch + " "
                    else:
                        text_tmp += ch
                text = text_tmp.strip().replace("  ", " ")
            elif metric_type == "cer":
                text_tmp = "".join(text)
                text = text_tmp.strip().replace(" ", "")
            else:
                assert False

            res_key.append(key)
            res_text.append(text)

    return res_key, res_text


def _cal_wer_normal(reference, hypothesis, metric_type):
    if metric_type == "wer":
        out = jiwer.process_words(reference=reference, hypothesis=hypothesis)
        ERR = out.wer
    elif metric_type == "cer":
        out = jiwer.process_characters(reference=reference, hypothesis=hypothesis)
        ERR = out.cer
    else:
        assert False

    H = out.hits
    S = out.substitutions
    D = out.deletions
    I = out.insertions
    N = H + S + D

    res = [ERR, N, S, D, I]

    return res, out


def _cal_wer_empty(hypothesis, metric_type):
    out = []

    I = 0
    for hyp in hypothesis:
        if hyp == "":
            i = 0
        else:
            if metric_type == "wer":
                i = len(hyp.split(" "))
            elif metric_type == "cer":
                i = len(hyp)
            else:
                assert False
        I += i
        out.append(i)

    res = [0, 0, 0, 0, I]

    return res, out


def _summary(ref_normal, hyp_normal, res_normal, out_normal, key_normal,
             hyp_empty, res_empty, out_empty, key_empty, 
             metric_type, output_detail, path_output):
    # wer/cer计算
    _, N, S, D, I = res_normal
    I += res_empty[-1]
    if N != 0:
        ERR = (S + D + I) / N
        SUB = S / N
        DEL = D / N
        INS = I / N
        N_WORD = N
    else:
        if I == 0:
            ERR = 0
        else:
            ERR = 1
        SUB, DEL, INS, N_WORD = 0, 0, I, 0

    # 句准计算 + 详细错误指标 + 详细错误统计
    utt_normal, alignments_normal, statistics_normal = _analyse_normal(
        ref_normal, hyp_normal, out_normal, key_normal, metric_type)
    utt_empty, alignments_empty, statistics_empty = _analyse_empty(
        hyp_empty, out_empty, key_empty, metric_type)

    utt = utt_normal + utt_empty
    alignments = alignments_normal + alignments_empty
    for key in statistics_empty['insert'].keys():
        if key not in statistics_normal['insert'].keys():
            statistics_normal['insert'][key] = statistics_empty['insert'][key]
        else:
            statistics_normal['insert'][key] += statistics_empty['insert'][key]
    N_SENT = len(out_normal) + len(out_empty)
    ACC_UTT = utt / N_SENT
    res = [ERR, SUB, DEL, INS, N_WORD, ACC_UTT, N_SENT]

    _format_output(res, alignments, statistics_normal, metric_type, output_detail, path_output)


def _analyse_normal(ref_normal, hyp_normal, out_normal, key_normal, metric_type):
    utt_normal = 0
    alignments_normal = []
    statistics_normal = {'substitute' : {}, 'delete' : {}, 'insert' : {}}

    for i, alignment in enumerate(out_normal):
        err, n_hit, n_sub, n_del, n_ins = 0, 0, 0, 0, 0
        ref_align, hyp_align = "", ""
        sub_align, del_align, ins_align = "", "", ""
        for j, chunk in enumerate(alignment):
            if (metric_type == "wer" and (ref_align != "" or hyp_align != "")):
                ref_align += " "
                hyp_align += " "
            if chunk.type == 'equal':
                n_hit += chunk.ref_end_idx - chunk.ref_start_idx
                ref_align += _extract_string(ref_normal[i], chunk.ref_start_idx, chunk.ref_end_idx, metric_type)
                hyp_align += _extract_string(hyp_normal[i], chunk.hyp_start_idx, chunk.hyp_end_idx, metric_type)

            elif chunk.type == 'substitute':
                err += 1
                n_sub += chunk.ref_end_idx - chunk.ref_start_idx

                ref_sub = _extract_string(ref_normal[i], chunk.ref_start_idx, chunk.ref_end_idx, metric_type)
                hyp_sub = _extract_string(hyp_normal[i], chunk.hyp_start_idx, chunk.hyp_end_idx, metric_type)

                ref_align += ref_sub
                hyp_align += hyp_sub

                key_sub = "(" + ref_sub + ") --> (" + hyp_sub + ")"

                sub_align += key_sub + "\t"

                if key_sub not in statistics_normal['substitute'].keys():
                    statistics_normal['substitute'][key_sub] = 1
                else:
                    statistics_normal['substitute'][key_sub] += 1

            elif chunk.type == 'delete':
                err += 1
                n_del += chunk.ref_end_idx - chunk.ref_start_idx

                ref_del = _extract_string(ref_normal[i], chunk.ref_start_idx, chunk.ref_end_idx, metric_type)
                hyp_del = "*"

                ref_align += ref_del
                hyp_align += hyp_del

                key_del = ref_del

                del_align += key_del + "\t"

                if key_del not in statistics_normal['delete'].keys():
                    statistics_normal['delete'][key_del] = 1
                else:
                    statistics_normal['delete'][key_del] += 1

            elif chunk.type == 'insert':
                err += 1
                n_ins += chunk.hyp_end_idx - chunk.hyp_start_idx

                ref_ins = "*"
                hyp_ins = _extract_string(hyp_normal[i], chunk.hyp_start_idx, chunk.hyp_end_idx, metric_type)

                ref_align += ref_ins
                hyp_align += hyp_ins

                key_ins = hyp_ins

                ins_align += key_ins + "\t"

                if key_ins not in statistics_normal['insert'].keys():
                    statistics_normal['insert'][key_ins] = 1
                else:
                    statistics_normal['insert'][key_ins] += 1

            else:
                assert False

        if err == 0:
            utt_normal += 1
        alignments_normal.append((key_normal[i], ref_align, hyp_align, 
                                  sub_align, del_align, ins_align, 
                                  n_hit, n_sub, n_del, n_ins))

    return utt_normal, alignments_normal, statistics_normal


def _analyse_empty(hyp_empty, out_empty, key_empty, metric_type):
    utt_empty = 0
    alignments_empty = []
    statistics_empty = {'insert' : {}}

    for i, ins in enumerate(out_empty):
        ref_align, hyp_align = "", ""
        sub_align, del_align, ins_align = "", "", ""

        if ins == 0:
            utt_empty += 1
        else:
            ref_ins = "*"
            hyp_ins = _extract_string(hyp_empty[i], 0, len(hyp_empty[i]), metric_type)

            ref_align += ref_ins
            hyp_align += hyp_ins

            key_ins = hyp_ins

            ins_align += key_ins + "\t"

            if key_ins not in statistics_empty['insert'].keys():
                statistics_empty['insert'][key_ins] = 1
            else:
                statistics_empty['insert'][key_ins] += 1
        alignments_empty.append((key_empty[i], ref_align, hyp_align, 
                                sub_align, del_align, ins_align, 
                                0, 0, 0, ins))

    return utt_empty, alignments_empty, statistics_empty


def _extract_string(s, begin, end, metric_type):
    res = ""
    if metric_type == 'wer':
        res = ' '.join(s.split(' ')[begin:end])
    elif metric_type == 'cer':
        res = s[begin:end]
    else:
        assert False
    return res


def _format_output(res, alignments, statistics, metric_type, output_detail, path_output):
    with open(path_output, "w", encoding="utf-8") as f_out:
        if output_detail == True:
            f_out.write("-"*100 + "\n")
            for i, sample in enumerate(alignments):
                key, ref, hyp = sample[0:3]
                sub_align, del_align, ins_align = sample[3:6]
                n_hit, n_sub, n_del, n_ins = sample[6:]

                f_out.write("KEY: " + key + "\n")
                f_out.write("REF: " + ref + "\n")
                f_out.write("HYP: " + hyp + "\n")
                f_out.write("CNT: " + "H(" + str(n_hit) + ") " + \
                                      "S(" + str(n_sub) + ") " + \
                                      "D(" + str(n_del) + ") " + \
                                      "I(" + str(n_ins) + ")\n")
                f_out.write("SUB: " + sub_align + "\n")
                f_out.write("DEL: " + del_align + "\n")
                f_out.write("INS: " + ins_align + "\n\n")
            f_out.write("-"*100 + "\n")

            f_out.write("-"*100 + "\n")
            lst_sub = list(sorted(statistics['substitute'].items(), key = lambda x : x[1], reverse=True))
            lst_del = list(sorted(statistics['delete'].items(), key = lambda x : x[1], reverse=True))
            lst_ins = list(sorted(statistics['insert'].items(), key = lambda x : x[1], reverse=True))
            f_out.write("\n替换错误统计: \n")
            for x in lst_sub:
                f_out.write("\t" + x[0] + "(" + str(x[1]) + ")" + "\n")
            f_out.write("\n删除错误统计: \n")
            for x in lst_del:
                f_out.write("\t" + x[0] + "(" + str(x[1]) + ")" + "\n")
            f_out.write("\n插入错误统计: \n")
            for x in lst_ins:
                f_out.write("\t" + x[0] + "(" + str(x[1]) + ")" + "\n")
            f_out.write("-"*100 + "\n")

        f_out.write("-"*100 + "\n")
        f_out.write(metric_type.upper() + ": " + str(round(res[0] * 100.0, 2)) + '%\n')
        f_out.write("WORDS: " + str(res[4]) + "\t")
        f_out.write("SUB: " + str(round(res[1] * 100.0, 2)) + "%\t")
        f_out.write("DEL: " + str(round(res[2] * 100.0, 2)) + "%\t")
        f_out.write("INS: " + str(round(res[3] * 100.0, 2)) + "%\n")
        f_out.write("ACC_UTT: " + str(round(res[5] * 100.0, 2)) + '%\t')
        f_out.write("SENTS: " + str(res[6]) + '\n')
        f_out.write("-"*100 + "\n")
    
    print (metric_type + " calculation done")
    print ("saved to " + path_output)


if __name__ == '__main__':

    '''
    # example of function cal_wer_from_list
    ref = ["今 天 天 气", "hello 我 ok 的", ""]
    hyp = ["今 天 天", "halo 我 ok 的 呀", "噪 声"]
    key = ["000", "001", "002"]
    path_output = "./example.wer"
    cal_wer(ref, hyp, key, "wer", True, path_output)

    ref = ["今天天气", "hello我ok的", ""]
    hyp = ["今天天", "halo我ok的呀", "噪声"]
    key = ["000", "001", "002"]
    path_output = "./example.cer"
    cal_wer_from_list(ref, hyp, key, "cer", True, path_output)
    '''
InspireMusic–阿里通义开源音乐生成框架

InspireMusic是由通义实验室开源的音乐生成技术,旨在打造一款集音乐生成、歌曲生成、音频生成能力为一体的开源AIGC工具包。

为研究者和开发者提供音乐/歌曲/音频生成模型的训练和调优工具及模型,方便优化生成效果;同时为音乐爱好者提供一个易于使用的文本生成音乐/歌曲/音频创作工具,可通过文字描述或音频提示来控制生成内容。

目前,InspireMusic已开源了音乐生成的训练和推理代码,支持通过简单的文字描述或音频提示,快速生成多种风格的音乐作品。

InspireMusic的文生音乐创作模式涵盖了多种曲风、情感表达和复杂的音乐结构控制,提供了极大的创作自由度和灵活性。未来计划进一步开放歌唱生成和音频生成的基础模型,欢迎研究者、开发者及用户积极参与体验和研发。该开源工具包为社区开发者提供了丰富的技术资源,支持从学术研究到产品开发的广泛应用。

🎶 主要特点

  • 统一的音频生成框架:基于音频大模型技术,InspireMusic支持音乐、歌曲及音频的生成,为用户提供多样化选择;
  • 灵活可控生成:基于文本提示和音乐特征描述,用户可精准控制生成音乐的风格和结构;
  • 简单易用:简便的模型微调和推理工具,为用户提供高效的训练与调优工具。

🌟代码仓库

核心模型

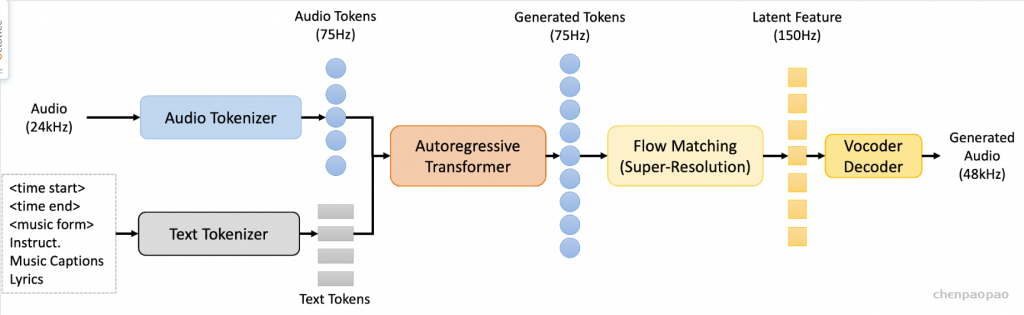
InspireMusic由音频tokenizer、自回归Transformer模型、基于常微分方程的扩散模型即Conditional Flow Matching (CFM)模型、Vocoder所组成,可支持文本生成音乐、音乐续写等任务。通过具有高压缩比的单码本WavTokenizer将输入的连续音频特征转换成离散音频token,然后利用基于Qwen模型初始化的自回归Transformer模型预测音频token,再由CFM扩散模型重建音频的潜层特征,最终通过Vocoder输出高质量的音频波形。两种推理模式的设计:fast模型和高音质模型,为不同需求的用户提供了灵活的选择。

工具包安装使用指南

第一步:下载代码库

git clone --recursive https://github.com/FunAudioLLM/InspireMusic.git
# If you failed to clone submodule due to network failures, please run the following command until success
cd InspireMusic
git submodule update --init --recursive

第二步:安装代码库

conda create -n inspiremusic python=3.8
conda activate inspiremusic
cd InspireMusic
# pynini is required by WeTextProcessing, use conda to install it as it can be executed on all platforms.
conda install -y -c conda-forge pynini==2.1.5
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
# install flash attention to speedup training, support version 2.6.3
pip install flash-attn --no-build-isolation

第三步:下载模型

InspireMusic-Base模型(https://www.modelscope.cn/iic/InspireMusic)
# git模型下载,请确保已安装git lfs
mkdir -p pretrained_models
git clone https://www.modelscope.cn/iic/InspireMusic.git pretrained_models/InspireMusic-Base

第四步:基本用法说明快速开始

cd InspireMusic/examples/music_generation/
bash run.sh

训练LLM和flow matching模型样例脚本。

torchrun --nnodes=1 --nproc_per_node=8 \
    --rdzv_id=1024 --rdzv_backend="c10d" --rdzv_endpoint="localhost:0" \
    inspiremusic/bin/train.py \
    --train_engine "torch_ddp" \
    --config conf/inspiremusic.yaml \
    --train_data data/train.data.list \
    --cv_data data/dev.data.list \
    --model llm \
    --model_dir `pwd`/exp/music_generation/llm/ \
    --tensorboard_dir `pwd`/tensorboard/music_generation/llm/ \
    --ddp.dist_backend "nccl" \
    --num_workers 8 \
    --prefetch 100 \
    --pin_memory \
    --deepspeed_config ./conf/ds_stage2.json \
    --deepspeed.save_states model+optimizer \
    --fp16

torchrun --nnodes=1 --nproc_per_node=8 \
    --rdzv_id=1024 --rdzv_backend="c10d" --rdzv_endpoint="localhost:0" \
    inspiremusic/bin/train.py \
    --train_engine "torch_ddp" \
    --config conf/inspiremusic.yaml \
    --train_data data/train.data.list \
    --cv_data data/dev.data.list \
    --model flow \
    --model_dir `pwd`/exp/music_generation/flow/ \
    --tensorboard_dir `pwd`/tensorboard/music_generation/flow/ \
    --ddp.dist_backend "nccl" \
    --num_workers 8 \
    --prefetch 100 \
    --pin_memory \
    --deepspeed_config ./conf/ds_stage2.json \
    --deepspeed.save_states model+optimizer

推理脚本

cd InspireMusic/examples/music_generation/
bash infer.sh

带有CFM的推理模式

pretrained_model_dir = "pretrained_models/InspireMusic/"
for task in 'text-to-music' 'continuation'; do
  python inspiremusic/bin/inference.py --task $task \
      --gpu 0 \
      --config conf/inspiremusic.yaml \
      --prompt_data data/test/parquet/data.list \
      --flow_model $pretrained_model_dir/flow.pt \
      --llm_model $pretrained_model_dir/llm.pt \
      --music_tokenizer $pretrained_model_dir/music_tokenizer \
      --wavtokenizer $pretrained_model_dir/wavtokenizer \
      --result_dir `pwd`/exp/inspiremusic/${task}_test \
      --chorus verse \
      --min_generate_audio_seconds 8 \
      --max_generate_audio_seconds 30 
done

不带CFM的fast推理模式

pretrained_model_dir = "pretrained_models/InspireMusic/"
for task in 'text-to-music' 'continuation'; do
  python inspiremusic/bin/inference.py --task $task \
      --gpu 0 \
      --config conf/inspiremusic.yaml \
      --prompt_data data/test/parquet/data.list \
      --flow_model $pretrained_model_dir/flow.pt \
      --llm_model $pretrained_model_dir/llm.pt \
      --music_tokenizer $pretrained_model_dir/music_tokenizer \
      --wavtokenizer $pretrained_model_dir/wavtokenizer \
      --result_dir `pwd`/exp/inspiremusic/${task}_test \
      --chorus verse \
      --fast \
      --min_generate_audio_seconds 8 \
      --max_generate_audio_seconds 30 
done

‍