Is Text All You Need? 文本作为语音大模型的通用信息瓶颈

Is Text All You Need? Text as a Universal Information Bottleneck for Speech LLMs

核心亮点: 提出 Convex Gate (C-Gate) 语音-LLM 桥接模块通过凸包约束将每帧语音表示为 LLM 词表嵌入的凸组合,确保表征严格位于预训练 LLM 的输入流形内,有效避免表征漂移与词汇锁定。该方法在 ASR 与情感识别联合任务上表现优异,LibriSpeech WER 相对降低高达 48.7%,且情感识别精度持平或超越单任务基线。研究揭示语音信息的核心载体是嵌入空间中的时序轨迹而非离散 Token 身份,证明了几何对齐而非离散化才是语音-LLM 接口设计的根本因素。

C-Gate不是把语音生硬地翻译成文字Token,而是把语音转换成LLM熟悉的连续词向量轨迹,让模型既能听清“说了什么”,也能感知“怎么说的”。

论文链接: https://arxiv.org/pdf/2606.09366v1

Speech-LLM 的一个核心问题是:语音编码器输出的连续向量,应该以什么形式进入一个已经冻结的文本大模型?如果强制语音表示接近离散文字 Token,ASR 会比较容易,但情绪、韵律等副语言信息可能丢失;如果允许适配器生成任意连续向量,表示能力虽然更强,却可能偏离 LLM 训练时熟悉的输入空间,导致自回归解码不稳定。

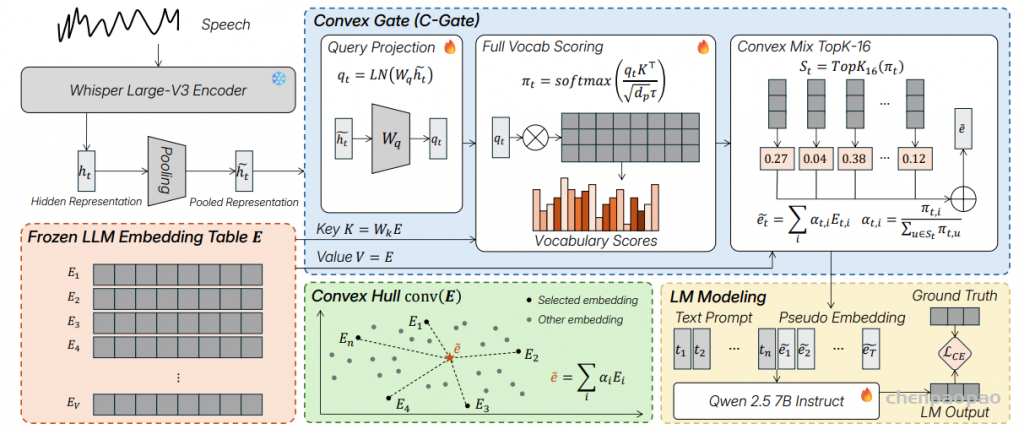
论文提出 Convex Gate,简称 C-Gate。它规定每一个语音帧表示都必须是若干 LLM 原始词嵌入的凸组合。模型不必把语音硬映射成某个文字 Token,但生成的向量始终位于 LLM 词嵌入表的凸包内部,从而在“离散符号约束”和“自由连续表示”之间取得平衡。

实验最值得关注的结论不是 Top-16 选中了哪些词,而是:真正承载语音信息的是这些连续混合向量在时间轴上形成的轨迹。打乱轨迹顺序或替换 LLM 的词嵌入基底,ASR 和情绪识别都会崩溃。

Figure 1,C-Gate 总体架构与词嵌入凸包示意图。C-Gate 并不是直接学习一个新的“语音 embedding 空间”,而是通过 Query/Key 打分 → 从冻结的 LLM embedding 中选择 Top-16 → 对原始 embedding 做加权求和,从而把 Whisper 的语音表示映射到 LLM 原有 embedding 空间的凸包内。这也是它不需要 Value Projection 和后置 MLP 的关键原因。

一、两种传统 Speech-LLM 接口的矛盾

  • 近离散 Token 对齐:通过 CTC 或文字对齐让语音表示接近 one-hot Token 分布,有利于转写,但容易形成 lexical lock-in,压缩情绪、韵律等信息。
  • 无约束连续表示:Q-Former 或连接器可以输出任意稠密向量,表达能力较强,但容易发生 basis drift,即语音向量偏离冻结 LLM 的输入分布。

C-Gate 的观点是:关键不是语音表示是否离散,而是它的几何位置是否与 LLM 的输入空间兼容。LLM 唯一真正训练过的连续输入空间就是自己的词嵌入表,因此语音桥接向量应该被限制在该嵌入表的凸包中。

二、C-Gate 模型设计

1. 凸包约束

设冻结 LLM 的词嵌入表为 \(E=\{E_1,\ldots,E_V\}\),其凸包定义为:

\( \operatorname{conv}(E)=\left\{\sum_{v=1}^{V}\alpha_vE_v:\alpha_v\ge 0, \sum_{v=1}^{V}\alpha_v=1\right\} \)

只要语音向量采用非负、和为 1 的词嵌入加权组合,它就不会离开 LLM 熟悉的输入几何,同时仍然可以在不同词向量之间连续移动,不必退化成某个离散 Token。

2. 全词表打分与 Top-16 混合

模型使用冻结的 Whisper-large-v3 编码器获得语音隐状态。经过步长为 4 的均值池化后,每个语音状态映射成查询向量:

\( q_t=\operatorname{LN}(W_q\tilde h_t),\qquad K=W_kE \)

其中 \(K\) 是整个词表的投影 Key。模型对完整词表计算相似度:

\( \pi_t=\operatorname{softmax}\left(\frac{q_tK^{\top}}{\sqrt{d_p}\,\tau}\right), \qquad S_t=\operatorname{TopK}_{16}(\pi_t) \)

然后只保留概率最高的 16 个词嵌入,并重新归一化:

\( \alpha_{t,v}= \begin{cases} \dfrac{\pi_{t,v}}{\sum_{u\in S_t}\pi_{t,u}}, & v\in S_t,\\ 0, & v\notin S_t, \end{cases} \qquad \tilde e_t=\sum_{v\in S_t}\alpha_{t,v}E_v\in\operatorname{conv}(E) \)

这里的一个关键设计是:投影只用于 Query 和 Key 打分,Value 始终是未经修改的原始 LLM 词嵌入。Top-16 后也没有 Value Projection 或额外 MLP,因此凸包约束由架构本身保证,而不是依赖训练损失近似实现。

3. 冻结 LLM 的统一解码接口

任务指令、语音伪嵌入和历史输出 Token 被拼接后送入 Qwen2.5-7B-Instruct:

\( p_M(y_{1:N}\mid x_{1:m},\tilde e_{1:T})= \prod_{i=1}^{N}p_M\!\left(y_i\mid[E(x_{1:m});\tilde e_{1:T};E(y_{<i})]\right) \)

所有任务都使用标准自回归交叉熵,不需要 CTC、外部分类头、前缀强制或任务专用解码器。

三、参数冻结与多任务训练

模块状态
Whisper-large-v3 Encoder冻结
Qwen2.5-7B 嵌入表、MLP、LayerNorm、LM Head冻结
C-Gate 的 Wq、Wk、LayerNorm、温度参数训练,约2.49M
Qwen第0至23层 Self-Attention 的 Q/K/V/O 投影训练,约704.75M
总可训练参数707.25M

训练使用一个多任务交叉熵目标,并通过动态重加权避免不同任务的损失尺度失衡:

\( \mathcal{L}^{(t)}=\sum_{i\in\mathcal{T}}w_i^{(t)}\mathcal{L}_i^{(t)}, \qquad w_i^{(t)}\propto\left(\frac{\mathcal{L}_{i,\mathrm{EMA}}^{(t)}} {\mathcal{L}_{i,\mathrm{init}}}\right)^{\alpha},\quad \alpha=1 \)

EMA 衰减系数为 0.9,任务权重截断在 0.2 至 5.0。C-Gate-2T 联合训练 ASR 和情绪任务;C-Gate-3T 再增加语音推理任务,用来测试共享桥接表示的能力边界。

四、训练数据与评测设置

  • ASR:960小时 LibriSpeech,使用 test-clean 报告自回归和 Teacher-Forced WER。
  • 情绪:约47小时公开情绪语音数据,RAVDESS 用作8分类的分布外闭集评测。
  • 推理:C-Gate-3T 增加语音推理任务,评测包括 VoiceBench-BBH、BBH-Heldout、SpeechMMLU、MMAU 和 MMSU。

论文没有在主体中详细列出全部 47 小时情绪训练语料和推理训练数据的逐项构成,因此数据部分的可复现信息弱于模型结构部分。作者同时强调,多项选择推理成绩可能受到文本捷径、答案先验和选项顺序影响,因此把它们视为能力边界测试,而不是完全由音频驱动的推理证明。

五、主要实验结果

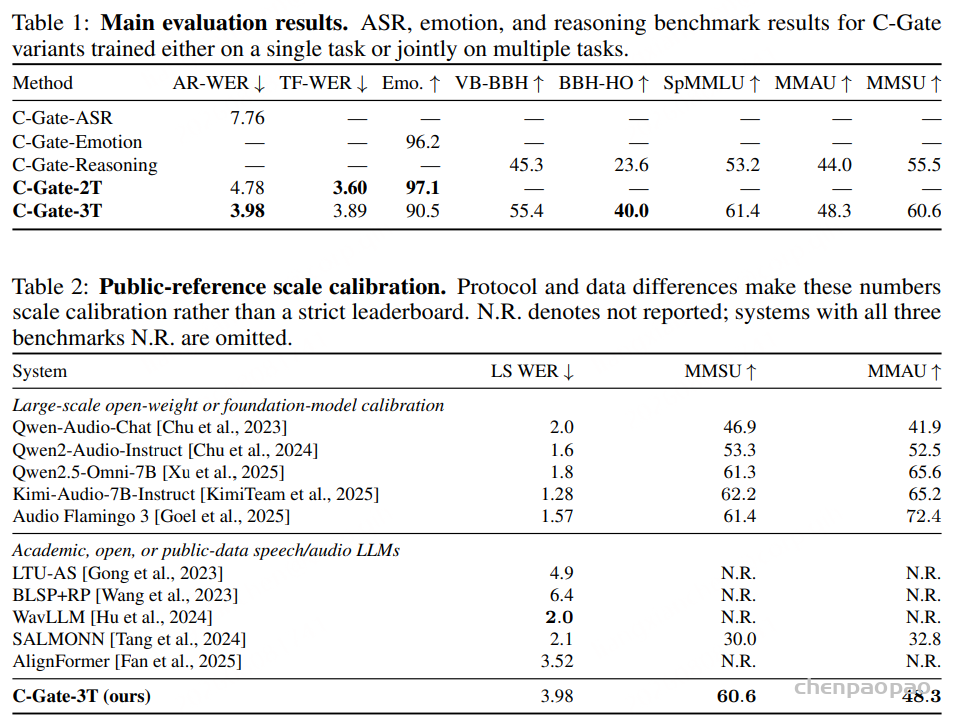
模型AR-WERTF-WER情绪准确率SpMMLUMMAUMMSU
C-Gate-ASR7.76%
C-Gate-Emotion96.2%
C-Gate-Reasoning53.2%44.0%55.5%
C-Gate-2T4.78%3.60%97.1%
C-Gate-3T3.98%3.89%90.5%61.4%48.3%60.6%
根据 Table 1,WER 越低越好,其余准确率越高越好。

1. ASR 与情绪之间出现正迁移

C-Gate-2T 将自回归 WER 从单任务模型的 7.76% 降至 4.78%,相对降低 38.4%;与此同时,情绪准确率从情绪单任务模型的 96.2% 提升到 97.1%。这意味着情绪监督没有干扰 ASR,反而抑制了 ASR-only 模型中较严重的插入错误。

C-Gate-3T 加入推理任务后,WER 进一步降至 3.98%,相比 C-Gate-ASR 相对降低 48.7%,但情绪准确率下降到 90.5%。因此论文将 C-Gate-2T 视为 ASR 与副语言任务之间更干净的平衡点,而 C-Gate-3T 是用于观察多任务干扰边界的压力测试。

2. 推理任务有所提升,但不是绝对SOTA

与 Reasoning-only 模型相比,C-Gate-3T 在五项推理测试上均有提升,例如 BBH-Heldout 从 23.6% 提升到 40.0%,SpeechMMLU 从 53.2% 提升到 61.4%,MMSU 从 55.5% 提升到 60.6%。

在公开模型尺度参考中,C-Gate-3T 的 LibriSpeech WER 为 3.98%,不及 Kimi-Audio 的 1.28% 和 Qwen2-Audio 的 1.6%;MMAU 48.3% 也低于大型音频模型。它的价值主要是以相同数据和可训练参数预算验证桥接几何,而不是追求绝对排行榜第一。

六、机制分析:信息不是离散词,而是时间轨迹

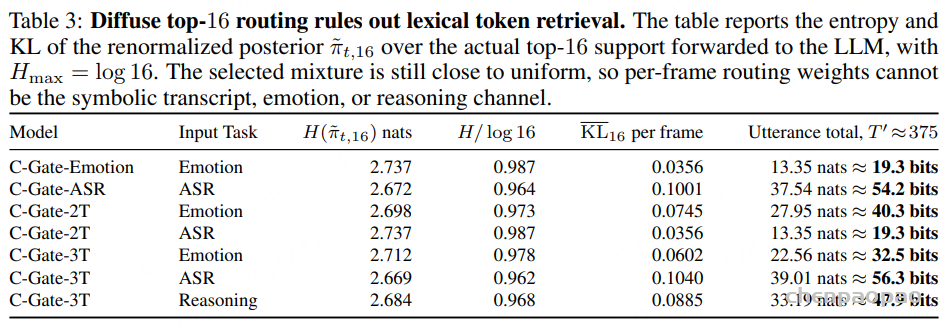
1. Top-16 分布接近均匀

Top-16 归一化分布的熵约为最大熵的 96.2% 至 98.7%,说明每一帧并没有选择一个非常明确的文字 Token。Top-1 Token 也不对应真实转写词、情绪标签或可解释类别,因此 C-Gate 不是一个隐式 ASR Token 检索器。

Top-16 路由熵和 KL 统计。

2. 选中支持集合的时间变化携带信息

相邻语音帧的 16 个支持 Token 中,平均只有约 3 个会继续保留。将整段语音选择过的支持 Token 做 Bag-of-Supports 探测,在 RAVDESS 上达到 77.7% 准确率,高于 C-Gate 之前 Whisper 表示的 67.8%;但如果把所有帧的桥接向量直接平均,准确率只有 16.8%。

因此,信息并不主要存在于某一帧的概率权重,也不在整句平均向量中,而是在语音帧沿着词嵌入凸包移动形成的有序轨迹中。

3. 同一轨迹可被不同任务以不同方式读取

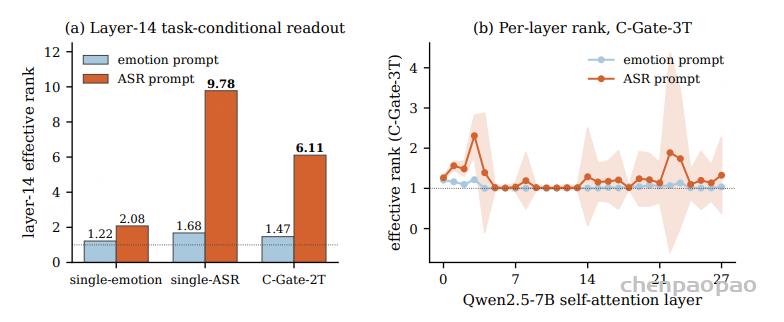
在情绪 Prompt 下,LLM 的文本到语音注意力趋向低秩,等价于对整段音频进行全局池化;在 ASR Prompt 下,注意力秩明显升高,不同输出位置会选择不同的局部语音位置。C-Gate-2T 在同一个模型中即可根据 Prompt 从低秩全局读取切换到位置敏感读取。

Figure 2,情绪与 ASR Prompt 下的任务条件化注意力有效秩。

4. 因果干预验证了凸包轨迹的重要性

作者在同一个 C-Gate-3T 检查点上进行干预:

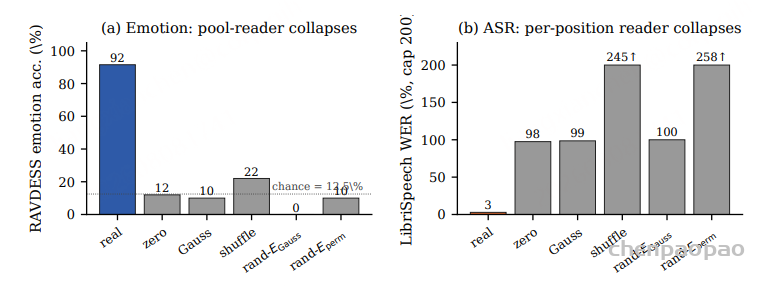
  • 将真实音频换成全零或等RMS高斯噪声,情绪准确率从约91.5%降到12%或10%,WER从2.8%升到约98%。
  • 打乱桥接向量的时间顺序,情绪准确率降到22%,WER升到244.5%。
  • 用同形状高斯矩阵或随机行排列替换词嵌入表,情绪与ASR性能同时崩溃。

这些结果排除了“只要有足够大的码本或额外 Self-Attention 参数就可以”的解释,支持论文的主要判断:有用通道是位于训练过的 LLM 词嵌入空间中的有序连续轨迹。

Figure 3,音频替换、时间打乱和词嵌入基底替换的因果干预结果。

七、论文的主要创新点

  1. 以架构方式保证语音表示位于词嵌入凸包。不需要额外对齐损失,也不会产生凸包外的新 Value 方向。
  2. 同时避免离散锁定和连续表示漂移。语音仍是连续向量,但始终处于冻结 LLM 熟悉的输入几何中。
  3. 在冻结 Encoder 和大部分 LLM 的受控条件下研究多任务迁移。把性能变化更多地归因于接口设计,而不是全模型训练规模。
  4. 从路由概率转向时间轨迹解释信息传递。证明 Token 身份不是主要通道,连续伪嵌入的时间结构才是关键。
  5. 使用因果干预验证机制。通过替换音频、打乱时间和更换嵌入基底,分别验证声学内容、顺序结构和输入几何的必要性。

八、局限性

  • 只验证了 Whisper-large-v3 与 Qwen2.5-7B-Instruct 这一组 Encoder-LLM 组合。
  • 主要训练实验只有一个随机种子,尚缺少多次训练的方差统计。
  • 缺少同参数预算的普通 Q-Former 连续桥接器作为最直接对照,无法完全排除收益来自新增可训练 Self-Attention 容量。
  • 情绪评测主要依赖表演式、闭集的 RAVDESS,不代表真实开放环境下的情绪理解。
  • 语音推理测试仍可能受文字捷径和答案先验影响,不能直接宣称模型已经具备可靠的音频落地推理。
  • 论文不建议将模型用于高风险的说话人属性或情绪判断。

九、总结

C-Gate 提出的不是一种新的语音 Tokenizer,而是一条几何原则:语音表示不必变成文字,但应该位于 LLM 已经学会读取的表示空间内。Top-16 词嵌入只是构成连续向量的坐标,模型实际读取的是这些向量随时间变化的轨迹。

这项工作对 Speech-LLM 设计的启发在于,与其只追求更大的连接器或更强的离散对齐,不如同时考虑“表示位于哪里”和“信息如何随时间组织”。C-Gate 在受控数据规模下展示了 ASR 与情绪任务的正迁移,也提供了一套可解释、可干预的研究框架。不过,它距离大规模、多语言、真实业务环境中的通用语音模型仍有明显距离。


Turn Detector v1.0- 语义轮次检测VAD

语音智能体最容易暴露“机器感”的地方,往往不是大模型回答得不够聪明,而是它不知道什么时候该接话。用户在句中稍作停顿,机器人便抢先开口;用户已经明确说完,机器人却仍然等待。前者破坏表达,后者制造尴尬的空白。

2026 年 6 月,LiveKit 发布 Turn Detector v1.0,将轮次结束检测从“读取转写文本”推进到“直接聆听语音”。新模型把语义理解与声学、韵律信号融合起来,并同步开放 eot-bench 基准与 14 种语言的真实人机对话评测数据。按照 LiveKit 公布的结果,完整版 v1 在其评测的模型中给出了最优的延迟—误截断前沿。

LiveKit 对这次发布的定位十分激进:对于基于 LiveKit 构建的智能体,他们认为端到端轮次检测已经成为一个“基本解决”的问题。不过,这一结论目前主要来自 LiveKit 自己设计并公开的基准,仍值得第三方在不同领域、口音和噪声条件下独立复现。

一、背景:停顿不等于说完

传统语音系统通常依靠 VAD(Voice Activity Detection,语音活动检测)判断音频中有没有人声,再设置一个静音计时器:静音达到若干毫秒,就认为用户已经说完。这种方法能够发现“停顿”,却无法理解“停顿的含义”。

例如用户说:“我要一个大号披萨……”并在“披萨”后停顿。此时他可能已经结束点单,也可能准备继续说“……再来一份蒜香面包”。在停顿发生的瞬间,两种情况的转写文本完全相同。文本模型无论多强,都无法从相同的文字中恢复已经丢失的语调、音高和节奏。

  • 只靠 VAD:知道用户停了,却不知道用户是否准备继续。
  • VAD 加文本语义模型:能理解句子是否完整,但受 STT 错误和转写延迟限制。
  • 音频语义与声学融合:同时理解“说了什么”与“怎么说”,这是 v1.0 的路线。

文本路线的三重上限

  1. 判断上限受 STT 质量约束:漏字、错字、断句方式和数字格式都会改变语义判断。
  2. 必须等待转写结果:模型不能在最终文本到达前完成判断,STT 尾部延迟会直接叠加到智能体响应时间。
  3. 副语言信息永久丢失:尾音上扬、音高下降、重音、语速和节奏无法从纯文本中可靠恢复。

这也是 LiveKit 从上一代文本模型转向 v1 音频模型的核心原因:要继续提高轮次判断质量,就必须“停止阅读,开始聆听”。

二、LiveKit Turn Detector 的三代演进

阶段输入与架构关键机制主要特征
初代(2024)转写文本 + Transformer根据对话文本预测用户是否结束表达把纯静音计时升级为语义判断
v0.4.x(Hugging Face 公开模型)Qwen2.5-0.5B-Instruct 文本模型预测下一个 token 是否为 <|im_end|>;按语言使用不同阈值由 7B teacher 蒸馏,INT8 ONNX,可在 CPU 运行
v1 / v1-mini(2026)原始音频 + 语义分支 + 声学分支 + Fusion直接融合语义、语调、音高、节奏和时序信息不依赖转写,只需当前用户轮次;v1 为云端完整版,v1-mini 为 CPU 优化开放权重版

重要版本说明:用户常见的 Hugging Face 仓库 livekit/turn-detector 当前模型卡主要描述 v0.4.x 文本路线,而不是本文重点讨论的 v1 音频双分支模型。模型卡中的 Qwen2.5-0.5B、最多 6 轮上下文、128 token、INT8 ONNX 和按语言阈值等参数,不应直接套用到 v1 或 v1-mini。

上一代文本模型如何判断轮次结束

v0.4.x 会把最近的对话按 Qwen Chat Template 格式化,但故意不在最后一条用户消息后添加 <|im_end|>。模型随后计算这个结束 token 成为下一个 token 的概率:

\(P_{\mathrm{EOT}} = P\!\left(y_s = \texttt{<|im\_end|>} \mid y_{<s}, x\right) = \mathrm{Trfm}(y_{<s},x)_{\texttt{<|im\_end|>}}\)

如果该概率超过对应语言的阈值,系统便倾向于认为用户已经说完。这个方案比单纯 VAD 更懂句意,但它仍要先经过 STT,也无法使用语调和韵律。

三、v1.0 模型设计:语义与声学双分支融合

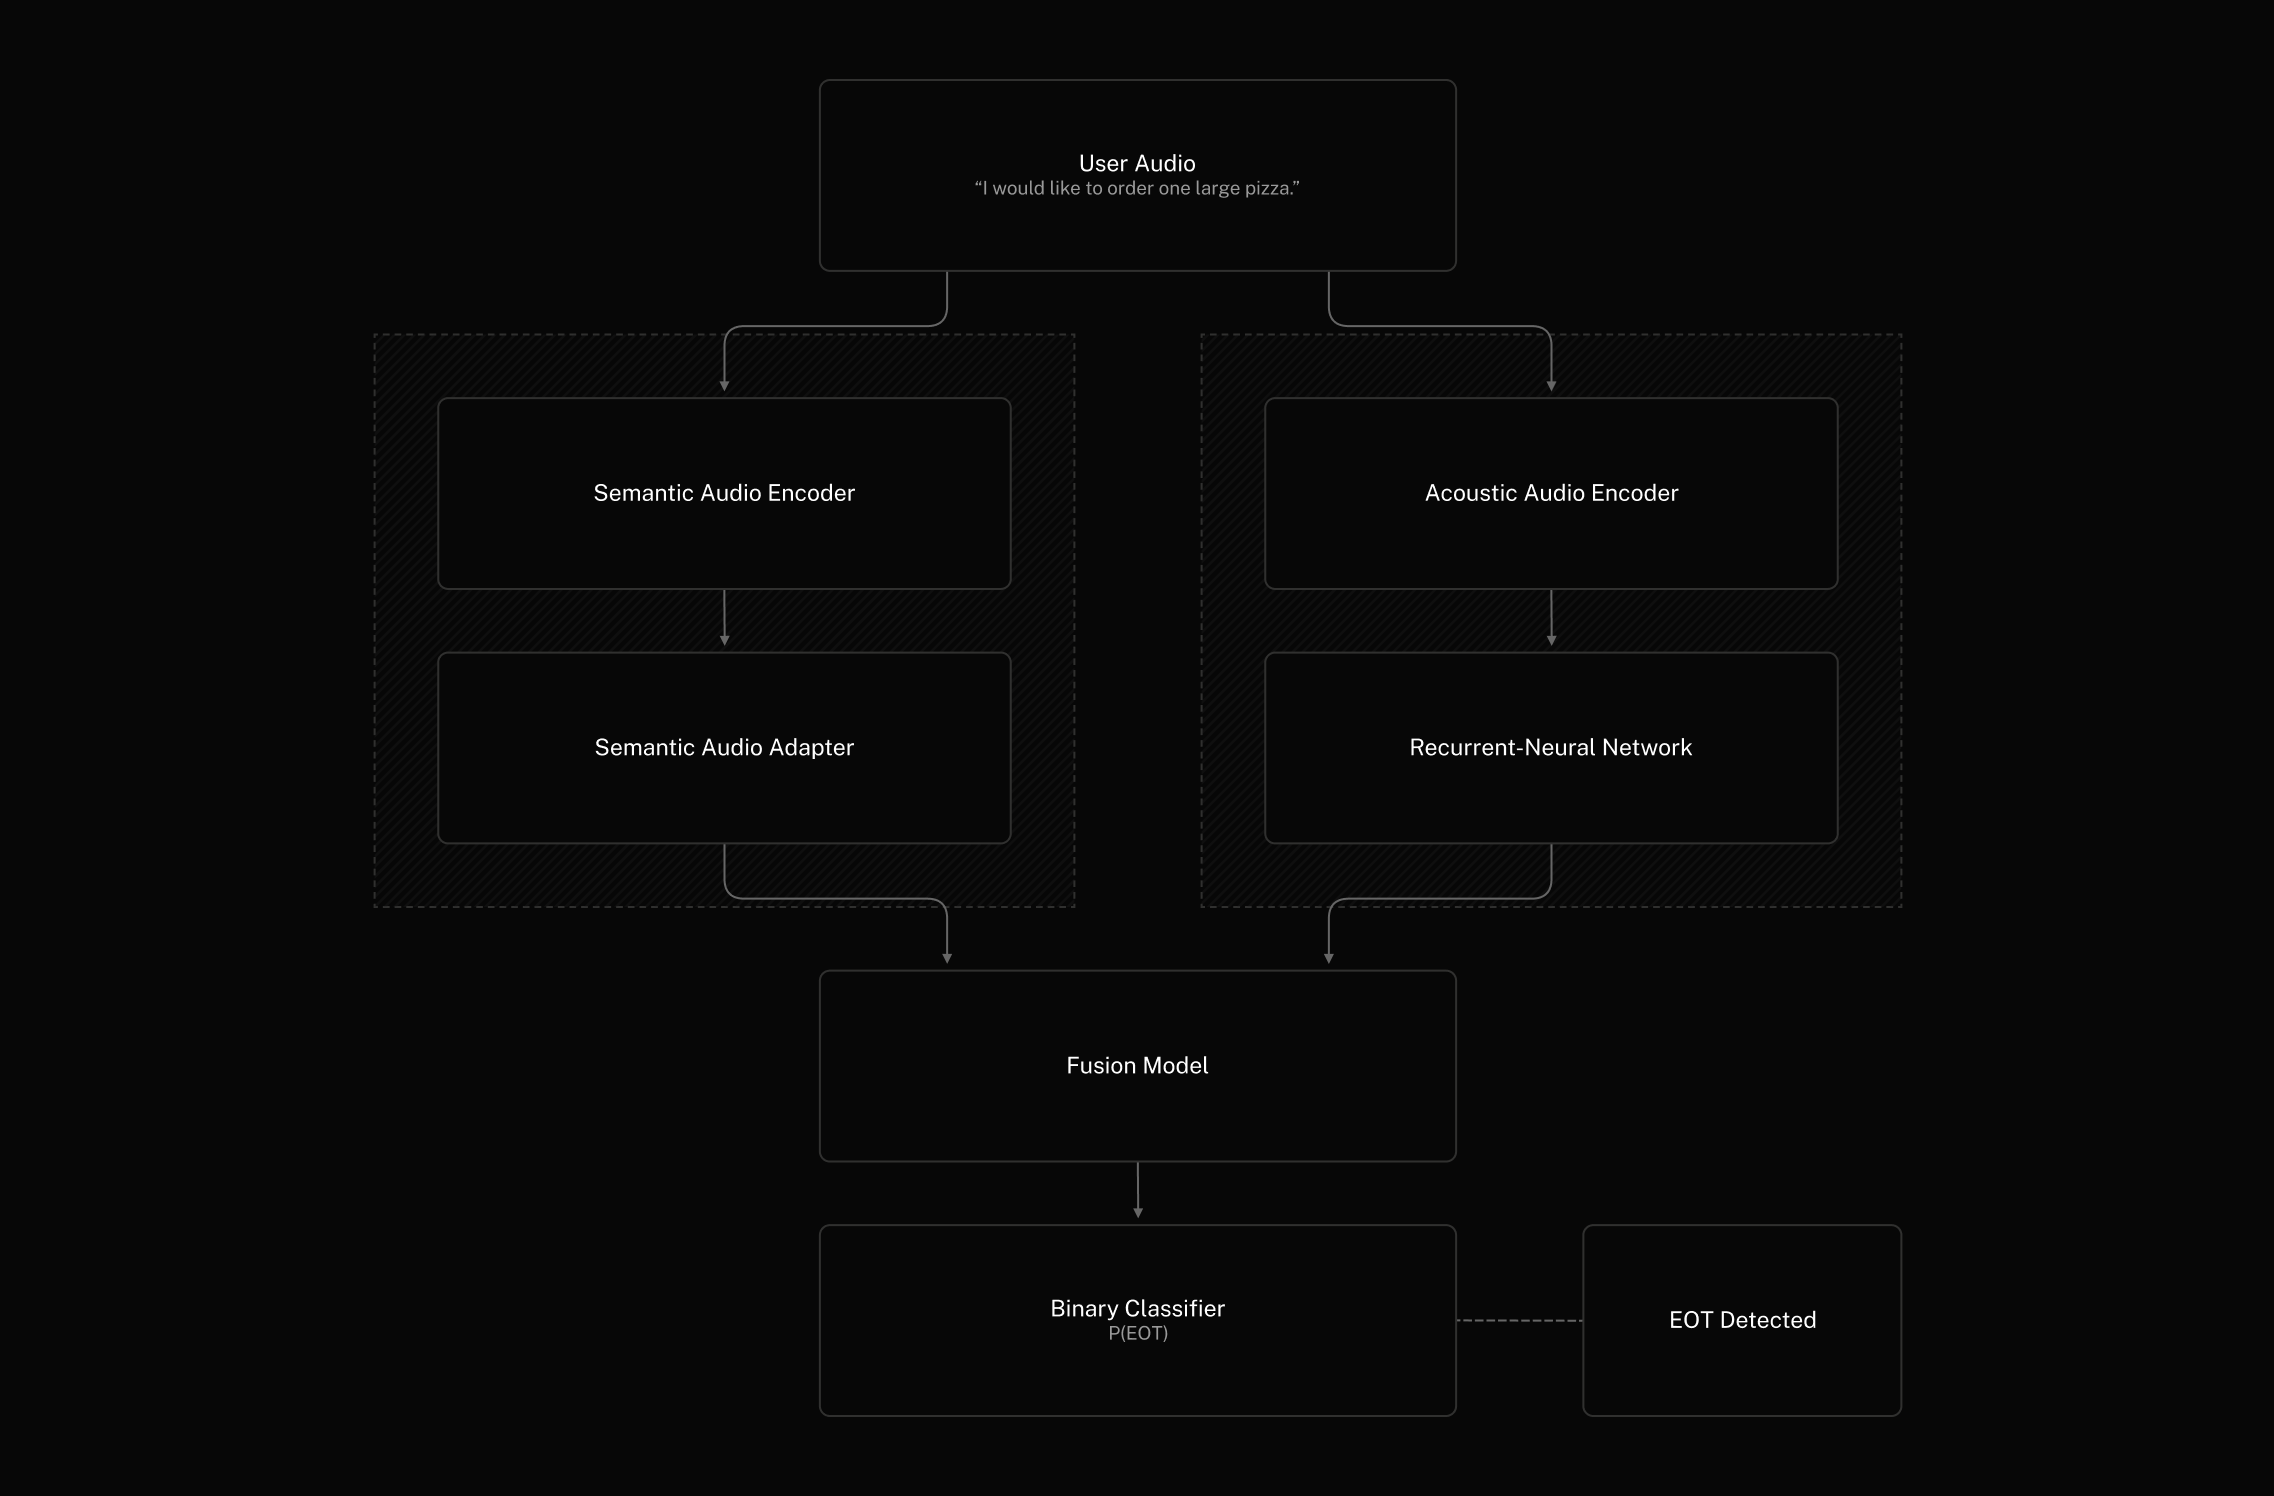
Turn Detector v1 的输入是当前用户轮次的音频,而不是转写文本。模型内部并行处理两类信号,最后输出用户已经结束当前轮次的概率。

模块公开结构职责
语义分支音频编码器 → 可学习适配器 → 微调语言模型理解音频表达的内容,即“说了什么”
声学分支独立音频编码器 → 循环层捕捉时序、语调、音高走势、节奏与停顿形态,即“怎么说”
融合模块Fusion合并两路表征,输出单一的端到端轮次结束概率

可以用下面的概念公式表达官方公开的架构关系。该公式是对模块连接方式的抽象,不代表 LiveKit 已公开的精确网络层数或参数配置:

\( h_{\mathrm{sem}}(t)=\mathrm{LLM}\!\left(A\!\left(E_{\mathrm{sem}}(x_{1:t})\right)\right) \) \( h_{\mathrm{ac}}(t)=\mathrm{RNN}\!\left(E_{\mathrm{ac}}(x_{1:t})\right) \) \( p_{\mathrm{EOT}}(t)=\sigma\!\left(W_f\,[h_{\mathrm{sem}}(t);h_{\mathrm{ac}}(t)]+b_f\right) \)

其中,x₁:ₜ 表示截至时刻 t 可见的因果音频;E_semE_ac 分别表示语义、声学编码器;A 是把音频表征投影到语言模型 embedding 空间的可学习适配器;σ 将融合结果映射为轮次结束概率。

LiveKit Turn Detector model architecture: parallel semantic and acoustic branches combined in a fusion module

这套设计带来的两个直接收益

  • 取消等待最终转写的成本:推理可以直接沿音频流进行,STT 尾部延迟不再是轮次检测的必要组成部分。
  • 缩短上下文:声学分支对当前轮次提供了很强的结束信号,v1 不再像文本版本那样依赖此前多轮对话,只观察当前用户轮次即可完成判断。

需要注意,“没有转写延迟”不等于“响应延迟为零”。系统仍需在避免抢话和快速接话之间选择工作点;模型推理速度与端点策略等待时间也是两个不同概念。

四、eot-bench:把“听起来更自然”变成可复现指标

过去,各家轮次检测厂商通常在私有数据上使用自己的方法评测,结果很难横向比较。LiveKit 因此同步开源 eot-bench,并提供真实人类与语音智能体对话的数据集。数据覆盖阿拉伯语、中文、荷兰语、英语、法语、德语、印地语、印度尼西亚语、意大利语、日语、韩语、葡萄牙语、西班牙语和土耳其语,共 14 种语言。

这里还有一个容易忽略的版本差异:eot-bench 的 14 语种包含阿拉伯语、不包含俄语;上一代 Hugging Face 文本模型的 14 语种则包含俄语、不包含阿拉伯语。讨论“支持 14 种语言”时,应明确是在说哪个版本和哪套评测数据。

评测对象不是孤立音频片段,而是每一次真实停顿

每条数据是一段完整的用户轮次,标注其中所有不少于 100ms 的静音区间。最后一个静音区间标为 eot,代表真正的轮次结束;此前的静音全部标为 hold,代表用户只是犹豫或换气,系统应该继续听。

  • hold 停顿中提前触发,计为 false cutoff,即误截断或抢话。
  • 在真实 eot 后等待过久,会增加用户可感知的 conversational dead air。
  • 评测严格采用因果输入:时刻 t 的模型只能看到时刻 t 之前已经出现的音频与上下文。

完整端点策略的三个旋钮

  1. threshold:结束概率必须超过的置信度阈值。
  2. action_delay:系统允许根据模型分数采取行动前,至少需要经历的静音时长。
  3. timeout:即使模型一直没有触发,系统也必须结束等待的最大静音时长。

若把阈值写作 τ、最小行动延迟写作 d、超时写作 T,则一次停顿中的实际触发时刻可以概括为:

\( t_{\mathrm{fire}}=\min\!\left(T,\;\max\!\left(d,\inf\{t:p_{\mathrm{EOT}}(t)>\tau\}\right)\right) \)

设第 i 个句中停顿的实际长度为 Dᵢ,那么 eot-bench 策略扫描中的误截断率可写成:

\( \mathrm{FCR}=\frac{1}{N_{\mathrm{hold}}}\sum_{i=1}^{N_{\mathrm{hold}}}\mathbf{1}\!\left(t_{\mathrm{fire},i}<D_i\right) \)

对真实轮次结束样本,端点延迟是模型触发时刻;若模型未触发,则按超时值计算。平均延迟为:

\( \overline{L}=\frac{1}{N_{\mathrm{eot}}}\sum_{j=1}^{N_{\mathrm{eot}}}t_{\mathrm{fire},j} \)

eot-bench 会联合扫描阈值、行动延迟和超时,而不是只比较某个厂商手工挑选的单一阈值。默认策略网格包括 0 至 1、步长 0.01 的阈值;0.2 至 1.0 秒的行动延迟;以及 1.0 至 3.5 秒的超时。真正重要的是延迟与误截断率构成的 Pareto 前沿:越靠近左下角,说明系统越少抢话、接话越快。

五、效果对比:v1 在英语评测中的领先幅度

下面的数据来自 eot-bench 仓库当前提交的可复现实验产物。所有数值都表示完整端点策略的用户体验结果,而不是单纯模型推理耗时;每一列都是越低越好。“—”表示该模型没有任何策略配置能达到相应的延迟预算。

模型300ms 延迟预算下误截断率600ms 延迟预算下误截断率误截断≤5%时平均延迟误截断≤10%时平均延迟
LiveKit Turn Detector v19.9%4.5%543ms295ms
Deepgram Flux12.9%9.9%1151ms548ms
ultraVAD27.7%11.9%899ms663ms
LiveKit Turn Detector v1-mini27.8%12.1%1070ms698ms
SmartTurn v3.235.2%14.8%1051ms739ms
AssemblyAI49.4%14.6%1049ms713ms
Soniox5.5%647ms512ms
Cartesia Ink 21056ms911ms
OpenAI GPT Realtime 21143ms824ms
仅 VAD 基线55.6%21.7%1600ms1000ms

如何理解这些数字

  • 300ms 延迟预算:v1 的误截断率为 9.9%,比 Deepgram Flux 的 12.9% 低 3.0 个百分点,相对减少约 23.3%。
  • 600ms 延迟预算:v1 为 4.5%,低于 Soniox 的 5.5%,也不到 Deepgram Flux 9.9% 的一半。
  • 把误截断控制在 5%:v1 平均只需等待 543ms;Flux 需要 1151ms,v1 减少约 608ms 的对话空白。
  • 把误截断控制在 10%:v1 平均延迟为 295ms,比 Flux 的 548ms 少 253ms。

v1-mini 的成绩揭示了明显的压缩代价

v1-mini 与 v1 共享核心架构,但通过权重量化和语言模型主干剪枝来降低体积与 CPU 推理延迟。它保留了大部分模型能力,却没有复制完整版的领先前沿:在 300ms 预算下,v1-mini 的误截断率是 27.8%,明显高于 v1 的 9.9%;在 5% 误截断预算下,其平均延迟为 1070ms,也高于 v1 的 543ms。

因此,v1-mini 的核心卖点不是“和 v1 一样准确”,而是开放权重、本地 CPU 可运行、避免云端推理依赖。对隐私、离线部署或成本高度敏感的应用,这种工程交换可能值得;对追求最佳对话手感的生产系统,官方云端 v1 才是本次发布的主力结果。

六、三个可用版本应该怎么选

版本输入获取与运行方式许可和适用场景
v1 完整版直接音频LiveKit Cloud / LiveKit Inference 优化推理;托管在 LiveKit Cloud 的 agent 可免费使用;各方案本地开发测试每月含 7500 次免费推理请求权重未开放;适合追求最佳效果且可接受云服务的生产应用
v1-mini直接音频Agents SDK 内置;Python livekit-agents ≥1.6.1,TypeScript @livekit/agents ≥1.4.7;量化并剪枝,可在 CPU 运行代码 Apache-2.0,模型文件使用 LiveKit Model License;适合本地、边缘或隐私敏感部署
v0.4.xSTT 转写文本Hugging Face 下载;Qwen2.5-0.5B 学生模型,INT8 ONNX,CPU 推理,官方给出的内存要求低于 500MBLiveKit Model License;生态成熟,但存在 STT 依赖与声学信息缺失

LiveKit Model License 并非标准 OSI 开源许可证。无论使用 v1-mini 还是 v0.4.x,在商用、再分发或模型衍生场景中,都应先阅读许可证原文,而不能仅凭“开放权重”判断可用范围。

LiveKit Agents 中显式启用 v1

from livekit.agents import AgentSession
from livekit.agents.inference import TurnDetector

session = AgentSession(
    turn_detection=TurnDetector(),
    # STT、LLM、TTS 等其他配置保持不变
)

当 agent 使用 LiveKit Cloud 运行,或者本地开发环境中存在 LiveKit Cloud 凭证时,v1 已成为默认 Turn Detector;显式配置主要用于让依赖关系更清晰。

七、架构层面的意义:轮次检测应该属于谁

Deepgram Flux、Soniox 等 STT 厂商会把端点检测直接嵌入流式识别服务。这样做的优势是识别与端点事件天然协同,接入简单;代价是对话节奏会与 STT 供应商绑定。更换识别服务时,停顿处理、阈值行为和语言覆盖都可能随之改变。

LiveKit 的主张是把轮次检测放在 agent 框架层,使同一套检测逻辑可以与任意 STT、LLM 和 TTS 组合。对多供应商切换、跨语言产品和统一体验治理来说,这种解耦很有价值。不过,这也明显符合 LiveKit 作为 agent 框架与云平台的商业位置,选型时仍应结合系统边界,而不是只接受单一厂商的叙事。

路线优势代价
VAD 静音计时简单、便宜、完全本地不理解语义和韵律,抢话率高
STT 内置端点检测事件与转写深度协同,集成方便行为和语言覆盖绑定供应商
文本语义检测理解句子完整性,本地部署成熟依赖 STT,丢失声学信号
LiveKit v1 音频融合兼顾语义与韵律,可独立于 STT 工作完整版依赖 LiveKit 云服务;本地 mini 版存在明显精度折损

八、如何理性看待“轮次检测已经解决”

  • 值得肯定:LiveKit 不只发布模型,还公开基准、数据结构、适配器、策略扫描方法和实验产物,让厂商声明具备可复现基础。
  • 不能忽略:eot-bench 与 v1 都由 LiveKit 发布,当前结论应准确表述为“在 LiveKit 公开基准上领先”。
  • 数据边界仍然存在:医疗问诊、客服报号、多人会议、强背景噪声、方言、儿童语音、情绪化长停顿等场景可能具有完全不同的分布。
  • 平均值不是全部:上线前应按语言、口音、设备、业务意图和用户群体分别观察尾部延迟与抢话案例。
  • 应评测完整链路:STT、LLM 首 token、TTS 首包、回声消除和打断恢复都会影响最终“对话手感”,Turn Detector 只是其中一环。

对于实际团队,最可靠的做法是把自己的生产对话转换为 eot-bench 的 span 结构,在相同的延迟与误截断预算下复测候选方案。如果采用云端 v1,还应同时评估网络抖动、区域可用性、数据合规和请求成本;如果采用 v1-mini,则要验证压缩后在目标语言和硬件上的真实效果。

结语

LiveKit Turn Detector v1.0 最重要的变化,不只是把某个准确率提高了几个百分点,而是重新定义了轮次检测的输入:系统不再等着读一份丢失韵律的转写稿,而是直接从语音中同时理解内容与表达方式。

完整版 v1 在 eot-bench 上显著领先 Deepgram Flux、Soniox、ultraVAD、SmartTurn 和纯 VAD 基线;v1-mini 则用效果换取开放权重和本地 CPU 部署。再加上公开的真实对话数据、完整策略扫描和 Pareto 前沿,轮次检测终于从“凭感觉调一个静音阈值”,变成了一个可以测量、复现和讨论工程取舍的问题。

它是否真的已经被彻底解决,还需要更多独立数据回答;但至少从这次发布开始,“用户到底说完没有”第一次拥有了一套足够接近生产环境的公开考场。

参考资料

Hy ASR 3.0 preview-腾讯混元语音识别模型

Hy ASR 3.0 preview 融合高精度语音识别与深度语义理解能力,在通用识别、上下文感知、多场景鲁棒性以及方言覆盖等核心维度实现全面提升,能够在更复杂的真实输入中给出准确、连贯且更接近用户意图的转写结果,从“逐字转写、单点优化”演进为“理解语境、兼容场景、一键直出”

架构、数据、后训练持续增强,提升语音识别能力上限

Hy ASR 3.0 preview 的能力提升并非来自单一模块,而是模型架构、数据  Scaling 与后训练优化共同作用的结果。

在架构层面,Hy ASR 3.0 preview 采用兼顾效率与性能的 MoE 架构,并将基座模型升级至 Hy3,进一步增强语言理解、上下文建模和语义推理能力。在语音侧,团队自研无监督语音 Encoder,通过数千万小时级无监督语音数据训练,使其能够从复杂音频中提取高质量的声学表征。

为了持续提升模型的语音建模与理解能力,混元团队对语音 Encoder 和大语言模型进行联合训练,引入数千万小时级、多来源的语音数据,覆盖多种方言、口音和声学环境,并通过高质量数据管线进行精细化标注。在大规模联合预训练的基础上,Hy ASR 3.0 preview 通过多阶段能力注入,逐步获得上下文感知、复杂场景适应和方言识别等能力。
围绕通用识别、上下文理解和复杂场景鲁棒性,团队构建了高质量的 SFT recipe,覆盖上下文 context、专业名词、不同声学环境以及多样人群语音。针对方言识别能力,SFT 数据体系进一步覆盖 10 大方言片区和 20 余个二级小片区。

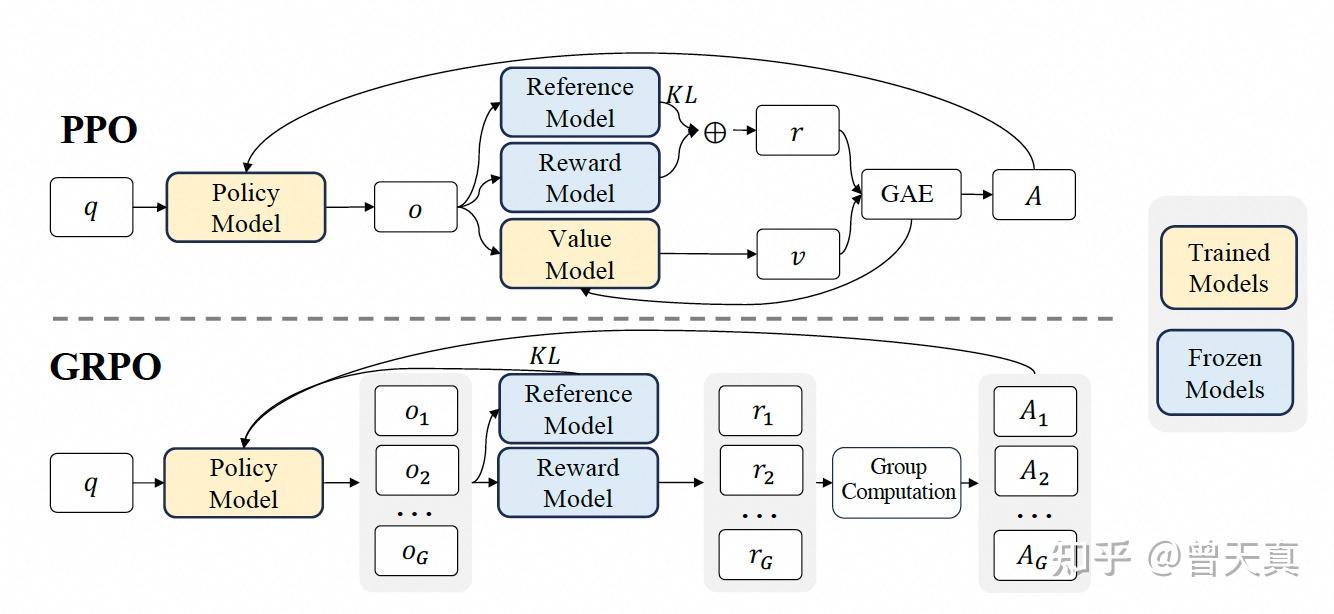
在此基础上,团队进一步引入多阶段强化学习,分别针对通用转写准确性、Any-context 上下文能力和复杂长尾场景进行优化,降低模型在复杂声学环境中的误识别和漏识别问题。

AmphionASR-大规模热词的个性化语音识别

基于Qwen3-ASR-1.7B的统一条件化语音识别系统,将热词检索、目标说话人选择、退化鲁棒与耳语识别整合进单一1.7B参数SpeechLLM。

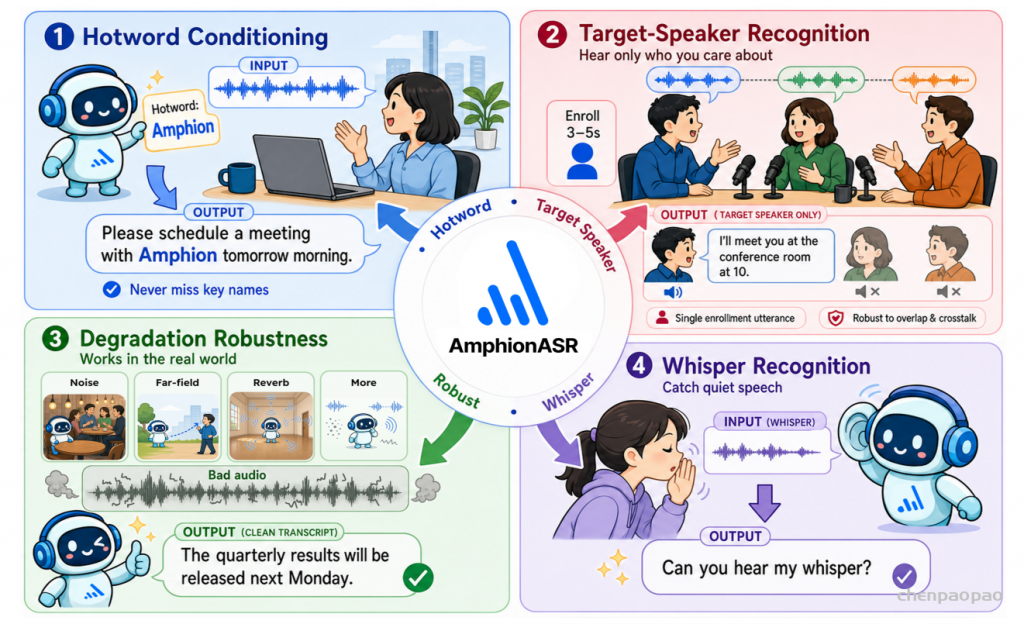
现实中的语音识别往往不只是“把声音转成文字”。用户可能希望模型优先识别人名、品牌名和行业术语,也可能只想转写某个指定说话人;输入音频还可能带有远场、噪声、混响、传输丢失,甚至是耳语。AmphionASR 的目标,就是用一个统一的 SpeechLLM 同时处理这些条件,而不是为每种场景分别维护一套模型。

论文最终给出的模型以 Qwen3-ASR-1.7B 为基础,通过分阶段微调、检索增强和目标说话人数据合成,将通用 ASR、热词 ASR、目标说话人 ASR、退化音频 ASR 和耳语 ASR 统一起来。其最突出的结果包括:热词检索 Recall@50 超过 94%,中英文实体错误率分别下降 55% 和 37%;目标说话人识别 WER 达到 13.02%;中文耳语 CER 为 0.58%,英文耳语 WER 为 6.11%。

AmphionASR 的四项主要条件化识别能力——热词、目标说话人、退化鲁棒性和耳语识别。

一、论文要解决什么问题

传统通用 ASR 默认将输入中的全部可听语音转写出来,但在实际业务里,“识别什么”和“在什么条件下识别”经常需要额外说明。论文将这些需求归纳为四类:

  • 热词条件识别:利用用户提供的词表,提高人名、地名、产品名和专业术语的识别率。
  • 目标说话人识别:给定目标说话人的短注册语音,只转写混合音频中该说话人的内容。
  • 退化音频识别:处理噪声、远场、遮挡、混响、录音染色、电子失真和传输丢失等情况。
  • 耳语识别:处理声带振动特征和正常语音明显不同的低能量耳语。

这些任务的附加信息不同,但输出目标相同:生成用户真正想要的那部分转写。AmphionASR 因而采用统一的指令接口,通过文本指令、热词列表或注册语音告诉模型当前任务。

本文提出 AmphionASR,一套可同时适配上述四类识别任务的统一模型。热词列表、目标说话人注册音频作为任务条件输入;各类受损语音、耳语样本则用于让模型适配非常规声学输入。该设计将通用识别主干网络,与 “识别对象、识别约束条件” 两类辅助信息解耦。 热词识别分支的技术路线参考已有研究,融合 GLCLAP Top-K 检索、提示词注入、基于强化学习的 GRPO 优化方案;本文重点是将整套热词流程集成至统一模型,并在四类任务上完成全面评测。

二、模型总体设计

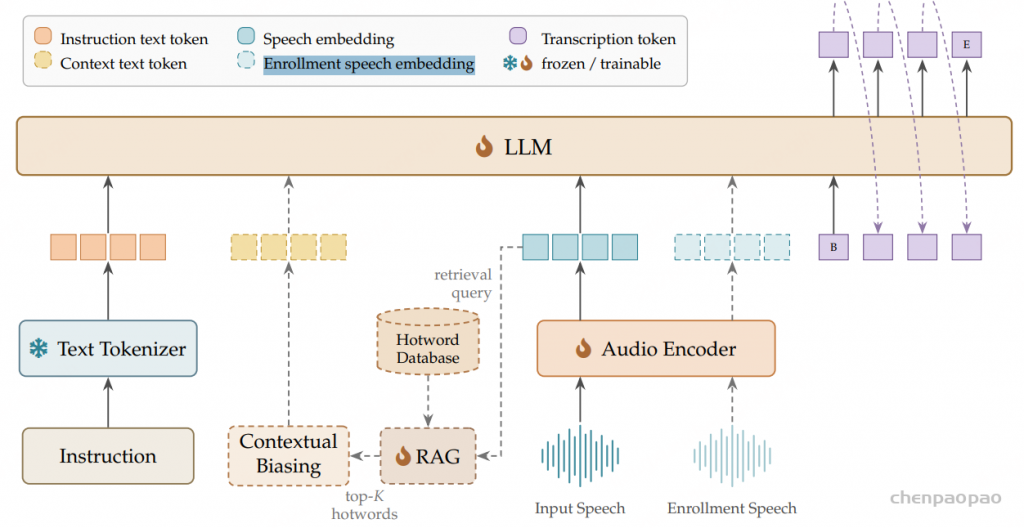
AmphionASR 由音频编码器、语言模型和热词检索分支组成。论文称其为 1.7B 模型,是按照 LLM 参数量命名;如果计入约 300M 的音频编码器和 2.6M 的检索适配器,总参数量约为 2.0B。

组件参数量主要设计
音频编码器300M初始化自 Qwen3-ASR-1.7B 的 AuT 编码器
语言模型1.7B28 层 Decoder-only Transformer,隐藏维度 2048
RAG 适配器2.6M音频和文本两侧的 MLP 投影层
合计约 2.0B音频编码器、LLM 与检索适配器
核心参数来自论文 Table 1。

Figure 2,AmphionASR 整体架构图

1. 音频编码器

输入为 16 kHz 单声道音频。前端提取 128 维 Log-Mel 特征,帧移为 10 ms,随后经过卷积下采样和 24 层 Whisper 风格的 Pre-LN Transformer,输出 2048 维、12.5 Hz 的音频帧表示。模型使用 800 帧的分块推理窗口,从而突破普通 30 秒输入限制。

2. 语言模型与统一提示词

音频表示会直接进入 Qwen3-ASR-1.7B 的语言模型嵌入空间,再由自回归解码器生成转写。不同任务不需要切换模型,只需要更换提示词和可选输入:

  • 通用 ASR:要求转写输入音频。
  • 热词 ASR:在提示词中增加 [Hotwords: ...]
  • 目标说话人 ASR:先输入注册语音,再输入待转写的混合语音。
  • 耳语 ASR:明确告诉模型输入是一段 whispered audio。

目标说话人任务中的注册语音和混合语音共用同一个音频编码器,并以“注册语音在前、混合语音在后”的两个音频嵌入片段进入 LLM。这个设计没有增加独立的说话人编码网络,而是让语言模型在统一上下文中完成说话人条件选择。

三、细粒度热词检索:从万级词库中找出当前相关词

直接把上万个候选热词塞进提示词既浪费上下文,也会引入大量无关干扰。AmphionASR 因此先进行检索,只选出与当前音频最相关的 Top-K 热词,论文默认 K=50。

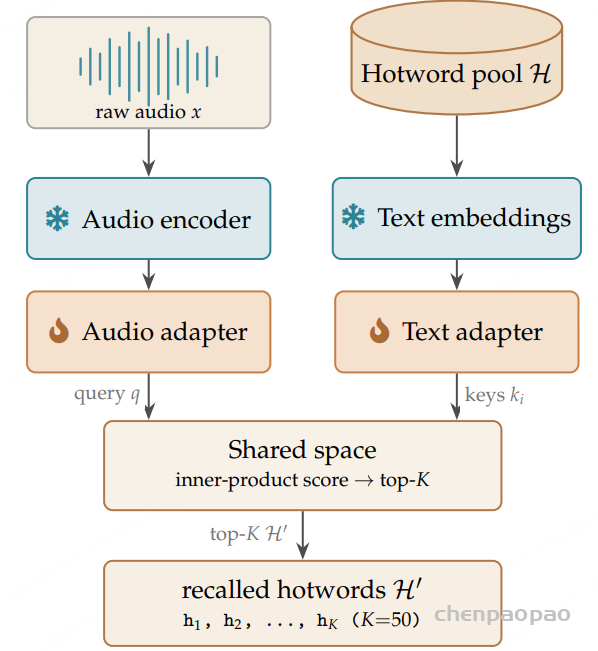
与将整段音频池化成一个向量的方案不同,AmphionASR 保留逐帧音频表示。音频帧和候选热词分别通过两个小型 MLP 映射到共享的 512 维空间:

\( a_t = g_{\mathrm{audio}}\!\left(\mathrm{AuT}(x)_t\right),\qquad k_h = g_{\mathrm{text}}\!\left(E_{\mathrm{tok}}(h)\right) \)

每个热词与所有音频帧计算内积,并取时间维度上的最大值作为相关性:

\( s_h = \max_t a_t^{\top}k_h,\qquad \mathcal{H}’=\operatorname{TopK}_{h\in\mathcal{H}}(s_h) \)

这种 max-over-time 方式强调局部匹配:即使热词只在长音频中短暂出现,也不容易被全句平均表示淹没。选出的热词随后作为逗号分隔的文本插入提示词,ASR 仍然只需要执行一次解码。

Figure 3,细粒度热词检索流程。该图用于说明音频帧、文本热词、共享空间和 Top-K 选择之间的关系

四、训练数据与三阶段训练

AmphionASR 基于低秩自适应微调(LoRA)有监督微调(SFT)三阶段训练方案完成训练。AmphionASR 使用 11 个公开语料构建出 8 个训练集合,总计 3,737,145 条训练样本。其中,目标说话人样本包含注册语音和混合语音两个音频输入,同时加入通用转写数据,缓解模型灾难性遗忘问题。

训练任务样本数主要来源
耳语 ASR222,440WhispEar,中英文耳语
退化鲁棒 ASR556,421Voice-in-the-Wild-2M
热词 ASR1,043,317CommonVoice、MagicData、AISHELL-1/3、THCHS-30
通用 ASR 保持1,290,464AISHELL-2、LibriSpeech
目标说话人 ASR624,503多个公开单说话人语料合成

训练阶段热词词表构建逻辑

针对带热词的训练样本,每条样本动态生成专属热词列表,真实热词 + 干扰词总数量约束在 10~50 个,词表构建分三步:

  1. 真实实体词 每条标注真值热词有 5% 概率被随机剔除,模拟检索模块召回不完全的真实场景。保留绝大多数真实热词,使模型能够借助上下文偏置修正稀有实体、领域专业术语,解决无约束解码器极易错识这类词汇的问题。
  2. 难例负样本(易混淆干扰词) 在线检索器为每条样本最多召回 10 个高度混淆词汇;检索打分权重为:0.6× 字符重叠度 + 0.4× 二元组杰卡德相似度,中文额外增加音节级近邻检索扩充候选。这类字形、发音相近的干扰词用于训练模型区分相似热词,避免模型无脑匹配列表内任意词汇。
  3. 随机干扰词 词表剩余空位从全局热词库随机填充;优先填满难例负样本,再补充随机词,保证列表总长落在 10~50 区间。随机无关词汇用于约束提示词长度,防止模型过度依赖匹配候选词产生识别偏置。

每条语音样本有 80% 概率保留完整热词提示行,20% 概率直接舍弃热词输入。该策略让模型在训练时同时接触 “带热词辅助” 与 “无热词辅助” 两类输入,提升泛化能力。
阶段 1:适应耳语和退化音频

音频编码器和 LLM 同时训练,数据来自 Voice-in-the-Wild-2M 和 WhispEar。由于这些声学条件与普通清晰语音差异较大,论文首先允许声学表示和语言模型共同适应。
阶段 2:学习热词与目标说话人条件

冻结音频编码器,只更新 LLM。模型在这一阶段学习如何使用热词提示,以及如何根据注册语音从多人混合音频中选择目标说话人。

阶段 3:通过数据回放抑制灾难性遗忘

继续冻结音频编码器,在前两阶段数据之外加入 AISHELL-2 和 LibriSpeech 通用转写数据。目的不是追求新的通用 ASR SOTA,而是在增加个性化能力后尽量保留原模型的基础识别能力。

三个阶段均采用全线性层 LoRA,LoRA rank 为 64、alpha 为 128;每阶段训练 1 个 epoch,学习率为 \(1\times10^{-6}\),余弦衰减和 5% warmup,有效 batch size 为 384,使用 6 张 GPU。

GRPO:同时优化转写准确率和热词一致性

三阶段 SFT 后,论文冻结音频编码器,通过 GRPO 继续优化 LLM。ASR 奖励是经过截断的负 CER:

\( R_{\mathrm{asr}}(\hat y,y)=\max\left(0,1-\mathrm{CER}(\hat y,y)\right) \)

热词奖励检查每个候选词在预测和参考文本中的“出现/未出现”状态是否一致:

\( R_{\mathrm{hw}}(\hat y,y;C)=\frac{1}{|C|}\sum_{c\in C} \mathbf{1}\!\left\{\mathbf{1}[c\in\mathrm{Pred}]=\mathbf{1}[c\in\mathrm{Ref}]\right\} \)

总奖励为:

\( R=R_{\mathrm{asr}}+0.3R_{\mathrm{hw}} \)

这一设计不仅鼓励模型抄对热词,也惩罚它盲目输出提示词中实际没有被说出的词。不过论文没有提供“SFT 后、GRPO 前”的独立对照,因此实验无法单独量化 GRPO 的贡献。

五、目标说话人数据是如何合成的

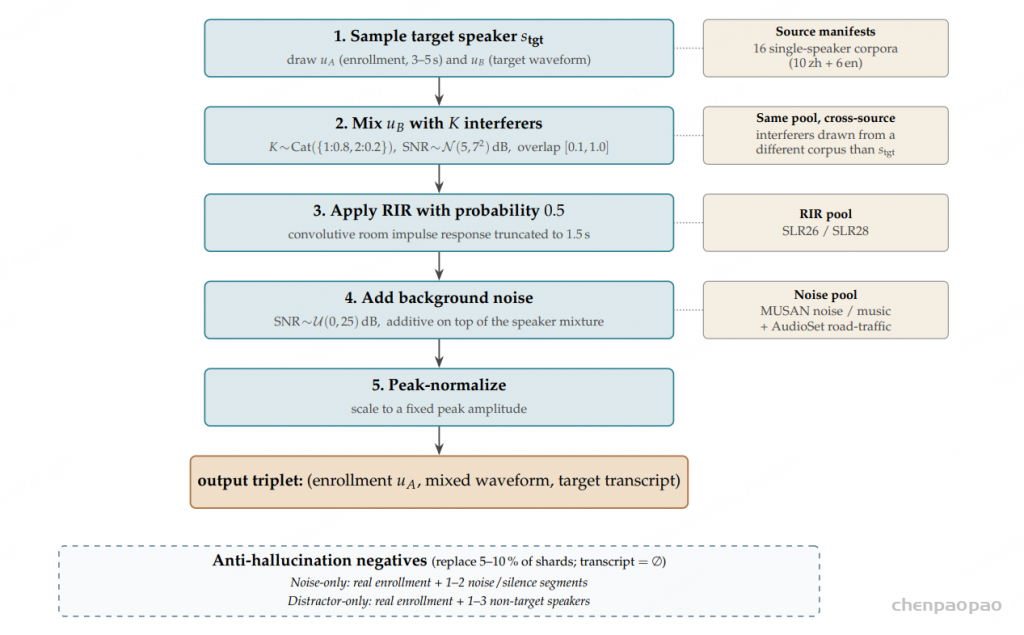
目标说话人训练数据由单说话人语料离线合成。对于同一目标说话人,系统选择两段不同录音:一段作为 3 至 5 秒注册音频,另一段作为待混合的目标语音,再加入 1 至 2 个非目标说话人。

混音过程可写为:

\( x_{\mathrm{mix}}[n]=s_{\mathrm{tgt}}[n]+\sum_{k=1}^{K}\alpha_k s_{\mathrm{int},k}[n-o_k],\qquad \alpha_k=\frac{\rho_{\mathrm{tgt}}}{\rho_{\mathrm{int},k}}10^{-\mathrm{SNR}_k/20} \)

其中 \(K\sim\mathrm{Cat}(\{1:0.8,2:0.2\})\),说话人间 SNR 服从均值 5 dB、标准差 7 dB 的正态分布,并截断到 -5 至 20 dB;干扰语音覆盖目标语音的比例从 0.1 到 1.0 均匀采样。之后以 0.5 的概率加入 RIR,再以 0 至 25 dB 的 SNR 加入 MUSAN 或 AudioSet 环境噪声。

为了降低“目标说话人不在场时仍然胡乱输出”的问题,训练集还包含 66,194 条空转写负样本,包括噪声/静音和只有非目标说话人的混合音频。这一部分是目标说话人系统能够学习保持沉默的关键。

Figure 4,目标说话人训练数据离线合成流程;可同时参考 Table 16 和 Table 17 的 RIR、噪声来源与负样本参数

六、实验结果

1. 热词和行业实体识别

在 GigaSpeechBench 的 12 个垂直领域中,加入 RAG 后,中文平均实体 B-CER 从 23.18% 降至 10.39%,相对下降约 55%;英文平均实体 B-WER 从 14.78% 降至 9.35%,相对下降约 37%。加入热词上下文后,AmphionASR 在中文 12 个领域中的 11 个、英文全部 12 个领域中优于无热词输入的 Qwen3-ASR-1.7B。

测试集无 RAG使用 RAGRecall@50
GigaSpeechBench 中文平均 B-CER23.18%10.39%
GigaSpeechBench 英文平均 B-WER14.78%9.35%
CommonVoice 中文热词9.27%2.30%94.52%
CommonVoice 英文热词28.93%9.81%95.19%
根据论文 Table 9、Table 10 和 Table 11 汇总,指标均越低越好,Recall 除外。

在约一万个候选词的词库上,相比已经预先计算好 Top-50 热词的条件,在线检索增加的配对中位延迟为英文 1.37 ms、中文 3.25 ms。但该实验每种语言只有 30 条音频,运行在共享 H20 上,没有并发和 RTF 数据,因此只能说明热状态下的相对开销,不能直接视为生产吞吐量结论。

2. 目标说话人识别

在内部合成的目标说话人测试集正样本上,AmphionASR 的 WER 为 13.02%,明显低于零样本 Qwen3-Omni-30B-A3B 的 31.91%,也远低于未进行目标说话人训练的 Qwen3-ASR-1.7B 的 78.99%。

模型正样本 WER目标缺席静音误报率
Qwen3-ASR-0.6B84.97%100.00%
Qwen3-ASR-1.7B78.99%100.00%
Qwen3-Omni-30B-A3B 零样本31.91%9.15%
AmphionASR13.02%6.10%
论文 Table 13,数值越低越好。

这一结果说明模型确实学到了“根据注册语音选择说话人”的能力,同时负样本降低了目标缺席时的幻觉。不过测试集由与训练相同的合成流水线生成,只是更换随机种子和说话人;论文也没有与专用 TS-ASR 模型进行完全一致协议下的比较,因此泛化能力仍需要公开真实重叠语音数据验证。

3. 真实退化音频鲁棒性

Voice-in-the-Wild-Bench 包含 5,000 条中英文音频,覆盖 7 类单一退化和 Mixed 复合退化,并分为真实录音与频谱模拟两组,共 16 个子集。AmphionASR 在其中 8 个子集取得最低 WER。

  • 真实录音领先项:遮挡 1.38%、混响 7.91%、录音染色 6.32%、传输丢失 2.32%。
  • 模拟退化领先项:噪声 7.24%、混响 11.49%、录音染色 11.55%、Mixed 4.19%。
  • Real-Mixed 为 2.85%,仅次于 Mega-ASR 的 2.63%。

这说明阶段 1 的退化训练具有明显效果,但 AmphionASR 并非在所有条件下都领先,例如真实噪声、远场、电子失真以及部分模拟条件仍有其他专用模型表现更好。

4. 耳语识别

耳语识别是论文中最稳定的优势之一。AmphionASR 在中文 wEar 上取得 0.58% CER,在英文 WTIMIT 上取得 6.11% WER,均为表中最低。

模型wEar 中文 CERWTIMIT 英文 WER
Whisper-large-v316.33%11.99%
Kimi-Audio-7B-Instruct1.48%10.95%
Qwen3-ASR-1.7B1.22%9.56%
FireRed-ASR2-LLM1.01%15.18%
AmphionASR0.58%6.11%
论文 Table 15 的主要模型结果。

相比基础模型 Qwen3-ASR-1.7B,AmphionASR 在中文耳语上绝对降低 0.64 个百分点,在英文耳语上绝对降低 3.45 个百分点。模型同时在中英文上领先,说明耳语训练没有出现明显的语言间取舍。

5. 通用 ASR 能力是否被遗忘

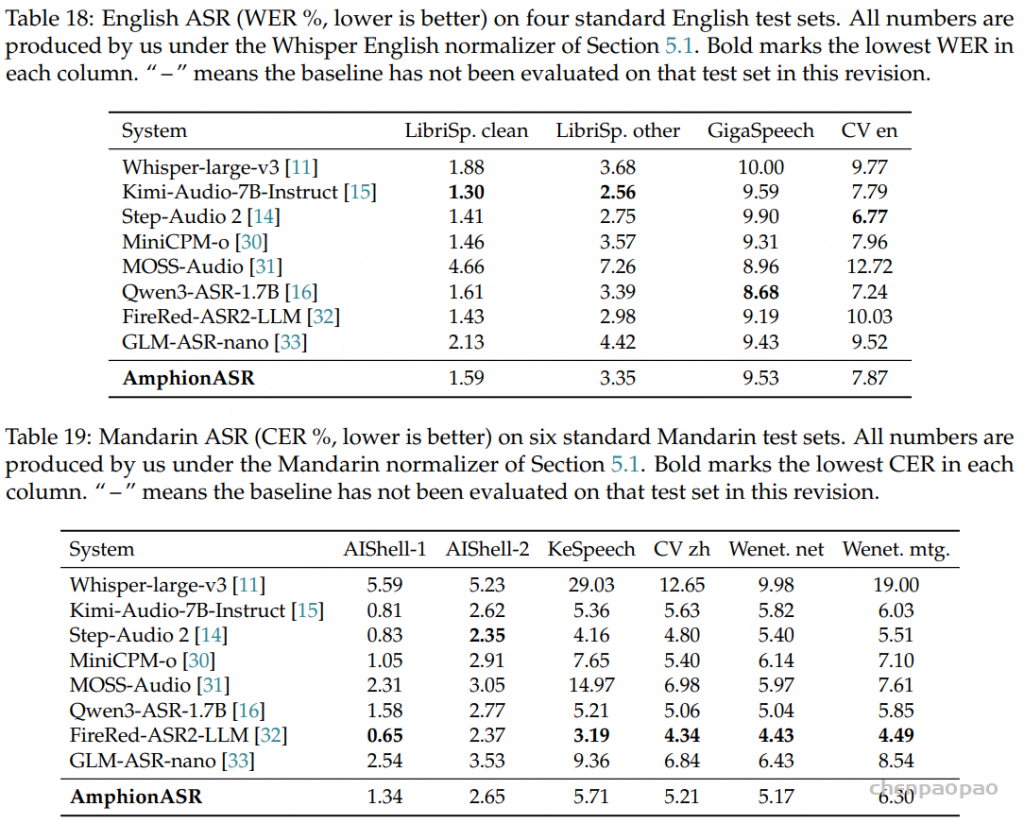
论文在 4 个英文和 6 个中文通用测试集上进行了保持性检查。与同规模的 Qwen3-ASR-1.7B 相比,AmphionASR 在每个测试集上的差距都不超过 0.85 个绝对 WER/CER 点,并在两者直接比较时赢下 10 个测试集中的 4 个。

需要区分的是:这不代表 AmphionASR 在 4 个数据集上取得所有系统中的最好结果。Table 18 和 Table 19 的整体领先者仍分散在 Kimi-Audio、Step-Audio、FireRed-ASR2 等模型中。论文将该实验定位为“能力保持检查”,而不是通用 ASR 的 SOTA 声明,这是较为客观的表述。

七、论文的主要创新点

  1. 用统一接口承载多种条件化 ASR。文本指令、热词和注册语音都被组织为 LLM 上下文,使不同任务共享音频编码器和解码器。
  2. 将帧级热词检索接入完整 SpeechLLM。局部 max-over-time 匹配比整句池化更适合发现短时出现的实体,并把万级候选库压缩到 Top-50。
  3. 通过双音频输入实现目标说话人选择。注册音频和混合音频共用声学编码器,不需要额外构建完全独立的 TS-ASR 网络。
  4. 系统化构造目标缺席负样本。噪声、静音和纯干扰说话人样本教会模型在找不到目标时保持沉默,从而降低幻觉。
  5. 分阶段训练兼顾专项能力与基础能力。先适应声学变化,再学习条件控制,最后回放通用数据,训练顺序与不同模块的职责相匹配。

需要注意,论文明确指出 GLCLAP Top-K 检索、提示词注入和 GRPO 的组合已有相关工作。AmphionASR 的贡献重点不是提出一种全新的检索或强化学习算法,而是把这些方法集成到统一模型中,并覆盖更多条件化识别任务。

八、局限性与值得继续验证的问题

  • 语言范围有限:当前核心评测只覆盖普通话和英语,尚不能证明统一训练方法对越南语等语言同样有效。
  • 热词对比并非完全同输入:多数基线没有收到热词,因而结果证明的是完整“检索加上下文提示”流水线价值,而不是公平条件下检索器单模块的增益。
  • GRPO 缺少独立消融:没有 SFT-only 对照,无法知道最终提升中有多少来自 GRPO。
  • 目标说话人测试仍偏内部合成:需要在公开真实会议、重叠说话和跨设备数据上验证。
  • 延迟测试规模较小:共享 GPU、每种语言 30 条请求、无并发、无 RTF,不能据此推断生产服务容量。
  • 统一模型并非所有任务都最优:它的优势是能力覆盖和共享部署,而不是在每个通用或退化子集上都击败专用模型。

九、总结

AmphionASR 最有价值的地方,是把 ASR 从“无条件转写器”推进成“可被用户条件控制的语音识别模型”。热词告诉模型哪些词值得重点关注,注册语音告诉模型应该听谁,任务指令告诉模型输入属于耳语还是普通语音,而退化数据让模型适应真实采集环境。

从实验结果看,热词和耳语是目前证据最充分的两项能力:前者在万级候选词库下显著降低实体错误,后者在中英文测试集上同时取得最好结果。目标说话人和退化鲁棒性同样表现出潜力,但还需要更严格的公开测试和生产级吞吐评估。

对于实际 ASR 系统,这篇论文给出的启发并不是必须把所有任务都塞进一个模型,而是可以建立一套共享的语音表示和解码骨干,再通过文本上下文、参考音频与检索结果描述用户意图。这样既能减少多模型维护成本,也让个性化语音识别拥有更统一的产品接口。


G-STAR: 端到端全局说话人追踪属性识别

paper: https://arxiv.org/pdf/2603.10468

G-STAR是一个LLM-based端到端多说话人ASR系统:1)Sortformer风格流式说话人追踪模块 + 到达顺序说话人缓存(AOSC);2)Speech-LLM转录主干(Qwen2-7B-Instruct + LoRA);3)交错时序融合(K:1插入)结合声学和说话人嵌入;4)缓存一致的SOT解码。三阶段训练:会议式ASR预训练→局部SA-ASR训练→全局SA-ASR训练。

💡 为什么值得关注

     LLM-based ASR近两年进展比较显著,但在多说话人ASR场景,依然需要持续持续探索。G-STAR解决了局部说话人日志与全局身份一致性难以兼顾的问题,将“时间感知的说话人跟踪”与“基于LLM的转录生成”耦合在一个可端到端训练的框架中,从而在“何时”、“何人”、“说了什么”这三个维度的信息上实现协同。此外,G-STAR支持分块流式推理且无需用户提前进行语音注册。对做会议转录、语音助手的团队有直接参考价值。

多方会议转写不只是“把语音变成文字”。系统还需要判断每句话是谁说的、发生在什么时间,并且在长音频被切成多个片段处理时,让同一个人的说话人编号始终保持一致。G-STAR 的主要贡献,就是把带缓存的全局说话人跟踪器与 Speech-LLM 生成模型连接起来,让文字、时间戳和全局说话人标签在同一条件上下文中联合生成。

一、论文要解决什么问题

给定长音频波形,模型需要输出一组带说话人和时间边界的文本片段:

\( Y=\left\{\left(s_n,\tau_n^{\mathrm{st}},\tau_n^{\mathrm{ed}},y_n\right)\right\}_{n=1}^{N} \)

其中,\(s_n\) 是说话人身份,\(\tau_n^{\mathrm{st}}\) 和 \(\tau_n^{\mathrm{ed}}\) 是起止时间,\(y_n\) 是对应文本。真正困难的地方在于:长会议通常必须分块推理,但说话人身份不能在每个块中重新编号。例如第一块中的 spk1,到了第十块仍然应该指向同一个真实说话人。

此前方法通常只解决其中一部分问题:SpeakerLM 更擅长块内说话人建模,但缺少显式的跨块全局身份关联;JEDIS-LLM 使用说话人缓存维持全局标签,却没有细粒度时间边界;TagSpeech 强化了时间锚点和说话人提示,但没有解决长音频分块推理中的会议级身份链接。G-STAR 的目标是同时覆盖时间戳、重叠语音、说话人归属和跨块全局一致性。

二、G-STAR 的总体设计

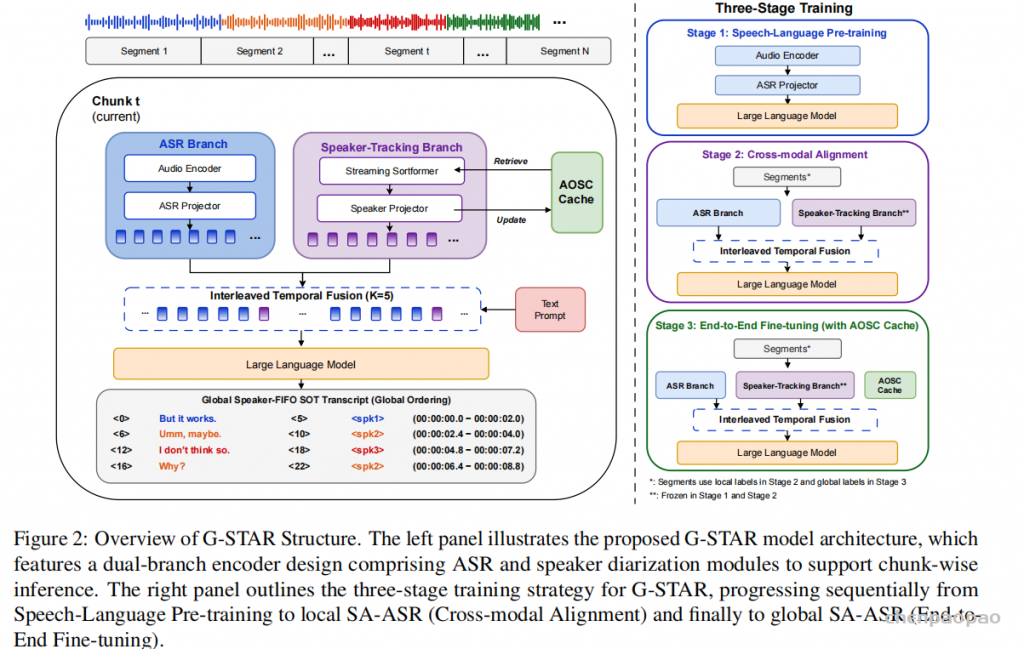
G-STAR 由三部分组成:ASR 声学分支、说话人跟踪分支,以及维护全局身份的 Arrival-Order Speaker Cache(AOSC)。两条分支生成的特征按照时间顺序交错融合,随后送入大语言模型,以 Serialized Output Training(SOT)格式输出文字、时间戳和全局说话人标签。

1. 分块处理与全局输出格式

长音频 \(x\) 被划分为连续的 \(T\) 个块:

\( x=\left\{x^{(t)}\right\}_{t=1}^{T} \)

每个块生成一个序列化结果,结构可以表示为:

\( z^{(t)}=\left[\langle t_{\mathrm{st}}\rangle,\;w,\;\langle t_{\mathrm{ed}}\rangle,\;\langle \mathrm{spk}=k\rangle\right]^{*} \)

这里的 \(k\) 不是当前块内的临时编号,而是由 AOSC 维护的会议级到达顺序编号。

2. ASR 声学分支

音频编码器首先把第 \(t\) 个音频块转换为帧级声学特征:

\( H^{(t)}=f_{\mathrm{enc}}\left(x^{(t)}\right)\in\mathbb{R}^{L_t\times d_h} \)

随后 ASR projector 将其映射到 LLM 的嵌入空间:

\( U^{(t)}=g_1\left(H^{(t)}\right)\in\mathbb{R}^{L_t\times d_{\mathrm{llm}}} \)

实现中,音频编码器和投影器初始化自 FireRed-LLM,语言模型使用 Qwen2-7B-Instruct,并继承 FireRed-LLM 的 LoRA 权重。

3. 说话人跟踪分支与 AOSC

说话人分支采用 Streaming Sortformer。它不只读取当前音频,还读取上一块保留下来的缓存:

\( S^{(t)},C^{(t)}=f_{\mathrm{trk}}\left(x^{(t)},C^{(t-1)}\right),\qquad S^{(t)}\in\mathbb{R}^{M_t\times d_s} \)

其中 \(C^{(t-1)}\) 是历史 AOSC 状态,\(S^{(t)}\) 是当前块的帧同步说话人提示。实现中,该分支初始化自 NVIDIA 的 diar_streaming_sortformer_4spk-v2;说话人 projector 由步长为 5 的一维卷积降采样模块和两层 MLP 组成,再把提示映射到 LLM 空间:

\( V^{(t)}=g_2\left(S^{(t)}\right)\in\mathbb{R}^{M_t\times d_{\mathrm{llm}}} \)

AOSC 按说话人在会议中首次出现的顺序保存紧凑状态。新说话人出现时分配下一个槽位;历史说话人再次出现时,系统从缓存中找回原槽位。因此,全局编号具有可解释性,也避免了不同音频块之间的标签置换漂移。

4. 交错时间融合

论文没有在最后阶段才把 ASR 与说话人时间轴做“后融合”,而是把说话人特征直接插入声学 token 流。设插入步长为 \(K\),融合结果为:

\( E^{(t)}=\operatorname{Interleave}\left(U^{(t)},V^{(t)};K\right)\in\mathbb{R}^{N_t\times d_{\mathrm{llm}}} \) \( N_t\approx L_t+\left\lceil\frac{L_t}{K}\right\rceil \)

具体来说,每经过 \(K\) 个声学位置就插入一次说话人提示。如果两条分支的帧率不同,则使用确定性的最近邻或线性重采样对齐。论文默认重点验证 \(K=5\),即在信息密度和对词汇建模的干扰之间取折中。

5. 全局 SOT 解码

LLM 在文本提示、融合后的声学/说话人表示以及已生成 token 的条件下进行自回归解码:

\( p\left(z^{(t)}\mid x^{(t)},C^{(t-1)}\right)=\prod_{m=1}^{\left|z^{(t)}\right|}p\left(z_m^{(t)}\mid p,E^{(t)},z_{<m}^{(t)}\right) \)

由于 <spk=k> 与 AOSC 中第 \(k\) 个到达顺序槽位绑定,模型可以在逐块解码时直接生成全局一致的说话人标签,不再依赖会后全局聚类。

三、三阶段训练策略

  1. 会议风格 ASR 预训练:让音频编码器、ASR projector 和 LLM 适应对话及会议语音。
  2. 局部 SA-ASR 跨模态对齐:在最长 20 秒的分段语音上学习时间戳、文本和块内说话人标签。Figure 2 显示说话人跟踪模块在前两个阶段冻结。
  3. 全局 SA-ASR 端到端微调:引入 AOSC 和全局标签,训练跨块一致的说话人归属。同时使用四个数据集构造的 90 秒片段独立调优 Sortformer,以增强长音频跟踪能力。

Speech-LLM 各阶段保持可训练模块一致:ASR projector、说话人 projector 和 LoRA adapter。LoRA rank 为 64,缩放因子为 16,dropout 为 0.05。训练样本最大打包长度为 12,000 tokens。

前两个阶段分别训练 20,000 steps,峰值学习率为 \(5\times10^{-5}\);全局阶段训练 5,000 steps,峰值学习率降为 \(2\times10^{-5}\)。均使用 AdamW、0.01 warmup ratio 和余弦退火。Sortformer 调优采用学习率 \(10^{-4}\)、batch size 4,共训练 5 epochs。

为了让模型更加重视结构 token,论文使用分层交叉熵:时间戳 token 权重为 1.5,说话人标签 token 权重为 2。可将其直观写成:

\( \mathcal{L}=\mathcal{L}_{\mathrm{lexical}}+1.5\,\mathcal{L}_{\mathrm{timestamp}}+2\,\mathcal{L}_{\mathrm{speaker}} \)

四、数据集与评价协议

公开实验使用四个会议或对话数据集:MLC 英文子集、AMI、Fisher,以及只使用音频模态的 Candor。训练音频被切分为最长 20 秒的片段。内部模型还使用中文对话数据;公开配置则使用 AISHELL-4 和 AliMeeting 等公开会议数据作为对应数据来源。

  • 局部设置:输入不超过 20 秒,使用 oracle VAD/分段,重点考察后端的联合转写和说话人归属能力。
  • 全局设置:输入完整会议,各系统使用自己的 VAD 或分段前端并逐块推理,更接近真实部署,但 VAD 差异也会进入最终结果。
  • 指标:cpWER 衡量考虑说话人匹配后的转写错误,DER 衡量说话人日志错误;两者都是越低越好。
  • DER collar:公开实验为 0,内部测试集为 0.5 秒。模型幻觉产生的额外片段会被计入 cpWER 和 DER 错误。

论文还实现了一个受控后融合基线:ASR 使用同一 Speech-LLM 后端,VAD 切出语音段,CTC 强制对齐补充词级时间戳,Sortformer 生成全局说话人时间轴,最后再按时间重叠关系合并。这个对照可以较好地区分“组件更强”和“跟踪条件直接参与生成”之间的差异。

五、局部实验结果

表 1 对应论文 Table 1,单位为 cpWER/DER(%),输入最长 20 秒,oracle VAD,DER collar=0。

系统AMIFisherMLCCandor
Sortformer(仅 DER)— / 29.87— / 18.33— / 17.76— / 30.92
Parakeet(仅 cpWER)24.62 / —27.73 / —25.90 / —27.44 / —
VibeVoice-ASR30.51 / 31.9915.18 / 17.6821.74 / 14.0122.12 / 30.89
MOSS-Diarizen25.13 / 32.2011.69 / 21.6114.16 / 10.5816.38 / 31.76
G-STAR24.86 / 19.0010.29 / 8.1813.90 / 6.4914.54 / 17.56

G-STAR 在四个数据集上都显著降低了 DER,并且在 Fisher、MLC 和 Candor 上获得最低 cpWER。AMI 的 cpWER 为 24.86,与 Parakeet 的 24.62 基本相当,但 DER 从 Sortformer 的 29.87 降到 19.00。结果说明,说话人提示被注入 LLM 后,并没有以牺牲词汇识别为代价,反而提升了联合生成的稳定性。

六、完整会议的全局实验

表 2 对应论文 Table 2,单位为 cpWER/DER(%),完整会议逐块推理,DER collar=0。

系统FisherMLCCandorAMI
Sortformer(仅 DER)— / 15.21— / 21.92— / 18.03— / 28.35
Parakeet(仅 cpWER)24.41 / —31.03 / —26.92 / —35.70 / —
VibeVoice-ASR25.03 / 27.1525.41 / 19.8327.24 / 25.6834.19 / 39.95
受控后融合级联21.01 / 23.4123.18 / 21.3817.62 / 17.6739.52 / 37.63
G-STAR16.44 / 16.8517.15 / 14.2515.17 / 24.8930.85 / 32.23

G-STAR 在 Fisher、MLC、Candor 和 AMI 上都取得最低的会议级 cpWER。相对使用相近主干组件的受控后融合方案,cpWER 分别从 21.01、23.18、17.62、39.52 降至 16.44、17.15、15.17、30.85,相对降幅约为 21.8%、26.0%、13.9% 和 21.9%。这说明改进并不只是来自更强的 ASR 或说话人模块,而是因为说话人跟踪信息在生成过程中直接参与了决策。

不过,DER 结果需要客观看待:G-STAR 在 MLC 上最好,但 Fisher 的 Sortformer、Candor 的受控后融合方案以及 AMI 的 Sortformer 都得到更低 DER。换言之,G-STAR 的优势重点是最终的“谁说了什么”联合转写,而不是在所有场景中取代专门的说话人日志系统。

内部域外会议测试

内部测试集包含 0.50 小时双人会议、0.49 小时三人会议和 1.86 小时四人会议。论文将三至四人场景合并报告,DER collar 为 0.5 秒。

系统2 人3–4 人平均
VibeVoice-ASR11.10 / 14.8354.48 / 38.3347.64 / 34.62
聚类式 Pipeline23.56 / 14.2041.14 / 30.7638.37 / 28.15
G-STAR10.42 / 4.8638.85 / 28.5934.37 / 24.88

G-STAR 的平均 cpWER/DER 为 34.37/24.88,优于 VibeVoice-ASR 的 47.64/34.62,也优于聚类式 Pipeline 的 38.37/28.15。双人场景提升最明显,DER 只有 4.86;三至四人会议仍然明显更难,说明说话人数增加后,全局跟踪和重叠语音依旧是主要挑战。

七、消融实验说明了什么

表 3 对应论文 Table 4,单位为 cpWER/DER(%)。

分层 CE交错时间融合AMIFisherCandor
26.33 / 21.0610.88 / 10.2414.97 / 20.21
28.63 / 21.2814.23 / 9.0218.30 / 18.10
24.86 / 19.0010.29 / 8.1814.54 / 17.56

两项设计的作用并不相同。交错时间融合对 cpWER 的帮助更大,说明周期性注入说话人提示能够协助 LLM 同时生成正确文字和结构 token;分层交叉熵对 DER 的改善更直接,因为更高的时间戳与说话人 token 权重会强化边界和说话人切换预测。两者同时启用时,三个数据集都得到最佳综合结果。

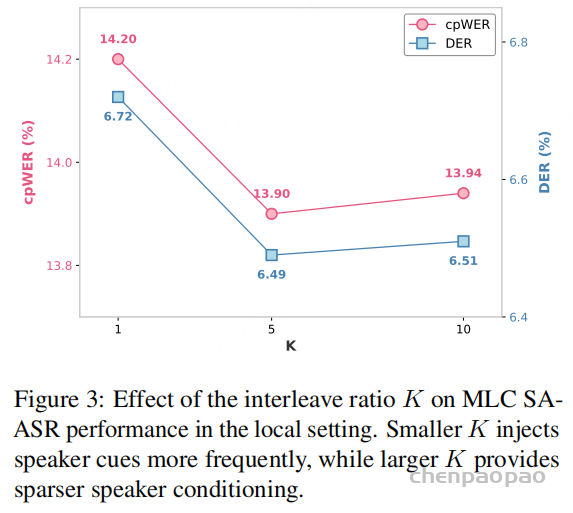
Figure 3 进一步比较了 MLC 上不同插入步长:

插入步长 KcpWERDER
114.206.72
513.906.49
1013.946.51

\(K=1\) 时提示过密,非词汇条件可能干扰语言建模;\(K=10\) 时提示偏稀疏;\(K=5\) 在 cpWER 和 DER 上取得最优平衡。

八、论文的主要创新点

  1. 把说话人归属从后处理变成生成条件。说话人时间信息在 LLM 解码前进入统一嵌入序列,而不是 ASR 完成后再做时间轴拼接。
  2. 用 AOSC 解决跨块身份漂移。按首次到达顺序维护说话人槽位,使长会议中的全局标签具备持续状态和可解释编号。
  3. 统一生成文字、时间戳和全局说话人标签。SOT 输出接口让多个结构化目标被组织为单一自回归序列,同时保留重叠语音片段。
  4. 兼顾模块化训练和端到端优化。说话人跟踪器可以独立调优,Speech-LLM 又能在其提示条件下联合优化,适合训练数据来源不一致或存在域偏移的情况。
  5. 建立局部与全局两套评价协议。oracle 分段实验隔离后端能力,完整会议实验则验证 VAD、跟踪、时间戳和转写共同作用下的真实表现。

九、局限性

第一,论文采用分块推理,但没有完整评估严格实时流式部署,尚缺少端到端延迟、缓存内存开销和在线缓存更新稳定性数据。第二,训练数据规模和多样性仍然有限,跨语言、复杂声学环境、更多说话人以及更强重叠场景的泛化能力还有提升空间。第三,从公开实验可以看到,模型对最终 cpWER 的优化非常稳定,但纯 DER 并非全面领先;如果应用只关注高精度说话人日志,专门的 diarization 系统仍可能更合适。

十、总结

G-STAR 最值得关注的不是简单增加一个说话人编码器,而是重新定义了说话人归属在 Speech-LLM 中的位置:它不再是 ASR 后面的拼接步骤,而是影响生成过程的显式条件。AOSC 负责记住“谁已经出现过”,交错时间融合负责在合适的时间点把信息交给 LLM,全局 SOT 则把文字、时间戳和身份转换为可直接阅读的统一序列。

实验表明,这一路线尤其适合长会议的“谁说了什么”任务:G-STAR 在四个完整会议基准上都获得最低 cpWER,并在内部域外数据上继续保持优势。其下一步关键问题,是把这种缓存条件生成机制推进到低延迟、严格在线的真实流式系统中。


说话人验证:Hybrid Enrollment + Neural Re-scoring 论文解读

本文讨论的是短时长说话人验证(Short-duration Speaker Verification, SDSV):在智能音箱、对话终端或用户自定义关键词唤醒场景中,系统先检测到一句很短的目标短语,再判断这句话是不是注册用户本人说的。

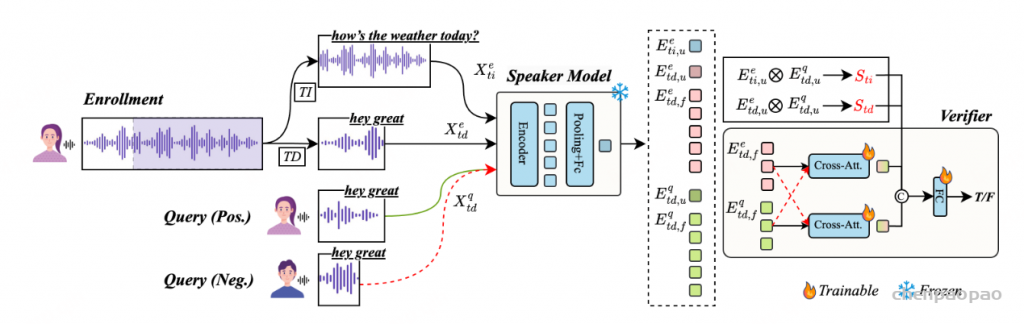
这类测试语音通常短于 3 秒,身份信息很少,且更容易受噪声、音素覆盖和短语内容变化影响。论文的核心思路不是重新训练一个大声纹模型,而是冻结已有说话人骨干模型,在其上训练一个轻量 neural verifier:注册端同时使用文本相关(TD)短语和文本无关(TI)较长语音,查询端仍是 TD 短语,通过全局余弦相似度和双向帧级 cross-attention 做神经重打分。

1. 任务背景:短语音声纹验证为什么难?

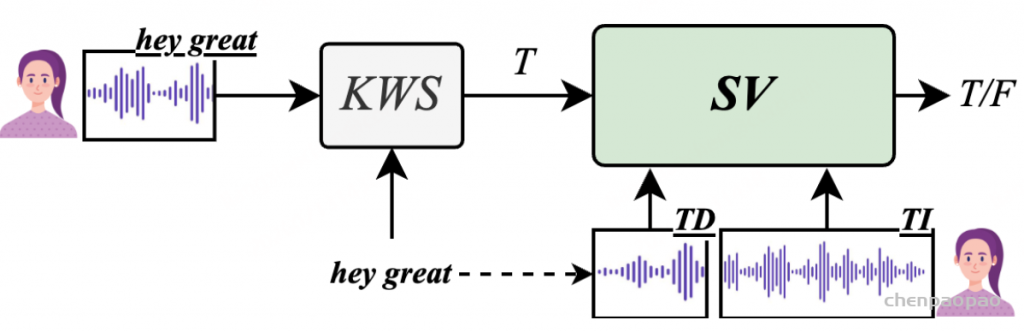
在用户自定义关键词(UDKWS)系统中,典型链路是:先通过 keyword spotting 找到用户说出的目标短语,再对这个短语片段做说话人验证。问题在于,这个片段通常只有 0.8 到 3 秒。相比长语音声纹验证,短语级音频中的说话人信息更少,固定维度 embedding 加余弦相似度的传统后端更容易出现分数不稳定。

图 1:针对自定义短语的短时长说话人验证任务示意图。首先,输入的语音会被一个自定义关键词检测模块进行处理,然后会被用来与文本依赖型或文本独立型的注册语音进行验证。

论文把注册方式分为两类:

  • TD enrollment:注册语音和查询语音是同一类短语,内容一致,音素更对齐,但注册时长也很短,说话人信息不足。
  • TI enrollment:注册语音不要求和查询短语内容一致,可以更长,身份信息更稳定,但存在文本内容不匹配。

论文的关键观察是:TD 的文本一致性有优势,但受限于短时长;TI 有内容 mismatch,但随着注册时长增加,speaker representation 会越来越稳定。因此,真实系统里不应该只押 TD 或 TI 单一路线,而应该把二者互补起来。

2. 方法总览:冻结骨干,只训练轻量验证器

论文提出的框架由两部分组成:一个冻结的 pretrained speaker backbone,以及一个可训练的 neural verifier。骨干模型负责提取 utterance-level 和 frame-level speaker features;verifier 负责把 TD、TI 与 query 之间的全局和局部证据融合成最终验证分数。

设 TI 注册语音为 \(X_{\mathrm{ti}}^e\),TD 注册语音为 \(X_{\mathrm{td}}^e\),TD 查询语音为 \(X_{\mathrm{td}}^q\)。冻结骨干会输出句级表示和帧级表示:

\( X_{\mathrm{ti}}^e \rightarrow (E_{\mathrm{ti},u}^e, E_{\mathrm{ti},f}^e),\quad X_{\mathrm{td}}^e \rightarrow (E_{\mathrm{td},u}^e, E_{\mathrm{td},f}^e),\quad X_{\mathrm{td}}^q \rightarrow (E_{\mathrm{td},u}^q, E_{\mathrm{td},f}^q) \)

这里 \(u\) 表示 utterance-level embedding,\(f\) 表示 frame-level feature。论文使用的骨干包括 ECAPA-TDNN、CAM++ 和 ERes2Net-L,全部在 Vox2 上预训练,并在本文训练中保持冻结。这一点对工程落地很重要:不需要推倒重训声纹模型,只需在已有声纹模型上加轻量重打分头。

3. 全局相似度:同时保留 TI 身份稳定性和 TD 内容一致性

verifier 首先计算两个 utterance-level 余弦相似度:

\( S_{\mathrm{ti}}=\cos(E_{\mathrm{ti},u}^e,E_{\mathrm{td},u}^q),\quad S_{\mathrm{td}}=\cos(E_{\mathrm{td},u}^e,E_{\mathrm{td},u}^q) \)

\(S_{\mathrm{ti}}\) 更偏向捕获稳定的说话人身份信息,\(S_{\mathrm{td}}\) 更偏向利用短语内容一致带来的匹配优势。单看这两个分数仍然是传统 embedding 后端思路,所以论文进一步引入帧级 cross-attention 来处理短语内部的局部对齐问题。

4. Parallel Cross-Attention:在帧级别重新对齐短语证据

短时长语音的问题不是只有“信息少”,还包括局部音素和时间位置不稳定。论文使用共享的 parallel cross-attention 模块,对 TD 注册短语和 TD 查询短语的 frame-level features 做双向比较。

注册到查询方向:

\( \tilde{Z}^{e}= \mathrm{CrossAtt.} (Q=E_{\mathrm{td},f}^{e},K=E_{\mathrm{td},f}^{q},V=E_{\mathrm{td},f}^{q}) \)

查询到注册方向:

\( \tilde{Z}^{q}= \mathrm{CrossAtt.} (Q=E_{\mathrm{td},f}^{q},K=E_{\mathrm{td},f}^{e},V=E_{\mathrm{td},f}^{e}) \)

随后对两个方向的输出做时间维 max pooling,并拼接得到局部匹配特征:

\( h_f=[\max(\tilde{Z}^{e}) \Vert \max(\tilde{Z}^{q})] \)

这一步是论文方法的关键:它不再把短语直接压成一个向量硬比,而是让注册短语和查询短语在帧级别互相“看见”对方,从短语内部找到更细粒度的匹配证据。中文解读里强调的“注册看查询、查询看注册,把短序列里对得上的局部证据捞出来”,对应的就是这个双向 cross-attention 模块。

5. 融合决策与训练目标

最终,模型把局部帧级特征 \(h_f\)、TI 全局相似度 \(S_{\mathrm{ti}}\) 和 TD 全局相似度 \(S_{\mathrm{td}}\) 输入轻量 MLP,输出最终验证分数:

\( S=\sigma(F(h_f,S_{\mathrm{ti}},S_{\mathrm{td}})) \)

其中 \(\sigma(\cdot)\) 是 sigmoid 函数。训练使用二分类交叉熵:

\( \mathcal{L}=- \left[ y\log S+(1-y)\log(1-S) \right] \)

\(y \in \{0,1\}\) 表示 enrollment 和 query 是否来自同一说话人。实验中 verifier 包含线性投影层和对称 cross-attention 模块,attention 为 8 heads,hidden dimension 为 128;训练在单张 RTX 4090 上进行,batch size 256,训练 25k steps。

6. VoxPhrase 数据集:从 VoxCeleb 自动切出短语级声纹验证数据

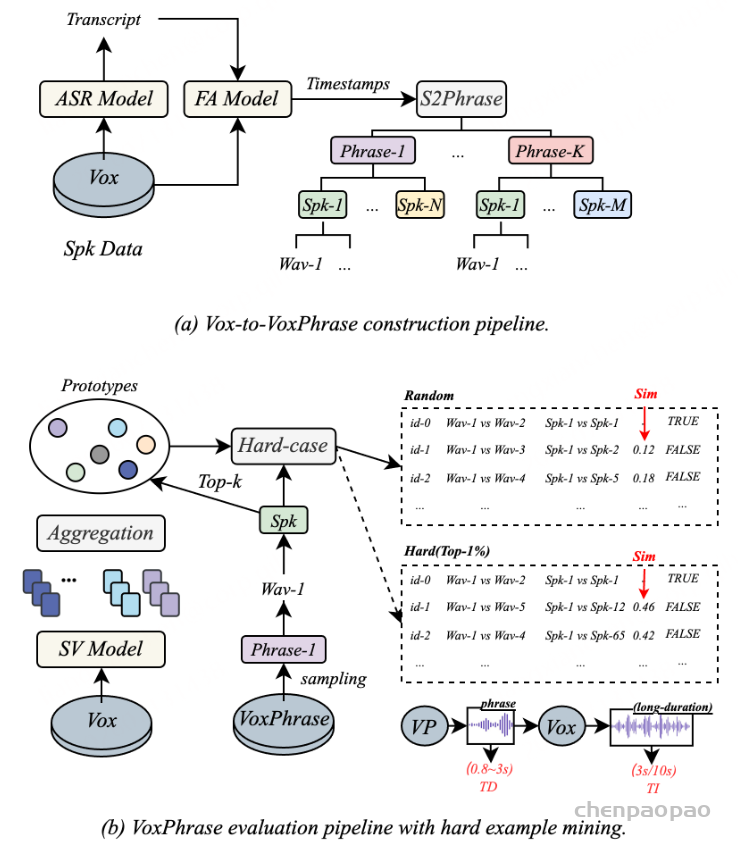
论文的另一个重要贡献是构建 VoxPhrase,用来模拟用户自定义短语下的 SDSV。构建流程是:先对 VoxCeleb 语音做 ASR 获得 transcript,再用 forced alignment 生成词或短语级时间戳,随后通过 S2Phrase 脚本把长语音切成 0.8 到 3 秒的短语片段,并过滤低质量对齐结果。每个短语片段保留 speaker identity 和 waveform。

VoxPhrase 的关键规模如下:

  • 训练集来自 Vox2-dev:5,994 个说话人,215,432 个短语。
  • Eval-1 来自 Vox1:1,251 个说话人,23,036 个短语。
  • Eval-2 来自 Vox2-test:118 个说话人,2,310 个短语。
  • Eval-3 / Eval-4 来自 DeepMine,用于 OOD 测试,短语分别是 “ok google”(约 2 秒)和 “my voice is my password”(约 3 秒)。

为了让评测更接近真实难例,论文还设计了 hard example mining。具体做法是先按说话人聚合短语样本,用预训练 SV 模型构造 speaker prototype,再计算说话人之间的相似度,把“相似但不同人”的配对选为 hard negatives。Eval-1 中 trials 包括 top-1% 565,242、top-5% 903,678、top-10% 1,041,902 和 random 1,382,110;Eval-2 中对应为 26,904、52,702、65,086 和 95,900。

7. 实验设置:三个强声纹骨干 + 多种注册方式

论文使用三个开源说话人模型作为冻结骨干:ECAPA-TDNN(20.8M 参数,embedding 维度 192)、CAM++(7.2M 参数,embedding 维度 512)和 ERes2Net-L(20.5M 参数,embedding 维度 192)。它们在 VoxCeleb-O 上的基础 EER 分别为 0.86、0.65 和 0.57,说明骨干本身已经是强基线。

对比的 enrollment 设置包括:10 秒 TI、3 秒 TI、TD phrase(0.8–3 秒),以及加入 verifier 后的混合注册神经重打分。指标使用 Equal Error Rate(EER,越低越好),并报告不同 hard-negative 难度下的结果。

8. 主要结果:混合注册 + 神经重打分跨骨干稳定提升

Table 2 的核心结论是:在 3 秒或 10 秒 TI 注册条件下,TI 通常优于纯 TD,因为更长注册音频提供了更稳定的身份信息;但当 TI 极短时,TD 的短语内容一致性又变得重要。因此最稳的方案是 TD + TI 混合注册,再通过 neural verifier 重新打分。

几个代表性数字如下:

  • ECAPA-TDNN:Eval-1 平均 EER 从 10 秒 TI 的 6.59 降到 5.75;3 秒 TI 从 8.23 降到 6.45;TD phrase 从 10.06 降到 9.27。
  • CAM++:Eval-1 平均 EER 从 10 秒 TI 的 6.44 降到 5.35;3 秒 TI 从 8.15 降到 6.03;TD phrase 从 9.15 降到 8.31。
  • ERes2Net-L:Eval-1 平均 EER 从 10 秒 TI 的 5.27 降到 4.54;3 秒 TI 从 6.51 降到 5.13;TD phrase 从 7.96 降到 7.22。

在最难的 top-1% hard-negative 场景中,改进同样明显。例如 CAM++ 的 10 秒 TI top-1% EER 从 11.33 降到 9.58,3 秒 TI 从 13.34 降到 10.47;ERes2Net-L 的 10 秒 TI top-1% EER 从 9.32 降到 8.17,3 秒 TI 从 11.02 降到 8.99。说明该方法不是只在容易样本上调分,而是在相似说话人构成的 hard cases 中也有效。

9. TI 时长分析:什么时候 TI 强,什么时候 TD 强?

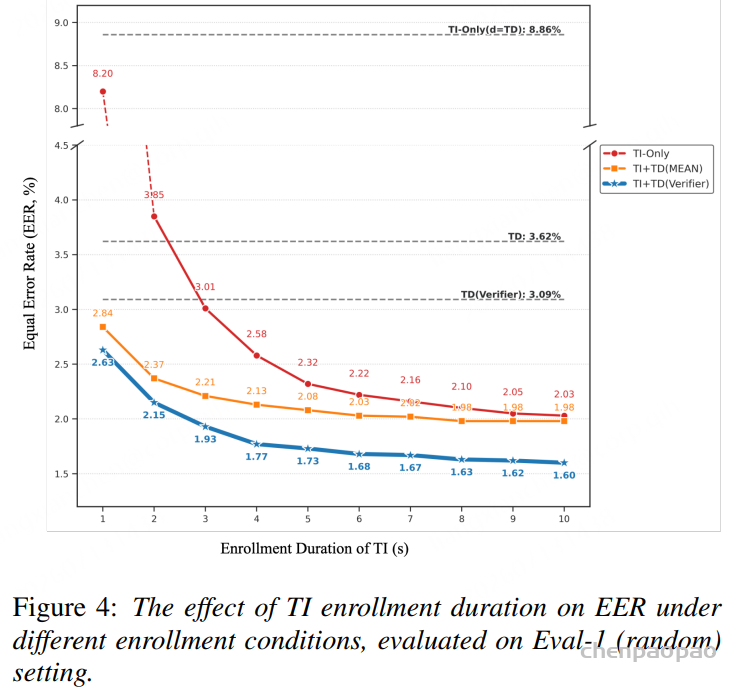
Figure 4 分析了 TI enrollment duration 对 EER 的影响。论文报告,在 CAM++ 的 Eval-1 random 设置下,纯 TD enrollment 的 EER 为 3.62%,加入 verifier 后降到 3.09%。而 3 秒 TI enrollment 的 EER 为 8.86%,表现较差;随着 TI 时长从 1 秒增加到 10 秒,EER 持续下降。当 TI 时长超过 3 秒时,TI 开始优于 TD;当 TI 小于 2 秒时,TI 仍弱于 TD。

这组实验解释了论文方法为什么要做 hybrid enrollment:TI 不是天然更好,它依赖足够时长;TD 也不是过时方案,在极短注册语音下,短语内容一致性仍然有价值。简单把 TI 和 TD 分数平均并不够,论文提到 10 秒时 TI+TD(mean) 几乎收敛到 TI-only(2.03% vs. 1.98%),而混合注册 + 神经重打分能进一步达到 1.6%。真正带来差距的是可学习的 frame-level re-scoring,而不是机械平均。

10. OOD 结果:DeepMine 上也能降 EER

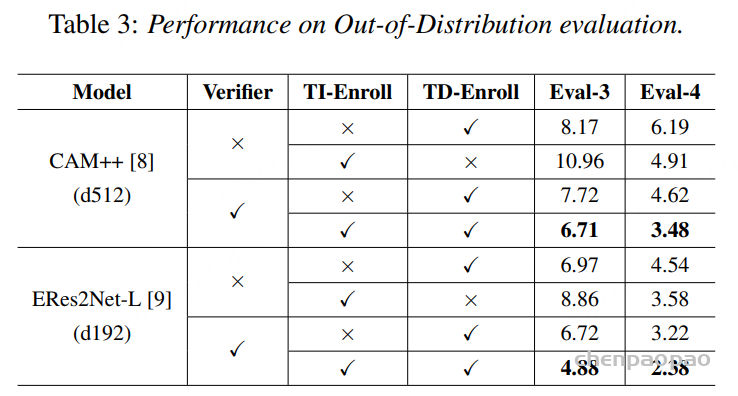
论文还在 DeepMine 构造的 Eval-3 / Eval-4 上做 out-of-distribution 评估。这里的短语分别是 “ok google” 和 “my voice is my password”。结果显示,在 OOD 场景中 TD enrollment 通常优于短时 TI enrollment,因为文本一致性更重要;但混合注册 + verifier 仍然取得最好结果。

CAM++ 上,Eval-3 / Eval-4 的 EER 从纯 TD 的 8.17 / 6.19 降到混合方案的 6.71 / 3.48。ERes2Net-L 上,从纯 TD 的 6.97 / 4.54 降到 4.88 / 2.38。这个结果说明,verifier 学到的不是只适配 VoxPhrase 域内数据的打分偏置,而是对短语级验证中的局部匹配确实有泛化帮助。

11. 创新点总结

  • 面向真实 UDKWS 的 SDSV 设定:论文关注用户自定义短语,而不是固定口令或预定义说话人集合,更贴近智能设备中的实际声纹核验链路。
  • VoxPhrase 数据集:从 VoxCeleb 自动构建 0.8–3 秒短语级声纹验证数据,并加入 hard example mining,使评测能覆盖相似说话人的难例。
  • Hybrid enrollment:把 TI 的稳定身份信息和 TD 的短语一致性结合起来,避免单一路线在不同注册时长下失效。
  • 冻结骨干 + 轻量 verifier:不修改 ECAPA-TDNN、CAM++、ERes2Net-L 等强声纹模型,只训练小型重打分模块,部署成本更低。
  • Parallel cross-attention:在 TD 注册短语和 TD 查询短语之间做双向帧级交互,弥补单个 utterance embedding 对局部短语证据建模不足的问题。
  • 实验结论清晰:TI 超过 TD 需要足够注册时长;极短 TI 下 TD 更稳;简单平均不足,神经重打分才是提升 EER 的关键。

12. 局限

这篇论文的优点是问题定义明确、工程路线轻量、实验覆盖多个骨干和 OOD 数据。但也有一些边界需要注意。第一,VoxPhrase 是从 VoxCeleb 自动切分得到,虽然规模大,但仍依赖 ASR 和 forced alignment 质量;真实设备中的远场噪声、回声、唤醒误检可能更复杂。第二,论文主要使用 EER 评估,没有展开真实产品中常见的固定 FAR/FRR 操作点分析。第三,方法需要注册端同时具备 TD 和 TI 语音,若用户注册流程只允许一句极短短语,混合注册收益会受限。

整体来看,这篇工作的价值不在于提出一个很大的声纹 backbone,而在于把短语级声纹验证中的两个实际矛盾讲清楚:短 TD 有内容一致性但身份信息少,长 TI 有身份稳定性但内容不一致。Hybrid enrollment 提供两类证据,parallel cross-attention 负责细粒度对齐,neural re-scoring 再学习如何融合它们。对于智能音箱、车载语音、个人助理和用户自定义关键词系统,这是一条比较务实的改进路线。

参考

Zhiqi Ai, Han Cheng, Shiyi Mu, Zhiyong Chen, Yongjin Zhou, Shugong Xu. Stabilizing Short Duration Speaker Verification through Neural Re-scoring with Hybrid Enrollment. arXiv:2606.16115v1, 2026. https://arxiv.org/abs/2606.16115

中文解读参考:短语音不到 3 秒,说话人验证怎么稳住?https://mp.weixin.qq.com/s/yM0XWdtOntNFMqWh3HW0hw

LangFlow: Continuous Diffusion Rivals Discrete in Language Modeling

  • 论文标题:LangFlow: Continuous Diffusion Rivals Discrete in Language Modeling
  • 论文链接:https://arxiv.org/abs/2604.11748
  • github:https://github.com/nealchen2003/LangFlow
  • huggingface:https://huggingface.co/papers/2604.11748

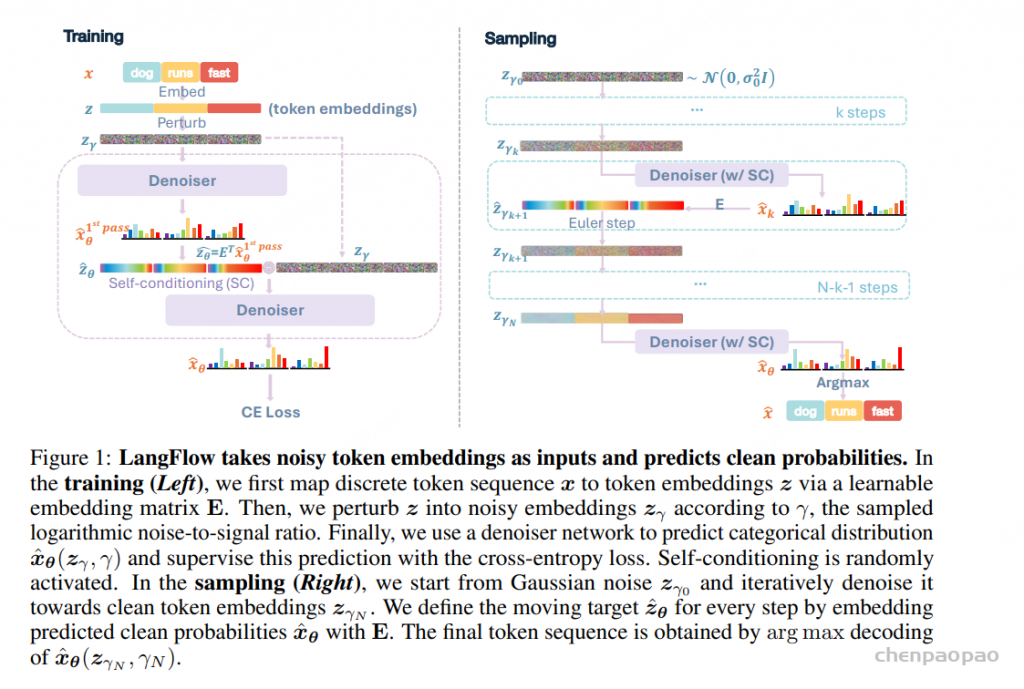
LangFlow 关注一个长期没有被充分解决的问题:连续扩散模型在图像、视频等连续模态上很强,但在语言建模中一直落后于离散扩散。作者认为问题不在于连续扩散本身不可行,而在于 embedding-space diffusion 的训练目标、似然评估和噪声调度设计还不够清楚。

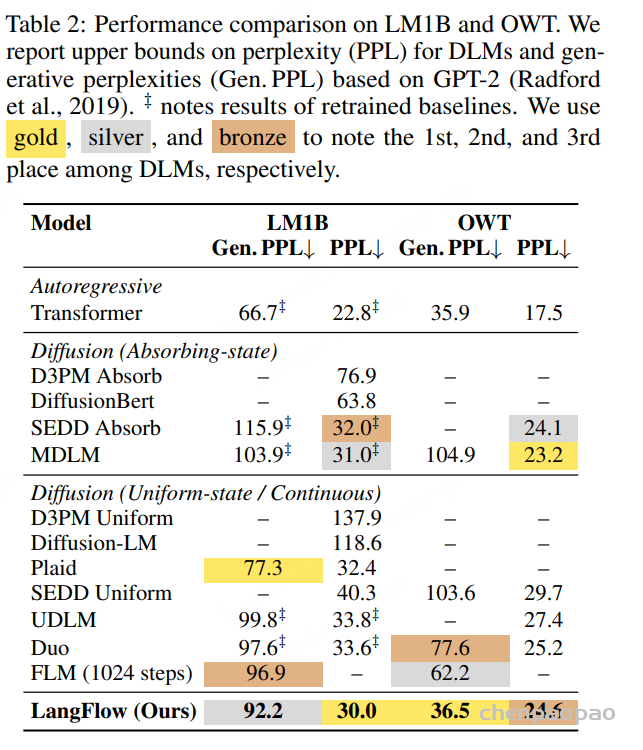
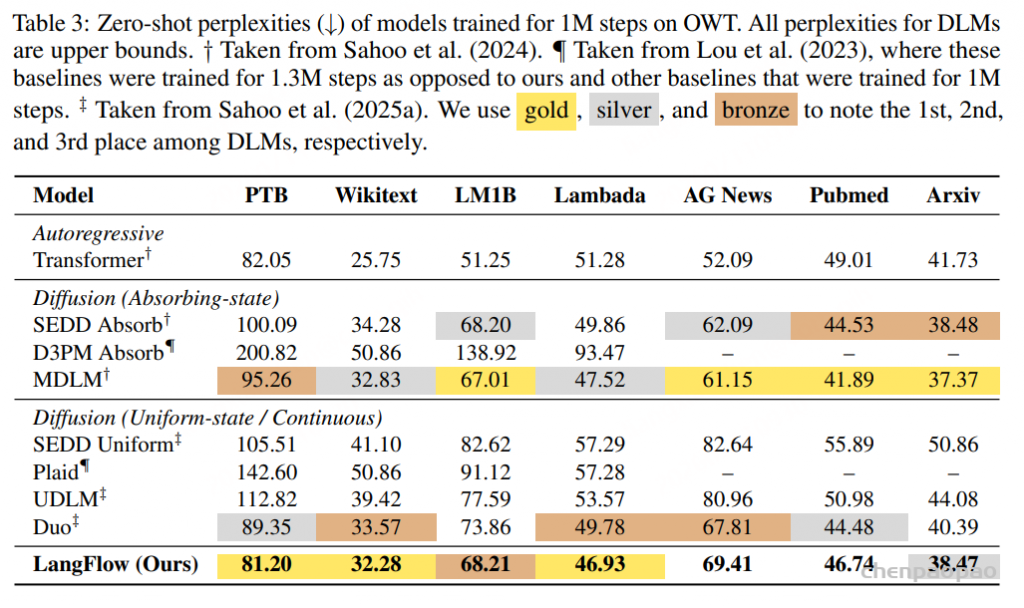
这篇论文的核心结论是:如果把 embedding-space diffusion 重新表述为 Flow Matching,并用 Bregman divergence 解释交叉熵训练目标,再配合 ODE-based NLL 上界、Gumbel 噪声调度和 self-conditioning,连续扩散语言模型可以在 LM1B 和 OpenWebText 上接近甚至追平主流离散扩散语言模型。LangFlow 在 LM1B 上达到 PPL 30.0,在 OpenWebText 上达到 PPL 24.6,并且在 7 个 zero-shot 迁移评测中有 4 个超过自回归 Transformer。

1. 背景:为什么语言里的连续扩散一直难做?

扩散模型天然适合连续空间,因此在图像和视频生成中非常成功。但语言是离散 token 序列,扩散语言模型通常有两条路线:一类是直接在离散状态上做扩散,例如 absorbing-state 或 uniform-state discrete diffusion;另一类是在 token embedding 空间中做连续扩散。后者理论上保留了连续扩散的优点,比如可编辑轨迹、ODE/SDE 采样、未来可做少步蒸馏,但过去在 PPL 和生成质量上没有真正追上离散扩散。

LangFlow 的切入点是 embedding-space diffusion。给定词表嵌入矩阵 \(E \in \mathbb{R}^{V \times d}\),一个 token 序列 \(y=(y_1,\ldots,y_L)\) 会先被映射成连续嵌入序列 \(x_1 = E[y]\)。模型不是在 one-hot simplex 上扩散,而是在连续 embedding 空间中从高斯噪声逐步移动到 clean embedding。

可以把 LangFlow 的生成过程抽象为一个 ODE:

\( \frac{d x_t}{d t}=v_\theta(x_t,t), \quad x_0 \sim \mathcal{N}(0,I), \quad x_1 \sim p_{\mathrm{data}} \)

其中 \(v_\theta\) 是模型学习到的 velocity field。训练和采样的关键,不是直接回归某个 embedding,而是让模型在噪声状态下预测 clean token 的概率分布。

2. LangFlow 的模型设计

LangFlow 的主干结构使用与强离散扩散基线相同的 modified DiT-style Transformer,并加入 RoPE 位置编码。正文实验配置为约 130M 参数、12 层、hidden size 768、12 个 attention heads。这样设计的好处是:实验对比时,LangFlow 与 SEDD、MDLM、Duo 等基线的网络容量基本对齐,性能提升更能归因于连续扩散框架和训练策略,而不是模型规模。

模型输入是 noisy embedding \(x_\gamma\),时间条件不直接使用普通时间 \(t\),而使用 log noise-to-signal ratio:

\( \gamma = \log \frac{\sigma^2}{\alpha^2} \)

在 variance-preserving 路径下,噪声状态可以写成:

\( x_\gamma = \alpha_\gamma x_1 + \sigma_\gamma \epsilon,\quad \alpha_\gamma = \frac{1}{\sqrt{1+e^\gamma}},\quad \sigma_\gamma = \sqrt{\frac{e^\gamma}{1+e^\gamma}} \)

当 \(\gamma\) 很大时,状态接近纯噪声;当 \(\gamma\) 很小时,状态接近 clean embedding。这样做的直觉是:语言 denoising 的难度主要由噪声强度控制,而不是由任意定义的时间变量控制。

LangFlow 还做了三个小但重要的工程修改:第一,将 self-conditioning 的输入并入主输入;第二,把 token embedding 归一化到单位球面后再缩放,使数据方差与噪声方差更匹配;第三,在 logits 上加入 tokenwise bias,改善训练初期的概率预测。这些修改没有显著改变参数量,但会影响训练稳定性。

3. 训练目标:用 Bregman divergence 解释交叉熵

过去一些连续扩散语言模型会直接用 MSE 回归 clean embedding,但论文指出这种做法可能导致 embedding collapse:不同 token 的 embedding 被错误地拉近,削弱语言表示的可分性。LangFlow 改为预测 clean token 的类别分布,并使用交叉熵训练。

作者的理论贡献是说明:交叉熵不是一个临时技巧,而可以看成 Bregman-divergence Flow Matching 在 categorical data 上的一个特殊形式。Bregman divergence 定义为:

\( D_F(q,p)=F(q)-F(p)-\langle \nabla F(p), q-p\rangle \)

当选择与负熵相关的凸函数时,token-level 交叉熵可以自然恢复出来。LangFlow 的训练目标可以简化写为:

\( \mathcal{L}_{\mathrm{CE}}(\theta) = \mathbb{E}_{\gamma,\,y,\,\epsilon} \left[-\log p_\theta(y \mid x_\gamma,\gamma)\right] \)

模型输出的是 \(p_\theta(\cdot \mid x_\gamma,\gamma)\),即 clean token 的概率分布。采样时,再把这个概率分布映射回连续 denoised embedding:

\( \hat{x}_1 = \sum_{i=1}^{V} p_\theta(i \mid x_\gamma,\gamma) E_i \)

这样就把两个世界连起来了:训练在 token space 中用交叉熵优化,采样在 embedding space 中沿 ODE 做连续移动。

4. ODE-based NLL:让连续扩散也能认真评估 PPL

语言模型的核心指标是 perplexity,但 embedding-space diffusion 过去主要依赖 SDE-based bound,和实际 ODE 采样并不完全一致。LangFlow 选择只用 deterministic ODE 采样,因为 ODE 保留从噪声到数据的确定性映射,也更适合未来做 flow-based distillation 和 few-step generation。

论文推导了一个 ODE-based NLL 上界。博客里可以把它理解为:沿着反向 ODE 轨迹积分概率密度变化,再加上末端 token 解码概率,从而得到可用于 PPL 评估的上界:

\( -\log p_\theta(y) \le \mathcal{L}_{\mathrm{ODE}}(y) \)

其中 \(\mathcal{L}_{\mathrm{ODE}}\) 包含 ODE trajectory 上的 divergence term。论文实验中,PPL 评估使用 128-step Heun-2 solver,并用 Hutchinson trace estimator 估计 divergence。这一点很关键,因为它让连续扩散语言模型不再只能报告生成样本的 Gen. PPL,而可以和离散扩散在 PPL 上更公平地比较。

5. Gumbel 噪声调度:语言不是图像

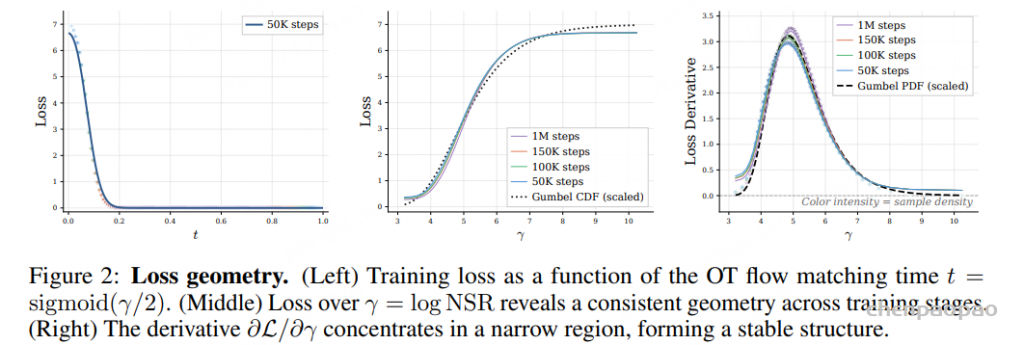
论文最有启发性的经验发现是:图像扩散里常用的均匀噪声调度,直接搬到语言上会浪费大量训练与采样步骤。作者观察到,在某些噪声区间,模型的 CE loss 几乎为 0,说明模型已经能轻松预测正确 token,这些区间继续分配大量 step 没有太多信息增益。

LangFlow 提出 information-uniform principle:噪声采样密度应该匹配每单位噪声水平带来的信息增益。直观写法是:

\( p(\gamma) \propto \left|\frac{d H(y \mid x_\gamma)}{d\gamma}\right| \)

这里 \(H(y \mid x_\gamma)\) 可以理解为在噪声状态 \(x_\gamma\) 下 clean token 的后验熵。作者发现这个信息增益曲线很适合用 Gumbel 分布拟合:

\( p(\gamma;\mu,\beta) = \frac{1}{\beta} \exp\left( -\frac{\gamma-\mu}{\beta} -\exp\left(-\frac{\gamma-\mu}{\beta}\right) \right) \)

实践中,LangFlow 让 Gumbel scheduler 的参数可学习。训练时从该分布采样 \(\gamma\),采样时按 Gumbel 分布分位点安排 ODE step。论文报告,这一设计能把 LangFlow 的 Gen. PPL 从 1000 级别显著降到 154.2,说明噪声调度不是细枝末节,而是连续扩散语言建模能否工作的关键。

6. Self-conditioning:连续扩散和离散扩散的效果不同

Self-conditioning 的做法是把上一步预测结果作为额外输入喂回模型。训练时随机开启,采样时始终开启。LangFlow 训练中 self-conditioning 概率为 0.25。

有意思的是,论文发现 self-conditioning 对离散扩散和连续扩散的作用不一样。在 LM1B 消融中,MDLM 加入 self-conditioning 后 Gen. PPL 从 103.9 降到 94.9,但 PPL 从 31.0 变差到 32.7;LangFlow 则从 Gen. PPL 154.2、PPL 49.0 改善到 Gen. PPL 81.5、PPL 30.0。也就是说,对 LangFlow 来说,self-conditioning 同时提升生成质量和似然上界,是把连续扩散追到离散扩散水平的关键组件。

7. 实验设置与关键结果

论文主要在 LM1B 和 OpenWebText(OWT)上评测。LM1B 使用 context length 128 和 bert-base-uncased tokenizer;OWT 使用 context length 1024 和 gpt2-large tokenizer。模型训练 1M steps,batch size 512。Gen. PPL 通过生成 1024 个样本并用 GPT2-Large 计算平均 perplexity 得到;PPL 则报告各扩散模型的上界。

LM1B:LangFlow 的 PPL 为 30.0,是表中扩散语言模型里最好的结果;Gen. PPL 为 92.2,低于 MDLM 的 103.9、SEDD Absorb 的 115.9、UDLM 的 99.8 和 Duo 的 97.6,仅略弱于 Plaid 的 77.3。相比早期连续方法 Diffusion-LM 的 PPL 118.6,LangFlow 的提升非常明显。

OpenWebText:LangFlow 的 Gen. PPL 为 36.5,是表中最优;PPL 为 24.6,接近 MDLM 的 23.2 和 SEDD Absorb 的 24.1,并优于 SEDD Uniform 的 29.7、UDLM 的 27.4 和 Duo 的 25.2。这说明 LangFlow 不只是小数据集上有效,在更接近真实网页语料的 OWT 上也有竞争力。

Zero-shot 迁移:用 OWT 训练后的模型在 PTB、Wikitext、LM1B、Lambada、AG News、PubMed、Arxiv 上评测。LangFlow 在 PTB 为 81.20、Wikitext 为 32.28、Lambada 为 46.93,均为扩散模型中的第一;Arxiv 为 38.47,仅略弱于 MDLM 的 37.37。论文总结为:LangFlow 在 7 个任务中有 4 个超过自回归 Transformer,并在 3 个任务中超过 MDLM。

采样步数:在 LM1B 上,LangFlow 的 NFE 从 128 降到 64、32、16 时,Gen. PPL 分别为 92.24、104.83、127.32、179.60,质量随步数减少而下降,但没有经过专门 few-step 蒸馏。OWT 上,在 1024 NFE 时 LangFlow Gen. PPL 为 36.53,明显优于 Duo 77.69、SEDD Uniform 99.90、MDLM 104.85 和 SEDD Absorb 105.03;即使 128 NFE,LangFlow 仍有 60.09。

8. 关键创新点总结

  • 把 embedding-space diffusion 接到 Flow Matching:LangFlow 用连续 ODE 视角重新组织语言扩散,而不是把连续扩散当作简单的 embedding 回归。
  • 交叉熵目标有理论解释:通过 Bregman divergence,作者说明 token-level CE 是 categorical Flow Matching 的合理目标,避免了 MSE 带来的 embedding collapse 风险。
  • ODE-based NLL 上界:让连续扩散语言模型可以用更贴近 ODE 采样的方式评估 PPL,这是论文的核心理论贡献之一。
  • information-uniform 噪声调度:根据后验熵变化分配噪声密度,并用可学习 Gumbel 分布实现,显著改善生成质量。
  • self-conditioning 训练协议修正:论文证明 continuous DLM 中 self-conditioning 不只是改善 Gen. PPL,也能大幅改善 PPL,这和离散扩散中的现象不同。
  • 公平对比离散扩散:模型规模、训练步数和主干结构尽量对齐,使 LangFlow 与 SEDD、MDLM、Duo 等方法的比较更有说服力。

9. 局限

LangFlow 证明连续扩散语言模型有机会追上离散扩散,但它还不是对自回归语言模型的全面替代。首先,AR Transformer 在 LM1B 和 OWT 的 PPL 仍更低,例如 LM1B 为 22.8、OWT 为 17.5。其次,LangFlow 的高质量采样仍需要较多 ODE steps,少步生成还依赖未来的 distillation。第三,OWT 生成样本的 entropy 偏低,作者也承认这可能反映全局词频偏置,仍需要更细的质量分析。

这篇论文最值得学习的地方,不是某一个指标刷新,而是它把连续扩散语言建模中几个原本分散的问题连成了闭环:如何训练、如何评估、如何调度噪声、如何采样、如何避免 embedding collapse。对于关注 diffusion LLM、非自回归生成、可编辑文本生成和少步生成的人来说,LangFlow 是一篇值得重点看的基础论文。

Dolphin-CN-Dialect汉语多方言语音识别模型

  • Github:https://github.com/DataoceanAI/Dolphin
  • ModelScope:https://modelscope.cn/organization/DataoceanAI
  • HuggingFace:https://huggingface.co/DataoceanAI
  • 技术报告: http://arxiv.org/abs/2605.08961

Dolphin-CN-Dialect 是由 Dataocean AI 与清华大学联合开发的多方言语音识别(ASR)模型,专注于中文方言识别及实际部署场景。相较于之前的 Dolphin 系列,Dolphin-CN-Dialect 在分词器设计、方言均衡训练、流式处理能力、热词偏置以及部署效率等方面均实现了显著改进。

该模型支持普通话及 22 种中文方言,同时保留了 Dolphin 系列原有的多语言 ASR 能力。Dolphin-CN-Dialect 同时支持流式与非流式推理,可在实时转录和工业级语音识别系统等对延迟敏感的应用中实现高效部署。

通用语音识别模型在普通话上表现越来越好,但面对四川话、吴语、闽南语、上海话、温州话等方言或强口音语音时,错误率仍然很高。Dolphin-CN-Dialect 的目标不是单纯堆大模型,而是在较小参数规模下,把中文多方言识别、流式推理、热词增强和部署效率做成一个实用系统。

论文的核心结论可以概括为:通过温度采样缓解方言数据长尾,通过中文字符级 tokenizer 改善 CTC-AED 对齐,通过流式/非流式统一推理与热词增强提升落地能力,Dolphin-CN-Dialect-0.4B 在多方言平均 CER 上达到 5.74%,在 sub-1B 模型组里明显优于 Paraformer、SenseVoice、Qwen3-0.6B 和 FunASR-Nano。

1. 背景:中文 ASR 的难点不只是普通话

近几年 ASR 的主流路线大致包括三类:自监督语音模型、LLM 集成式模型,以及 Whisper 风格的大规模监督或弱监督序列到序列模型。这些模型在公开普通话测试集上已经很强,但真实应用中的中文语音远比标准普通话复杂:说话人可能带有明显地区口音,甚至直接使用方言;语音长度、录音设备、噪声环境、说话风格也高度不一致。

报告指出,一个关键问题是训练数据的长尾分布。标准普通话数据通常占主导,低资源方言数据远少于普通话。如果按原始数据比例训练,模型会过度偏向普通话;如果简单平均采样每个方言,又会过度重复少量方言样本,带来过拟合。Dolphin-CN-Dialect 的数据采样策略就是围绕这个矛盾设计的。

2. 方法总览:不是换骨干,而是补齐中文方言工程链路

Dolphin-CN-Dialect 基本沿用 Dolphin 的核心 CTC-AED 架构与训练配置。真正的改动集中在几个工程层面:数据采样、tokenizer、训练稳定性、流式推理、热词增强和部署优化。这个取向很重要,因为报告关注的是“能不能在真实中文多方言场景中稳定工作”,而不是只在某一个标准 benchmark 上刷分。

作者列出的关键改进包括:用温度采样平衡普通话和低资源方言;将词表从 40,000 缩减到 18,173;中文采用字符级建模,英文和其他拼音文字采用 BPE subword;额外设计方言/地区 token;支持 streaming 和 non-streaming;提供 encoder-level contextual biasing 与 prompt-based hotword biasing 两种热词方案。

3. 数据采样:用温度系数处理长尾方言

论文先定义了两种极端采样策略。第一种是自然采样,即第 i 个数据集的采样概率与它的数据量成正比:

\( p_i=\frac{n_i}{\sum_j n_j} \)

这种方式保留了原始分布,但会导致普通话占比过高,低资源方言曝光不足。第二种是均匀采样,每个方言或数据集概率相同:

\( p_i=\frac{1}{N} \)

均匀采样能显著增加低资源方言的训练机会,但会反复采样极小数据集,容易过拟合,也可能损害普通话和整体泛化。Dolphin-CN-Dialect 采用第三种折中方式:温度采样。

\( p_i=\frac{n_i^{\alpha}}{\sum_j n_j^{\alpha}} \)

其中 n_i 是第 i 个数据集大小,α 位于 0 到 1 之间。α=1 时退化为自然采样,α=0 时变成均匀采样。取中间值可以提升低资源方言采样概率,同时保留高资源普通话数据的影响。报告称,这一策略带来了 38% 的方言识别准确率提升和 16.3% 的整体 CER 相对下降,普通话性能只出现约 0.2% 的边际退化。

4. Tokenizer:中文用字符级,方言用可扩展 token

Tokenizer 是这篇报告里容易被低估的一部分。Dolphin-CN-Dialect 将词表从 40,000 降到 18,173。对中文,报告采用字符级建模,因为中文字符天然适合 CTC-AED 的单调对齐;对英文和其他拼音文字,则继续采用 BPE subword,以平衡词表规模和表达能力。

此外,模型引入了结构化特殊 token,包括任务 token、结束 token、时间戳 token、方言/地区 token,并预留 80 个额外方言 token 槽位。这意味着后续如果要支持更细粒度的地区变体,不需要完全重做 tokenizer。这是一个明确面向可扩展部署的设计。

5. 热词增强:同时做 encoder-level 和 prompt-based biasing

实际 ASR 系统经常需要识别专有名词、人名、地名、产品名、术语等热词。报告将热词增强分为两条路线。第一条是 encoder-level contextual biasing,用上下文 embedding 在编码器侧引导模型;第二条是 prompt-based hotword biasing,把热词以提示形式交给解码器,使模型在生成时更偏向这些词。

这两种方式各有取舍。encoder-level 方法更稳定、可控,适合常规热词增强;prompt-based 方法更直接,尤其适合长尾或罕见热词,但也更依赖解码器对提示的利用能力。报告分别在 AISHELL 和 CommonVoice 构造热词测试集,并统计 WER、BWER、UWER 和 RER。

6. 实验结果:0.4B 模型在方言上很有竞争力

多方言 CER 是这篇报告最关键的结果之一。下表摘取平均 CER 与几个代表模型,数值越低越好。

模型参数量多方言平均 CER说明
Paraformer_zh220M22.76传统中文 ASR baseline
SenseVoice-S234M18.80小型开源 ASR 模型
Dolphin-CN-Dialect-0.1B0.1B10.46小参数版本
Dolphin-CN-Dialect-0.4B0.4B5.74sub-1B 组最佳
Qwen3-0.6B0.6B12.74更大但方言平均不如 Dolphin-CN-Dialect
FunASR-Nano-25120.8B12.73sub-1B 对比模型
FireRed-AED1.2B6.85billion-scale 组最佳之一
Qwen3-1.7B1.7B10.04大模型对比
FireRed-LLM8.3B7.17大参数 LLM-ASR 对比
多方言平均 CER 摘要。Dolphin-CN-Dialect-0.4B 在 sub-1B 组取得最低平均 CER,甚至优于部分 billion-scale 模型。

从分方言结果看,Dolphin-CN-Dialect-0.4B 在台湾普通话、四川话、吴语、闽南语、上海话、甘肃、山东、云南、河北、安徽、辽宁、福建、湖南、温州、湖北、河南、天津、陕西、宁夏等多数方言/地区测试上都取得 sub-1B 组最优。它不是只在少数方言上提升,而是整体降低了中文区域语音识别错误率。

7. 开放测试集:KeSpeech 和 Common Voice tw

报告还在 KeSpeech 和 Common Voice 的台湾中文子集上做了比较。Dolphin-CN-Dialect-0.4B 在两个测试集上分别达到 5.04 和 5.62 CER,在 sub-1B 组中最好。

模型参数量KeSpeech CERCV-tw CER
Dolphin-CN-Dialect-0.1B0.1B8.7978.964
SenseVoice-S234M17.8419.41
Paraformer_zh220M14.468.18
Dolphin-CN-Dialect-0.4B0.4B5.045.62
Qwen3-0.6B0.6B7.075.92
FunASR-Nano-25120.8B7.855.64
FireRed-AED1.2B3.971.61
Qwen3-1.7B1.7B5.733.92
FireRed-LLM8.3B3.584.20
KeSpeech 和 Common Voice tw 结果。Dolphin-CN-Dialect-0.4B 在 sub-1B 模型中表现最强。

8. 热词结果:降低 BWER,但可能牺牲少量 UWER

热词实验中,报告区分整体 WER、热词相关错误 BWER,以及非热词错误 UWER。一个典型现象是:加入热词后,BWER 会显著下降,但 UWER 可能略微上升。这说明热词 biasing 会把模型注意力推向热词,提升专名和关键词召回,但也可能带来少量非热词误识别。

数据集方法无热词 WER有热词 WERRER
AISHELLDolphin-CN-Dialect encoder-level attention1.201.099.20%
AISHELLDolphin-CN-Dialect encoder-level rescoring1.231.1010.6%
CommonVoiceDolphin-CN-Dialect encoder-level attention7.546.957.8%
CommonVoiceDolphin-CN-Dialect encoder-level rescoring7.637.037.9%
AISHELLDolphin-CN-Dialect prompt-based1.261.1111.9%
CommonVoiceDolphin-CN-Dialect prompt-based7.116.0814.5%
热词增强结果摘要。prompt-based 方法在 CommonVoice 长尾热词场景上相对收益更高。

9. 工程问题:流式模型的 CTC 删除错误

报告专门提到一个工程问题:流式模型在 WenetSpeech 上出现 CTC decoding degradation,表现为删除错误率偏高,也就是模型更容易漏掉 token。作者通过消融发现,根因与训练和测试语音长度分布不匹配有关:训练集中短语音不足,而测试集包含大量短音频。

解决办法不是改网络,而是改数据:增强短语音样本覆盖,使模型在训练时见到更多短时长输入。这一点很工程化,但很重要。ASR 系统的真实性能经常被数据分布问题限制,而不是被模型结构本身限制。

Dolphin-CN-Dialect 的贡献不在于提出一个全新的 ASR backbone,而在于把中文多方言 ASR 里容易被忽略的实际问题系统处理了一遍:长尾采样、中文字符级对齐、方言 token 扩展、流式推理、热词增强、短语音覆盖和部署优化。对中文 ASR 来说,这些问题往往比单纯扩大模型更关键。

从结果看,0.4B 版本是一个比较实用的平衡点。它在多方言平均 CER 上达到 5.74,在 KeSpeech 和 CV-tw 上也明显优于其他 sub-1B 模型。对需要中文普通话、方言、口音、热词和低延迟同时兼顾的应用,这类设计比一个单纯“更大”的模型更有部署价值。

11. 总结

Dolphin-CN-Dialect 是一个面向中文多方言真实场景的 ASR 技术报告,它用温度采样解决方言数据不均衡,用中文友好的 tokenizer 改善对齐和表达,用热词增强覆盖专名长尾,并在较小参数规模下取得了很有竞争力的多方言识别效果。

基于 OpenRLHF 的大模型强化训练

OpenRLHF代码细节

https://zhuanlan.zhihu.com/p/12871616401

训练入口

ppo_ray相关的训练入口在:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/cli/train_ppo_ray.py

在main中我们启动了driver进程,并执行训练函数train(args),这里主要做了如下几件事:

  • 在ray集群上部署Actor/Ref/Critic/RM实例
  • 在ray集群上部署vllm_engines实例
  • 配置Actor和vllm_engines之间的通讯,用于传递权重
  • 训练Actor和Critic模型

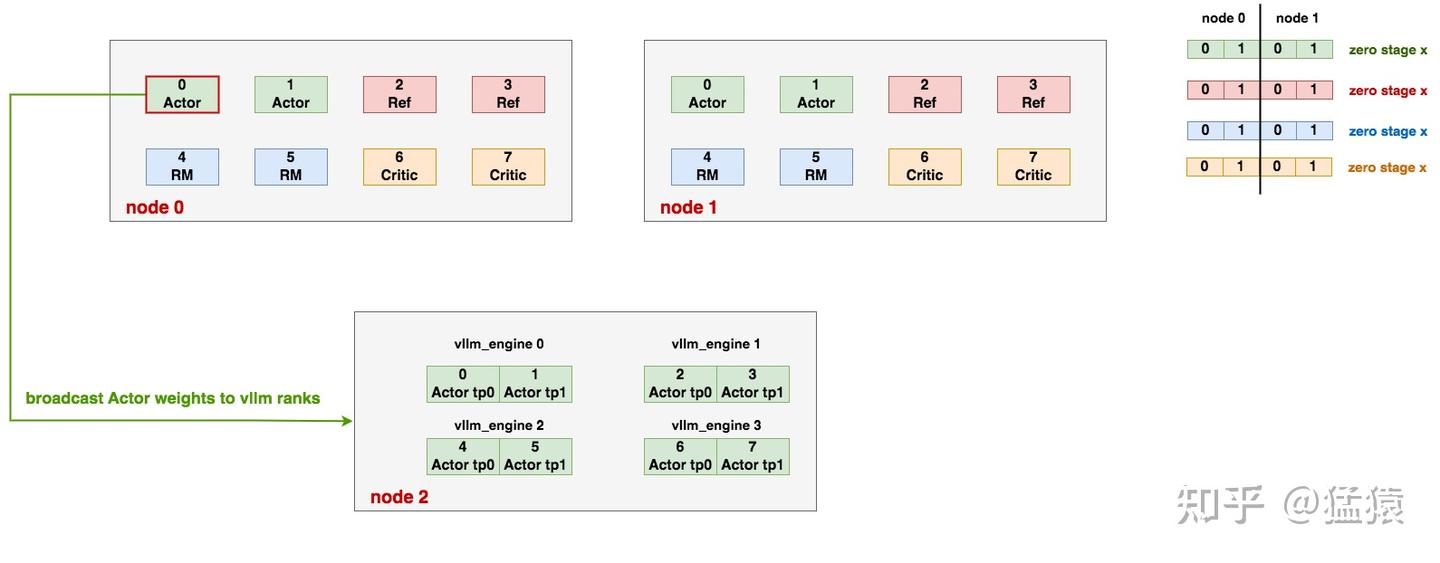
我们依次来解读这几个关键步骤。同时为了在表述上消除歧义,我们接下来谈到“Actor”时,会使用Ray-Actor和PPO-Actor来做区分,从之前的介绍中可知,Ray-Actor是指部署在Ray集群中的远端class,PPO-Actor/Ref/Critic/RM都属于Ray-Actor。

部署Actor/Ref/Critic/RM实例

(1)非共同部署

针对多个node的情况,我们以PPO-Actor为例,看代码是如何将其部署到Ray集群上的。

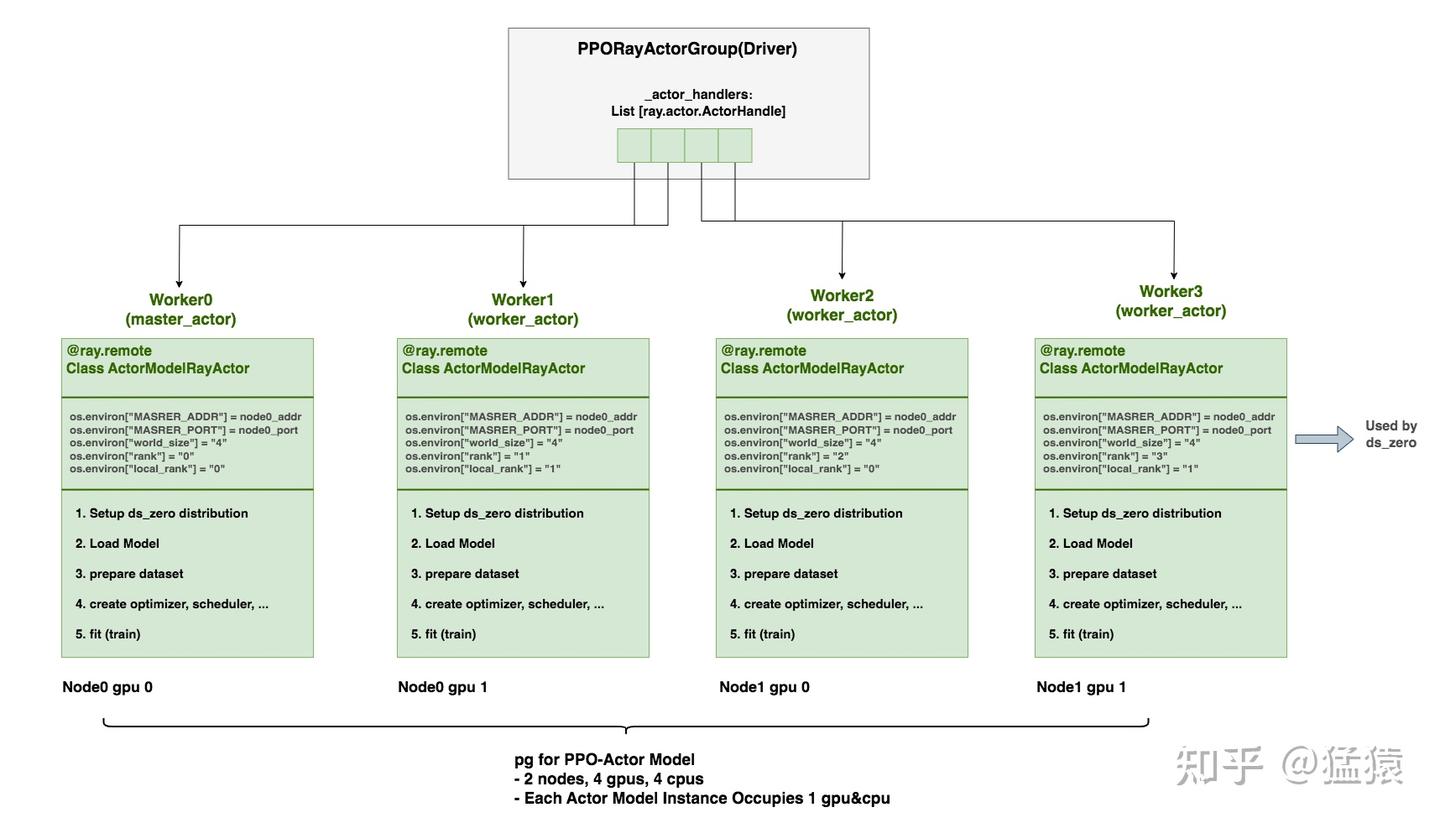
  • PPORayActorGroup创建在driver进程上,可将它理解成一种部署方案,专门负责部署PPO中的4类模型
    • PPORayActorGroup中维护着self._actor_handlers,它是一个List[ray.actor.ActorHandle],列表中每个元素表示某个远端Ray-Actor的引用,而这个远端Ray-Actor可以是PPO-Actor/Ref/Critic/RM实例。如前文所说,我们可以在ray集群中的任何位置调用这个handler,来对相应的远端Ray-Actor执行操作。
    • 在本例中,我们创建了4个Ray-Actor(1个master-actor,3个worker_actor)。每个Ray-Actor都运行在一个worker进程中。在创建Ray-Actor的同时,我们也会去修改worker进程的环境变量。后续当我们在这些worker进程中启动ds_zero相关的分布式配置时,ds会读取这些环境变量信息,这样我们就知道哪些Ray-Actor同时又构成ds中的数据并行组。
    • 使用PPORayActorGroup部署模型实例的代码如下:
model = PPORayActorGroup(
        # 为部署该模型的全部实例,我们想用多少台node,例如本例中为2
        args.actor_num_nodes,
        # 为部署该模型的全部实例,我们每台node上想用多少gpu,例如本例中为2
        args.actor_num_gpus_per_node,
        # Actor/Critic/Reward/ReferenceRayActor
        ActorModelRayActor, 
        # pg可理解为,在ray cluster中锁定/预留一片资源,然后只在这片资源上部署该模型全部实例。
        # (pg维护在Head Node的GCS上,参见3.3)
        # 例如本例中,pg锁定的资源为node0 gpu0/1, node1 gpu0/1,
        # 我们只在上面部署ActorModelRayActor全部实例
        pg=pg,
        # 当我们在pg指向的预留资源中分配模型实例时,再进一步指定每个实例占据一张gpu的多少部分
        # 等于1说明每个实例占满一张gpu,即“非共同部署”
        # 小于1说明每个实例只占部分gpu,即“共同部署”,例如PPO-Actor/Ref共同部署在一张卡上
        num_gpus_per_actor=0.75 if pg else 1,
    )

ActorModelRayActor创建在远端worker进程上,是Ray-Actor。它包含了设置ds_zero分布式环境、加载模型权重、数据集准备、optimizer/scheduler准备、训练等一系列操作。

共同部署

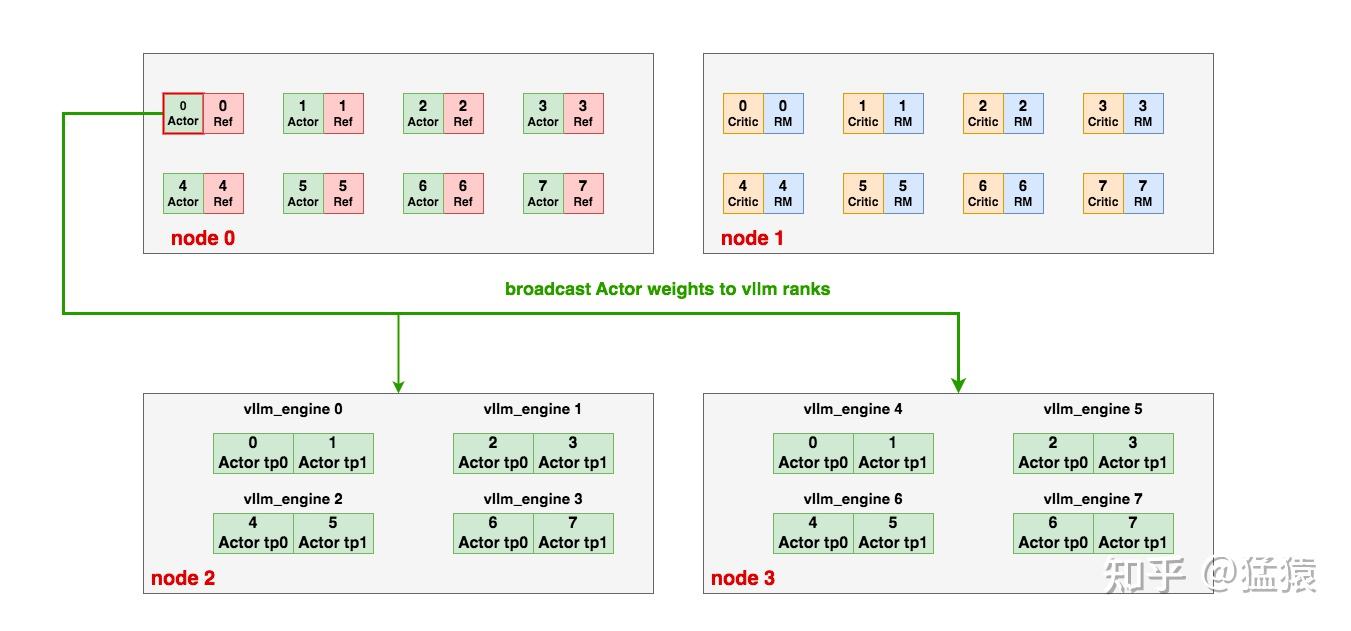
针对下图的情况,我们以PPO-Actor为例,看代码是如何将其部署到Ray集群上的

  • PPORayActorGroup:在driver进程上创建2个PPORayActorGroup,分别管理PPO-Actor,PPO-Ref的部署
  • 使用actor_model = PPORayActorGroup(..., pg = pg, num_gpus_per_actor=0.75)创建PPO-Actor部署方案实例;使用ref_model = PPORayActorGroup(..., pg = pg, num_gpus_per_actor=0.25)创建PPO-Ref部署方案实例
  • 这里,两个方案实例使用的pg都是同一个,即这个pg都指向“1台node,每台node 8张卡”这片预留好的资源。
  • num_gpus_per_actor = 0.75/0.25是一种创建trick,虽然我们的最终目的是为了让PPO-Actor和PPO-Ref对半分一张卡(对半=共享,不是指显存上对半分),但是:
    • 假设设置为0.5,当我们实际部署ActorModelRayActor时,Ray先在单卡上部署1个ActorModelRayActor实例,当它准备部署第二个ActorModelRayActor实例时,它发现由于每个实例只占0.5块卡,因此完全可以把第2个实例接着第1个实例在同一张卡上部署,这样就导致最终无法让PPO-Actor和PPO-Ref共享一张卡
    • 假设设置0.75,当我们在单卡上部署完1个ActorModelRayActor实例后,ray发现单卡剩下的空间不足以部署第2个ActorModelRayActor实例,所以就会把第二个实例部署到别的卡上,这样最终实现PPO-Actor和PPO-Ref共享一张卡
    • 所以,这个设置是为了达到不同类型模型的实例共享一张卡的目的,而并非真正指模型实际占据的单卡显存空间。
  • 最后,在这一步中,我们对全部ActorModelRayActor共创建8个worker进程,对全部RefenreceModelRayActor共创建8个worker进程,一共创建16个工作进程。

相关代码依然在:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/launcher.py#L143

部署vllm_engines实例

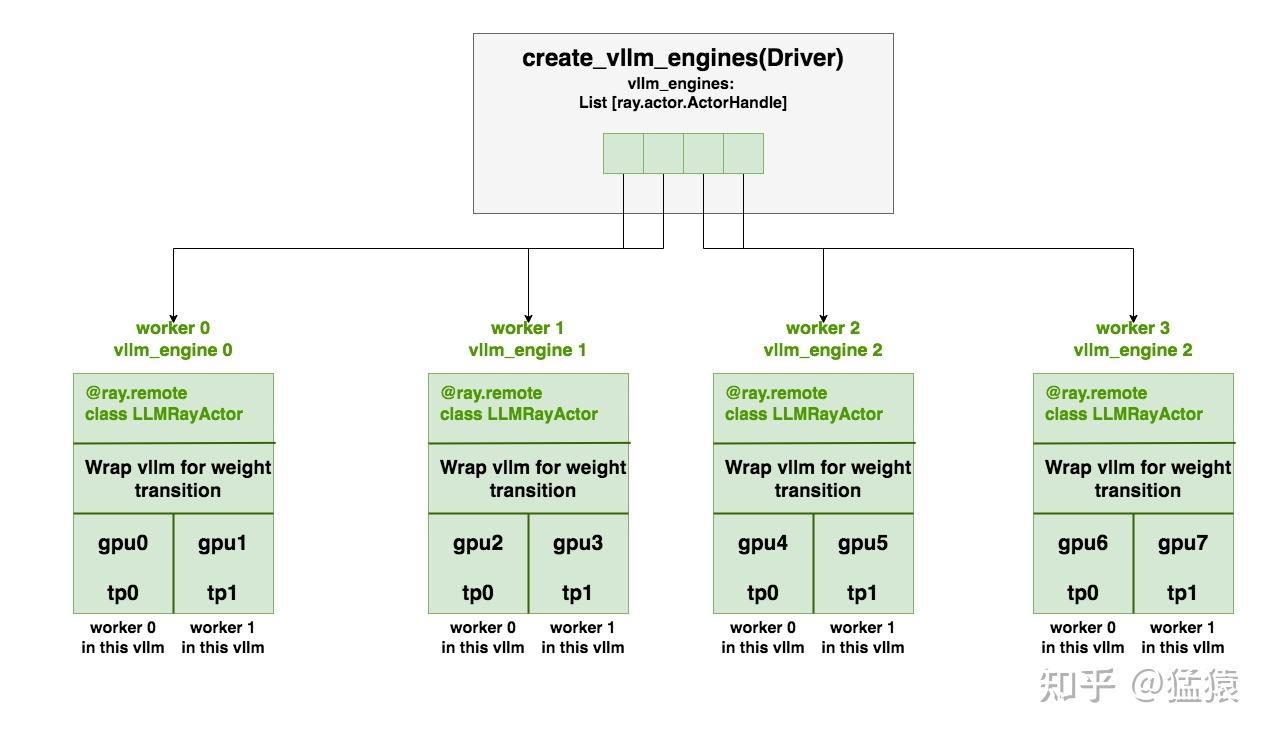
  • create_vllm_engines:在driver端,我们通过运行该函数来创建vllm_engines,过程相似于4.2节中的介绍,信息都在图中,这里不赘述。
  • LLMRayActor:worker端Ray-Actor,它主要是把vllm实例进行了一些包装,包装的目的是为了让ds_rank0和all vllm ranks间可以进行PPO-Actor的权重通讯(参见2.1(3))
  • 在上面的例子中,我们会创建4个worker进程(不占gpu资源,只占cpu资源),用于运行管理4个vllm_engine。在每个worker进程内,vllm实例还会创建属于自己的worker进程做分布式运行(这些worker进程会实际占据gpu资源)。

相关代码参见:
https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/vllm_engine.py


https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/vllm_worker_wrap.py

ds_rank0与vllm_ranks之间的通讯

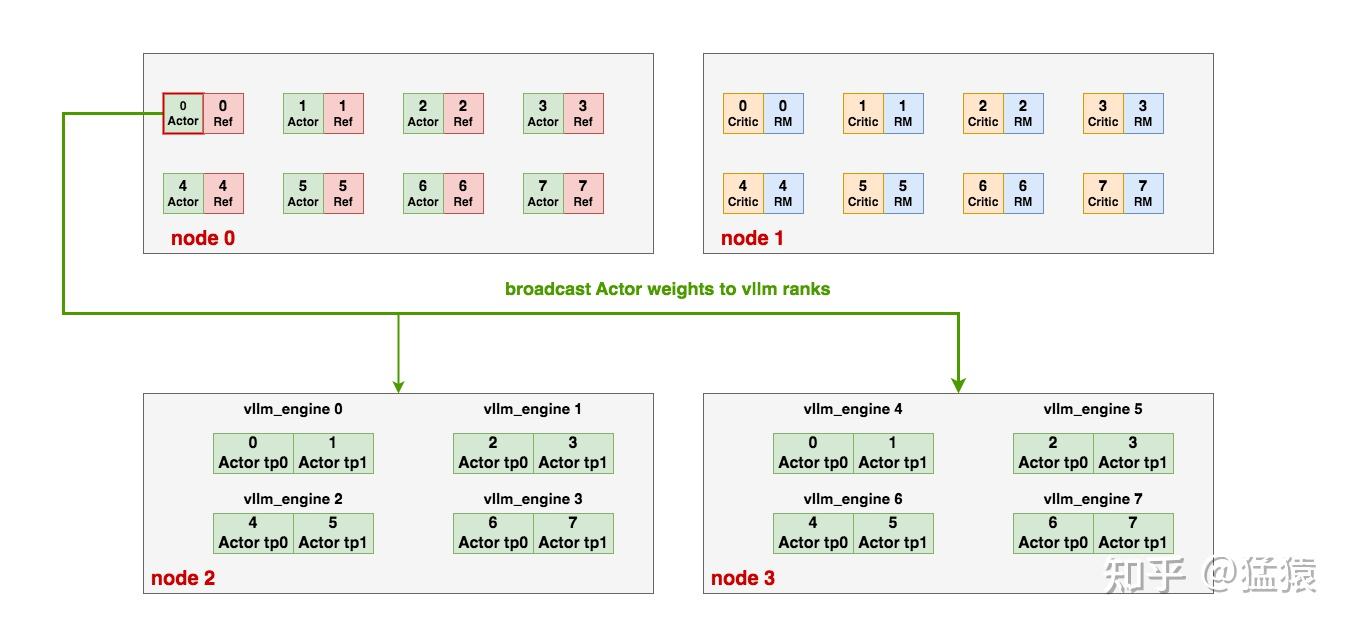
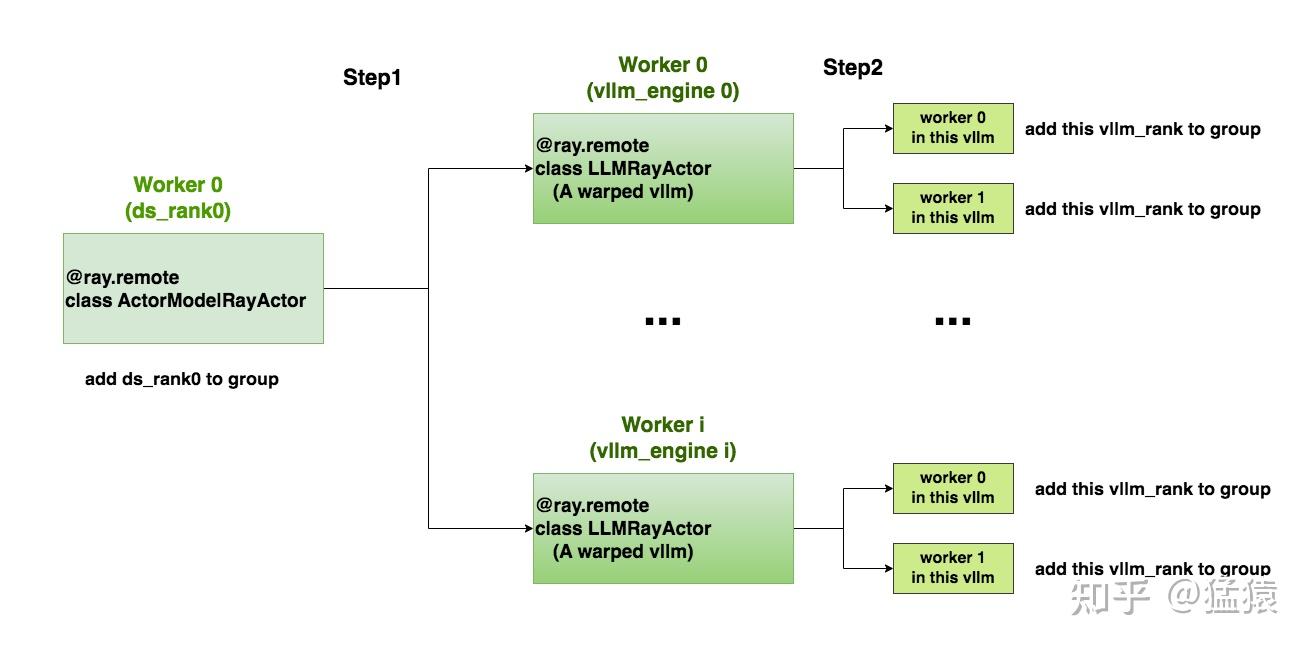
PPO-Actor的ds_rank0需要和all_vllm_ranks进行通讯,传递最新的PPO-Actor权重,例如以下ds_rank0要把完整的权重broadcast给16个vllm_ranks:

我们分成如下几步实现这个目标:

(1)创建通信组

Step1:

代码来自:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/ppo_actor.py#L58
这段代码执行在PPO-Actor0(ds_rank0)所在的worker进程中。这个worker进程将通过handler引用,触发远端每个vllm_engine上的init_process_group操作,并将ds_rank0纳入通讯组

 # Create torch group with deepspeed rank 0 and all vllm ranks
        # to update vllm engine's weights after each training stage.
        #
        # Say we have 3 vllm engines and eache of them has 4 GPUs,
        # then the torch group is:
        # [    0,      1, 2, 3, 4,  5, 6, 7, 8,  9, 10, 11, 12]
        # |ds rank 0 |  engine-0  |  engine-1  |   engine-2   |
        #
        # For ZeRO-1/2:
        #   1. Broadcast parameters from rank 0 to all vllm engines
        # For ZeRO-3:
        #   1. AllGather paramters to rank 0
        #   2. Broadcast parameters from rank 0 to all vllm engines
        if self.vllm_engines is not None and torch.distributed.get_rank() == 0:
            ...
            # world_size = num_of_all_vllm_ranks + 1 ds_rank0
            world_size = vllm_num_engines * vllm_tensor_parallel_size + 1
            ...
            # =====================================================================
            # 遍历每个vllm_engines,将其下的每个vllm_rank添加进通讯组中,这里又分成两步:
            # 1. engine.init_process_group.remote(...):
            #    首先,触发远程vllm_engine的init_process_group方法
            # 2. 远程vllm_engine是一个包装过的vllm实例,它的init_process_group
            #    方法将进一步触发这个vllm实例下的各个worker进程(见4.4图例),
            #    最终是在这些worker进程上执行“将每个vllm_rank"添加进ds_rank0通讯组的工作
            # =====================================================================
            refs = [
                engine.init_process_group.remote(
                    # ds_rank0所在node addr
                    master_address, 
                    # ds_rank0所在node port
                    master_port,
                    # 该vllm_engine的第一个rank在"ds_rank0 + all_vllm_ranks“中的global_rank,
                    # 该值将作为一个offset,以该值为起点,可以推算出该vllm_engine中其余vllm_rank的global_rank
                    i * vllm_tensor_parallel_size + 1, 
                    world_size,
                    "openrlhf",
                    backend=backend,
                )
                for i, engine in enumerate(self.vllm_engines)
            ]
            # =====================================================================
            # 将ds_rank0添加进通讯组中
            # =====================================================================
            self._model_update_group = init_process_group(
                backend=backend,
                init_method=f"tcp://{master_address}:{master_port}",
                world_size=world_size,
                rank=0,
                group_name="openrlhf",
            )
            # =====================================================================
            # 确保all_vllm_ranks都已添加进通讯组中
            # =====================================================================
            ray.get(refs)

Step2:

代码来自:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/vllm_worker_wrap.py#L11
这段代码实际运行在每个vllm_engine(即每个包装后的vllm实例)下的worker进程内。例如tp_size=2,那么每个vllm实例下就有2个worker进程,这两个worker进程都会运行这段代码

class WorkerWrap(Worker):
    def init_process_group(self, master_address, master_port, rank_offset, world_size, group_name, backend="nccl"):
        """Init torch process group for model weights update"""
        assert torch.distributed.is_initialized(), f"default torch process group must be initialized"
        assert group_name != "", f"group name must not be empty"
        # =====================================================================
        # torch.distributed.get_rank(): 在当前vllm_engine内部的rank,
        #                               例如在tp_size = 2时,这个值要么是0,要么是1
        # rank_offset:当前vllm_engine中的第一个rank在“ds_rank0 + all_vllm_ranks"中的global_rank
        # 两者相加:最终得到当前rank在“ds_rank0 + all_vllm_ranks"中的global_rank
        # =====================================================================
        rank = torch.distributed.get_rank() + rank_offset
        self._model_update_group = init_process_group(
            backend=backend,
            init_method=f"tcp://{master_address}:{master_port}",
            world_size=world_size,
            rank=rank,
            group_name=group_name,
        )
        ...

(2)_broadcast_to_vllm

构建好通讯组,我们就可以从ds_rank0广播PPO-Actor权重到all_vllm_ranks上了,这里也分成两步。

Step1:PPO-Actor ds_rank0发送权重

代码在:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/ppo_actor.py#L146
这段代码运行在ds_rank0对应的worker进程中

    def _broadcast_to_vllm(self):
        # avoid OOM
        torch.cuda.empty_cache()
        model = self.actor.model.module
        count, num_params = 0, len(list(model.named_parameters()))
        for name, param in model.named_parameters():
            count += 1  # empty_cache at last param

            # Fire all vllm engines for broadcast
            if torch.distributed.get_rank() == 0:
                shape = param.shape if self.strategy.args.zero_stage != 3 else param.ds_shape
                refs = [
                    # 远端vllm_engine的每个rank上,初始化一个尺寸为shape的empty weight张量,
                    # 用于接收广播而来的权重
                    engine.update_weight.remote(name, dtype=param.dtype, shape=shape, empty_cache=count == num_params)
                    for engine in self.vllm_engines
                ]

            # For ZeRO-3, allgather sharded parameter and broadcast to all vllm engines by rank 0
            # ds_rank0发出权重(视是否使用zero3决定在发出前是否要做all-gather)
            with deepspeed.zero.GatheredParameters([param], enabled=self.strategy.args.zero_stage == 3):
                if torch.distributed.get_rank() == 0:
                    torch.distributed.broadcast(param.data, 0, group=self._model_update_group)
                    ray.get(refs) # 确保所有vllm_ranks接收权重完毕

Step2: 各个vllm_ranks接收权重

代码在:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/vllm_worker_wrap.py#L29
代码运行在每个vllm_engine(即每个包装后的vllm实例)下的各个worker进程中。例如tp_size = 2,那么每个vllm实例下有2个worker进程,这2个worker进程都会运行这段代码。

 def update_weight(self, name, dtype, shape, empty_cache=False):
        """Broadcast weight to all vllm workers from source rank 0 (actor model)"""
        if torch.distributed.get_rank() == 0:
            print(f"update weight: {name}, dtype: {dtype}, shape: {shape}")

        assert dtype == self.model_config.dtype, f"mismatch dtype: src {dtype}, dst {self.model_config.dtype}"
        # 创建同尺寸空张量用于接收ds_rank0广播来的权重
        weight = torch.empty(shape, dtype=dtype, device="cuda")
        # 接收权重
        torch.distributed.broadcast(weight, 0, group=self._model_update_group)
        # 使用接收到的权重进行更新
        self.model_runner.model.load_weights(weights=[(name, weight)])

        del weight

 PPO-Actor/Critic Training

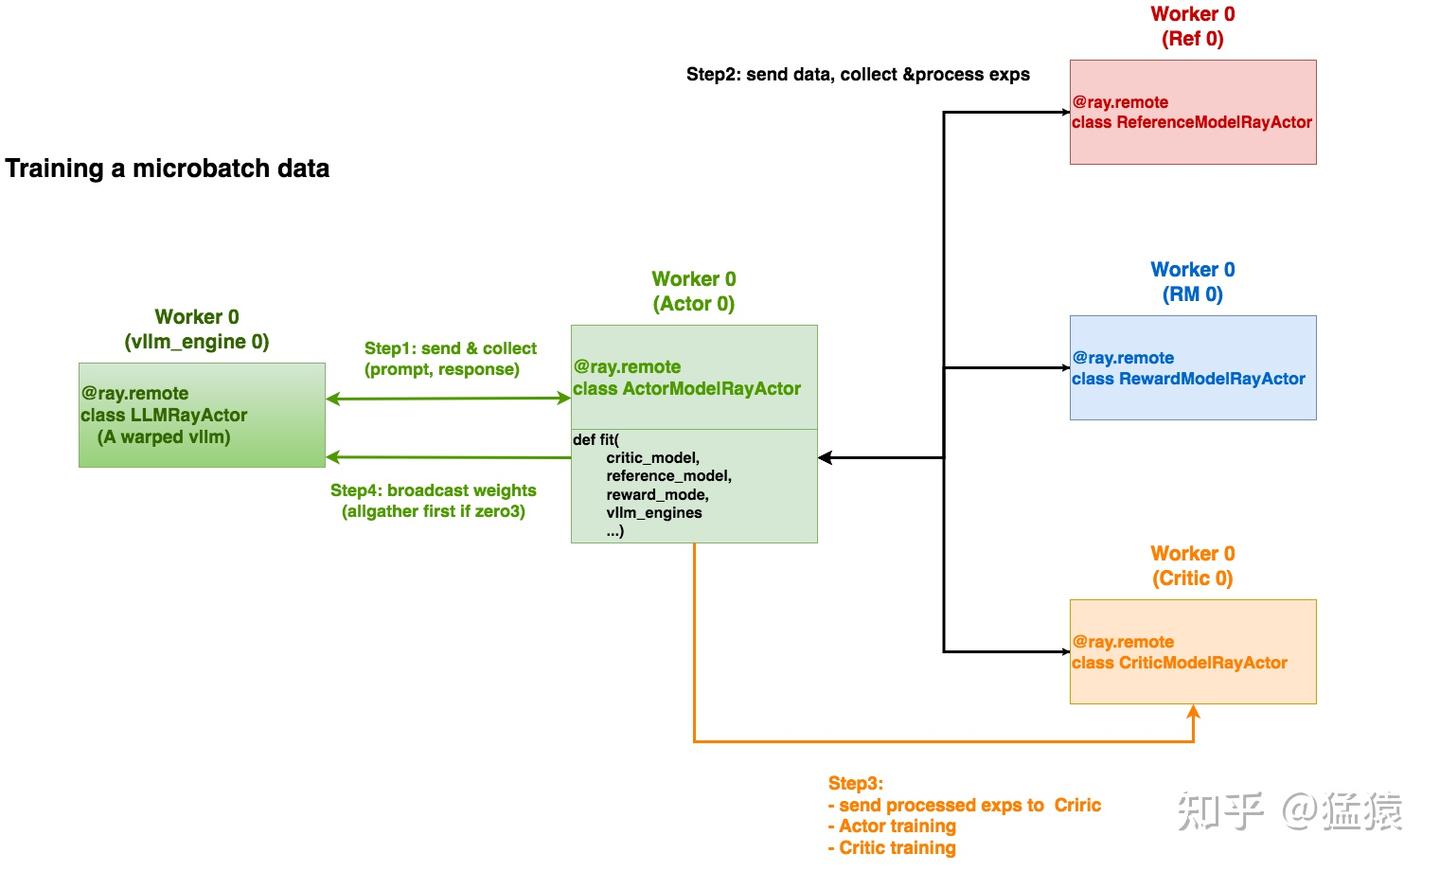
正如2.1(4)中所说,我们将部署在ray集群上的PPO-Actor/Ref/Critic/RM实例们进行分组,每组分别负责一份micro-batch的训练,上图刻画了某个组内的训练流程。一组内的训练流程发起自PPO-Actor实例(fit方法),注意不同颜色的worker0表示的是不同工作进程。共分成如下步骤执行。


Step1:发送prompts,并从vllm_engine上收集(prompt, response)。

代码参见:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ppo_utils/experience_maker.py#L627


Step2:从Ref/Reward/Critic上收集并处理exps

代码参见:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ppo_utils/experience_maker.py#L492


Step3: 确保将处理后的exps传送给Critic,并行执行Actor和Critic的训练

将exps传送给Critic:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ppo_utils/experience_maker.py#L470
Actor训练:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/ppo_actor.py#L125
Critic训练:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/ppo_actor.py#L122
我们在Actor实例所在的worker进程上出发Actor和Critic的训练。以上代码只给出了训练入口,更多细节需要顺着入口去阅读。


Step4:vllm_engine权重更新。

代码参见:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ray/ppo_actor.py#L130

RLHF-PPO算法细节

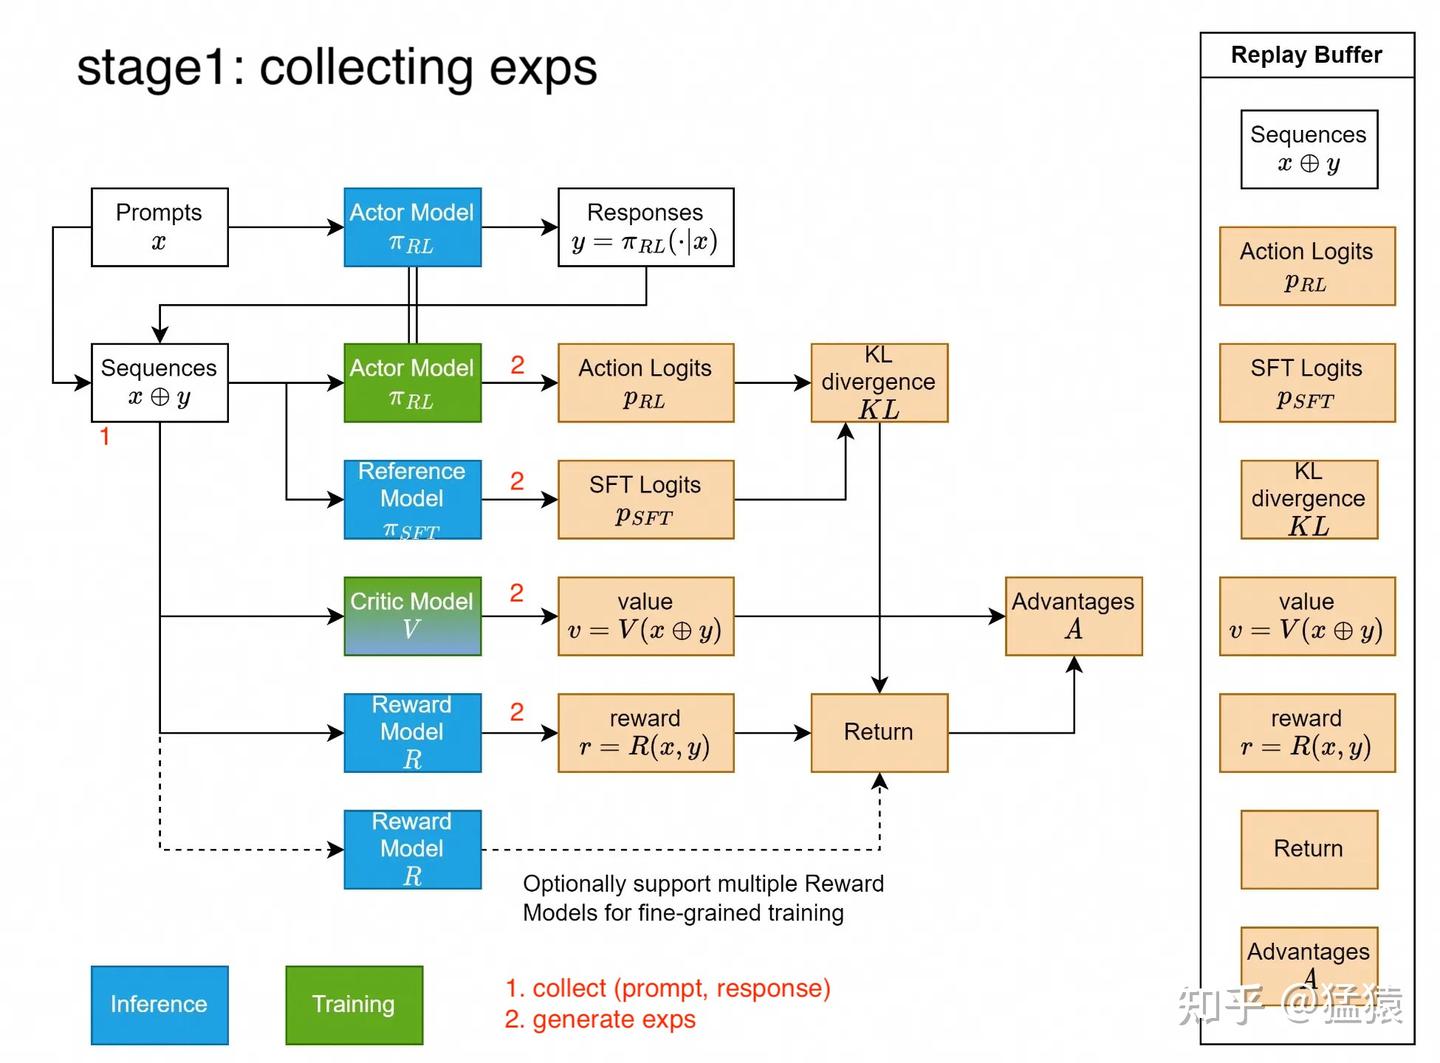
整个RLHF-PPO训练过程大致分成2步:

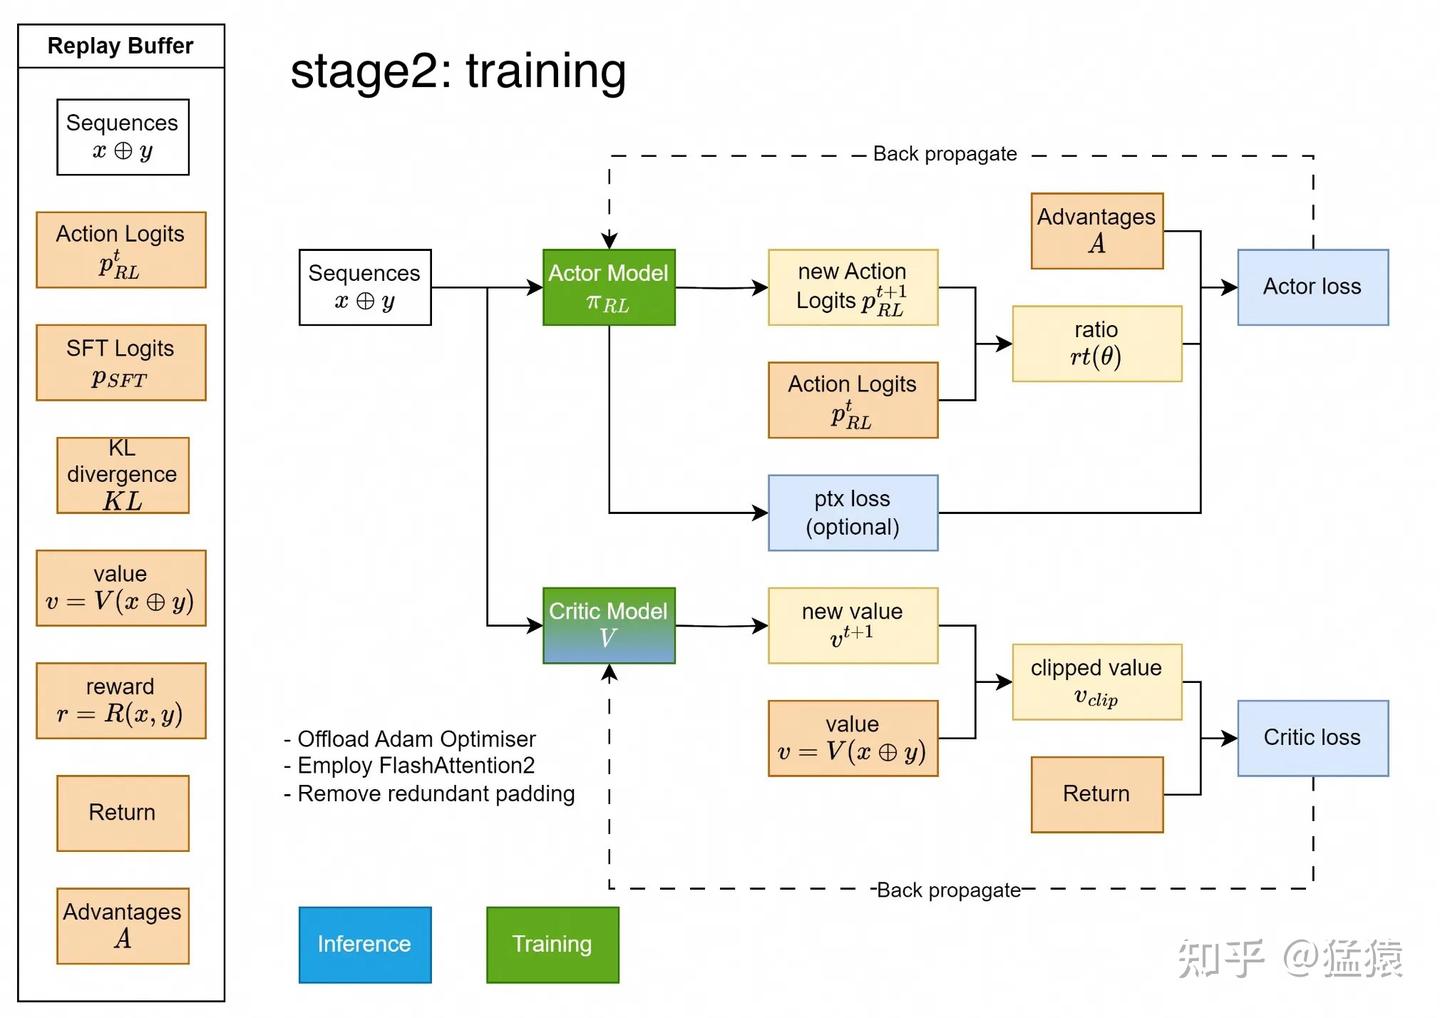
  • Stage1:收集exps
  • Stage2:使用收集到的exps计算actor_loss和critic_loss,用于训练actor和critic

在OpenRLHF中的核心代码为:https://github.com/OpenRLHF/OpenRLHF/blob/bb46342711a203c457df2fbca5967fd0549557e0/openrlhf/trainer/ppo_trainer.py#L19

下面我们分别解读这2个stage的过程

 Stage2:Training

ASR大模型GRPO训练

从一个 SFT(监督微调)得到的 Qwen3-ASR语音识别模型 出发,用 Ray + DeepSpeed + vLLM 缺省(此处未启用 vLLM,由 actor 自身 generate 的方式做 PPO/GRPO 强化学习: 对每条音频采样多个转写结果 → 用一个 远程 Python 奖励函数(CER、关键词、语言一致性、平滑度等多维打分)给每个结果打分 → 用 group_norm(GRPO 组内归一化) 计算优势 → 用 PPO 策略损失 更新 actor(冻结音频 encoder,只训 LLM/adapter 部分)→ 周期性保存 HuggingFace 权重。

整体调用链:

run_train_v2_from_sft.sh                    # 启动脚本:起 Ray 集群 + 提交 job
  └─ openrlhf.cli.train_ppo_ray             # 入口:解析参数、建 Ray actor 组、驱动训练
       └─ ActorModelRayActor (ray/ppo_actor.py)   # actor 进程:建模型、数据、优化器
            └─ ActorPPOTrainer.fit → PPOTrainer.fit  # PPO 主循环
                 ├─ RemoteExperienceMaker            # 采样 rollout + 打分 + 算优势
                 │    ├─ actor.generate               # 生成转写(rollout)
                 │    ├─ reward_func (远程 py)         # 多维奖励打分
                 │    └─ group_norm 优势               # GRPO 组内归一化
                 └─ PPOTrainer.ppo_train              # 用 PolicyLossV3 更新 actor

ASR语音识别-MOE架构论文

MOE- Conformer :

MoE Adapter: https://arxiv.org/pdf/2601.02967

论文:Mixture-of-Expert Conformer for Streaming Multilingual ASR

这篇论文 Mixture-of-Expert Conformer for Streaming Multilingual ASR 讨论的是一个更偏工业部署的问题:如何让一个流式端到端 ASR 模型同时支持多种语言,又不把推理成本推到端侧设备难以承受的程度。作者选择的路线是把 Mixture-of-Experts 放进 Conformer,把模型总容量做大,但每次推理只激活一小部分参数。

摘要:容量变大,激活参数不线性变大

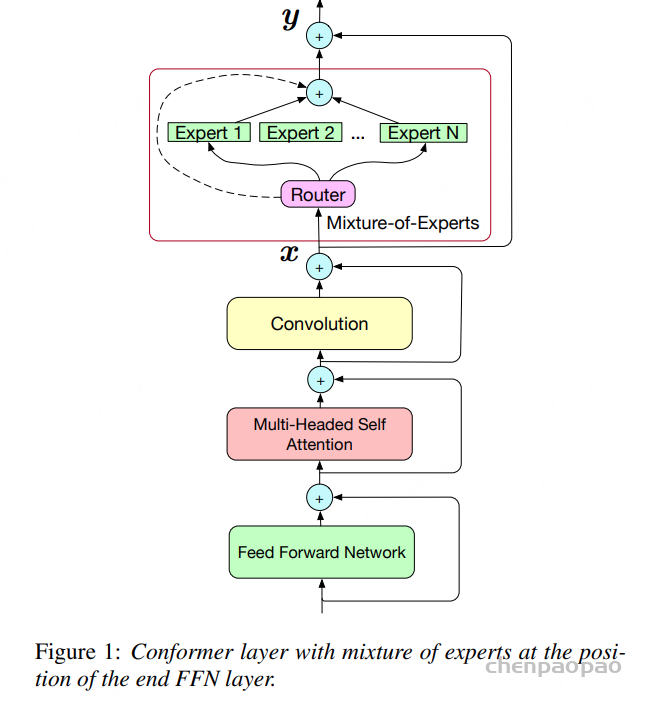
论文提出的模型是在流式多语种 Conformer 中加入 MoE 层。MoE 层由多个 FFN 专家和一个 softmax gate 组成,每个输入帧只选择权重最高的两个专家参与计算。这样,专家总数可以增加,模型总容量也可以增加,但推理时激活的专家数固定,因此计算和激活参数不会随专家数量线性增长。

论文中的 gate 先对第 l 层输入 x 做线性映射,再通过 softmax 得到专家权重:

\( g_l=\mathrm{Softmax}(W_l\cdot x) \)

随后只取 top-2 expert,并把两个 expert 的输出按 gate 权重加权求和:

\( y=\sum_{i=1}^{2}g_{l,i}\cdot e_{l,i} \)

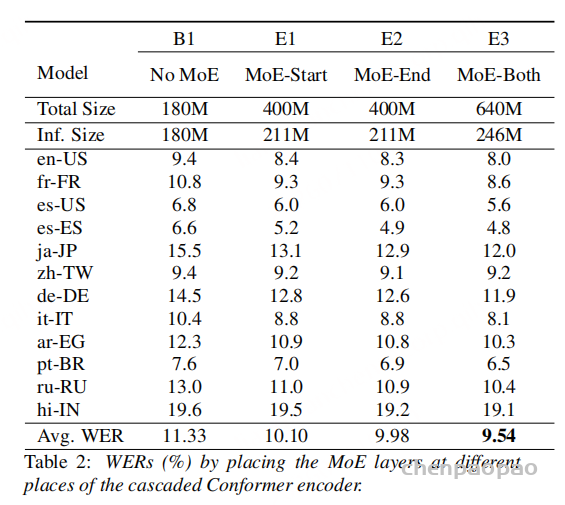
实验覆盖 12 个语言 locale。相对于 180M 参数的多语种 cascaded Conformer baseline,MoE-End 模型把平均 WER 从 11.33 降到 9.98,约 11.9% 相对改善。与同等总规模的 dense baseline 相比,MoE 达到类似 WER,但推理激活参数约为 211M,对比 dense 的 400M 更省。再结合多语种 neural LM 做 shallow fusion,平均 WER 还能进一步相对降低约 3%。

引言:多语种统一模型的容量问题

多语种端到端 ASR 的吸引力很直接:用一个模型识别多种语言,降低维护和部署复杂度。过去几年,CTC、LSTM、attention-based 模型以及流式 RNN-T 都在多语种 ASR 上取得了进展。尤其是端侧流式场景,模型既要有识别质量,又要满足低延迟和低计算。

经验上,模型容量越大,多语种 ASR 越容易受益。Whisper、USM 等大型模型也说明了大数据和大模型对语音识别质量的推动作用。但大模型的代价是训练和推理成本。对端侧应用来说,不能简单把模型扩大到数十亿参数。

已有一些效率方案依赖语言相关组件,比如按语言选择 adapter 或二阶段模型。但流式场景里,稳定预测语言信息本身就不容易,还可能引入错误传播。本文的 MoE 路线更直接:由输入表示动态选择专家,不需要显式语言标签,也不需要 ground-truth language information。

相关工作:专家模型与语言信息

论文把自己的方法放在几类工作之间比较。第一类是 ASR 中已有的 MoE 模型,但许多工作偏单语种,或者需要额外的共享 embedding 网络来做专家路由。第二类是 NLP 和视觉中的 MoE,比如 Switch Transformer 或 DeepMoE,不过这些结构在 ASR 尤其是流式多语种 ASR 中的直接效果并不确定。

第三类是 informed-expert:模型根据已知语言信息选择某个语言专家、adapter 或二阶段模块。这种做法在有可靠语言标签时很自然,但部署中会遇到两个麻烦:语言信息要么来自外部,要么需要模型先预测;一旦预测错了,后面的专家选择也会受影响。本文的 MoE 不显式使用语言信息,routing 由模型从声学表示中学出来。

MoE Conformer:把专家放在 FFN 位置

基础模块是 Conformer。一个 Conformer layer 通常包含两个 FFN、中间的 self-attention 和 convolution。作者把 MoE 主要用于替换 Conformer 里的 FFN,尤其是 end FFN。每个 MoE 层包含多个 FFN 专家和一个 router。

对每一帧表示,router 通过 softmax 计算各专家权重,然后选出 top-2 专家。两个专家的输出按路由权重加权求和,得到该 MoE 层输出。训练和推理都使用 top-2。为了防止专家使用不均衡,论文加入辅助负载均衡损失,让不同专家都有机会被训练到。

这个设计的关键是稀疏激活。比如总共有 8 个、16 个或 24 个专家时,每帧仍只走两个专家。总参数代表模型潜在容量,激活参数代表推理成本;MoE 的优势就在于让这两者不再完全绑定。

实验设置

模型训练使用 RNN-T loss,并额外加入专家负载均衡项。论文中的 auxiliary loss 写成:

\( l_{\mathrm{aux}}=\frac{1}{N}\sum_{i=1}^{N}c_i\cdot m_i \)

其中 m_i 是第 i 个 expert 的平均 gate,c_i 是 top-2 路由中该 expert 被选择的计数。

数据

实验使用 12 个语言 locale:美式英语、中文、法语、德语、日语、美式西班牙语、西班牙西班牙语、阿拉伯语、意大利语、印地语、葡萄牙语和俄语。训练数据来自 Voice Search、YouTube 等多个域,总计约 139.4M 条人工转写匿名语音。不同语言数据量差异很大,从 0.5M 到 25.2M utterances 不等。

测试集来自 Voice Search 流量,每个语言大约 1.4K 到 10K 条 utterances,与训练集不重叠。评价指标是 WER;对中文等语言,论文按字符计算错误率。

模型细节

baseline 是一个语言无关的多语种 transducer 模型,包含 7 层 causal Conformer encoder 和 10 层 non-causal cascaded encoder。causal 部分保证流式,non-causal cascaded 部分提供约 0.9 秒右上下文。模型使用 separate decoders 分别服务 causal 和 non-causal encoder,以获得更好质量。baseline 总参数约 180M。

MoE 改造主要发生在 cascaded encoder。作者尝试替换 start FFN、end FFN 或两者都替换。最多使用 24 个专家,但每次训练和推理只选 top-2。输入特征为 128 维 log-Mel filterbank,经连续帧堆叠形成 512 维输入,并下采样到 30ms 帧率;训练中使用 SpecAug 增强鲁棒性。

结果与比较

消融实验

首先看 MoE 放在哪里。baseline 平均 WER 为 11.33。把 MoE 放在 start FFN,平均 WER 为 10.10;放在 end FFN,平均 WER 为 9.98;两处都放,平均 WER 最好,为 9.54。不过两处都放会增加推理激活参数。作者最终更多采用 MoE-End,因为它在质量和效率之间更均衡。

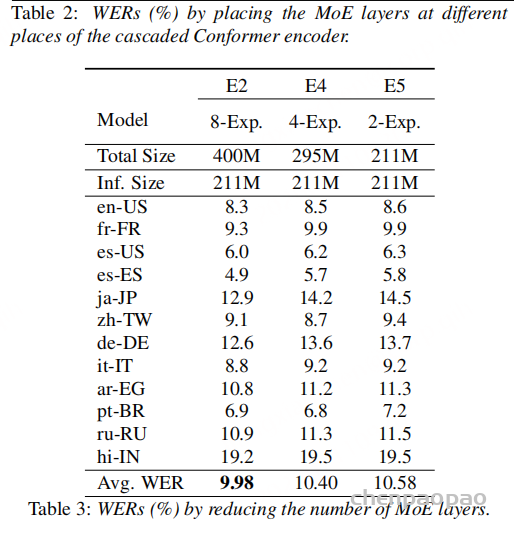
专家数量方面,8 experts 的 MoE-End 平均 WER 为 9.98;减少到 4 experts 后为 10.40;减少到 2 experts 后为 10.58。由于推理始终激活 top-2,专家总数减少主要影响总容量而不是激活参数。结果说明,额外专家确实被模型利用了。

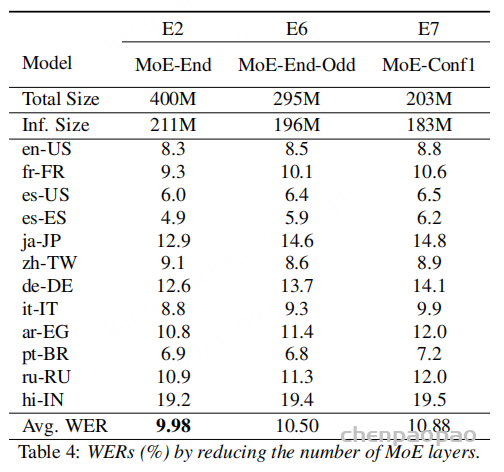
MoE 层数也很重要。只在隔层使用 MoE,平均 WER 退到 10.50;只在第一个 Conformer 层使用 MoE,为 10.88。即便只加一个 MoE 层也比 baseline 好,但完整地在 end FFN 位置加入 MoE 才能发挥主要效果。

与 dense baseline 和 adapter 比较

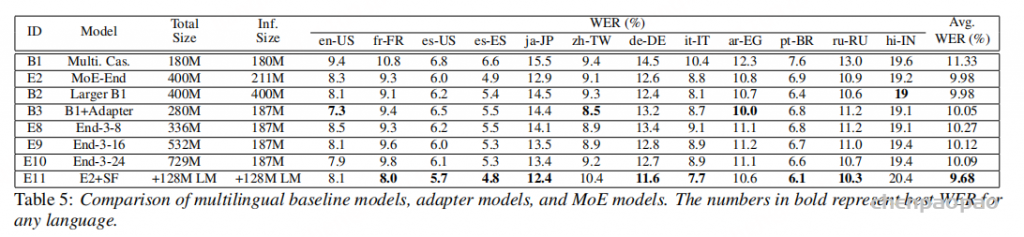
与 180M baseline 相比,MoE-End 模型总参数约 400M,推理激活约 211M,平均 WER 从 11.33 降到 9.98。为了排除“只是模型变大”的因素,作者构造了一个同为 400M 的大 dense baseline。这个 dense 模型平均 WER 也是 9.98,但推理需要激活 400M 参数;MoE 只激活 211M,约为 dense 的 53%。

与基于 ground-truth language information 的 adapter 模型相比,MoE 的意义更明显。Adapter 模型依赖真实语言信息选择对应模块;MoE 不需要语言标签,只根据输入动态路由。把 FFN multiplier 调小并增加专家数后,16 或 24 experts 的 MoE 在平均 WER 上接近 adapter,但部署上少了语言信息依赖。

Shallow Fusion 进一步提升

作者还训练了一个 128M 左右的多语种 neural LM,并在解码时做 shallow fusion。文本数据来自 12 种语言的监督训练文本和额外 text-only 数据。加入 LM 后,MoE 模型平均 WER 从 9.98 进一步降到 9.68,约 3% 相对改善。

不过改善并非所有语言都一致。法语收益最大,中文和印地语出现退化。作者推测,中文退化可能与 text-only 数据里混入粤语转写有关;印地语则可能因为 text-only 数据规模很大但与 Search 域不完全匹配,需要更好的过滤策略。

结论:MoE 的部署价值在于“不需要语言标签”

这篇论文展示了 MoE 在流式多语种 ASR 中的一个清晰用途:用更大的总容量提升多语种识别质量,同时通过 top-2 稀疏激活控制推理成本。最重要的是,模型不依赖语言标签完成专家选择,这比 adapter 或 per-language expert 在真实部署中更省心。

从结果看,MoE-End 相对于 baseline 有 11.9% 平均相对 WER 改善;与同规模 dense 模型相比,达到类似质量但只激活约 53% 参数;与语言标签 adapter 相比,质量接近但路由更自动。对端侧、流式、多语种这三个约束同时存在的场景,这种“动态容量”思路很值得继续跟进。

快手论文:Parameter-Efficient Conformers,利用MOE进行模型裁剪

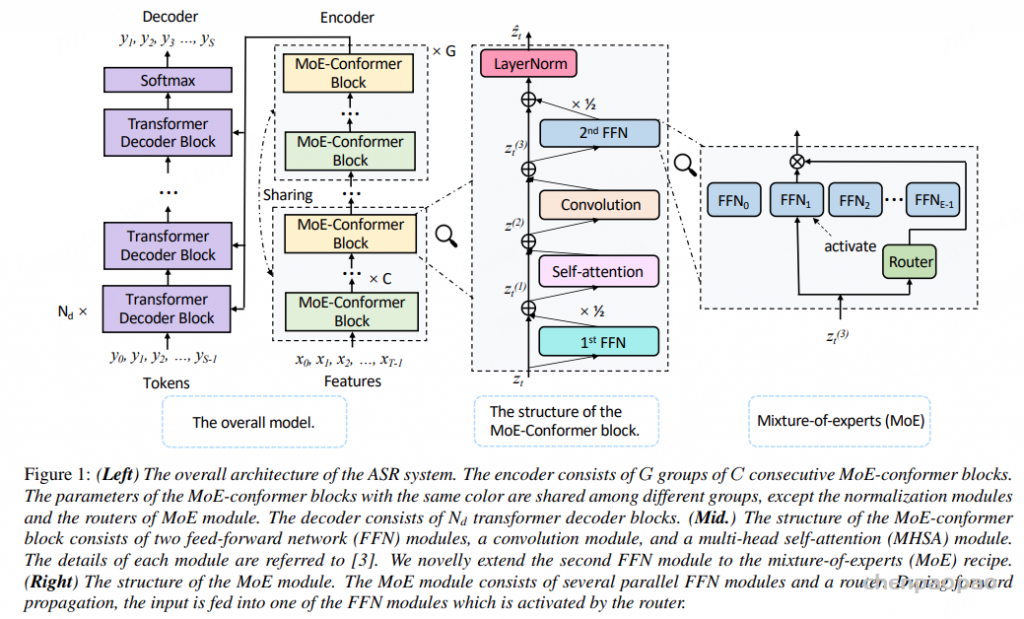
这篇论文 Parameter-Efficient Conformers via Sharing Sparsely-Gated Experts for End-to-End Speech Recognition 关注一个非常实际的问题:Conformer 在端到端语音识别里效果很好,但模型层数和参数量上来之后,训练、部署、端侧运行都会变重。作者的思路不是简单砍层,也不是只做普通的参数共享,而是把“共享 Conformer 块”和“稀疏门控专家”结合起来,让少量参数被重复使用,同时用 MoE 保住表示容量。

摘要:少参数,不想少能力

论文的核心目标是构造一个参数高效的 Conformer 编码器。传统跨层权重共享可以减少参数,但也会压缩模型容量,导致识别性能下降。作者提出的方案是在共享的 Conformer 块中加入 sparsely-gated MoE:第二个前馈网络不再是单一路径,而是一组专家,由路由器选择其中一个专家参与计算。这样总参数增加了一些,但每次前向只激活一个专家,计算量基本保持在非 MoE 模型的水平。

为了让共享块在不同深度位置仍能适配不同层级的表示,论文还让路由器和归一化层保持独立,而不是所有内容都共享。最后,作者用全参数模型作为 teacher,通过隐藏层表示的知识蒸馏进一步弥补共享模型的能力损失。实验显示,在 AISHELL-1 上,最终模型用约三分之一的编码器参数取得了接近全参数模型的 CER。

引言:Conformer 很强,但部署不轻

端到端 ASR 中,Transformer 和 Conformer 已经是很常见的编码器选择。Conformer 在 Transformer 的全局建模基础上加入卷积模块,更适合语音这种既有长程依赖、又有局部结构的序列。相对位置编码、Macaron 风格 FFN、卷积增强等设计,都让它在语音识别中表现稳定。

问题在于,这类模型往往参数冗余。直接堆很多层可以换来更强表达,但也带来显存、存储和推理成本。已有工作会通过跨层共享参数降低模型规模,类似让同一个 block 被重复调用多次。这个办法省参数,但副作用也明显:自由参数少了,模型容量下降,性能容易掉。

作者的切入点是:既然共享会损失容量,那就在共享块内部引入 MoE 来补容量;既然 MoE 可以稀疏激活,那就只让少数专家参与一次前向,避免计算量跟着总参数线性增长。这个组合特别适合“参数少、计算不能太贵”的场景。

背景:Conformer Seq2Seq ASR

论文使用的是 attention-based encoder-decoder 框架。编码器把声学特征序列变成高层表示,解码器按 token 逐步生成文本序列,训练时优化负对数似然,推理时用 beam search 找更可能的输出。

论文中先把 AED 的逐 token 预测概率写成下面这个形式,其中 y<s 表示当前位置之前的 token 前缀:

\( P(y_s \mid y_{<s}, x)=\mathrm{Trfm}(y_{<s},x) \)

对应的最大似然训练目标,也就是负对数似然损失为:

\( L_{\mathrm{nll}}(\theta)=-\frac{1}{S}\sum_{s=1}^{S}\log P(y_s\mid y_{<s},x) \)

Conformer 块由两个 FFN、一个多头自注意力模块和一个卷积模块组成。两个 FFN 采用半步残差风格,注意力负责长程依赖,卷积负责局部模式。本文的 MoE 改造发生在第二个 FFN:作者把它替换成一个稀疏门控的专家集合,也就是 MoE-Conformer block。

论文把一个 MoE-Conformer block 的计算写成四步。最后一步中,第二个 FFN 被替换成 MoE 版本:

\( \begin{aligned} z_t^{(1)} &= z_t + \frac{1}{2}\mathrm{FFN}(z_t),\\ z_t^{(2)} &= z_t^{(1)} + \mathrm{MHSA}(z_t^{(1)}),\\ z_t^{(3)} &= z_t^{(2)} + \mathrm{Conv}(z_t^{(2)}),\\ \hat{z}_t &= \mathrm{LayerNorm}\left(z_t^{(3)}+\frac{1}{2}\mathrm{FFN}^{(\mathrm{MoE})}(z_t^{(3)})\right). \end{aligned} \)

方法:共享稀疏门控专家

Conformer 参数共享

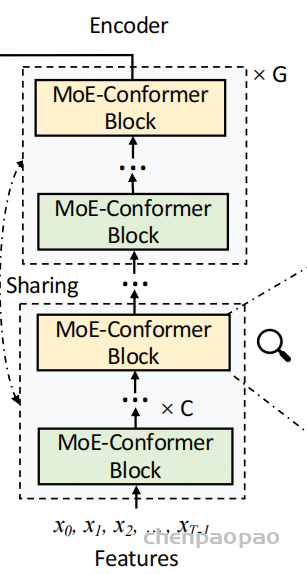
作者把连续的 C 个 Conformer 块看作一组,再堆叠 G 组。不同组中相同位置的块共享参数,相当于一组块被递归调用 G 次。这样做的好处很直接:如果想要 12 次变换,不一定真的保存 12 套编码器参数,可以用更少的块反复计算。

但是共享不是白来的。共享块在浅层和深层面对的表示分布不一样,如果完全用同一套参数、同一套路由、同一套归一化统计,模型会很难同时适配不同深度的表示。因此后面两个设计,也就是独立路由器和独立归一化,就变得很关键。

MoE 动态路由

MoE 模块由 E 个并行 FFN 专家和一个 router 组成。对每个时间步的表示,router 输出各专家的概率,论文采用 top-1 选择,只激活得分最高的专家。也就是说,虽然模型里存着多个专家参数,但每次计算只走其中一个 FFN。

top-1 MoE 的路由过程如下。router 先产生各 expert 的 gate 分数,再选择最大分数对应的 expert:

\( \begin{aligned} g &= [g_0,\cdots,g_{E-1}]=\mathrm{softmax}(\mathrm{router}(z_t^{(3)})),\\ i^* &= \arg\max_{0\le i\le E-1} g_i,\\ \mathrm{FFN}^{(\mathrm{MoE})}(z_t^{(3)}) &= g_{i^*}\mathrm{FFN}_{i^*}(z_t^{(3)}). \end{aligned} \)

这个设计把“容量”和“计算”部分解耦:总参数更多,潜在表达空间更大;但激活参数不增加太多,推理计算仍接近普通 FFN。为了避免所有样本都挤向同一个专家,作者加入 load balancing loss,同时在训练时给 router 加高斯噪声,让专家选择更分散。

负载均衡损失用于鼓励 expert 被更均匀地使用:

\( L_{\mathrm{balance}}=E\sum_{i=0}^{E-1}f_i\bar{g}_i \)

独立路由器与归一化

论文没有把所有 MoE router 都一起共享,而是让每个 MoE 模块拥有自己的 router。直觉上,同一个共享块在第 1 次、第 6 次、第 12 次递归调用时,输入表示已经处在不同层级;如果路由路径完全一致,就会限制专家选择的灵活性。

归一化层也类似。LayerNorm、BatchNorm 的统计和缩放偏移参数对表示分布很敏感。作者让归一化模块保持独立,使不同层级的表示能够维持各自合适的统计状态。论文还把归一化中的 scale 和 offset 看作一种轻量 adapter,用很少参数增强共享块的适配能力。

隐藏层知识蒸馏

共享模型再聪明,毕竟参数少。作者用全参数 Conformer 编码器作为 teacher,让共享模型的编码器输出尽量接近 teacher 的隐藏表示。这里不是只蒸馏最终预测分布,而是直接约束隐藏 embedding 的 L2 距离。这样做的目的,是让小模型学习 full model 的中间表征轨迹。

hidden embedding 蒸馏损失直接约束 student encoder 输出 h_t 与 teacher encoder 输出 h_t' 的距离:

\( L_{\mathrm{kd}}=\frac{1}{T}\sum_{t=0}^{T-1}\lVert h_t-h_t’\rVert_2 \)

训练目标

最终损失由三部分组成:主任务的负对数似然、MoE 的负载均衡损失、隐藏层知识蒸馏损失。负载均衡项负责让专家不塌缩,蒸馏项负责让共享模型贴近全参数 teacher。论文还在实验中加入 CTC loss 来辅助对齐。

\( L=L_{\mathrm{nll}}+\frac{\alpha}{C}\sum L_{\mathrm{balance}}+\beta L_{\mathrm{kd}} \)

这里 C 是 MoE module 的数量,αβ 分别控制负载均衡损失与蒸馏损失的权重。

与已有工作的关系

MoE 常被用来扩大模型容量,尤其是在 NLP 大模型里,通过条件计算扩展到很大的参数规模。但这篇论文不是追求超大规模,而是把 MoE 当作参数高效工具:共享专家、重复使用专家,让少量模块发挥更大作用。

跨层权重共享也不是新想法,ALBERT、Universal Transformer 以及若干 ASR 工作都用过类似机制。本文的不同点在于,它没有只做朴素共享,而是在共享结构里加入稀疏专家,同时让 router 和 normalization 独立,从而减少共享带来的容量和分布适配问题。

实验:

实验设置

实验使用 AISHELL-1 普通话语音识别数据集:约 150 小时训练语音、18 小时开发集、10 小时测试集。输入特征为 80 维 FBANK,窗口 25ms、步长 10ms,并使用全局 CMVN、速度扰动、SpecAugmentation 和 time stretch 等增强手段。词表包含 4235 个中文字符以及起止符号。

模型前端是两层 CNN subsampling,把帧率降到 25Hz。编码器维度为 256,MHSA 使用 4 个头,卷积核大小 15,FFN 中间维度 1024。MoE-Conformer 的第二个 FFN 使用 4 个专家,解码器是 4 层 Transformer。训练 80 个 epoch,使用 PyTorch 和 FastMoE 实现。

结果与分析

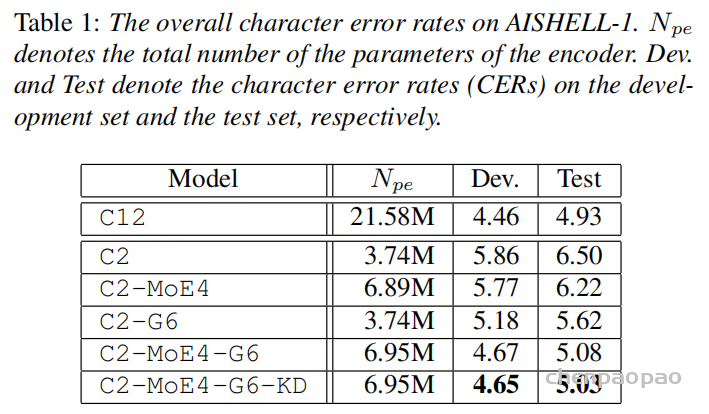
主表里,全参数 C12 编码器参数量为 21.58M,测试集 CER 为 4.93。最终的 C2-MoE4-G6-KD 只有 6.95M 编码器参数,测试集 CER 为 5.03。换句话说,它用大约三分之一的编码器参数,做到了非常接近 full-parameter 模型的结果。

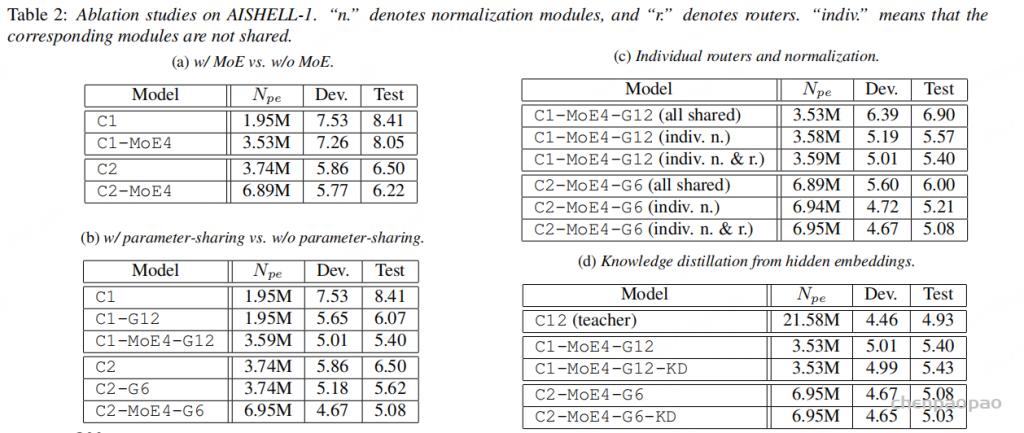
消融实验显示,单独减少块数会明显损伤效果,例如 C2 的测试 CER 为 6.50;加入 MoE 后,C2-MoE4 降到 6.22,说明专家机制确实补了一部分容量。再加入跨层共享递归计算后,C2-G6 为 5.62,而 C2-MoE4-G6 达到 5.08,说明“共享 + MoE”的组合比任一单独机制更有价值。

独立路由器和归一化的作用也很明显。C2-MoE4-G6 如果全部共享,测试 CER 为 6.00;只让归一化独立,降到 5.21;归一化和 router 都独立后,进一步到 5.08。这说明共享模型最怕的不是参数少本身,而是不同深度表示被迫使用完全相同的适配路径。

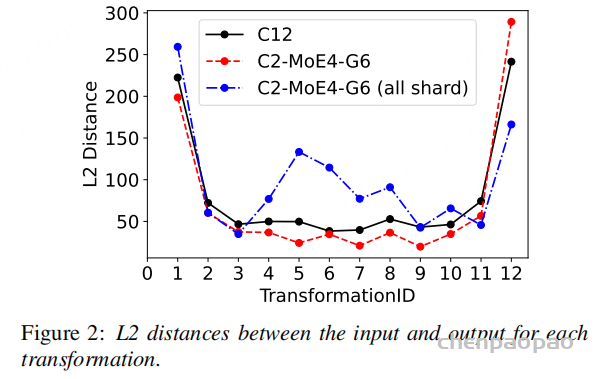
知识蒸馏带来的提升相对温和,但在 C2-MoE4-G6 上仍把测试 CER 从 5.08 推到 5.03。作者还通过输入输出 L2 距离观察模型内部变化:带独立 router 和 normalization 的共享模型更接近全参数 C12 的变化曲线,而全共享模型曲线更不稳定。

结论与未来方向

这篇论文的价值在于,它给出了一个较完整的参数高效 Conformer 方案:用跨层共享压缩参数,用稀疏 MoE 恢复容量,用独立路由器和归一化适配不同深度表示,再用隐藏层蒸馏补齐小模型表现。最终模型在 AISHELL-1 上以约三分之一编码器参数接近全参数模型。

它也留下了自然的后续问题:方法是否能在更大规模、多语种或更复杂的 ASR 数据集上保持优势?能否迁移到 RNN-T、CTC 或其他端到端 ASR 架构?从工程角度看,这类方案的吸引力很强,因为它不是单纯追求小模型,而是在“参数、计算、表达容量”之间做更细的拆分。

MoEAdapter for Large Audio Language Models: Sparsity, Disentanglement, and Gradient-Conflict-Free

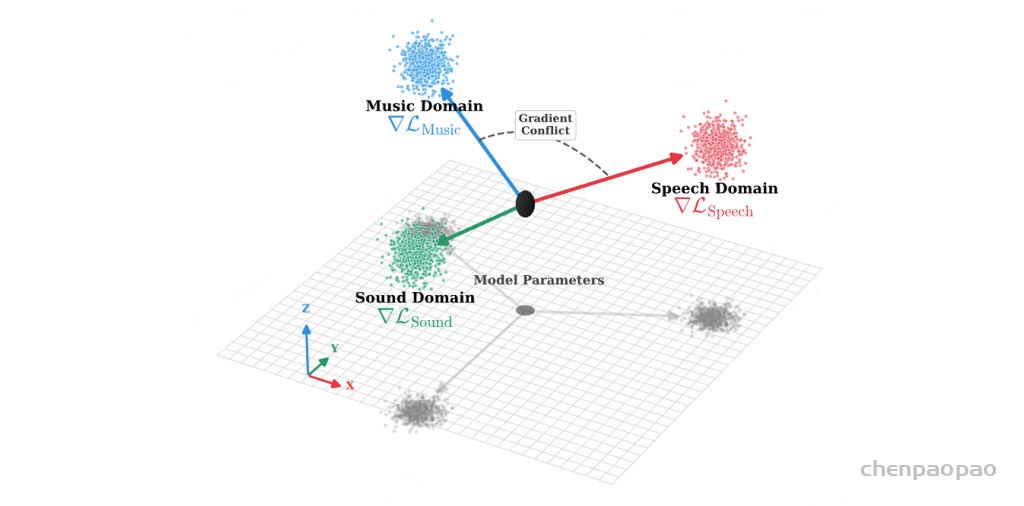
这篇论文 MoE Adapter for Large Audio Language Models: Sparsity, Disentanglement, and Gradient-Conflict-Free 的问题意识很明确:大语言模型要理解真实世界,不能只看文本,音频是很重要的输入模态。但音频并不是一种均匀信号。语音、音乐、环境声承载的信息结构不同,如果用一个 dense adapter 把所有音频都压进同一个文本 embedding 空间,很容易出现参数更新方向互相冲突。

摘要:用专家分工处理异质音频

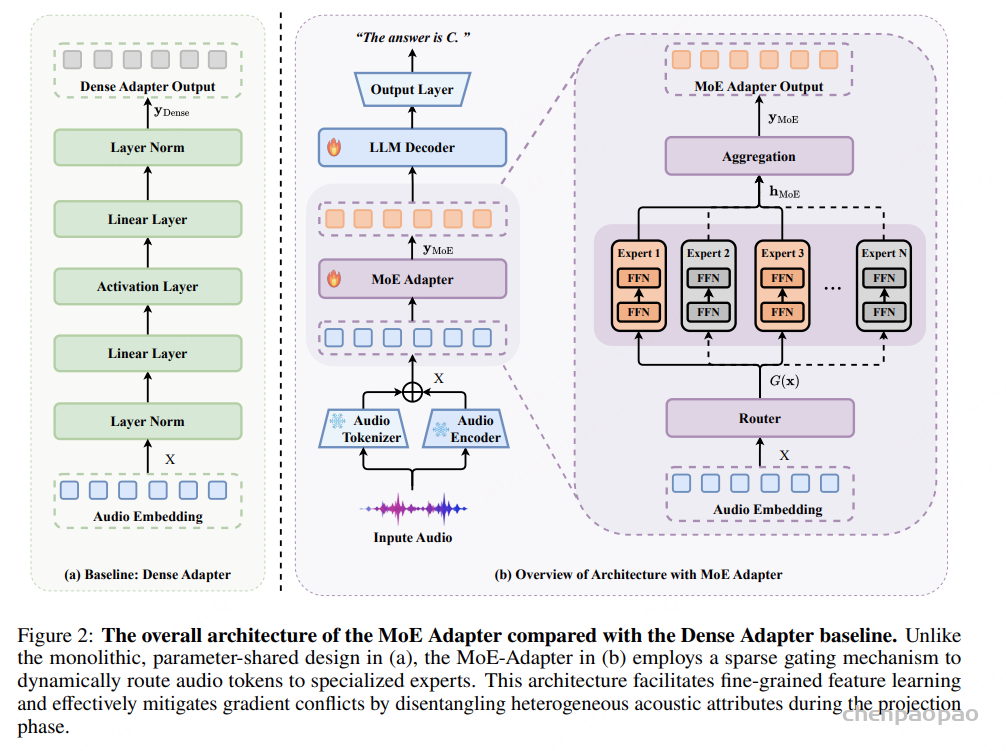
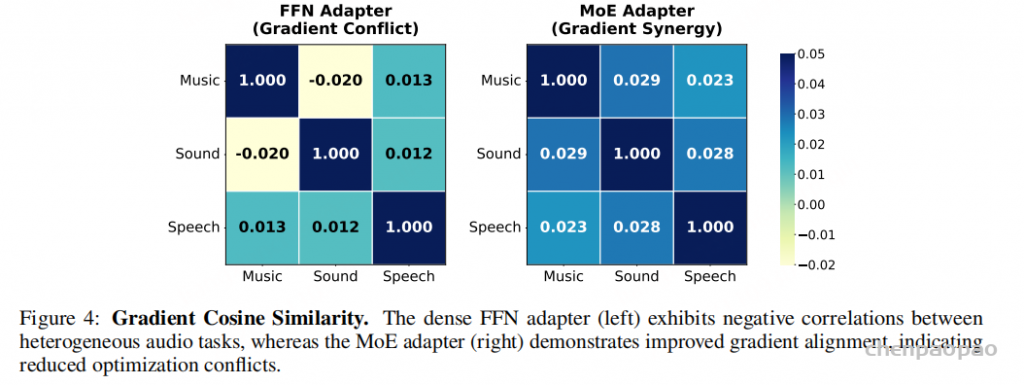
论文提出 MoE-Adapter,用稀疏 Mixture-of-Experts 替代传统的 dense audio adapter。它不是让所有音频 token 都通过同一套 FFN,而是用动态门控把 token 路由到若干专门专家,同时保留一定共享能力来捕捉全局上下文。这样,语音、音乐、环境声等不同属性可以在不同专家子空间中被建模,从而减轻梯度冲突。

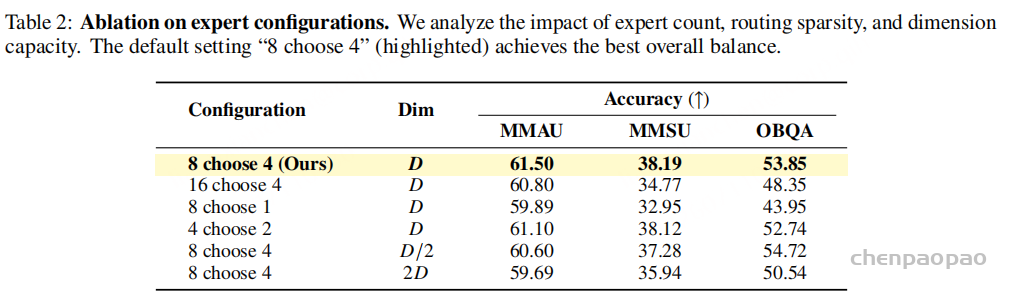
实验基于 Qwen3-1.7B 骨干,音频前端使用 Whisper-VQ tokenizer 和 Whisper Encoder。作者在相同参数预算下比较 dense adapter 和 MoE-Adapter:两者总参数约 94.4M,但 MoE 因稀疏激活,推理时只激活约 70.8M 参数。结果显示,MoE-Adapter 在 MMSU、OBQA、MMAU 等音频理解和推理任务上均优于 dense baseline,并减少音频输入与文本输入之间的 modality gap。

引言:音频不是一种单一分布

大语言模型在文本推理上已经非常强,但只处理文本会限制它们感知现实世界的能力。音频包含人类说话、环境声音、音乐和情绪韵律等信息,是多模态智能绕不开的一环。当前许多大音频语言模型的主流做法,是加一个 adapter,把声学特征投影到 LLM 的文本语义空间里。

问题在于,很多 adapter 是 dense、参数共享的:所有音频都经过同一套投影层。这隐含一个假设,即不同音频类型可以被同一种映射均匀处理。作者认为这个假设过强。语音主要承载语义和语言结构,音乐更关注节奏、旋律和情感,环境声又有自己的声学模式。它们在表示空间中可能位于不同流形。

如果一个 dense adapter 同时学习这些相互差异很大的目标,不同数据类型的梯度可能朝相反方向更新同一组参数。这就是论文强调的 gradient conflict。MoE-Adapter 的贡献,就是用动态专家路由把这些冲突拆开:相似属性共享专家,冲突属性进入不同专家。

相关工作

大音频语言模型

早期音频问答或语音交互系统常采用级联管线:先 ASR 转文字,再交给 LLM。这样的系统容易受到识别错误传播影响,也会丢失语调、情绪、音乐和环境声等非文字信息。后来的端到端 LALM 通过可学习 adapter,把声学特征映射到文本空间,让 LLM 直接条件化在音频表示上。

现有 adapter 大致分为 Q-Former 类和 linear projector / MLP projector 类。后者结构简单、效率高,因此被许多最新模型采用。但这种全局共享投影层难以面对音频内部的分布差异。本文正是针对这个瓶颈,把稀疏 MoE 引入 audio-text alignment 阶段。

MoE 架构

MoE 的基本思想是让不同专家处理不同样本或不同 token,通过稀疏门控实现条件计算。它已经在语言模型、多模态模型、视觉语言模型等方向证明了对异质数据和任务冲突的缓解能力。音频领域也开始出现 MoE 相关工作,例如生成、医疗音频特征选择等。

不过,在通用 audio-text alignment 这个环节,主流 LALM 仍大量依赖静态、共享参数 adapter。本文的 MoE-Adapter 不只是借用 MoE 扩容量,而是把 MoE 作为一种“解耦工具”,专门处理音频属性之间的冲突。

方法

整体框架

模型采用类似 Kimi-Audio 的 dual-stream 音频前端:一条路径用冻结 tokenizer 提取离散语义 token,另一条路径用 speech encoder 提取连续声学特征。两类表示经过投影和融合后,进入 adapter。

传统方案会用 dense adapter 把融合音频特征映射到 LLM embedding 空间。本文则用 MoE-Adapter 完成这一步。最终,adapted audio embeddings 与文本 token embeddings 拼接,作为 LLM 的输入,并用标准自回归 next-token prediction 训练。

稀疏 MoE Adapter

Dense adapter 可以看作一个单体 FFN:所有音频 token 都通过同一组权重。作者指出,这种设计强制同一组参数同时容纳异质音频,会形成不必要的优化干扰。

论文先把 dense adapter 写成单体 FFN 投影。给定音频 token x,输出 embedding 为:

\( y=\mathcal{N}\left(W_{d2}\cdot\sigma\left(W_{d1}\cdot\mathcal{N}(x)\right)\right) \)

MoE-Adapter 把单体 FFN 替换成专家集合。每个专家都是轻量 FFN,router 根据输入 token 计算各专家得分,并通过 Top-k 选择保留若干活跃专家。被选中的专家输出按门控权重聚合,形成中间表示。随后再经过输出投影和 LayerNorm,对齐到 LLM embedding 维度,用来替换输入序列中的音频占位 token。

每个 expert 本身也是一个轻量 FFN:

\( E_i(x)=W_{e2}^{(i)}\cdot\phi\left(W_{e1}^{(i)}\cdot\mathcal{N}(x)\right) \)

router 根据 logits s=xW_g 做 Top-k 稀疏选择,再 softmax 得到门控概率:

\( G(x)=\mathrm{softmax}\left(T_k(s)\right),\quad s=xW_g \)

被选中的 expert 输出按 gate 权重聚合,并经过最终投影对齐到 LLM embedding 空间:

\( h_{\mathrm{MoE}}=\sum_{i\in I}G(x)_i\cdot E_i(x) \) \( y_{\mathrm{MoE}}=\mathcal{N}\left(W_P\cdot h_{\mathrm{MoE}}\right) \)

这套机制有两个效果:一是稀疏激活降低推理成本,二是专家分工让不同音频属性进入不同子空间。对于语音、音乐、环境声这种天然异质输入,第二点尤其重要。

训练目标

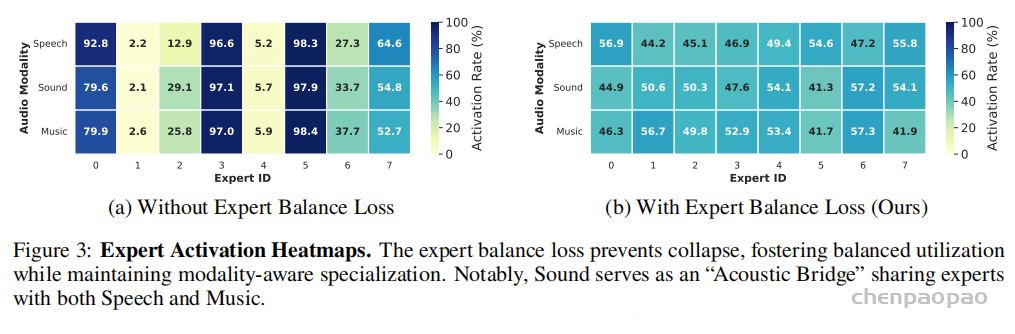
训练目标由 next-token prediction loss 和 auxiliary load-balancing loss 组成。前者让模型基于音频上下文预测后续文本 token,是主任务;后者用于避免 expert collapse,即所有 token 都涌向少数专家。

总训练目标为 next-token prediction 与负载均衡项的加权和:

\( L=L_{\mathrm{NTP}}+\lambda L_{\mathrm{aux}} \)

其中主任务 NTP loss 写成:

\( L_{\mathrm{NTP}}=-\sum_{t=1}^{T}\log P(y_t\mid y_{<t},X;\theta) \)

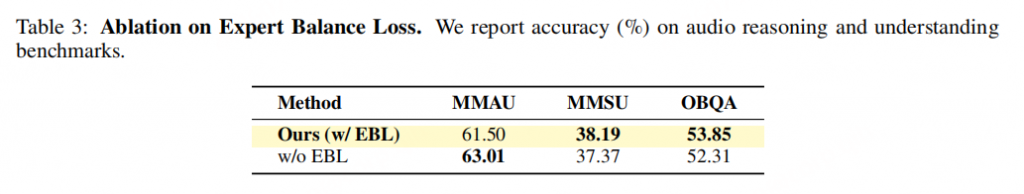
负载均衡损失会同时考虑专家的重要性和实际负载,让不同专家都被充分训练。这里有一个微妙的取舍:过强的均衡可能压制某些自然形成的专家偏好,但完全不均衡又会损害高层语义推理的泛化。论文后面的消融和分析专门讨论了这个矛盾。

论文将 expert importance 与 expert load 分别定义为:

\( \bar{P}_e=\frac{1}{B}\sum_{b=1}^{B}p_{b,e} \) \( \bar{f}_e=\frac{1}{B}\sum_{b=1}^{B}r_{b,e} \)

最终 auxiliary loss 为:

\( L_{\mathrm{aux}}=|\mathcal{E}_R|\sum_{e\in\mathcal{E}_R}\bar{P}_e\cdot\bar{f}_e \)

实验

实验设置

LLM 骨干是 Qwen3-1.7B,音频前端使用 Whisper-VQ tokenizer 和 Whisper Encoder。训练语料规模为 40B token,优化器为 AdamW,学习率调度采用 Warmup-Stable-Decay。为了公平比较,dense adapter 与 MoE-Adapter 的总参数预算都限制在约 94.4M。

评测覆盖几类能力。MMAU 用于音频感知和副语言理解,覆盖 speech、sound、music 等场景;VoiceBench 中的 MMSU 和 OpenBookQA 子集用于世界知识和语义推理,它们是从文本推理基准改造来的音频版本。所有评测采用 greedy decoding,避免采样随机性干扰比较。

主结果

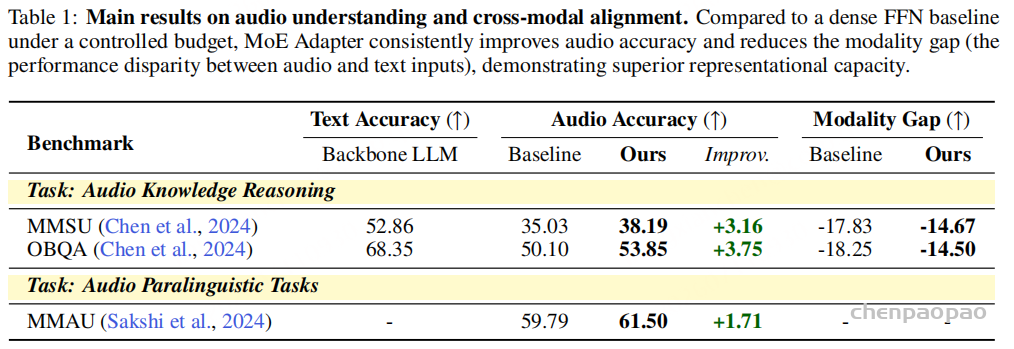
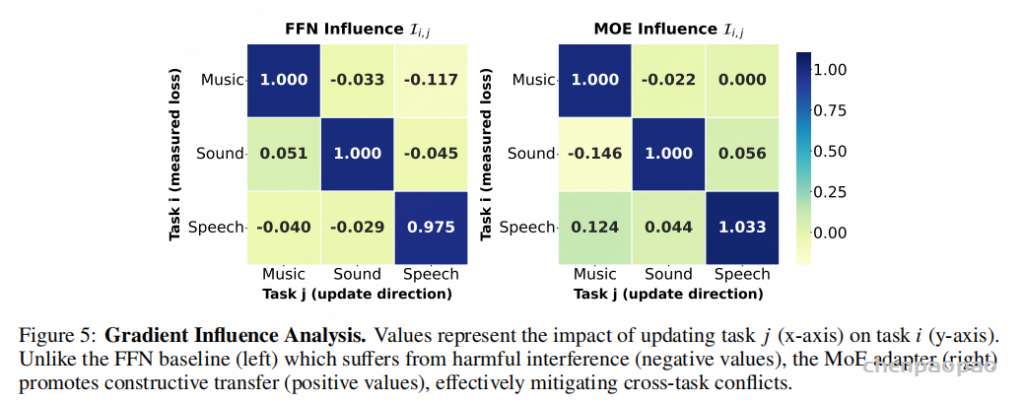
在知识推理任务上,MoE-Adapter 明显超过 dense baseline。MMSU 的 audio accuracy 从 35.03 提升到 38.19,OBQA 从 50.10 提升到 53.85。对比文本输入准确率,音频输入仍存在明显 gap,但 MoE 把这个差距分别缩小了约 3.16 和 3.75 个点。

在 MMAU 这类副语言和音频感知任务上,MoE-Adapter 也从 59.79 提升到 61.50。这个提升说明专家路由不仅对知识推理有用,也能帮助模型捕捉更复杂的声学线索。论文强调,MoE 的收益不是单纯参数变多,而是在相近总参数预算下更合理地分配表示能力。

消融实验

专家配置方面,默认的 “8 choose 4” 表现最均衡:MMAU 61.50、MMSU 38.19、OBQA 53.85。把专家数扩大到 “16 choose 4” 反而变差,说明专家总数不是越多越好。把路由变得过稀疏,例如 “8 choose 1”,也会显著伤害音频推理。论文的结论是,专家数量、激活数量和专家容量之间需要平衡,而不是盲目扩某一个维度。

负载均衡损失的消融更有意思。去掉 EBL 后,MMAU 从 61.50 升到 63.01,但 MMSU 和 OBQA 分别下降到 37.37 和 52.31。作者解释说,MMAU 很异质且含有大量低层声学感知样本,不加均衡时 router 会集中使用少数“强专家”,反而有利于这类感知任务;但这会减少专家多样性,损害需要世界知识和语义推理的任务

专家分工与优化动态分析

专家均衡如何影响路由

作者在 MMAU 上分析 speech、sound、music 三类样本的专家激活热力图。结果显示,模型确实学出了模态相关的专家分工:有些专家主要服务单一类别,有些专家在 sound 与 speech 或 sound 与 music 之间共享。值得注意的是,几乎没有专家同时专门服务 speech 和 music。

这个现象符合直觉:环境 sound 和 speech/music 都可能共享一些低层声学特征,因此可以作为“桥”;但 speech 和 music 在时间结构、语义组织上差异更大,不适合强行塞进同一个专家。EBL 并不会消灭这种分工,而是防止少数专家过度支配,保留一定均衡。

梯度冲突与缓解机制

论文用两个指标分析优化过程。第一个是不同音频类别梯度之间的 cosine similarity。dense adapter 中,不同类别的梯度经常出现负相似度,意味着一个类别的更新方向可能伤害另一个类别。MoE-Adapter 则把这些相似度推向更正的方向,说明专家路由减少了破坏性干扰。

第二个是 gradient influence score,用来衡量基于某一任务梯度做更新后,对另一个任务损失是帮助还是伤害。dense adapter 中,speech 的更新会明显伤害 music 和 sound;MoE-Adapter 中,影响分数更多为正,说明它不是简单隔离任务,还能通过共享专家保留有益迁移。例如 speech 对 sound 的更新可以产生正向帮助,而 music 的冲突被更好地隔开。

结论

这篇论文把 MoE-Adapter 定位为解决 LALM 音频异质性的结构工具。相比 dense adapter,它用动态专家分工缓解语音、音乐、环境声之间的梯度冲突,在相近参数预算下提升音频知识推理、副语言理解和跨模态对齐表现。更重要的是,论文不仅给出指标提升,也通过路由热力图、梯度相似度和影响分数解释了为什么 MoE 有效。

局限性

作者也明确指出了几个限制。第一,实验目前只在 Qwen3-1.7B 骨干上验证,方法是否适用于其他 LLM 家族或更大规模模型,例如 70B,还需要实验。第二,论文没有系统研究稀疏路由随训练数据规模增长的 scaling law。第三,当前任务集中在音频理解与推理,没有扩展到生成式音频任务。

附录:超参数和工程含义

附录强调,dense baseline 与 MoE-Adapter 在总参数预算上被严格对齐,约为 94.4M。MoE-Adapter 的活跃参数约为 70.8M,大约是 dense baseline 的 75%。共同音频前端包含 speech encoder、audio hidden projection 和 feature fusion;MoE 端则包含专家集合、gate network 和 aggregation block。

从工程角度看,这个设置很关键。它把论文的结论从“MoE 参数更多所以更强”拉回到“在可比预算下,稀疏专家分工更适合异质音频”。如果未来大音频语言模型要同时处理语音问答、环境声推理、音乐理解和情绪韵律,adapter 层可能不该再是一个单体投影器,而应该具备更细粒度的路由和分工能力。