论文:Hy ASR 3.0 Technical Report
团队:Hy ASR team / Tencent Hy
arXiv:2611.14908v1
Hy ASR 3.0 是一个建立在预训练 Hy3 基座模型之上的大语言模型式自动语音识别系统。它的目标不只是降低普通话和英语的 CER/WER,还要同时处理粤语与其他中文方言、热词和对话上下文、同音词消歧、长音频、儿童与老年人语音、低音量和噪声环境。系统由音频编码器、音频适配器、Hy3 LLM 解码器和音频条件热词检索模块组成,训练流程则覆盖自监督编码器训练、大规模 ASR 预训练、定向持续预训练、SFT、领域专家 RL、多教师 on-policy 蒸馏和行为强化学习。
一、核心结论与关键贡献
- LLM-based ASR:音频编码器提取声学表示,音频适配器将其投影到 LLM 输入空间,Hy3 LLM 自回归生成转写。
- 多种外部上下文:支持热词列表、问答式对话历史和摘要;热词先通过音频条件检索模块筛选,再与其他上下文一起作为文本前缀。
- 句内上下文消歧:模型能够利用同一条语音其他位置的语义或显式拼字说明,识别同音、近音和生僻词,无需额外外部上下文。
- 大规模自监督编码器:采用 Best-RQ 启动、迭代 HuBERT 和残差向量量化,在数千万小时语音上训练。
- 大规模伪标签:多套 ASR 系统独立生成候选转写,以 ROVER 投票融合,再经过多阶段质量过滤。
- 数据效率:领域平衡和数据压缩后,只使用原训练数据的 50% 仍获得更好性能;持续预训练对齐 SFT 分布后,SFT 数据可压缩到原来的 1/10,同时保持模型性能。
- 专家强化学习:分别训练通用 ASR、方言 ASR、上下文偏置 ASR 三个专家,以降低跨领域目标干扰。
- MOPD:学生先生成 on-policy 假设,再按领域路由给相应专家做 token 级 KL 蒸馏,把三个专家合并为一个统一模型。
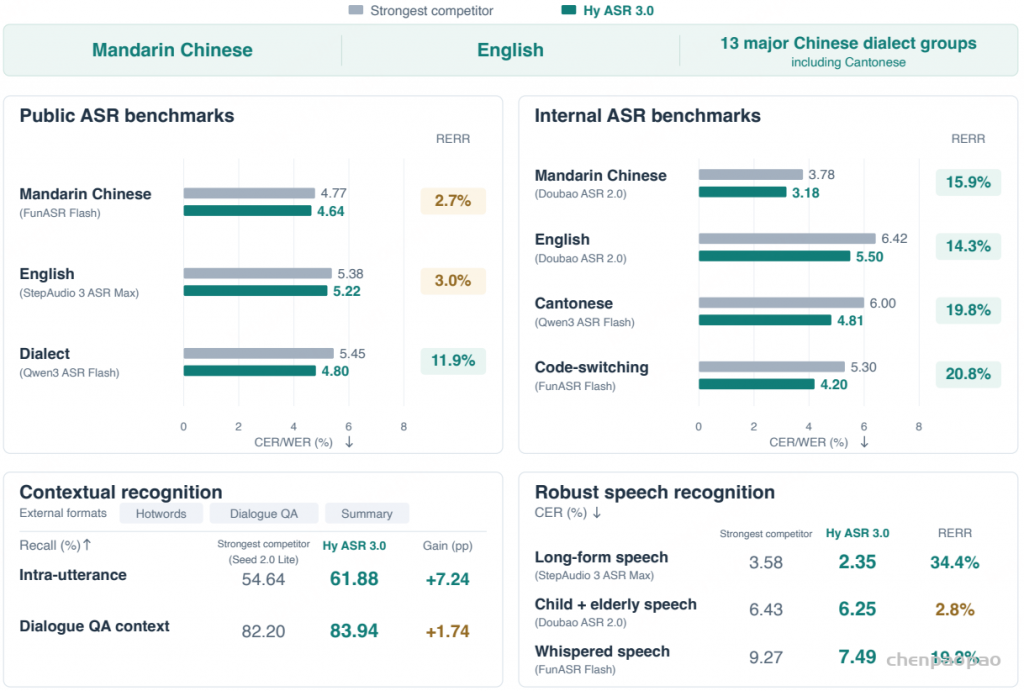
- 公开基准:论文报告中文聚合错误率 4.64%、英文 5.22%、方言组合 4.80%;粤语四个子集的非加权均值为 5.06%。
- 内部基准:普通话、英语、粤语、代码切换分别为 3.18%、5.50%、4.81%、4.20%,在论文比较的系统中均为最低。
- 上下文与鲁棒性:句内上下文关键词召回 61.88%,对话 QA 上下文召回 83.94%;长音频 CER 2.35%,儿童+老年语音 6.25%,低音量+噪声 7.49%。
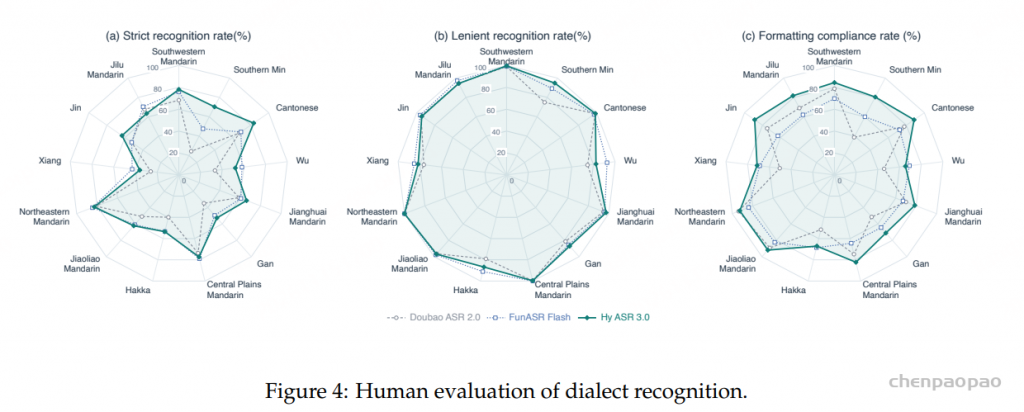
- 方言人工评测:覆盖 13 个方言大类、91 个次区域变体,严格识别率 64.7%,格式合规率 80.3%。
二、任务定位:
Hy ASR 3.0 的输出目标是语音内容转写,即把音频转换为文字。它关注的核心是四类问题:
- 普通话、英语、粤语和中文方言的识别准确率;
- 热词、历史问答和摘要等外部上下文如何帮助识别;
- 同一语句内部的语义、对比和逐字解释如何消除同音歧义;
- 长音频、不同年龄人群、低音量和噪声等真实业务条件下的鲁棒性。
三、模型架构
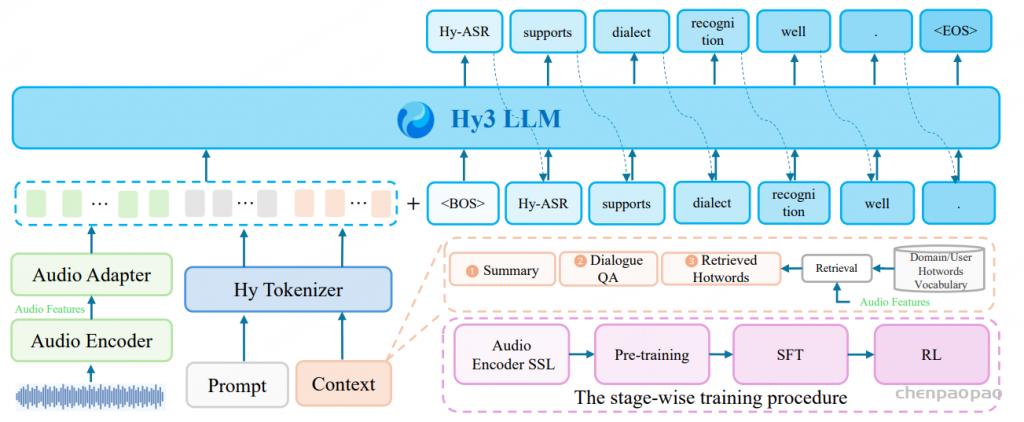
Hy ASR 3.0 模型架构与分阶段训练流程。图中包含 Audio Encoder、Audio Adapter、Hy Tokenizer、Hy3 LLM、摘要/对话 QA/检索热词前缀,以及 Encoder SSL、Pre-training、SFT、RL 四段训练链路。
3.1 音频编码器
音频编码器的训练采用迭代的 HuBERT 式自监督流程。先训练一个 Bootstrap Encoder,并用 Best-RQ 对它选定的中间表示做量化,得到离散目标;再用这些目标训练一个 Intermediate HuBERT 模型;随后对它的表示做残差向量量化,得到多级目标;最后训练最终编码器,从被掩码的语音输入预测这些目标。整个阶段的直接监督来自语音自身的量化表示,人工逐字标注留给后续需要监督的任务。
编码器在数千万小时语音上分 2 阶段训练,数据以普通话和英语为主,也包含粤语和其他汉语方言。第一阶段覆盖较广的语音混合,第二阶段继续预训练时重新平衡数据,更强调汉语方言,降低噪声录音和短句的权重,并加强掩码策略和 utterance mixing,以提高对干扰语音的鲁棒性。
Best-RQ × HuBERT 式自监督学习 × 残差向量量化: Best-RQ 先提供可训练的 bootstrap 目标和量化表示,HuBERT 式自监督学习把这些表示变成掩码预测任务,残差向量量化再把表示分成多级离散目标。三者的分工是:Best-RQ 解决起始监督,HuBERT 式流程解决从掩码语音学习语义表示,残差向量量化提供更细的多级预测目标;组合后,最终音频编码器不需要人工逐字标签,就能从大量无标注语音中学习可供 LLM 使用的表示。
PS:
- Best-RQ 的核心思想是:不需要预训练教师模型,也不需要人工标签,通过随机投影和随机码本,就能将连续语音特征转换成离散 Token,作为模型学习的伪标签。
- HuBERT(Hidden-Unit BERT)的核心思想是:先为语音生成离散伪标签,再遮挡输入语音的一部分,让模型根据未被遮挡的上下文预测被遮挡位置的离散标签。建模上下文中的声学和语义关联,迫使模型学习更强的上下文表示。
- RVQ,即残差向量量化,核心思想是:不再使用一个码本对连续向量进行一次量化,而是使用多个码本逐级量化前一级未能表示的残差,从而实现多级离散编码。提高离散表示的表达容量。保留更细粒度的声学和语音信息。提供多个离散预测目标,丰富自监督训练信号。
无标注语音
   ↓
Bootstrap Encoder
   ↓
Best-RQ 量化中间表示
   ↓
离散伪标签
   ↓
Intermediate HuBERT
   ↓
残差向量量化 RVQ
   ↓
多级离散伪标签
   ↓
最终 Encoder
   ↓
遮蔽语音预测多级目标
3.2 音频适配器
音频适配器将编码器的声学表示映射到 Hy3 LLM 的输入嵌入空间,使连续音频表示能够与文本 token、提示词和上下文前缀处在同一个条件序列中。
3.3 外部上下文与音频条件热词检索
系统支持三种外部上下文:
- Hotword list:明确给出专有名词、产品名、人名、地名等候选词。
- Dialogue QA:先前轮次的问答历史,为当前语音提供对话语义。
- Summary:对任务、会议或对话主题的摘要。
候选热词表可能很大,直接把所有词塞入 LLM 前缀会造成无关干扰和上下文浪费。因此热词检索模块同时观察音频表示和候选热词,只选择与当前音频相关的词,形成 retrieved hotwords。检索结果与摘要、对话 QA 一起编码成文本前缀,排在音频嵌入之前。
3.4 LLM 自回归转写
Hy3 LLM 根据外部上下文前缀、音频嵌入和此前已经生成的 token,自回归地产生转写:
\(P(y_{1:T}\mid x,c)=\prod_{t=1}^{T}P(y_t\mid y_{<t},x,c)\)其中 \(x\) 是音频表示,\(c\) 可以包含检索热词、摘要和历史对话。论文强调,句内上下文不是单独输入项:模型通过整段音频和已生成转写序列,自然利用语句其他位置的信息。
四、音频编码器的自监督训练
4.1 Best-RQ 启动编码器
第一步先用 Best-RQ 训练一个 bootstrap encoder。Best-RQ 通过随机投影量化产生离散目标,避免一开始就依赖高质量人工标签。训练完成后,从该编码器选定的中间层提取表示并量化,作为下一轮 HuBERT 的离散监督。
4.2 中间 HuBERT 与多级目标
用 bootstrap encoder 生成的离散标签训练中间 HuBERT 模型。然后再对这个 HuBERT 的表示应用残差向量量化(Residual Vector Quantization,RVQ),形成多级离散目标。RVQ 不只给一个 code,而是用多个残差量化层逐级逼近表示,因此最终编码器可以学习不同粒度的声学—语义结构。
4.3 最终编码器的掩码预测
最终音频编码器接收被遮蔽的语音输入,并预测 RVQ 产生的多层离散目标。这一流程与 HuBERT 的“先聚类/量化、再预测掩码位置伪标签”思想一致,但目标构建经历了 Best-RQ 启动、中间 HuBERT 和残差量化的迭代精炼。
4.4 编码器数据与两阶段配比
编码器使用数千万小时语音训练,主要为普通话和英语,也包含粤语与其他中文方言。论文没有公开精确小时数、数据集清单和各语言比例。
- 大规模预训练:先在宽泛的语音混合上训练,获取通用声学与语义表示。
- 持续预训练:重新平衡数据,提高中文方言占比,降低噪声录音和短语音的采样权重。
编码器训练还加强了掩码策略,并采用 utterance mixing,把不同语句混合,提升对干扰语音的鲁棒性。论文引用了相关混合方法,但没有给出混合概率、信噪比或具体增强参数。
五、大规模 ASR 预训练:数据如何获取与后处理
5.1 第一阶段:Web 级大规模预训练
第一阶段使用来自 Web 的数千万小时语音。如此大规模的数据不可能全部依赖人工转写,团队构建了多系统自动标注流水线:
- 多个不同 ASR 系统对同一音频独立生成候选转写;
- 使用 ROVER(Recognizer Output Voting Error Reduction)对多个候选进行对齐和投票;
- 对融合后的伪转写进行多阶段质量过滤,去除不可靠样本;
- 进行领域感知的数据平衡,避免高频领域过度占用训练容量;
- 进行数据压缩,删除冗余信息,把预算集中到更有信息量的样本。
ROVER 的核心思想是把多套识别结果对齐成词图/混淆网络,再根据系统投票选出更可信的 token 序列。给出了总体效果:经过平衡与压缩后,使用原始训练数据的 50% 就能获得更好的模型性能。这说明“规模”不是唯一变量,数据冗余、领域失衡和伪标签噪声同样重要。
5.2 第二阶段:定向持续预训练
第二阶段提高以下数据的比例:
- 中文方言语音;
- 上下文偏置/热词相关数据;
- 困难声学条件下的语音。
这个阶段有两个目的:一是直接增强方言、上下文和噪声鲁棒性;二是让预训练分布更接近后续 SFT 数据。论文报告,经过这种分布对齐后,SFT 数据可缩减到原来的 1/10,同时保持模型性能,从而显著加快 SFT 实验迭代。
六、后训练:SFT、专家 RL、MOPD 与行为 RL
6.1 监督微调 SFT
SFT 重点提升方言、上下文偏置和困难声学场景,同时保持预训练阶段的通用 ASR 能力。训练数据也采用迭代自举:
- 持续改进自动转写流水线的各个标注组件;
- 每轮选择上一轮表现最好的 SFT 检查点作为教师;
- 教师为下一轮数据生成伪转写;
- 逐轮提高伪标签质量,并补充方言与其他困难场景的定向数据。
6.2 三个领域专家的强化学习
团队从同一个 SFT 检查点初始化三个独立专家:
- 通用领域 ASR 专家;
- 方言 ASR 专家;
- 上下文偏置 ASR 专家。
分开训练可以减少通用准确率、方言行为和上下文关键词识别之间的梯度冲突。每个专家的奖励按领域特点设计,不仅考虑整体识别准确率,也考虑关键词识别和语句级转写流畅度。报告没有公开奖励函数的精确公式和各项权重。
6.3 多教师 On-Policy 蒸馏(MOPD)
三个专家最终需要合并为一个服务模型。MOPD 的流程是:学生先对每条语音生成自己的 on-policy 识别假设;根据样本领域,把该学生轨迹路由给对应专家;专家在学生实际访问的 token 前缀状态上提供 token 级分布监督。
\(\mathcal{L}_{\mathrm{MOPD}}=\mathbb{E}\left[\frac{1}{T}\sum_{t=1}^{T}D_{\mathrm{KL}}\left(\pi_{\theta}(\cdot\mid\mathbf{s}_t)\Vert\pi_{\phi_d}(\cdot\mid\mathbf{s}_t)\right)\right]\) \(T=|\hat{\mathbf{y}}|,\qquad \mathbf{s}_t=(\mathbf{x},\hat{\mathbf{y}}_{<t})\)其中 \(\pi_{\theta}\) 是学生策略,\(\pi_{\phi_d}\) 是领域 \(d\) 对应的专家,\(\mathbf{x}\) 包含声学输入和可选上下文,\(\hat{\mathbf{y}}\) 是学生自己生成的序列。采用 on-policy 轨迹的好处是:专家监督发生在学生真实会遇到的状态上,而不是只在标准答案前缀上蒸馏,可缓解训练—推理状态分布不一致。
KL 的方向是学生到教师:
\(D_{\mathrm{KL}}(\pi_{\theta}\Vert\pi_{\phi_d})=\sum_{v}\pi_{\theta}(v\mid\mathbf{s}_t)\log\frac{\pi_{\theta}(v\mid\mathbf{s}_t)}{\pi_{\phi_d}(v\mid\mathbf{s}_t)}\)6.4 Model-Behavior RL
最后阶段针对真实使用中发现的 hard cases 做行为强化,重点是必须依赖周围语义才能正确识别的关键词。这一阶段直接奖励上下文依赖的关键词识别和整句连贯、流畅的转写。它更接近产品反馈闭环:先发现线上困难行为,再构造定向强化样本,而不是只优化平均 CER/WER。
七、数据规模、获取与处理:
| 阶段 | 论文披露的数据规模 | 获取/处理方式 | 未披露项 |
|---|---|---|---|
| 音频编码器自监督训练 | 数千万小时 | 普通话和英语为主,含粤语与其他方言;Best-RQ、HuBERT、RVQ、掩码预测;持续预训练重平衡 | 精确小时数、来源清单、语言比例 |
| ASR 大规模预训练 | 数千万小时 Web 语音 | 多 ASR 候选、ROVER 融合、多阶段过滤、领域平衡、数据压缩 | 教师系统、过滤阈值、原始/保留小时数 |
| 定向持续预训练 | 未给精确规模 | 提高方言、上下文偏置、困难声学数据比例 | 各类占比、训练步数 |
| SFT | 可压缩到原规模的 1/10 | 迭代教师伪标签,定向补充方言与困难场景 | 原始规模、最终规模、人工/伪标签比例 |
| 专家 RL 与 MOPD | 未披露 | 通用/方言/上下文三专家,领域路由蒸馏 | 样本量、奖励权重、采样和训练超参数 |
| Model-Behavior RL | 未披露 | 来自真实使用的 hard cases,强调上下文关键词 | 数据收集与隐私流程、规模、奖励公式 |
八、评测设置、对比系统与指标
对比系统包括 Qwen3 ASR Flash、FunASR Flash、Doubao ASR 2.0、Seed 2.0 Lite、StepAudio 3 ASR Max 和 Hy ASR 3.0 Preview。论文说明,这些系统名称与服务来自其技术报告或官方服务页面,但表中的数值是本研究自己的评测结果,不是从外部文档直接摘录的排行榜分数。
- CER/WER:客观识别错误率,越低越好。
- Target-keyword recall:目标关键词召回率,越高越好。
- 人工方言指标:严格识别率、宽松识别率、格式合规率,越高越好。
- 相对错误率下降:以最强非 Hy 对手为基准。
其中 S、D、I 分别为替换、删除和插入。召回率或人工百分比之间的差异使用“百分点”,不使用相对错误率公式。
九、公开 ASR 基准
公开测试覆盖 AISHELL-1/2、AliMeeting、WenetSpeech、FLEURS、Common Voice、SpeechIO、LibriSpeech、GigaSpeech、TED-LIUM 3、VoxPopuli、MLS、WenetSpeech-Yue 和 KeSpeech。论文声称进行了严格去污染:训练中不包含评测语音,也不包含其音频或文本近重复。
| 聚合组 | Qwen3 | FunASR | Doubao | Seed | StepAudio | Preview | Hy ASR 3.0 |
|---|---|---|---|---|---|---|---|
| 中文 | 5.73 | 4.77 | 5.55 | 5.42 | 6.98 | 4.73 | 4.64 |
| 英文 | 6.21 | 6.02 | 7.93 | 5.56 | 5.38 | 5.28 | 5.22 |
| 方言组合 | 5.45 | 5.46 | 7.66 | 6.73 | 6.26 | 5.23 | 4.80 |
相对最强外部对手,三组分别约降低 2.7%、3.0% 和 11.9%;相对 Preview 分别约降低 1.9%、1.1% 和 8.2%。这些聚合提升并不意味着每个子集都第一。
9.1 普通话子集
| 测试集 | Qwen3 | FunASR | Doubao | Seed | StepAudio | Preview | Hy ASR 3.0 |
|---|---|---|---|---|---|---|---|
| AISHELL-1 | 2.12 | 1.01 | 1.90 | 2.03 | 1.40 | 1.21 | 1.37 |
| AISHELL-2 Android/iOS/Mix | 2.70/2.59/2.55 | 2.16/1.91/2.14 | 2.67/2.55/2.69 | 2.68/2.75/2.78 | 2.30/2.20/2.35 | 2.02/2.03/2.10 | 2.05/2.02/1.98 |
| AliMeeting Near/Far | 7.13/23.14 | 5.94/22.02 | 5.88/26.18 | 6.27/24.81 | 7.89/34.23 | 5.84/21.27 | 5.47/21.52 |
| WenetSpeech Net/Meeting | 4.96/6.16 | 3.74/3.62 | 4.11/4.54 | 4.13/4.23 | 6.63/8.52 | 3.91/4.31 | 3.74/4.16 |
| FLEURS-zh | 2.95 | 2.00 | 2.40 | 2.13 | 1.85 | 1.84 | 1.84 |
| CommonVoice-zh | 4.41 | 4.10 | 5.61 | 4.54 | 5.00 | 4.52 | 4.49 |
| SpeechIO Locked/Unlocked | 3.62/6.47 | 5.95/2.61 | 2.52/5.52 | 5.09/2.62 | 8.50/2.94 | 5.04/2.63 | 4.63/2.36 |
Hy ASR 3.0 的优势集中在 AISHELL-2 Mix、AliMeeting Near、SpeechIO Unlocked,并在 WenetSpeech test-net 与 FLEURS-zh 并列最佳。但 AISHELL-1、WenetSpeech Meeting、CommonVoice-zh 和 SpeechIO Locked 并非最好,说明总体聚合提升来自跨数据集平衡,而非全面碾压。
9.2 英文子集
| 测试集 | Qwen3 | FunASR | Doubao | Seed | StepAudio | Preview | Hy ASR 3.0 |
|---|---|---|---|---|---|---|---|
| LibriSpeech Clean/Other | 1.33/2.60 | 1.31/2.50 | 2.87/5.85 | 1.37/2.65 | 1.17/2.25 | 1.28/2.59 | 1.19/2.31 |
| CommonVoice-en | 6.32 | 6.31 | 14.18 | 6.81 | 7.21 | 5.53 | 5.48 |
| FLEURS-en | 2.66 | 3.24 | 6.38 | 2.55 | 2.95 | 2.64 | 2.53 |
| GigaSpeech Test | 9.15 | 9.96 | 9.58 | 9.43 | 9.68 | 8.27 | 8.27 |
| TED-LIUM 3 | 3.00 | 3.39 | 3.18 | 3.04 | 2.48 | 2.50 | 2.44 |
| VoxPopuli Test/Accented | 5.99/20.97 | 6.06/16.84 | 9.52/12.57 | 7.40/13.28 | 7.08/11.75 | 5.98/14.75 | 5.84/15.27 |
| MLS Test-en | 3.87 | 4.57 | 7.27 | 3.54 | 3.85 | 3.99 | 3.69 |
Hy ASR 3.0 在 Common Voice、FLEURS、TED-LIUM 3、VoxPopuli 普通测试集上最好,并在 GigaSpeech 与 Preview 持平。但 LibriSpeech 两个子集仍由 StepAudio 领先;VoxPopuli accented 上 Hy ASR 3.0 为 15.27%,不仅落后 StepAudio 的 11.75%,还比 Preview 的 14.75% 更差,论文把带口音英语列为后续改进方向。
9.3 粤语与 KeSpeech
| 测试集 | Qwen3 | FunASR | Doubao | Seed | StepAudio | Preview | Hy ASR 3.0 |
|---|---|---|---|---|---|---|---|
| FLEURS-yue | 2.97 | 3.24 | 6.52 | 2.64 | 3.05 | 2.76 | 2.63 |
| CommonVoice-yue | 4.67 | 4.98 | 5.84 | 6.28 | 5.90 | 3.49 | 3.56 |
| WenetSpeech-Yue Short/Long | 6.51/8.58 | 5.73/9.01 | 9.48/11.33 | 8.27/10.77 | 7.09/9.86 | 5.38/9.34 | 5.00/9.05 |
| KeSpeech | 4.51 | 4.33 | 5.12 | 5.68 | 5.39 | 5.17 | 3.77 |
Table 1 的“方言 4.80%”把四个粤语子集与 KeSpeech 合并。若只计算 FLEURS-yue、CommonVoice-yue、WenetSpeech-Yue Short/Long 四个粤语子集的非加权均值,Hy ASR 3.0 为 5.06%,Qwen3 为 5.68%,相对下降约 11.0%。KeSpeech 从 Preview 的 5.17% 降到 3.77%,相对下降 27.1%。
十、内部主语言基准
内部测试集来自真实业务数据,用来补充公开数据不能覆盖的实际分布。论文未公开数据规模、领域构成和采样方法。
| 测试集 | Qwen3 | FunASR | Doubao | Seed | StepAudio | Preview | Hy ASR 3.0 |
|---|---|---|---|---|---|---|---|
| 普通话 | 4.94 | 4.15 | 3.78 | 5.56 | 5.30 | 3.35 | 3.18 |
| 英语 | 8.76 | 7.54 | 6.42 | 8.78 | 10.68 | 5.78 | 5.50 |
| 粤语 | 6.00 | 19.40 | 7.49 | 7.90 | 7.00 | 4.92 | 4.81 |
| 代码切换 | 8.80 | 5.30 | 6.49 | 6.37 | 6.90 | 4.35 | 4.20 |
Hy ASR 3.0 在四类内部测试中都最低,并全面优于 Preview。相对图 1 中所列最强外部对手,普通话、英语、粤语和代码切换分别给出约 15.9%、14.3%、19.8% 和 20.8% 的相对错误率下降。
十一、上下文利用
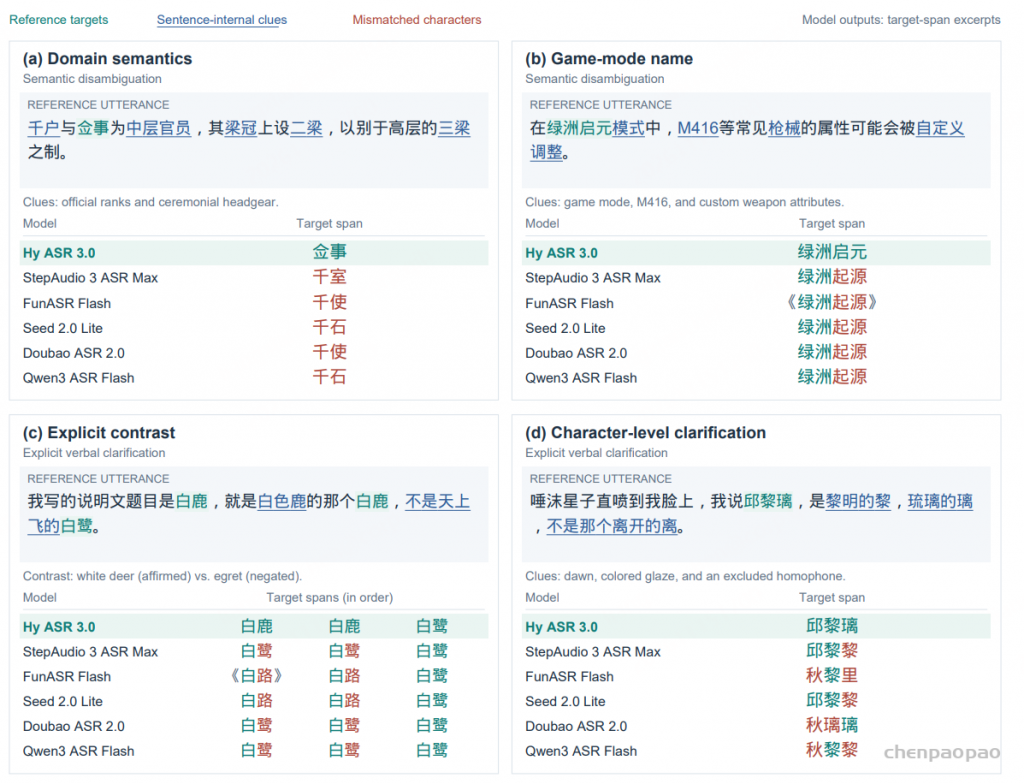
四个句内消歧案例。面板 (a)–(b) 为语义消歧,(c)–(d) 为显式口头澄清;所有线索都在当前语句内部。
11.1 四个定性案例
- 历史官职:根据“负责太子中属官员、祭祀及礼仪”等语义,识别罕见官职名称,而其他模型输出近音常见词。
- 游戏模式名:根据游戏、M416 和自定义调整等领域语义,选择正确的专名写法。
- 显式对比:说话者明确说明“白鹿的鹿,不是白鹭的鹭”,模型需保留肯定项并排除否定同音词。
- 逐字解释姓名:通过“哪个部首/哪个字”的解释区分姓名中相邻同音字;部分模型虽然转对了解释,却仍在姓名中重复同一个字。
这些案例证明输出与上下文线索一致,但它们只是定性示例,不是“关闭上下文/开启上下文”的受控消融。
11.2 关键词召回结果
| 测试集 | Qwen3 | FunASR | Doubao | Seed | StepAudio | Preview | Hy ASR 3.0 |
|---|---|---|---|---|---|---|---|
| 句内上下文 | 46.60 | 51.16 | 51.86 | 54.64 | 50.75 | 58.12 | 61.88 |
| 对话 QA 上下文 | 71.68 | 77.33 | 78.47 | 82.20 | 69.32 | 79.44 | 83.94 |
相对最强非 Hy 对手 Seed 2.0 Lite,Hy ASR 3.0 分别提高 7.24 和 1.74 个百分点。需要再次强调,这是跨系统比较,不是同一模型有无上下文的消融,因此不能精确量化每种上下文模块的单独贡献。
十二、鲁棒性
| 测试集 | Qwen3 | FunASR | Doubao | Seed | StepAudio | Preview | Hy ASR 3.0 |
|---|---|---|---|---|---|---|---|
| 长音频 | 3.86 | 3.98 | 5.60 | 4.99 | 3.58 | 2.96 | 2.35 |
| 儿童 + 老年人 | 9.98 | 7.87 | 6.43 | 10.49 | 9.90 | 7.18 | 6.25 |
| 低音量 + 噪声 | 14.72 | 9.27 | 15.75 | 17.31 | 43.02 | 8.48 | 7.49 |
相对最强非 Hy 对手,三项 CER 分别下降 34.4%、2.8% 和 19.2%。长音频和低音量/噪声的改进更明显。儿童与老年人被合并成一个测试集,因此 6.25% 不能证明模型分别在儿童和老年人子集都同样提升。
十三、方言识别与人工评测
许多方言缺乏统一书写标准,同一句口语可能有多个合理写法,传统 WER/CER 未必能公平衡量。论文对缺少标准正字法的方言采用翻译式表示,把口语内容转成更一致的书面表达。模型开发阶段使用 LLM judge 评估语义错误率和转写风格一致性,但最终以人工评测为准。
人工评测覆盖 13 个方言大类、91 个次区域变体,对比 FunASR Flash 与 Doubao ASR 2.0。指标含义如下:
- 严格识别率:转写内容被判断为完全正确的比例。
- 宽松识别率:允许不改变语义的措辞差异,判断语义正确的比例。
- 格式合规率:没有标点、逆文本归一化(ITN)和流畅性问题的比例。
Hy ASR 3.0 的总体严格识别率为 64.7%,比 FunASR 高 2.8 个百分点、比 Doubao 高 12.5 个百分点;格式合规率为 80.3%,分别高 11.4 和 13.7 个百分点。宽松识别率高于 Doubao,但比 FunASR 低 1.0 个百分点。
分方言看,闽南语与粤语的严格识别率分别达到 70.3% 和 83.3%,比各自最强对手高 22.7 和 14.2 个百分点;但吴语三个指标都仍由 FunASR 领先,说明模型在不同地区变体上的能力并不均衡。
十四、总结
Hy ASR 3.0 的主线不是提出一个单独的新网络层,而是构建一套大规模、分阶段的 LLM-ASR 训练体系:先用迭代 HuBERT 风格的离散目标训练强音频编码器,再用多系统 ROVER 伪标签和数据压缩做 Web 级预训练,随后用方言/上下文/困难声学数据持续预训练,通过迭代教师 SFT 提高监督质量,最后把通用、方言和上下文三个 RL 专家的能力用 MOPD 汇入一个学生,并对真实 hard cases 做行为强化。
从结果看,这套路线在聚合普通话、英语、粤语/方言、上下文关键词和实际鲁棒性上取得了较均衡的性能;真正值得关注的创新是“数据治理 + 上下文输入组织 + 领域专家 RL + on-policy 多教师蒸馏”的组合。它的主要不足则是复现信息不够完整、缺少模块级消融、内部评测不可公开验证,而且带口音英语和部分方言类别仍有明显提升空间。