论文:Qwen-Audio-3.1-ASR Technical Report(arXiv:2610.28711)
一、先给结论:Qwen-Audio-3.1-ASR 做了什么
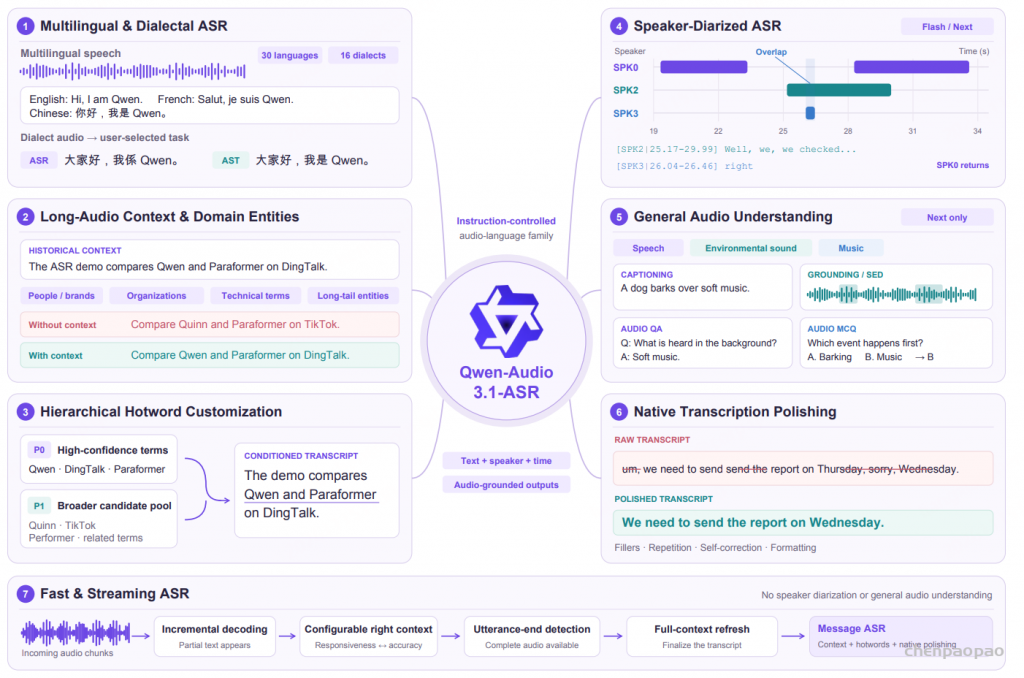
Qwen-Audio-3.1-ASR 不是只把语音转成一串文字的单一 ASR 模型,而是一组由指令控制的 Audio-Language Model。它在保留 Qwen-Audio-3.0-ASR 多语言识别、历史上下文、热词和原生润色能力的基础上,增加了两类能力:第一,输出带有说话人标签和时间戳的说话人日志;第二,Qwen-Audio-3.1-ASR-Next 能够处理声音描述、时间定位、声音事件和音频问答。
- 支持 30 种语言,以及 16 种中文方言。
- 中文方言可以在推理时选择“保留方言原话的 ASR”,也可以选择“翻译成普通话文字的 AST”。
- 非流式 Flash 和 Next 版本支持说话人日志,输出格式为
[SPK|start-end]text,支持不同说话人的时间区间重叠。 - Message 版本采用“流式实时显示 + 句末非流式刷新”,并在同一识别流程中支持历史上下文、分层热词和原生转写润色。
- 训练流程包含六个阶段:音频编码器预训练、Audio LLM 预训练、LLM cooldown adaptation、监督微调、强化学习和多教师在策略蒸馏(MOPD)。
二、模型家族与部署版本
| 版本 | 主要场景 | ASR | 说话人日志 | 通用音频理解 | 上下文 | 热词 | 原生润色 |
|---|---|---|---|---|---|---|---|
| Qwen-Audio-3.1-ASR-Flash-Filetrans | 异步文件转写 | 支持 | 不支持 | 不支持 | 支持 | 支持 | 不支持 |
| Qwen-Audio-3.1-ASR-Flash-Streaming | 实时流式识别 | 支持 | 不支持 | 不支持 | 支持 | 支持 | 不支持 |
| Qwen-Audio-3.1-ASR-Flash-Message | 交互式语音输入 | 支持 | 不支持 | 不支持 | 支持 | 支持 | 支持 |
| Qwen-Audio-3.1-ASR-Flash | 非流式转写 | 支持 | 支持 | 不支持 | 支持 | 支持 | 支持 |
| Qwen-Audio-3.1-ASR-Next | 非流式转写与音频分析 | 支持 | 支持 | 支持 | 支持 | 支持 | 支持 |
论文中的实验名称略有简化:实验表格中的 Qwen-Audio-3.1-ASR 通常指 Flash 基础模型的非流式接口;Qwen-Audio-3.1-ASR-Next 指带通用音频理解能力的 Next 版本;Message 延迟和行业术语召回实验使用 Qwen-Audio-3.1-ASR-Flash-Message。
三、总体架构:声音、指令和上下文共同参与解码
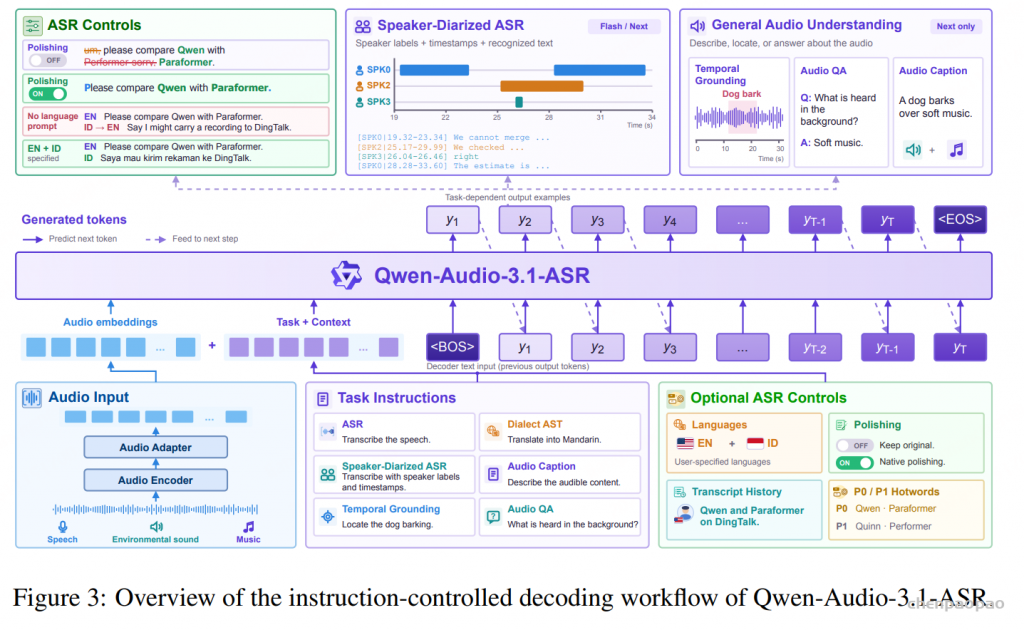
Qwen-Audio-3.1-ASR 的核心由三部分组成:音频编码器(audio encoder)、音频适配器(audio adapter)和基于 Qwen 的 LLM 解码器。音频编码器从波形中提取声学表示;适配器把声学表示映射到语言模型可以接收的表示空间;LLM 解码器根据声音、任务指令、可选文本条件和已经生成的前缀逐 token 产生结果。
对于音频输入 x、任务指令 q 和可选文本条件 c,可以把模型抽象为:
\(H=A(E(x)),\qquad p_{\theta}(y\mid x,q,c)=\prod_{t=1}^{T}p_{\theta}(y_t\mid y_{<t},H,q,c)\)其中,E 是音频编码器,A 是音频适配器,H 是音频 embedding 序列,y 是输出 token 序列。c 可以包含目标语言、历史转写、P0/P1 热词或润色指令。由于解码器仍然直接接收音频表示,因此上下文提示是辅助证据,不能简单替代声学证据。
模型还保留一条辅助 CTC 路径。CTC 分支从音频编码器表示中生成初步识别假设和粗粒度位置,用于帮助热词定制与长音频上下文注入;最终输出仍由音频、指令、上下文和自回归解码共同决定,不能把 CTC 初稿当作最终答案。
3.1 说话人日志的结构化输出
说话人日志不再是单一文本串,而是多个带结构字段的片段。可以抽象为:
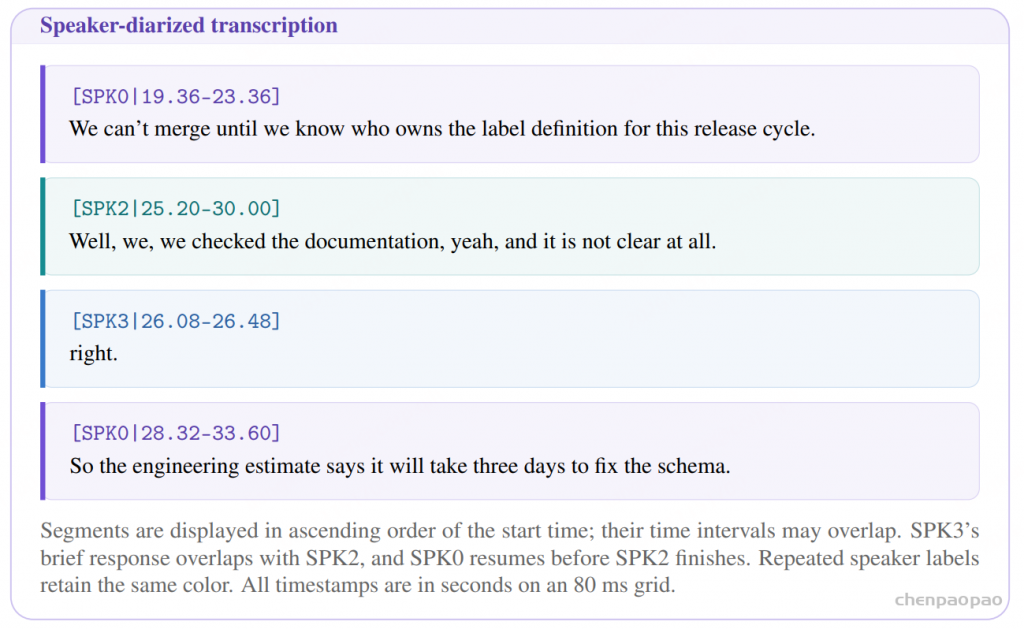
\(\mathcal{S}=\{(b_i,e_i,k_i,w_i)\}_{i=1}^{M}\)b_i 和 e_i 是片段起止时间,k_i 是录音内部的说话人标签,w_i 是对应文字。实际序列化格式为 [SPK|start-end]text,例如 [SPK2|25.20-30.00]Well, we checked the documentation.。同一录音中同一说话人会重复使用相同标签;不同说话人的时间区间可以重叠,因此可以表示插话、短响应和同时说话。标签只表示录音内部的参与者,不等于现实世界身份识别。
四、六阶段训练流程
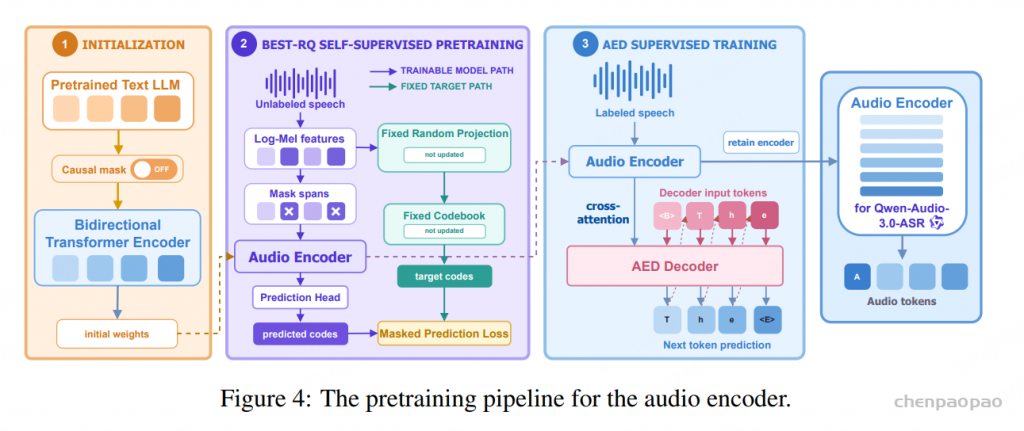
4.1 第一阶段:音频编码器预训练
音频编码器预训练分为 BEST-RQ 自监督预训练和 AED 监督训练两步,论文称两阶段合计使用了数千万小时、覆盖多种真实场景的音频。音频来自人工智能、生物技术、电商、教育、娱乐、金融、出行等领域,但论文没有公开每个领域的具体时长。
- Qwen3 初始化:从预训练 Qwen3 LLM 中初始化结构兼容的 Transformer 层。非流式编码器使用双向注意力,以便同时查看语音前后文;声学前端单独初始化。
- BEST-RQ:随机遮挡声学帧,使用未遮挡特征经过固定随机投影和冻结 codebook 得到的离散目标,训练编码器预测被遮挡位置的目标。这样可以利用大量无转写语音学习上下文声学表示。
- AED 监督训练:把编码器接入 attention-based encoder-decoder,用配对的音频和文字逐 token 预测转写。标注数据经过 VAD、Paraformer-V2、Whisper-large-v3、SenseVoice 等多系统伪标签生成和 ITN 处理。完成后丢弃 AED 解码器,只保留训练好的编码器初始化主模型。
4.2 第二阶段:Audio LLM 预训练
Audio LLM 解码器从 Qwen 的语言模型部分初始化,采用 Mixture-of-Experts(MoE)骨干。论文给出的预训练规模约为 2,000 万小时多语言数据,主要包括 ASR 数据和文字-音频交错数据。此阶段冻结音频编码器,只联合训练音频适配器和 LLM 解码器,并使用目标文字上的交叉熵损失建立音频表示与语言表示之间的对齐。
这一阶段带来的不仅是发音到文字的映射,也包括多语言知识、世界知识和语义消歧能力。例如,当声音在同音词之间存在歧义时,语言模型可以利用话题、实体和常识进行候选排序,但最终仍需要以音频为主要证据。
4.3 第三阶段:LLM Cooldown Adaptation
Cooldown 阶段使用约 100 万小时的更高质量音频-文字数据,重点不是继续简单扩大数据量,而是重新平衡语言和中文方言比例、提高转写质量并增加任务多样性。混合数据包括常规 ASR、音频理解、说话人日志、语音问答和对话数据。
质量过滤方面,团队使用 VibeVoice 对 ASR 音频重新识别,再与已有参考文本比较;词错误率大于 0.3 的样本被移除。重要的是,这个过程只是筛选数据,不是用 VibeVoice 输出替换原参考文本。
4.4 第四阶段:监督微调(SFT)
SFT 把模型变成真正的指令控制 Audio-Language Model。每个样本由用户指令、音频和 assistant 目标回答构成,覆盖多语言、方言、代码切换、噪声、远场、行业术语、说话人日志和通用音频理解。
SFT 时联合更新音频编码器和音频适配器;基础 LLM 参数冻结,只通过 LoRA 适配解码器。训练目标仍是目标回答的自回归交叉熵。语言控制样本会明确要求“按指定语言转写”“保留多语言原有书写系统”,避免模型把较低资源语言擅自替换成更熟悉的语言。
4.4.1 行业实体数据合成
团队从人工智能、金融、医疗、IT 等领域挖掘稀有实体和长尾词,结合检索到的事实背景让 LLM 生成包含实体的多样短句,再用 CosyVoice3 合成语音;对难以稳定合成的术语补充人工录音。随后用当前 ASR 模型重新识别,并过滤实体明显不一致的样本。这样可以让模型在训练中同时“看到”和“听到”不常见的名称,而不是只在词表中加入文字。
4.4.2 原生转写润色
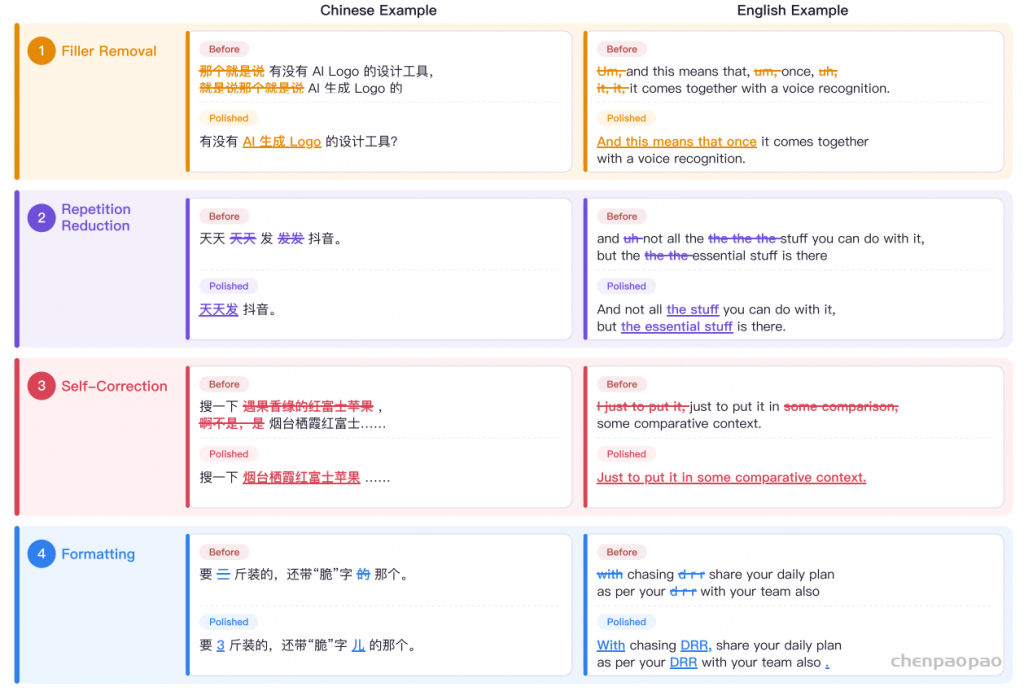
通过一个二值润色指令控制输出是逐字稿还是清洁稿。润色样本教模型删除非语义填充词、合并口吃和不必要重复、处理说话人的自我纠正,并规范标点和格式。真实语音保留原始音频,再用文本 LLM 生成润色监督,并用保真度过滤去除语义损失或无依据添加;合成数据则在标准文本中注入填充词、重复和自我修正,再通过 TTS、发音过滤和噪声增强生成音频。
4.4.3 历史上下文与同音词消歧
上下文训练把同一会话前面已经出现的转写或交互记录作为参考。指令明确告诉模型:历史上下文可能不完整、无关甚至错误,当前音频仍是首要证据。真实数据按照音频 ID 找回原会话,恢复时间顺序,只使用当前语音之前的轮次,不对历史文本做 LLM 改写;合成数据则专门构造正确、冲突、噪声和空白上下文,用来训练模型既会利用有效提示,也不会无条件复制提示。
这解释了“没有外部知识时如何利用同一句话内部线索”的基本机制:音频编码器提供发音证据,当前句子已生成的前缀、指令和历史片段提供语义约束;如果目标词是专名或同音词,模型可以通过同一句中的动作、对象、数量、主题和显式拼字说明来提高候选概率。训练时还要加入冲突提示和无关提示,避免模型形成“提示了什么就一定输出什么”的捷径。
4.4.4 分层热词 P0/P1
P0 是高置信度、高优先级候选,例如关键人名和上下文中确定出现的实体;P1 是更宽的候选池。LLM 根据候选与参考转写的语义匹配把词分层。推理时 P0 获得更强条件,但模型仍需同时满足声学和上下文证据;P1 用于扩大覆盖而不是强制替换。
4.4.5 说话人日志 SFT、speaker loss 与时间量化
说话人日志训练数据由人工转写和模型生成监督组成。影视数据使用原始字幕,并结合语言识别、声音事件检测和说话人日志模型交叉校验;另外用 LLM 生成会议话题,模拟多人会议,并加入不同混响和噪声。
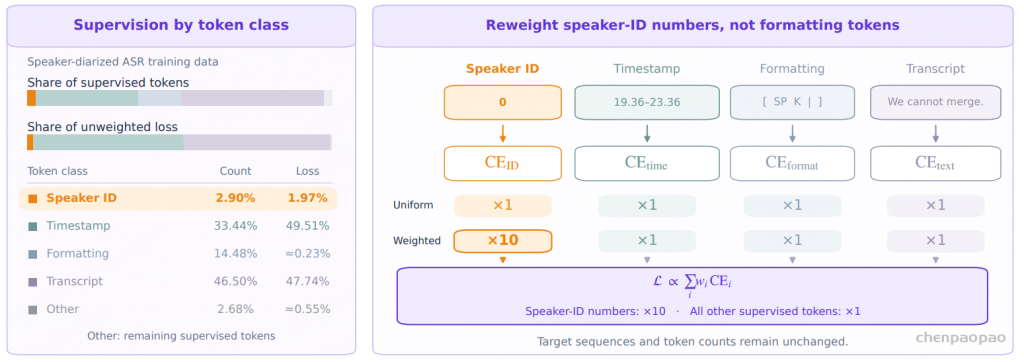
输出按时间顺序序列化为 [SPK|start-end]text。同一说话人保持一致标签,区间允许重叠。训练语料中,speaker-ID 数字 token 占全部监督 token 的 2.90%,但只贡献未加权交叉熵损失的 1.97%;时间戳 token 占 33.44%,贡献 49.51%;格式 token 占 14.48%,损失约 0.23%;转写 token 占 46.50%,损失 47.74%。因此只对 speaker-ID 数字 token 施加 10 倍损失权重,其余 token 保持 1 倍。
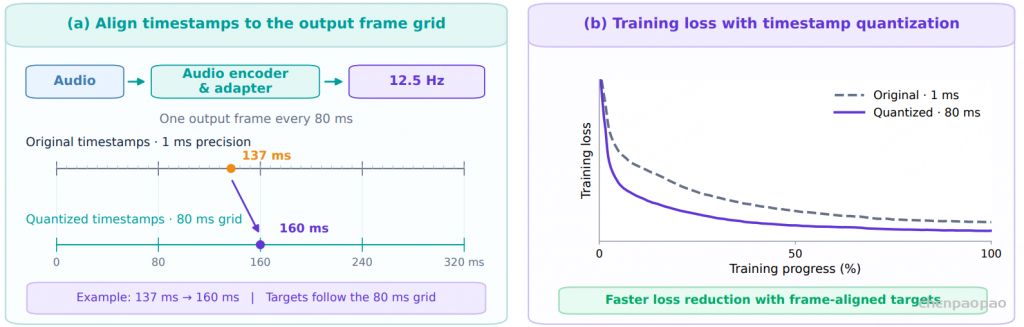
时间戳从原始 1 ms 精度量化到 80 ms 网格,与编码器和适配器的 12.5 Hz 表示帧率对齐。论文报告,相比 1 ms 目标,80 ms 量化能带来更快的损失、DER 和 cpWER 收敛,并在相同数据混合下取得更好的 DER 和 cpWER。
4.5 第五阶段:强化学习(RL)
RL 数据集聚焦真实困难样本,包括多个 ASR 系统(Whisper、FireRed-ASR、SenseVoice)意见不一致的样本、超过 20 秒的长语音、幻觉与长重复、关键词/热词样本,以及用于防止灾难性遗忘的常规 ASR 数据。上下文样本保留原有历史文本和指令,以便奖励真正反映指定任务。
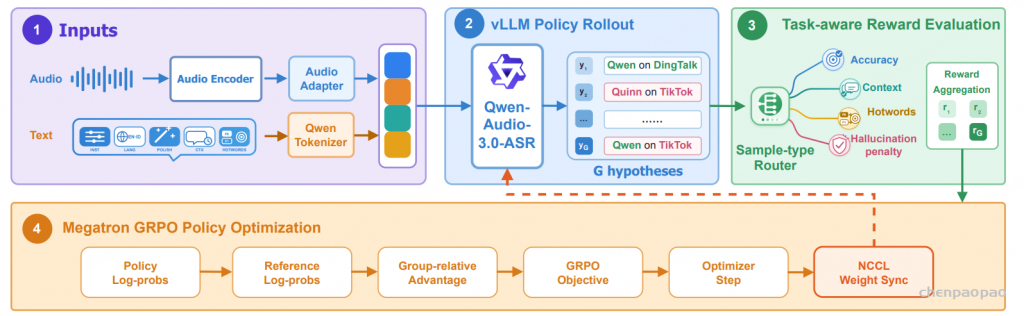
团队实现了异步音频强化学习框架 FunVerl:音频处理器提取 Mel 特征并 token 化文本;vLLM 生成一组候选答案;奖励模块按任务计算分数;Megatron trainer 使用张量、流水线和专家并行更新策略。轨迹队列把生成和优化解耦,NCCL 同步更新后的权重,并通过策略版本阈值过滤过旧轨迹。
对每个输入 q,旧策略生成 G 个回答,组内标准化奖励得到共享优势:
\(\hat A_{i,t}=\frac{R_i-\operatorname{mean}(\{R_j\}_{j=1}^{G})}{\operatorname{std}(\{R_j\}_{j=1}^{G})+\delta}\)GRPO 的裁剪目标为:
\(J_{\mathrm{GRPO}}(\theta)=\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_t\left[\min\left(r_{i,t}\hat A_{i,t},\operatorname{clip}(r_{i,t},1-\varepsilon,1+\varepsilon)\hat A_{i,t}\right)-\beta D_{\mathrm{KL}}(\pi_\theta\|\pi_{\mathrm{ref}})\right]\)- 普通 ASR 奖励:
1-WER为主,结合关键词召回、关键词准确率、P0/P1 热词奖励、上下文实体命中与误插入惩罚。 - 幻觉抑制:通过模式匹配检测幻觉片段,并按幻觉长度惩罚。
- 说话人日志奖励:使用 DER、cpWER 和 tcpWER,分别关注说话人活动/混淆、按说话人拼接后的识别、以及带时间约束的词对齐。
4.6 第六阶段:多教师在策略蒸馏(MOPD/OPD)
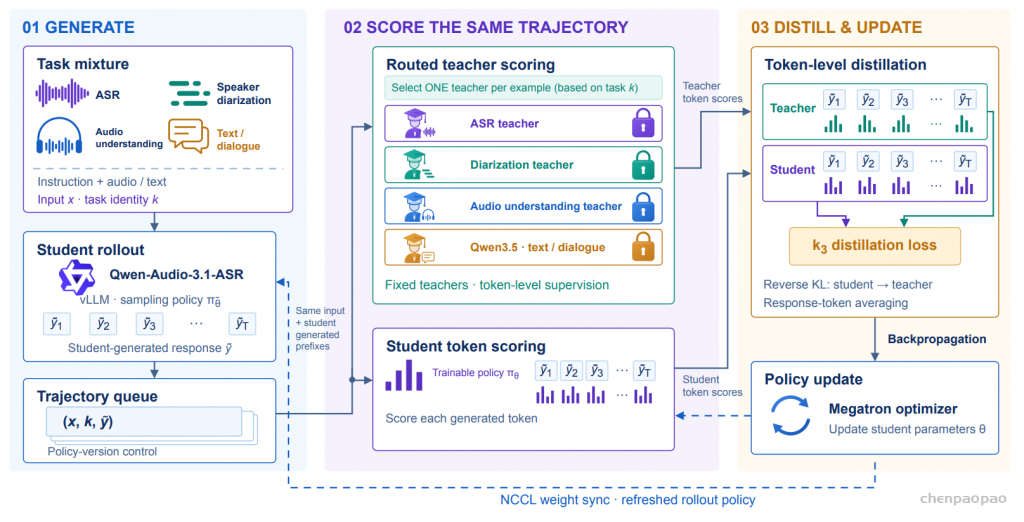
多教师在策略蒸馏的通俗理解是:不是让学生只背固定标准答案,而是先让学生按当前能力自己生成,再让最适合该任务的教师在学生实际走到的前缀上给出 token 级指导。这样,学生前面即使已经犯错,教师仍能在学生真实访问到的状态上纠偏,减轻训练分布与推理分布不一致的问题。
任务路由使用四类教师:ASR 教师负责语音转写;说话人日志教师负责 speaker、时间和文字结构;音频理解教师负责声音描述、时间定位和音频问答;Qwen3.5 文本/对话教师负责保留语言模型和对话能力。
设学生采样回答为 \tilde y,输入为 x,任务对应教师为 p_{\phi_k}。对学生生成的第 t 个 token,使用 k3 估计器:
\(\rho_t(\theta)=\frac{p_{\phi_k}(\tilde y_t\mid x,\tilde y_{<t})}{\pi_\theta(\tilde y_t\mid x,\tilde y_{<t})},\qquad d_t^{(k_3)}=\rho_t-\log\rho_t-1\)完整蒸馏损失为:
\(\mathcal L_{\mathrm{OPD}}(\theta)=\mathbb E_{(x,k),\tilde y\sim\pi_{\bar\theta}}\left[\frac{1}{|\tilde y|}\sum_{t=1}^{|\tilde y|}d_t^{(k_3)}(\theta)\right]\)蒸馏数据混合 ASR、speaker diarization、audio understanding,以及文本和对话数据。论文没有给出各教师、各任务的具体采样比例,也没有公开单独的 MOPD 增益表,因此可以确认其设计目标是能力合并和稳定化,但不能把最终成绩定量归因于 MOPD 单一步骤。
五、推理与部署:流式、上下文和方言任务
5.1 多语言和代码切换
推理时可以指定目标语言列表,模型在同一个 checkpoint 中处理多语言和代码切换,并保留各语言原有书写系统。例如日语保留汉字与假名,韩语保留韩文。公众号给出的韩语金融口述和日语求职咨询样例,强调专业词、语气和关键信息的保留,而不是把所有语言统一翻译成中文。
5.2 方言 ASR 与方言到普通话 AST
同一段方言有两种合法目标:ASR 要求保留方言原话;AST 要求把方言意思翻译成书面普通话。比如“大家好,我係 Qwen。”在方言 ASR 中保留“我係”,在方言到普通话 AST 中输出“我是”。这两个任务必须分开评测,不能把方言原文 CER 和普通话翻译的语义准确率混为一谈。
5.3 流式识别与 Message ASR
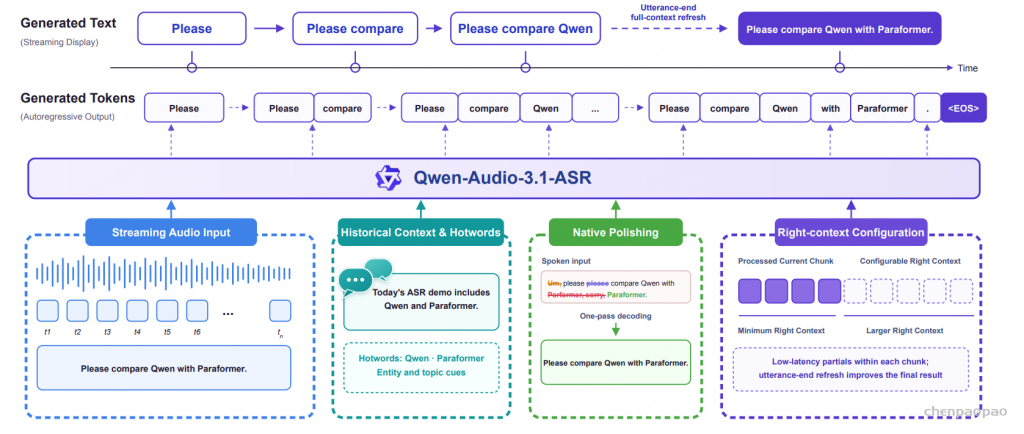
Streaming 版本把音频切成短 chunk,并配置有限的 right context,以在延迟和准确率之间折中。短 right context 更快,长 right context 能看到更多声学证据;随着更多音频到达,部分假设可以被修订。句末检测后,完整 utterance 会被重新解码并刷新最终文本。
Message ASR 在此基础上叠加历史转写、P0/P1 热词和原生润色。它的设计重点是“先让用户看到字,再在句末用完整上下文刷新”,而不是要求流式阶段立即输出最终完美结果。
连续音频输入
      ↓
音频切成短 chunk
      ↓
加入有限的未来音频 right context
      ↓
流式编码与增量解码
      ↓
输出临时文本
      ↓
继续接收新的音频
      ↓
修订尚未稳定的文本尾部
      ↓
检测到 utterance 结束
      ↓
取完整语句音频
      ↓
使用完整上下文重新解码
      ↓
刷新最终转写文本
六、实验设置与指标
论文覆盖公开 ASR、多语言、方言、行业实体、热词、长音频上下文、原生润色、Message 延迟、说话人日志和通用音频理解。公开数据集包括 AISHELL-1、AISHELL-2、FLEURS、LibriSpeech、WeNetSpeech、GigaSpeechBench、Common Voice 15、KeSpeech、WSYue、AISHELL-4、AliMeeting-test、MLC-SLM、MagicData-RAMC、MMAU、MMSU、CochlScene、Nonspeech7k、MELD、NSynth、DiDiSpeech、Clotho-Moment 和 DESED。
常用指标定义如下:
- CER:中文或逐字评价中的字符错误率,越低越好。
- WER:英文等按词评价的词错误率,越低越好。
- DER:说话人日志错误率,反映漏检、误报和说话人混淆。
- cpWER:按说话人拼接后,在最佳说话人置换下计算的词错误率,降低了 SPK0/SPK1 名称任意性的影响。
- tcpWER:带时间约束的 cpWER,要求词与时间区间兼容。
- 实体召回率:参考文本中关键名称和术语被正确识别的比例。
- 语义句准确率:方言 AST 中输出是否保留人名、数量、否定、动作、对象、时间、地点等关键意义。
- mIoU:时间定位预测区间与标注区间的平均交并比。
内部方言 AST 的语义句准确率为:
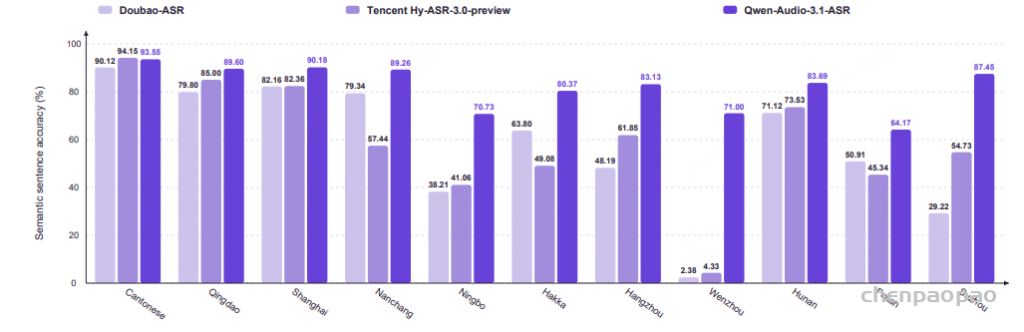
\(\mathrm{Semantic\ Sentence\ Accuracy}(\%)=\frac{100}{N}\sum_{i=1}^{N}\mathbf 1[z_i=0]\)其中 z_i=1 表示第 i 个输出存在语义错误,z_i=0 表示没有语义错误。人工标注子集与 Qwen3.7-Max 判断的一致率为 95.35%,这 95.35% 是评估器一致率,不是方言翻译准确率。
七、主要实验结果
7.1 中文和英文公开 ASR
| 测试集 | 指标 | Qwen-Audio-3.0-ASR | Qwen-Audio-3.1-ASR | 3.1 观察 |
|---|---|---|---|---|
| AISHELL-1 | CER | 1.03% | 1.08% | 略高于上一代;统一 API 评测中 Fun-ASR-Flash 为 0.76% |
| AISHELL-2 | CER | 2.02% | 2.05% | 与上一代接近 |
| FLEURS-zh | CER | 2.08% | 2.25% | 统一 API 评测中为参评系统最低 |
| FLEURS-en | WER | 4.17% | 4.72% | 统一 API 评测中为参评系统最低 |
| LibriSpeech-clean | WER | 1.19% | 1.23% | 统一 API 评测中为参评系统最低 |
| LibriSpeech-other | WER | 2.24% | 2.19% | 论文公开结果中达到最低值 |
| WeNetSpeech-net | CER | 4.31% | 4.37% | 统一 API 评测中 Fun-ASR-Flash 为 3.83% |
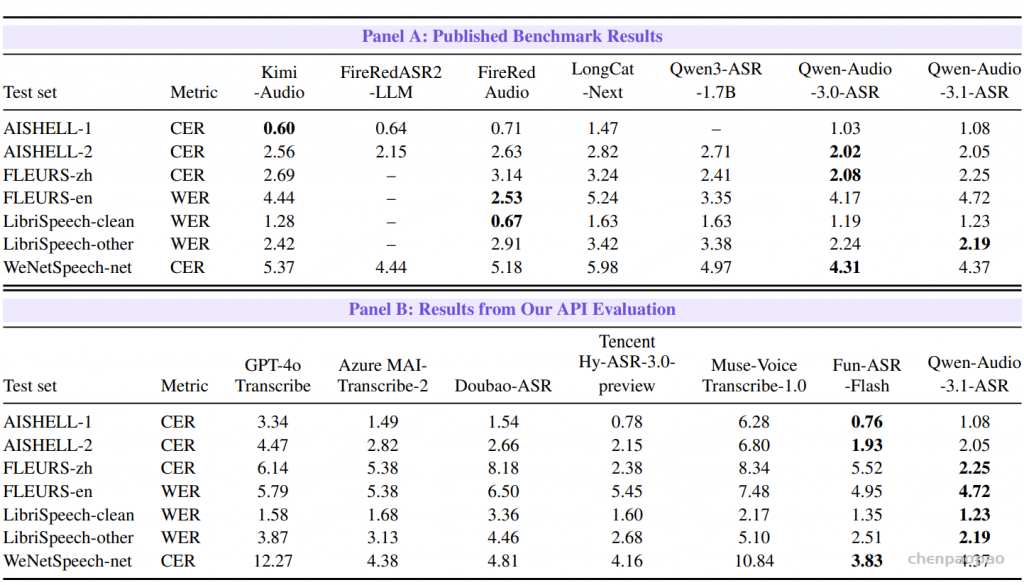
论文特别区分了“公开来源结果”和“统一 API 评测”。由于公开结果可能使用不同预处理和打分协议,直接比较应优先看 Panel B。统一 API 评测中,Qwen-Audio-3.1-ASR 在七个测试集中的四个取得最低错误率:FLEURS-zh 相对最强基线降低 0.13 个百分点,FLEURS-en 降低 0.23 个百分点,LibriSpeech-clean 降低 0.12 个百分点,LibriSpeech-other 降低 0.32 个百分点;AISHELL-1、AISHELL-2 和 WeNetSpeech-net 则由 Fun-ASR-Flash 最低。
7.2 多语言 ASR
| 测试组 | Qwen-Audio-3.0-ASR 宏平均 | Qwen-Audio-3.1-ASR 宏平均 | 结论 |
|---|---|---|---|
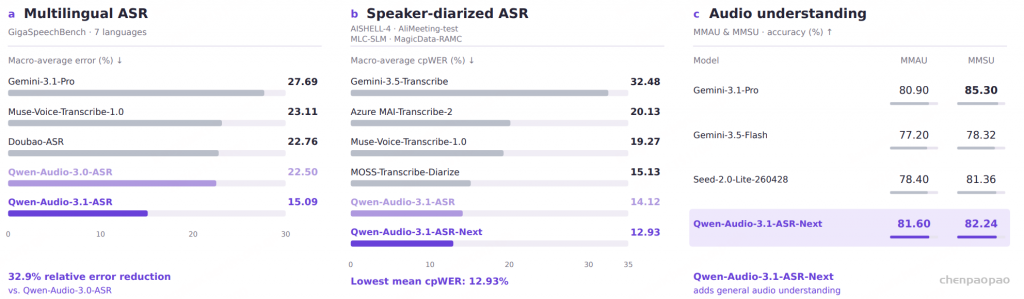
| GigaSpeechBench(印尼、日、泰、菲、越、韩、马来) | 22.50% | 15.09% | 相对降低 32.9%,七种语言均低于上一代 |
| Common Voice 15(8 种语言) | 未提供完整上一代结果 | 3.74% | 有完整结果的参评系统中最低 |
| FLEURS(9 种语言) | 4.94% | 3.85% | 低于上一代,但 Azure MAI-Transcribe-2 为 3.25% |
GigaSpeechBench 中,日语 CER 从 28.48% 降到 18.47%,泰语 CER 从 16.22% 降到 7.75%,马来语 WER 从 34.65% 降到 25.04%。FLEURS 中,Qwen-Audio-3.1-ASR 在印尼语、日语和韩语取得该表最低错误率;但泰语、菲律宾语、越南语和马来语的最佳值由 Azure MAI-Transcribe-2 获得,说明不同语言和录音条件下仍存在系统差异。
7.3 中文方言 ASR 与 AST
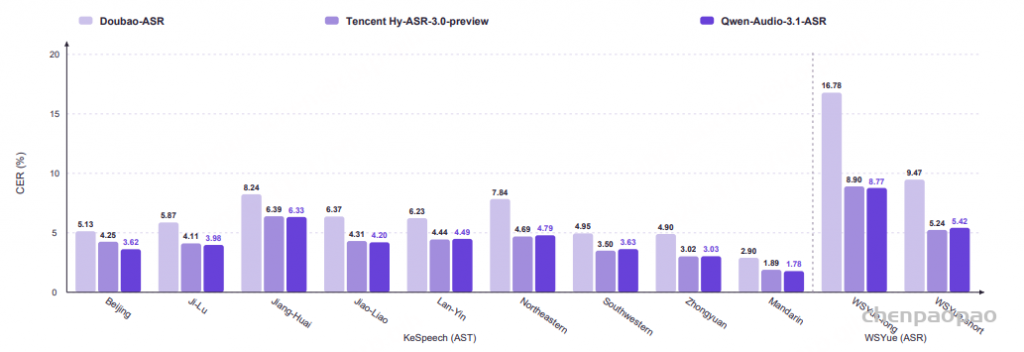
公开方言基准包含 9 个 KeSpeech AST 子集和 WSYue 粤语长/短语音 ASR 子集。Qwen-Audio-3.1-ASR 的宏平均 CER 为 4.55%,Doubao-ASR 为 7.15%,Tencent Hy-ASR-3.0-preview 为 4.61%,并在 6 个子集取得最低 CER。
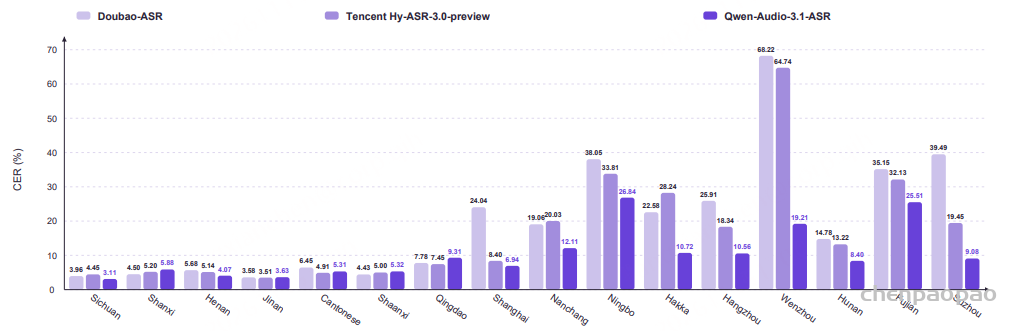
内部 16 方言 ASR 测试中,Qwen-Audio-3.1-ASR 在 11 个子集取得最低 CER,宏平均为 10.38%,低于 Doubao-ASR 的 20.23% 和 Tencent Hy-ASR-3.0-preview 的 17.13%。温州话 CER 为 19.21%,对应两个基线分别为 68.22% 和 64.74%。
内部 11 方言 AST 测试中,对 Doubao-ASR 可比的上海、客家和粤语子集,Qwen-Audio-3.1-ASR 语义句准确率宏平均为 88.03%,Doubao-ASR 为 78.69%;对 Tencent Hy-ASR-3.0-preview 可比的南昌、湖南、粤语和青岛子集,宏平均为 89.03%,基线为 77.53%。这些结果评估的是意义是否保留,不等于普通话表达是否最自然。
7.4 行业实体与热词
15 个行业的内部实体识别测试中,Qwen-Audio-3.1-ASR 在 9 个领域取得最高实体召回率,并在建筑与家居、制造业两个领域并列最高;召回率范围为 94.9%–99.5%。相较更强竞争系统,人工智能、农业、商业与物流的提升分别为 2.3、2.2 和 2.1 个百分点。论文也明确提醒:该结果不能单独证明实体合成流水线的因果增益,因为它与其他改进一起加入了最终模型。
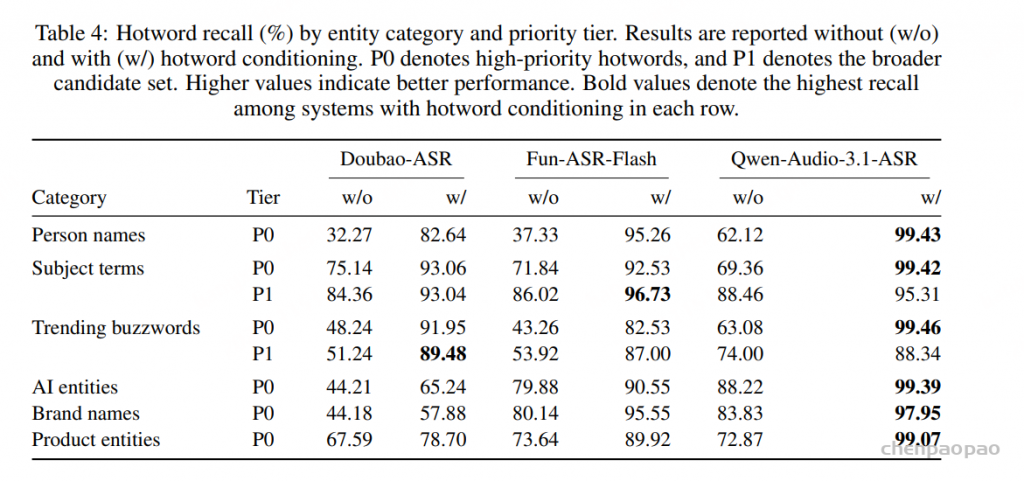
| 热词类别 | 层级 | 无热词 | 有热词 | 说明 |
|---|---|---|---|---|
| 人名 | P0 | 62.12% | 99.43% | 高优先级人名提升显著 |
| 主题词 | P0 | 69.36% | 99.42% | P0 强条件 |
| 主题词 | P1 | 88.46% | 95.31% | P1 提升较温和 |
| 趋势词 | P0 | 63.08% | 99.46% | P0 强条件 |
| AI 实体 | P0 | 88.22% | 99.39% | 长尾实体召回 |
| 品牌名 | P0 | 83.83% | 97.95% | 有热词时明显改善 |
| 产品实体 | P0 | 72.87% | 99.07% | 有热词时明显改善 |
7.5 长音频上下文
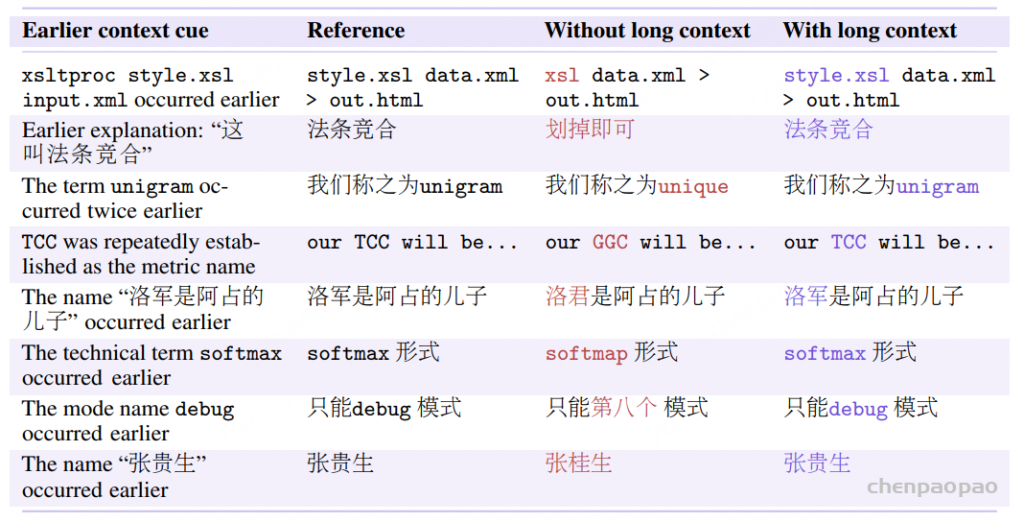
论文给出的定性案例显示,前面出现过的代码文件名、法条名称、unigram、TCC、softmax、debug 模式和人名,可以帮助后续片段纠正音近但错误的结果。例如前文出现 style.xsl,后文不带上下文时识别为 xsl,加入历史上下文后恢复为 style.xsl;“张贵生”也能从“张桂生”纠正回来。这里的上下文来自同一会话的此前转写,不是外部知识库。
这些例子是定性展示,不是受控的上下文消融实验。论文没有公开一个统一的“有上下文/无上下文”总体 CER 降幅,因此应把它们理解为机制示例,而非单独的性能承诺。
7.6 原生转写润色
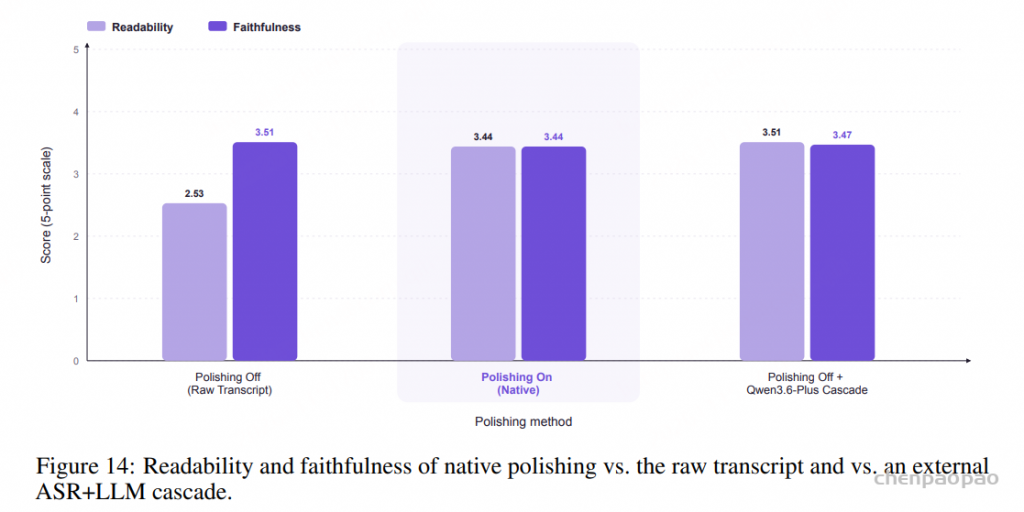
在五分制内部评分中,原始转写可读性为 2.53,原生润色提高到 3.44,外部 ASR+Qwen3.6-Plus 串联为 3.51;原生润色的忠实度为 3.44,串联为 3.47,原始转写为 3.51。也就是说,原生润色显著改善可读性,只带来有限的忠实度下降,并省掉额外的文本 LLM 调用。
公众号和论文示例包括删除 um/uh、合并 the the the、处理 false start、吸收说话人的最终自我修正,以及把口述字母 d r r 规范成 DRR。
7.7 Message ASR 延迟与行业词召回
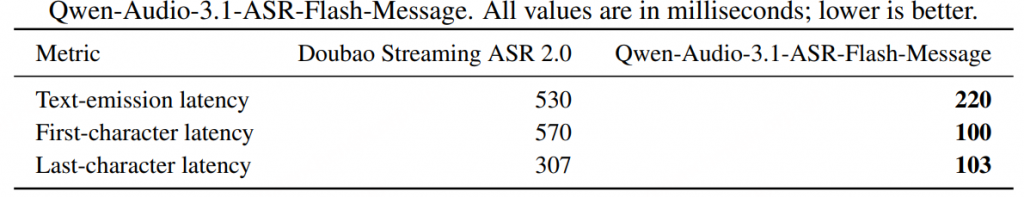
| 指标(毫秒) | Doubao Streaming ASR 2.0 | Qwen-Audio-3.1-ASR-Flash-Message |
|---|---|---|
| 文本输出延迟 | 530 | 220 |
| 首字符延迟 | 570 | 100 |
| 末字符延迟 | 307 | 103 |
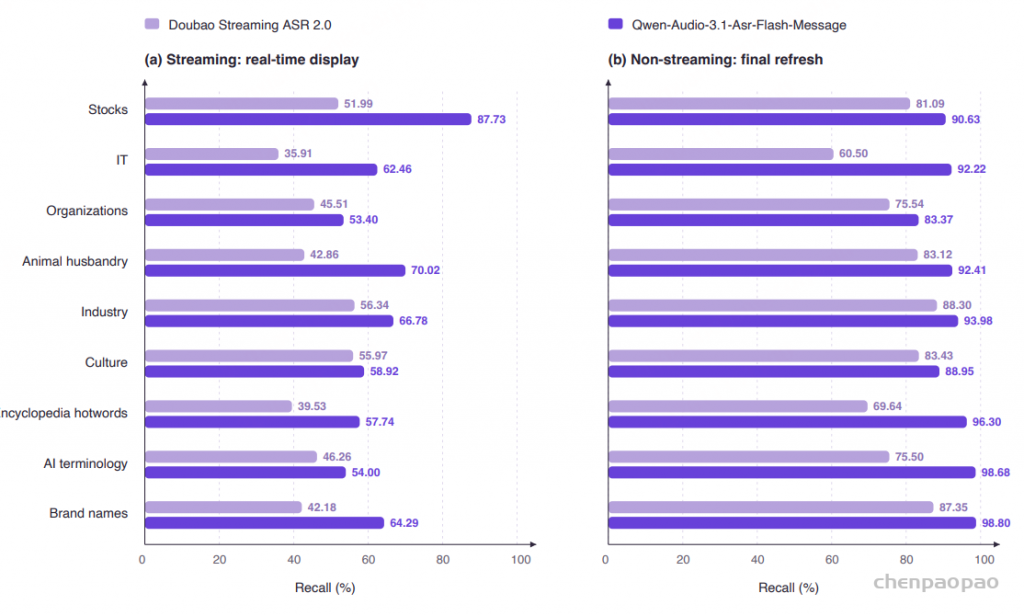
测试使用 10 路并发音频流,Qwen 服务运行在 NVIDIA H100,自建服务;网络延迟假设相近。九个行业测试集上,Qwen 流式显示阶段平均实体召回率为 63.93%,Doubao 为 46.28%;句末非流式刷新阶段为 92.82%,Doubao 为 78.27%。因此流式输出负责即时反馈,句末刷新负责更高质量的最终文本。
7.8 说话人日志 ASR
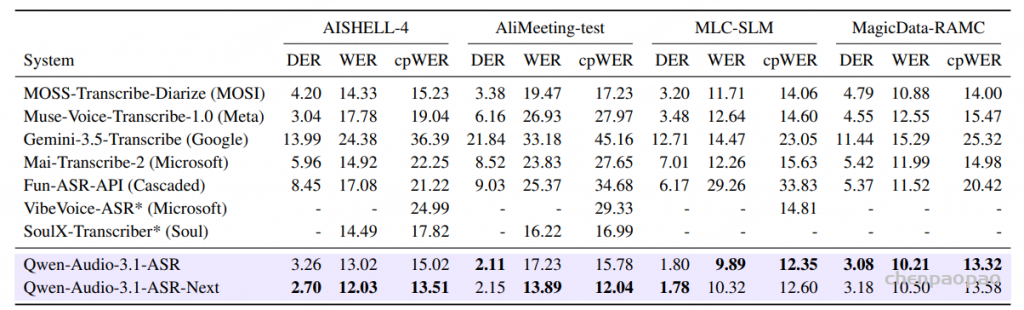
| 测试集 | Qwen 3.1 ASR DER | Qwen 3.1 ASR cpWER | Qwen 3.1 ASR-Next DER | Qwen 3.1 ASR-Next cpWER |
|---|---|---|---|---|
| AISHELL-4 | 3.26% | 15.02% | 2.70% | 13.51% |
| AliMeeting-test | 2.11% | 15.78% | 2.15% | 12.04% |
| MLC-SLM | 1.80% | 12.35% | 1.78% | 12.60% |
| MagicData-RAMC | 3.08% | 13.32% | 3.18% | 13.58% |
两种 Qwen 版本合计在四个数据集的 12 个数据集-指标组合中都取得最低错误率;两者各有优势。Next 在 AISHELL-4 的 DER/WER/cpWER、AliMeeting-test 的 WER/cpWER 等项目更强;基础 ASR 在 AliMeeting-test DER、MLC-SLM WER/cpWER 和 MagicData-RAMC 三项指标更强。所有 Qwen 版本都在四个数据集上同时优于级联 Fun-ASR 的 DER 和 cpWER。为公平比较,长音频测试统一切成约 4 分钟片段,论文提供了 SDR Evaluation Toolkit。
7.9 通用音频理解与时间定位
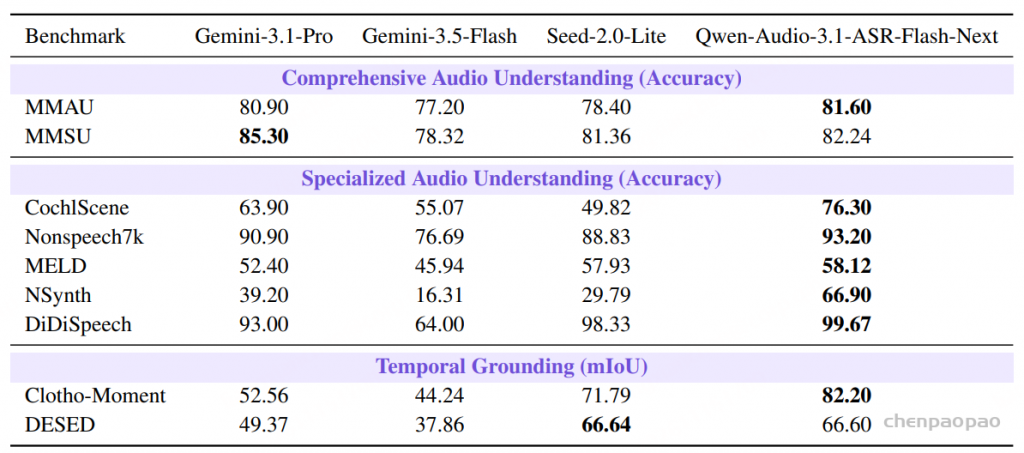
| 基准 | 任务/指标 | Qwen-Audio-3.1-ASR-Flash-Next | 结果解读 |
|---|---|---|---|
| MMAU | 综合音频理解准确率 | 81.60% | 高于 Gemini-3.1-Pro 0.70 个百分点 |
| MMSU | 细粒度语音理解准确率 | 82.24% | 低于最佳结果 3.06 个百分点 |
| CochlScene | 声学场景准确率 | 76.30% | 领先次优 12.40 个百分点 |
| Nonspeech7k | 非语音声音准确率 | 93.20% | 该任务最佳 |
| MELD | 情绪识别准确率 | 58.12% | 该任务最佳 |
| NSynth | 乐器识别准确率 | 66.90% | 领先次优 27.70 个百分点 |
| DiDiSpeech | 说话人性别准确率 | 99.67% | 该任务最佳 |
| Clotho-Moment | 单区间时间定位 mIoU | 82.20% | 领先次优 10.41 个百分点 |
| DESED | 多区间事件检索 mIoU | 66.60% | 仅低于最佳 0.04 个百分点 |
Next 在 9 个基准中的 7 个取得最佳结果。它把 ASR 扩展为对语音、环境声和音乐的统一音频理解,但这类能力只在 Next 非流式接口提供,不能与 Streaming 或 Message 版本混用。
八、论文中真正的创新点
- 从平面 ASR 到结构化音频输出:同一个指令控制框架覆盖普通转写、说话人+时间戳转写和音频理解。
- 说话人日志直接生成:把 speaker、时间和文字序列化为统一自回归目标,并支持重叠语音,避免单独 diarization、ASR、对齐模块之间的级联误差。
- 面向长尾实体的训练闭环:行业词挖掘、事实驱动句子生成、TTS/人工录音、重新识别过滤,形成专门的实体数据合成流水线。
- 上下文与热词的分层控制:历史转写提供话题线索,P0/P1 把高置信度候选和宽候选分开,同时用冲突/无关上下文训练模型避免盲目复制。
- 时间戳和 speaker token 的针对性优化:speaker-ID loss 乘 10,时间戳对齐到 80 ms 音频帧网格。
- 异步 GRPO 与 MOPD:RL 用序列级指标直接优化;MOPD 用多个任务教师在学生实际轨迹上提供 token 级指导。
- 流式显示与句末刷新结合:用实时性和最终准确率两个阶段分别服务用户体验和最终稿质量。
- 原生润色:把逐字识别与清洁稿生成放进同一次音频条件解码,减少额外 ASR+LLM 串联调用。
Qwen-Audio-3.1-ASR 的关键变化不是简单堆叠更多语言,而是把 ASR 放进一个更完整的音频语言建模框架:音频编码器负责提取可对齐的声学证据,Qwen MoE 解码器负责语言和语义组织,指令决定输出任务,上下文与热词负责在有依据时解决长尾实体和同音词,RL 和 MOPD 进一步把序列级指标与任务教师反馈纳入优化。
从结果看,它在多语言、中文方言、行业术语、说话人日志和通用音频理解上形成了较完整的能力谱系;从工程上看,Flash/Streaming/Message/Next 的版本拆分说明不同能力之间存在真实的延迟、上下文和输出结构取舍。对于实际应用,最合理的使用方式不是只追求一个最低 CER,而是根据任务选择:实时输入用 Message,异步文件和说话人日志用非流式 Flash,音频描述、声音事件和时间定位用 Next;涉及关键实体时,再结合 P0/P1 热词和同一会话历史上下文。