论文的核心问题是:很多音频理解任务最终只需要一个有限答案,例如从几个候选项中选一个、判断一个命题是否成立,或者给语音质量打分。如果仍然让大型音频语言模型逐字生成答案,就会产生额外的解码延迟、格式解析和结果校验成本。
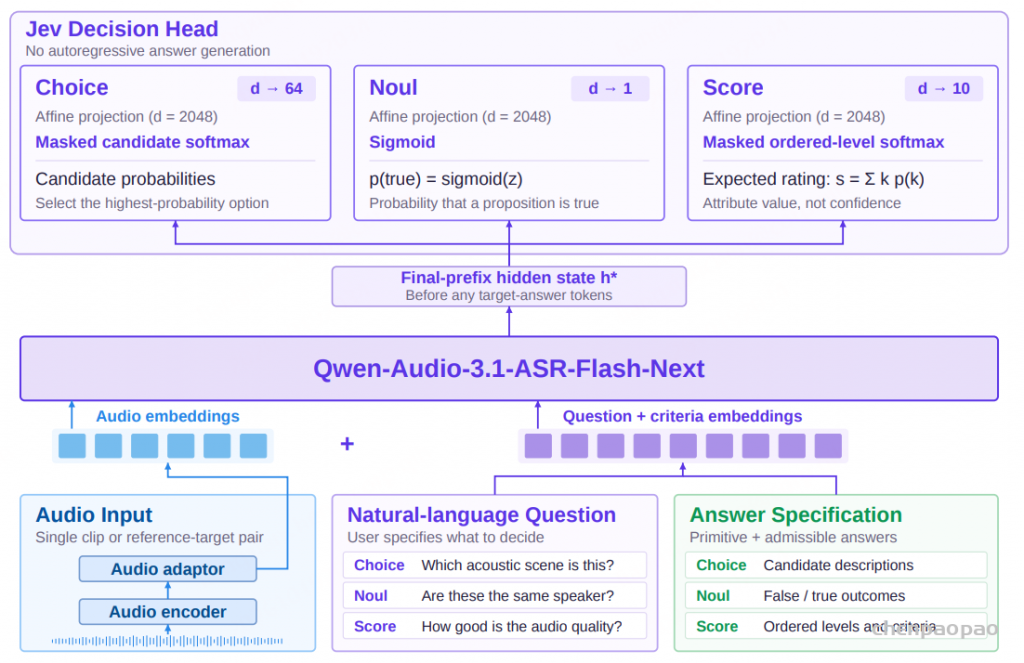
Qwen-Audio-Jev 保留 Qwen-Audio-3.1-ASR-Flash-Next 的音频编码器、音频到语言适配器和 MoE 语言解码器,在“答案开始之前”的隐藏状态上增加一个专用决策头 。模型通过自然语言问题和显式答案规范理解任务,然后直接输出概率分布或数值分数,不再自回归生成答案文本。 论文在 18 个标注配置上评测:MMAU-mini 准确率 78.70%,MMSU 准确率 84.06%,VoxCeleb1-O 说话人验证 EER 为 6.50%,NISQA overall 质量评分归一化 MAE 为 0.1062,Pearson 为 0.8210,Spearman 为 0.8074;在论文给定的推理设置下,速度约为原始 Qwen-Audio-3.1-ASR-Flash-Next 的 20 倍。
一、论文要解决的实际问题
传统大模型适合生成开放式文本,但在音频筛选、批量质检、说话人验证和数据标注中,输出空间往往是有界的。比如“这段音频属于哪种声学场景”“两个录音是否来自同一说话人”“这段语音的噪声等级是多少”,都可以表示为有限类别、真假概率或有序评分。自回归文本生成会带来三类问题:
需要逐 Token 解码,短答案也要承担语言模型生成的时间开销。 生成结果还要经过字符串解析、候选映射和格式校验,工程链路更长。 文本答案的概率不一定等于任务本身的类别概率,难以直接做校准和阈值控制。 Jev 的思路是将问题、答案空间和输出类型显式写入接口。模型仍然可以使用自然语言描述音频任务,但最后由固定维度的决策读出完成选择、判断或打分。
二、模型总体设计
2.1 Qwen-Audio-3.1-ASR-Flash-Next 基座
基座模型包含三个主要表示模块:
Audio Encoder: 从波形中提取声学、说话人、环境声音和韵律等表示。Audio-to-Language Adaptor: 对相邻编码帧做时间下采样,并将结果投影到语言解码器的隐藏维度。MoE Language Decoder: 把音频表示与文本指令、问题和上下文融合,形成问题条件的隐藏状态。论文实验使用的解码器为 40 层 MoE,隐藏维度为 2048,共 256 个 Routed Experts,每个 Token 选择 8 个专家。原始模型通过自回归概率生成文字答案:
\(p_{\theta}(y\mid x,u)=\prod_{\ell=1}^{L}p_{\theta}\left(y_{\ell}\mid y_{<\ell},\mathbf{a},u\right)\)
其中 \(x\) 是输入音频,\(\mathbf{a}\) 是音频编码和适配后的表示,\(u\) 是文本指令和上下文。Qwen-Audio-Jev 保留这个音频条件表示通路,但把最终答案从“生成文本”改成“读取决策状态”。
2.2 Jev 决策头插入位置
设 \(q\) 为自然语言问题,设 \(c\) 为答案规范。答案规范规定使用哪一种决策原语、合法答案空间是什么,以及候选项或评分等级的含义。问题和规范被序列化为文本前缀,与音频表示一起送入共享解码器:
\(\mathbf{H}=D_{\theta}\left(\operatorname{Fuse}\left(\mathbf{a},\operatorname{Embed}\left(\operatorname{Serialize}(q,c)\right)\right)\right)\)
决策状态取问题前缀最后一个 Token 的隐藏向量:
\(\mathbf{h}_{\star}=\mathbf{H}_{t_{\star}}\)
\(t_{\star}\) 位于目标答案 Token 之前,因此因果注意力无法读取训练样本中的正确答案,避免标签泄漏。决策头包含三个独立的仿射投影:
\(\mathbf{z}^{\mathrm{Choice}}=\mathbf{W}_{C}\mathbf{h}_{\star}+\mathbf{b}_{C}\)
\(z^{\mathrm{Noul}}=\mathbf{W}_{N}\mathbf{h}_{\star}+b_{N}\)
\(\mathbf{z}^{\mathrm{Score}}=\mathbf{W}_{S}\mathbf{h}_{\star}+\mathbf{b}_{S}\)
当前实现中,决策头维度分别为 \(\mathbf{W}_{C}\in\mathbb{R}^{64\times d}\)、\(\mathbf{W}_{N}\in\mathbb{R}^{1\times d}\)、\(\mathbf{W}_{S}\in\mathbb{R}^{10\times d}\),其中 \(d=2048\)。Choice 和 Score 只对当前问题实际提供的候选或评分等级做归一化,未使用的位置不参与 Softmax。
2.3 三种类型化输出
统一接口可以写成:
\(f_{\theta}(x,q,c)\longrightarrow r_{\tau},\qquad \tau\in\{\mathrm{Choice},\mathrm{Noul},\mathrm{Score}\}\)
Choice:从候选项中选择
Choice 适用于声学场景、乐器、人类非语音声音、性别、情绪和音频问答。当前实现支持 2 到 64 个候选项。候选项的语义由问题中的描述决定,而不是绑定到一个固定的全局类别 ID:
\(p_{ik}=\frac{\exp(z^{\mathrm{Choice}}_{ik})}{\sum_{j\in\mathcal{C}_{i}}\exp(z^{\mathrm{Choice}}_{ij})},\qquad \hat{k}=\arg\max_{k\in\mathcal{C}_{i}}p_{ik}\)
训练时会随机打乱 Choice 候选项,同时同步打乱候选描述和标签概率,防止模型记住“第一个位置通常是正确答案”。
Noul:二元命题的真实性概率
Noul 适用于“两个录音是不是同一个说话人”“这段音频是否包含讽刺”“音频是否为深度伪造”等二元问题。输出是命题为真的概率:
\(p_{i}=\sigma(z^{\mathrm{Noul}}_{i})=\frac{1}{1+\exp\left(-z^{\mathrm{Noul}}_{i}\right)}\)
Score:有序等级上的分布与期望分数
Score 适用于 NISQA、VoiceMOS 和 BVCC 等主观质量评估。评分等级从 \(0\) 到 \(K_i-1\),模型不只输出一个回归数,还输出完整的等级概率分布。预测期望和目标期望分别为:
\(\hat{s}_{i}=\sum_{k=0}^{K_i-1}k p_{ik},\qquad s_i^{\star}=\sum_{k=0}^{K_i-1}k t_{ik}\)
这种设计同时保留分类分布、评分顺序和原始 MOS 尺度,适合需要概率校准的质量控制系统。
2.4 推理过程
推理时输入音频、自然语言问题和答案规范,模型只执行一次共享解码器前向计算,再读取被请求的输出头。Choice 和 Score 对有效候选或等级做 Softmax;Noul 对单个 Logit 做 Sigmoid 。无需生成“答案是……”“评分为……”之类的文本,也不需要后处理字符串。
三、训练数据:
3.1 任务数据
决策类型 论文涉及的数据集/配置 监督信号 典型任务 Choice CochlScene、NSynth、NonSpeech7k、DiDiSpeech、MELD、MMAU、MMSU、MMAR 类别标签或多选答案 声学场景、乐器、咳嗽/笑声等非语音声音、性别、情绪、音频问答 Noul VoxCeleb1-O、Clotho-AQA、PodSarc、In-the-Wild 二元真假标签 说话人验证、二元音频问答、讽刺检测、音频深度伪造检测 Score NISQA overall/noise/coloration/discontinuity/loudness、VoiceMOS 有序等级或 MOS 评分 噪声、染色、断续、响度、整体语音质量
论文将每条训练样本统一成“音频—问题—答案规范—目标”的格式。一个音频不需要同时拥有 Choice、Noul 和 Score 三类标注;样本只对已有且可靠的目标计算损失,缺失标注不产生 Loss。这是论文处理异构数据的关键。
四、SFT:异构音频任务的联合监督
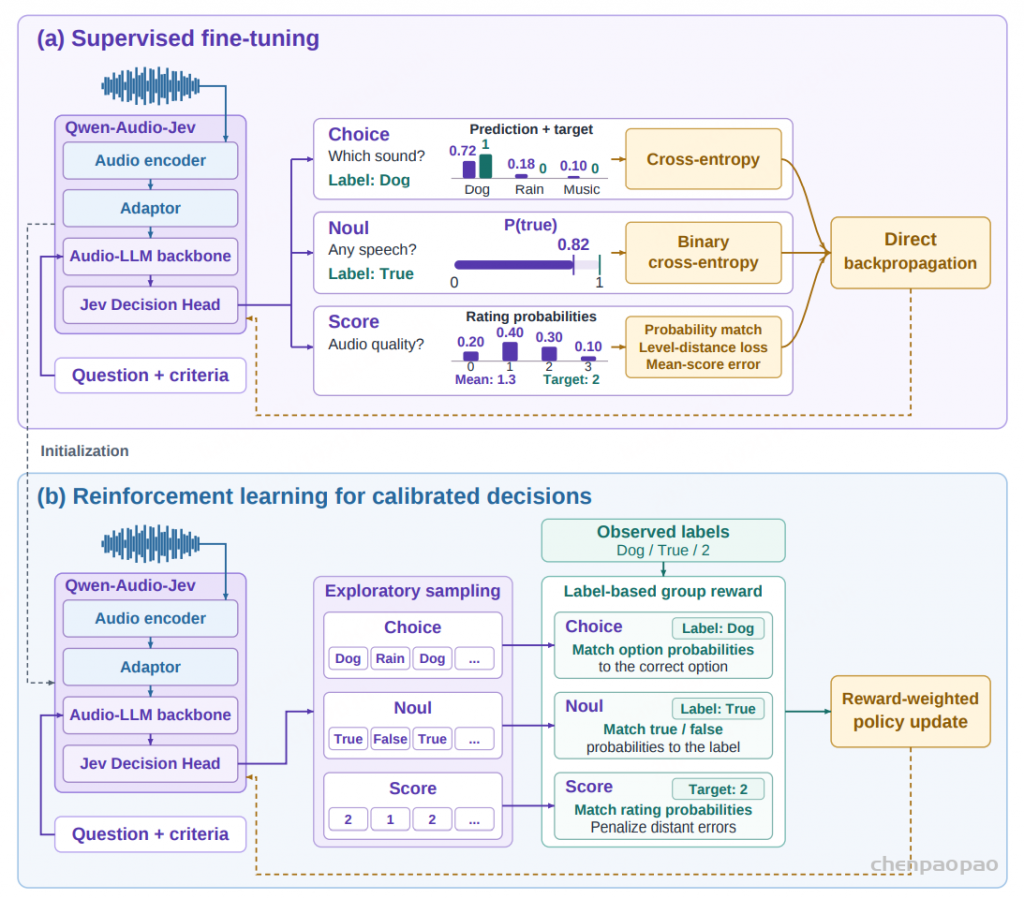
SFT 阶段联合优化 Audio Encoder、Audio-to-Language Adaptor、语言模型 Backbone 和 Jev 决策头。每条样本只激活其请求的决策原语,另外两个读出头不接受该样本的任务损失。论文没有把训练拆成多个串行阶段,而是把三类任务放入同一个监督微调流中;因此这里的“训练阶段”主要是 SFT 和后续 RLCD-inspired 强化学习两个阶段。
4.1 Choice 损失
对有效候选集合 \(\mathcal{C}_i\),候选概率为:
\(p_{ik}=\frac{\exp(z_{ik})}{\sum_{j\in\mathcal{C}_i}\exp(z_{ij})},\qquad k\in\mathcal{C}_i\)
交叉熵为:
\(\ell_i^{\mathrm{choice}}=-\sum_{k\in\mathcal{C}_i}t_{ik}\log p_{ik}\)
硬标签是 One-hot 分布;当数据提供人工标注分布时,使用 Soft Target。Choice 的候选随机排列是论文中特别强调的抗位置偏置增强。
4.2 Noul 损失
二元标签 \(y_i\in\{0,1\}\) 经过 Sigmoid 得到真值概率,使用 Binary Cross Entropy:
\(p_i=\sigma(z_i),\qquad \ell_i^{\mathrm{noul}}=-y_i\log p_i-(1-y_i)\log(1-p_i)\)
论文同时允许 \(y_i\in[0,1]\) 的软二元标注。这样可以用于多人标注后的概率标签,而不是强行压缩为单一真假值。
4.3 Score 损失
Score 同时使用等级分布交叉熵、累计分布误差和期望分数的 SmoothL1。预测和目标的累计概率分别为:
\(P_{im}=\sum_{k=0}^{m}p_{ik},\qquad T_{im}=\sum_{k=0}^{m}t_{ik}\)
三项损失为:
\(C_i=-\sum_{k=0}^{K_i-1}t_{ik}\log p_{ik}\)
\(D_i=\frac{1}{K_i-1}\sum_{m=0}^{K_i-2}(P_{im}-T_{im})^2\)
\(H(e)=\begin{cases}\frac{1}{2}e^2,&|e|<1,\\ |e|-\frac{1}{2},&|e|\ge 1\end{cases}\)
\(\ell_i^{\mathrm{score}}=C_i+\lambda_{\mathrm{cdf}}D_i+\lambda_{\mathrm{mean}}H(\hat{s}_i-s_i^{\star})\)
论文固定使用 \(\lambda_{\mathrm{cdf}}=0.25\) 和 \(\lambda_{\mathrm{mean}}=0.10\)。这比单一 MSE 回归更适合有序评分:交叉熵约束等级分布,CDF 项惩罚等级距离,SmoothL1 约束原始评分尺度上的期望值。
4.4 SFT 总目标
每条样本只计算其激活原语的损失:
\(\mathcal{L}_{\mathrm{dec}}=\ell_i^{t_i}\)
完整 SFT 目标为:
\(\mathcal{L}_{\mathrm{SFT}}=\mathcal{L}_{\mathrm{dec}}+\lambda_{\mathrm{lb}}\mathcal{L}_{\mathrm{lb}}^{\mathrm{base}}+\mathcal{L}_{\mathrm{rz}}\)
其中 \(\mathcal{L}_{\mathrm{lb}}^{\mathrm{base}}\) 是语言模型 Backbone 的 MoE 负载均衡损失,\(\mathcal{L}_{\mathrm{rz}}\) 是 Router z-loss。论文明确指出,SFT 不包含下一 Token 或多 Token 预测目标。
五、RLCD-inspired 强化学习:优化概率校准
强化学习从 SFT Checkpoint 开始,把每个类型化决策视为一步 Contextual Bandit。它不是为了让模型生成更长的解释,而是让概率分布同时具备正确性和校准性。论文使用基于 Brier Score 和 Ranked Probability Score 的组奖励,并通过采样动作做 REINFORCE 更新。
5.1 探索策略
对于第 \(i\) 个问题,Choice 和 Score 从候选或有序等级分布中采样,Noul 视为 False/True 两类策略。每个问题独立采样 \(M=32\) 个动作,探索行为策略为:
\(\mu_{\theta,i}(a)=(1-\epsilon)p_{\theta,i}(a)+\frac{\epsilon}{K_i},\qquad \epsilon=0.05\)
重要性权重为:
\(w_{ir}=\frac{p_{\theta,i}(a_{ir})}{\mu_{\theta,i}(a_{ir})}\)
5.2 校准导向的组奖励
对真实答案 \(y_i\),Brier 误差为:
\(B_i=\sum_{k=0}^{K_i-1}\left(p_{\theta,i}(k)-\mathbf{1}[k=y_i]\right)^2\)
Score 任务额外加入累计概率误差:
\(D_i=\frac{1}{K_i-1}\sum_{h=0}^{K_i-2}\left(\sum_{k=0}^{h}p_{\theta,i}(k)-\mathbf{1}[y_i\le h]\right)^2\)
论文构造的采样组奖励期望满足:
\(\mathbb{E}[\widehat{J}_i]=-B_i-\lambda_iD_i\)
其中 Score 任务使用 \(\lambda_i=0.25\),Choice 和 Noul 不使用有序等级项。该奖励不只奖励“猜对”,还奖励把概率质量放在正确等级附近,并减少过度自信。
5.3 策略梯度更新
论文使用 Leave-one-out Baseline,构造每个采样动作的 Return 和 Advantage,最终的策略梯度损失为:
\(\ell_i^{\mathrm{PG}}=-\frac{1}{M}\sum_{r=1}^{M}\operatorname{sg}\left[w_{ir}A_{ir}\right]\log p_{\theta,i}(a_{ir})\)
\(\operatorname{sg}\) 表示 Stop-gradient;采样动作、奖励、Baseline 和重要性权重视为常量,梯度只通过动作概率流动。这个阶段的重点是校准概率,而不是增加新的标签类型。
六、评测设置与数据集
论文共评测 18 个标注配置:8 个 Choice、4 个 Noul、6 个 Score。评测覆盖分类、音频问答、说话人验证、讽刺和深度伪造检测,以及语音质量评分。论文重点报告模型自身在这些任务上的结果,而不是逐任务与所有原始基座模型做完整消融对比。
6.1 Choice 任务
Benchmark 任务 Accuracy (%) CochlScene 声学场景分类 77.8717 NSynth instrument 乐器识别 72.2900 NonSpeech7k sound 人类非语音声音识别 92.6897 DiDiSpeech gender 说话人性别分类 100.0000 MELD emotion 对话情绪识别 57.3072 MMAU 多模态音频问答 78.7000 MMSU 语义、韵律和副语言理解 84.0568 MMAR 复杂混合音频问答 69.9000
Choice 结果显示,性别分类和人类非语音声音识别超过 90%,而 MELD 情绪识别只有 57.31%,是最弱配置。模型对说话人属性和明显的副语言事件更容易判断,对对话情绪这种依赖上下文、语气和角色关系的任务仍有明显提升空间。三个音频问答数据集中,MMSU 最好,MMAU 居中,MMAR 最低,说明复杂混合音频问答比基础类别识别更难。
6.2 Noul 二元判断
Configuration Accuracy (%) EER (%) AUC Brier FPR (%) FNR (%) VoxCeleb1-O 93.5441 6.4980 0.982267 0.048695 7.3214 5.5901 Clotho-AQA 79.8901 19.8251 0.878652 0.146391 14.4121 24.4898 PodSarc 98.2651 1.4427 0.995230 0.016406 2.1725 1.2149 In-the-Wild 76.3232 20.9469 0.876318 0.158112 3.7822 57.2867
PodSarc 和 VoxCeleb1-O 同时具备较高 AUC 和较低阈值错误,说明模型在说话人验证和讽刺检测上的概率排序、二元决策与概率误差都较稳定。In-the-Wild 与 Clotho-AQA 的 AUC 接近,但 In-the-Wild 在 0.5 阈值下 FNR 达到 57.29%,说明它不是不能排序,而是在当前阈值下漏掉了大量正样本。实际部署时应根据业务成本重新选择阈值,而不能只看默认 0.5。
6.3 Score 质量评分
Configuration MOS MAE MOS RMSE Normalized MAE Normalized RMSE Pearson Spearman NISQA overall 0.424642 0.546344 0.106160 0.136586 0.821002 0.807382 NISQA noise 0.584499 0.738843 0.146125 0.184711 0.736052 0.722851 NISQA coloration 0.345370 0.431912 0.086342 0.107978 0.809883 0.808054 NISQA discontinuity 0.430562 0.539793 0.107640 0.134948 0.800940 0.725388 NISQA loudness 0.436985 0.523098 0.109246 0.130775 0.728235 0.689991 VoiceMOS 0.813497 1.004048 0.203374 0.251012 0.723059 0.753843
NISQA overall 和 coloration 的 MOS 误差较低且相关性接近 0.8;loudness 的平均误差与 overall 接近,但 Pearson 较低,说明“平均偏差小”和“随样本质量变化的趋势一致”是两个不同维度。VoiceMOS 的 Pearson 和 Spearman 都为正,但原始 MOS MAE 为 0.813,高于 NISQA 各维度,说明跨数据集评分尺度和主观一致性仍是难点。
七、对 ASR 和音频理解系统的工程启示
把“识别”和“决策”分开: ASR、说话人验证、质量审核和音频筛选常常只需要结构化结果,直接读出比生成解释文本更适合高吞吐服务。使用问题条件化的候选空间: 同一个输出位置可以在一个问题中表示场景,在另一个问题中表示情绪,候选语义放在问题中,比固定分类头更容易扩展新任务。把概率校准作为一等目标: 线上系统通常需要阈值、置信度和风险排序,Brier、CDF 和概率分布损失比只优化准确率更贴近实际。允许部分标注: 不同音频数据集的标签互不相同,统一“音频—问题—规范—目标”格式,可以在不强行补全标签的情况下联合训练。对 Score 保留有序结构: 语音质量的 2 分和 3 分比 2 分和 5 分更接近,CDF 损失可以把这种等级距离纳入训练。部署时重新选阈值: In-the-Wild 结果说明 AUC 相近的系统,在固定 0.5 阈值下可能出现完全不同的 FNR,生产系统应根据漏检和误报成本选择 operating point。Qwen-Audio-Jev 的主要价值在于重新定义音频语言模型的输出接口:输入仍然是音频、自然语言问题和答案规范,输出则从开放式文本改为三种类型化决策。Choice 负责有限候选选择,Noul 负责二元命题概率,Score 负责有序质量分布和期望分数。模型通过共享的 Qwen-Audio-3.1-ASR-Flash-Next 表示通路和一个决策头覆盖多个数据集,再用异构标签的 SFT 和面向校准的 RLCD-inspired 训练统一优化。
论文结果说明,这种设计在音频筛选、说话人验证、深度伪造检测、语音质量评估和批量音频问答中具有工程潜力;但它还不是完整的端到端复现方案,因为训练数据总量、数据配比、完整消融和统一速度基准仍未公开。对于 ASR 团队,最值得借鉴的是:把高频、有限答案的后处理任务从“生成式问答”改造成“问题条件化决策”,并把概率校准、候选重排和缺失标签处理直接纳入训练接口。